跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. AI硬件
  4. Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G

Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G

已定时 已固定 已锁定 已移动 热议 AI硬件
macapple-m5视频生成
29 帖子 10 发布者 874 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • E
    E
    eddie-hk
    编写于 最后由 编辑
    #19

    @fsclsnow 謝謝師兄分享,小弟也是小白一名,之後可以直接抄功課了 🙏🏻

    F 1 条回复 最后回复
    0
    • F
      F
      fsclsnow
      编写于 最后由 fsclsnow 编辑
      #20

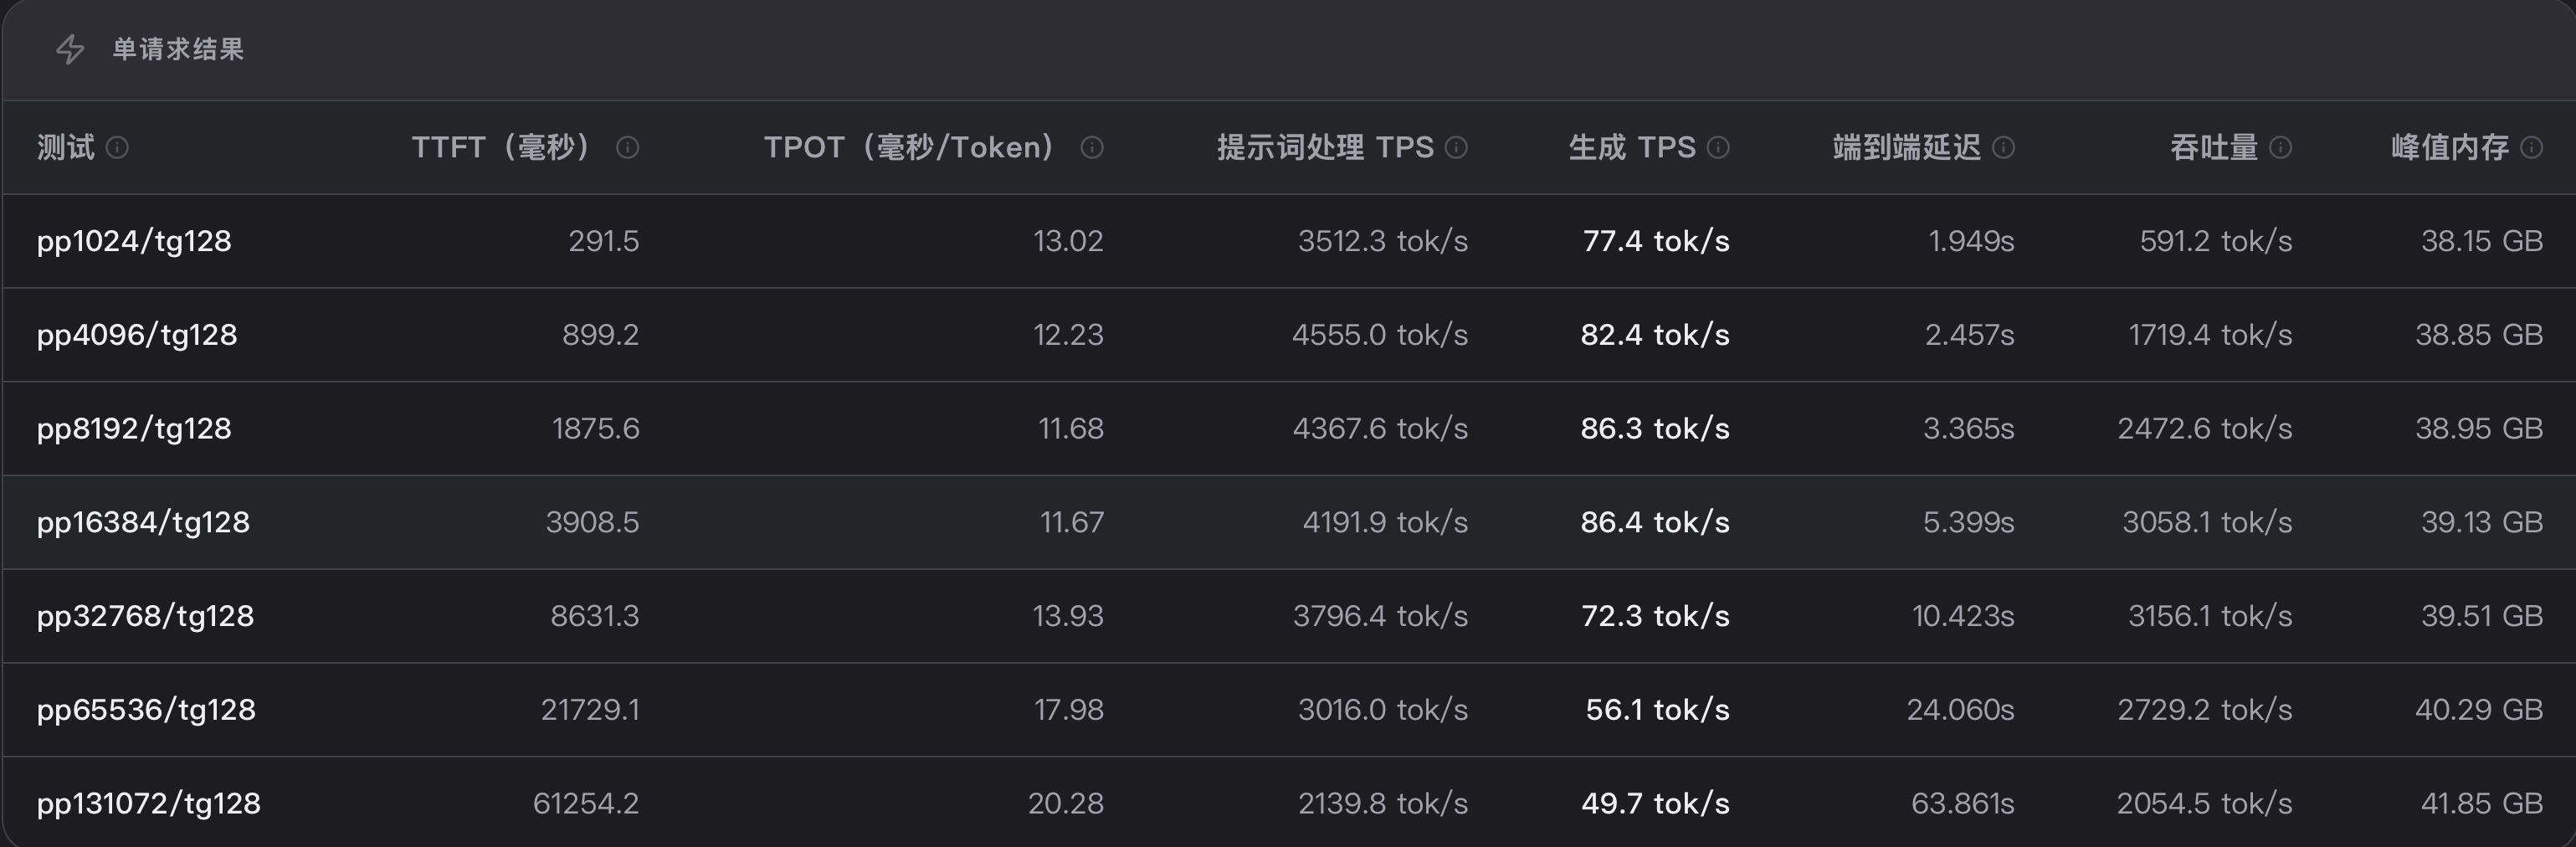
      接着测试 oMLX with Qwen3.8-35B-A3B-Distill-oQ8-fp16-mtp(38.6G)

      
      Screenshot 2026-09-25 at 11.39.24.jpeg
      A3B模型性能更好了,缺点是因为Q8占内存更高,上下文128K以上就压力太大了。

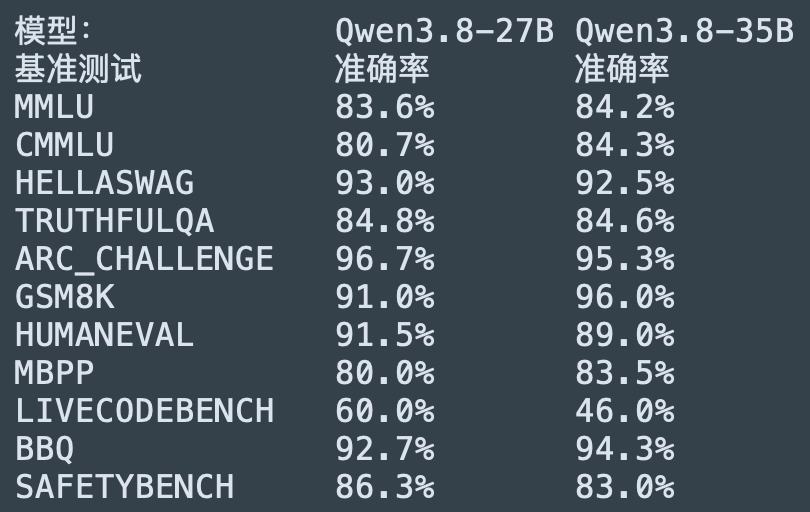
      智力测试与27B(Q4)对比:

      Screenshot 2026-09-25 at 12.53.54.png

      除了LIVECODEBENCH 低了不少,其余测试似乎和4Bit 27B不相上下

      1 条回复 最后回复
      0
      • Tony WangT
        Tony WangT
        Tony Wang
        超级版主
        编写于 最后由 编辑
        #21

        A3B 干活不太行, 很容易陷入死循环的思考

        1 条回复 最后回复
        0
        • E eddie-hk

          @fsclsnow 謝謝師兄分享,小弟也是小白一名,之後可以直接抄功課了 🙏🏻

          F
          F
          fsclsnow
          编写于 最后由 编辑
          #22

          @eddie-hk 互相学习!互相学习!😊

          1 条回复 最后回复
          0
          • F
            F
            fsclsnow
            编写于 最后由 fsclsnow 编辑
            #23

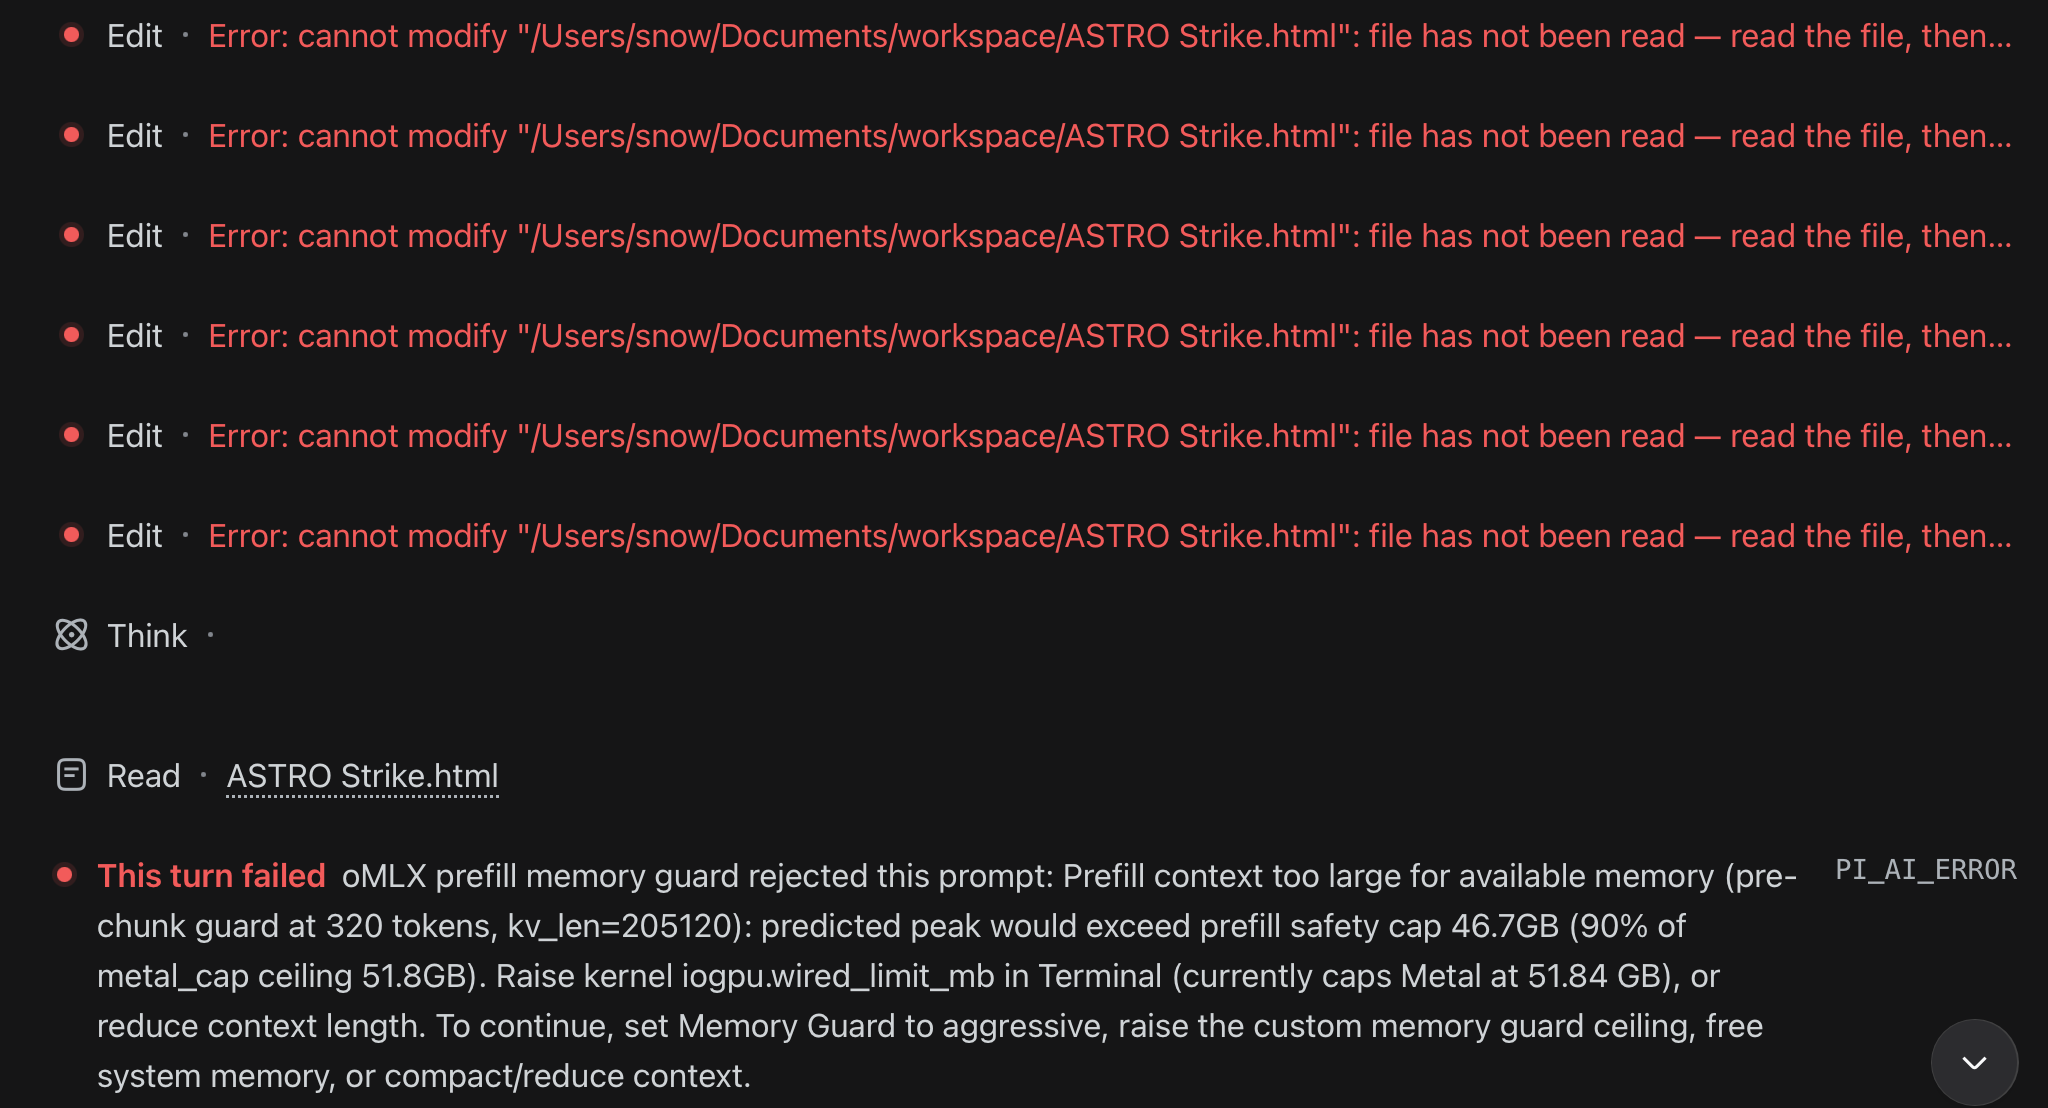
            半实战测试,让Qwen3.8-27B 写了个射击小游戏;反复修一些小bug;调整关卡难度,物品掉落折腾了半天。期间大部分由hermes调配完成。不知道是不是DSH对非自家模型适配的调配机制问题。给了他几个请求发一起,他一通思考然后就爆上下文罢工了。期间还报错在自己workspace内的文件他自己无法修改,最后爆掉了。
            Screenshot 2026-09-25 at 16.22.37.png

            还请DSH大神指导。

            然后我让Hermes去查,就是可以修改的,没问题。是DSH打开文件,又开了个复件自己修改自己被拒。。。我也是没想明白DSH怎么把自己绕进去的。

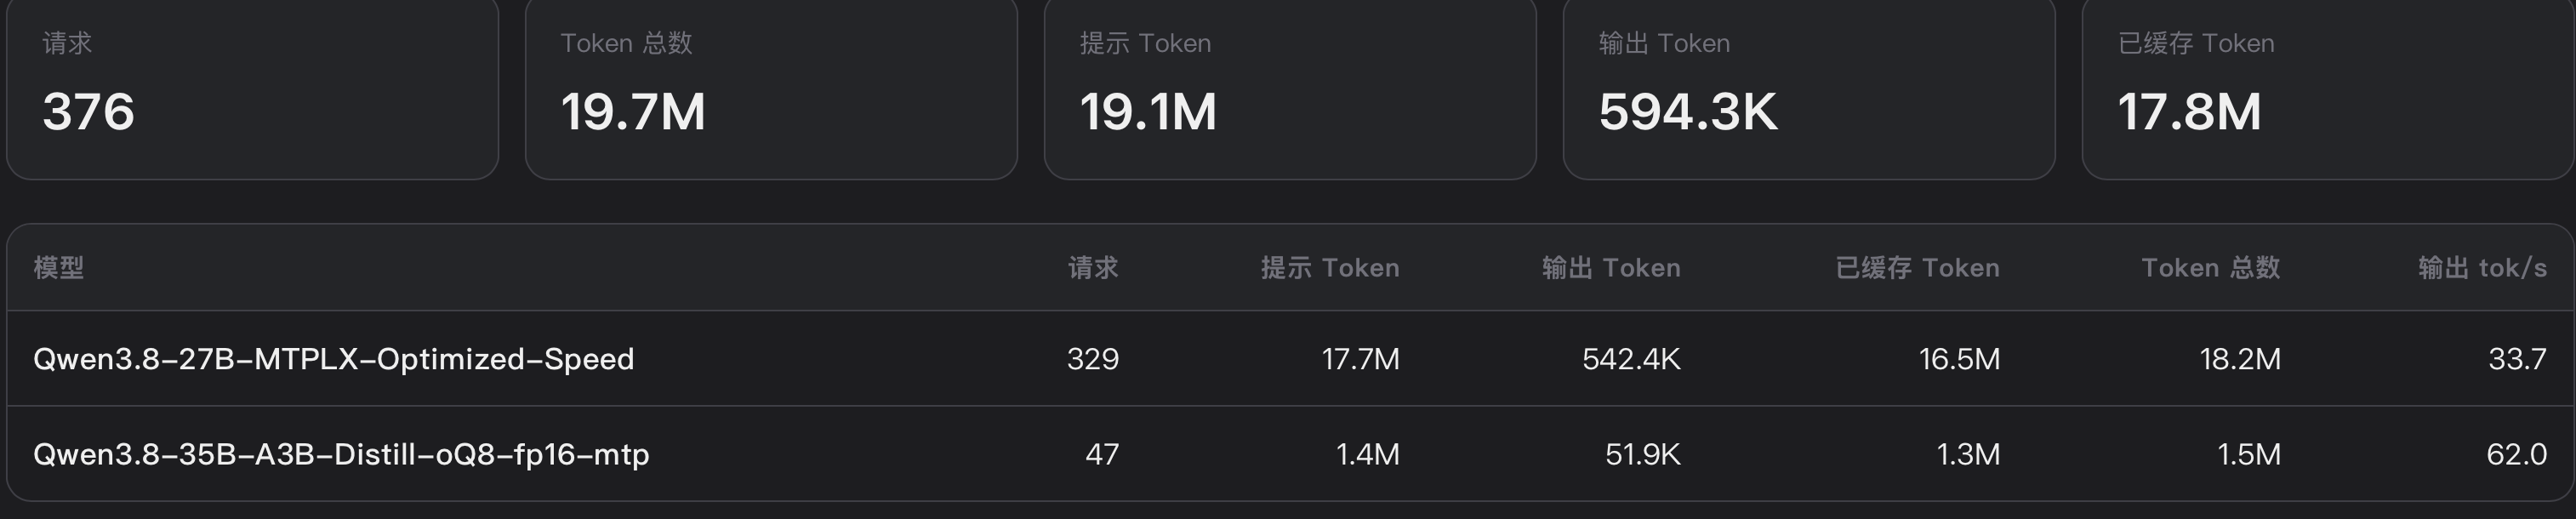
            然后就让Hermes持续开发完善了小半天。长上下文持续工作下,输出就降到了33 Tok/s。
            今天让35B-A3B开发了第四关,很顺利的一把完成。没遇上什么问题。因为上下文压力也比较小,输出在62 Tok/s
            也算模拟小规模实际开发时,2个模型大概的能力展示。27B稠密模型这个速度也还算是可以接受,就是心理预期知道,实际能力很难维持50 Tok/s左右的。
            Screenshot 2026-09-25 at 16.28.19.png

            1 条回复 最后回复
            0
            • F
              F
              fsclsnow
              编写于 最后由 编辑
              #24

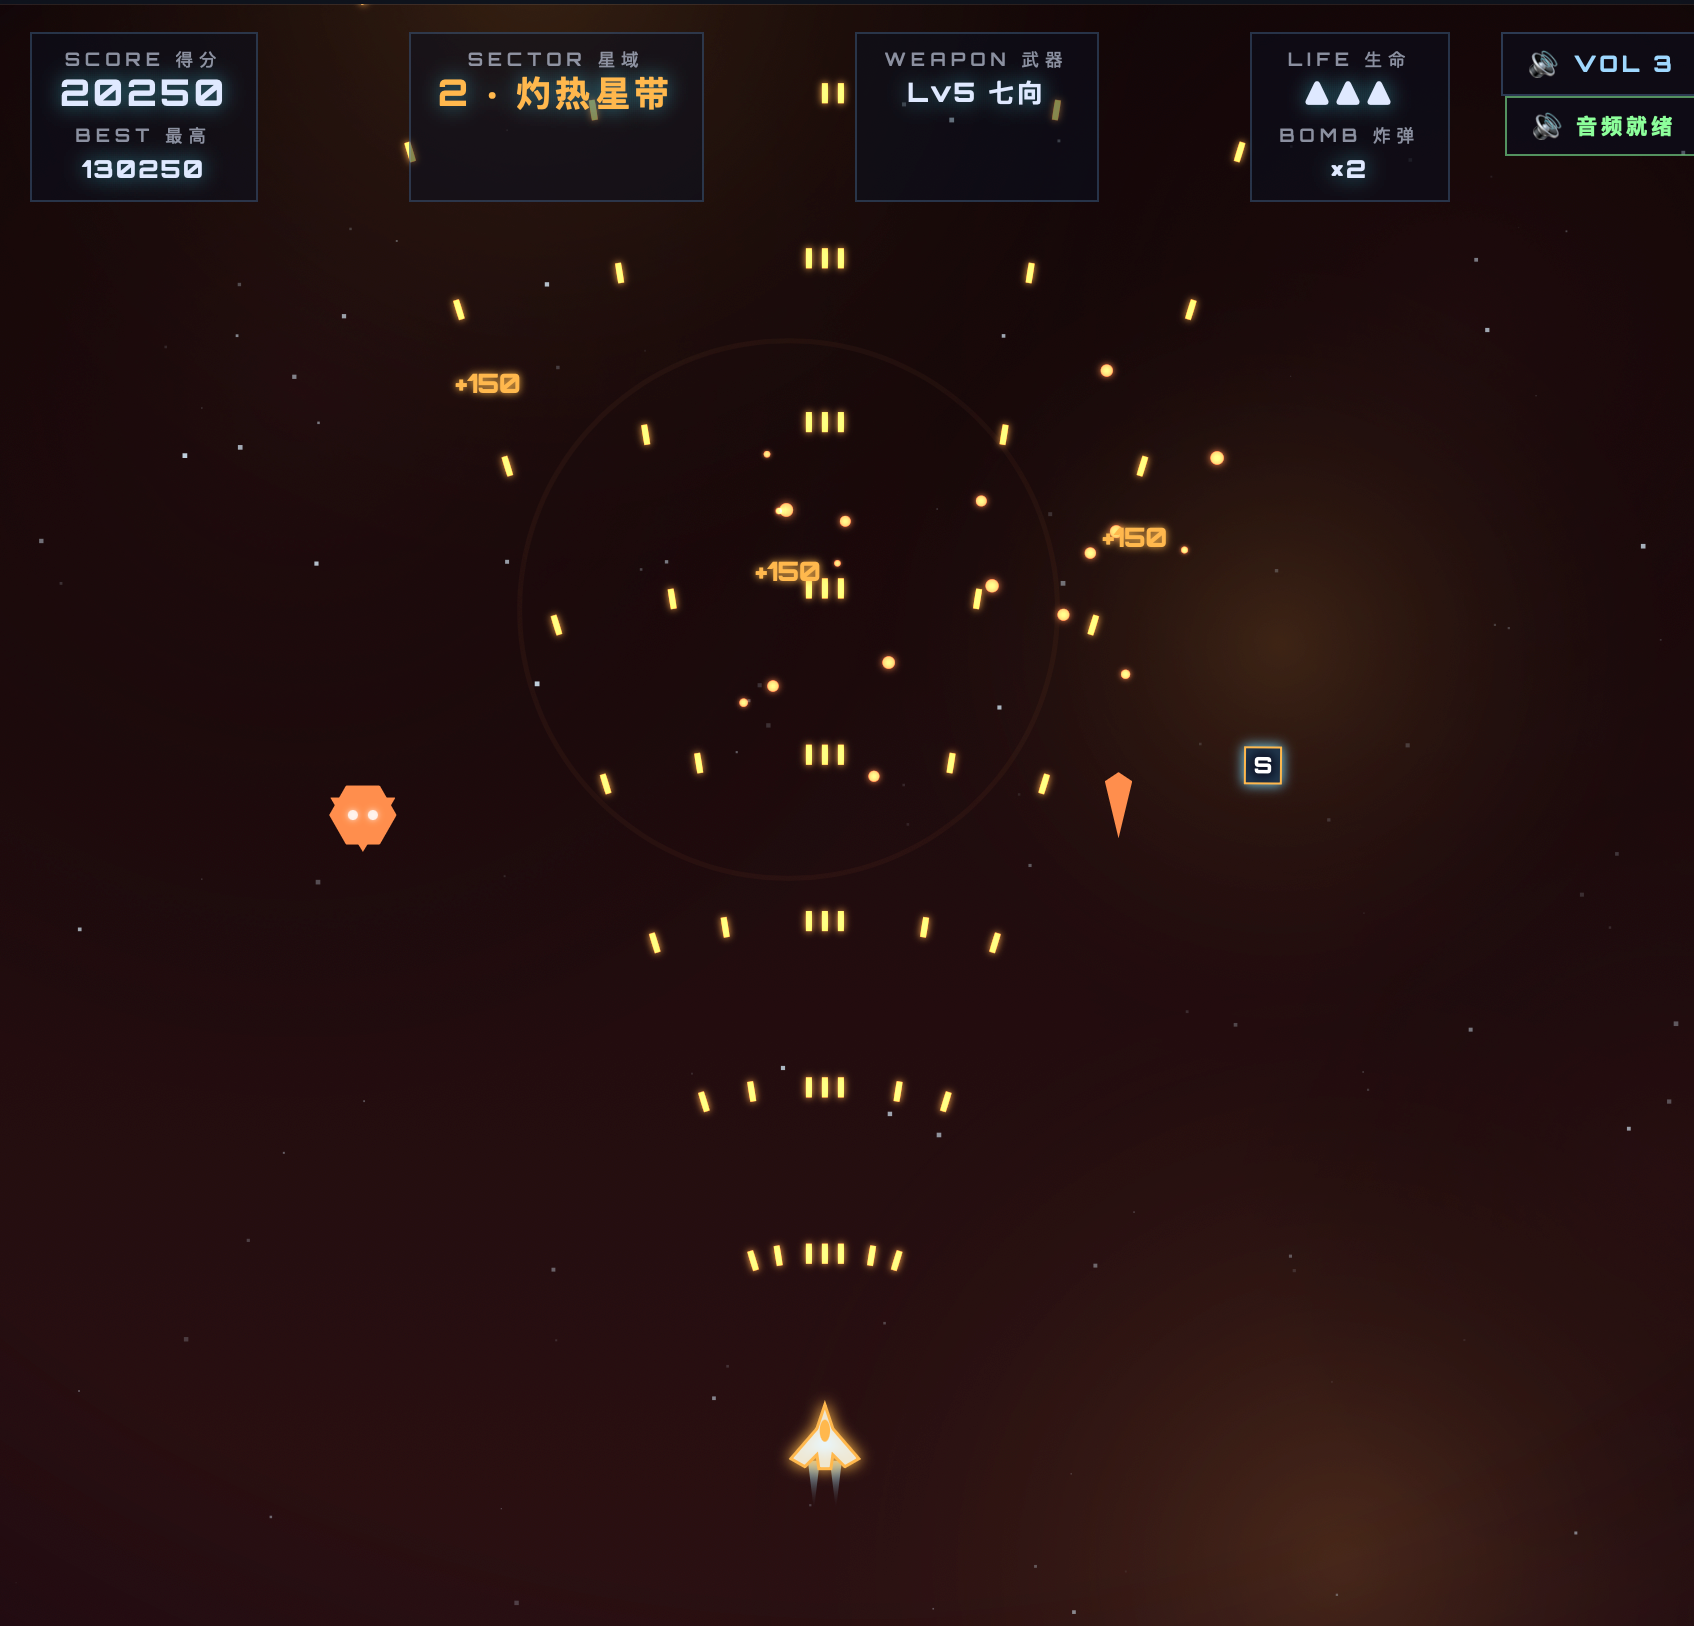
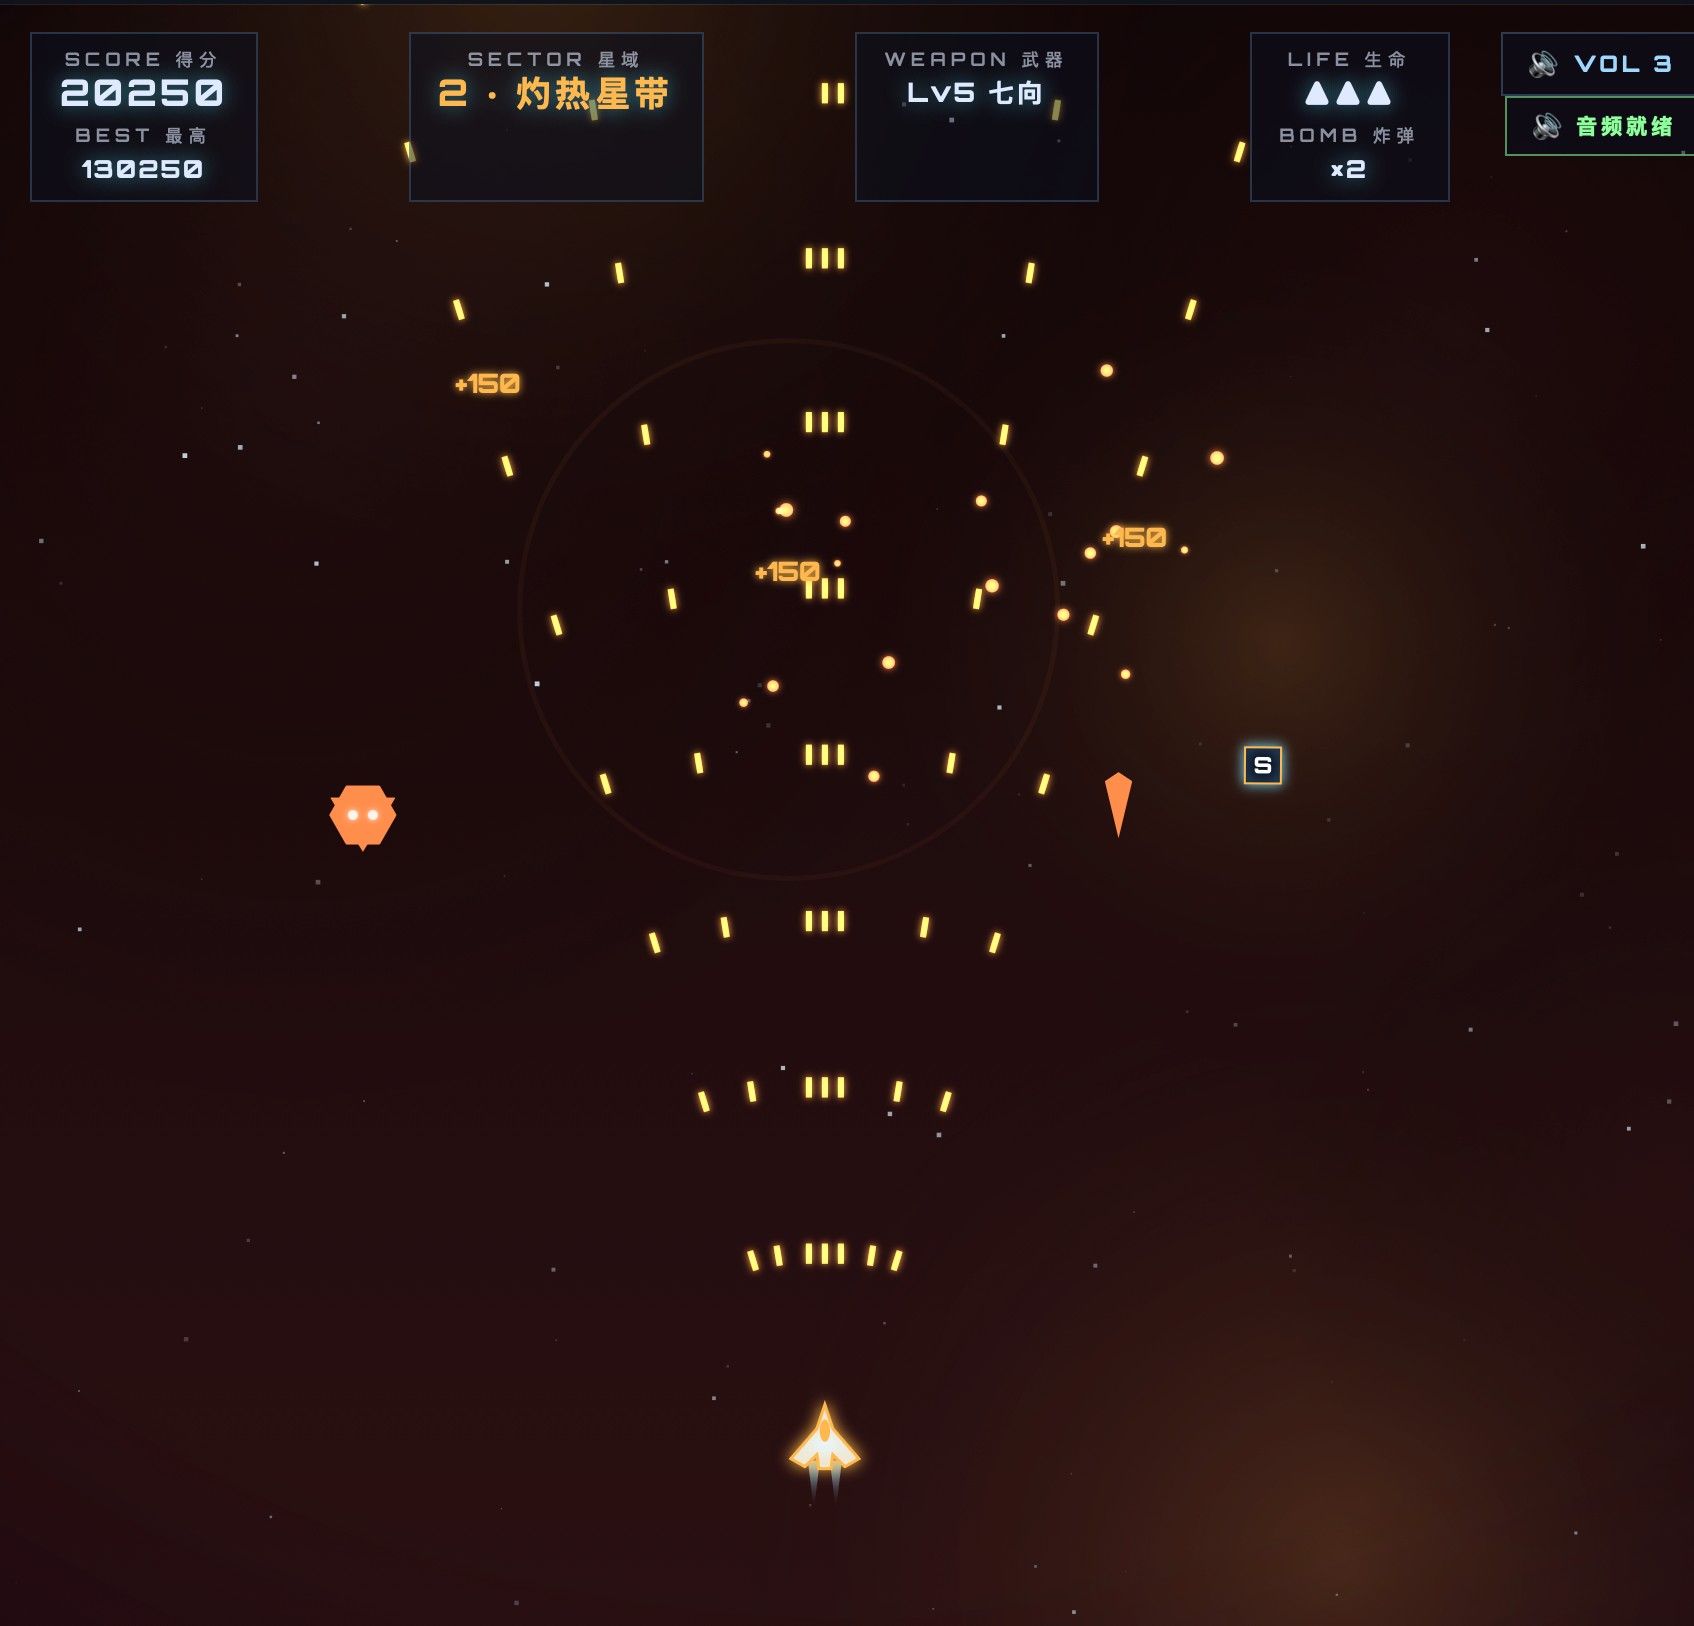
              最后展示下最终成品效果,图一乐。

              Screenshot 2026-09-25 at 16.44.47.png

              ASTRO Strike.html.zip

              01 ltzc0 1 条回复 最后回复
              1
              • 01 ltzc0
                01 ltzc0
                01 ltzc
                编写于 最后由 编辑
                #25

                Mac M2 Max测试本地模型Qwen3.8-27B-4bit、Qwen3.8-27B-Uncensored-oQ4e-mtp模型在 oMLX(Mac M2 Max 环境) 下的横向深度对比:oMLX - LLM inference, optimized for your Mac

                https://github.com/jundot/omlx

                Benchmark Model: Qwen3.8-27B-4bit

                Engine: Auto

                Context: 代码(Python)

                ================================================================================

                Single Request Results


                Test TTFT(ms) TPOT(ms) pp TPS tg TPS E2E(s) Throughput Peak Mem

                pp1024/tg128 9048.7 50.86 113.2 tok/s 19.8 tok/s 15.531 74.2 tok/s 15.85 GB

                pp4096/tg128 34039.8 52.03 120.3 tok/s 19.4 tok/s 40.670 103.9 tok/s 17.10 GB

                Continuous Batching

                预处理1024 / 生成128


                Batch tg TPS Speedup pp TPS pp TPS/req TTFT(ms) E2E(s)

                1x 19.8 tok/s 1.00x 113.2 tok/s 113.2 tok/s 9048.7 15.531

                2x 33.6 tok/s 1.70x 90.6 tok/s 45.3 tok/s 17273.3 30.233

                4x 62.8 tok/s 3.17x 78.3 tok/s 19.6 tok/s 31000.7 60.467
                oMLX - LLM inference, optimized for your Mac
                https://github.com/jundot/omlx
                Benchmark Model: Qwen3.8-27B-Uncensored-oQ4e-mtp
                Engine: Auto
                Context: 代码(Python)

                Single Request Results

                Test TTFT(ms) TPOT(ms) pp TPS tg TPS E2E(s) Throughput Peak Mem
                pp1024/tg128 8955.1 50.04 114.3 tok/s 20.1 tok/s 15.330 75.1 tok/s 22.34 GB
                pp4096/tg128 33851.1 57.56 121.0 tok/s 17.5 tok/s 41.180 102.6 tok/s 23.70 GB

                Continuous Batching
                预处理1024 / 生成128

                Batch tg TPS Speedup pp TPS pp TPS/req TTFT(ms) E2E(s)
                1x 20.1 tok/s 1.00x 114.3 tok/s 114.3 tok/s 8955.1 15.330
                2x 28.8 tok/s 1.43x 91.5 tok/s 45.8 tok/s 16951.1 31.272
                4x 47.3 tok/s 2.35x 81.3 tok/s 20.3 tok/s 30249.7 61.207
                数据深度分析如下:一、 关键指标对比(oQ4e-mtp vs. 常规 4bit)指标常规 4bit 模型oQ4e-mtp 模型变化分析内存峰值 (Peak Mem)15.85 - 17.10 GB22.34 - 23.70 GB大增约 6.5 GB (+38%),接近纯 6-bit 的开销单生成速度 (tg TPS)19.8 tok/s20.1 tok/s (pp1024)17.5 tok/s (pp4096)基础生成速度相当,但在长上下文下略有所衰减Prefill 吞吐量 (pp TPS)113.2 ~ 120.3 tok/s114.3 ~ 121.0 tok/s首字响应(TTFT)性能几乎完全一致Continuous Batching (4x)62.8 tok/s (3.17x)47.3 tok/s (2.35x)并发性能明显下降 (-25%)二、 性能与技术细节拆解为什么内存增加到了 22.34 - 23.70 GB?oQ4e 混合精度量化:它不是普通的均匀 4-bit 量化,而是通过 importance-matrix(重要性矩阵 calibration)对关键层/注意力层提高了精度(提升至 5-bit 或 fp16),因此实际权重体积接近 6-bit 量化。 MTP (Multi-Token Prediction / 投机/多Token预测模块):附加了 MTP 预测头,这需要额外的显存空间用于加载加速权重和维持额外的 KV Cache。 为什么单生成速度没有大幅提升?MTP 本质是通过 Speculative Decoding(投机采样)以计算换速度。但在 M2 Max(显存带宽约 300-400 GB/s) 这种带宽受限设备上,当权重增长到 22GB+ 时,内存带宽瓶颈冲淡了 MTP 带来的并行收益。长上下文(pp4096)下生成速度降至 17.5 tok/s,也是因为更高的显存占用导致 Cache 访问开销变大。为什么多并发 (Continuous Batching) 性能下降严重?从 4x 批处理来看,常规 4bit 可以达到 62.8 tok/s,而本模型降到了 47.3 tok/s。这是由于 MTP 模块和更高权重的模型在多 Request 并发时抢占显存带宽与 GPU 计算单元更剧烈,造成 Batching 的并行加速效率下降。

                1 条回复 最后回复
                0
                • F fsclsnow

                  最后展示下最终成品效果,图一乐。

                  Screenshot 2026-09-25 at 16.44.47.png

                  ASTRO Strike.html.zip

                  01 ltzc0
                  01 ltzc0
                  01 ltzc
                  编写于 最后由 编辑
                  #26

                  @fsclsnow 提示词发个
                  image.jpeg

                  F 1 条回复 最后回复
                  0
                  • 01 ltzc0 01 ltzc

                    @fsclsnow 提示词发个
                    image.jpeg

                    F
                    F
                    fsclsnow
                    编写于 最后由 编辑
                    #27

                    @01-ltzc 很简单的提示词:
                    “制作一个有数个关卡的飞机射击游戏。画面精致好看,操作流畅,细节清楚”

                    01 ltzc0 1 条回复 最后回复
                    0
                    • F fsclsnow

                      @01-ltzc 很简单的提示词:
                      “制作一个有数个关卡的飞机射击游戏。画面精致好看,操作流畅,细节清楚”

                      01 ltzc0
                      01 ltzc0
                      01 ltzc
                      编写于 最后由 编辑
                      #28

                      @fsclsnow 11111多谢啦

                      1 条回复 最后回复
                      0
                      • XiaoteX
                        XiaoteX
                        Xiaote
                        编写于 最后由 编辑
                        #29

                        🔥 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!

                        奖励凭证:热议 +3 分 · 编号 h1816-412-1(系统自动发放,显示稍有延迟)

                        老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~直接私信我会被封号~

                        1 条回复 最后回复
                        0

                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                        有了你的建议,这篇帖子会更精彩哦 💗

                        注册 登录
                        回复
                        • 在新帖中回复
                        登录后回复
                        • 从旧到新
                        • 从新到旧
                        • 最多赞同


                        • 登录

                        • 登录或注册以进行搜索。
                        • 第一个帖子
                          最后一个帖子
                        0
                        • 版块
                        • 最新
                        • 标签
                        • 热门
                        • 用户
                        • 群组