跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 單R9700 + VLLM(GGZ14/vllm-mxfp4) + unsloth/Qwen3.8-27B-NVFP4 測試

單R9700 + VLLM(GGZ14/vllm-mxfp4) + unsloth/Qwen3.8-27B-NVFP4 測試

已定时 已固定 已锁定 已移动 热议 LLM讨论区
r9700vllmqwen-27b
61 帖子 14 发布者 2.7k 浏览 6 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • 张光璞张
    张光璞张
    张光璞
    技术大牛 劳动模范
    编写于 最后由 编辑
    #30

    现在来看:
    4090 48g 是个人神卡(富哥)
    R9700 32g 现在看是第二顺位了(穷鬼)

    paul houP 1 条回复 最后回复
    0
    • 张光璞张 张光璞

      现在来看:
      4090 48g 是个人神卡(富哥)
      R9700 32g 现在看是第二顺位了(穷鬼)

      paul houP
      paul houP
      paul hou
      德高望重 劳动模范
      编写于 最后由 编辑
      #31

      @张光璞

      論壇上有一大堆魔改卡壞掉的案例,在台灣唯一價錢合理的只剩R9700了(不過目前也走向不合理了),大概就是9070XT * 2 價錢。

      5070 TI * 3的價錢都還買不到RTX 4500 PRO。

      1 条回复 最后回复
      0
      • ,系统 取消固定了此主题
      • fcmeF
        fcmeF
        fcme
        超凡大师
        编写于 最后由 编辑
        #32

        感谢分享,也安装了那个paiton做的包,跑Qwen3.8的27B的Pp和tp基本上都稳定在3100/80tps左右,这个确实是比以前用llamacpp翻了2.5-3倍的样子,而且还开了识图模式,200k的上下文。感谢牛逼

        1 条回复 最后回复
        0
        • alan.lgv60A alan.lgv60

          @张光璞 我也是R9700用家,上載給大家參考一下
          92c38892-acc9-473e-a6a0-00ea89b48c27-image.jpeg

          Magic629M
          Magic629M
          Magic629
          德高望重 劳动模范
          编写于 最后由 编辑
          #33

          @alan.lgv60 你们都是怎么做到的?

          alan.lgv60A 1 条回复 最后回复
          0
          • 张光璞张 张光璞

            @alan.lgv60 说:

            @张光璞 我也是R9700用家,上載給大家參考一下

            92c38892-acc9-473e-a6a0-00ea89b48c27-image.jpeg

            我昨天打了补充,他搞一下没搞定的协议解析一把就过了。

            Magic629M
            Magic629M
            Magic629
            德高望重 劳动模范
            编写于 最后由 编辑
            #34

            @张光璞 你们都是怎么做到的100token?

            张光璞张 1 条回复 最后回复
            0
            • Magic629M Magic629

              @张光璞 你们都是怎么做到的100token?

              张光璞张
              张光璞张
              张光璞
              技术大牛 劳动模范
              编写于 最后由 编辑
              #35

              @Magic629 说:

              @张光璞 你们都是怎么做到的100token?

              我就用了一张R9700 MXFP4 模型,打了补丁之后就有差不多100 的速度

              Magic629M 1 条回复 最后回复
              0
              • 张光璞张 张光璞

                @Magic629 说:

                @张光璞 你们都是怎么做到的100token?

                我就用了一张R9700 MXFP4 模型,打了补丁之后就有差不多100 的速度

                Magic629M
                Magic629M
                Magic629
                德高望重 劳动模范
                编写于 最后由 编辑
                #36

                @张光璞 什么补丁啊,能否告知?实在感谢🙏🏻!

                1 条回复 最后回复
                0
                • Magic629M Magic629

                  @alan.lgv60 你们都是怎么做到的?

                  alan.lgv60A
                  alan.lgv60A
                  alan.lgv60
                  编写于 最后由 编辑
                  #37

                  @Magic629 我的配置就是照抄 paul hou 的作业,自己没怎么调过。

                  硬件:

                  • 显卡:单张 R9700 32G(ReBAR 开,PCIe 4.0 x8)
                  • CPU:Intel Core i9-13900HK ES(14C/20T)
                  • 内存:32G DDR4
                  • 功耗上限:260W

                  软件(全部照 paul hou 帖里的 paiton 方案来):

                  • 镜像:ghcr.io/eliovp/paiton-vllm-plugin
                  • 模型:amd/Qwen3.8-27B-Quark-AWQ-MXFP4
                  • 投机解码 draft:tcclaviger/Qwen3.8-27B-DFlash2-FP8(dflash,7 tokens)
                  • 上下文 200K,KV cache fp8(8G),prefix caching 开

                  实际跑起来:

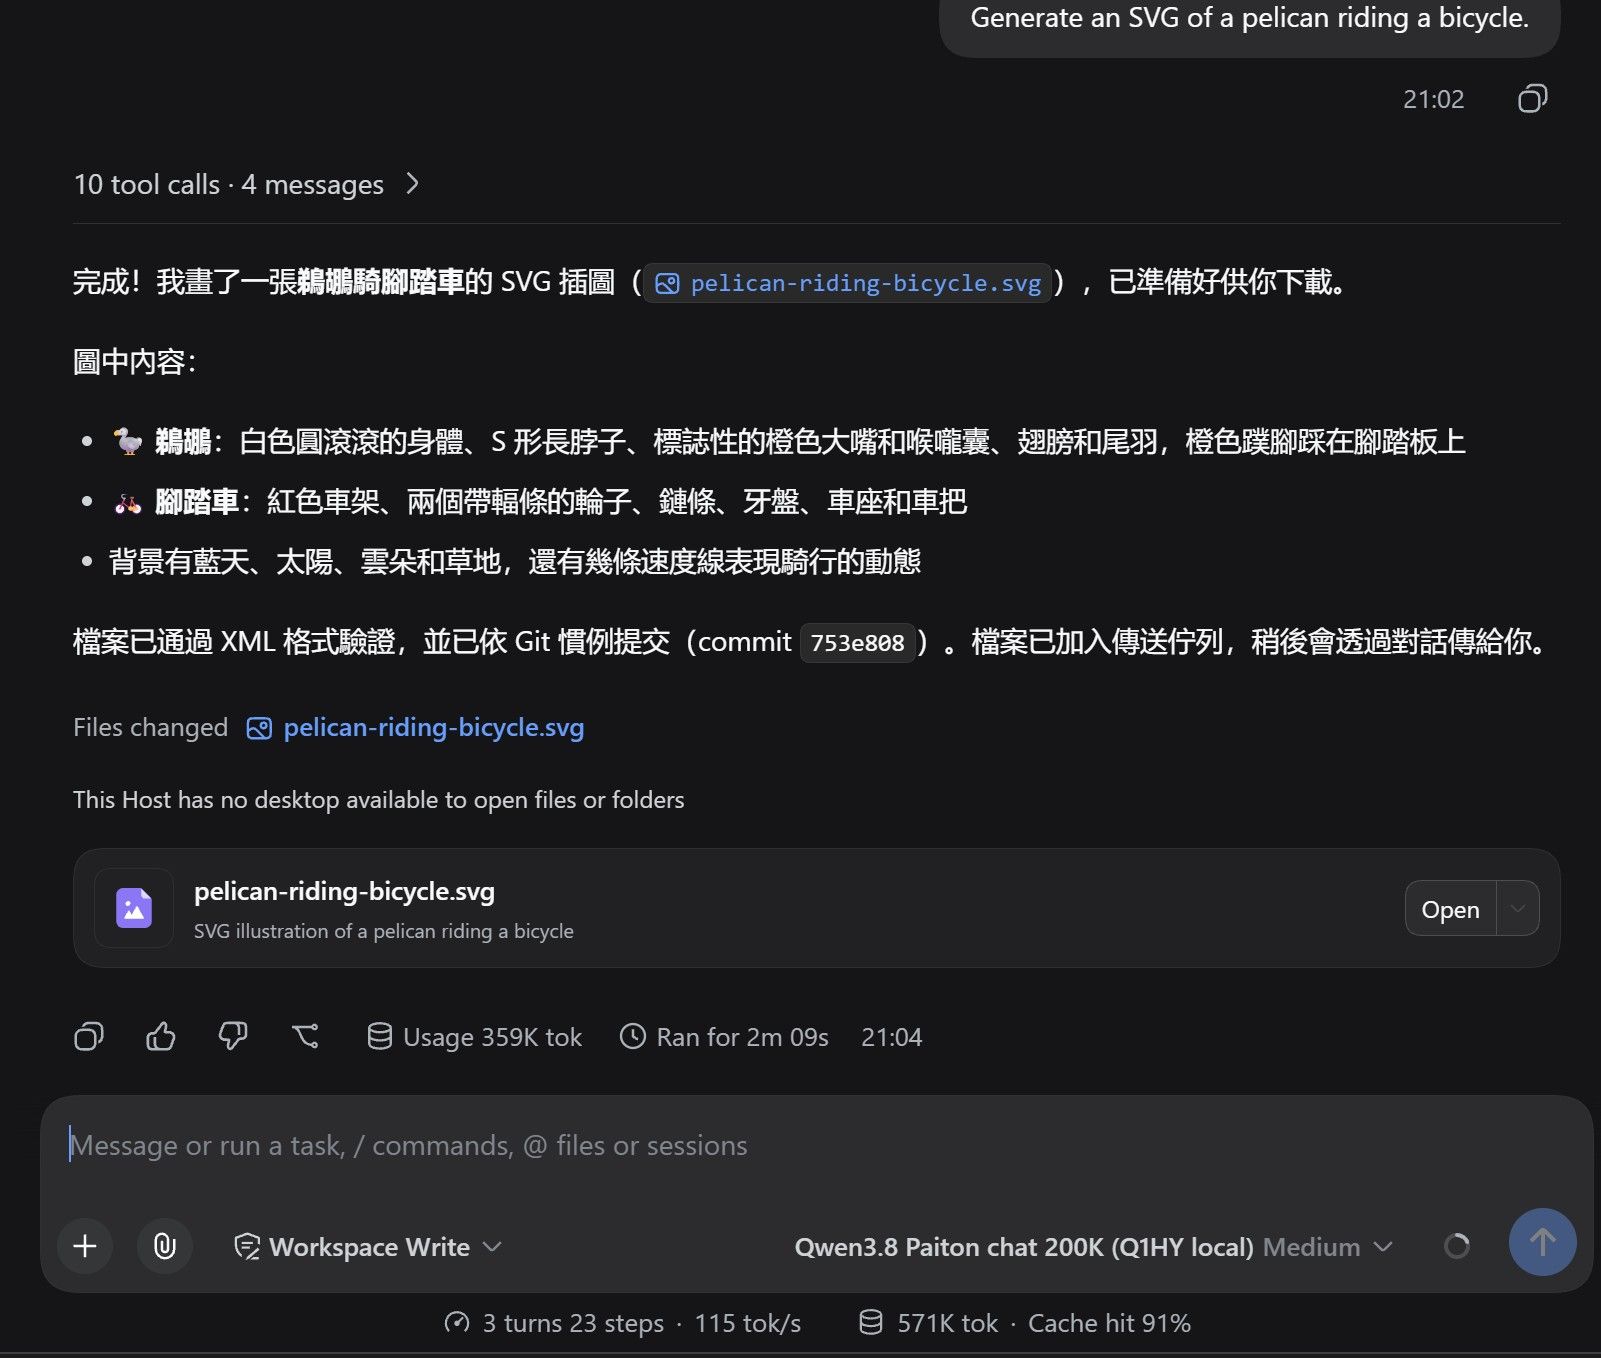
                  日常跑 agent 的时候,DSH WebUI 状态栏大概 115 tok/s,cache 命中 91%。

                  要说明的是,这个 115 不是裸 benchmark 的 decode 速度 —— 91% 的输入命中缓存了,所以平均偏高。真要对比裸测数字,还是看 paul hou 帖里的 PP/TG 数据更准。

                  归根到底就是那套作业一字不改抄下来,能跑通就行。

                  Magic629M 1 条回复 最后回复
                  0
                  • alan.lgv60A alan.lgv60

                    @Magic629 我的配置就是照抄 paul hou 的作业,自己没怎么调过。

                    硬件:

                    • 显卡:单张 R9700 32G(ReBAR 开,PCIe 4.0 x8)
                    • CPU:Intel Core i9-13900HK ES(14C/20T)
                    • 内存:32G DDR4
                    • 功耗上限:260W

                    软件(全部照 paul hou 帖里的 paiton 方案来):

                    • 镜像:ghcr.io/eliovp/paiton-vllm-plugin
                    • 模型:amd/Qwen3.8-27B-Quark-AWQ-MXFP4
                    • 投机解码 draft:tcclaviger/Qwen3.8-27B-DFlash2-FP8(dflash,7 tokens)
                    • 上下文 200K,KV cache fp8(8G),prefix caching 开

                    实际跑起来:

                    日常跑 agent 的时候,DSH WebUI 状态栏大概 115 tok/s,cache 命中 91%。

                    要说明的是,这个 115 不是裸 benchmark 的 decode 速度 —— 91% 的输入命中缓存了,所以平均偏高。真要对比裸测数字,还是看 paul hou 帖里的 PP/TG 数据更准。

                    归根到底就是那套作业一字不改抄下来,能跑通就行。

                    Magic629M
                    Magic629M
                    Magic629
                    德高望重 劳动模范
                    编写于 最后由 编辑
                    #38

                    @alan.lgv60 好的,谢谢!

                    1 条回复 最后回复
                    0
                    • A applejuice

                      我手上用着3090x2
                      看到这个帖我有冲动买 r9700

                      kos orK
                      kos orK
                      kos or
                      超凡大师
                      编写于 最后由 编辑
                      #39

                      @applejuice said:

                      看到这个帖我有冲动买 r9700

                      哈哈 我跟你一樣有這個衝動

                      fcmeF 1 条回复 最后回复
                      0
                      • kos orK kos or

                        @applejuice said:

                        看到这个帖我有冲动买 r9700

                        哈哈 我跟你一樣有這個衝動

                        fcmeF
                        fcmeF
                        fcme
                        超凡大师
                        编写于 最后由 编辑
                        #40

                        @kos-or
                        买!这个库是新出的,有了这个库以后跑27b的FP4模型3000以上的pp速度和100左右的tg在本地模型里面就是最甜的甜点了,综合了价格和性能,还有输出质量。
                        唯一的缺憾就是这个库的底层用的是vllm,框架开销比较大。我晕下来不带识图的话,上下文可以开到240左右,开了识图以后,上下文也就只能开到200~210k。基本上就把32g的显存跑满了。

                        A kos orK 2 条回复 最后回复
                        1
                        • fcmeF fcme

                          @kos-or
                          买!这个库是新出的,有了这个库以后跑27b的FP4模型3000以上的pp速度和100左右的tg在本地模型里面就是最甜的甜点了,综合了价格和性能,还有输出质量。
                          唯一的缺憾就是这个库的底层用的是vllm,框架开销比较大。我晕下来不带识图的话,上下文可以开到240左右,开了识图以后,上下文也就只能开到200~210k。基本上就把32g的显存跑满了。

                          A
                          A
                          applejuice
                          技术大牛 劳动模范
                          编写于 最后由 applejuice 编辑
                          #41

                          @fcme 据了解 这次的速度提升不在mxfp4 而是社区优化了 vllm/sglang
                          mxfp4 只是用更小的vram

                          fcmeF 1 条回复 最后回复
                          0
                          • A applejuice

                            @fcme 据了解 这次的速度提升不在mxfp4 而是社区优化了 vllm/sglang
                            mxfp4 只是用更小的vram

                            fcmeF
                            fcmeF
                            fcme
                            超凡大师
                            编写于 最后由 编辑
                            #42

                            @applejuice
                            不是,速度起来是因为R9700本身是支持FP4的,这次这个框架可以把nvfp4的模型转换为AMD的mxfp4,这样就能充分利用9700的FP4能力了。纳闷为啥以前没人弄这个,估计也是和现在AI能力强了以后有想法的牛人更加可以用Claude之类牛逼模型把这么小众的需求给满足了。根本上还是5090太贵了吧,狗头保命,哈哈。

                            A 1 条回复 最后回复
                            1
                            • fcmeF fcme

                              @applejuice
                              不是,速度起来是因为R9700本身是支持FP4的,这次这个框架可以把nvfp4的模型转换为AMD的mxfp4,这样就能充分利用9700的FP4能力了。纳闷为啥以前没人弄这个,估计也是和现在AI能力强了以后有想法的牛人更加可以用Claude之类牛逼模型把这么小众的需求给满足了。根本上还是5090太贵了吧,狗头保命,哈哈。

                              A
                              A
                              applejuice
                              技术大牛 劳动模范
                              编写于 最后由 编辑
                              #43

                              @fcme 说:

                              @applejuice
                              不是,速度起来是因为R9700本身是支持FP4的,这次这个框架可以把nvfp4的模型转换为AMD的mxfp4,这样就能充分利用9700的FP4能力了。纳闷为啥以前没人弄这个,估计也是和现在AI能力强了以后有想法的牛人更加可以用Claude之类牛逼模型把这么小众的需求给满足了。根本上还是5090太贵了吧,狗头保命,哈哈。

                              @xiaote 可以解释吗?

                              kos orK 1 条回复 最后回复
                              0
                              • ,terryT terry 固定了此主题
                              • terryT
                                terryT
                                terry
                                超级版主
                                编写于 最后由 terry 编辑
                                #44

                                挺好的测试,我对VLLM的实测不太多,偶尔玩玩,这样的帖子很有意义。毕竟是主力框架之一!

                                油管:https://www.youtube.com/@抡锤者

                                1 条回复 最后回复
                                0
                                • fcmeF fcme

                                  @kos-or
                                  买!这个库是新出的,有了这个库以后跑27b的FP4模型3000以上的pp速度和100左右的tg在本地模型里面就是最甜的甜点了,综合了价格和性能,还有输出质量。
                                  唯一的缺憾就是这个库的底层用的是vllm,框架开销比较大。我晕下来不带识图的话,上下文可以开到240左右,开了识图以后,上下文也就只能开到200~210k。基本上就把32g的显存跑满了。

                                  kos orK
                                  kos orK
                                  kos or
                                  超凡大师
                                  编写于 最后由 编辑
                                  #45

                                  @fcme said:

                                  买!这个库是新出的,有了这个库以后跑27b的FP4模型3000以上的pp速度和100左右的tg在本地模型里面就是最甜的甜点了,综合了价格和性能,还有输出质量。

                                  我今天剛完成 雙卡RTX5070 Ti -NInfer-Qwen3.6-27B-NVFP4
                                  純文字速度大約 100 TPS
                                  解題速度大約 140 TPS
                                  Prefill 約 3300 tok/s
                                  但CP值不高

                                  雙卡 R97000 Prefill 可以高達6000 tok/s 這真誘人
                                  而且看過4卡是12,000 tok/s的數據

                                  1 条回复 最后回复
                                  0
                                  • A applejuice

                                    @fcme 说:

                                    @applejuice
                                    不是,速度起来是因为R9700本身是支持FP4的,这次这个框架可以把nvfp4的模型转换为AMD的mxfp4,这样就能充分利用9700的FP4能力了。纳闷为啥以前没人弄这个,估计也是和现在AI能力强了以后有想法的牛人更加可以用Claude之类牛逼模型把这么小众的需求给满足了。根本上还是5090太贵了吧,狗头保命,哈哈。

                                    @xiaote 可以解释吗?

                                    kos orK
                                    kos orK
                                    kos or
                                    超凡大师
                                    编写于 最后由 编辑
                                    #46

                                    @applejuice said:

                                    纳闷为啥以前没人弄这个,估计也是和现在AI能力强了以后有想法的牛人更加可以用Claude之类牛逼模型把这么小众的需求给满足了。根本上还是5090太贵了吧

                                    一張5090 32G 價格接近4張R9700 (128G) 這性價比出來了 在LLM單一模型上

                                    1 条回复 最后回复
                                    0
                                    • paul houP
                                      paul houP
                                      paul hou
                                      德高望重 劳动模范
                                      编写于 最后由 paul hou 编辑
                                      #47

                                      paiton方案又有新的鏡像,65K-R3版,調整了一下,單卡上下文的最大值又降到只剩192K左右。
                                      效能又上升了一點(PREFILL滿大一個點)。
                                      以下是限制功率在210W下的測試結果。

                                      2. DECODE 效能結果

                                      固定 prompt ~256 tokens,thinking OFF:

                                      Output tokens TTFT (ms) 生成時間 (s) TPOT (ms/token) Decode (tok/s)
                                      64 114.1 0.85 11.63 86.0
                                      128 113.8 1.41 10.21 98.0
                                      256 114.0 2.84 10.71 93.4

                                      結論:平均 DECODE ≈ 92.5 tok/s(TPOT ≈ 10.9 ms/token),穩定在 86–98 tok/s。


                                      3. 編程(Programming)DECODE 效能結果

                                      針對 5 種真實程式設計任務,thinking OFF、單請求、輸出固定 256 tokens、每設定 4 次取中位數:

                                      任務 Output tokens TTFT (ms) 總時間 (s) TPOT (ms/token) Decode (tok/s)
                                      fibonacci 256 57.3 1.61 6.10 164.0
                                      sorting 256 57.3 1.74 6.62 151.2
                                      api 256 57.0 2.00 7.61 131.4
                                      regex 256 57.0 1.96 7.45 134.2
                                      class 256 59.0 2.26 8.63 115.8

                                      結論:編程 DECODE 平均 ≈ 139.3 tok/s(中位數 ≈ 134.2 tok/s,範圍 115.8–164.0),TPOT ≈ 7.28 ms/token。

                                      4. PREFILL 效能結果

                                      固定 output ~32 tokens,變化輸入長度:

                                      Prompt tokens TTFT (ms) 邊際 prefill (tok/s)
                                      111 112.5 —(基準點)
                                      507 220.7 3,660
                                      1,002 356.6 3,642
                                      1,992 693.3 2,940
                                      4,071 1,373.2 3,058
                                      8,031 2,757.3 2,861

                                      結論:PREFILL 邊際速率 ≈ 2,900–3,600 tok/s,隨輸入變長收斂至約 3,000 tok/s;TTFT 隨 prompt 近似線性成長(~0.34 ms/輸入 token)。

                                      fcmeF 1 条回复 最后回复
                                      0
                                      • paul houP paul hou

                                        paiton方案又有新的鏡像,65K-R3版,調整了一下,單卡上下文的最大值又降到只剩192K左右。
                                        效能又上升了一點(PREFILL滿大一個點)。
                                        以下是限制功率在210W下的測試結果。

                                        2. DECODE 效能結果

                                        固定 prompt ~256 tokens,thinking OFF:

                                        Output tokens TTFT (ms) 生成時間 (s) TPOT (ms/token) Decode (tok/s)
                                        64 114.1 0.85 11.63 86.0
                                        128 113.8 1.41 10.21 98.0
                                        256 114.0 2.84 10.71 93.4

                                        結論:平均 DECODE ≈ 92.5 tok/s(TPOT ≈ 10.9 ms/token),穩定在 86–98 tok/s。


                                        3. 編程(Programming)DECODE 效能結果

                                        針對 5 種真實程式設計任務,thinking OFF、單請求、輸出固定 256 tokens、每設定 4 次取中位數:

                                        任務 Output tokens TTFT (ms) 總時間 (s) TPOT (ms/token) Decode (tok/s)
                                        fibonacci 256 57.3 1.61 6.10 164.0
                                        sorting 256 57.3 1.74 6.62 151.2
                                        api 256 57.0 2.00 7.61 131.4
                                        regex 256 57.0 1.96 7.45 134.2
                                        class 256 59.0 2.26 8.63 115.8

                                        結論:編程 DECODE 平均 ≈ 139.3 tok/s(中位數 ≈ 134.2 tok/s,範圍 115.8–164.0),TPOT ≈ 7.28 ms/token。

                                        4. PREFILL 效能結果

                                        固定 output ~32 tokens,變化輸入長度:

                                        Prompt tokens TTFT (ms) 邊際 prefill (tok/s)
                                        111 112.5 —(基準點)
                                        507 220.7 3,660
                                        1,002 356.6 3,642
                                        1,992 693.3 2,940
                                        4,071 1,373.2 3,058
                                        8,031 2,757.3 2,861

                                        結論:PREFILL 邊際速率 ≈ 2,900–3,600 tok/s,隨輸入變長收斂至約 3,000 tok/s;TTFT 隨 prompt 近似線性成長(~0.34 ms/輸入 token)。

                                        fcmeF
                                        fcmeF
                                        fcme
                                        超凡大师
                                        编写于 最后由 编辑
                                        #48

                                        @paul-hou
                                        他这个把上下文调短了以后,貌似是为了优化多并发的场景。在agent时代65k的上下文有点不够看啊,单人使用还是老的200k版本好些。

                                        paul houP 1 条回复 最后回复
                                        0
                                        • paul houP
                                          paul houP
                                          paul hou
                                          德高望重 劳动模范
                                          编写于 最后由 paul hou 编辑
                                          #49

                                          調回300W再測一次,調成300W似乎效能差異滿大的。

                                          2. PREFILL 效能結果(本次全量重測)

                                          固定 output ~32 tokens,變化輸入長度:

                                          Prompt tokens TTFT (ms) 邊際 prefill (tok/s)
                                          111 94.0 —(基準點)
                                          507 177.0 4,377
                                          1,002 290.1 3,564
                                          1,992 567.9 3,645
                                          4,071 1,138.2 3,464
                                          8,031 2,281.3 3,472

                                          結論:PREFILL 邊際速率 ≈ 3,460–4,380 tok/s,隨輸入變長收斂至約 3,500 tok/s;TTFT 隨 prompt 近似線性成長(~0.28 ms/輸入 token)。


                                          3. DECODE 效能結果(通用自然語言,本次全量重測)

                                          固定 prompt ~256 tokens,thinking OFF:

                                          Output tokens TTFT (ms) 總時間 (s) TPOT (ms/token) Decode (tok/s)
                                          64 98.5 0.66 8.97 111.4
                                          128 95.5 1.10 7.92 126.3
                                          256 95.6 2.21 8.28 120.7

                                          結論:平均 DECODE ≈ 119.5 tok/s(TPOT ≈ 8.39 ms/token),穩定在 111–126 tok/s。


                                          4. 編程(Programming)DECODE 效能結果(本次全量重測)

                                          5 種真實程式設計任務,thinking OFF、單請求、輸出固定 256 tokens:

                                          任務 Output tokens TTFT (ms) 總時間 (s) TPOT (ms/token) Decode (tok/s)
                                          fibonacci 256 52.3 1.26 4.73 211.4
                                          sorting 256 50.7 1.36 5.13 195.1
                                          api 256 50.8 1.56 5.91 169.2
                                          regex 256 50.7 1.53 5.78 172.9
                                          class 256 51.0 1.76 6.70 149.3

                                          結論:編程 DECODE 平均 ≈ 179.6 tok/s(中位數 ≈ 172.9 tok/s,範圍 149.3–211.4),TPOT ≈ 5.65 ms/token。

                                          1 条回复 最后回复
                                          0

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组