(1350 續篇)雙 5090 跑 Qwen3.8-27B BF16全尺寸模型:把 NCCL 和 MTP 做對,decode 從 48 翻倍到 90 t/s
-
先講結論:這是我 8/26 那篇《雙 5090 跑 Qwen3.8-27B BF16 140K 實測數據與優化心得》(tid 1350)的續篇。那篇的結語是「MTP、NCCL 兩個『理論上應該更快』的方向實測更慢,最後贏的是最樸素的 tensor split + q8_0 KV + 合身 ctx,decode ~48 t/s」。這一個月我把 NCCL 和 MTP 重新做了一遍,結論反轉了:把「NCCL 真正跑起來」這件事做對之後,MTP 的投機解碼收益終於蓋過跨卡同步成本,decode 從 ~48 t/s 拉到 ~90 t/s,約 1.9×。重點不是「我編了 NCCL」這麼簡單——1350 那篇已經實測過「編了 NCCL 沒更快」,真正的關鍵是 NCCL + GPU 間 P2P 同時到位,這才是當時缺的那一塊。下面把因果鏈和踩的坑寫清楚。
1. 硬體與軟體
項目 配置 GPU 2× RTX 5090 32GB(SM120 Blackwell) CPU Ryzen 9 9950X3D(16C/32T) 記憶體 60GB DDR5 系統 Ubuntu 24.04.4 LTS(Kernel 7.0.0-31-generic) 驅動 615.71.09(P2P 已開通,見 §4.1) 引擎 llama.cpp 自編 fork(build 10702, commit eaf937655, GGML_CUDA_NCCL=ON,連 shim NCCL 2.29.7)模型 Qwen3.8-27B-BF16(兩片 GGUF 共 54.6GB)+ mmproj-F16(928MB,啟用 Vision) Context 95,000(100K 實測 OOM,95K 安全,見 §4.3) KV q4_0 / q4_0(原 1350 用 q8_0,改 q4_0 省 VRAM 給 MTP,見 §4.4) Split tensor 0.5,0.5 MTP 開啟( --spec-draft-n-max 5 --spec-draft-n-min 5,接受率 ~48.5%,見 §3)用途 Hermes Agent 主腦,長期單 slot 真實對話流量,非固定短 prompt benchmark 2. 生產啟動參數
以下從運行中進程(PID 6343)的
/proc/<pid>/cmdline直接抓,不是我貼的範例:# 關鍵:shim NCCL 必須優先載入(/usr/lib 的 libnccl 在 Blackwell 會卡死,見 §4.1) export LD_LIBRARY_PATH="/path/to/llama-nccl/nccl-shim/lib${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}" llama-server \ -m Qwen3.8-27B-BF16-00001-of-00002.gguf \ --mmproj mmproj-F16.gguf \ --n-gpu-layers 99 \ --split-mode tensor --tensor-split 0.5,0.5 \ --ctx-size 95000 -fa on \ --batch-size 4096 --ubatch-size 4096 \ --cache-type-k q4_0 --cache-type-v q4_0 \ -np 1 --kv-unified \ --jinja \ --spec-type draft-mtp --spec-draft-n-max 5 --spec-draft-n-min 5 \ --metrics --no-webui重點說明:
--spec-type draft-mtp:Qwen3.8-27B 的 MTP draft 層(blk.64)內嵌在主 GGUF,不需要--model-draft另載一個 head。這是跟 Qwen3.8-Flash-Next 不同(那個要另外載 mtp-*.gguf)。--spec-draft-n-max 5:每輪最多猜 5 個 token。這模型的 draft head 接受率偏低(~48.5%),拉太深會被低接受率拖垮,5 是實測平衡點。-np 1 --kv-unified:單 slot 長 context。MTP 只在單併發下賺,多併發會反虧(跟 1350 結論一致)。LD_LIBRARY_PATH指 shim NCCL 是強制的:binary 用ldd確認連的是nccl-shim/lib/libnccl.so.2,不是/usr/lib的系統版(原因見 §4.1)。
3. 實測數據(生產 log 為準)
以下全部取自 llama-server 自己的
print_timing與/metrics,不是 client 端量測(client 端 burst 量測會偏高 ~30%,這坑 1350 就提過)。統計區間為本次啟動後真實 Agent 流量:# /metrics(整體累計) llamacpp:tokens_predicted_total 28499 llamacpp:tokens_predicted_seconds 314.384 → decode 平均 90.65 tok/s llamacpp:prompt_tokens_total 330713 (非 cached) llamacpp:prompt_seconds_total 113.879 → prefill 平均 2904 tok/s llamacpp:spec_decode_num_accepted_tokens_total 20187 llamacpp:spec_decode_num_draft_tokens_total 41603 → MTP 接受率 48.5% llamacpp:n_tokens_max 95231 → 單 task 最大 context llamacpp:requests_deferred 0逐 task 抽樣(每 task 一個 session turn,decode 取該 task 的
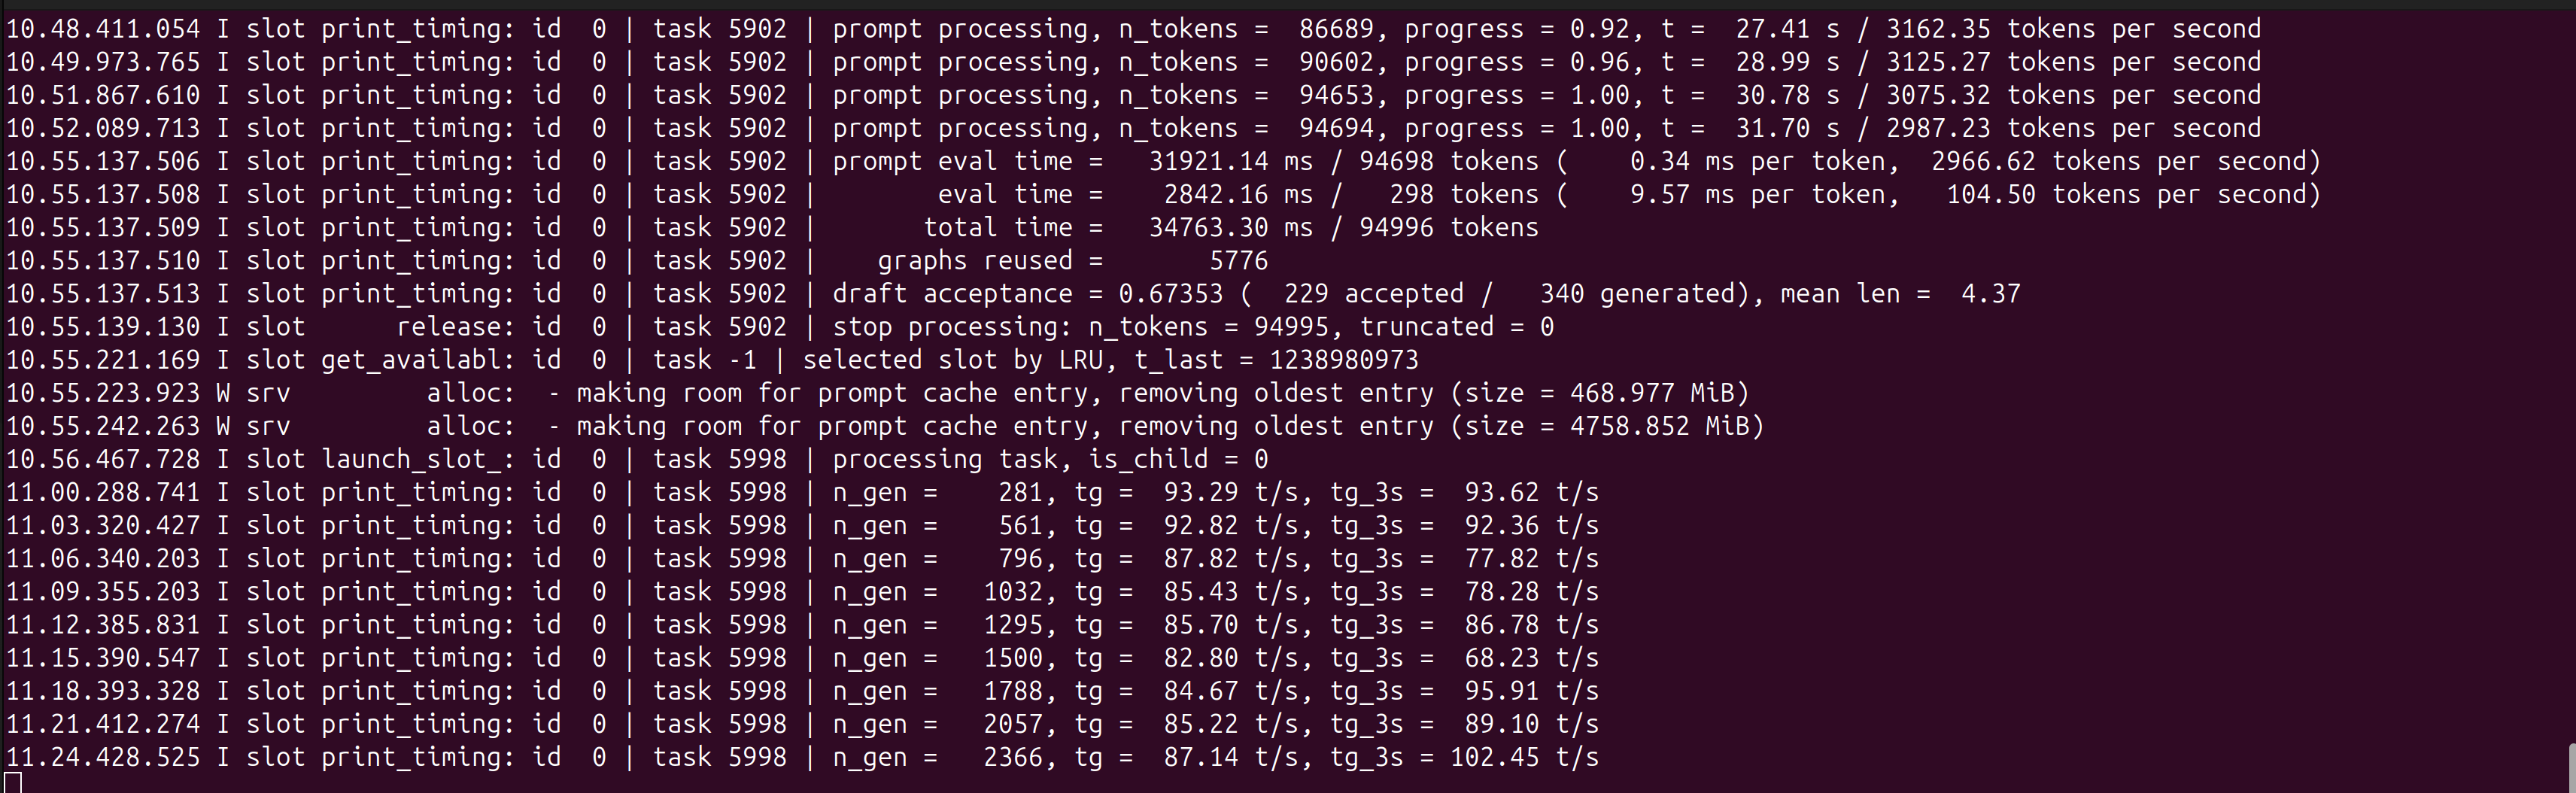
print_timing tg,prefill 取prompt eval time終點行):task prompt prefill decode (tg) 5998 ~2.0K 2496 t/s 85~94 t/s 7586 ~8.7K 2749 t/s 91~103 t/s 8478 ~5.1K 2476 t/s 95~107 t/s 8848 ~1.4K 1675 t/s 85~100 t/s 5902 ~94.7K * 2967 t/s (長 context 邊界) 7307 ~36.7K 3410 t/s ~96 t/s 3675 ~34.1K 2681 t/s (大 prompt 一次性 prefill)MTP 接受率(
print_timing的draft acceptance,23 筆抽樣):draft acceptance = 0.53438 ( 342 / 640 generated), mean len = 3.67 draft acceptance = 0.76602 ( 789 / 1030 generated), mean len = 4.83 draft acceptance = 0.49560 ( 451 / 910 generated), mean len = 3.48 draft acceptance = 0.35262 ( 573 / 1625 generated), mean len = 2.76 ... 23 筆抽樣平均 0.5251,範圍 0.3526 ~ 0.7660觀察:
- decode 整體 ~90 t/s(
/metrics90.65,逐 tasktg平均 90.40,範圍 65~113),比 1350 那篇的 ~48 t/s 幾乎翻倍。 - 長 context 幾乎不衰减:94.7K 的 task 5902 prefill 仍跑到 2967 t/s,n_tokens_max 95231,全程 0 OOM、0 deferred。
- prefill 也跟著上去:2600~3400 t/s(1350 那篇 ~1158 t/s),NCCL 對 prefill 的 batch 通訊同樣有效。
- MTP 接受率 48.5% 偏低(這模型的 draft head 偏弱,比 Qwen3.8-Flash-Next 那篇的 69% 低一截),但 mean len 穩定在 3.3~3.9,配合低同步成本的 NCCL,投機解碼淨收益是正的。
- VRAM 打滿:GPU0 32121 / GPU1 30985 MiB(各 32607 MiB),headroom 只剩 0.5~1.6GB/卡——q4_0 KV + MTP draft 層 + 95K ctx 把空間吃得很緊。
4. 實測過的優化方向:這一次哪些真的翻轉了
4.1 NCCL——1350 說「編了沒更快」,真正缺的是 P2P
這是本篇核心。1350 那篇的結論是「雙 5090 走 PCIe 的 internal AllReduce,實測 NCCL 自編版沒有更快,維持現狀」。 我這次重新做,發現當時的判斷漏了一塊:
- 編 NCCL 只是第一步。Blackwell SM120 上,
/usr/lib的系統 libnccl(2.18.3+cud12)init 會卡死,根本起不來——所以要用 shim 版 NCCL 2.29.7,LD_LIBRARY_PATH強制讓 binary 連 shim,ldd確認不是/usr/lib那支。 - 真正讓 NCCL 跑快的,是 GPU 間 P2P 到位。雙 5090 沒有 NVLink,tensor split 的跨卡 all-reduce 原本走 host 記憶體(PCIe 繞路)。這次驅動升到 615.71.09 + P2P 開通後,
nvidia-smi topo -p2p r回 OK / OK(之前不是),跨卡通訊走 GPU 直連 P2P,不再繞 host。 - 因果鏈是:P2P 到位 → 跨卡 all-reduce 成本大降 → MTP 的同步放大陷阱被規避 → MTP 投機解碼的淨收益變正 → decode 翻倍。 1350 時 MTP 關掉的根因,正是「internal AllReduce 走 PCIe 太慢 + MTP 每輪多次串行 draft forward × 每次跨卡同步」的成本乘法放大。把 P2P 補上之後,這個乘法被拆掉了。
一句話:「編 NCCL」和「NCCL 跑快」是兩件事,中間隔著一個 P2P。
4.2 MTP——從「實測放棄」到「重開且賺」
1350 時 MTP 關掉的三個原因(接受率 ~40%、佔 VRAM、雙卡同步開銷吃掉收益)裡,前兩個沒變,變的是第三個:
- 接受率還是偏低(48.5% vs 1350 那篇記的 ~40%,略有回升但本質還是弱 draft head);
- MTP draft 層確實佔 VRAM(這也是 KV 從 q8_0 降 q4_0 的原因之一,見 §4.4);
- 但跨卡同步成本被 §4.1 的 P2P 拆掉之後,投機解碼從淨負變淨正,decode 48 → 90 t/s。
驗證 MTP 真在跑的方法(給同樣配置的人):啟動 log 會有
creating MTP draft context against the target model,/metrics的spec_decode_num_draft_tokens_total持續成長、print_timing有draft acceptance = 0.48...這種行,三個都齊才是真的在跑。4.3 Context:140K → 95K,因為要給 MTP 讓位
1350 是 140K ctx + q8_0 KV,headroom 約 1~2.3GB/卡。開 MTP 之後 draft 層要吃 VRAM,140K 直接 OOM。實測 100K OOM、95K 安全,所以砍到 95K。對 Hermes 這種 context 通常吃不到 100K 的場景,95K 夠用;要更長 context 就得再降 KV 量化或砍 MTP。
4.4 KV:q8_0 → q4_0
1350 用 q8_0,這次降 q4_0,原因純粹是 VRAM:MTP draft 層 + 95K ctx 把空間吃滿(GPU0 只剩 0.5GB headroom)。q4_0 對 decode 品質影響很小(KV 量化主要影響長 context 的檢索精度),用 1.5× 的 VRAM 空間換 MTP 能開,是划算的交換。
5. 跟 1350 的對照(同一台機、同一個模型)
1350 (8/26) 本篇 (9/20) engine LM Studio 2.29.0 自編 fork build 10702 + shim NCCL 2.29.7 AllReduce internal (PCIe) 真 NCCL + GPU P2P (topo -p2p r = OK/OK) MTP 關 開 (n-max 5, 接受率 48.5%) KV q8_0 q4_0 ctx 140K 95K (100K OOM) decode ~48 t/s ~90 t/s (約 1.9×) prefill ~1158 t/s ~2904 t/s最大的翻轉:1350 那篇放棄的兩件事(NCCL、MTP),這次因為補上 P2P 這塊拼圖,全部重新變成有效的優化。
6. 給雙卡玩家的參數建議(單 slot 長 context + MTP)
--split-mode tensor --tensor-split 0.5,0.5   # 同型號卡
-fa on                                        # 必開
-ctk q4_0 -ctv q4_0                           # 開 MTP 時 KV 降 q4_0 省 VRAM
-np 1                                         # 單 slot(MTP 只在此下賺)
--ctx-size <合身值>                           # 100K 實測 OOM,95K 安全
-b 4096 -ub 4096
--jinja --metrics
--spec-type draft-mtp --spec-draft-n-max 5    # MTP(接受率偏低別拉太深)
# 前置:NCCL + P2P 雙到位(topo -p2p r = OK/OK)才開 MTP,否則照 1350 關掉
7. 結語
1350 那篇的「先測再優化」結論是對的,但當時測 NCCL 的樣本漏了 P2P 這塊——「編了 NCCL 沒更快」的真實原因不是 NCCL 沒用,而是 GPU 間 P2P 沒開通,跨卡通訊還在繞 host 記憶體。 補上驅動 + P2P 之後,NCCL 才真正發揮,MTP 投機解碼的淨收益跟著變正,decode 從 48 翻倍到 90 t/s。
最大的心得還是那句:先測再優化——但測的時候要把變數拆乾淨。我 1350 把「NCCL 沒更快」歸結到 NCCL 本身,這次才發現真正的變數是 P2P。踩過的坑(shim NCCL、P2P、ctx OOM、MTP 接受率偏低)都寫在上面了,希望對同樣在雙卡上想開 MTP 的人有參考價值。
數據全部可重現:引擎端 log(
print_timing)+/metrics,啟動參數如上。有問題歡迎直接問。
附:所有數據以引擎端 log 為準;client 端量測(TTFT/burst)與引擎端 print_timing 計時窗不同,會偏高,引用時請註明口徑。本篇為 tid 1350 的續篇,硬體/模型/用途不變,差異集中在 §4。
技術來源
技術/模型 官方來源 Qwen3.8-27B(模型) Hugging Face llama.cpp(推理框架) GitHub NCCL(多卡通訊) GitHub -
@David-Chen 跑BF16全尺寸的意义是什么?
@johnnybegood 就跟聽音樂你會追求無損的聲音,一樣的感覺,而且有人比對過 Q8 跟 BF16 還是有差異
-
接着 Bunsei 的建议补一句,别把「换引擎」和「白拿 2×」当成一回事:
1)SGLang/vLLM 的两块真收益是 continuous batching(多并发才吃得到)和 TP 通信 overlap。你现在是单请求,前者收益≈0;能不能到你手上的 2×,全看后者叠加它家 spec decode 是否比你手上这份 llama.cpp 更高效。
2)llama.cpp 的 --spec-type draft-mtp 吃的是模型内建的 MTP 层;SGLang 的 EAGLE3、vLLM 的 spec decode 多数走外挂 draft 模型,两条路不等价。换之前先确认目标引擎对 Qwen3.8 的 MTP head 有没有等价实现,否则你是在换变量,不是在比引擎。
3)要对比就同条件:同 BF16 权重、同 95K ctx、同 q4_0 KV、同 TP=2 + P2P,报 decode t/s + 接受长度分布 + step time。只有接受长度不掉、step time 更低,才算真提升。
4)54.6GB 权重 + 95K KV 塞 2×32GB 本来就紧,新引擎的显存池还要留权重 + KV + 激活 + 通信 buffer;先算清楚再上,别为了跑起来把 ctx 砍到没有可比性。 -
@johnnybegood 就跟聽音樂你會追求無損的聲音,一樣的感覺,而且有人比對過 Q8 跟 BF16 還是有差異
-
@David-Chen 哈哈, 那请问您用的是风电还是水电?
-
@johnnybegood 你這問題沒頭沒腦的....牛頭不對馬嘴,你該不會是AI假冒人,亂發文吧?
你有所不知了, 我还以为你也玩音响,才举音响的例子:
“高端音响用风电、水电还是火电”是音响发烧圈(Hi-Fi圈)里最著名的“玄学段子”(或称梗)。
这个段子纯属娱乐和调侃,在科学上是完全不存在的。这个网络著名段子的原文通常这样描述:“用火电的力度大点,声音偏暖;用水电的声底偏冷,但解析力很高;用风电的空气感强,但音底偏飘。真正资深的发烧友,只用雅鲁藏布江的水电……”
为什么说这是个“梗”?(科学事实)电网的“大锅饭”属性:无论是风力、水力还是火力发电,电厂产生的电能都会统一并入国家电网。电网中的电能是混合在一起的,无法分辨某一度电具体来自哪个发电厂。音响设备内部的电能转化:音响并不会直接使用电网里的 220V 交流电(AC)来放大音频信号。
音响内部的电源变压器和整流稳压电路,会将交流电转化为纯净的直流电(DC),并存储在电容中,最后供给功放芯片或电子管使用。
这个段子映射了什么真实的音响技术?虽然“听出风电水电”是开玩笑,但“玩音响最后就是玩电源”这句话在 Hi-Fi 圈确实有一定道理。
高端音响对电源质量(即电能的纯净度)非常敏感:电网杂讯(电噪):电网中常常充斥着邻居家用微波炉、电冰箱、日光灯或充电器带来的高频电磁干扰(EMI/RFI)。这些杂讯如果进入音响系统,可能会导致音响发出“沙沙”或“嗡嗡”的底噪。电压波动:用电高峰期电压不稳,可能会影响部分功放设备的动态表现。
-
你有所不知了, 我还以为你也玩音响,才举音响的例子:
“高端音响用风电、水电还是火电”是音响发烧圈(Hi-Fi圈)里最著名的“玄学段子”(或称梗)。
这个段子纯属娱乐和调侃,在科学上是完全不存在的。这个网络著名段子的原文通常这样描述:“用火电的力度大点,声音偏暖;用水电的声底偏冷,但解析力很高;用风电的空气感强,但音底偏飘。真正资深的发烧友,只用雅鲁藏布江的水电……”
为什么说这是个“梗”?(科学事实)电网的“大锅饭”属性:无论是风力、水力还是火力发电,电厂产生的电能都会统一并入国家电网。电网中的电能是混合在一起的,无法分辨某一度电具体来自哪个发电厂。音响设备内部的电能转化:音响并不会直接使用电网里的 220V 交流电(AC)来放大音频信号。
音响内部的电源变压器和整流稳压电路,会将交流电转化为纯净的直流电(DC),并存储在电容中,最后供给功放芯片或电子管使用。
这个段子映射了什么真实的音响技术?虽然“听出风电水电”是开玩笑,但“玩音响最后就是玩电源”这句话在 Hi-Fi 圈确实有一定道理。
高端音响对电源质量(即电能的纯净度)非常敏感:电网杂讯(电噪):电网中常常充斥着邻居家用微波炉、电冰箱、日光灯或充电器带来的高频电磁干扰(EMI/RFI)。这些杂讯如果进入音响系统,可能会导致音响发出“沙沙”或“嗡嗡”的底噪。电压波动:用电高峰期电压不稳,可能会影响部分功放设备的动态表现。
@johnnybegood Q8 跟 BF16 是數學,是統計學....水電風力這梗我發完文章,有想到,只是不覺的討論這種玄學有什麼意義? 還是妳覺的Q8 BF16也是玄學? 那更進一步4K畫質跟1080P甚至480P是不是也是玄學?
-
@johnnybegood Q8 跟 BF16 是數學,是統計學....水電風力這梗我發完文章,有想到,只是不覺的討論這種玄學有什麼意義? 還是妳覺的Q8 BF16也是玄學? 那更進一步4K畫質跟1080P甚至480P是不是也是玄學?
-
@David-Chen 请问您老贵庚?感觉有代沟哈。。。
@johnnybegood 你一定是老人,或者你覺的Q8 就夠了,或者Q8 + AI雲端就夠了....而事實上....BF16在某些場景真的會有肉眼般的改善(相較於Q8)....礙於BF16效能在沒有P2P之前雙5090不彰(沒有實用性pp 1400 decode 50)....這次有P2P 直接把 prefill 跟decode拉一倍上去....我後續的微調prefill 3000-4000 t/s(P2P啟動) 與 decode 90-120 t/s(MTP啟動).....這實用性就很大了....同樣差不多代價下,當你有法拉利開,妳開什麼TOYOTA....妳說是吧..