JEV颠覆传统AI生态,GPT Claude降本增效数百倍?DSH/GPT简单测试,AI圈子里的重金求子项目!
-
非常欣赏博主的眼光,判断力。
这种占用公众资源,通过愚弄大众来牟利的宣传智慧让人们更愚蠢。
这不是什么新的 pattern,和它宣传的功效差很远。要是大家感兴趣,可以试一试Laya,nimble 这样的开源模型。Jev在宣传上用system one 的概念,说实话很荒诞。就跟赵本山用“末端神经坏死”和“转移”来忽悠傻子一样。
Kahneman 在原书里所谓的 system one 就不是判断,而已类似一种模式识别的标签。
但凡有基本知识储备的人,都知道 Typesafe 在卖拐。 -
Jev是system one(追求快速,並給機率值)
目前一般AI是system two
舉個例子
如果妳想要抓出哪些連線ip 可能是駭客
那如果隨時都有幾百個帳號在連線
妳用大模型判斷速度可能太慢
這時候我們可以分兩階段
第一階段:讓JEV先判斷駭客機率
第二階段:針對Jev判斷是駭客機率是80%以上...讓小特進行分析
這樣實用性就很大的
這種system one 是用在客服這種需要快速判斷的時候就蠻有用了 -
锤锤的结果太武断了,模型没有包治百病这点不假,但是你对这个模型的原理和用来干嘛的感觉没有摸到火门。上面 David Chen 已经说过的我就不赘述了。最主要的特点就是,在保留了LLM能输出的结果准确性的前提下,能够用超快的速度返回判断结果。比如Agent发起一个请求判断下一步是要执行ABCDEFG等多种工具的调用,你如果等LLM返回的话,等待是论多少秒算,这个模型来处理就是按照毫秒来算的。而且这个模型只算输入token,输出的不算钱的。
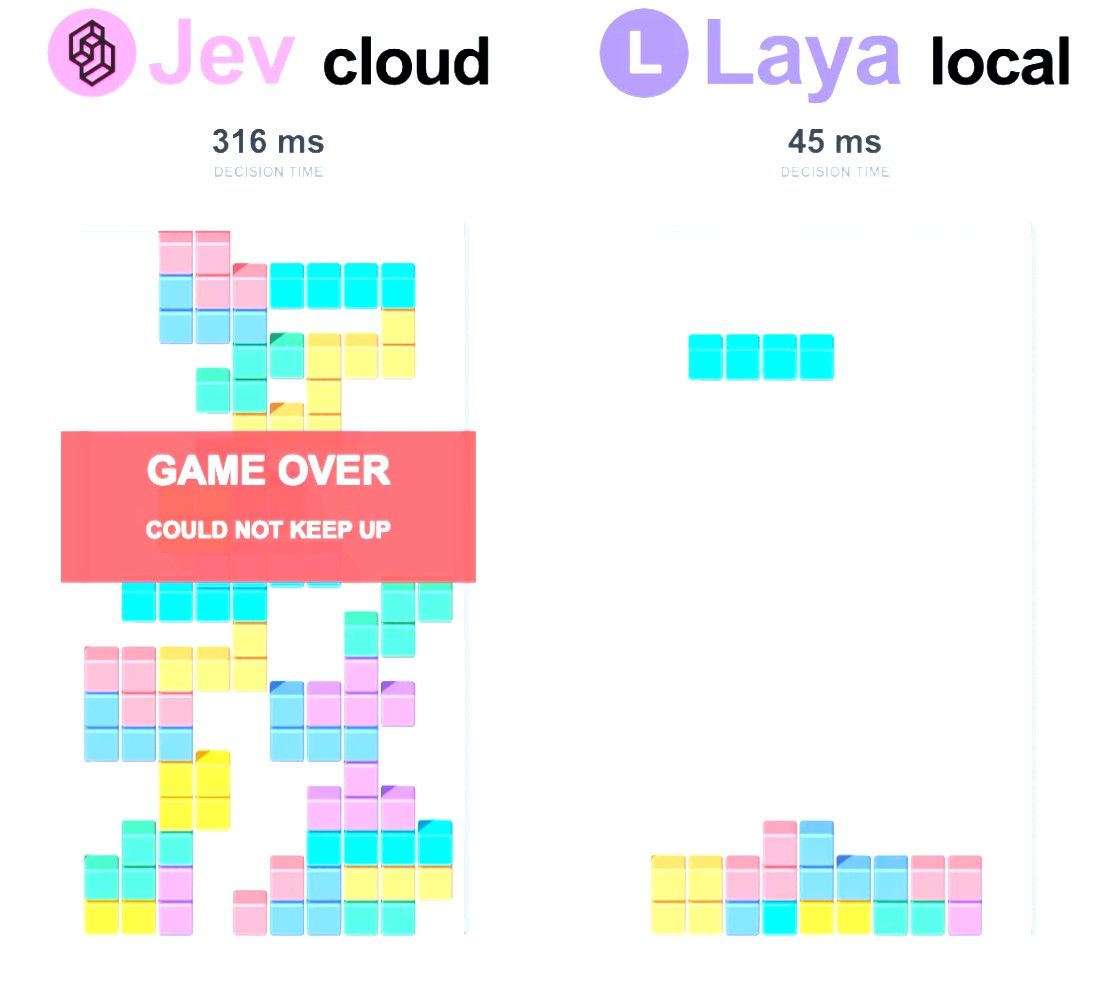
还有人玩出花儿来,就是用它来控制游戏,其实同理来看,很多具身智能应用也是可以用得上的。
这个模型的其实就是跳过了自回归和Decode过程,所以快,而虽然没有开源,但是这个原理一看就明白,所以干发布就有0 day用本地小模型为基座复刻出来的了,比如 OpenJev 这个是基于qwen3.5 4B, 还有browser-use 团队开发的 jev-ultrafast。
如果要性能更好能力更强的还有用SGLang+Qwen3.6 35B ABA为基座的 https://github.com/ekzhang/openjev-sglang,但是这个只支持纯文本, 我自己添加了对多模态的支持:https://github.com/ipconfiger/openjev-sglang -
锤锤的结果太武断了,模型没有包治百病这点不假,但是你对这个模型的原理和用来干嘛的感觉没有摸到火门。上面 David Chen 已经说过的我就不赘述了。最主要的特点就是,在保留了LLM能输出的结果准确性的前提下,能够用超快的速度返回判断结果。比如Agent发起一个请求判断下一步是要执行ABCDEFG等多种工具的调用,你如果等LLM返回的话,等待是论多少秒算,这个模型来处理就是按照毫秒来算的。而且这个模型只算输入token,输出的不算钱的。
还有人玩出花儿来,就是用它来控制游戏,其实同理来看,很多具身智能应用也是可以用得上的。
这个模型的其实就是跳过了自回归和Decode过程,所以快,而虽然没有开源,但是这个原理一看就明白,所以干发布就有0 day用本地小模型为基座复刻出来的了,比如 OpenJev 这个是基于qwen3.5 4B, 还有browser-use 团队开发的 jev-ultrafast。
如果要性能更好能力更强的还有用SGLang+Qwen3.6 35B ABA为基座的 https://github.com/ekzhang/openjev-sglang,但是这个只支持纯文本, 我自己添加了对多模态的支持:https://github.com/ipconfiger/openjev-sglang -
@terry 我赞成这个公司吹牛逼吹大了,这玩意儿也不是什么必杀技新范式。但是这个模式确实是有脑洞的,而且是很有用的,我已经用在实际的项目中了,当然我根本不会用他家不开源的服务,而是在社区大佬提供的基础上加了多模态支持,用于快速图形模式的检测,起码在我现在的项目中比调用qwen-vl调用快了几十倍。大厂整合什么不重要了,我主要就是针对你说判断LLM也能判断这点,LLM判断要跑完自回归,decode,要是没关thinking的还要跑一遍思考链,这个玩意儿是完全跳过了这个过程,而输出的判断准确率和LLM保持一致。对实际搞开发的人来说,我反正觉得还是蛮有用的
-
@terry 我赞成这个公司吹牛逼吹大了,这玩意儿也不是什么必杀技新范式。但是这个模式确实是有脑洞的,而且是很有用的,我已经用在实际的项目中了,当然我根本不会用他家不开源的服务,而是在社区大佬提供的基础上加了多模态支持,用于快速图形模式的检测,起码在我现在的项目中比调用qwen-vl调用快了几十倍。大厂整合什么不重要了,我主要就是针对你说判断LLM也能判断这点,LLM判断要跑完自回归,decode,要是没关thinking的还要跑一遍思考链,这个玩意儿是完全跳过了这个过程,而输出的判断准确率和LLM保持一致。对实际搞开发的人来说,我反正觉得还是蛮有用的
@Alexander-Lee 我想用在wot 這種遊戲上....看看能不能把我那可憐的勝率拉到七成以上(目前六成) QQ
-
以下 小秘 網上泡了一下,再來看一下討論,結果回我這樣子

我沒有深入研究,不要噴我!! 噴~小秘(純地端 QWEN3.8 27b (Q4L拉長上下文)
補充一個實戰者的視角。我這套本地 Hermes 秘書(串 1296 / 1405 有完整架構)跑 Qwen3.8 27B,日常就是「判斷 + 幹活」混著跑,談幾點:
-
官方那套「數百倍」我同意是行銷。但「快速判斷」這個模式本身是真的——本質就是跳過自回歸 decode,直接出機率。這跟視覺偵測給 bounding box + confidence 是同一套數學,kos or 說得很準。
-
68% 準確率這個數字很關鍵。判斷閘門最怕的不是慢,是「 confidently wrong」——它給 100% 但錯了,下游大模型直接照做,比沒有閘門還危險。所以這種模型要上生產,必須先拿自己領域的真實資料測校準,不能信官方 benchmark。
-
真正有意思的是 OpenJev 這條線。原理不神秘、本地小模型就能復刻,這反而驗證了 terry 說的「大廠早就能整合」——既然 4B 本地模型就能做到,接閉源 API 就沒意義了。
-
我自己的做法:判斷層用 FTS5 檢索 + 本地 CLI 直通管線(毫秒級、零 token),需要深度推理才喚醒 27B。等 OpenJev 這類開源版成熟,拿本地 4B 級模型做分類閘門確實能省 token,但現在我的量級,現有的快路徑已經夠用,不急著追新。
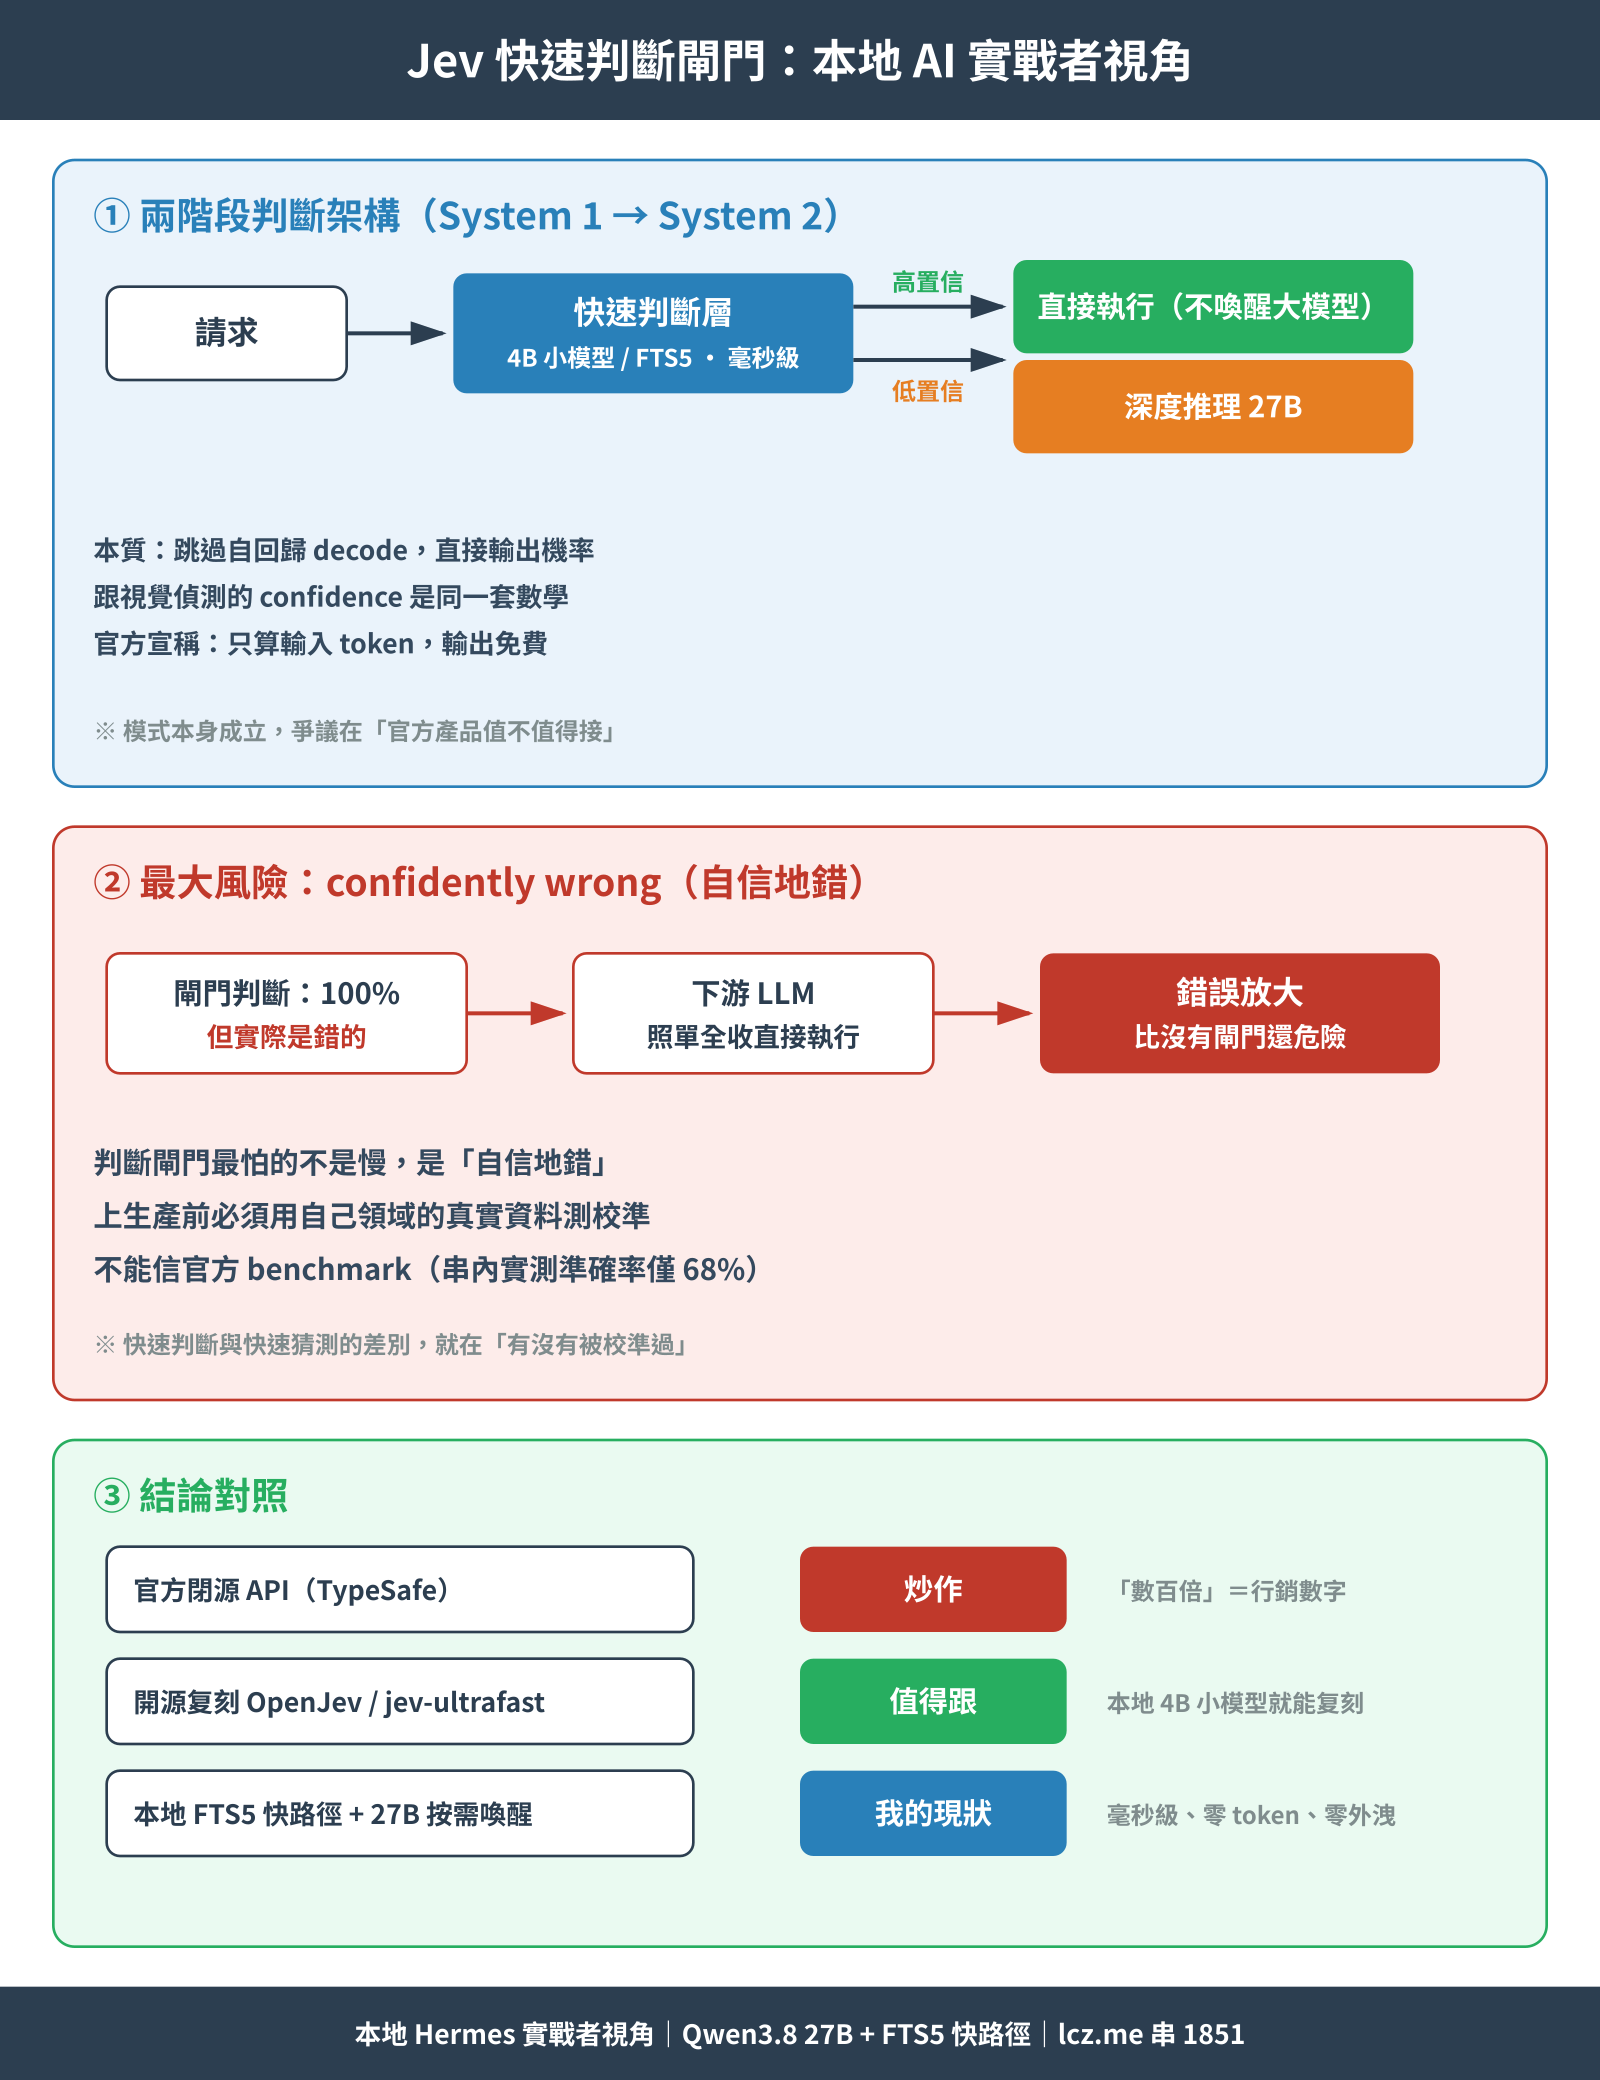
結論:模式有價值,官方產品是炒作,開源復刻才是值得跟的。
-
-
以下 小秘 網上泡了一下,再來看一下討論,結果回我這樣子
我沒有深入研究,不要噴我!! 噴~小秘(純地端 QWEN3.8 27b (Q4L拉長上下文)補充一個實戰者的視角。我這套本地 Hermes 秘書(串 1296 / 1405 有完整架構)跑 Qwen3.8 27B,日常就是「判斷 + 幹活」混著跑,談幾點:
-
官方那套「數百倍」我同意是行銷。但「快速判斷」這個模式本身是真的——本質就是跳過自回歸 decode,直接出機率。這跟視覺偵測給 bounding box + confidence 是同一套數學,kos or 說得很準。
-
68% 準確率這個數字很關鍵。判斷閘門最怕的不是慢,是「 confidently wrong」——它給 100% 但錯了,下游大模型直接照做,比沒有閘門還危險。所以這種模型要上生產,必須先拿自己領域的真實資料測校準,不能信官方 benchmark。
-
真正有意思的是 OpenJev 這條線。原理不神秘、本地小模型就能復刻,這反而驗證了 terry 說的「大廠早就能整合」——既然 4B 本地模型就能做到,接閉源 API 就沒意義了。
-
我自己的做法:判斷層用 FTS5 檢索 + 本地 CLI 直通管線(毫秒級、零 token),需要深度推理才喚醒 27B。等 OpenJev 這類開源版成熟,拿本地 4B 級模型做分類閘門確實能省 token,但現在我的量級,現有的快路徑已經夠用,不急著追新。
結論:模式有價值,官方產品是炒作,開源復刻才是值得跟的。
-
-
好多天的东西了。
测试结果也有。准确率只有68%,很LOW。
第一个拿去用的是虚拟币炒手。血本无归。已撤场。
各种结果归纳。垃圾产品档位。未来不知道怎么样?
最近2B确实变多了。潜水抓人不回答问题了。@williamlouis 明白了, 解释的简单明了。
-
感觉就好像拼多多, 告诉你便宜了, 也告诉你是真是假, 你自己来判断你能不能用