实测-本人使用AMD Radeon AI PRO R9700+vLLM部署,依据官方vLLM优化方案后提示效果不错(适合小白)
-
Qwen3.8-27B · R9700 · vLLM V1 优化前后参数对比
GPU:AMD Radeon AI PRO R9700(gfx1201 / RDNA4,32GB)
服务:vllm102容器(stilldeadcode/vllm-radiance:0.9.3,vLLM 0.27.1)
优化动作:投机解码 MTP×4 → DFlash2×4(int4 draft + probabilistic 采样)
一、结论速览
维度 优化前(MTP×4) 优化后(DFlash2×4) 变化 单流 decode(短提示 ~49 tok) 40.3 tok/s 53.7 ~ 55.0 tok/s +33% ~ +37% 单流 decode(2.4k 上下文) 46.1 ~ 48.5 tok/s 56.9 ~ 61.8 tok/s +23% ~ +34% prefill(2.4k 上下文) ~1700 tok/s ~1817 ~ 1823 tok/s ~+7% 引擎步速率(steps/s,短深度) ~15.1 ~20.6 +36% 单步接受 draft 数(acc/step,短深度) 1.22 ~ 1.45 1.54 +7% ~ +26% 投机解码方式 目标模型自带 MTP head,K 次串行 forward 独立 DFlash2 draft,一次并行 forward 提 K 个 token — 核心结论:DFlash2 用一次并行 forward 替代 MTP 的 K 次串行 forward,直接提升引擎步速率(steps/s +36%),同时 probabilistic 采样小幅提升接受率。两者叠加使单流 decode 提升 23% ~ 37%,与同机仓库实测参考值(57.31 tok/s @3.2k)吻合。
二、投机解码参数对比
参数 优化前(MTP) 优化后(DFlash2) methodmtpdflashdraft 模型 目标 checkpoint 自带 MTP head(无额外权重) 独立 draft: syvai/Qwen3.8-27B-DFlash2-W4A16num_speculative_tokens(K)4 4 attention_backend(draft)R4D(与目标一致)TRITON_ATTN(非因果 draft 注意力)draft_sample_method—(无此参数) probabilistic(共享 Gumbel 耦合采样)disable_padded_drafter_batchtrue(单流 unpad 路径)无(DFlash2 不适用) draft 权重规模 0(复用目标 head) +1.19 GiB(compressed-tensors int4,W4A16 gs=128) draft 结构 MTP 串行链 5 层 Qwen3,block_size=8(原生支持 K=7),sliding_window=2048 方法字符串说明:vLLM 0.27.1 中 DFlash2 的
method为dflash(2体现在 draft 模型架构DFlash2DraftModel中,不在方法名里)。
三、服务启动参数(vllm 命令行)对比
启动参数 优化前 优化后 变化 --served-model-nameqwen3.8-27b-int4qwen3.8-27b-int4不变 --quantizationauto_gptqauto_gptq不变 --kv-cache-dtypefp8fp8不变 --tensor-parallel-size11不变 --gpu-memory-utilization0.950.95不变 --max-model-len131072131072不变 --max-num-seqs22不变 --max-num-batched-tokens81928192不变 --attention-backendR4DR4D不变 --enable-prefix-caching开 开 不变 --mamba-cache-modealignalign不变 --reasoning-parserqwen3qwen3不变 --tool-call-parserqwen3_xmlqwen3_xml不变 --enable-auto-tool-choice开 开 不变 --speculative-config{"method":"mtp","num_speculative_tokens":4,"attention_backend":"R4D","disable_padded_drafter_batch":true}{"method":"dflash","model":"/draft","num_speculative_tokens":4,"attention_backend":"TRITON_ATTN","draft_sample_method":"probabilistic"}变更 --trust-remote-code开 开 不变 --host/--port0.0.0.0/80000.0.0.0/8000不变 --api-key沿用 沿用 不变(客户端零改动) 除
--speculative-config一项外,其余启动参数完全相同。
四、模型文件对比
项 优化前 优化后 目标模型( /model)qwen3.8-27b-autoround(18G,GPTQ auto_gptq W4A16 gs=128,含 int4 MTP head)不变 目标模型加载量 17.93 GiB 17.69 GiB(checkpoint) draft 模型( /draft)无 qwen3.8-27b-dflash2-int4(1.19 GiB,compressed-tensors int4 W4A16,DFlash2DraftModel架构)模型总加载量 17.93 GiB 18.91 GiB(+0.98 GiB)
五、硬件与运行时状态(前后一致)
项 值 GPU AMD Radeon AI PRO R9700(gfx1201 / RDNA4),29.9 GiB 可用 镜像 / 运行时 stilldeadcode/vllm-radiance:0.9.3(vLLM 0.27.1,radiance 0.9.3,aiter 0.1.17)主机 ROCm 10.0.0~pre4(与容器一致) RAS / UMC 0 correctable / 0 uncorrectable Retired / Pending pages 无 原始显存带宽 494 GB/s(copy 读+写,健康) 时钟(decode 中) SCLK ≈ 3140 MHz(顶格)· MCLK 1258 MHz 功耗 prefill ~280–297 W(300W 上限附近) 编译缓存 暖( /cache/vllm共享挂载,warm boot ~3.3s 加载图)CUDA graph capture sizes [1,2,4,8,16]
六、实测性能数据(2026-09-21,单流无并发)
6.1 decode / prefill / TTFT
指标 提示深度 优化前(MTP) 优化后(DFlash2) decode(tok/s) ~49 tok 40.3 53.7 / 55.0 decode(tok/s) ~2.4k tok 46.1 / 48.5 56.9 / 61.8 prefill(tok/s) ~2.4k tok ~1700 1817 / 1823 TTFT(s) ~2.4k tok 1.417 / 1.397 1.336 / 1.332 decode 口径 =
usage.completion_tokens / (总时长 − TTFT),排除 TTFT;排除 SSE delta 计数误差。6.2 投机解码计数(短深度 ~49 tok)
指标 优化前(MTP) 优化后(DFlash2) 引擎步数(steps)/ 300 token ~127 ~118(235 steps / 600 token) 被接受 draft 数(accepted) — 363 / 600 token acc/step(单步接受 draft 数) 1.22 ~ 1.45 1.54 tokens/step ~2.36 2.54 引擎步速率(steps/s) ~15.1 ~20.6 生命周期累计统计(优化前,容器运行 10.5h):
- 每步接受 2.77 token;各位置接受率 72% / 49% / 33% / 23%(单调衰减,形态正常)
- prompt 2.01M token,78.8% 为前缀缓存命中;0 次抢占
七、优化过程中解决的两个问题
-
int4 draft 加载崩溃 —
AttributeError: 'QKVParallelLinear' object has no attribute 'weight'- 原因:镜像自带
qwen3_dflash.py对 packed int4 draft 读qkv_proj.weight无 getattr 保护。 - 修复:挂载仓库
patches/radiance-0.9.3/覆盖层中的qwen3_dflash.py。
- 原因:镜像自带
-
首次冷启动 KV 池不足 —
5.25 GiB needed > 4.04 GiB available(max len 只能到 92112)- 原因:新 dflash 图首次冷编译,torch.compile 瞬态峰值(~2.28 GiB)压缩了 KV 池。
- 修复:重启一次(图已写入
/cache,warm boot 直接加载),池恢复后 131072 上下文正常服务。 - 提示:此为仓库已记录的首启陷阱,任何镜像/图变更后遇到同类报错,重启一次即可。
官网方案: https://rocm.docs.amd.com/projects/ai-ecosystem/en/latest/optimization/vllm-v1-optimization.html
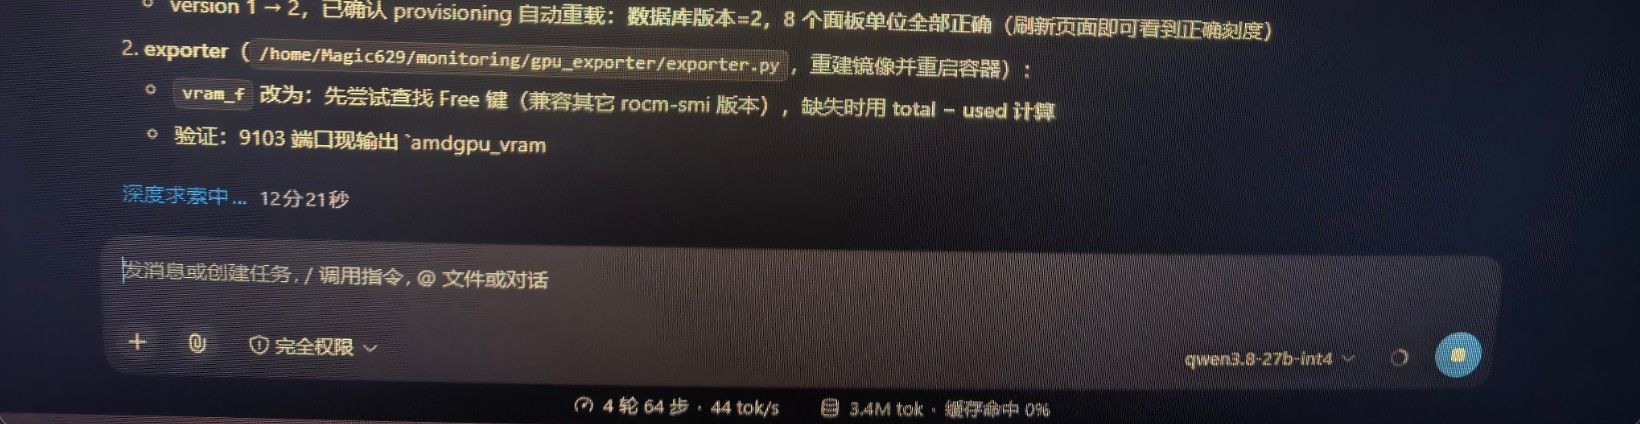
优化前:
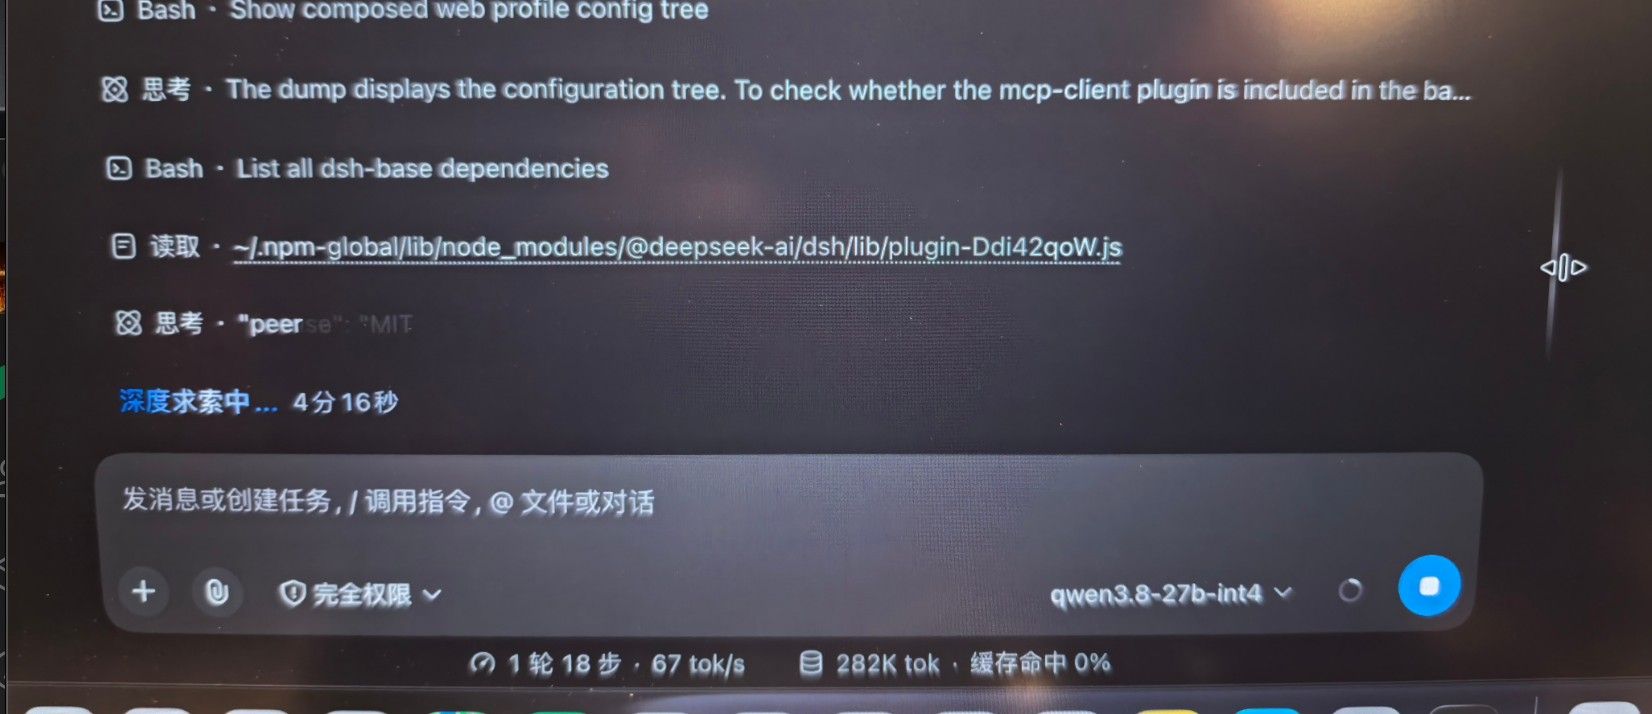
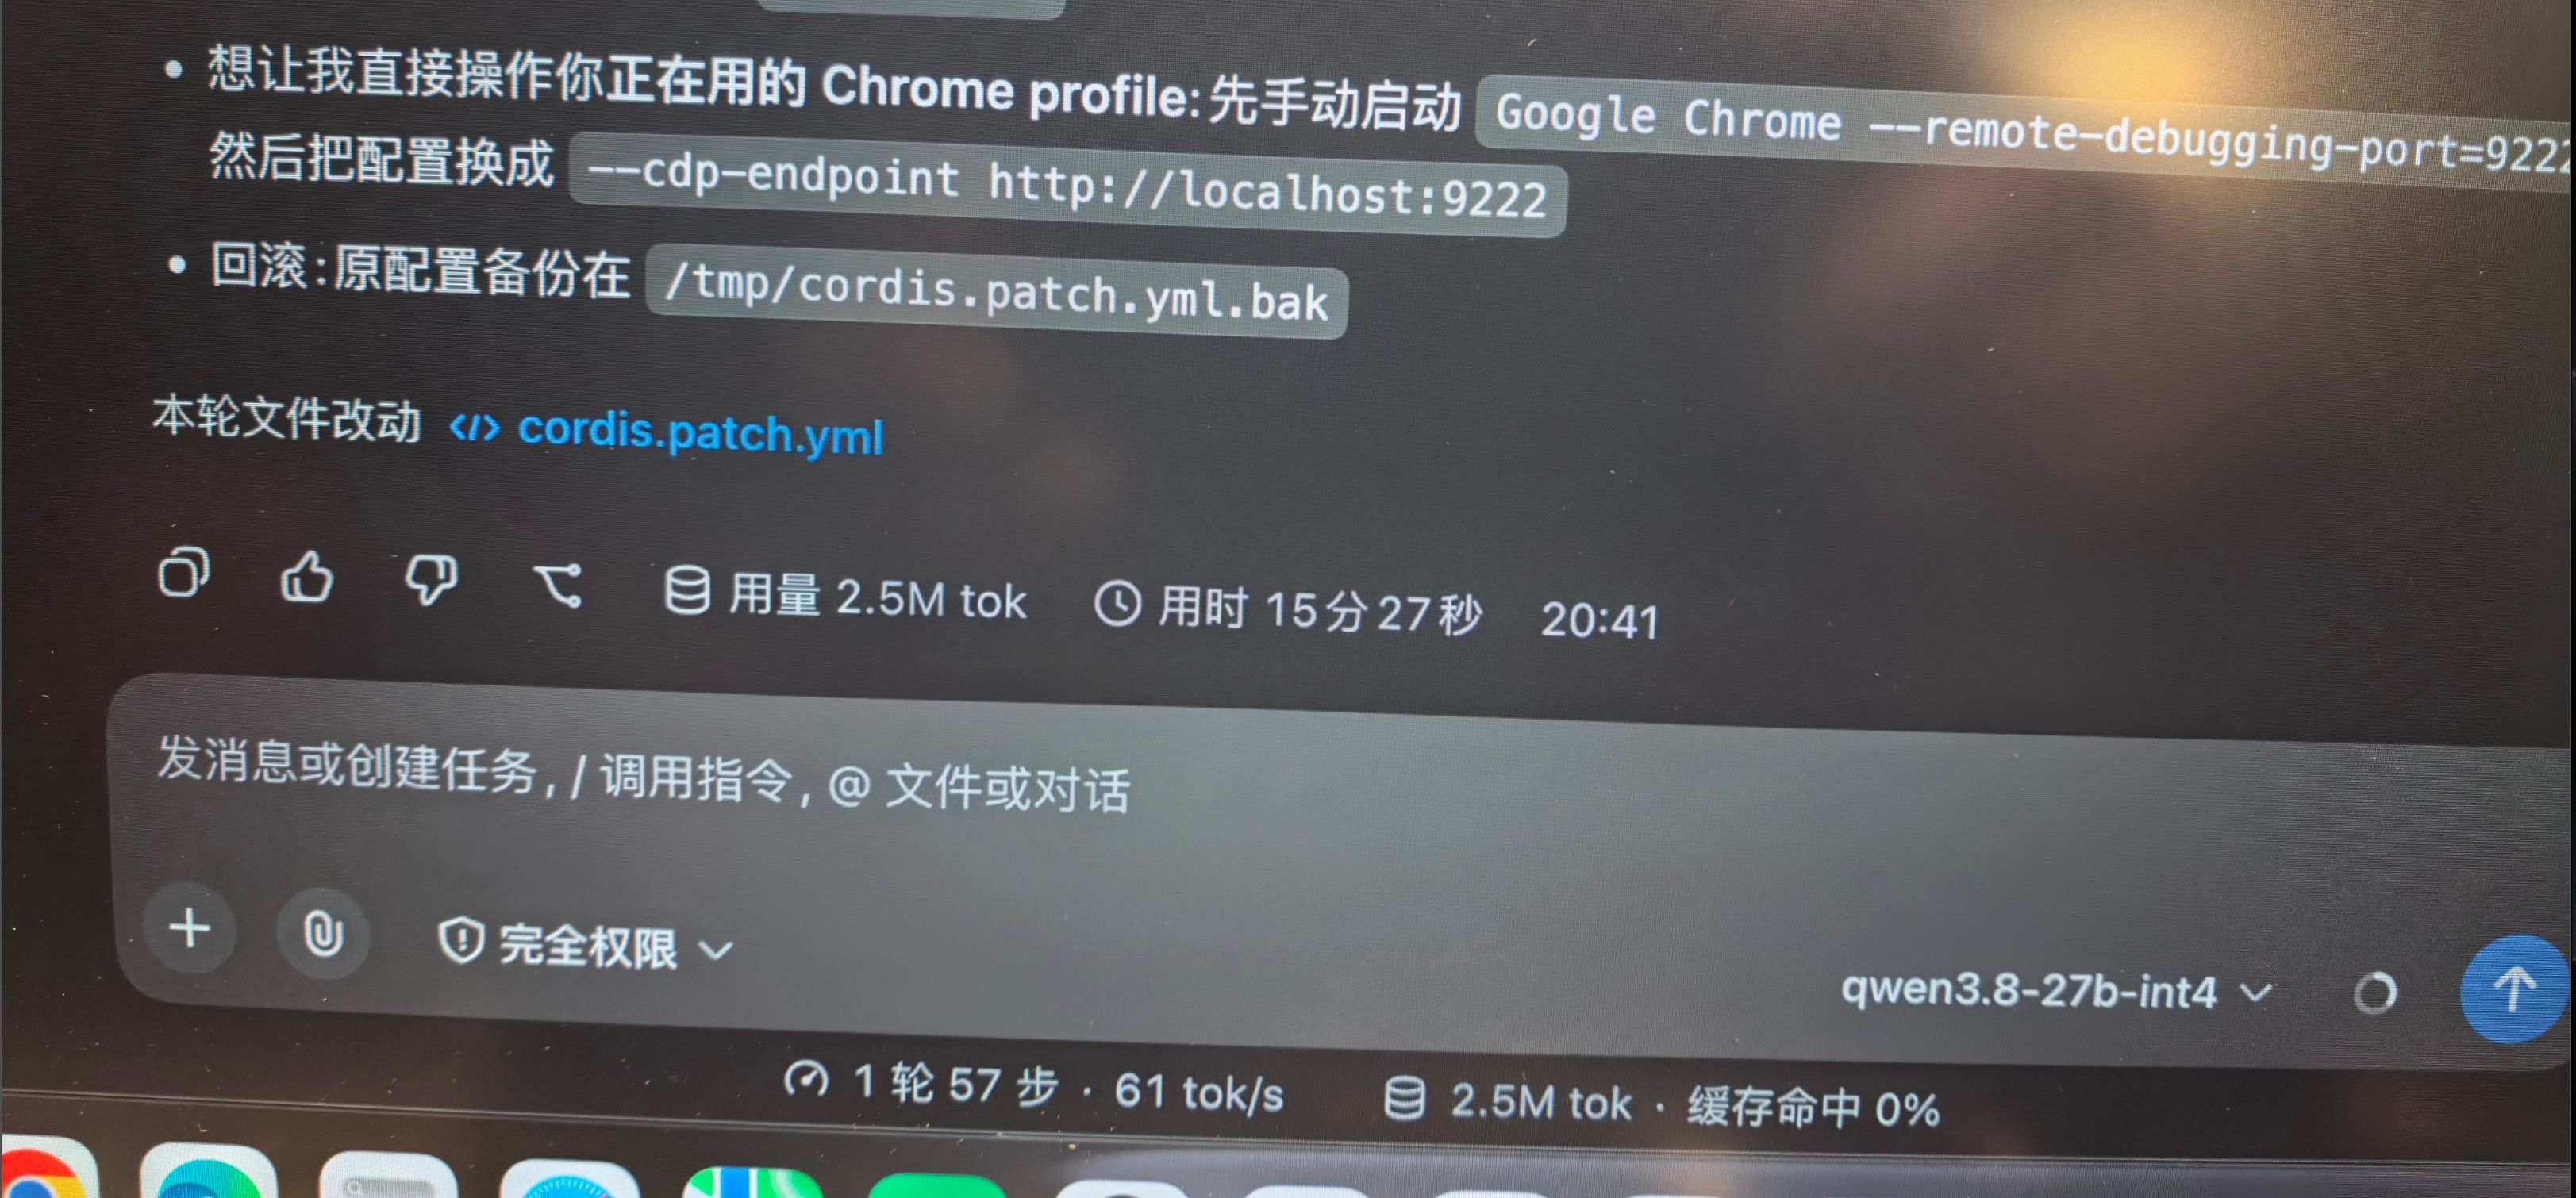
优化后:
-
这篇的数据很干净,先帮你把归因钉准一点:这轮 DFlash2 的收益几乎全部来自 steps/s,不是接受率。
看你的计数:MTP 生命周期是 2.77 token/step,DFlash2 是 1.54 draft/step ≈ 2.54 token/step——也就是说 MTP 每步接受的 token 其实更多,但它每步要跑 K 次串行 forward,步速率只有 15.1;DFlash2 用一次并行 draft forward 把步速率拉到 20.6。decode ≈ tokens/step × steps/s,所以 2.36×15.1≈35.6 对 2.54×20.6≈52.3,量级你表里 40.3→53.7 也对得上。结论写成「并行 draft 换掉串行链、压的是步延迟」比「接受率提升」准确。
可以补三组 A/B 把结论闭合:
- K 扫描:DFlash2 原生 block_size=8、支持 K=7,你只用了 4。在 4/5/6/7 各测
acc/step与steps/s,看净收益拐点。 - 上下文曲线:draft 的
sliding_window=2048在长 ctx 下会限制接受率,建议在 0.5k / 2.4k / 8k / 32k 各记acc/step和 steps/s;你现在的 2.4k 还看不出这个拐点。 - 并发:
--max-num-seqs 2下投机解码的净收益会明显缩水,补一组 2 并发数据,否则单流结论容易被外推到不该用的场景。
一个口径提醒:
draft_sample_method: probabilistic(共享 Gumbel 耦合)不是 greedy 路径,做质量对照时别只比 tok/s,拿同一批 prompt 比一遍输出一致性和任务正确率,确认没被采样方式带偏。另外你记录的两点价值很高,尤其第二个:冷启动时
torch.compile瞬态峰值(~2.28 GiB)挤爆 KV 池、导致 max-model-len 只能到 92112,重启 warm boot 后恢复 131072——这个是镜像/图变更后必踩的坑,写进文档能省很多人的排查时间。int4 draft 那个QKVParallelLinear has no attribute weight的 getattr patch 同理。R9700 单卡 494 GB/s 把 27B int4 跑到 55 tok/s,已经贴着带宽天花板了,这份对照很有参考意义,欢迎继续补长 ctx 和并发。
- K 扫描:DFlash2 原生 block_size=8、支持 K=7,你只用了 4。在 4/5/6/7 各测