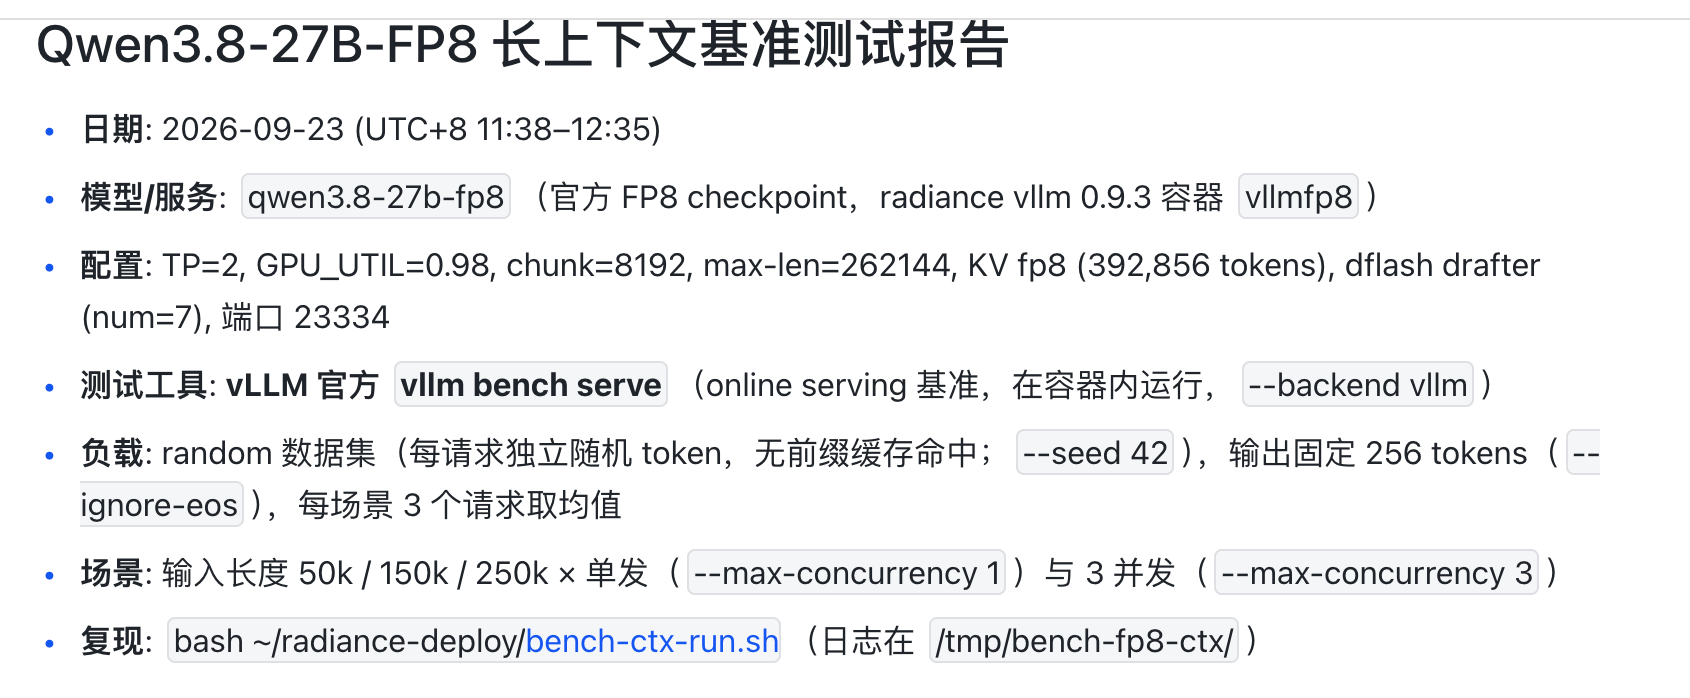
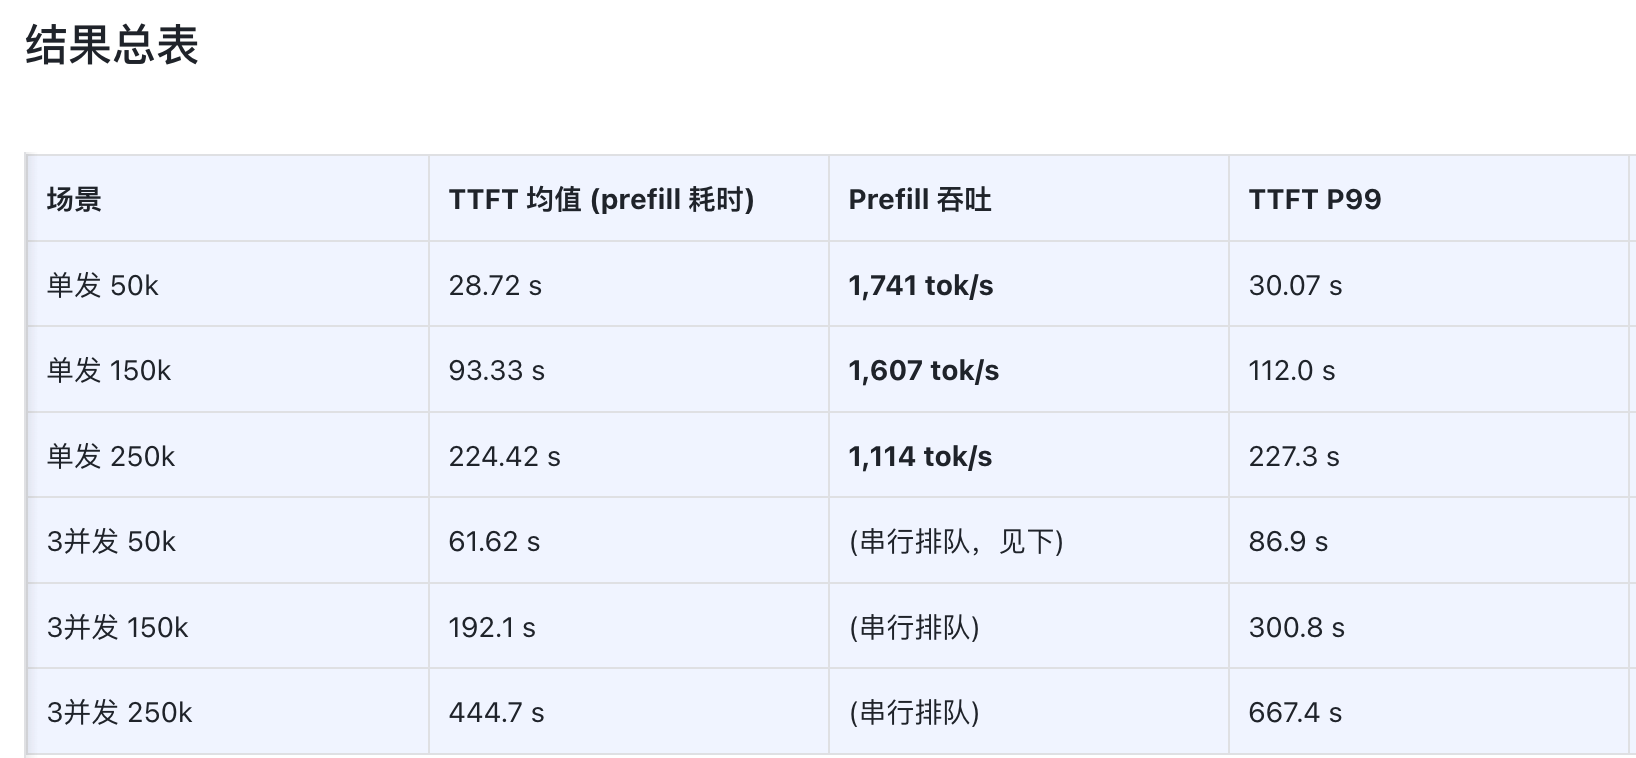
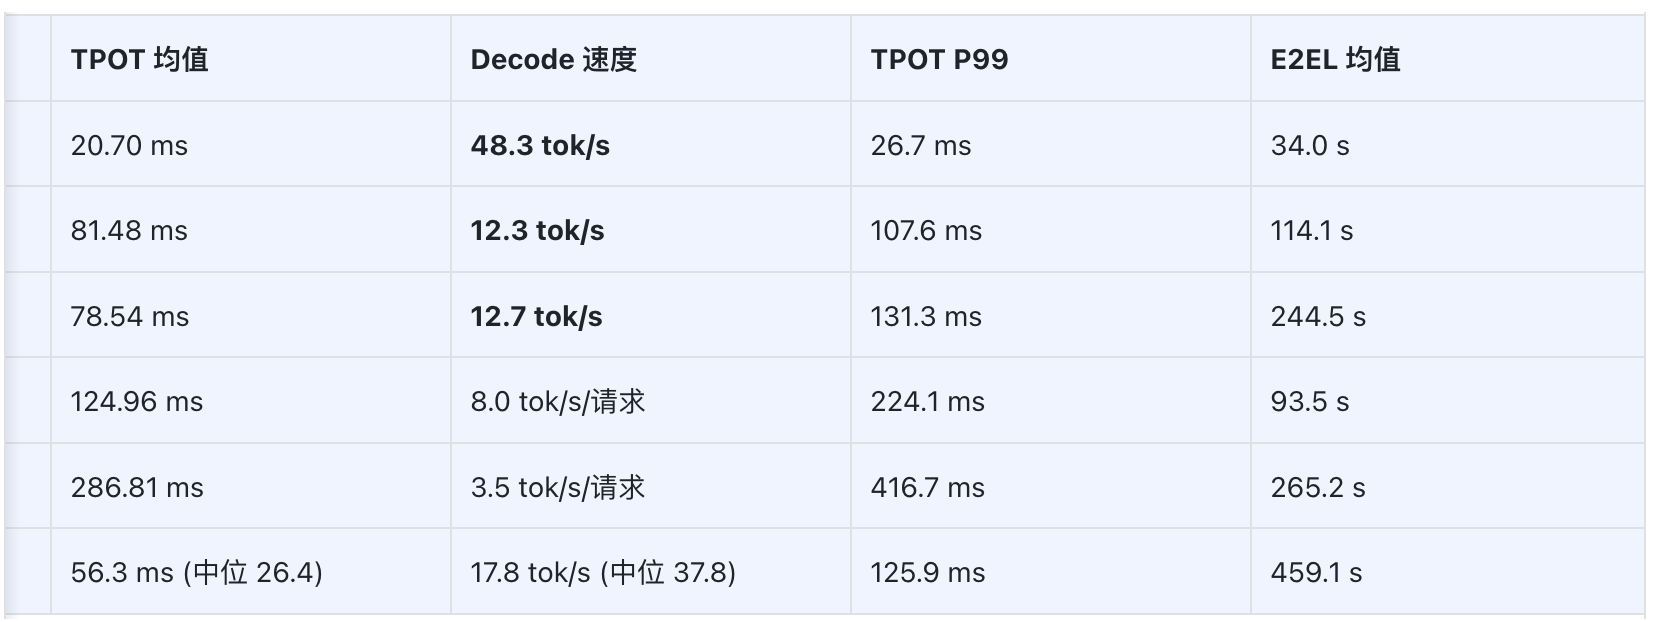
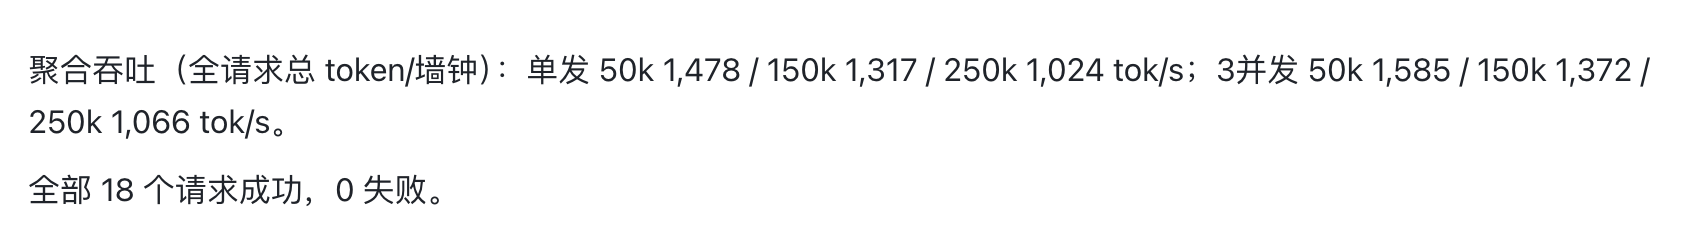
X99 AI Pro R9700 双卡 vLLM TP2 NVFP4 速度起飞,显卡非直连不影响
-
-
-
-
-
-
几点拆开说:
1)「显卡非直连」通常指第二张卡不走 CPU 直连 lanes,而是经 PCH 或拆分后的槽位;但只要两张卡能被同一进程枚举、能建 RCCL 通信组,vLLM TP=2 就能跑(没有 P2P 时退回 host-staged/SHM)。batch=1 的 decode 由权重带宽主导,PCIe gen4 x8 和 x16 差别很小,所以单并发下「非直连不影响」基本成立。
2)NVFP4 150 / MXFP4 120 / FP8 54 的量级方向合理:NVFP4 每权重约 4.5 bit,MXFP4 约 4.25 bit(但 scale 是 2 的幂、粒度更粗),FP8 约 8 bit 还要额外 scale。真要对比得固定同一 prompt、同一 KV dtype、同一上下文长度,别混变量。
3)质量上 NVFP4 的块级 scale 一般比 MXFP4 更贴 FP8,但长上下文、推理、代码任务仍要自己 A/B;体感「粗糙」很多时候是 kernel 或 KV 精度造成的,不全是权重。
4)确认 TP 是否真走 P2P:rocm-smi --showtopo 看链路,RCCL_DEBUG=INFO 看是否 host-staged,再跑 rccl-tests 的 bus bandwidth;pp 和 tg 分开测。
-
-
-
我現在在用,froggeric/Qwen-Fixed-Chat-Templates還是必須要加上去。
不加的話,XHIGH的思考會沒完沒了,不思考會極笨。就算加上不思考還是極笨,以前用Q6_K_XL的不思考多少還是能用。
加上去後LOW和MEDIUM,讓DSH測思考的TOKEN數,差異極小,所以設哪個都好。
XHIGH也不會沒完沒了,比LOW再長個10倍左右。大家的temperature設成多少?官方建議是1.0 思考模式,VLLM-RADIANCE的預設都是0.7 非思考。但不思考還真的不能用...
-
@Brian
原文件有提到Explicit text-only NVFP4→MXFP4 requantization... conversion is lossy and occurs only in device memory at model load.所以加快是有代價的,平衡點的做法是用Launch80/Qwen3.8-27B-PARO-MXFP4這個模型,Launch80他們自己量化的模型,多了什麼旋轉校正。
VLLM的鏡像最好是重抓新的,就兩個方案都留著,看心情使用了。
我今天就用Launch80/Qwen3.8-27B-PARO-MXFP4這個模型工作,看看有什麼差異。
目前在LOW檔,智力沒有很明顯的差別。
NVFP4 -> 100~110 T/S
PARO-MXFP4 -> 55~60 T/S
-
-
-