X99 + 双 AMD Radeon AI PRO R9700 跑通跨 Root Port P2P:从内核、RCCL 到 SGLang Qwen3.8 实战
-
-
-
-
谢谢老特肯定。打通P2P和调试SGLang的过程都是Agent来操作的,包括内核编译、遇到问题寻找解决方法。5.5小时双卡几乎满功率推理测试,没有出现问题。
🔧 X99 × Dual R9700 P2P Lab
https://lcz.me/projects/local/x99-amd-gpu-p2p -
谢谢老特肯定。打通P2P和调试SGLang的过程都是Agent来操作的,包括内核编译、遇到问题寻找解决方法。5.5小时双卡几乎满功率推理测试,没有出现问题。
@PhoenixRise2026 可以继续优化,或许可以出个github项目,这玩意还挺重要的。
-
 T terry 于 引用了 此主题
-
-
但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
-
但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
-
@suboyang
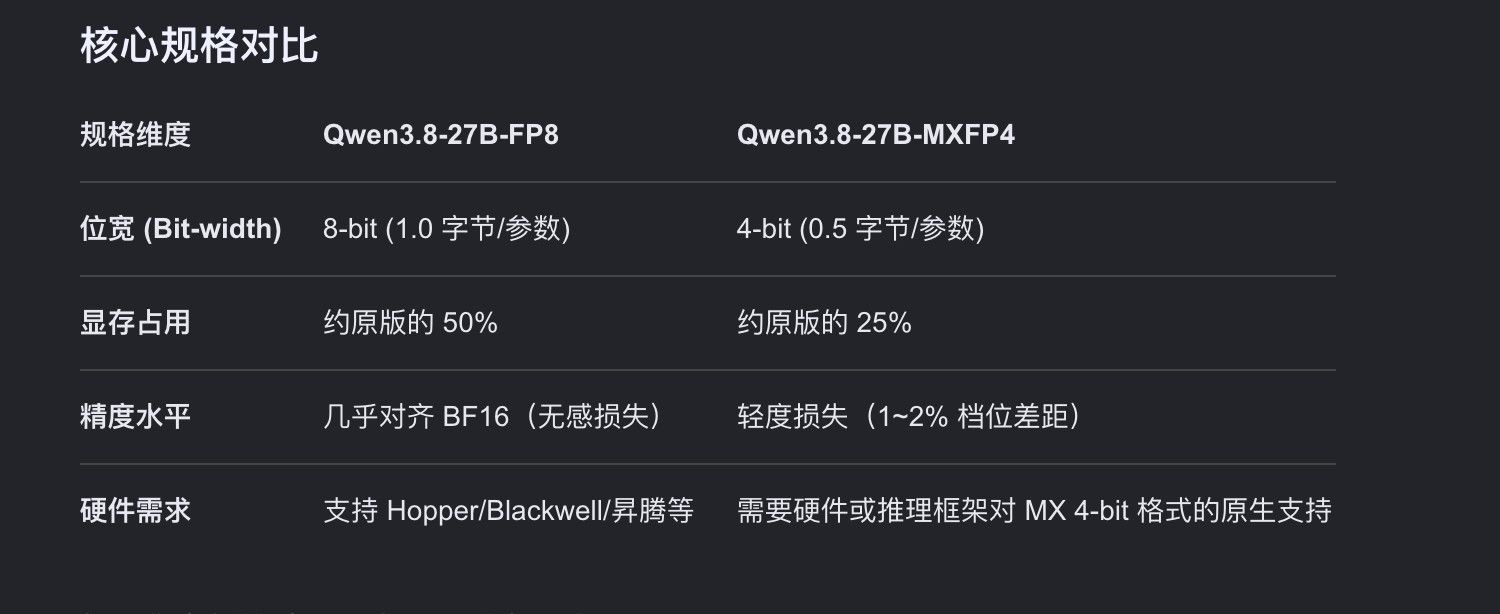
精度差不了一半,估计也就百分之几吧。按你这个算法,原始精度32位量化到Q4就没法用了,事实上Q4也可以保留差不多95%以上的有用信息。而且真要是干啥大活,跑云端不是更靠谱么,本地模型毕竟是本地。 -
@suboyang
精度差不了一半,估计也就百分之几吧。按你这个算法,原始精度32位量化到Q4就没法用了,事实上Q4也可以保留差不多95%以上的有用信息。而且真要是干啥大活,跑云端不是更靠谱么,本地模型毕竟是本地。 -
对啊,2%不到的差距没啥可担心的,Agent时代验收一下就可以了,也就可能是有时候需要多做个一步两步的。我现在发现搭配的agent某种程度上更重要,dsh明显比Hermes干活的效率要高。
-
但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
但是看起来好像你这个运行速度也不是太好啊,Pp才1000左右。看看https://github.com/Eliovp-BV/paiton-vllm-plugin。 单卡运行速度就炸裂,昨天刚配置好的
Paiton 单卡确实很强,这个后面有时间我也会测。
我这篇主要验证的是 X99 双 R9700 的 P2P 可行性和双卡 scaling,SGLang 只是目前先跑通的 serving stack。现在这些 PP/TG 数据主要看单卡→双卡提升,不是在做 SGLang vs vLLM 横评。
后续会补 vLLM/Paiton,同模型同参数下再比较。🔧 X99 × Dual R9700 P2P Lab
https://lcz.me/projects/local/x99-amd-gpu-p2p -
对啊,2%不到的差距没啥可担心的,Agent时代验收一下就可以了,也就可能是有时候需要多做个一步两步的。我现在发现搭配的agent某种程度上更重要,dsh明显比Hermes干活的效率要高。
@fcme 弟人家这个帖子是的关键是速度吗?人家是打通P2P,第一这是个人实验项目,刚刚开始,以后还可以优化。解决的是有无问题,是原创,就算纯粹从炫技的角度来看,也很有意义。它不是我发现了某个插件,某个方案很牛逼,这种技能很多人都能掌握,并不特别值得炫耀。
第二,PP在有SGLang的情况下,影响并不那么大,Agent场景只做增量Prefill,并不会一直做如此大的Prefill工作,所以可以接受。还是有应用价值的,不是所有场景都看测试数据的。
第三,这个方案对24G的7900XTX意义很大,它没有mxfp4的红利,可以抄作业,只要用上SGLang,双卡TP的意义在过往的帖子中有过大量测试,很有意义。
第四,VLLM有它的强项,也有弱项,Agent上它就是不如SGLang,不如NInfer,HaloGen,它没有硬核增量缓存计算,更没有跨会话缓存复用,并不是数字好看,体验就好的。
第五,对VLLM的用户而言,在X99上打通P2P难道没意义?你怎么知道人家不会vLLM呢?论坛藏龙卧虎,低调交流。不能总学我,有点知识就吹牛逼,我都被打脸太多次,不太在乎了。谦虚使人进步,骄傲使人落后。
-
 S suboyang 于 引用了 此主题
-
 张 张光璞 于 引用了 此主题
-
-
-
T terry 于 引用了 此主题
-
@张光璞 单独更新个帖子可以,详细弄下数据。其实最主要的,我不希望大家总是发一大堆内容,就几个关键的,吐字速度,长上下文多并发的实际使用体验。然后再展开prefill,decode等具体数据,先给结论。这玩意能普及,也算是开了个新的玩法。
-
@fcme 弟人家这个帖子是的关键是速度吗?人家是打通P2P,第一这是个人实验项目,刚刚开始,以后还可以优化。解决的是有无问题,是原创,就算纯粹从炫技的角度来看,也很有意义。它不是我发现了某个插件,某个方案很牛逼,这种技能很多人都能掌握,并不特别值得炫耀。
第二,PP在有SGLang的情况下,影响并不那么大,Agent场景只做增量Prefill,并不会一直做如此大的Prefill工作,所以可以接受。还是有应用价值的,不是所有场景都看测试数据的。
第三,这个方案对24G的7900XTX意义很大,它没有mxfp4的红利,可以抄作业,只要用上SGLang,双卡TP的意义在过往的帖子中有过大量测试,很有意义。
第四,VLLM有它的强项,也有弱项,Agent上它就是不如SGLang,不如NInfer,HaloGen,它没有硬核增量缓存计算,更没有跨会话缓存复用,并不是数字好看,体验就好的。
第五,对VLLM的用户而言,在X99上打通P2P难道没意义?你怎么知道人家不会vLLM呢?论坛藏龙卧虎,低调交流。不能总学我,有点知识就吹牛逼,我都被打脸太多次,不太在乎了。谦虚使人进步,骄傲使人落后。
@terry
这我完全同意,sglang对amd的支持始终就挺屎的。
牛人太多了,要是有人能完全搞定AMD民用卡在sglang上面的生态那就太牛了,加油。 -
-
@fcme 很多人都搞起来了,双7900XTX 4路并发长上下文都跑了,这对AMD用户太重要了。现在就是DDR4平台的板子太贵,大家想要解决X99这样的DDR3平台双卡TP的问题,这真的是非常重要。
-
对啊,2%不到的差距没啥可担心的,Agent时代验收一下就可以了,也就可能是有时候需要多做个一步两步的。我现在发现搭配的agent某种程度上更重要,dsh明显比Hermes干活的效率要高。

 站长已核:本帖设为精华,作者 +5 积分奖励,希望再接再厉!