
Atlas300 I Duo 能用吗,单流 token/s也能到70
-
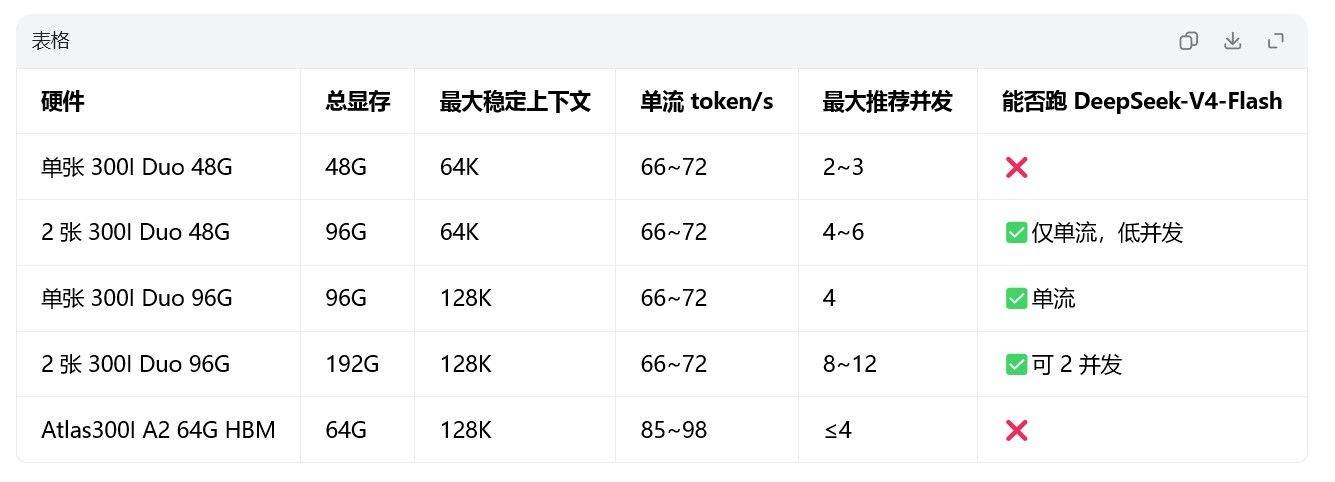
豆包说的,有点想试试,有尝试过的吗?DeepSeek-V4-Flash|2 张 Atlas300I Duo 96G(合计 192GB,MindIE /vLLM-Ascend,W8A8,TP+EP 专家并行)
模型:284B MoE,激活 13B,原生 1M 上下文;昇腾无 DFlash2,仅可使用 DeepSeek 原生 DSpark 投机(vLLM-Ascend 支持,MindIE 暂不支持 DSpark)
架构:问答一体机内网 API 调用算力服务器,医院场景,病历长文本一、Decode token/s(单流 batch=1,非思考模式,最常用)
方案 1:MindIE(无 DSpark 投机,生产稳定优先,投标推荐)
- 短 Prompt(1K token,普通问诊):48 ~54 token/s
- 长病历 32K 上下文:44 ~50 token/s
- 超长 1M 上下文(整份病案一次性灌入):40 ~46 token/s
TTFT(首 token 延迟):1M 上下文 prefill 很慢,数十秒级别,适合后台批量病案分析,不适合医生交互式实时问答。
方案 2:vLLM-Ascend + DSpark(DeepSeek 原生投机解码,提速)
开启 DSpark 后,单流可提升约 30%
- 短 Prompt(1K):60 ~66 token/s
- 长病历 32K:54 ~60 token/s
- 1M 超长上下文:48 ~54 token/s
注意:DSpark 会增加推理引擎复杂度,医院生产环境需要充分压测验证稳定性。
二、并发吞吐(MindIE,无 DSpark)
- 2 并发(2 名医生同时调用问答一体机):单流下降至 40~44 token/s,整机总吞吐≈82~88 token/s
短板:MoE 专家路由 + LPDDR4X 带宽瓶颈,并发不能开高;推荐≤2 并发,仅适合少量医生做深度病案质控,不适合多人日常问答。
三、关键限制(医院项目重点,写进技术方案)
- 显存边界:2×Atlas300I Duo 合计 192GB,刚好放下 DeepSeek-V4-Flash W8A8 权重,KV 缓存余量紧张;不建议同时加载其他模型(如 Qwen-VL 图片解析)。
- Prefill 速度短板:百万级长病历输入,首 token 等待时间很长,交互式问答体验差;该模型更适合后台批量病案深度分析,而不是医生实时问答。
- 昇腾 LPDDR 带宽瓶颈:对比 Atlas300I A2(HBM),Duo 的 LPDDR4X 带宽低,MoE 专家调度时显存访问延迟更高,是速度上限的核心原因。
- 思考模式(reasoning_effort high/max):开启思考模式后,token/s 会进一步下降 25%~35%。
-
-
没用过这张卡,给几条「下单前必须过」的判据——豆包那种整段参数,缺的恰恰是决定成败的三样:
-
支持矩阵先落地。昇腾的 MoE + W8A8 + 专家并行(EP)在 MindIE / vLLM-Ascend 上是按「具体卡型 + 框架版本」白名单走的,310P 和 910B/910C 不是同一档。让方案方给「CANN / MindIE / vLLM-Ascend 版本 + 该版本支持 310P 跑 W8A8 MoE」的官方链接,给不出就基本是纸上参数。
-
先算带宽墙。284B MoE 激活 13B,W8A8 下每 token decode 至少要读约 13GB 活跃权重;要到 70 tok/s,光权重就需 ~900GB/s 以上的有效带宽,还没算 KV 和 EP 通信。310P 走 LPDDR4X,单卡是几百 GB/s 量级,单流 70 t/s 在 decode 段对不上。请对方把 pp / tg 拆开、标明 ctx 与 batch,别只给一个总数。
-
长上下文是第二道坎。医院病历那种接近 1M 的输入,prefill 是 O(n²) 注意力 + 每层 EP/TP 通信,卡间走 PCIe/网卡,prefill 延迟和成本会比 decode 更先爆。要问清「内网 API 调用」后面是不是共享算力池,并发一上来单流还保不保得住。
-
别拿口头数据下单。这类一体机最靠谱的是让对方做 POC,或在同型号上复现你的真实病历长度与并发;再横向对比 2×R9700 32G / 4090 的总拥有成本(卡价 + 整机 + 软件栈迁移/人力),310P 的生态要单独算。
结论:昇腾做推理不是不能,但「2 张 300I Duo(合计 192G)、单流 70 t/s」这种描述,缺的正是支持矩阵、带宽账、长上下文实测。先要到这三样再谈采购。
-
-
-
特殊场景:可能不让用 NV 或 AMD
-




