跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 09-30: 挺不错的swift 1.5 27B模型,思考更少,双3090测试 VLLM PK buun llama!

09-30: 挺不错的swift 1.5 27B模型,思考更少,双3090测试 VLLM PK buun llama!

已定时 已固定 已锁定 已移动 LLM讨论区
rtx3090vllmllama.cpp
19 帖子 5 发布者 533 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • stxpnetS
    stxpnetS
    stxpnet
    王侯将相
    编写于 最后由 stxpnet 编辑
    #1

    {1EE5249C-D7A3-45CE-9BB9-D5242BF2827B}.jpeg

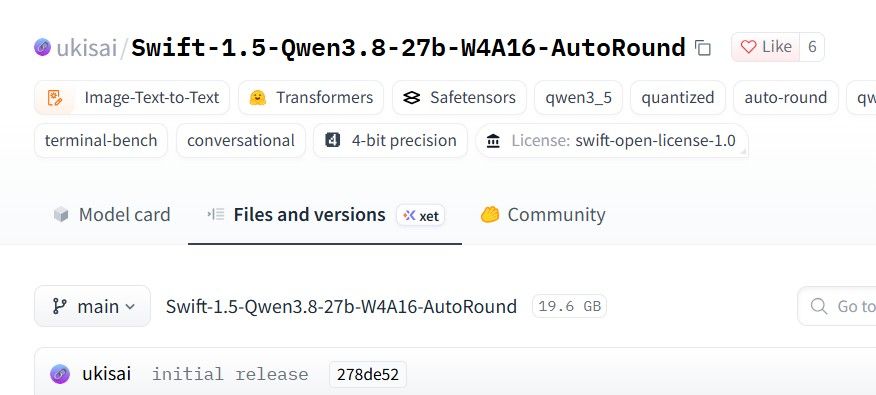
    5天下载量约74K。
    号称综合分数超越原版,根治雷霆思考。

    我看它的形态和noonghunna 的ultrafast档位差不多,所以直接套用那边的启动参数,把模型换成这个。 KV缓存采用INT8量化,双并行,每槽188K上下文. 总可用约400K上下文,但我没有跑完过。
    单流的时候每张显卡各占用21.5G左右。

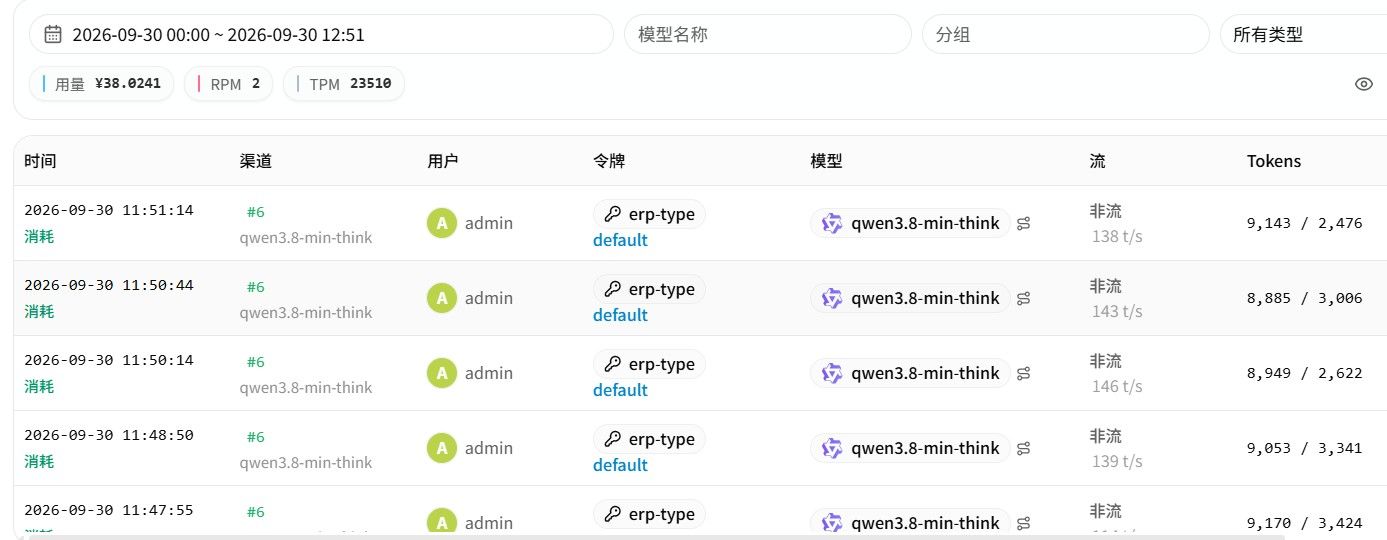
    用来跑我的报表任务,比以前快了2倍,质量没有下降:
    {46E4DBCA-0338-4B92-99A5-D1AA9111F218}.jpeg

    都是单个不到10K TOKEN的任务,所以能爆发峰值 160t/s 左右。

    实际报表处理速度达到以前W8A8的1.6倍左右。
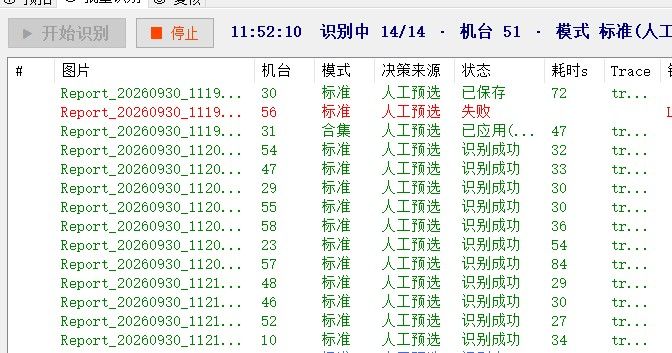
    image.jpeg

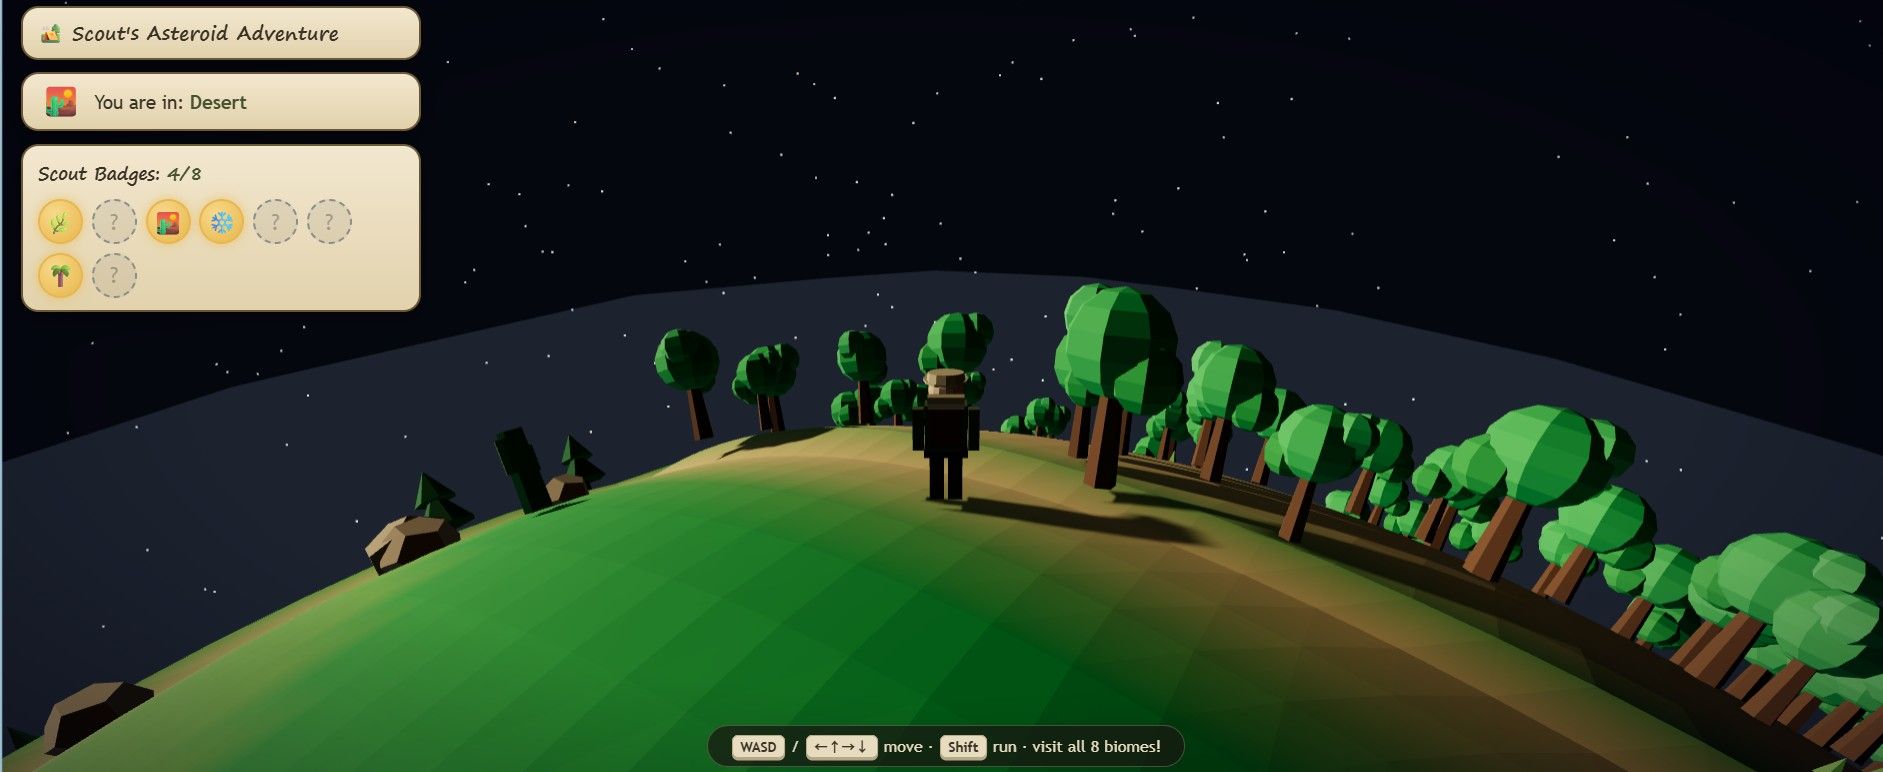
    用opencode 调用 它来写的小小星球,用时10分钟左右:
    {72C9E859-787B-4FCC-B537-D19DD98F211B}.jpeg

    提示词:用HTML5创建一个3D小行星地球,玩家可以在上面行走,并且它包含所有这些可以探索的生物群落(biomes),星球不必太大,但走起来依然有趣。故事背景是一个正在露营并四处探索的童子军男孩。游戏要有server.py,启动后随机寻找一个本机的空闲端口作为服务器,并自动从默认浏览器打开让用户试玩
    

    总的来说感觉不错。希望尽快有人把它的qwen 3.8 flashnext 移植到 ampere平台。

    双卡3090 PCIE 4.0 16X/16X

    白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
    夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
    1 条回复 最后回复
    4
    • stxpnetS
      stxpnetS
      stxpnet
      王侯将相
      编写于 最后由 stxpnet 编辑
      #2
      
      
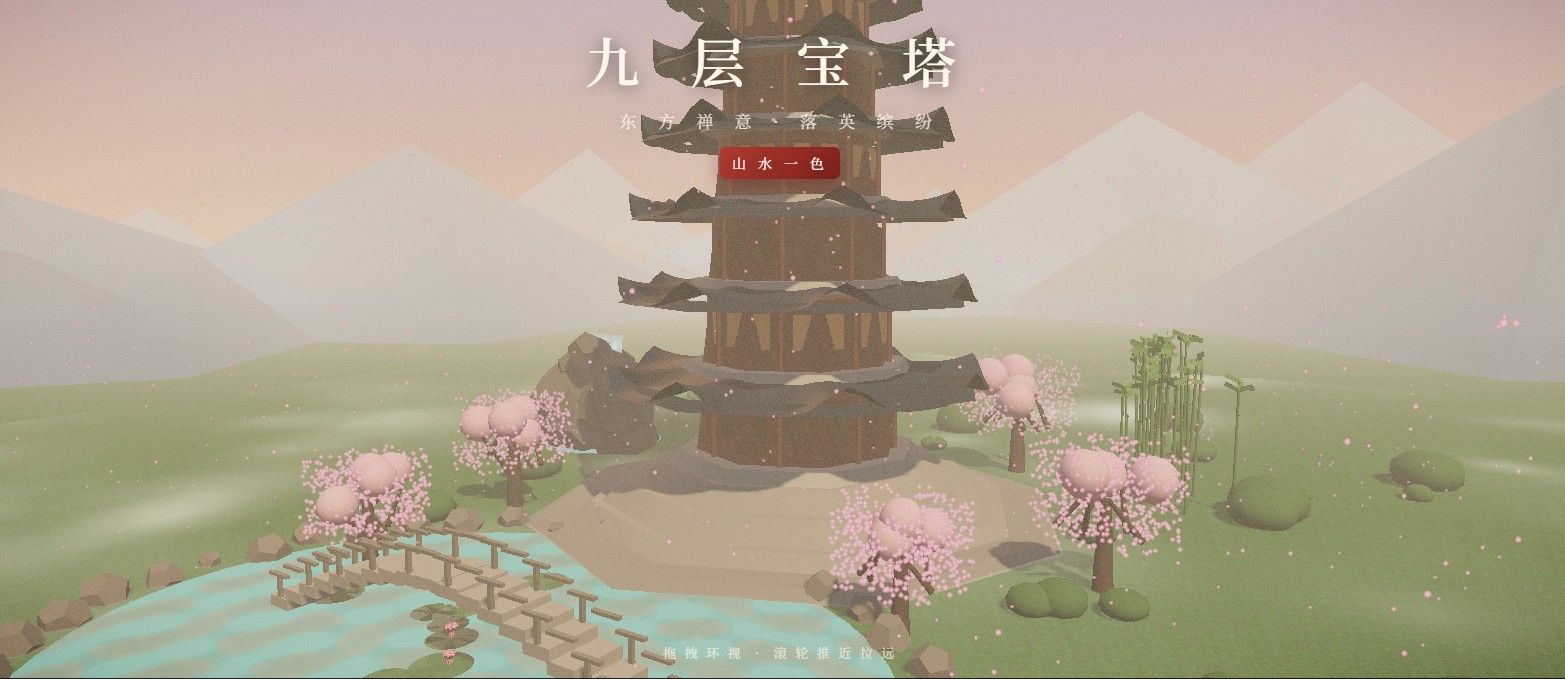
      用HTML,WEBGL,three.js或其它你认为合适的技术,创建一座宏伟精美的中国传统九层宝塔,坐落在一座充满东方禅意的中式古典花园中央。花园里有盛开的粉色樱花树、青翠的竹林、清澈的小池塘、弯曲的小石桥和流淌的小瀑布。池面有微波和睡莲,落英缤纷。柔和的阳光透过树叶洒下斑驳的光影,远处有朦胧的山雾,电影级光影,尽可能高的分辨率,极致的细节,唯美,梦幻,中国风,确保构图充满活力、色彩斑斓且视觉效果引人注目。
      先规划需求,然后再拆分组件模块,以经典的软件工程思想来完成本项目。
      

      12点08分开始,挑战一下宝塔花园HTML。
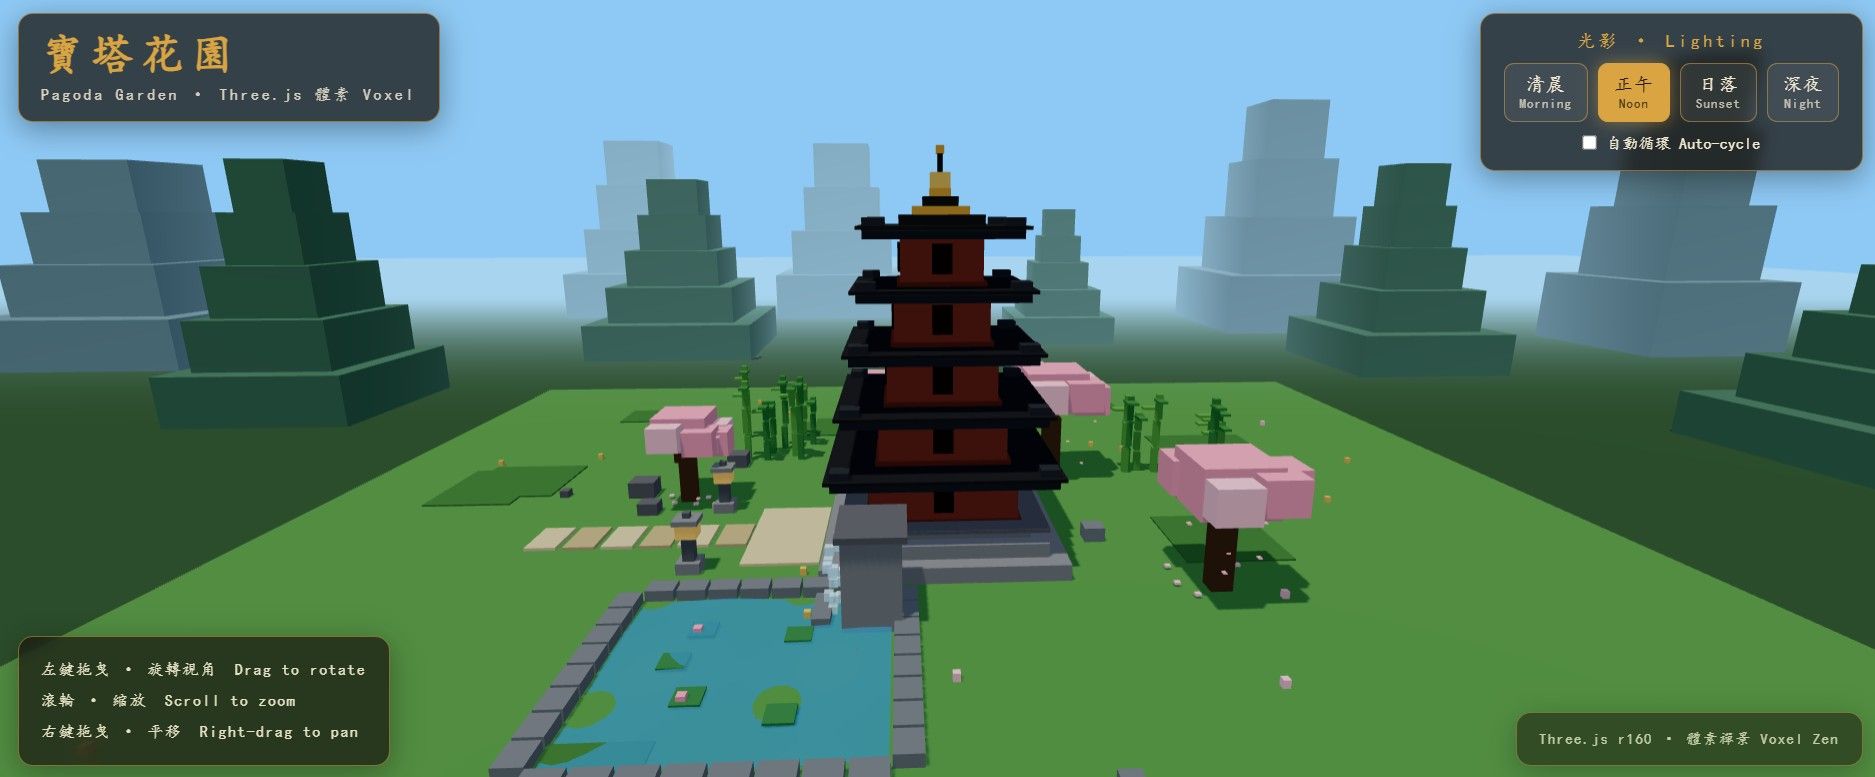
      做了32分钟,感觉太久了,不想做了,中止,看下它32分钟弄出来的半成品:
      {C46FBC39-51DC-402D-966B-6E8728465AF8}.jpeg

      双卡3090 PCIE 4.0 16X/16X

      白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
      夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
      kos orK 1 条回复 最后回复
      0
      • stxpnetS
        stxpnetS
        stxpnet
        王侯将相
        编写于 最后由 编辑
        #3

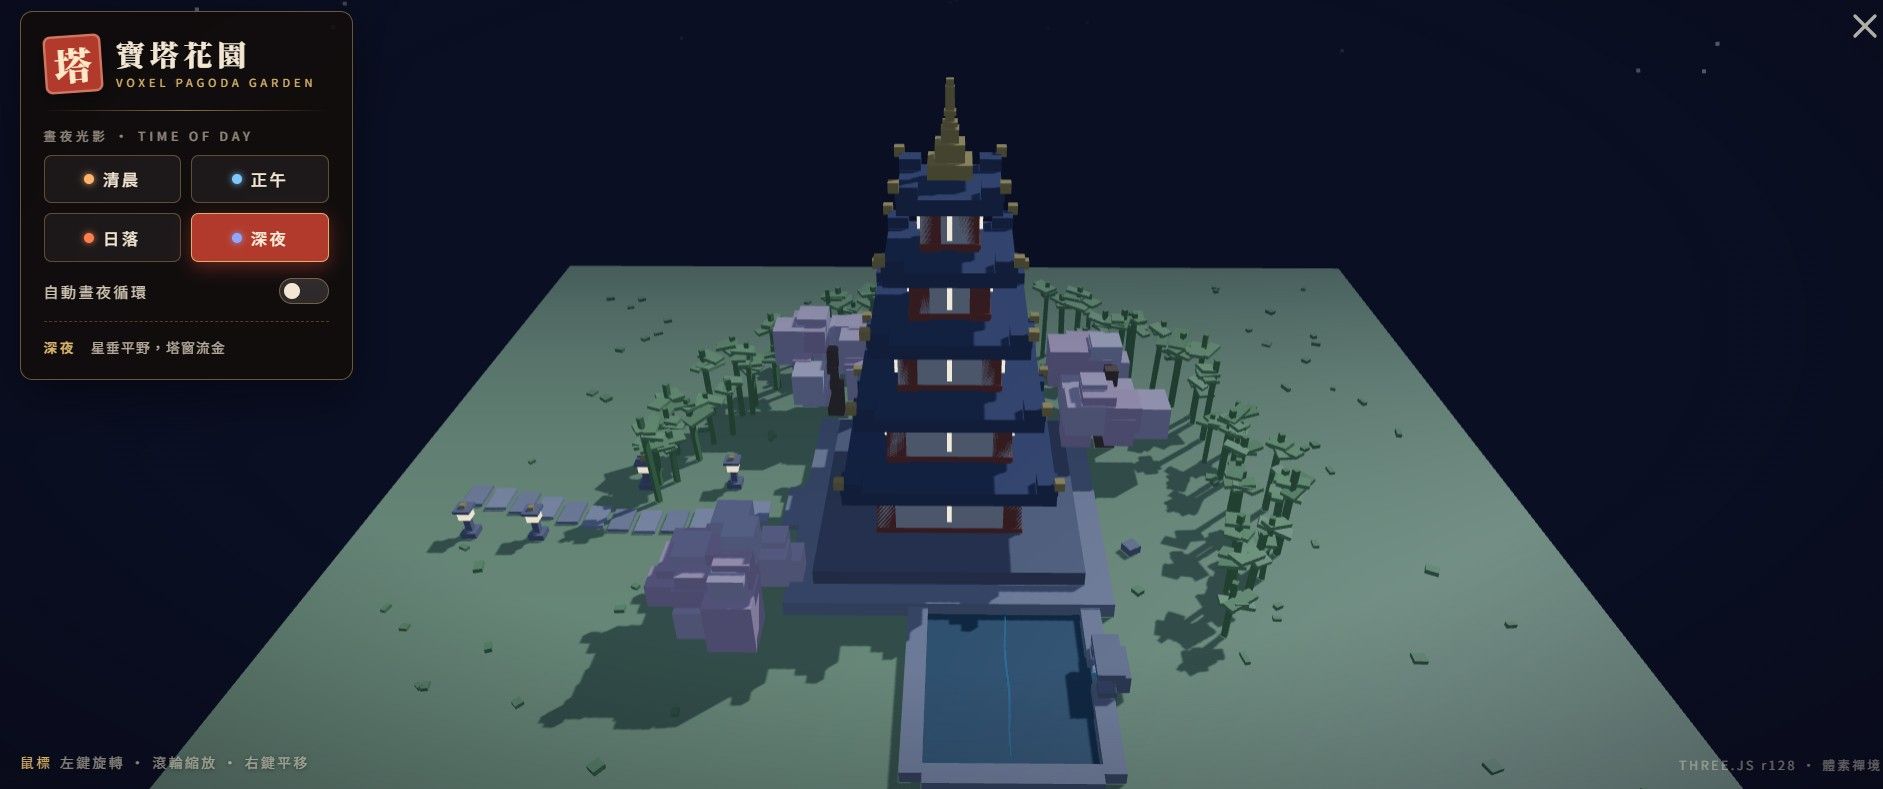
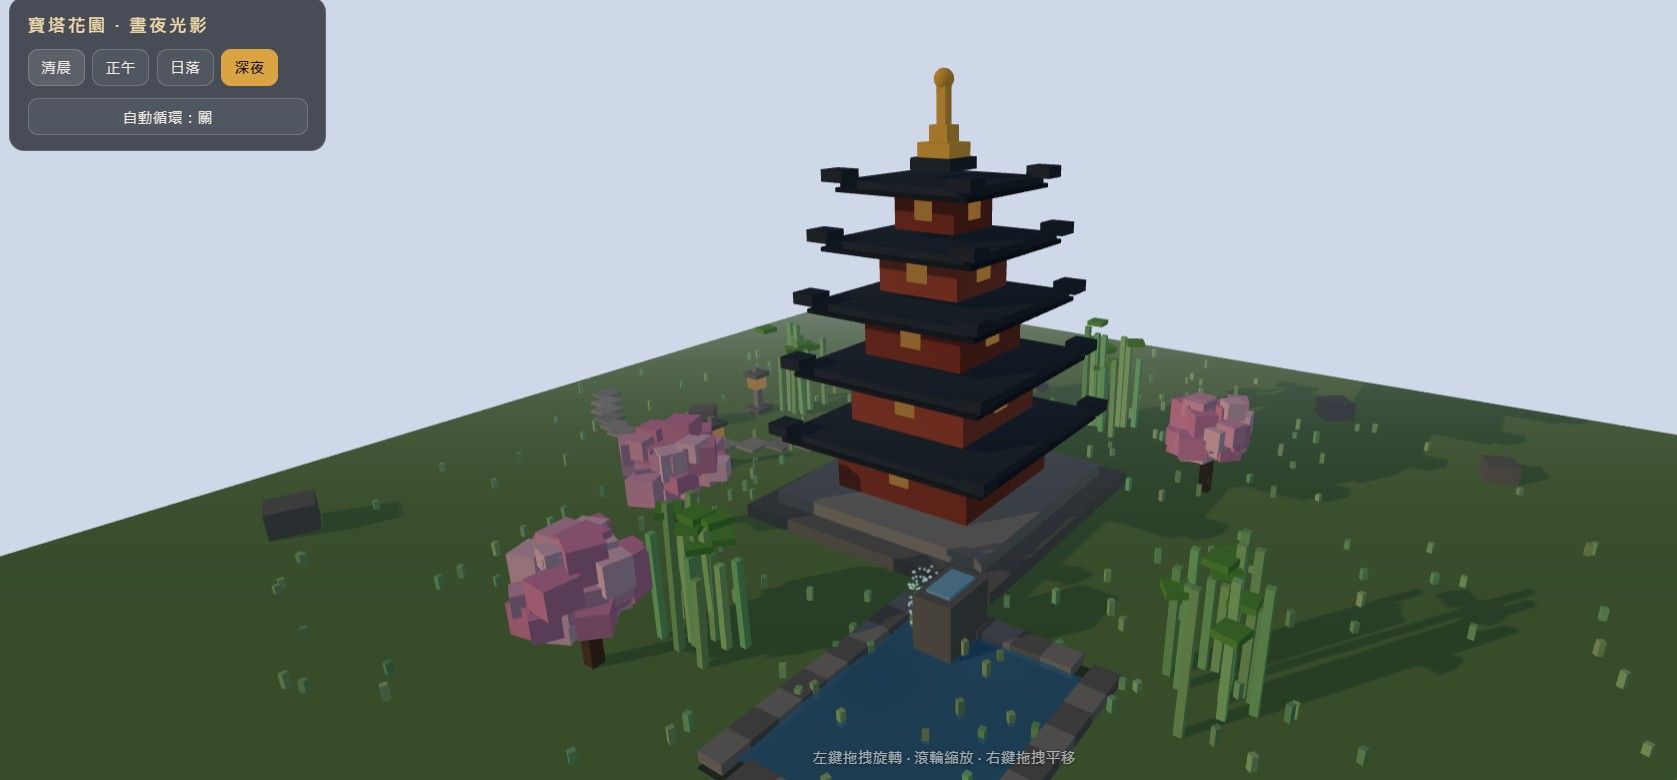
        换个提示词,换最高思考,明确要求它先出MVP,减少视觉测试,然后它思考了4分半钟,用15分钟做出的效果:
        {0FE95413-B269-4576-9075-45D38DF5B34A}.jpeg

        双卡3090 PCIE 4.0 16X/16X

        白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
        夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
        1 条回复 最后回复
        0
        • 张光璞张
          张光璞张
          张光璞
          贵族大夫 硕果累累
          编写于 最后由 编辑
          #4

          双3090 跑的?

          1 条回复 最后回复
          0
          • terryT
            terryT
            terry
            易有太极
            编写于 最后由 编辑
            #5

            不错,值得尝试,最近太多新东西,都忙不过来了

            油管:https://www.youtube.com/@抡锤者

            1 条回复 最后回复
            0
            • stxpnetS
              stxpnetS
              stxpnet
              王侯将相
              编写于 最后由 stxpnet 编辑
              #6

              继续测,这是Swift-1.5-Qwen3.8-27B-Uncensored-Dynamic-MTP-UD-IQ4_XS.gguf 13.3G
              上游模型为swift 1.5最新版,使用unsloth ud 3.0压缩成。
              buun llama.cpp 分支 mtp n max =2
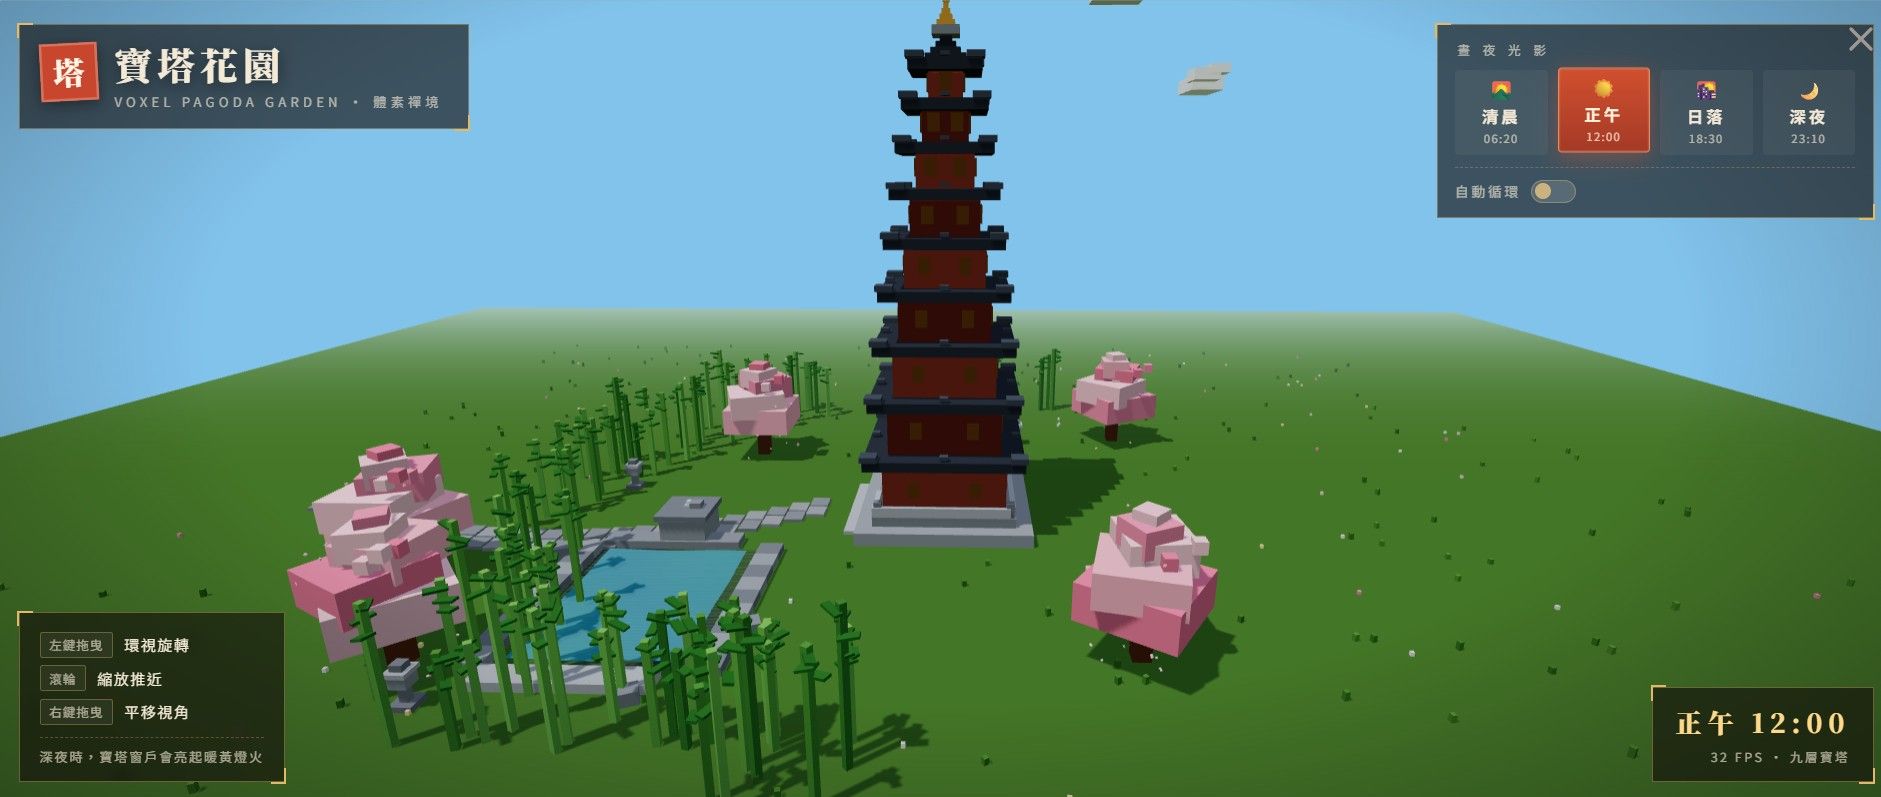
              满上下文测出来的,直接在WEBUI上面跑,用时4分52秒。 感觉UD的潜力挺深啊!
              从75T左右起步 ,开始写代码的时候就会加速 ,最终82t/s :
              {EE115B11-911C-4966-AC15-ED2375248B46}.jpeg

              {581FBC54-7FA4-4AD9-8CF2-560CC47755A2}.jpeg

              262K上下文,单流,带视觉。K V 缓存用双turbo8,实际双卡占用13G+14G 。
              下一楼开测Q4_K_XL!

              双卡3090 PCIE 4.0 16X/16X

              白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
              夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
              1 条回复 最后回复
              0
              • stxpnetS
                stxpnetS
                stxpnet
                王侯将相
                编写于 最后由 stxpnet 编辑
                #7

                buun llama使用的这个提示词,和vllm有一点点差异:

                請使用單個獨立的 HTML 文件,編寫一個基於 Three.js 的 3D 体素風格(Voxel Style)「寶塔花園」互動網頁。代碼必須包含完整的 HTML、CSS 和 JavaScript,並且可以直接在 Chrome 瀏覽器中運行。
                核心場景要求:
                1. 中式寶塔(Pagoda): 在場景中央建立一座多層(如 5 层或 9 层)的中式寶塔。外觀需具備體素方塊特徵,擁有層層收分的飛簷和寶頂結構。
                2. 禪意花園(Garden): 圍繞寶塔布置花園。包含幾棵盛開的體素粉色櫻花樹、環繞的綠色竹林、一條用方塊鋪成的小徑,以及一個清澈的池塘。
                3. 動態水體(Water): 池塘需有動態的水面微波效果,並設計一個簡單的體素小瀑布,水流有向下的粒子或位移效果。
                視覺與交互要求:
                1. 動態光影切換: 介面上設計一個按鈕(或自動循環),可在「清晨、正午、日落、深夜」四種晝夜環境光影(Lighting)之間切換,寶塔的窗戶在深夜會發出暖黃色的光。
                2. 相機控制: 整合 OrbitControls,允許用戶通過鼠標進行旋轉、縮放和拖拽視角。
                3. 代碼規範: 所有 Three.js 庫(包括主庫、OrbitControls 等)請使用穩定且可用的 CDN 鏈接引入。代碼結構清晰,一次性生成完整可運行的單文件,不要使用省略號。
                4.先规划需求,然后再拆分组件模块,以经典的软件工程思想来完成本项目。
                

                这个分支的思考开关又是坏的,我也懒得弄了。可能是调用的med think档位:
                这次使用 Swift-1.5-Qwen3.8-27B-Uncensored-ajgazin-Dynamic-MTP-UD-Q4_K_XL.gguf 16.4GB
                双F16 K V缓存,显卡占用,18GB+ 17GB,余量还比较充足!
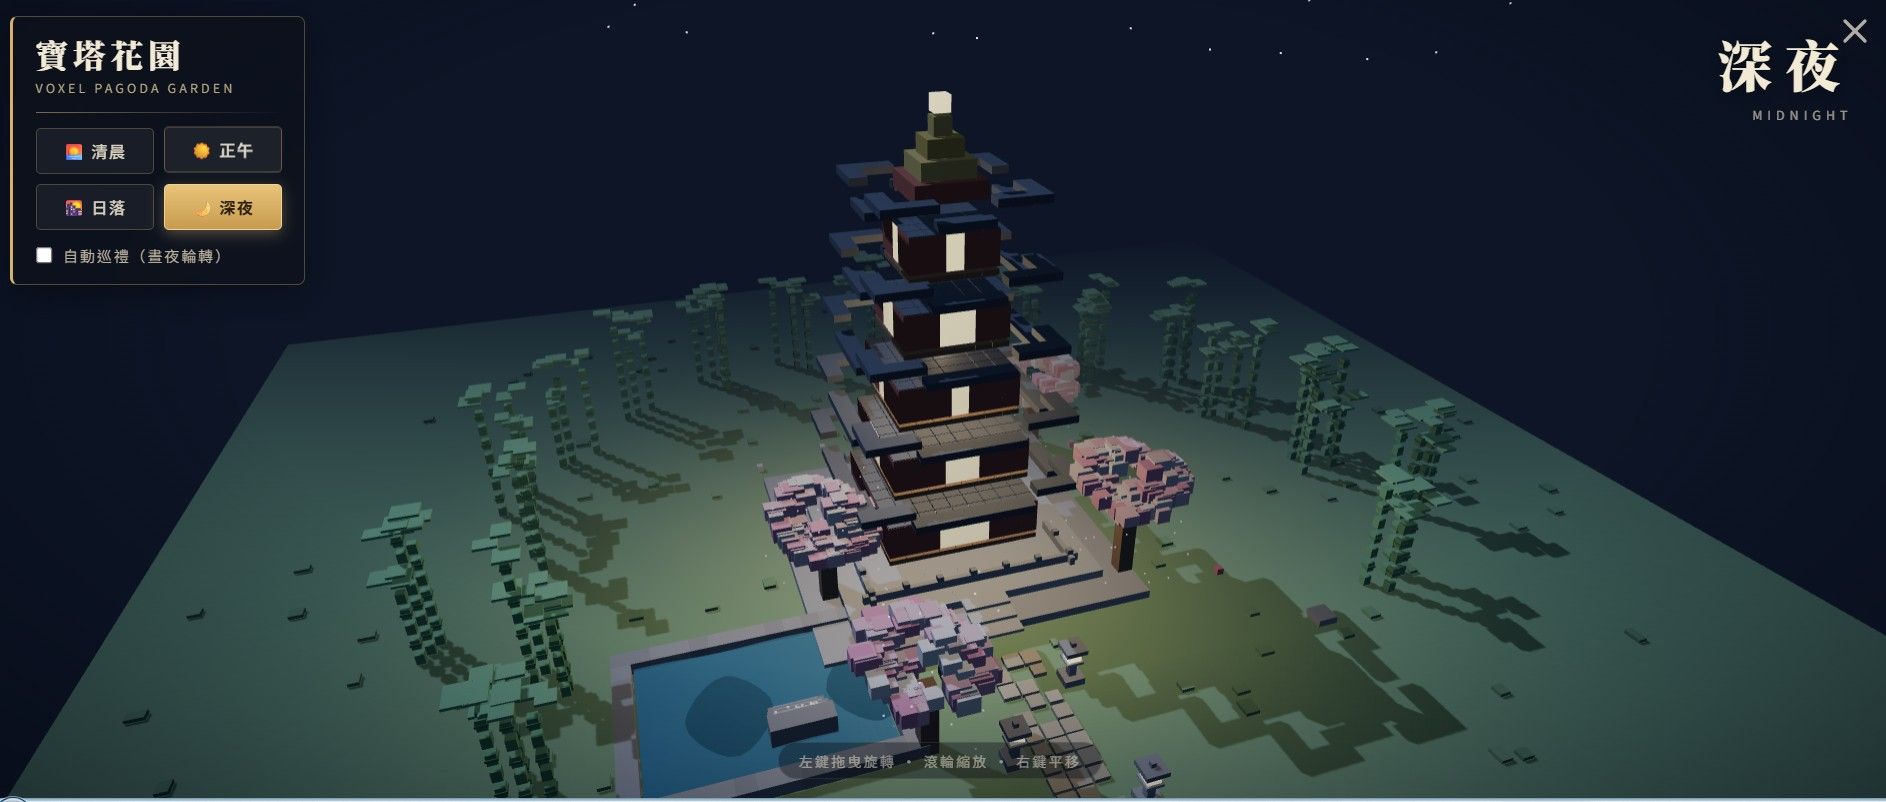
                prefill 584 t/s . 起步70t/s左右 ,这个量化等级比IQ4_XS占用的GPU要大一些,接近100%。 用时5分钟完成:
                {5D59033F-BFA9-418B-9975-2009A25E33B0}.jpeg

                F16反而翻车,除夜晚外都是一片惨白,而且没有IQ4_XS那么细腻。
                {A621E393-91CF-445F-8060-398FF7EA82A0}.jpeg

                还是用双Q8_0再试一下这个GGUF:
                占用显存16.6G + 15.5G。中途大概65t/s. 还是5分钟完成,但是效果依然不如iq4_xs. 白光没有处理好.
                {0255F1C8-ED9B-4015-822E-6F6ACDD4C7DA}.jpeg

                双turbo8 k v cache 用时4分50秒。:
                直接翻车了,只有背景,没有任何物体出现。

                不测了,最终采纳的启动参数:

                sudo prlimit --memlock=unlimited:unlimited --pid $$
                killall llama3-server 2>/dev/null; sleep 3
                killall llama-server 2>/dev/null; sleep 3
                export MTMD_BACKEND_DEVICE=CUDA1
                export GGML_CUDA_GRAPH_OPT=1
                export CUDA_VISIBLE_DEVICES=0,1
                export NCCL_P2P_DISABLE=0 NCCL_SHM_DISABLE=0
                /n1/llama2609/buun-llama-cpp/build/bin/llama-server \
                 -m /n1/Swift-1.5-Qwen3.8-27B-Uncensored-Dynamic-MTP-UD-IQ4_XS.gguf \
                 --mmproj /n2/mmproj-BF16-swift-1.5-ajgazin.gguf \
                 -sm tensor -ts 50,50 -ngl 99 -fa on \
                 --props --ctx-checkpoints 64 \
                 --fit off --kv-unified -t 16 -tb 16 \
                   --image-min-tokens 1024 --image-max-tokens 4096 \
                 -b 8192 -ub 2048 --reasoning-preserve --cache-ram 32384 \
                 --spec-type draft-mtp --spec-draft-n-max 2 \
                 -ctk turbo8 -ctv turbo8 \
                 -c 262144 -np 1 \
                 --jinja \
                 --api-key "$(head -1 /home/oakcn/dev/api-key.txt)" \
                 --alias qwen3.8-27b-mat-awq \
                 --host 0.0.0.0 --port 8025
                

                双卡3090 PCIE 4.0 16X/16X

                白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                1 条回复 最后回复
                0
                • 张光璞张
                  张光璞张
                  张光璞
                  贵族大夫 硕果累累
                  编写于 最后由 编辑
                  #8

                  已经在下了,现在的W4A16 想得太多

                  1 条回复 最后回复
                  0
                  • kos orK
                    kos orK
                    kos or
                    至尊皇帝
                    编写于 最后由 编辑
                    #9

                    原版的雷霆思考 不是可以透過Reasoning Efforts 參數調整嗎?效果不好嗎?

                    张光璞张 1 条回复 最后回复
                    0
                    • kos orK kos or

                      原版的雷霆思考 不是可以透過Reasoning Efforts 參數調整嗎?效果不好嗎?

                      张光璞张
                      张光璞张
                      张光璞
                      贵族大夫 硕果累累
                      编写于 最后由 编辑
                      #10

                      @kos-or 说:

                      原版的雷霆思考 不是可以透過Reasoning Efforts 參數調整嗎?效果不好嗎?

                      我自己量化的W8A16 思想就像脱缰的野马

                      估计是量化过程中伤了神经。

                      1 条回复 最后回复
                      0
                      • stxpnetS stxpnet
                        
                        
                        用HTML,WEBGL,three.js或其它你认为合适的技术,创建一座宏伟精美的中国传统九层宝塔,坐落在一座充满东方禅意的中式古典花园中央。花园里有盛开的粉色樱花树、青翠的竹林、清澈的小池塘、弯曲的小石桥和流淌的小瀑布。池面有微波和睡莲,落英缤纷。柔和的阳光透过树叶洒下斑驳的光影,远处有朦胧的山雾,电影级光影,尽可能高的分辨率,极致的细节,唯美,梦幻,中国风,确保构图充满活力、色彩斑斓且视觉效果引人注目。
                        先规划需求,然后再拆分组件模块,以经典的软件工程思想来完成本项目。
                        

                        12点08分开始,挑战一下宝塔花园HTML。
                        做了32分钟,感觉太久了,不想做了,中止,看下它32分钟弄出来的半成品:
                        {C46FBC39-51DC-402D-966B-6E8728465AF8}.jpeg

                        kos orK
                        kos orK
                        kos or
                        至尊皇帝
                        编写于 最后由 kos or 编辑
                        #11

                        @stxpnet said:

                        12点08分开始,挑战一下宝塔花园HTML。
                        做了32分钟,感觉太久了,不想做了,中止,看下它32分钟弄出来的半成品:

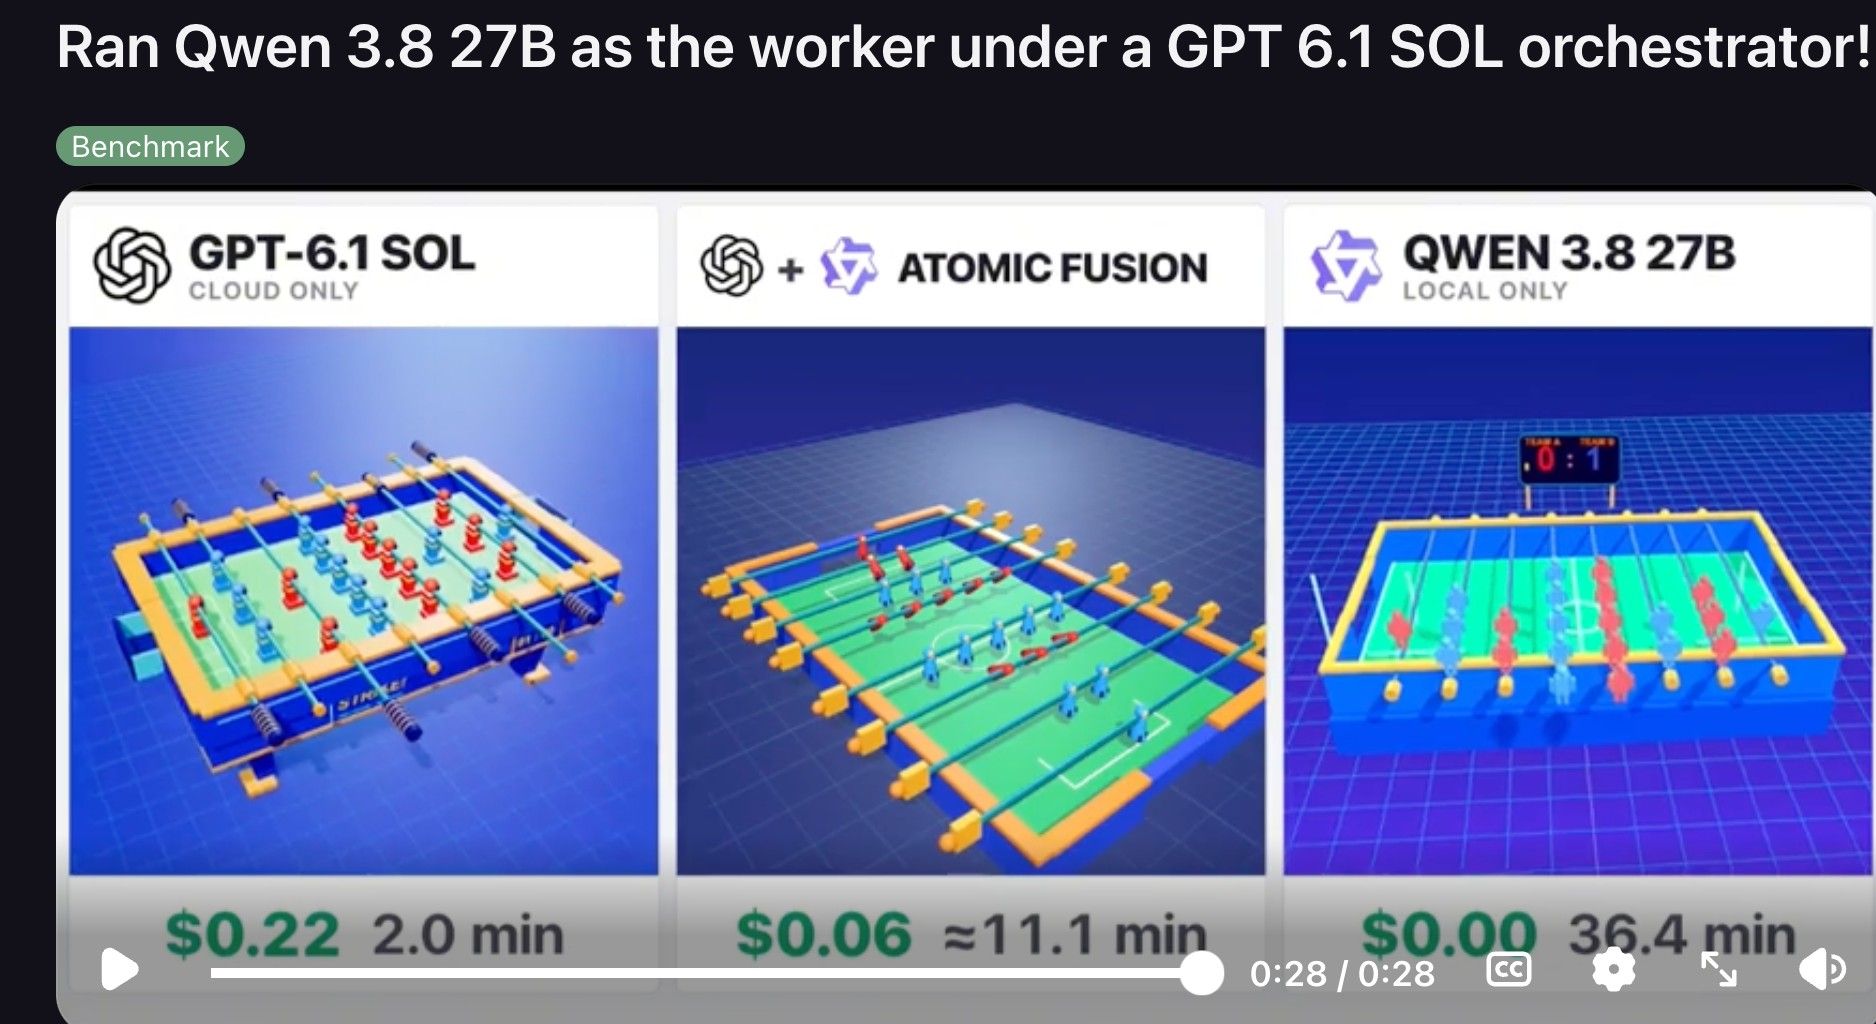
                        網路上有人測試過

                        GPT6.0-SOL 負責規劃 + Qwen3.8-27B 負責執行 產出時間可以節省7成, 產出品質效果更好

                        image.jpeg

                        张光璞张 stxpnetS 2 条回复 最后回复
                        0
                        • kos orK kos or

                          @stxpnet said:

                          12点08分开始,挑战一下宝塔花园HTML。
                          做了32分钟,感觉太久了,不想做了,中止,看下它32分钟弄出来的半成品:

                          網路上有人測試過

                          GPT6.0-SOL 負責規劃 + Qwen3.8-27B 負責執行 產出時間可以節省7成, 產出品質效果更好

                          image.jpeg

                          张光璞张
                          张光璞张
                          张光璞
                          贵族大夫 硕果累累
                          编写于 最后由 编辑
                          #12

                          @kos-or 说:

                          @stxpnet said:

                          12点08分开始,挑战一下宝塔花园HTML。
                          做了32分钟,感觉太久了,不想做了,中止,看下它32分钟弄出来的半成品:

                          網路上有人測試過

                          GPT6.0-SOL 負責規劃 + Qwen3.8-27B 負責執行 產出時間可以節省7成, 產出品質效果更好

                          image.jpeg

                          建美术模型还好,但工业模型全是参数化建模的,理论上来讲更容易才对。

                          ai本来就擅长干这种一板一眼的事情。

                          1 条回复 最后回复
                          0
                          • kos orK kos or

                            @stxpnet said:

                            12点08分开始,挑战一下宝塔花园HTML。
                            做了32分钟,感觉太久了,不想做了,中止,看下它32分钟弄出来的半成品:

                            網路上有人測試過

                            GPT6.0-SOL 負責規劃 + Qwen3.8-27B 負責執行 產出時間可以節省7成, 產出品質效果更好

                            image.jpeg

                            stxpnetS
                            stxpnetS
                            stxpnet
                            王侯将相
                            编写于 最后由 编辑
                            #13

                            @kos-or 大模型带小模型确实不错,但是这样玩多了,资本家会不会发现,然后故意捣乱,或者修改条款呢?

                            双卡3090 PCIE 4.0 16X/16X

                            白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                            夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                            kos orK 1 条回复 最后回复
                            0
                            • stxpnetS
                              stxpnetS
                              stxpnet
                              王侯将相
                              编写于 最后由 stxpnet 编辑
                              #14

                              {974E76CD-2657-4307-A94B-C3B41808AD8A}.jpeg
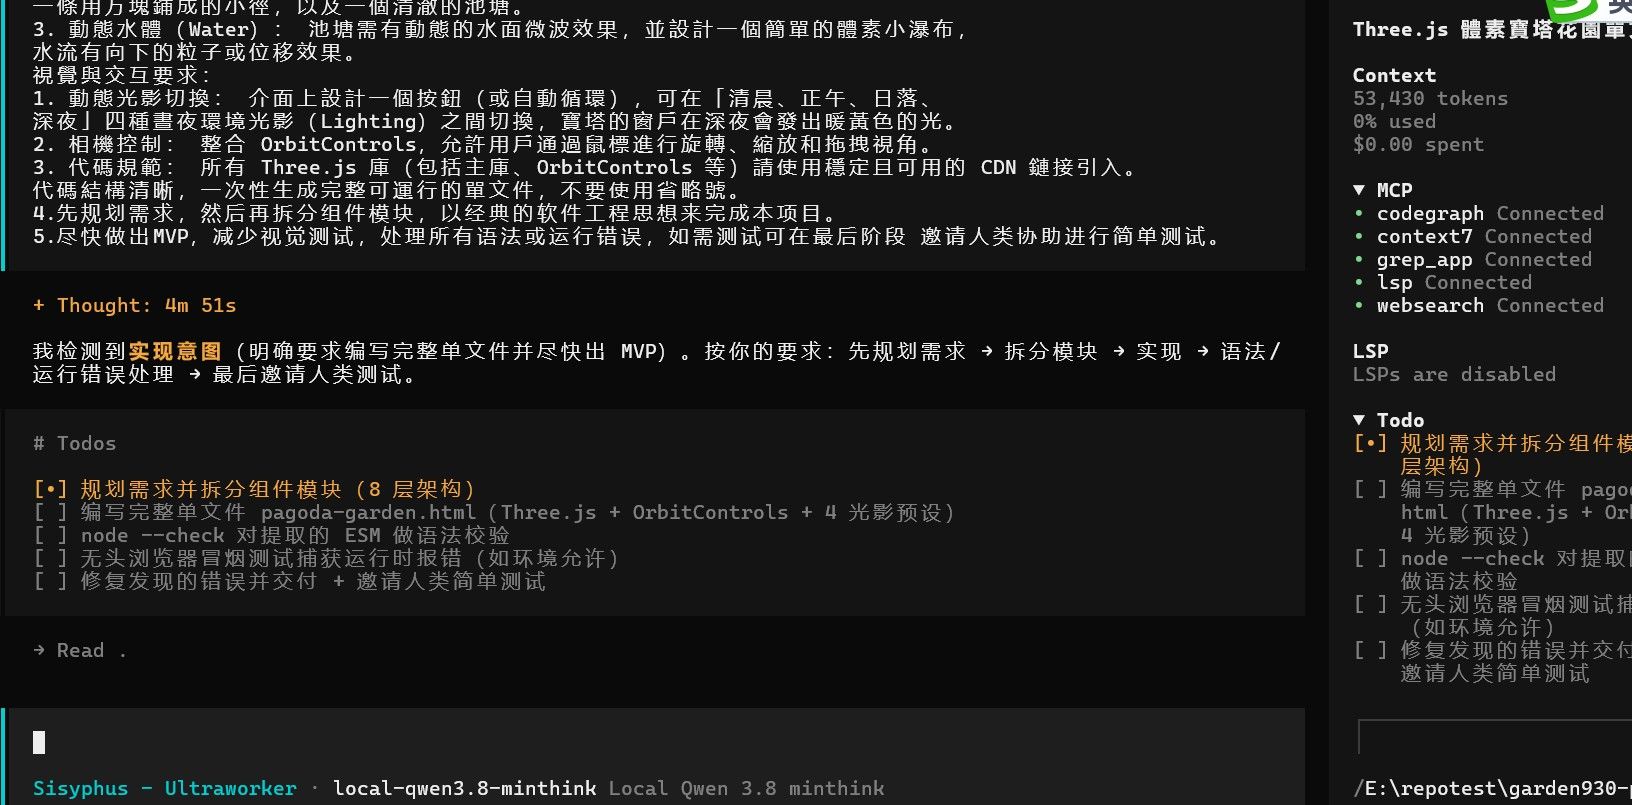
                              现在把opencode接入这个iq4_xs 的双流,看一下写出来的会不会比网页版效果更好。

                              {1BC09438-3D76-4C95-BE10-ABF7EF9A0092}.jpeg

                              权重和KV CACHE一样的情况下,做出来的东西都是一个样!

                              双卡3090 PCIE 4.0 16X/16X

                              白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                              夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                              1 条回复 最后回复
                              1
                              • stxpnetS stxpnet

                                @kos-or 大模型带小模型确实不错,但是这样玩多了,资本家会不会发现,然后故意捣乱,或者修改条款呢?

                                kos orK
                                kos orK
                                kos or
                                至尊皇帝
                                编写于 最后由 kos or 编辑
                                #15

                                @stxpnet said:

                                但是这样玩多了,资本家会不会发现,然后故意捣乱,或者修改条款呢

                                不會 因為大家都對AI 沒興趣, 更何況是要買顯卡 更沒興趣, 又要浪費時間(對沒興趣的大眾來說)
                                玩地端本地模型折騰 是自我虐待 所以只有極少數的人會這樣使用
                                Codex Luna 一個月20美元 都用不完了

                                去大馬路上 問100個人 願意花錢買顯卡玩本機模型的可能不到1個人
                                我認識一位網頁工程師, 他勉為其難終於買了一張顯卡 5060 Ti 16G
                                另位一從事自動化的工程師,他只願意使用免費的Gemini, 要買顯卡?免談

                                1 条回复 最后回复
                                0
                                • 张光璞张
                                  张光璞张
                                  张光璞
                                  贵族大夫 硕果累累
                                  编写于 最后由 编辑
                                  #16

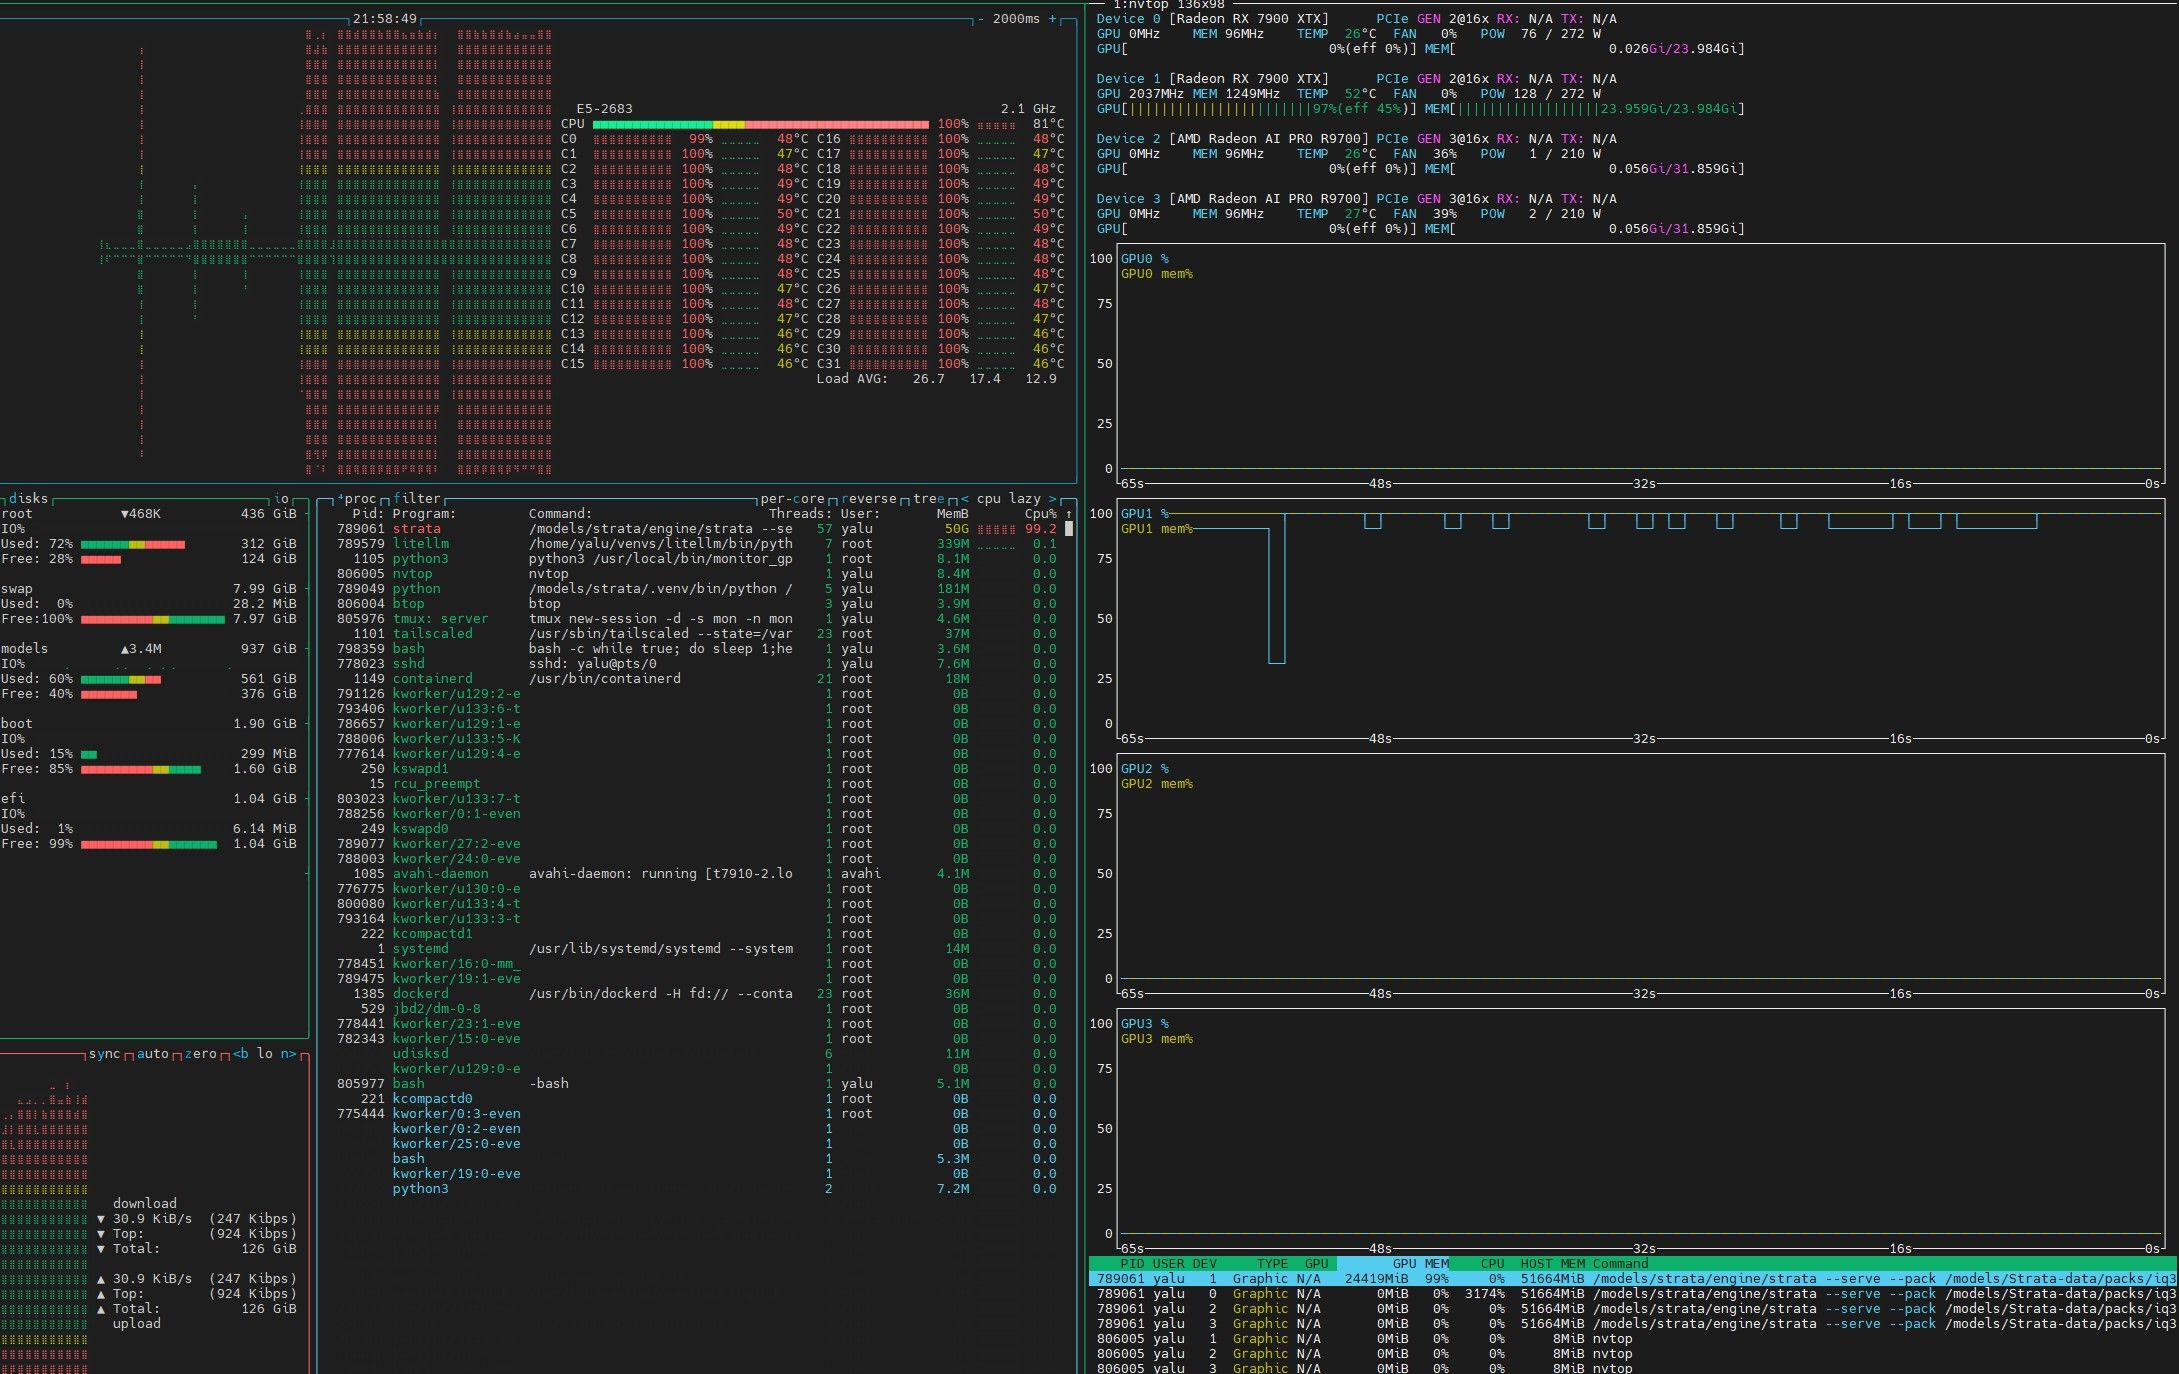
                                  我发现这个框架推理的时候,CPU占用率特别高

                                  image.jpeg

                                  1 条回复 最后回复
                                  0
                                  • stxpnetS
                                    stxpnetS
                                    stxpnet
                                    王侯将相
                                    编写于 最后由 编辑
                                    #17

                                    我反而想让CPU高点都不行。 你的是四卡 异构啊,怎么没试一下tabby api? 我只用buun 跑过双卡 张量并行。

                                    双卡3090 PCIE 4.0 16X/16X

                                    白天(宰相) Strata QFN3.8 IQ4_XS 262K ~120 t/s
                                    夜间(将军) vllm+swift 1.5 27B INT4-W4A8-dflash2 188K X 2 ~85 t/s
                                    张光璞张 1 条回复 最后回复
                                    0
                                    • 懒人烘培懒
                                      懒人烘培懒
                                      懒人烘培
                                      体面乡绅 硕果累累
                                      编写于 最后由 编辑
                                      #18

                                      不错,有时间我也在我那个双7900XTX部署一下

                                      双 7900 XTX:模型本地跑,Token 随便烧!

                                      1 条回复 最后回复
                                      0
                                      • stxpnetS stxpnet

                                        我反而想让CPU高点都不行。 你的是四卡 异构啊,怎么没试一下tabby api? 我只用buun 跑过双卡 张量并行。

                                        张光璞张
                                        张光璞张
                                        张光璞
                                        贵族大夫 硕果累累
                                        编写于 最后由 张光璞 编辑
                                        #19

                                        @stxpnet 说:

                                        我反而想让CPU高点都不行。 你的是四卡 异构啊,怎么没试一下tabby api? 我只用buun 跑过双卡 张量并行。

                                        SB了,我是跑的Qwen3.8-flash . 现在准备跑Swift1.5

                                        1 条回复 最后回复
                                        0

                                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                        有了你的建议,这篇帖子会更精彩哦 💗

                                        注册 登录
                                        回复
                                        • 在新帖中回复
                                        登录后回复
                                        • 从旧到新
                                        • 从新到旧
                                        • 最多赞同


                                        • 登录

                                        • 登录或注册以进行搜索。
                                        • 第一个帖子
                                          最后一个帖子
                                        0
                                        • 版块
                                        • 最新
                                        • 标签
                                        • 热门
                                        • 用户
                                        • 群组