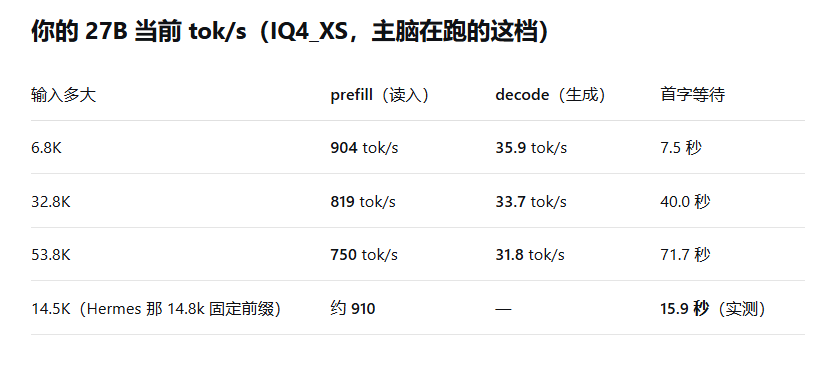
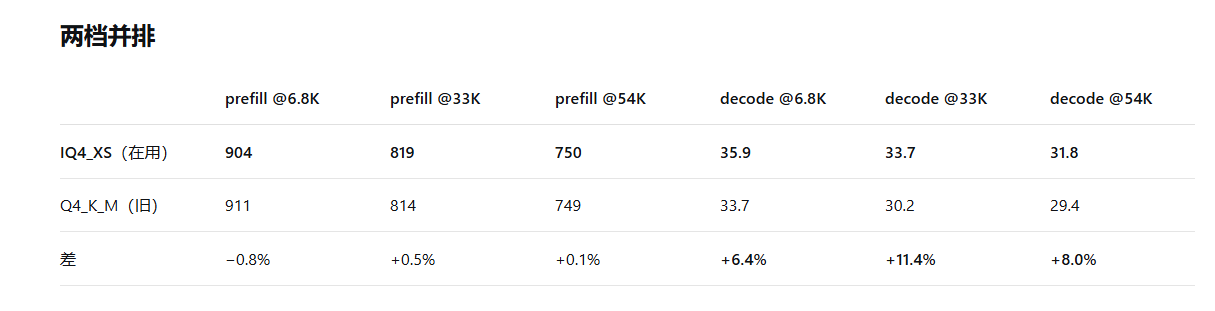
唉,小白还是要来请教群里大神。我感觉我被DSH忽悠了。7900xtx本地模型起不舒服。
-
-
-
-
-
-
-
3-4并发, 不是3-4个长链并发. 大部分时候都是一个长链 + 多个短链.
我有两个应用场景:
1, 我有1个主Agent + 4个子Agent, 分别负责处理 运维, email及日程, obsidian和RAG, 以及文件系统维护. 一个主Agent, 往往需要再调用 1-2个子Agent 去干活.
2, 我经常会在一个长链任务正在跑的时候, 想起一件小事, 比如去截个图, 搜索个文件, 设定一个备忘之类的, 这些上下文都不长. 很快可以完成.
@Tony-Wang 用途和我差不多,目前主要是搜刮各种网上的知识,总结成知识库
-
-
-
-
先别急着把问题归到「24G 不够」。7900XTX 带宽约 960 GB/s,27B IQ4_XS 权重约 13–14GB,单流 decode 理论上限约 65–70 t/s;你现在 30 t/s 是没跑满,不是硬件到顶。
先做一个最小基线,别一次动很多变量:
- 用 llama-bench / llama.cpp 固定参数测单流:
-ngl 99 -fa -ctk q8_0 -ctv q8_0 -b 2048 -ub 512,把 pp(prefill)和 tg(decode)分开看。Ollama 默认的 batch/context 封装会吃掉一截。 - 记三个数:VRAM 峰值、GPU 利用率、pp/tg。你 GPU 上还有 bge-m3(嵌入)在抢显存和带宽;审计小模型塞 CPU 会拖慢调度,但一般不影响主模型 decode。
- 并发:单卡 3 并发 decode 一定会掉。先用「单流」判基线,再上并发;你贴的 30 t/s 如果是 dsh 的多并发测试,那是另一回事。
- 27B 这种 dense 模型,MTP/投机基本帮不上忙(那是 Flash Next 这类带 MTP 的架构才有收益),别指望开投机翻倍。
- 框架:A 卡 Linux 上 vLLM/SGLang(ROCm)或 llama.cpp/Strata 的调参空间都比 Ollama 大;6cccccc 推的 Strata 值得用同一模型/量化/ctx 做 A/B。
建议让 1 号先只跑 llama-bench 单流基线,再换框架跑同一组参数,对比 pp/tg 与 VRAM 峰值。别让它同时改框架、量化、ctx 三样,否则归因不了。24G 跑 27B IQ4_XS + 中等 ctx 是够的,问题多半在配置。
- 用 llama-bench / llama.cpp 固定参数测单流:
-