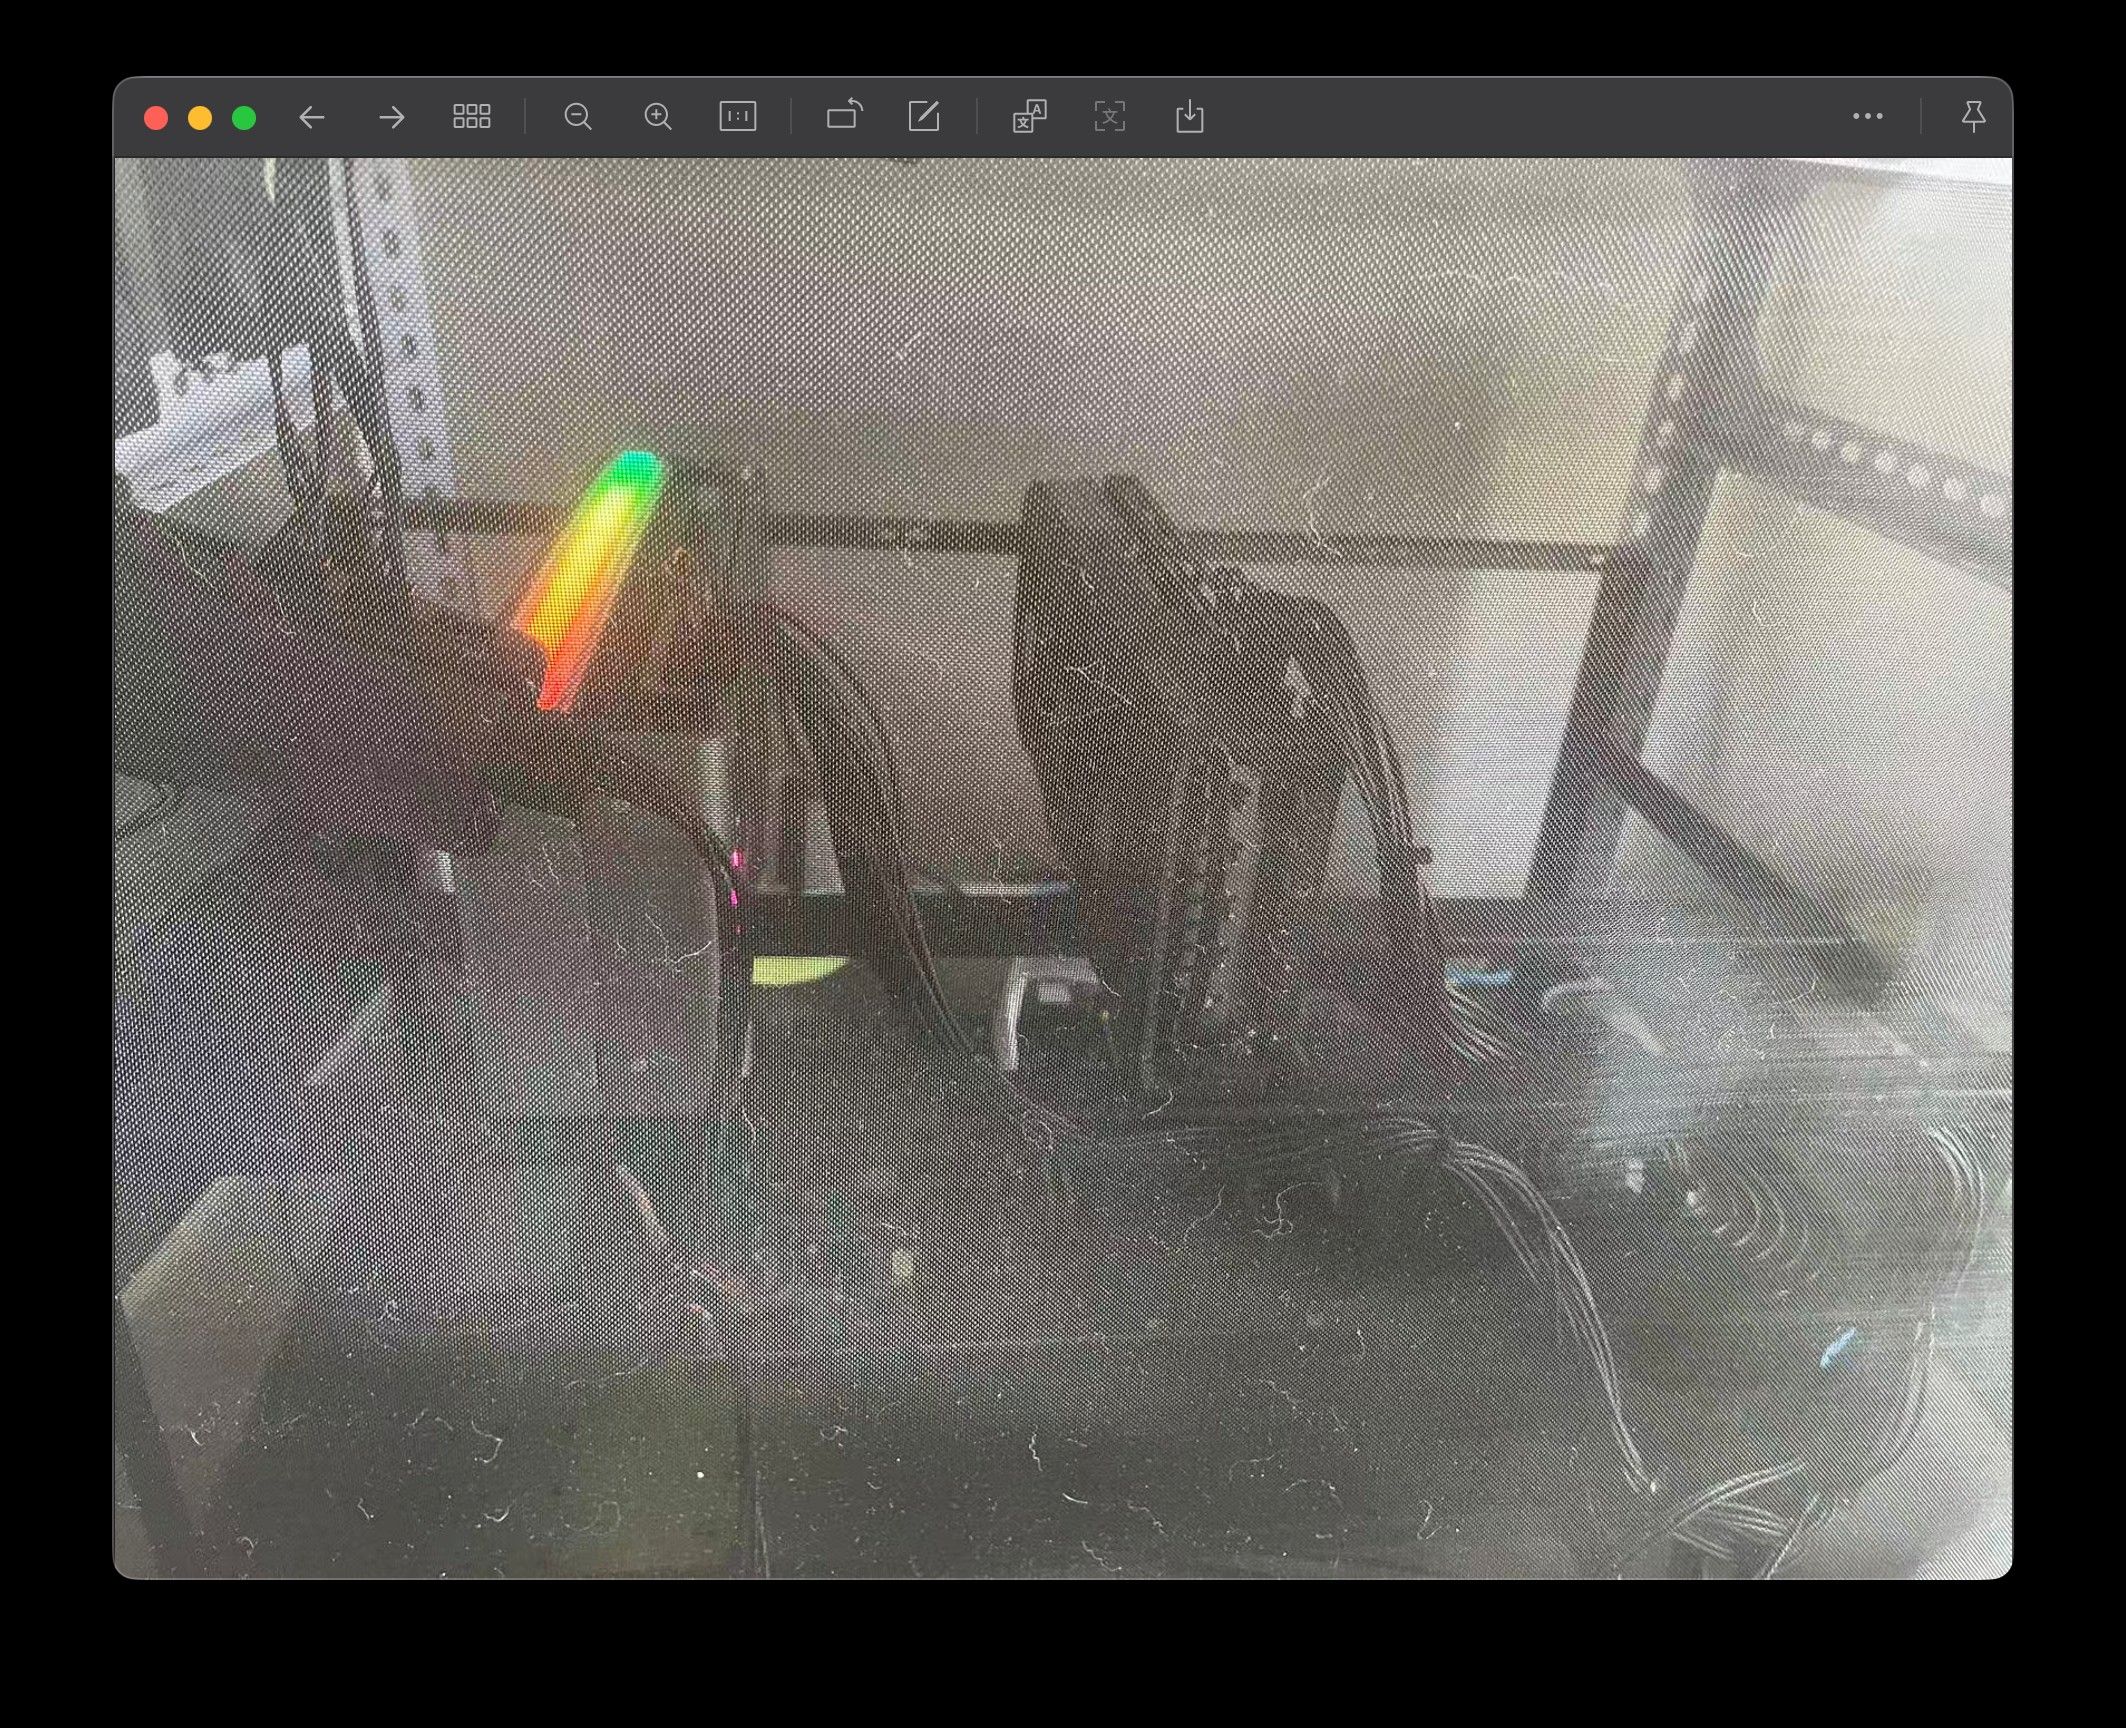
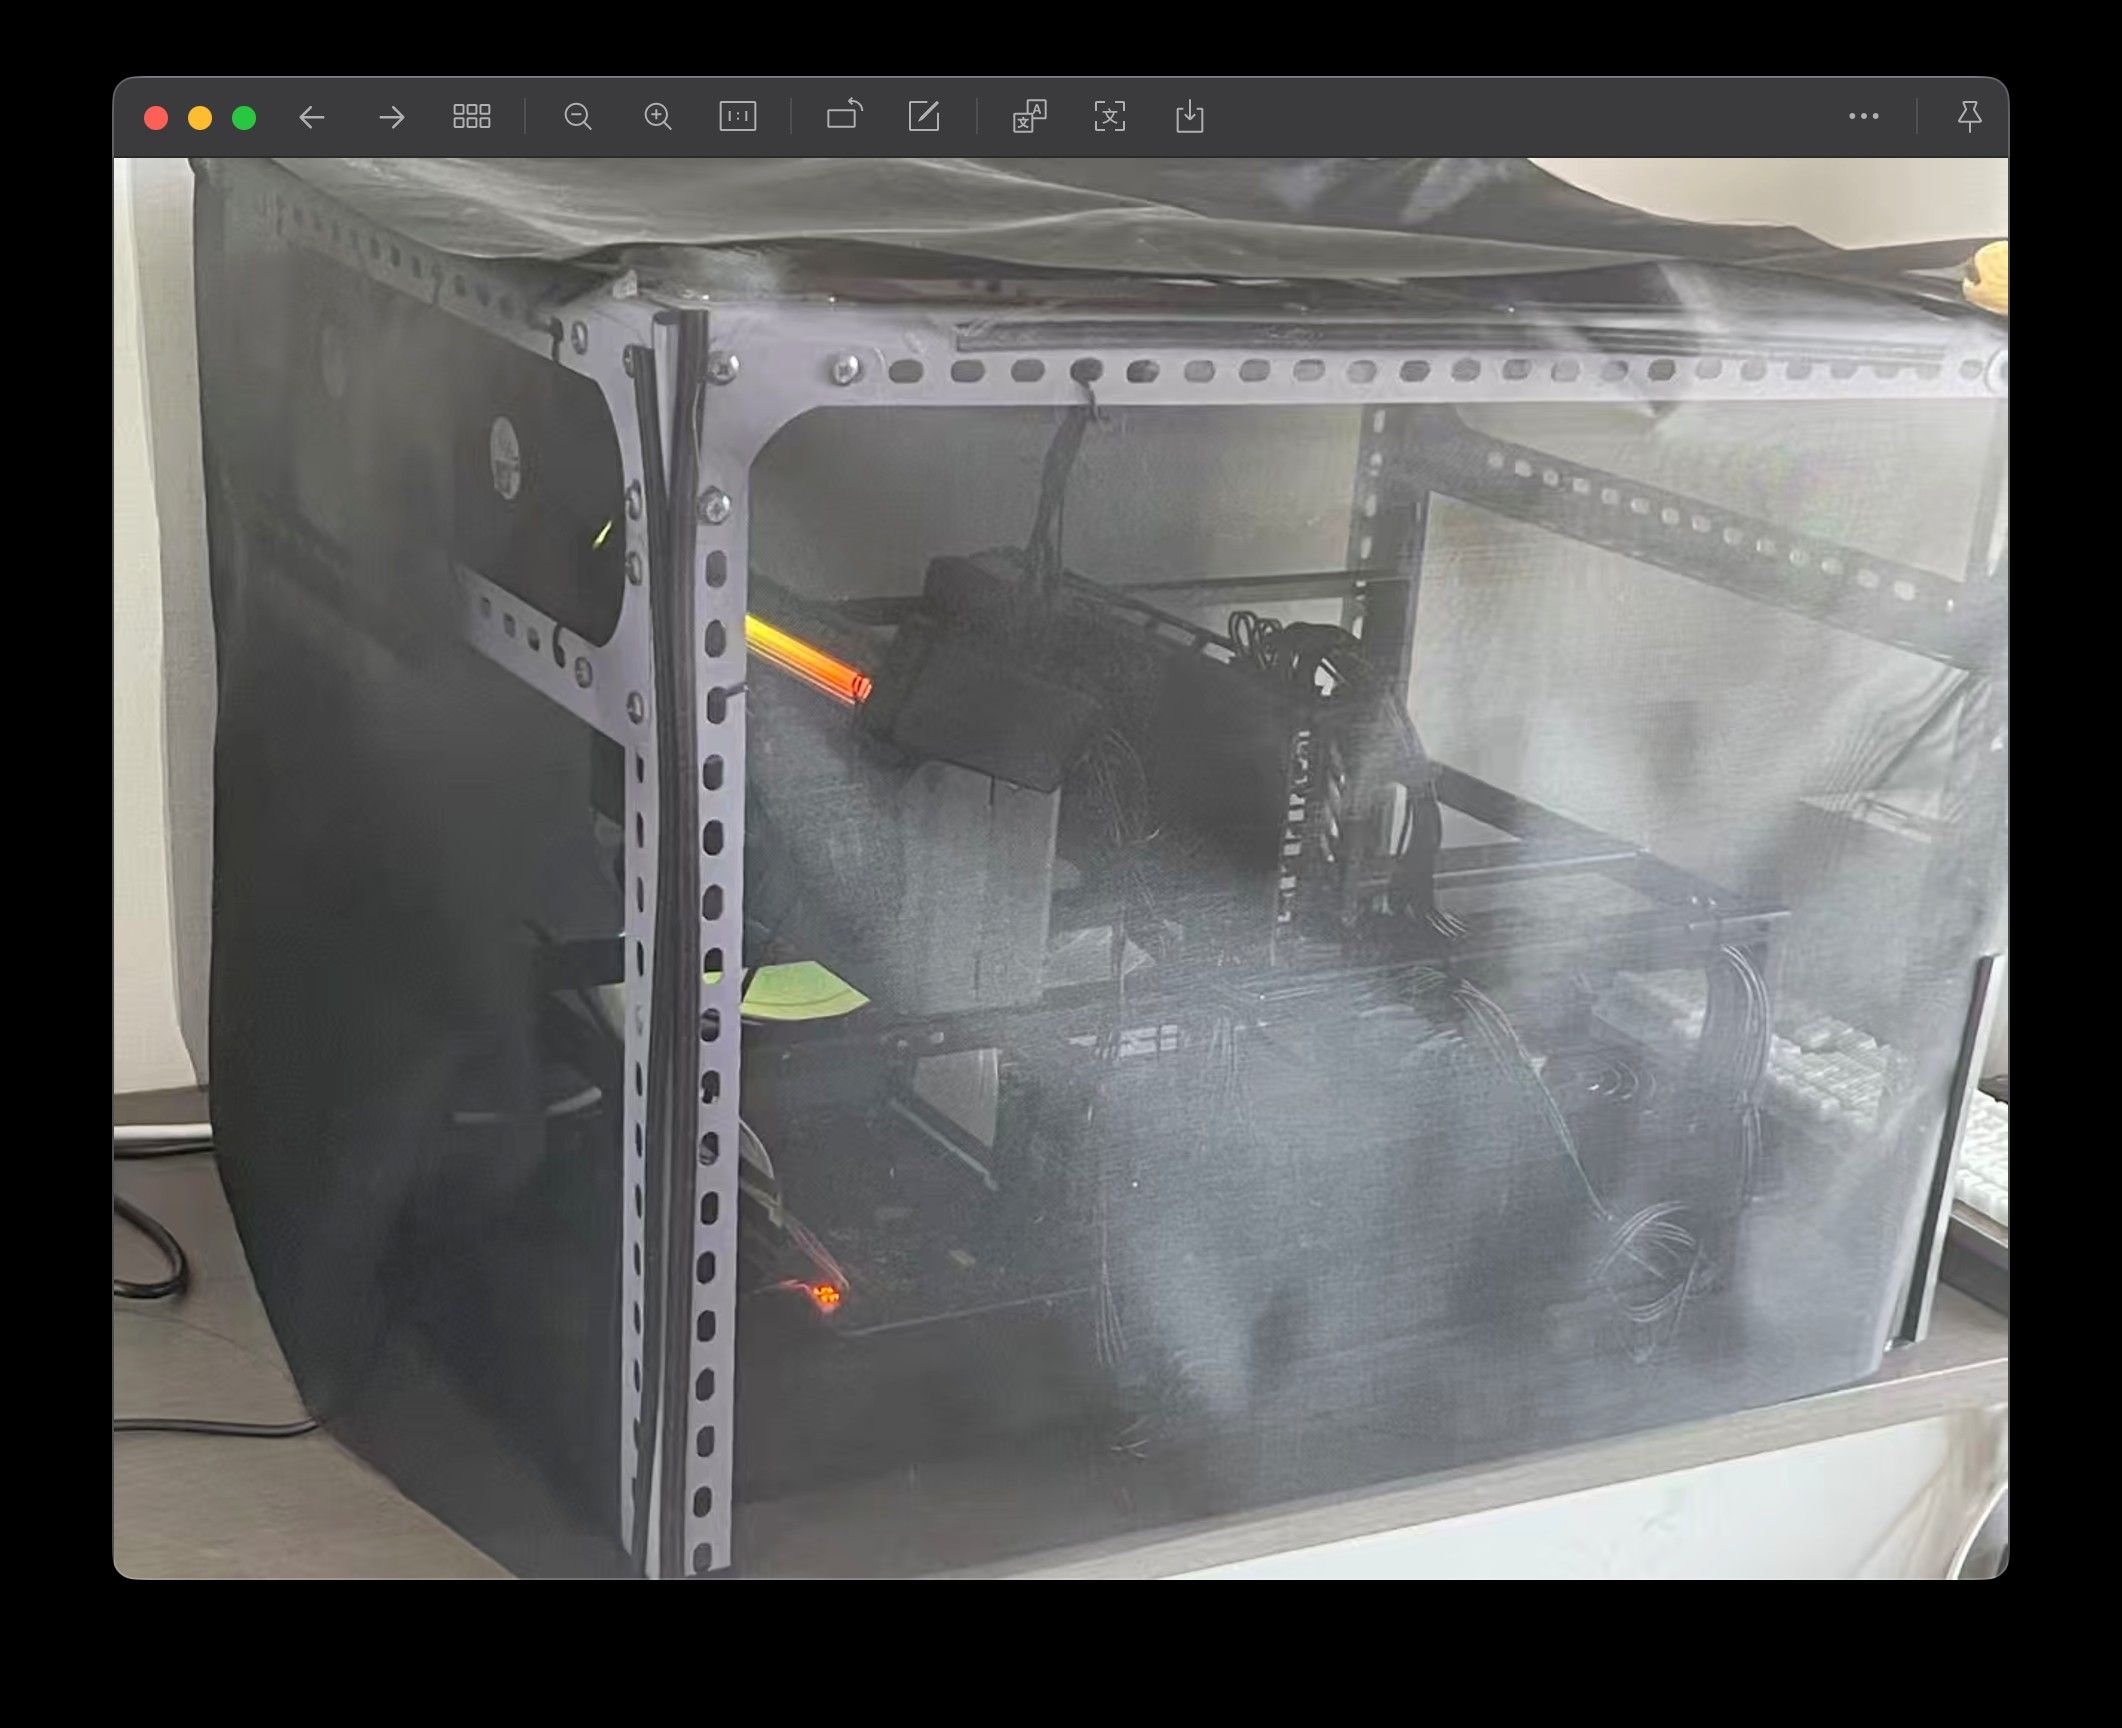
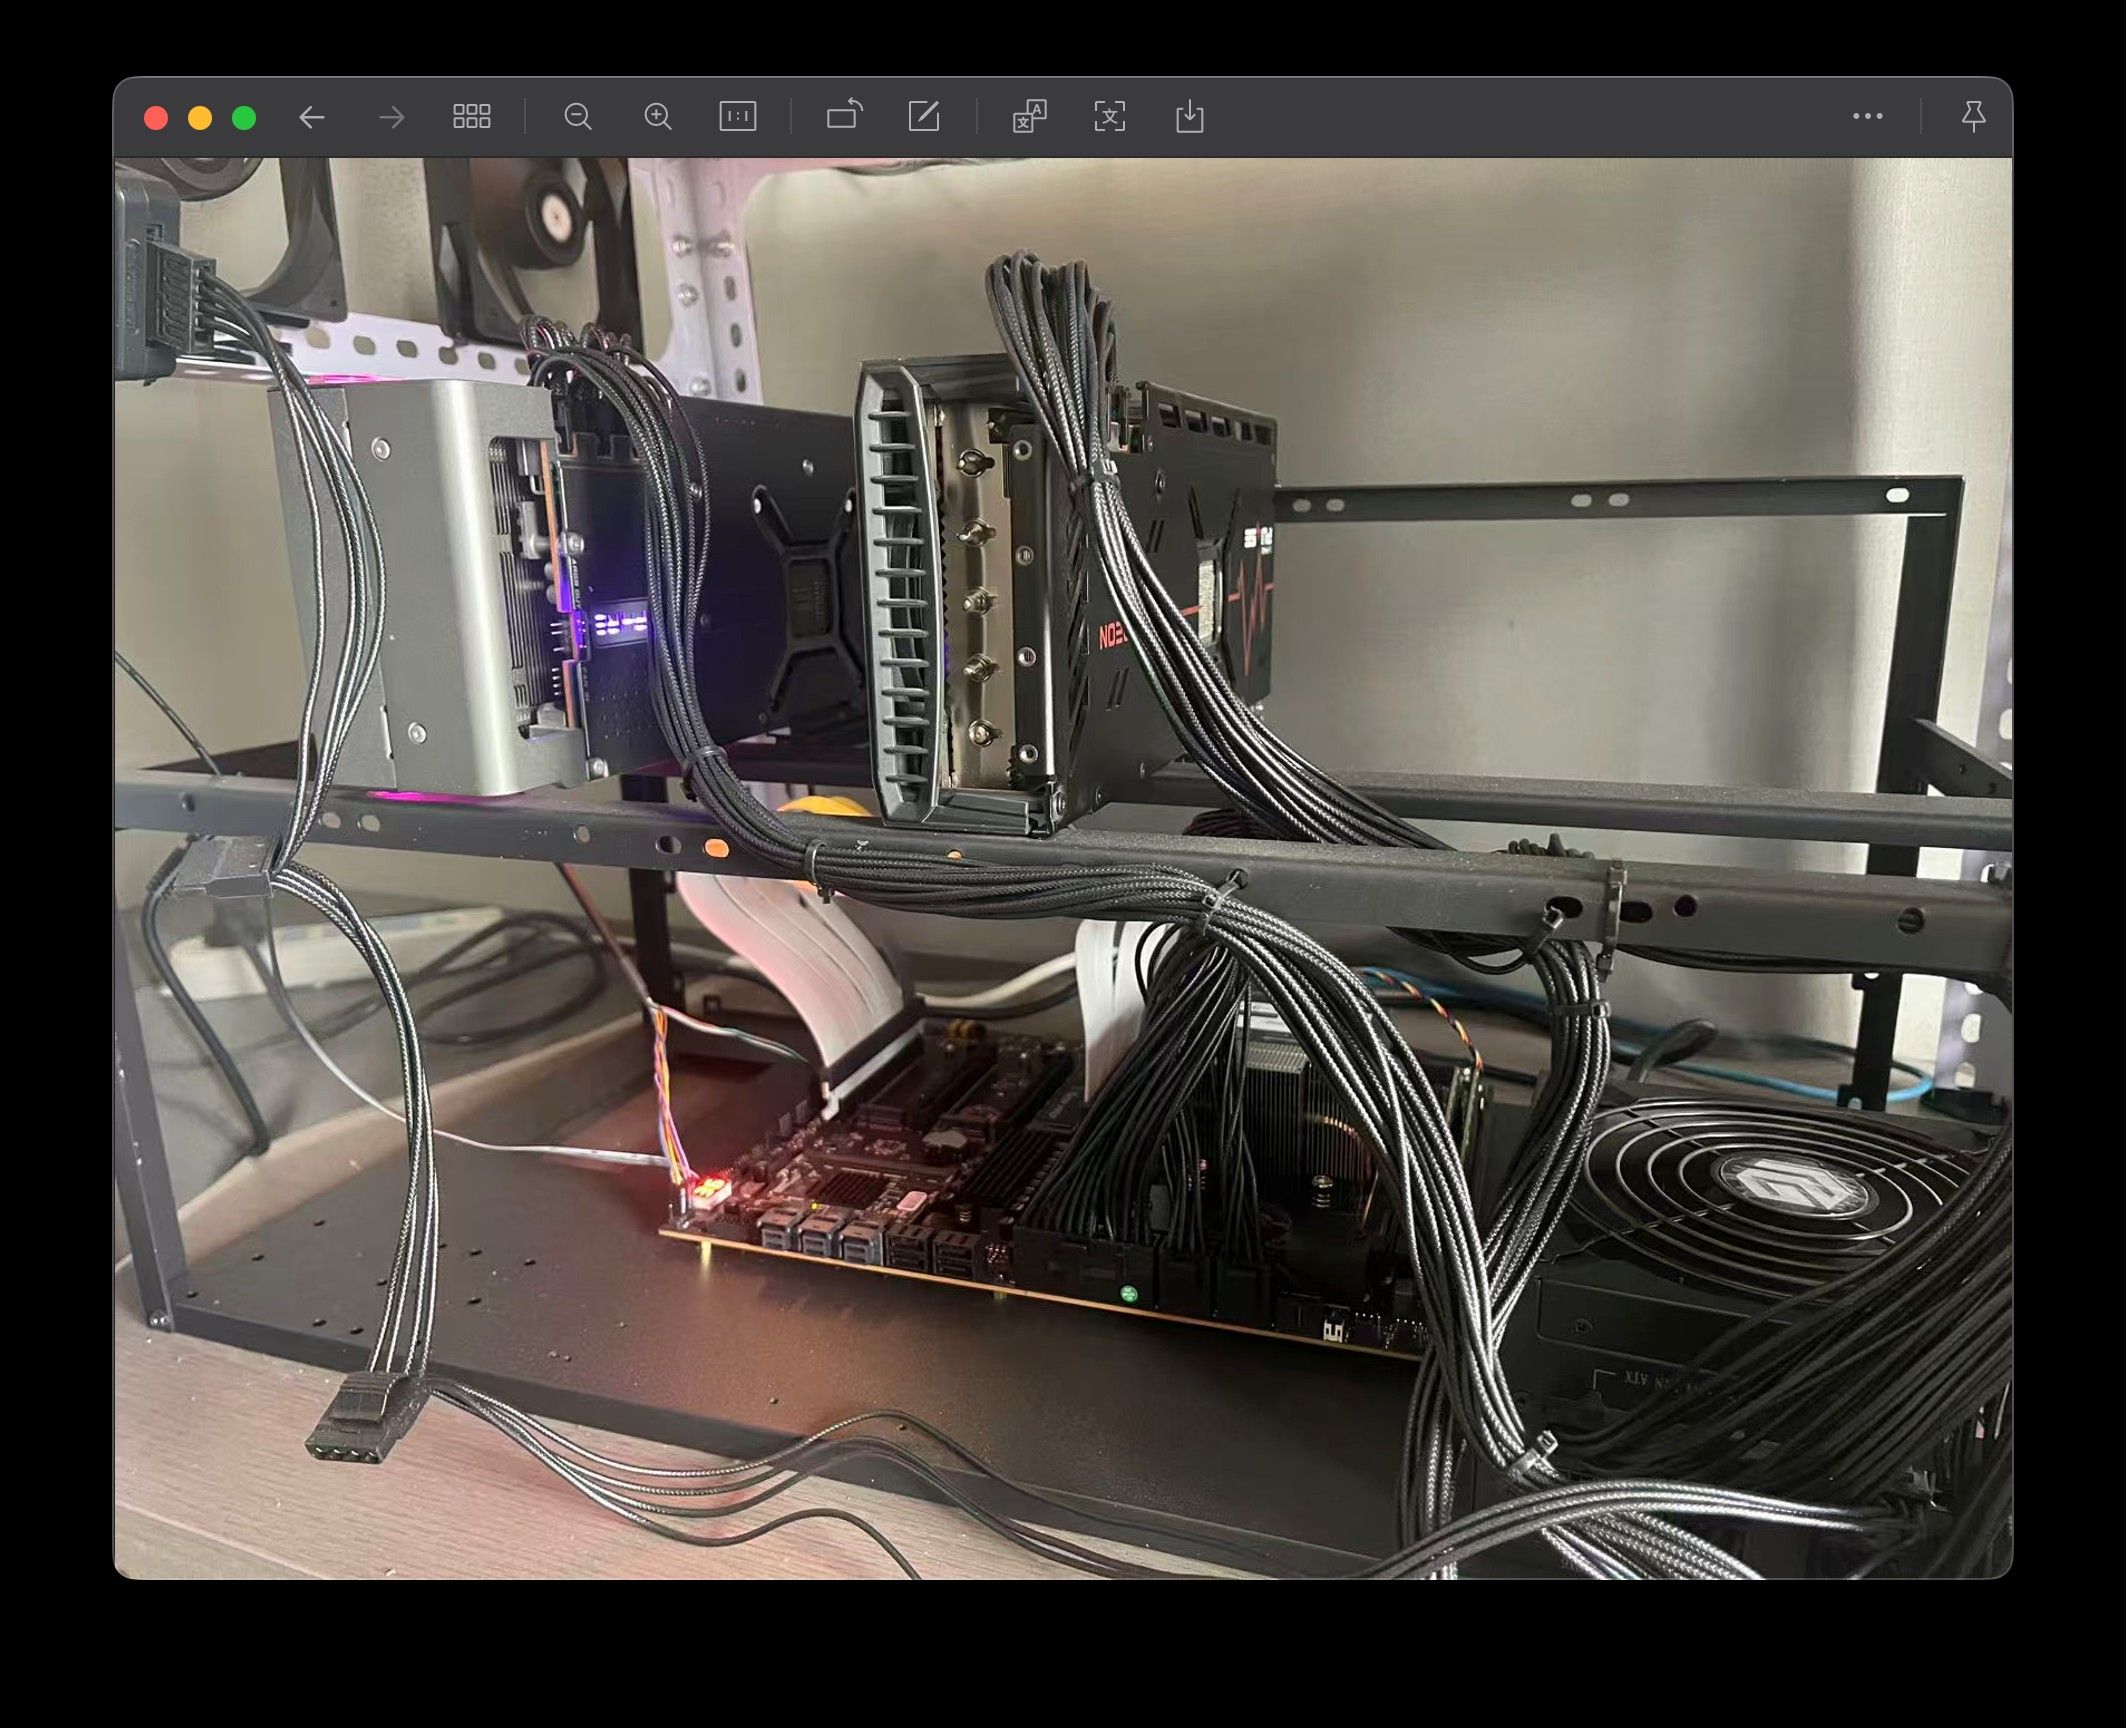
2 *7900 XTX vllm TP2, 8并发 476 tok/s,256K *4 ,157tok/s
-
-
非常不错,VLLM的并发能力还是最好的,最差的就是长上下文Agent场景没有增量Prefill,一般Agent舒适工作区间在128k-256k之间,延迟太高了。这是比SGLang最大的弱点。还有就是Page attension不能跨会话共用缓存。但是框架本身开销更小,这个见仁见智了。
@terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用30g 内存,也才400-500k ,并发只能拉到 4 * 120k 左右, 但是现在这个 KV 是有1000k, 可以跑256*4 并发, 如果加上贡献前缀, 以及agent 的75% 压缩限制, 256k * 8 ,是可以直接跑的 ,如果不跑 256k , 跑120k 可以跑 16 并发! @ben-lee 这个可以跑 120k *16 并发呀。
-
-
@terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用30g 内存,也才400-500k ,并发只能拉到 4 * 120k 左右, 但是现在这个 KV 是有1000k, 可以跑256*4 并发, 如果加上贡献前缀, 以及agent 的75% 压缩限制, 256k * 8 ,是可以直接跑的 ,如果不跑 256k , 跑120k 可以跑 16 并发! @ben-lee 这个可以跑 120k *16 并发呀。
-
@farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧
-
@farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧
-
@farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧
但是他TTFT 很慢
-
-
-
-