跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 2 *7900 XTX vllm TP2, 8并发 476 tok/s,256K *4 ,157tok/s

2 *7900 XTX vllm TP2, 8并发 476 tok/s,256K *4 ,157tok/s

已定时 已固定 已锁定 已移动 LLM讨论区
7900xtxvllm多卡部署
13 帖子 5 发布者 564 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • terryT terry

    非常不错,VLLM的并发能力还是最好的,最差的就是长上下文Agent场景没有增量Prefill,一般Agent舒适工作区间在128k-256k之间,延迟太高了。这是比SGLang最大的弱点。还有就是Page attension不能跨会话共用缓存。但是框架本身开销更小,这个见仁见智了。

    farmer nodeF
    farmer nodeF
    farmer node
    德高望重 劳动模范
    编写于 最后由 farmer node 编辑
    #4

    @terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用30g 内存,也才400-500k ,并发只能拉到 4 * 120k 左右, 但是现在这个 KV 是有1000k, 可以跑256*4 并发, 如果加上贡献前缀, 以及agent 的75% 压缩限制, 256k * 8 ,是可以直接跑的 ,如果不跑 256k , 跑120k 可以跑 16 并发! @ben-lee 这个可以跑 120k *16 并发呀。

    Ben LeeB 1 条回复 最后回复
    2
    • terryT
      terryT
      terry
      超级版主
      编写于 最后由 编辑
      #5

      @farmer node 说:

      @terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用3…

      可以,继续探索,我直接抄作业

      油管:https://www.youtube.com/@抡锤者

      1 条回复 最后回复
      0
      • farmer nodeF farmer node

        @terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用30g 内存,也才400-500k ,并发只能拉到 4 * 120k 左右, 但是现在这个 KV 是有1000k, 可以跑256*4 并发, 如果加上贡献前缀, 以及agent 的75% 压缩限制, 256k * 8 ,是可以直接跑的 ,如果不跑 256k , 跑120k 可以跑 16 并发! @ben-lee 这个可以跑 120k *16 并发呀。

        Ben LeeB
        Ben LeeB
        Ben Lee
        超凡大师
        编写于 最后由 编辑
        #6

        @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

        张光璞张 farmer nodeF 2 条回复 最后回复
        1
        • Ben LeeB Ben Lee

          @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

          张光璞张
          张光璞张
          张光璞
          技术大牛 劳动模范
          编写于 最后由 编辑
          #7

          @Ben-Lee 说:

          @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

          但是他TTFT 很慢

          farmer nodeF 1 条回复 最后回复
          2
          • Ben LeeB Ben Lee

            @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

            farmer nodeF
            farmer nodeF
            farmer node
            德高望重 劳动模范
            编写于 最后由 编辑
            #8

            @Ben-Lee 这个就是flyer666 改的 tensor 的上游分支,是参考的这个仓库改的,所一 TTFT 是很快的,prefill 和之前的一样,快的离谱,针对 7900txt 专门优化的 tensor ,数据上是比 3090 更快的 prefill。

            1 条回复 最后回复
            1
            • 张光璞张 张光璞

              @Ben-Lee 说:

              @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

              但是他TTFT 很慢

              farmer nodeF
              farmer nodeF
              farmer node
              德高望重 劳动模范
              编写于 最后由 编辑
              #9

              @张光璞 这个就是flyer666 改的 tensor 的上游分支,是参考的这个仓库改的,所一 TTFT 是很快的,prefill 和之前的一样,快的离谱,针对 7900txt 专门优化的 tensor ,数据上是比 3090 更快的 prefill,不是很慢,是快的离谱,但是还是会有 之前 一个大的prefill 会卡住的问题,这个问题,已经修复了很多,不会完全卡死,但是会慢一些。

              1 条回复 最后回复
              1
              • terryT
                terryT
                terry
                超级版主
                编写于 最后由 编辑
                #10

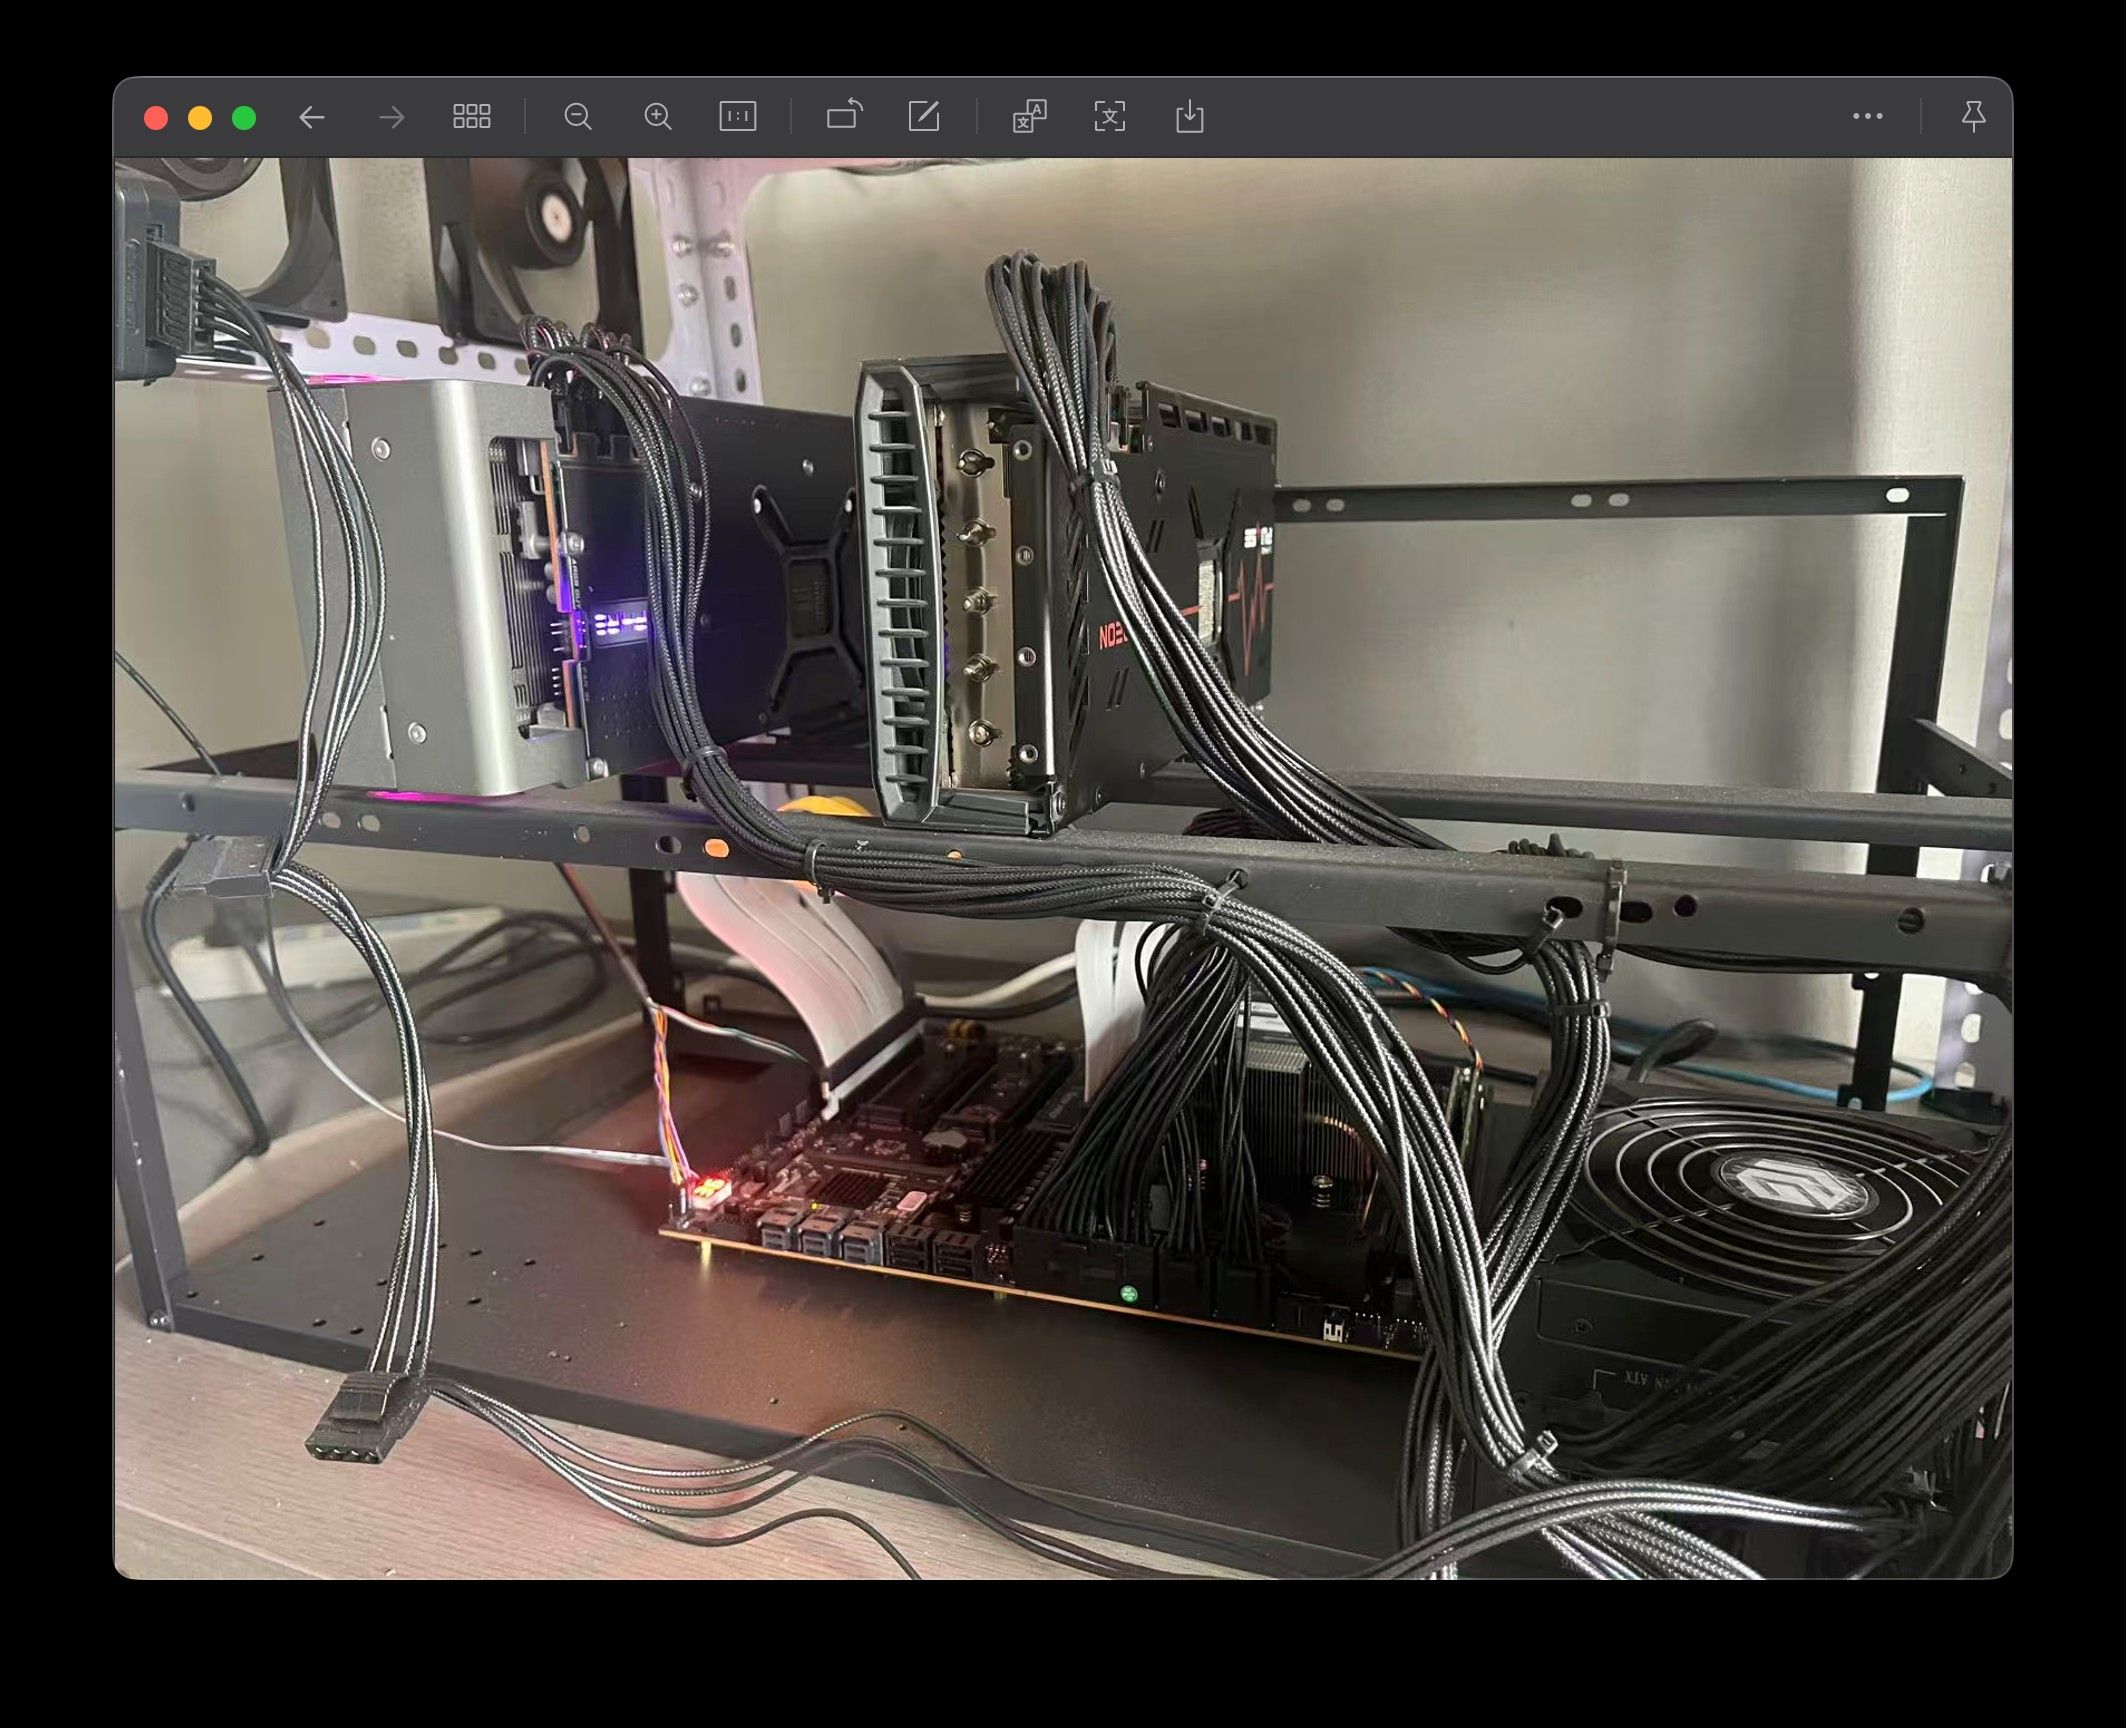
                你这开放式机架也很骚气啊,发个装备秀,多发几张图,观摩下。

                油管:https://www.youtube.com/@抡锤者

                farmer nodeF 1 条回复 最后回复
                0
                • 9
                  9
                  909
                  编写于 最后由 编辑
                  #11

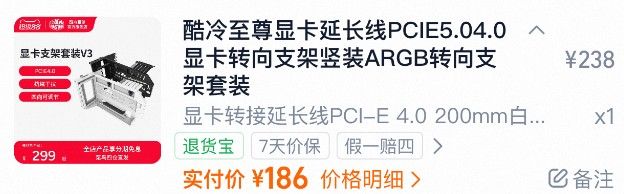
                  你买的这种pcie3.0延长线不会报错吗,我买的这种线运算老是报错啊!! 我就换成pcie4.0得了

                  farmer nodeF 1 条回复 最后回复
                  0
                  • 9 909

                    你买的这种pcie3.0延长线不会报错吗,我买的这种线运算老是报错啊!! 我就换成pcie4.0得了

                    farmer nodeF
                    farmer nodeF
                    farmer node
                    德高望重 劳动模范
                    编写于 最后由 编辑
                    #12

                    @909 不会呀,插上去就直接能用了, 我这个就是PCIE 4.0 的线呀。
                    image.jpeg

                    1 条回复 最后回复
                    0
                    • terryT terry

                      你这开放式机架也很骚气啊,发个装备秀,多发几张图,观摩下。

                      farmer nodeF
                      farmer nodeF
                      farmer node
                      德高望重 劳动模范
                      编写于 最后由 farmer node 编辑
                      #13

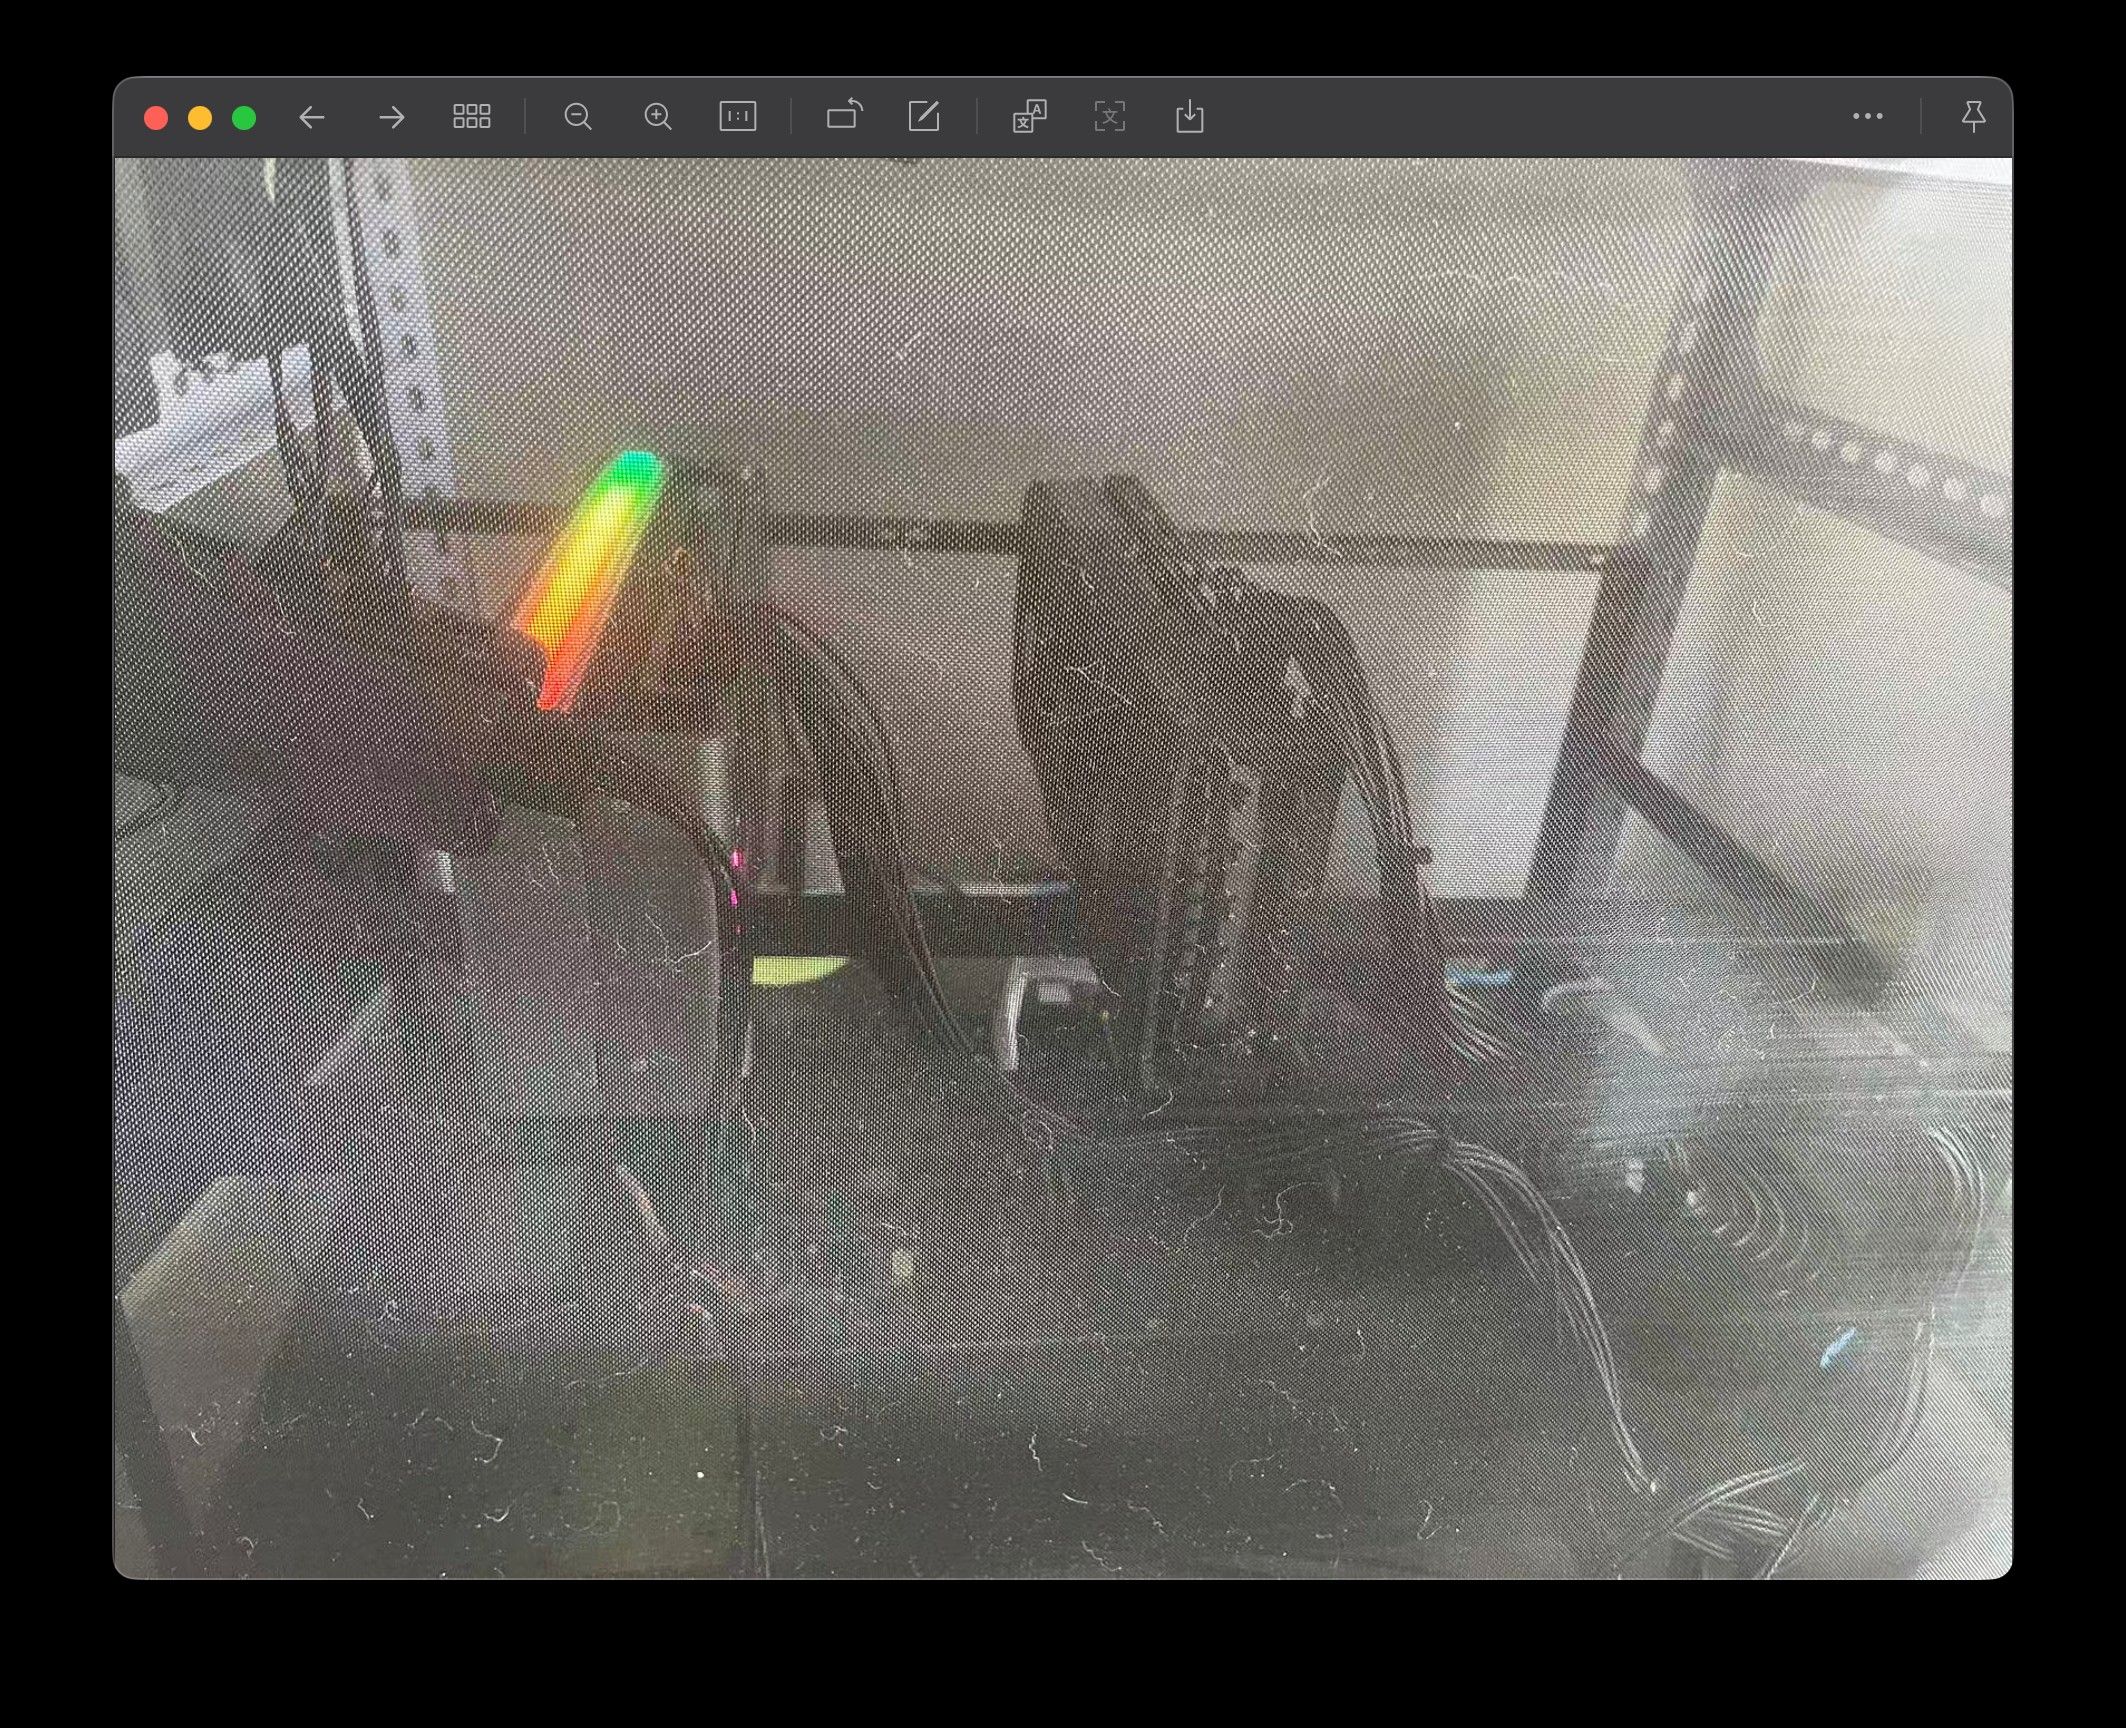
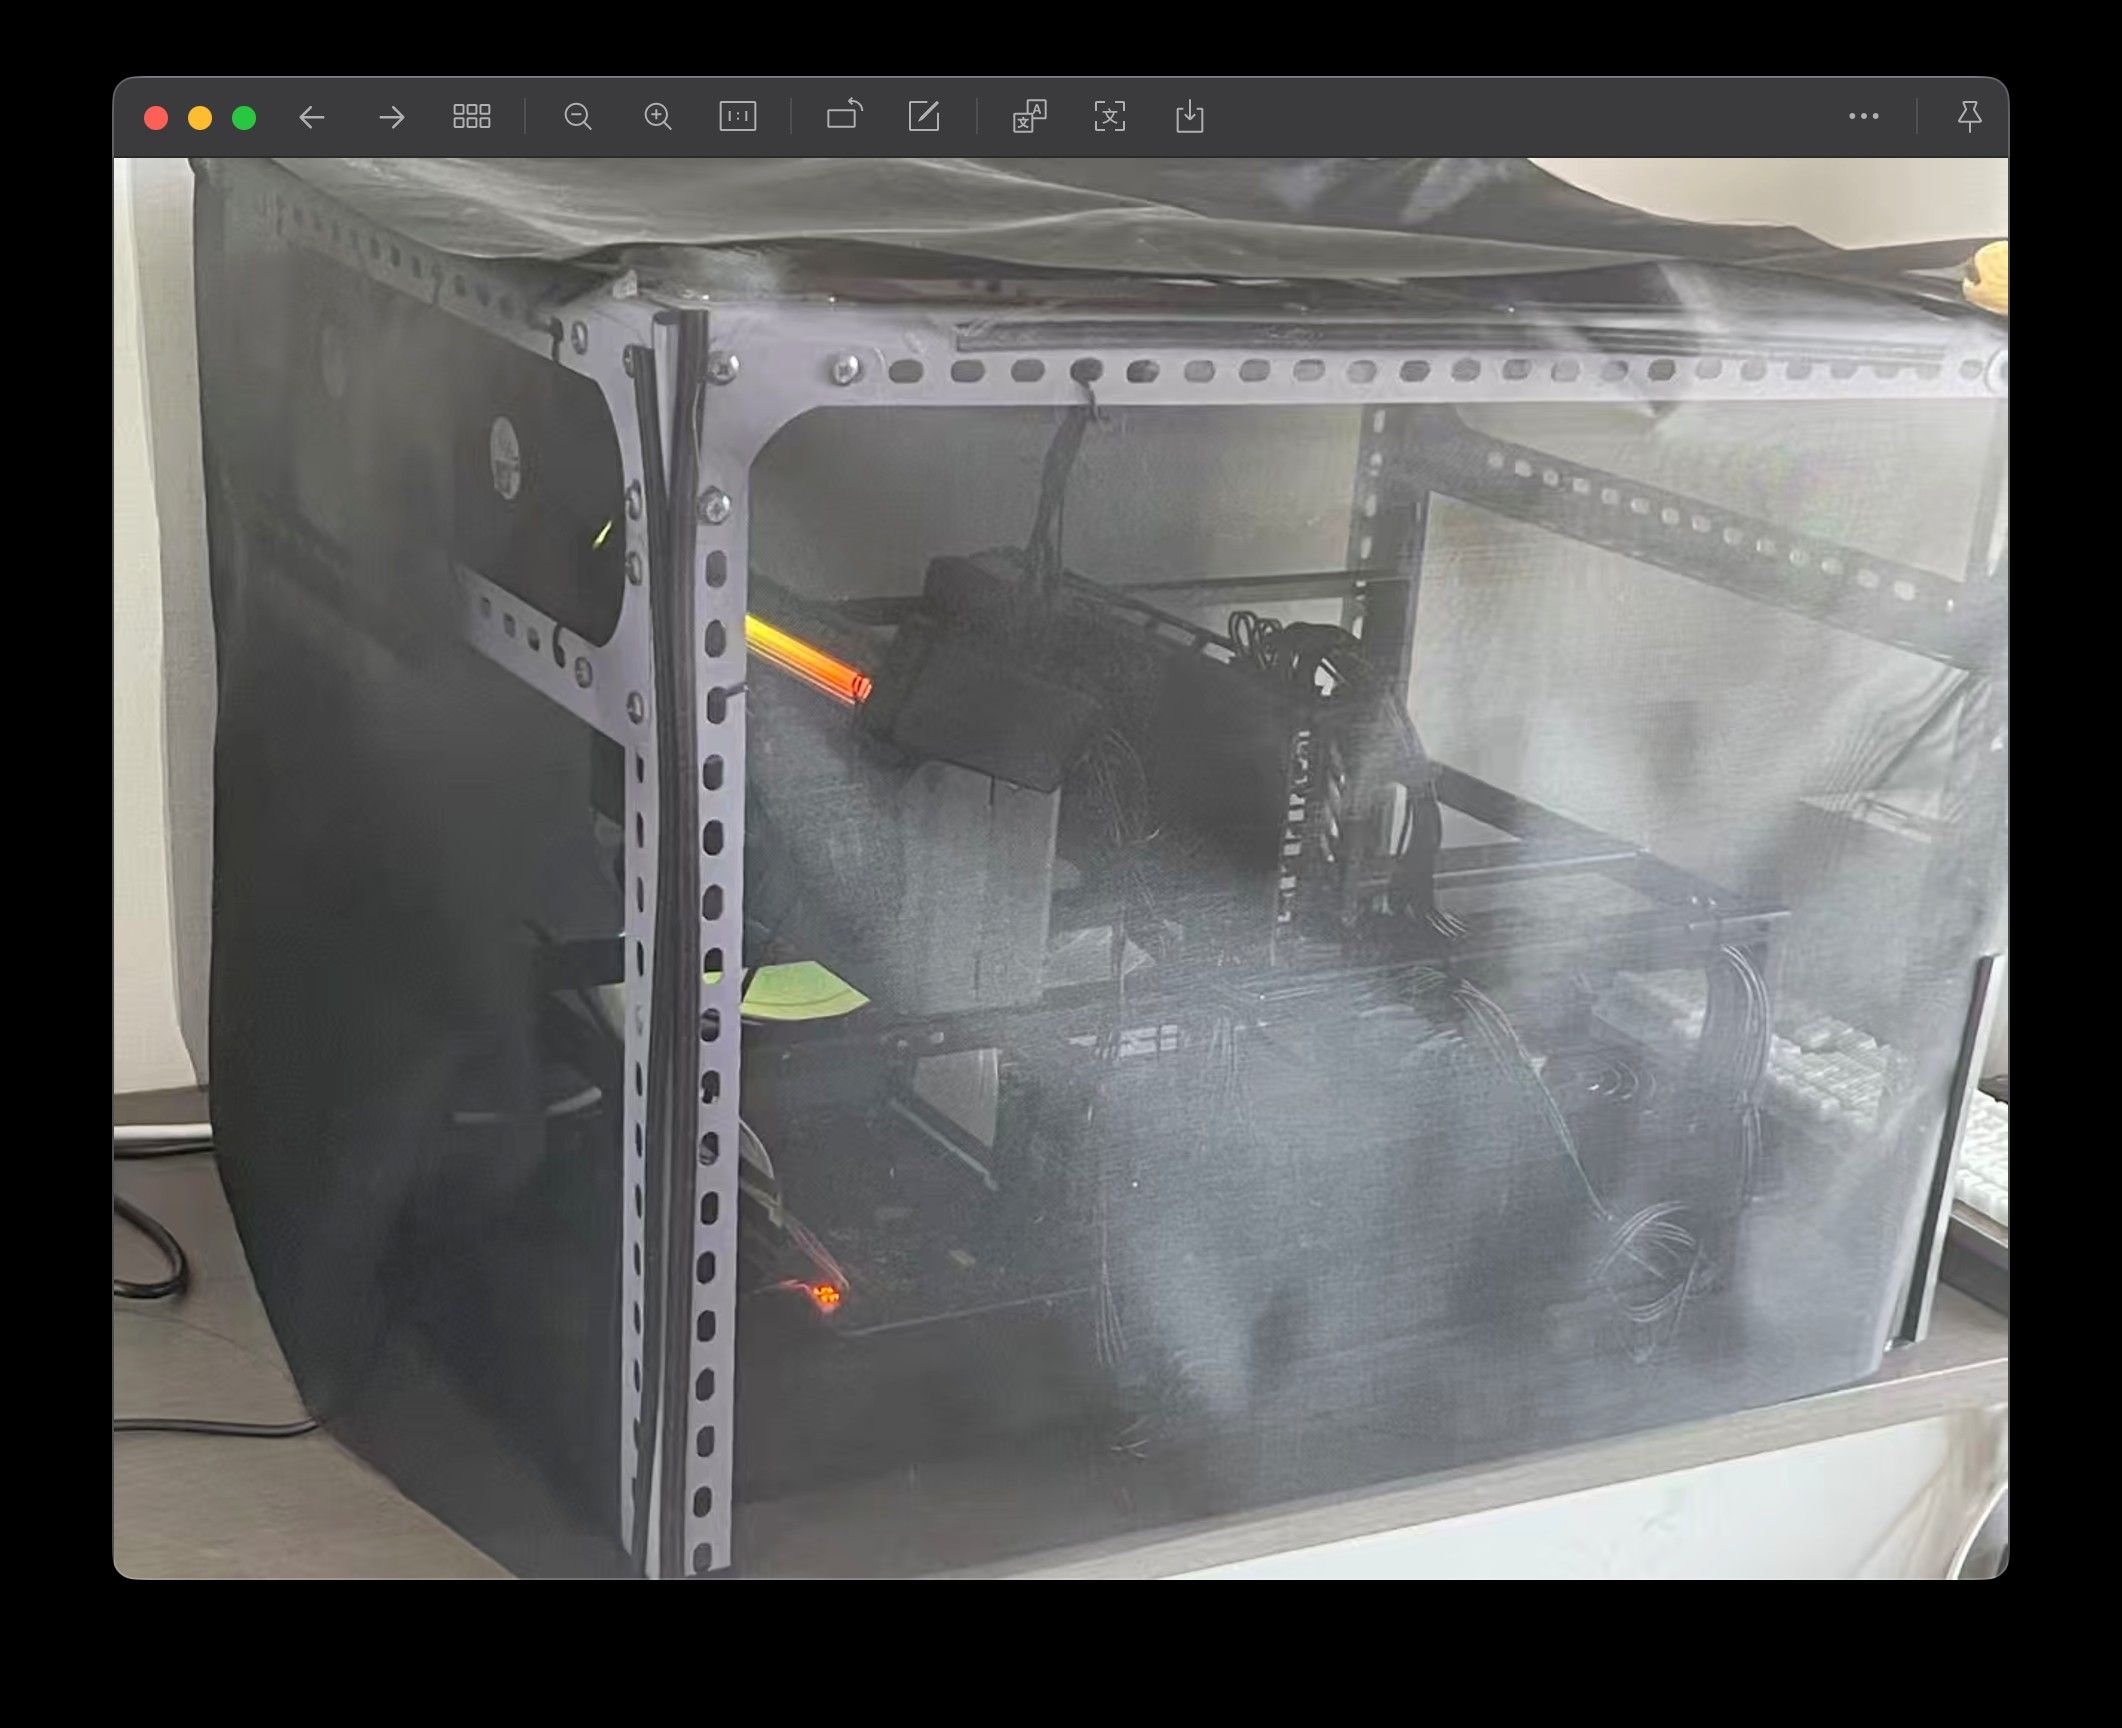
                      @terry 这个就是上次说有黑罩子的那个。这个是外面:
                      image.jpeg
                      image.jpeg

                      这个是里面: 顶上和侧边加了几个风扇,温度最高是80,以前跑llama.cpp 负载高的时候会跑到80 , 现在换 vllm ,或是strata ,都是70左右:
                      image.jpeg

                      1 条回复 最后回复
                      1

                      你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                      厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                      有了你的建议,这篇帖子会更精彩哦 💗

                      注册 登录
                      回复
                      • 在新帖中回复
                      登录后回复
                      • 从旧到新
                      • 从新到旧
                      • 最多赞同


                      • 登录

                      • 登录或注册以进行搜索。
                      • 第一个帖子
                        最后一个帖子
                      0
                      • 版块
                      • 最新
                      • 标签
                      • 热门
                      • 用户
                      • 群组