跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 2 *7900 XTX vllm TP2, 8并发 476 tok/s,256K *4 ,157tok/s

2 *7900 XTX vllm TP2, 8并发 476 tok/s,256K *4 ,157tok/s

已定时 已固定 已锁定 已移动 LLM讨论区
7900xtxvllm多卡部署
13 帖子 5 发布者 566 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • farmer nodeF
    farmer nodeF
    farmer node
    德高望重 劳动模范
    编写于 最后由 farmer node 编辑
    #1

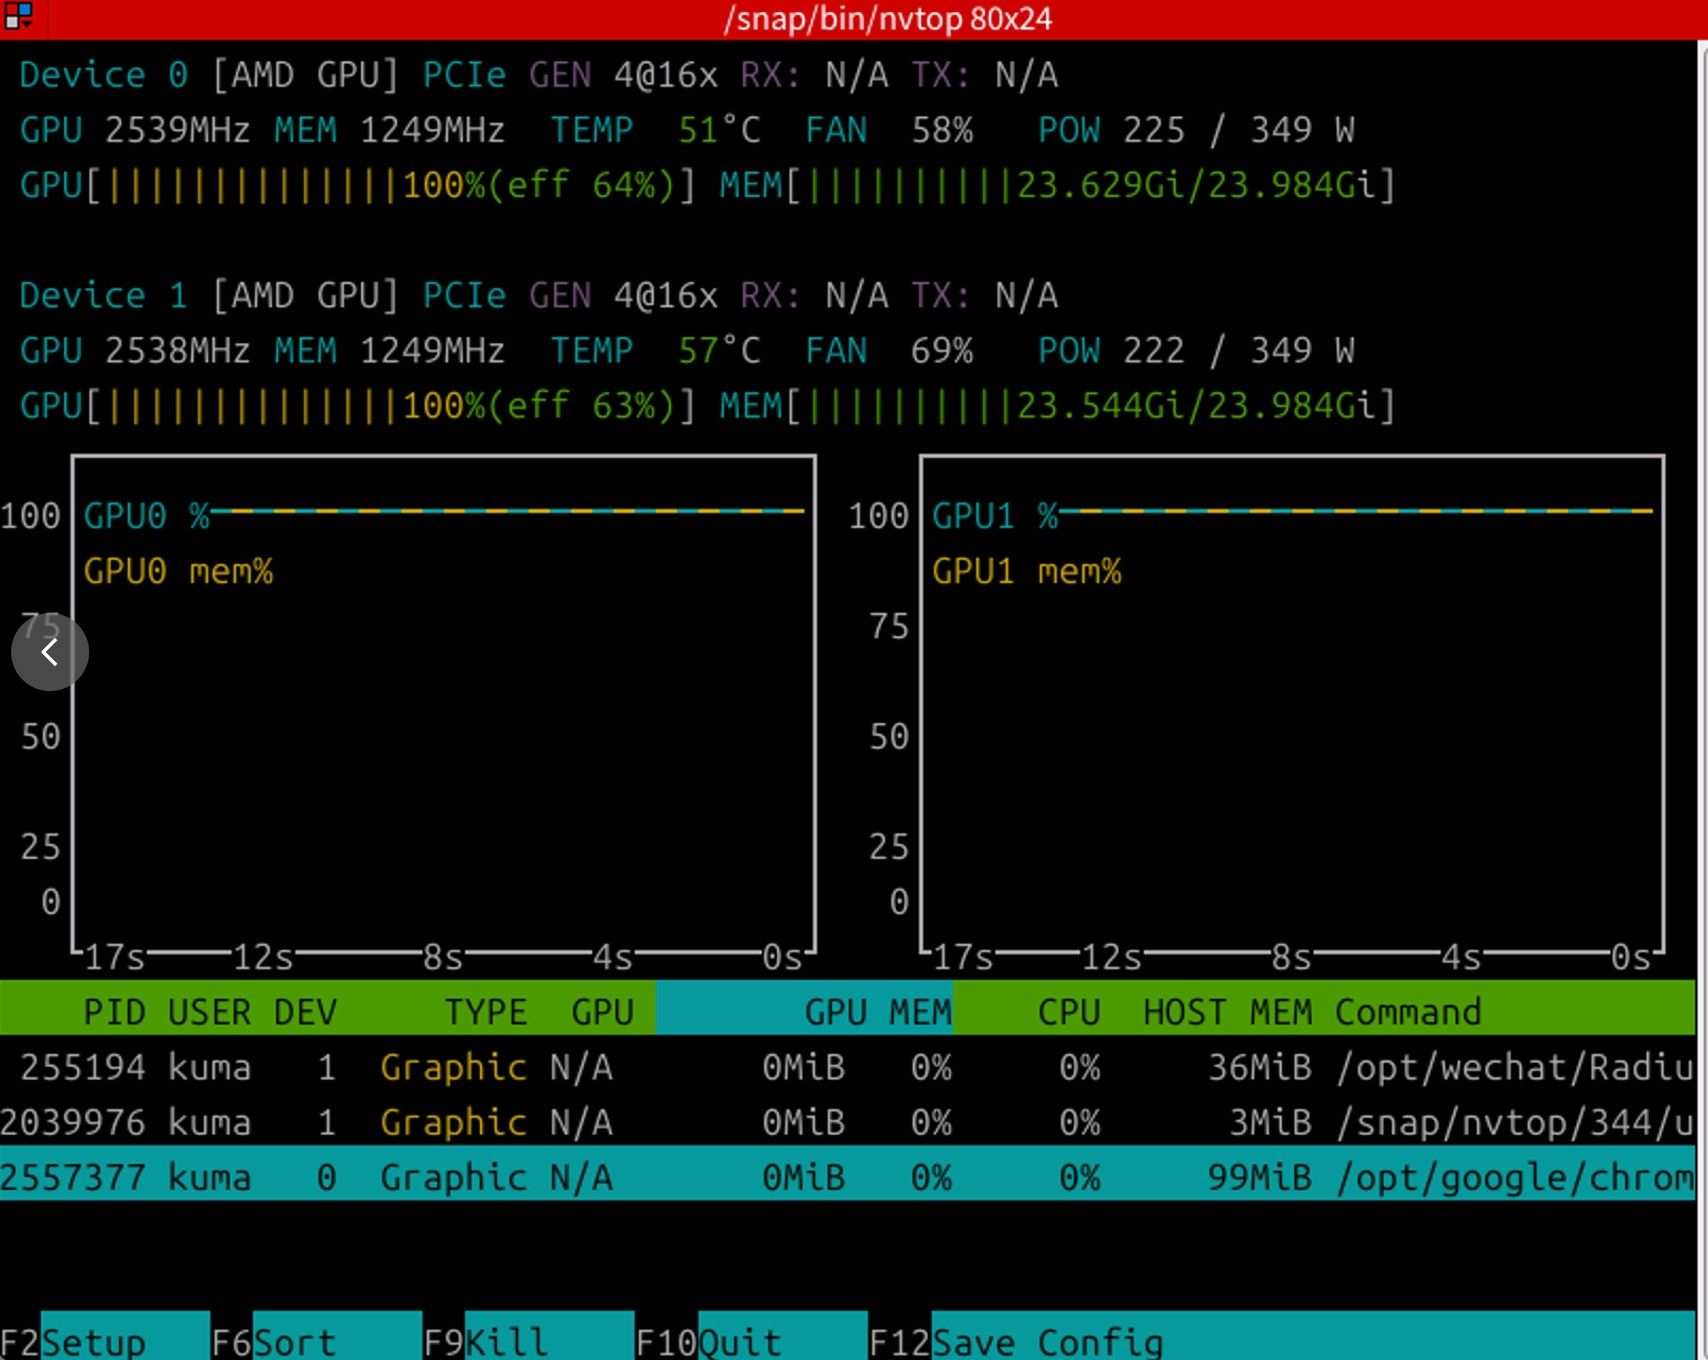
    把我这套双 7900 XTX 的 vLLM 部署交个作业。全部数字都是 2026-10-07 这台机器实测的,不是别人的理论值,不同硬件/版本跑出来会不一样,当参考不当保证。

    机器

    部件 配置
    主板 华南金牌 H12D8D(SP3 双路平台)
    GPU 2 × PULSE RX 7900 XTX(Navi 31 / gfx1100),各 24GB
    CPU AMD EPYC 7452,32 核 / 64 线程
    内存 128GB(30GB 划给会话缓存,见下)
    系统 Ubuntu 24.04.4,ROCm 7.2.4
    模型 Qwen3.8-27B W4A16(AutoRound 量化,19GB),256K 原生上下文
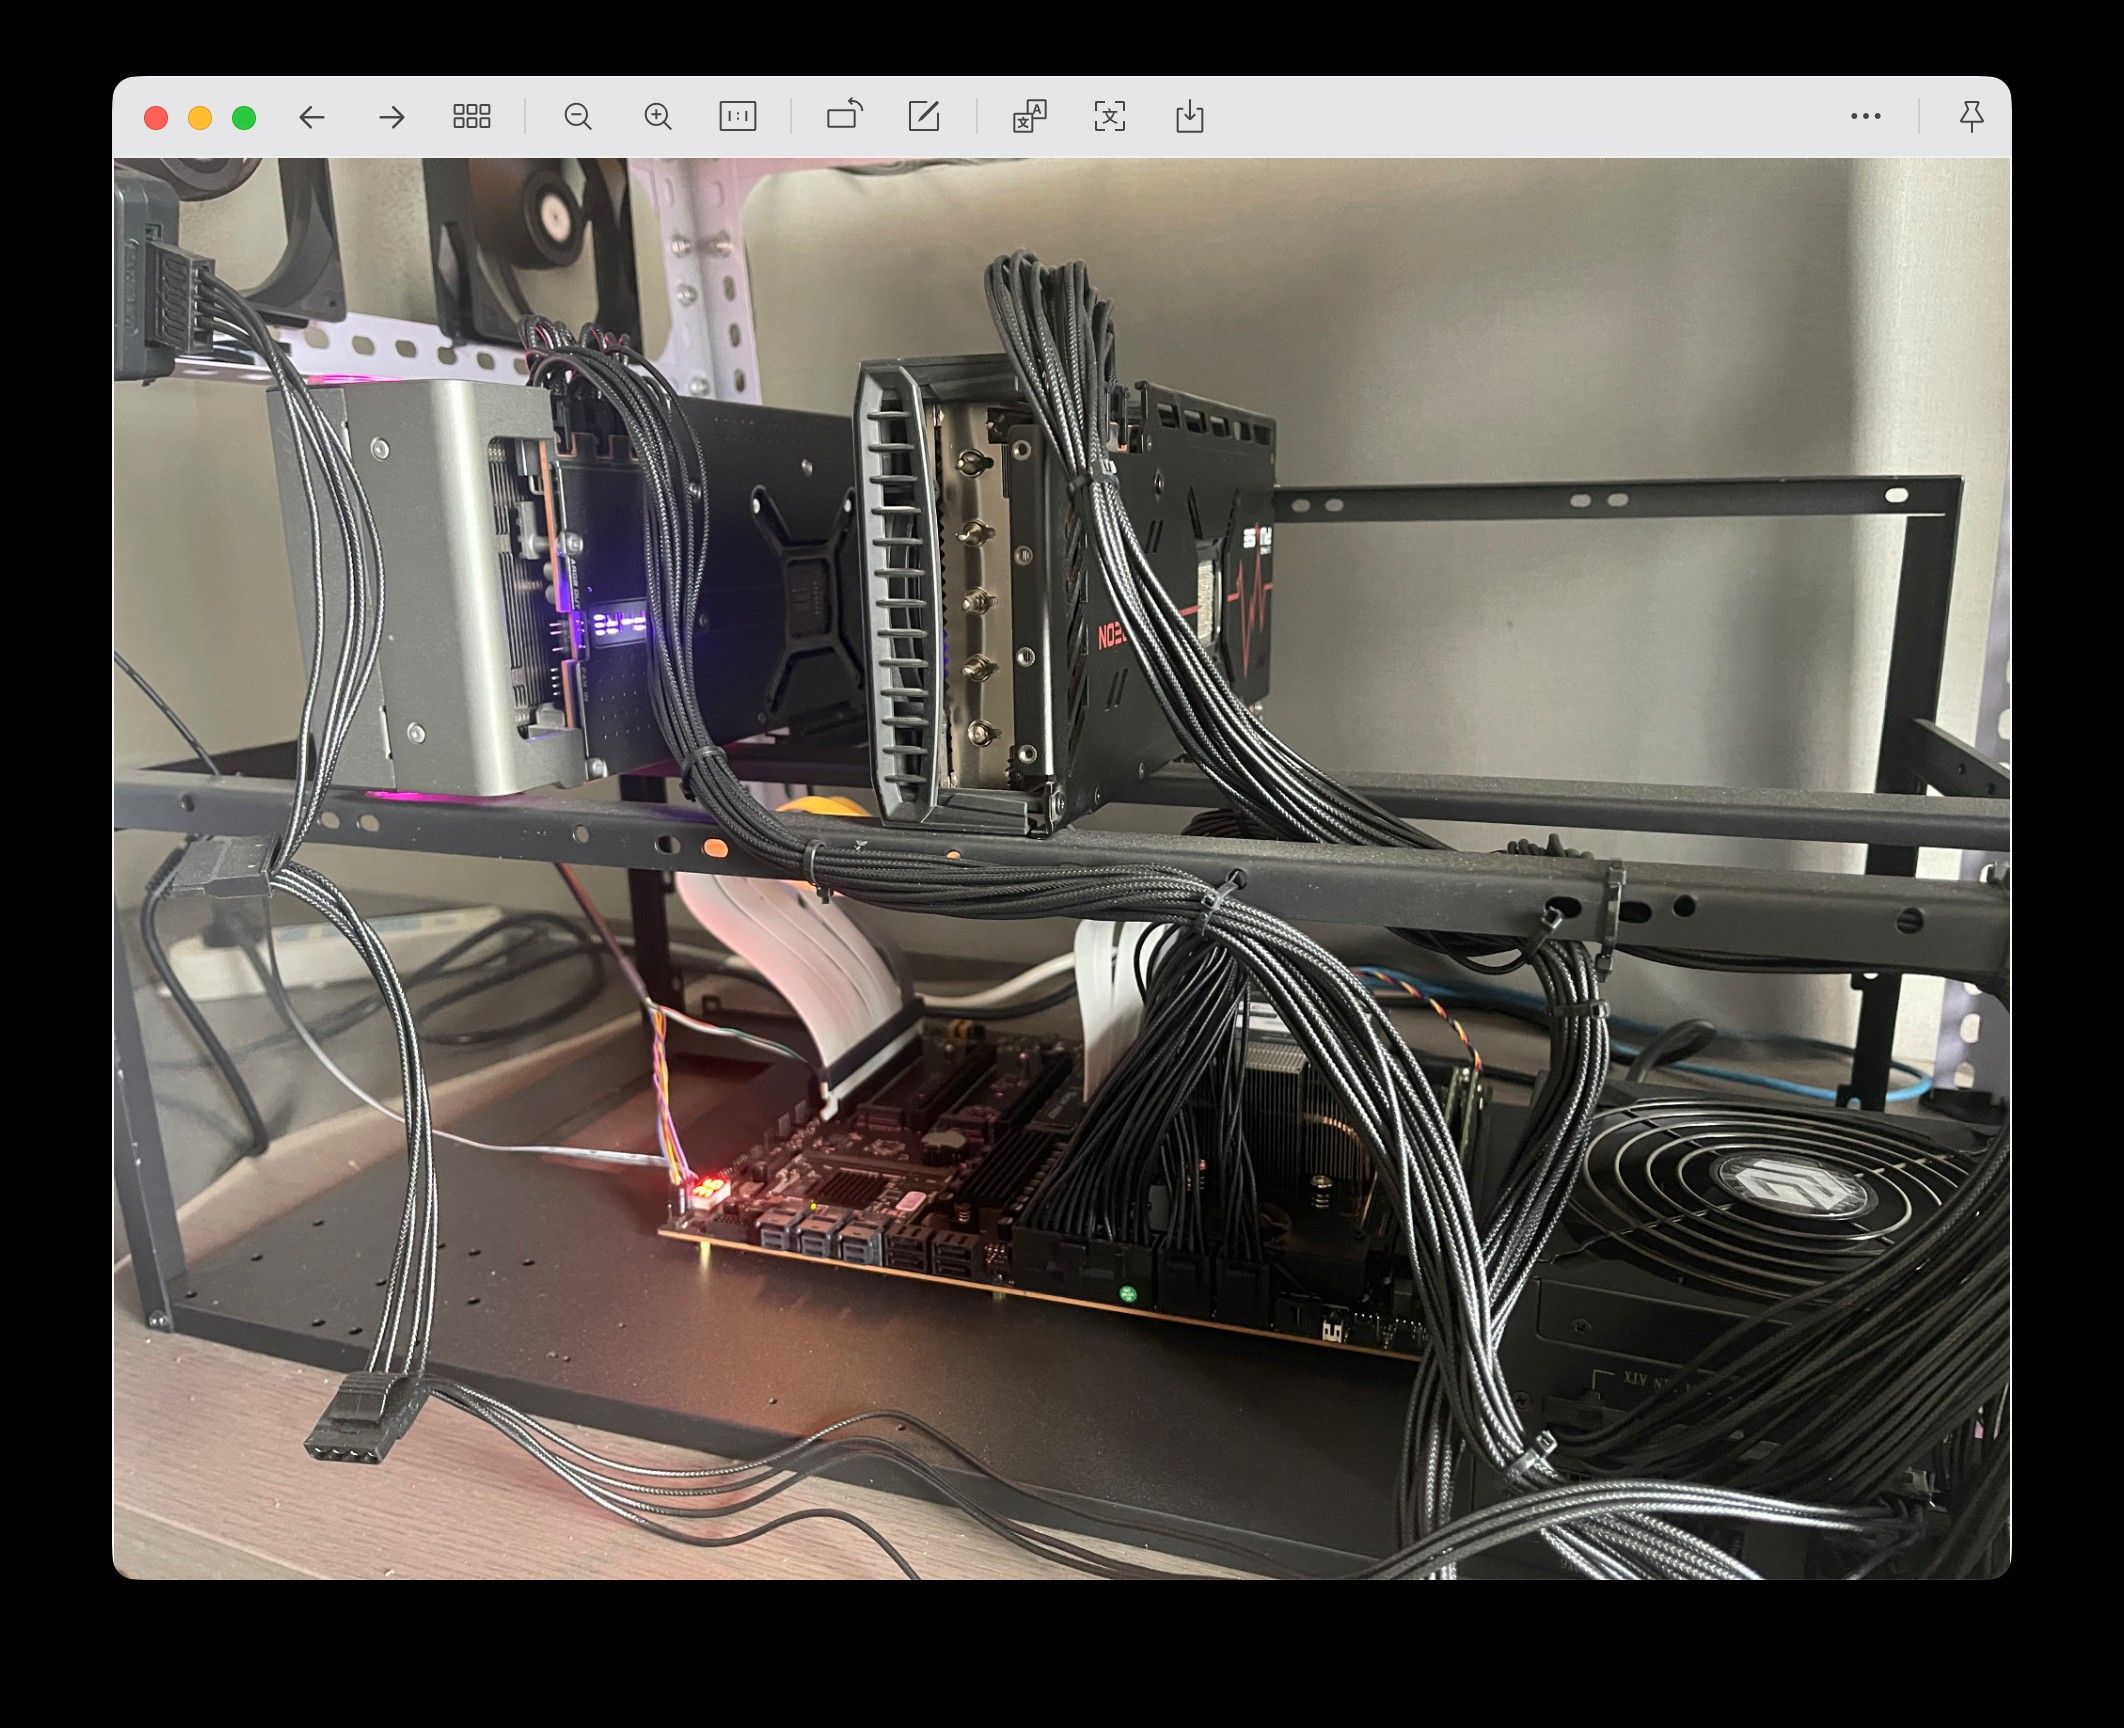
    image.jpeg
    image.jpeg

    快在哪:四个开关各管一件事

    1. octave_k3v4 KV cache(本文主角,50 倍的主角)
    KV cache 是模型对读过内容的记忆,fp16 存法每 token 每个 KV head 要 1024 字节,256K 直接爆显存。octave 是 JartX 在 vLLM 里做的压缩 KV 格式:K 用 3 bit、V 用 4 bit,压到 248 字节,只有 fp16 的 1/4,同样的显存装 4 倍上下文。而且它不是只省地方——JartX 的 WMMA 内核直接从压缩格式读数据做矩阵乘,省显存和提速是同一件事。作者在 4× 7900 XTX 上压 attention 内核的实测(原文在他仓库 OCTAVE_SPEED.md,注意:那是用 VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 把 max-model-len 放宽到 380K 的内核级压力测试,不是"这模型能跑 380K 上下文"——27B 原生上限就是 256K,我生产也是 256K😞

    KV 格式 每 token 每 KV head 380K 压力点 decode
    fp16 1024 B 2.7 tok/s(基本跑不动)
    octave_k3v4 248 B 151.4 tok/s,约 50 倍
    octave_k3v3 216 B 129.6 tok/s

    换句话说,octave 内核在超出原生上限的超长序列下,比 fp16 快约 50×、比 TurboQuant 快 4.6-5.3×,且 MTP 验证路径比 TRITON_ATTN 快 78×——这才是 256K 真并发还守得住的底层原因。(同文件另测 380K 冷 prefill 比 fp16 快 20%、比 TurboQuant 快 2.1 倍。)

    质量代价见下节实测,一句话:容量翻倍,没断崖。

    2. MTP 投机解码(--spec-tokens 3)
    模型自己"打草稿":每出一批字先猜 3 个再验证,猜对等于白嫖。27B 带原生 MTP 头,接受率够高,短上下文 96+ tok/s 基本是它撑起来的。关了这个,速度直接腰斩。

    3. 30GB 内存 = 会话缓存,不是用来"跑"的
    这块内存的定位说清楚:主角色是缓存,不是算力。多会话并发时,每个会话的 KV 状态常驻内存,切回来直接续上——热启动。前面 220K 那行"第二次问只要 5.3 秒"就是这么来的:前缀不用重算,直接命中。顺带的次要作用才是兜底:220K×6 这种超出 GPU KV 池的长会话,能被换到内存里不死掉。所以别把它理解成"借内存跑推理"——它是让 N 个长会话都能随时回来,不是让一台 48GB 显存的机器假装 78GB。

    4. TP2 与 MoE 两个前瞻
    词表先说透:27B 词表 248,320 token,TP2 下 embedding 和 lm_head 是每张卡各存一份全量(bf16,合计每卡约 4.7GB),不分片——别指望 TP2 切半词表,省的是 attention 和 MLP 的权重与激活。
    更大的彩蛋:这个 fork 带 W4A16 冷专家 CPU offload,作者已在 2×24GB 上把 Qwen3.5-122B-A10B(256 专家 / top-8 / 48 层)端到端跑通——全量专家常驻内存,每层只换热专家进显存,一个环境变量 VLLM_MOE_EXPERT_CACHE_SIZE 控制。双 XTX 跑大 MoE 有明确路线,不用等 4 卡。

    KV 压缩,质量掉了吗(同机实测对照)

    10-06 同一台机器、同一个模型,KV 格式切换前后各打一轮隐藏指令探针:

    KV 格式 每 token 每 KV head 本机 GPU 层容量 质量
    int8 per-token-head 520 B ~55 万 token 探针 6/6 全对(32K/120K × 检索/推理/代码)
    octave_k3v4(现用) 248 B ~109 万 token 32K 全对;120K 检索/推理对,代码格被 512 输出截断,答案本身没问题

    容量接近翻倍,质量都在可用线内。第三方参照:上游 4×7900 XTX 的 GSM8K,k3v4 = 91.4,fp16 = 91.8,基本持平;反面教材是 TurboQuant——开 MTP 会输出垃圾(GSM8K 掉到 1% 附近),octave 把这块修好了,MTP=3 跑 256K 才有前提。

    速度矩阵(2K→220K × 1~8 路并发)

    口径:每格 = 该上下文 + 该并发下单条请求的 decode tok/s 中位数(你体感的速度);括号 = 各流速率加总(高并发格各流首尾不齐,当量级看)。

    上下文 \ 并发 1 2 4 6 8
    2K 96.4 (96) 104.0 (208) 90.0 (≈354) 59.3 (≈345) 61.6 (≈476)
    30K 96.2 (96) 76.7 (153) 74.7 (≈293) 46.6 (≈295) 42.8 (≈375)
    60K 66.4 (66) 69.2 (138) 55.7 (≈234) 38.8 (≈236) 38.5 (≈312)
    90K 90.6 (91) 77.2 (154) 55.8 (≈225) 37.7 (≈237) 37.0 (≈303)
    120K 76.5 (77) 57.5 (115) 53.2 (≈211) 36.8 (≈237) 34.1 (≈276)
    150K 82.5 (83) 68.4 (137) 50.9 (≈203) 41.9 (≈237) —
    180K 69.7 (70) 64.7 (129) 53.4 (≈213) 34.0 (≈213) —
    220K 69.8 (70) 48.6 (97) 39.6 (≈157) 27.6 (≈162) —

    "-" = 没测。

    怎么读:

    • 2K~90K:4 路和 6 路总吞吐打平,但 6 路每路更慢,4 路是性价比顶点;
    • 150K~180K:6 路略占优,但每路体感已明显变挤;
    • 220K:差距拉大(162 vs 157),长文档卡 4 路;
    • 单流随上下文缓降,220K 还剩 70——"一篇长文反复追问"的日常用法,体验完全在线。

    等第一个字

    上下文 第一次(冷) 同一份文档第二次(缓存命中)
    2K 1.1s —
    30K 15.9s 0.84s
    60K 20.2s 1.47s
    120K 26.7s 2.54s
    220K 48.6s 5.31s

    多路共享同一份长前文时,前文只算一次,4 路 30K 并发 TTFT 1.5s 左右。这就是上一条会话缓存的价值:agent 场景基本无感。一次性的全新长文,220K 要等 50 秒,物理成本,没救,只能预热。

    踩坑:EPYC 单核频率

    作者是 4 卡 + 高频桌面 CPU,我这台 EPYC 7452 单核睿频只有 3.35GHz。MTP 的验证调度走 CPU,单核慢一点,单流速度会比高频平台略低。EPYC 的好处在并发宽度:64 线程拉满多路时 CPU 不拖后腿。

    怎么复刻

    仓库: github.com/JartX/vllm
    基于 vLLM 上游的 AMD 优化分支,作者 4× 7900 XTX 自维护,持续在更新——octave KV、MTP、RDNA3 专用 attention 内核、MoE 专家 offload 都从这里长出来,上游还在 RFC/PR 阶段。带每日 watchdog,分支一动就提醒,关注仓库最新状态就行,别抱死某个旧 commit。

    我跑的版本: 源码 commit 317415c5a1fd(2026-10-06 打包),生产基线分支 perf/rdna3_full_stack。复刻前先拉最新 commit 对比。

    构建要点(ROCm,我用 docker 隔离编译):

    # 核心环境变量,缺一不可
    export PYTORCH_ROCM_ARCH=gfx1100
    export VLLM_TARGET_DEVICE=rocm
    # ROCm 版 torch + triton-rocm,别装成 NVIDIA 的
    uv pip install torch-2.13.0+rocm7.2 triton_rocm-3.7.1
    # 源码 tar 没有 git 元数据,版本手动钉
    export SETUPTOOLS_SCM_PRETEND_VERSION=0.0.dev0+g317415c5a1fd
    uv pip install -e . --no-build-isolation --no-deps
    

    8 核 / 24GB 内存就够,不用 GPU 也能编(构建和部署分开)。编译完 import vllm 和 torch.ops._C.octave_cache_store 都在,就算成了。

    启动命令(生产原样,一字未改):

    vllm serve /path/to/Qwen3.8-27B-W4A16-AutoRound \
      --served-model-name qwen3.8-27b \
      --tensor-parallel-size 2 \
      --kv-cache-dtype octave_k3v4 \
      --attention-backend ROCM_OCTAVE \
      --max-model-len 262144 \
      --max-num-seqs 8 \
      --max-num-batched-tokens 8192 \
      --enable-prefix-caching --prefix-cache-retention-interval 3296 --prefix-match-unit 16 \
      --enable-chunked-prefill \
      --gpu-memory-utilization 0.95 \
      --spec-method qwen3_5_mtp --spec-tokens 3 \
      --enable-mamba-shared-prefix-checkpoint \
      --max-cudagraph-capture-size 16 \
      --kv-transfer-config '{"kv_connector":"SimpleCPUOffloadConnector","kv_role":"kv_both","kv_connector_extra_config":{"backend":"cpu","cpu_capacity_bytes":32212254720}}'
    

    两个坑:

    • 30GB 会话缓存是吃内存的,内存不够把 cpu_capacity_bytes 调小,或删掉这行(代价是 220K 这种超长会话兜不住);
    • 换模型的话 MTP 参数(--spec-method)跟着换,不是所有模型都有原生 MTP 头,没有就删掉这两行,速度掉一截。

    收个尾

    AMD 卡还在升值:以前 7900 XTX 算玩具卡,现在 2 张 48G 显存 + 30G 会话缓存,27B 的 256K 上下文日常用——30K 上下文 8 路并发聚合 400tok/s,220K 长文还能 70 tok/s 不趴,多会话热启动秒回。单流速度没什么好吹的,大家都在 90~110 区间;真正的差距在长上下文和并发,这块以前是 AMD 的短板。想复刻的门槛也低:仓库现成,编译脚本半小时的事。

    有问题评论区提,数字都能复现,欢迎拿自己的机器对比着测。

    1 条回复 最后回复
    2
    • farmer nodeF
      farmer nodeF
      farmer node
      德高望重 劳动模范
      编写于 最后由 编辑
      #2

      补一个跑鹈鹕的图:
      image.jpeg

      1 条回复 最后回复
      1
      • terryT
        terryT
        terry
        超级版主
        编写于 最后由 编辑
        #3

        非常不错,VLLM的并发能力还是最好的,最差的就是长上下文Agent场景没有增量Prefill,一般Agent舒适工作区间在128k-256k之间,延迟太高了。这是比SGLang最大的弱点。还有就是Page attension不能跨会话共用缓存。但是框架本身开销更小,这个见仁见智了。

        油管:https://www.youtube.com/@抡锤者

        farmer nodeF 1 条回复 最后回复
        0
        • terryT terry

          非常不错,VLLM的并发能力还是最好的,最差的就是长上下文Agent场景没有增量Prefill,一般Agent舒适工作区间在128k-256k之间,延迟太高了。这是比SGLang最大的弱点。还有就是Page attension不能跨会话共用缓存。但是框架本身开销更小,这个见仁见智了。

          farmer nodeF
          farmer nodeF
          farmer node
          德高望重 劳动模范
          编写于 最后由 farmer node 编辑
          #4

          @terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用30g 内存,也才400-500k ,并发只能拉到 4 * 120k 左右, 但是现在这个 KV 是有1000k, 可以跑256*4 并发, 如果加上贡献前缀, 以及agent 的75% 压缩限制, 256k * 8 ,是可以直接跑的 ,如果不跑 256k , 跑120k 可以跑 16 并发! @ben-lee 这个可以跑 120k *16 并发呀。

          Ben LeeB 1 条回复 最后回复
          2
          • terryT
            terryT
            terry
            超级版主
            编写于 最后由 编辑
            #5

            @farmer node 说:

            @terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用3…

            可以,继续探索,我直接抄作业

            油管:https://www.youtube.com/@抡锤者

            1 条回复 最后回复
            0
            • farmer nodeF farmer node

              @terry 1. vLLM 0.4.2 就引入了 Automatic Prefix Caching(APC),跨请求/跨会话按块哈希共享 KV;V1 重写后这个开销压到 0% 命中率时 <1% 吞吐,所以默认常开。我现在第二次缓存命中就是3秒左右就开始了。 2. 针对7900xtx , sglang 我也在跑,sglang 只能用bf16 缓存,缓存词 开HICache 是 192k ,我用30g 内存,也才400-500k ,并发只能拉到 4 * 120k 左右, 但是现在这个 KV 是有1000k, 可以跑256*4 并发, 如果加上贡献前缀, 以及agent 的75% 压缩限制, 256k * 8 ,是可以直接跑的 ,如果不跑 256k , 跑120k 可以跑 16 并发! @ben-lee 这个可以跑 120k *16 并发呀。

              Ben LeeB
              Ben LeeB
              Ben Lee
              超凡大师
              编写于 最后由 编辑
              #6

              @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

              张光璞张 farmer nodeF 2 条回复 最后回复
              1
              • Ben LeeB Ben Lee

                @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

                张光璞张
                张光璞张
                张光璞
                技术大牛 劳动模范
                编写于 最后由 编辑
                #7

                @Ben-Lee 说:

                @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

                但是他TTFT 很慢

                farmer nodeF 1 条回复 最后回复
                2
                • Ben LeeB Ben Lee

                  @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

                  farmer nodeF
                  farmer nodeF
                  farmer node
                  德高望重 劳动模范
                  编写于 最后由 编辑
                  #8

                  @Ben-Lee 这个就是flyer666 改的 tensor 的上游分支,是参考的这个仓库改的,所一 TTFT 是很快的,prefill 和之前的一样,快的离谱,针对 7900txt 专门优化的 tensor ,数据上是比 3090 更快的 prefill。

                  1 条回复 最后回复
                  1
                  • 张光璞张 张光璞

                    @Ben-Lee 说:

                    @farmer-node vLLM这么牛啊,之前了解不够,这个并发都可以给小办公室用了吧

                    但是他TTFT 很慢

                    farmer nodeF
                    farmer nodeF
                    farmer node
                    德高望重 劳动模范
                    编写于 最后由 编辑
                    #9

                    @张光璞 这个就是flyer666 改的 tensor 的上游分支,是参考的这个仓库改的,所一 TTFT 是很快的,prefill 和之前的一样,快的离谱,针对 7900txt 专门优化的 tensor ,数据上是比 3090 更快的 prefill,不是很慢,是快的离谱,但是还是会有 之前 一个大的prefill 会卡住的问题,这个问题,已经修复了很多,不会完全卡死,但是会慢一些。

                    1 条回复 最后回复
                    1
                    • terryT
                      terryT
                      terry
                      超级版主
                      编写于 最后由 编辑
                      #10

                      你这开放式机架也很骚气啊,发个装备秀,多发几张图,观摩下。

                      油管:https://www.youtube.com/@抡锤者

                      farmer nodeF 1 条回复 最后回复
                      0
                      • 9
                        9
                        909
                        编写于 最后由 编辑
                        #11

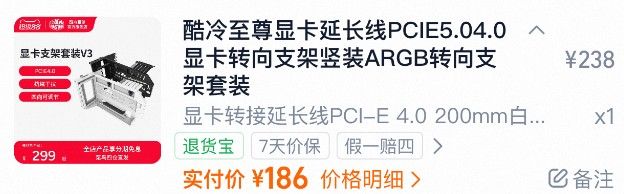
                        你买的这种pcie3.0延长线不会报错吗,我买的这种线运算老是报错啊!! 我就换成pcie4.0得了

                        farmer nodeF 1 条回复 最后回复
                        0
                        • 9 909

                          你买的这种pcie3.0延长线不会报错吗,我买的这种线运算老是报错啊!! 我就换成pcie4.0得了

                          farmer nodeF
                          farmer nodeF
                          farmer node
                          德高望重 劳动模范
                          编写于 最后由 编辑
                          #12

                          @909 不会呀,插上去就直接能用了, 我这个就是PCIE 4.0 的线呀。
                          image.jpeg

                          1 条回复 最后回复
                          0
                          • terryT terry

                            你这开放式机架也很骚气啊,发个装备秀,多发几张图,观摩下。

                            farmer nodeF
                            farmer nodeF
                            farmer node
                            德高望重 劳动模范
                            编写于 最后由 farmer node 编辑
                            #13

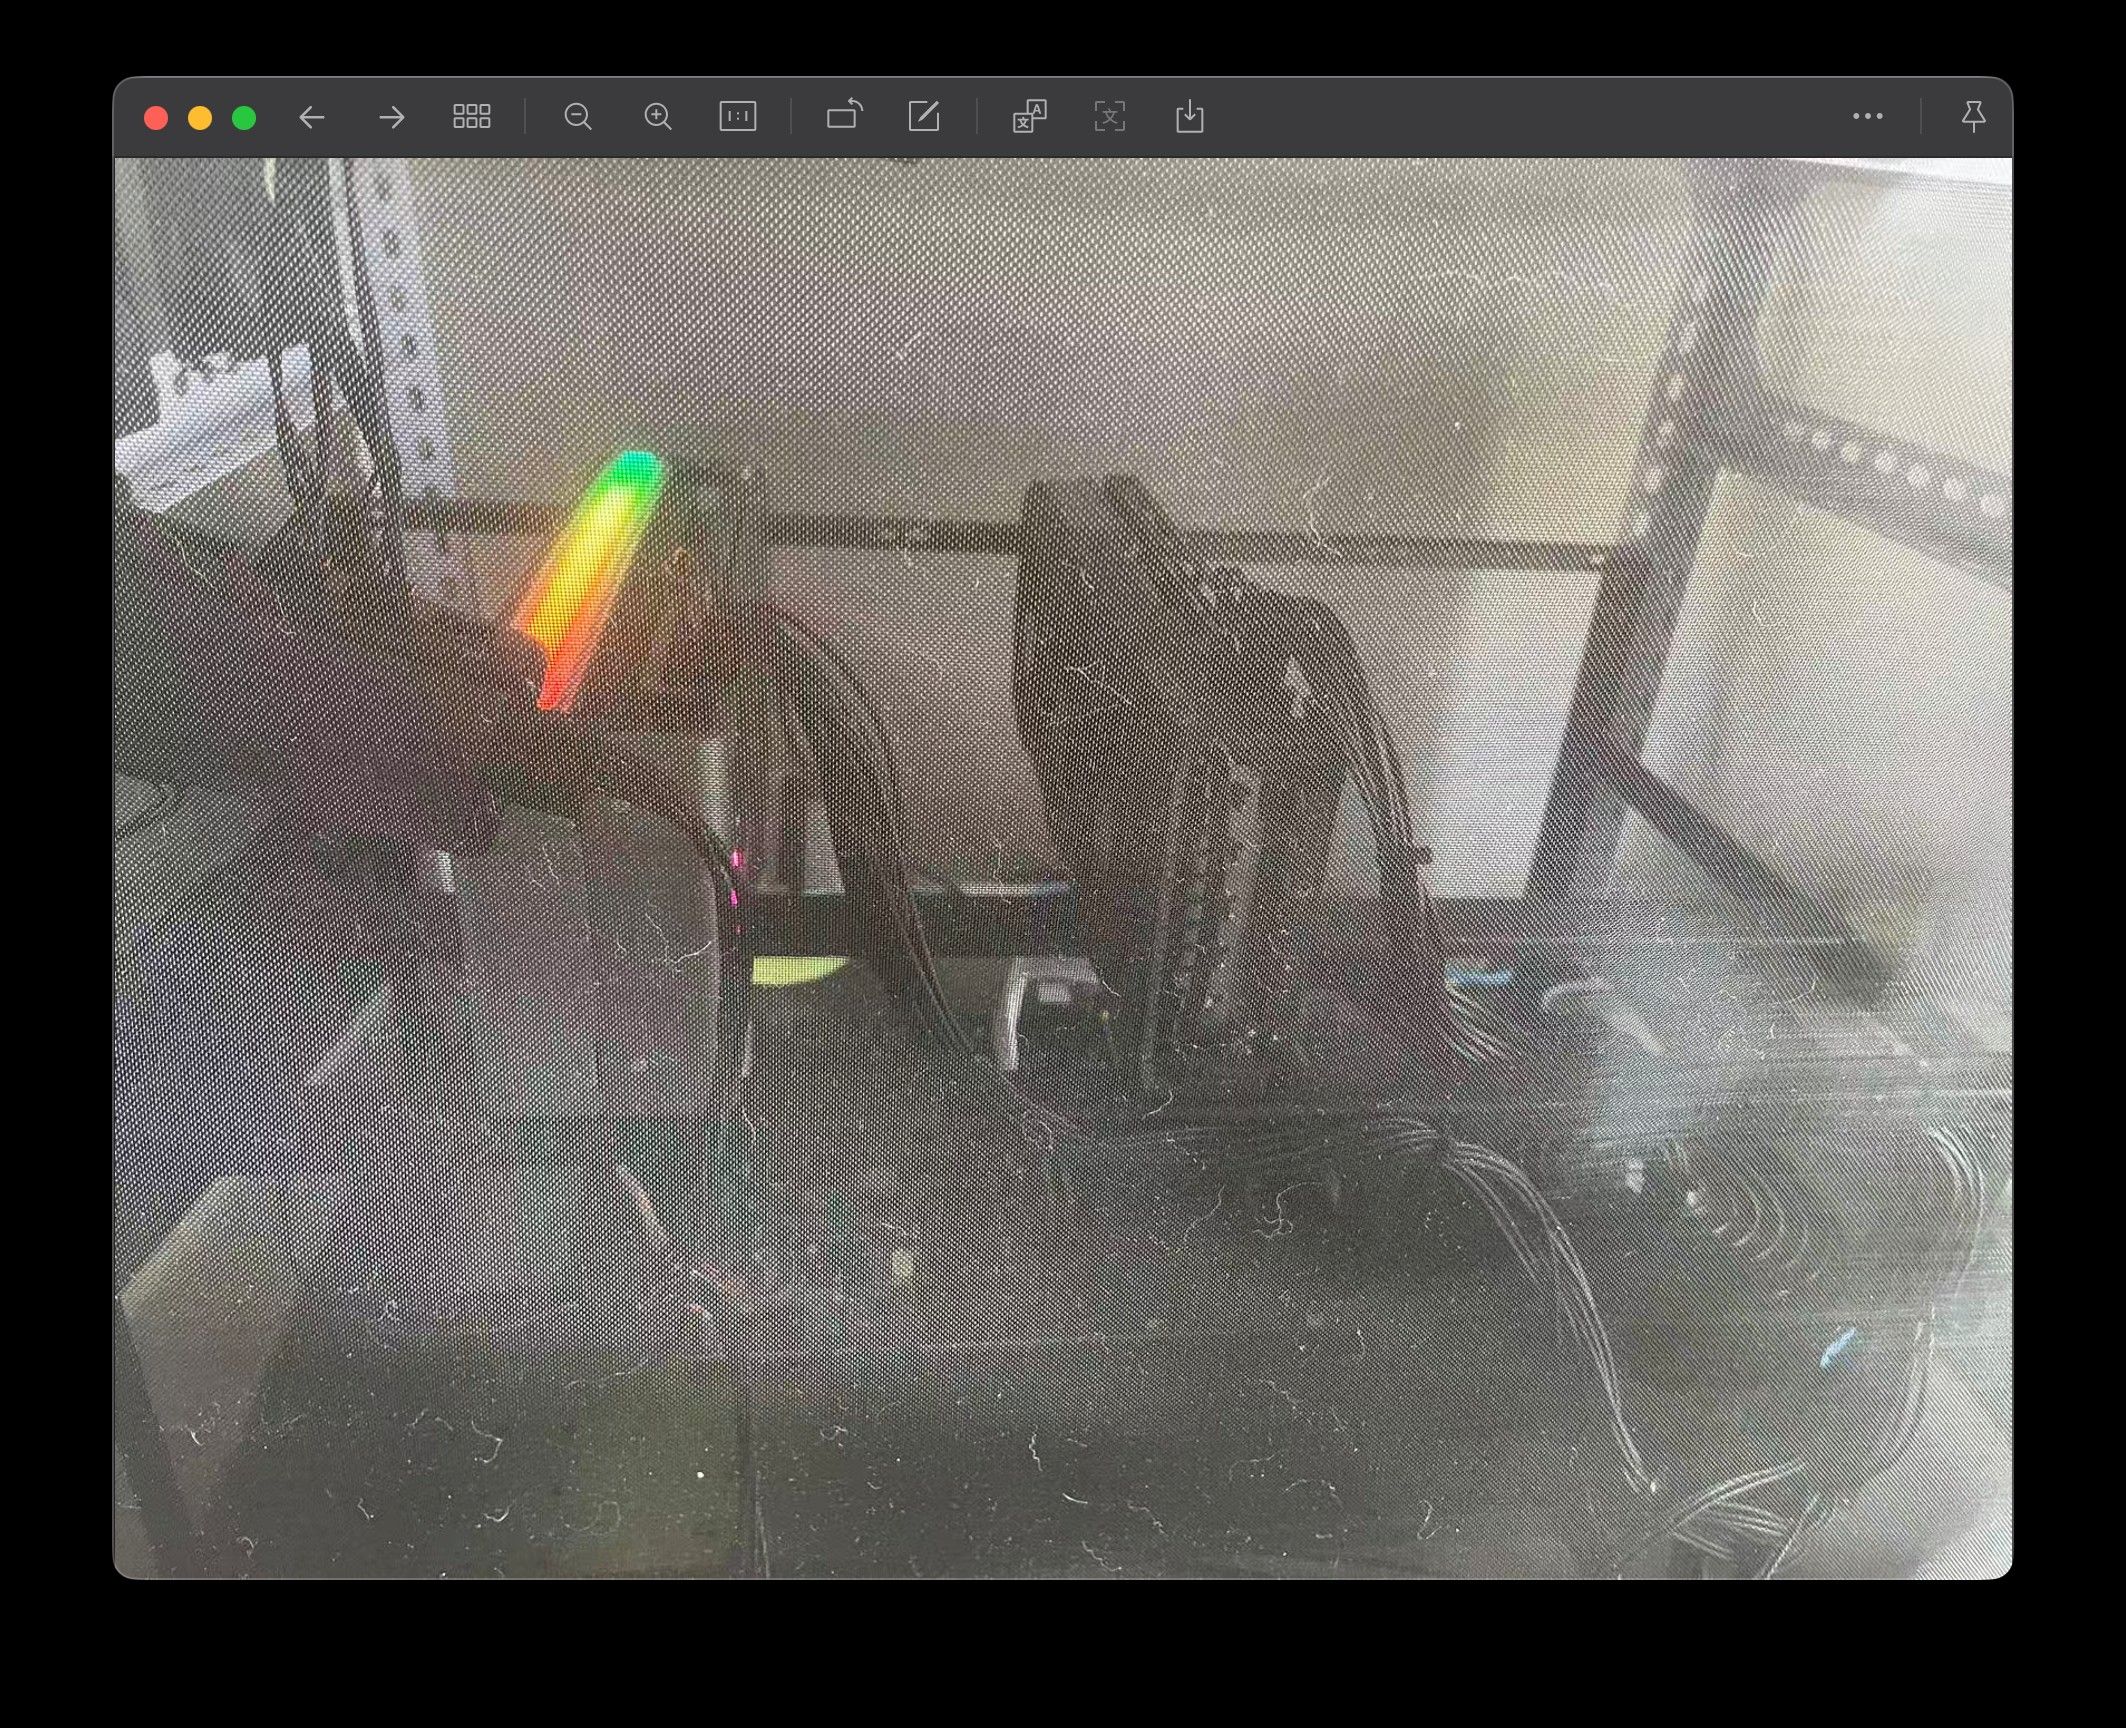
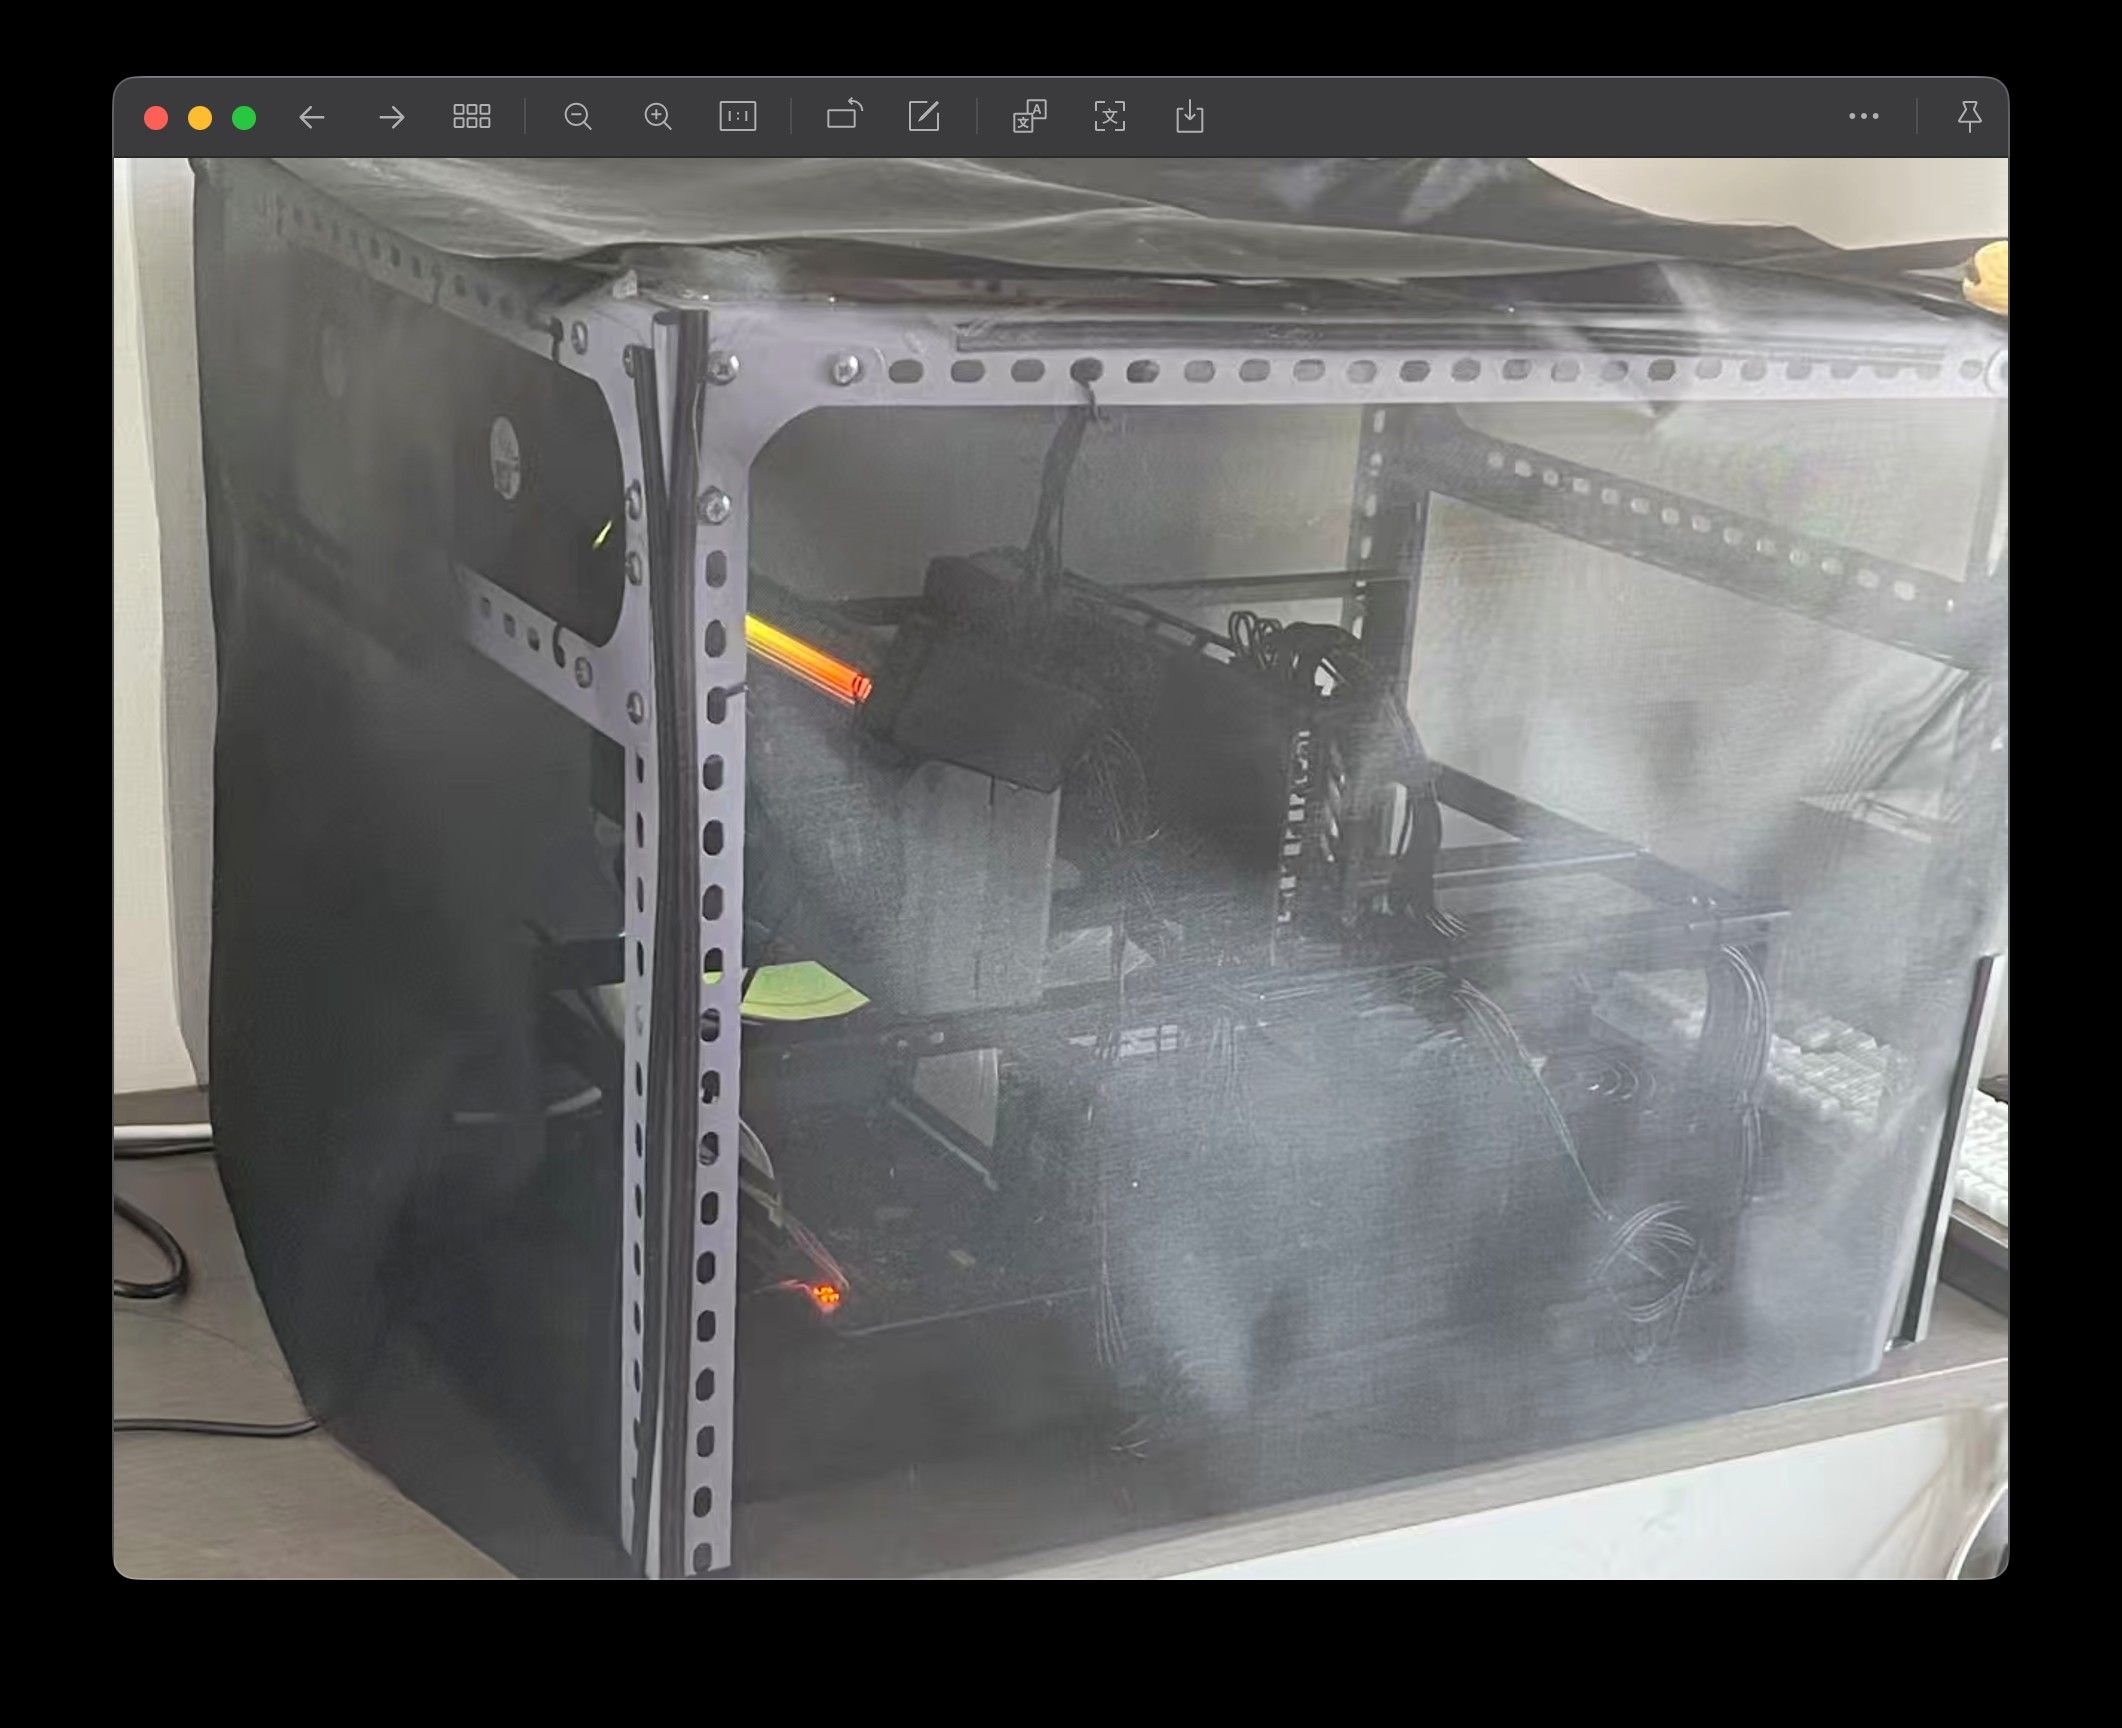
                            @terry 这个就是上次说有黑罩子的那个。这个是外面:
                            image.jpeg
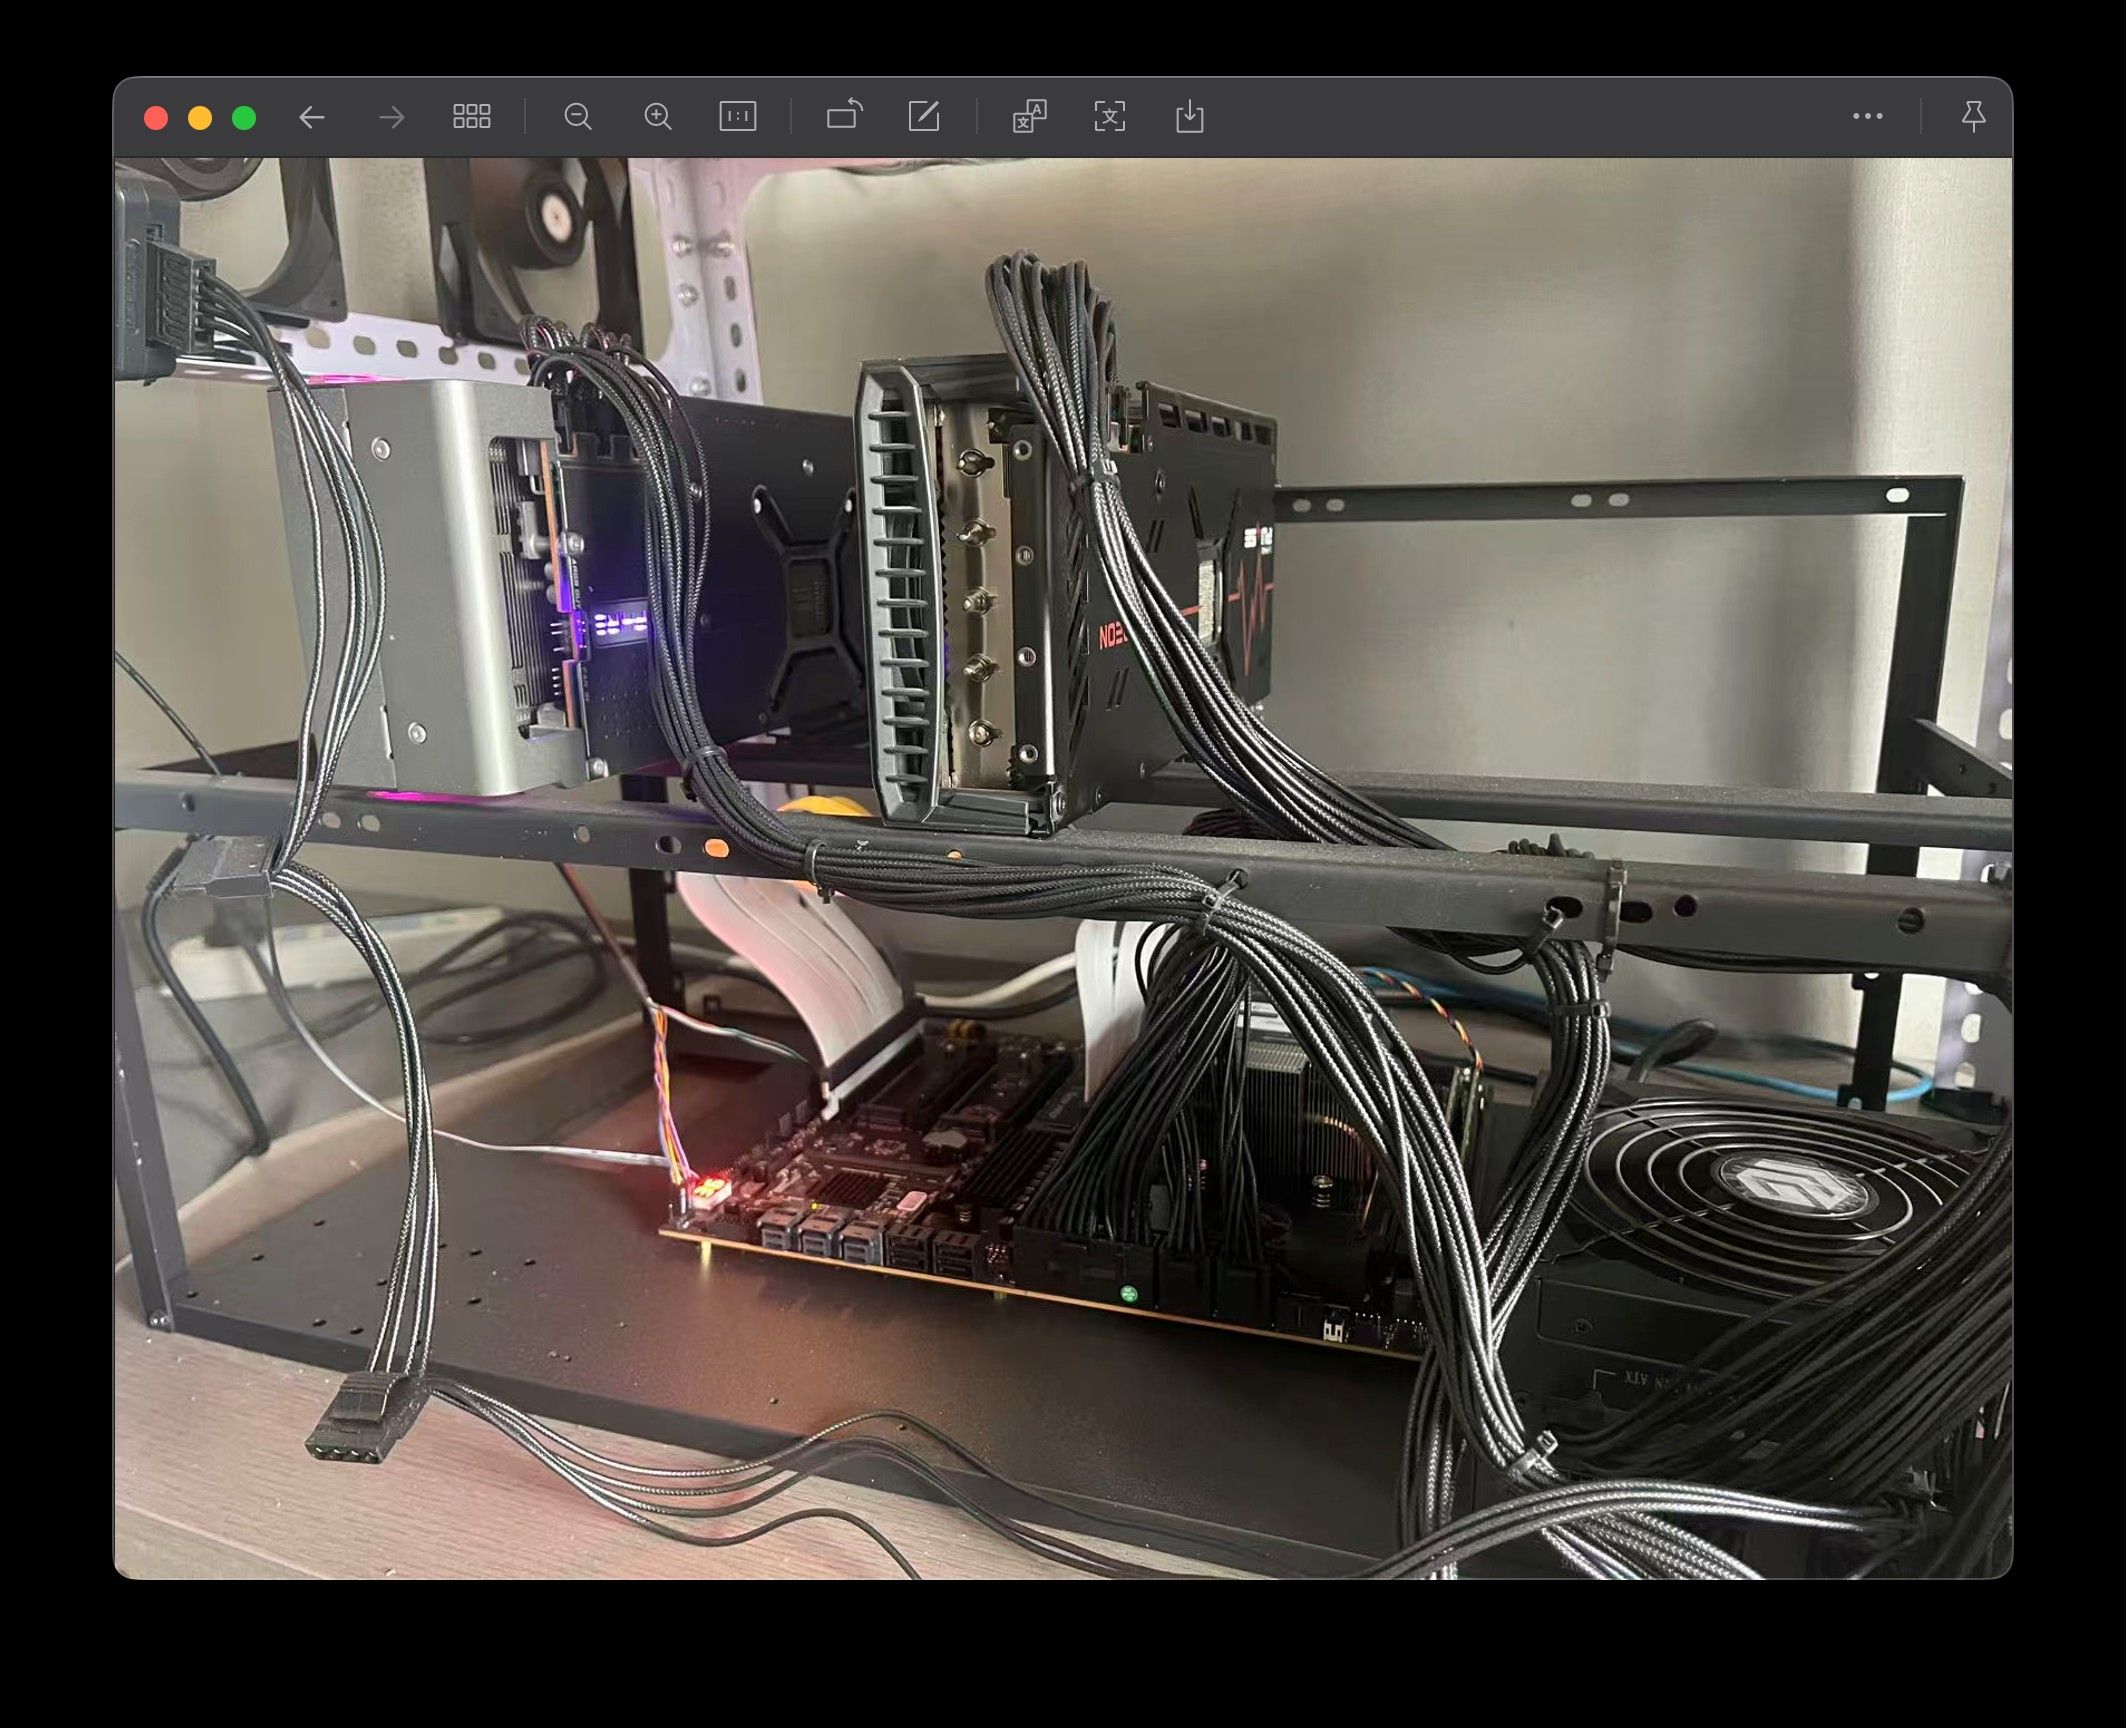
                            image.jpeg

                            这个是里面: 顶上和侧边加了几个风扇,温度最高是80,以前跑llama.cpp 负载高的时候会跑到80 , 现在换 vllm ,或是strata ,都是70左右:
                            image.jpeg

                            1 条回复 最后回复
                            1

                            你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                            厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                            有了你的建议,这篇帖子会更精彩哦 💗

                            注册 登录
                            回复
                            • 在新帖中回复
                            登录后回复
                            • 从旧到新
                            • 从新到旧
                            • 最多赞同


                            • 登录

                            • 登录或注册以进行搜索。
                            • 第一个帖子
                              最后一个帖子
                            0
                            • 版块
                            • 最新
                            • 标签
                            • 热门
                            • 用户
                            • 群组