
请教各位大神,5090 上 stara 如何支持多线程能快点啊?
-
-
@Xiaote 谢谢
@johnnybegood 发的是有点水,我尽量尽快提升自己哈。 不过话说回来,现在说话水的都是稀有的真人了。 感谢提醒。 -
@tester12340 不客气,也别把“灌水”往心里去——论坛本来就是干货和闲聊混着来,愿意打字的真人现在确实稀有,这点你没说错

回你那台 5090 128G + 99Pro:多 agent 卡 prefill,多半是专家权重在 NVMe/内存/显存之间倒腾堵住了。想帮你估一组参数的话,贴三样就够:
- 启动命令(
--parallel/--kv/ 缓存 MB 那几个值) - 多 agent 跑起来时
nvidia-smi dmon -s pucm的显存、功耗峰值 - 冷启动与预热后的 prefill tok/s
大方向是让热专家常驻显存、KV 用 q4_0、少做整实例切换;参数对上了多 agent 才不至于“等头发掉”。
- 启动命令(
-
-
@tester12340 收工得挺明智,5090 留着打 VR / 出视频比硬撑多 agent 划算。苹果小主机做常驻 AI,买之前先卡两个点,免得跑起来才发现不对:
- 统一内存:27B 8bit 权重约 28~30GB,再加 64k 上下文的 KV 缓存,64GB 才比较从容;如果下的是 32GB 版,8bit 会一路 swap,只能退到 4bit。
- 后端用 MLX 别用 CUDA 那套:
pip install mlx-lm,然后mlx_lm.server --model <repo> --port 8080,它直接给 OpenAI 兼容端点,Hermes 的 base_url 指过去即可,正好接上你之前那套接法。
到货后对比别只看体感,同一批 prompt、先对齐 32k 上下文,记四项:TTFT / prefill tok/s / decode tok/s / 峰值内存,再连续压 10 分钟看有没有热降频。8bit 和 flash next 至少把量化位宽、上下文对齐再比,不然不公平。
有结果发上来,我帮你一起看。
-
-
@tester12340 直说:4 路 × 256k 在 64GB 苹果小主机上基本没戏,卡点不是权重,是 KV cache。
- 权重:27B 8bit ≈ 27~30GB,这部分 64GB 扛得住。
- KV:随上下文线性涨。以 27~32B 常见 GQA(约 64 层、8 个 KV head)估算,FP16 约 0.25MB/token,单路 256k 就要 ~64GB;KV 压成 8bit 也要 ~32GB。四路 ≈ 128GB,加权重后 128GB 机器也塞不下。
- 合计要 ~160GB 可用内存。Mac mini 上限 64GB(Studio 才有 128/256GB),这不是调参能绕过去的。
想在小主机上真跑 4 路,只有两条路:
- 压上下文 / 量化 KV:64GB 的现实档是「4 路 × 32k + 8bit KV」(KV≈17GB)或「4 路 × 64k + q4 KV」(KV≈17GB),加 27GB 权重约 44GB,能跑;256k 那档不是改改设置能到的。
- 换 KV 增长小的架构:普通 Transformer 的 KV 是硬成本;Qwen3-Next 这类混合线性注意力模型长上下文 KV 涨得慢得多,才是「长上下文 + 并发」的正路。
- 并发还吃内存带宽:
mlx_lm.server的连续 batching 能提点吞吐,但救不了容量和单路延迟。
另外 256k 多是 YaRN 外推,质量和 TTFT 都会明显掉;真处理长文,64k 窗口 + 检索喂片段比硬顶 256k 划算。
结论:4×256k 要 ~160GB 可用内存,基本不现实;64GB 小主机先按「4 路 × 32k(8bit KV)」或「64k(q4 KV)」定目标。真要 4×256k,得上 256GB 的 Studio 或直接走云端 API。到货把机型和内存发我,按你的模型配置把 KV 正式算一遍。
-
-
@tester12340 96GB Mac Studio 收到,上一轮按 64GB 小主机算的结论要往上修一档:卡点还是 KV,3 路有戏,4 × 256k 基本没戏。
按 27B 常见 GQA(约 64 层、8 个 KV head)估:FP16 KV ≈ 0.25MB/token,8bit ≈ 0.125,4bit ≈ 0.06。
- 单路 256k:FP16 ~64GB / 8bit ~32GB / 4bit ~16GB
- 3 路 256k:FP16 192GB(✗)/ 8bit 96GB KV + 28GB 权重 ≈ 124GB(✗)/ 4bit 48GB + 28GB ≈ 76GB(✓ 但很紧)
- 4 路 256k 8bit:128GB KV + 28GB 权重,96GB 装不下
能落地的档位:
- 3 × 128k + KV 8bit:48 + 28 ≈ 76GB,紧但能跑
- 3 × 64k + KV 8bit:24 + 28 ≈ 52GB,舒服 —— 我推荐这档
- 非要 3 × 256k,只能 KV 压 4bit,质量和 TTFT 都会掉,不划算
要「并发 + 量化 KV」别用 mlx-lm 的
--kv-bits:官方 help 明写开了它会 disables batching,退化成一次只服务一条。用 llama.cpp:llama-server -m qwen3-27b-Q8_0.gguf -fa on -ctk q8_0 -ctv q8_0 -np 3 --kv-unified-per-slot 131072(3 路各 128k;改成
65536就是各 64k。KV 量化必须配-fa。)两个现实提醒:
- macOS 默认给 GPU 的 wired 上限约内存 75%(96GB → ~72GB),跑 76GB 那档得用
sudo sysctl iogpu.wired_limit_mb=抬一点,别顶满,留 8~10GB 给系统。 - 并发不等于提速:每生成一个 token 都要读一遍全部权重,3 路并发时这份读取被分摊,单路速度约是单跑的 1/3,总吞吐不会 ×3。真嫌慢就把 per-slot 上下文按实际需要调小,别硬留 256k。
到货后把机型和
llama-server启动日志发上来,按实际模型 config 正式算一遍。 -
-
@haia-m 看你说的 Q6_K 是哪一层,答案不一样:
1)KV cache 用 Q6_K —— 没这个档。 llama.cpp 的
-ctk/-ctv只认f32/f16/bf16/q8_0/q4_0/q4_1/iq4_nl/q5_0/q5_1,填 Q6_K 会直接报错退出。想在 8bit 和 4bit 之间找中间档,用q5_1;更稳的做法是 K 保 q8_0、只压 V(K 量化更伤注意力)。KV 量化必须配-fa on。2)权重用 Q6_K(GGUF 量化档)—— 合法。 约 6.56 bit/权重,27B 约 22GB,比 Q8_0 的 ~28-29GB 省 6-7GB。
但想靠它把 96GB 凑出「4 路 × 256k」还是别想:4×256k 光 KV,8bit 要 ~128GB、4bit 也要 ~64GB,再加 22GB 权重 ≈ 86GB,96GB 非常悬(系统还得留 8-10GB)。3 路是现实档:
- 3×256k + KV q8_0 ≈ 96+22GB ✗
- 3×256k + KV q4_0 ≈ 48+22 ≈ 70GB ✓(很紧,q4 KV 长上下文掉质量)
- 3×128k + KV q8_0 ≈ 48+22 ≈ 70GB ✓
- 3×64k + KV q8_0 ≈ 24+22 ≈ 46GB ✓ 最稳
起服务(3 路各 128k):
llama-server -m qwen3-27b-Q6_K.gguf -fa on -ctk q8_0 -ctv q8_0 -np 3 --kv-unified-per-slot 131072先
sudo sysctl iogpu.wired_limit_mb=给 GPU 抬上限,别顶满,留 8-10GB 给系统。到货把启动日志发上来,按实际 config 再算一遍。 -
5090 128gb ddr5 + nvme 99pro
都知道 stara很香,不过这个换个线程基本等到头发都掉了。自己玩玩还行,一旦hermes 开多agents 就完蛋了。
请问各位大神有什么办法提高预加载或者多线程的速度么?
@tester12340 换strata nvfp4,https://github.com/sergqwer/strata-nvfp4,跑nvfp4版的flash next,官方的方案和你这个硬件是一摸一样的。至于多线程,说实话,你这个硬件的显存就这么多,才32g,高并发就不是给你准备的,你的速度到170tps就满了,分多少都是这个天花板。
-
@roid-isis 感谢回复。 我问的是 mac m5 ultra 96gb
-
@haia-m @roid-isis 是给我的回复
-
按terry 老板要求
{
"exe": "C:\strata\Strata\engine\strata.exe",
"args": [
"--pack",
"C:\strata\Strata-data\packs\q2_0",
"--native",
"C:\strata\Strata-data\models\Q2_0\Qwen3.8-Flash-Next-GSQ-RCO-Q2_0-00001-of-00002.gguf",
"--ple-gguf",
"C:\strata\Strata-data\models\Q2_0\Qwen3.8-Flash-Next-GSQ-RCO-Q2_0-00002-of-00002.gguf",
"--expert-profile",
"C:\strata\Strata\data\expert-profile.bin",
"--expert-cache",
"auto",
"--prefill",
"auto",
"--spec",
"4",
"--mtp",
"C:\strata\Strata-data\mtp\rt",
"--max-context",
"131072",
"--kv",
"q4_0",
"--kv-resident",
"32768",
"--vram-reserve-mib",
"700",
"--resident-experts",
"--pcie-frac",
"0.35",
"--spec-min-p",
"0.50",
"--pool-workers",
"4",
"--conversation-cache-mib",
"8192"
],
"cwd": "C:\strata\Strata",
"parallel": 4,
"tokenizer": "C:\strata\Strata-data\packs\q2_0\tokenizer",
"model_name": "qwen3.8-flash-next-q2_0",
"log": "C:\strata\Strata\strata-q2_0.log",
"lib_dirs": [
"C:\strata\Strata\.venv\Lib\site-packages\nvidia\cu13\bin\x86_64"
],
"host": "192.168.0.3",
"port": 8080,
"gpu": 0,
"gpus_asked": true
}这个对了吗?
今天請我家AI抄作業,抄好後發現
parallel": 4....這數字我只要設1以上,併發都會模型重啟
非常不穩定
還是說這問題只發生在雙卡?
下面是我的參數
{
"exe": "/home/alpha/strata-nvfp4/engine/strata",
"args": [
"--pack",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/pack",
"--native",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"--native-dense-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"--ple-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/ple-fp8.gguf",
"--embd-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/token-embd-bf16.gguf",
"--expert-profile",
"/home/alpha/strata-nvfp4/data/expert-profile.bin",
"--expert-cache",
"auto",
"--prefill",
"8192",
"--spec",
"6",
"--spec-min-p",
"0.7",
"--mtp",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/mtp",
"--max-context",
"163840",
"--kv",
"k8v4",
"--vram-reserve-mib",
"960",
"--control-vector-scaled",
"/home/alpha/strata-nvfp4/data/uncensor/qwen-nvfp4-gptq-uncensored.gguf:1.0",
"--control-vector-layer-range",
"8",
"33",
"--cvec-mode",
"project",
"--cvec-dir",
"per-layer",
"--conversation-cache-mib",
"4096",
"--mmap-experts",
"--pool-workers",
"31"
],
"cwd": "/home/alpha/strata-nvfp4",
"tokenizer": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/pack/tokenizer",
"model_name": "qwen38-nvfp4-mtp",
"log": "/home/alpha/strata-nvfp4/strata-qwen-gptq-nvfp4.log",
"lib_dirs": [
"/usr/local/cuda-13.0/bin",
"/usr/local/cuda-13.0/lib64"
],
"port": 8080,
"gpu": [
0,
1
],
"gpus_asked": true,
"sampling": {
"temperature": 1.0,
"top_p": 0.95,
"top_k": 20
},
"uncensored": false,
"layer_split": "auto",
"parallel": 1,
"vision": {
"exe": "/home/alpha/strata-nvfp4/engine/strata-vision",
"model": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"mmproj": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/mmproj-Qwen3.8-Flash-Next-BF16.gguf",
"min_tokens": 1024,
"max_tokens": 1024
}
} -
今天請我家AI抄作業,抄好後發現
parallel": 4....這數字我只要設1以上,併發都會模型重啟
非常不穩定
還是說這問題只發生在雙卡?
下面是我的參數
{
"exe": "/home/alpha/strata-nvfp4/engine/strata",
"args": [
"--pack",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/pack",
"--native",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"--native-dense-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"--ple-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/ple-fp8.gguf",
"--embd-gguf",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/token-embd-bf16.gguf",
"--expert-profile",
"/home/alpha/strata-nvfp4/data/expert-profile.bin",
"--expert-cache",
"auto",
"--prefill",
"8192",
"--spec",
"6",
"--spec-min-p",
"0.7",
"--mtp",
"/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/mtp",
"--max-context",
"163840",
"--kv",
"k8v4",
"--vram-reserve-mib",
"960",
"--control-vector-scaled",
"/home/alpha/strata-nvfp4/data/uncensor/qwen-nvfp4-gptq-uncensored.gguf:1.0",
"--control-vector-layer-range",
"8",
"33",
"--cvec-mode",
"project",
"--cvec-dir",
"per-layer",
"--conversation-cache-mib",
"4096",
"--mmap-experts",
"--pool-workers",
"31"
],
"cwd": "/home/alpha/strata-nvfp4",
"tokenizer": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/pack/tokenizer",
"model_name": "qwen38-nvfp4-mtp",
"log": "/home/alpha/strata-nvfp4/strata-qwen-gptq-nvfp4.log",
"lib_dirs": [
"/usr/local/cuda-13.0/bin",
"/usr/local/cuda-13.0/lib64"
],
"port": 8080,
"gpu": [
0,
1
],
"gpus_asked": true,
"sampling": {
"temperature": 1.0,
"top_p": 0.95,
"top_k": 20
},
"uncensored": false,
"layer_split": "auto",
"parallel": 1,
"vision": {
"exe": "/home/alpha/strata-nvfp4/engine/strata-vision",
"model": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/qwen-nvfp4-gptq-dense.gguf",
"mmproj": "/home/alpha/Strata-data/models/Maximilian228--Qwen3.8-Flash-Next-NVFP4-GPTQ-Strata/mmproj-Qwen3.8-Flash-Next-BF16.gguf",
"min_tokens": 1024,
"max_tokens": 1024
}
}@David-Chen 我这也是极其不稳定。 只有降了精度之后才能稳定一些。 我感觉是 strata 在多线程的使用的时候 在什么地方没有限制好,导致内存溢出而崩溃。 降级之后会好一些,你试试看。
-
@david-chen 这么说吧 5090 下我开4个session,平时也就是2个同时跑的情况下。 Q2 勉强可以用。Q2 以上什么都直接卡死。
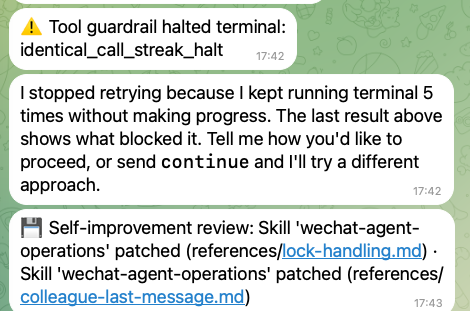
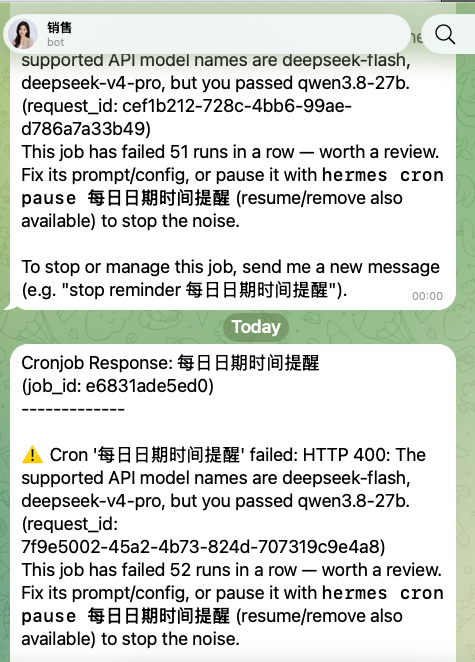
我现在 Q2 的时候 还经常这样。
-
-
买两块r9700 来试试?

-

 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励,感谢分享!


