跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. 随便聊聊
  4. 新手请教16G显存32G内存装哪个版本的模型

新手请教16G显存32G内存装哪个版本的模型

已定时 已固定 已锁定 已移动 随便聊聊
rtx5080本地模型
15 帖子 9 发布者 336 浏览 1 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • J
    J
    joker_chang
    体面乡绅 硕果累累
    编写于 最后由 编辑
    #4

    要看你计划做什么,其实锤哥在他的视频中说过无数次了,除非有数据安全的要求,肯定是在线API香,你买一根ddr5的钱够你用好久好久了。

    long chengL 1 条回复 最后回复
    0
    • J joker_chang

      要看你计划做什么,其实锤哥在他的视频中说过无数次了,除非有数据安全的要求,肯定是在线API香,你买一根ddr5的钱够你用好久好久了。

      long chengL
      long chengL
      long cheng
      编写于 最后由 编辑
      #5

      @joker_chang 也是😧 倒没什么数据安全要求,就是看到说什么token自由,有点心动

      1 条回复 最后回复
      0
      • E
        E
        exllm
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #6

        台账优先肯定选在线API

        1 条回复 最后回复
        0
        • long chengL long cheng

          各位大佬,看到很多本地部署大模型的视频,但是现在陷入了尴尬的局面,5080显卡16G显存+32Gddr5内存,到底是部署27B版本的模型还是部署125B的轻量化的模型呢?请各位大佬指点😳

          perterP
          perterP
          perter
          贵族大夫 硕果累累
          编写于 最后由 perter 编辑
          #7

          @long-cheng
          你这个配置有点尴尬,先跑一个轻量的Qwen3.8-27B试一试,以后升级内存还是跑QFN效果更好一点。可以参考下面这个帖子。
          https://lcz.me/topic/2250

          long chengL 1 条回复 最后回复
          0
          • U
            U
            un1980
            编写于 最后由 编辑
            #8

            Qwen3.8-27B 3位量化的那个版本, 是当前最优的了。 我用自己编译的NInfer,在4080 32Gddr5的配置下 能跑到100-130tokens/s 。很满足了。

            long chengL 1 条回复 最后回复
            0
            • perterP perter

              @long-cheng
              你这个配置有点尴尬,先跑一个轻量的Qwen3.8-27B试一试,以后升级内存还是跑QFN效果更好一点。可以参考下面这个帖子。
              https://lcz.me/topic/2250

              long chengL
              long chengL
              long cheng
              编写于 最后由 编辑
              #9

              @perter OKOK,我去看看

              perterP 1 条回复 最后回复
              0
              • long chengL long cheng

                @perter OKOK,我去看看

                perterP
                perterP
                perter
                贵族大夫 硕果累累
                编写于 最后由 编辑
                #10

                @long-cheng
                https://github.com/ggml-org/llama.cpp/releases
                先下载这两个文件后解压合并到一个文件夹,再把模型文件下载放到指定的文件夹即可。
                Windows x64 (CUDA 13)
                CUDA 13.4 DLLs
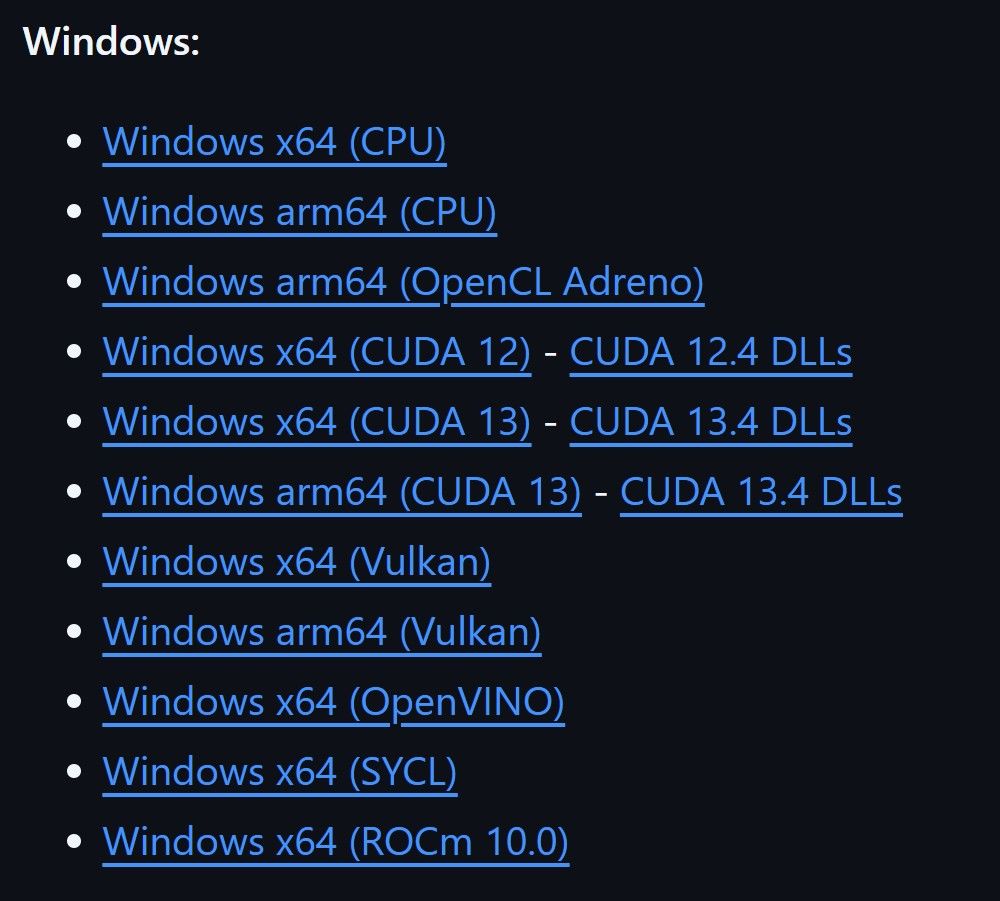
                image.jpeg

                1 条回复 最后回复
                0
                • Tony WangT
                  Tony WangT
                  Tony Wang
                  易有太极
                  编写于 最后由 Tony Wang 编辑
                  #11

                  @long-cheng

                  我觉得升级成64G内存比较好, 内存现在很贵, 但是短期内可能只会更贵. 随着strata这种显存, 内存, SSD 混合的架构, 逐渐成熟, 内存一定会越来越有用.

                  你16G显存如果跑27B稠密 3bit 量化的版本, 你的上下文也会受到很大的限制. 你升级显卡的话, 要面临各种选型的问题, 但是你32G内存, 或早或晚, 都要面临扩容的眼里.

                  所以我建议你升级成64G内存, 起码可以再战一段时间.

                  1 条回复 最后回复
                  1
                  • U un1980

                    Qwen3.8-27B 3位量化的那个版本, 是当前最优的了。 我用自己编译的NInfer,在4080 32Gddr5的配置下 能跑到100-130tokens/s 。很满足了。

                    long chengL
                    long chengL
                    long cheng
                    编写于 最后由 编辑
                    #12

                    @un1980 厉害厉害👍

                    1 条回复 最后回复
                    0
                    • 九
                      九
                      九门奇人
                      编写于 最后由 编辑
                      #13

                      32G内存配你的5080 16G也是能跑起来的。STRATA上有介绍,让你的AI搞定就行了

                      1 条回复 最后回复
                      0
                      • imbiplaza ASUSI
                        imbiplaza ASUSI
                        imbiplaza ASUS
                        谪仙人
                        编写于 最后由 编辑
                        #14

                        就等于你租房子和买房子的道理是一样。。。。
                        东西越来也贵,价格越来也高,1 就现在买,2就是等崩盘,3就是租token
                        如果你连32g 都要想半天的话,其实可以先试一试先租token,
                        然而等你token钱花的七七八八,你就会想起为什么当初不干脆去买
                        我们所谓的token钱很省的代价是包月,5小时限制,每个星期固定reset,如果api 形式就必须度量你可以承担的消费数额

                        1 条回复 最后回复
                        1
                        • PhilipShi2026P
                          PhilipShi2026P
                          PhilipShi2026
                          编写于 最后由 编辑
                          #15

                          16G显存可以试试Ninfer。
                          我用笔记本跑的情况,供参考 https://lcz.me/topic/2381
                          32K CTX太小了,Agent得不停压缩上下文,作为本地大模型,至少64K以上,17K tps才可用。

                          1 条回复 最后回复
                          0

                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                          有了你的建议,这篇帖子会更精彩哦 💗

                          注册 登录
                          回复
                          • 在新帖中回复
                          登录后回复
                          • 从旧到新
                          • 从新到旧
                          • 最多赞同


                          • 登录

                          • 登录或注册以进行搜索。
                          • 第一个帖子
                            最后一个帖子
                          0
                          • 版块
                          • 最新
                          • 标签
                          • 热门
                          • 用户
                          • 群组

