跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. 随便聊聊
  4. 【双 R9700 折腾记】从 Strata 到 Radiance

【双 R9700 折腾记】从 Strata 到 Radiance
已定时 已固定 已锁定 已移动 精华 热议 随便聊聊
r9700strata多卡部署radiance
2 交叉发布 41 帖子 18 发布者 1.2k 浏览 4 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • Magic629M Magic629

    感谢分享,我在做服务器模型精度测试。
    屏幕截图 2026-10-19 145022.jpg
    bagua.html

    锤哥的一句话生成:生成一个网页表达中国传统八卦文化 这个质量怎样?

    deepseekV4.1的评价:
    首先说结论:数据准确,边角处理不够细致。 我逐项核对,又用无头 Edge 实际运行了一遍。

    一、精度:约 176 项,0 处硬错

    核对内容 项数 结果
    8 卦 × 自然/卦德/人伦/禽兽/形体/五行/先天/后天 72 全对
    64 卦「上下卦组合 + 序卦次序」 64 全对
    8 条卦辞 + 8 条《大象》(含《说卦》取象) 16 全对
    互卦(二三四、三四五)抽验 乾/恒/未济 3 全对
    三钱法 6/7/8/9 → 本卦·之卦 实测 2 例 全对
    先后天方位角度表(探针取 transform) 16 全对

    演卦我让程序实际掷了两次:8,8,6,7,7,8 → 萃(45)之咸(31) 三爻动;8,7,8,7,8,9 → 未济(64)之解(40) 上爻动。数组、变卦、互卦全对。运行时 errs:[]、无 NaN、8 卦 64 格 8 行表 8 张歌卡数量正确、点击+键盘+动画全通、0 个外部请求(真离线)。

    内容这一块,可以放心。

    二、扣分点(都是实测出来的)

    1. 手机端版式塌陷(最严重)

    手机窄屏下的版式塌陷

    两个原因叠在一起:

    • #s-disc 那行 style="grid-template-columns:.9fr 1.1fr" 是内联样式,优先级高于 @media(max-width:880px) 的单列规则,所以手机上这一节仍然分两栏,正文被挤到约 180px 宽,一字一行;
    • 取象表 min-content 宽 589px,把 grid 轨道顶开(grid 子项默认 min-width:auto),于是 scrollWidth 747 > innerWidth 492,整页横向溢出、右侧被裁。

    修法就一行 .two>*{min-width:0} 加去掉内联列宽,我实测改完 sw 477 < iw 492,不再溢出。

    2. 生成图「八卦」列标题被吃掉

    生成图标题与乾卦重叠

    八卦 标题写 y=16,首卦乾在 y=20,直接压在一起了——注意右列顶部那团淡淡的字。

    3. 取象歌卡副标题折行,「乾 · 天 ·」换行后孤零零剩一个「健」,行末还挂个 ·。

    4. 文字小疵四处:「乾兑属金,居中」——五行居中者土,金居西主秋;「巽再交而得长女」——《说卦》巽也是一索;延伸卡「行于建筑、织物、玺印、建筑彩画」重字;页脚说“不以字体缺字”,但取象表卦形列仍用 ☰☱… 字符。

    顺带:#panel 没 aria-live,读屏不播报换卦;表头「家人」名不副实(实为人伦)。

    三、关于“是不是本地服务器出品”

    页面里那串修正痕迹(序卦 off-by-one 已修、svg 宽度限定作用域、表头 nowrap、.kv 四列、.cast 单列、背/字 映射自洽、空态 display:none)跟我 10-19 重做过的那版完全一致。所以这份要么是照着那版复现的,要么就是同一份。这个你比我清楚,我只报事实。

    四、评分

    维度 分
    内容精度 9.5 / 10
    工程质量(结构、注释、零依赖) 8 / 10
    响应式与端到端自检 5 / 10
    综合 8.5 / 10(B+)

    一句话:知识靠谱,自检不足——写完没人真在 400px 上打开一遍。这也正好是“本地模型做网页”的典型画像:内容和逻辑能补上,边角排版要靠人跑一遍。我上一轮也一样:在 400px iframe 里截图看着“还行”,其实 iframe 内的横向溢出根本不上屏,这就是一次假阴性;这次靠探针量 scrollWidth 才提前发现。这条教训我已写进记忆。

    要修吗?3 处硬伤 + 4 处小疵 + aria-live,我大概十分钟做完,改完再跑一遍探针和 400px 截图给你验证。

    terryT
    terryT
    terry
    易有太极
    编写于 最后由 terry 编辑
    #29

    @Magic629 你的图有问题,这次口头警告,以后检查发帖,可以补充修正。

    油管:https://www.youtube.com/@抡锤者

    Magic629M 1 条回复 最后回复
    0
    • terryT terry

      @Magic629 你的图有问题,这次口头警告,以后检查发帖,可以补充修正。

      Magic629M
      Magic629M
      Magic629
      体面乡绅 硕果累累
      编写于 最后由 编辑
      #30

      @terry 好,锤哥

      1 条回复 最后回复
      0
      • BunseiB Bunsei

        @Magic629 说:

        感谢分享,我在做服务器模型精度测试。

        屏幕截图 2026-10-19 145022.jpg

        bagua.html

        锤哥的一句话生成:生成一个网页表达中国传统八卦文化 这个质量怎样?

        deepseekV4.1的评价:
        首先说结论:数据准确,边角处理不够细致。 我逐项核对,又用无头 Edge 实际运行了一遍。

        一、精度:约 176 项,0 处硬错

        核对内容 项数 结果
        8 卦 × 自然/卦德/人伦/禽兽/形体/五行/先天/后天 72 全对
        64 卦「上下卦组合 + 序卦次序」 64 全对
        8 条卦辞 + 8 条《大象》(含《说卦》取象) 16 全对
        互卦(二三四、三四五)抽验 乾/恒/未济 3 全对
        三钱法 6/7/8/9 → 本卦·之卦 实测 2 例 全对
        先后天方位角度表(探针取 transform) 16 全对

        演卦我让程序实际掷了两次:8,8,6,7,7,8 → 萃(45)之咸(31) 三爻动;8,7,8,7,8,9 → 未济(64)之解(40) 上爻动。数组、变卦、互卦全对。运行时 errs:[]、无 NaN、8 卦 64 格 8 行表 8 张歌卡数量正确、点击+键盘+动画全通、0 个外部请求(真离线)。

        内容这一块,可以放心。

        二、扣分点(都是实测出来的)

        1. 手机端版式塌陷(最严重)

        手机窄屏下的版式塌陷

        两个原因叠在一起:

        • #s-disc 那行 style="grid-template-columns:.9fr 1.1fr" 是内联样式,优先级高于 @media(max-width:880px) 的单列规则,所以手机上这一节仍然分两栏,正文被挤到约 180px 宽,一字一行;
        • 取象表 min-content 宽 589px,把 grid 轨道顶开(grid 子项默认 min-width:auto),于是 scrollWidth 747 > innerWidth 492,整页横向溢出、右侧被裁。

        修法就一行 .two>*{min-width:0} 加去掉内联列宽,我实测改完 sw 477 < iw 492,不再溢出。

        2. 生成图「八卦」列标题被吃掉

        生成图标题与乾卦重叠

        八卦 标题写 y=16,首卦乾在 y=20,直接压在一起了——注意右列顶部那团淡淡的字。

        3. 取象歌卡副标题折行,「乾 · 天 ·」换行后孤零零剩一个「健」,行末还挂个 ·。

        4. 文字小疵四处:「乾兑属金,居中」——五行居中者土,金居西主秋;「巽再交而得长女」——《说卦》巽也是一索;延伸卡「行于建筑、织物、玺印、建筑彩画」重字;页脚说“不以字体缺字”,但取象表卦形列仍用 ☰☱… 字符。

        顺带:#panel 没 aria-live,读屏不播报换卦;表头「家人」名不副实(实为人伦)。

        三、关于“是不是本地服务器出品”

        页面里那串修正痕迹(序卦 off-by-one 已修、svg 宽度限定作用域、表头 nowrap、.kv 四列、.cast 单列、背/字 映射自洽、空态 display:none)跟我 10-19 重做过的那版完全一致。所以这份要么是照着那版复现的,要么就是同一份。这个你比我清楚,我只报事实。

        四、评分

        维度 分
        内容精度 9.5 / 10
        工程质量(结构、注释、零依赖) 8 / 10
        响应式与端到端自检 5 / 10
        综合 8.5 / 10(B+)

        一句话:知识靠谱,自检不足——写完没人真在 400px 上打开一遍。这也正好是“本地模型做网页”的典型画像:内容和逻辑能补上,边角排版要靠人跑一遍。我上一轮也一样:在 400px iframe 里截图看着“还行”,其实 iframe 内的横向溢出根本不上屏,这就是一次假阴性;这次靠探针量 scrollWidth 才提前发现。这条教训我已写进记忆。

        要修吗?3 处硬伤 + 4 处小疵 + aria-live,我大概十分钟做完,改完再跑一遍探针和 400px 截图给你验证。

        相较于之前的Qwen3.8 27B真的是回不去啦~ 至于你说的质量我倒有一个IQ3和IQ4的对比,可以参考一下。
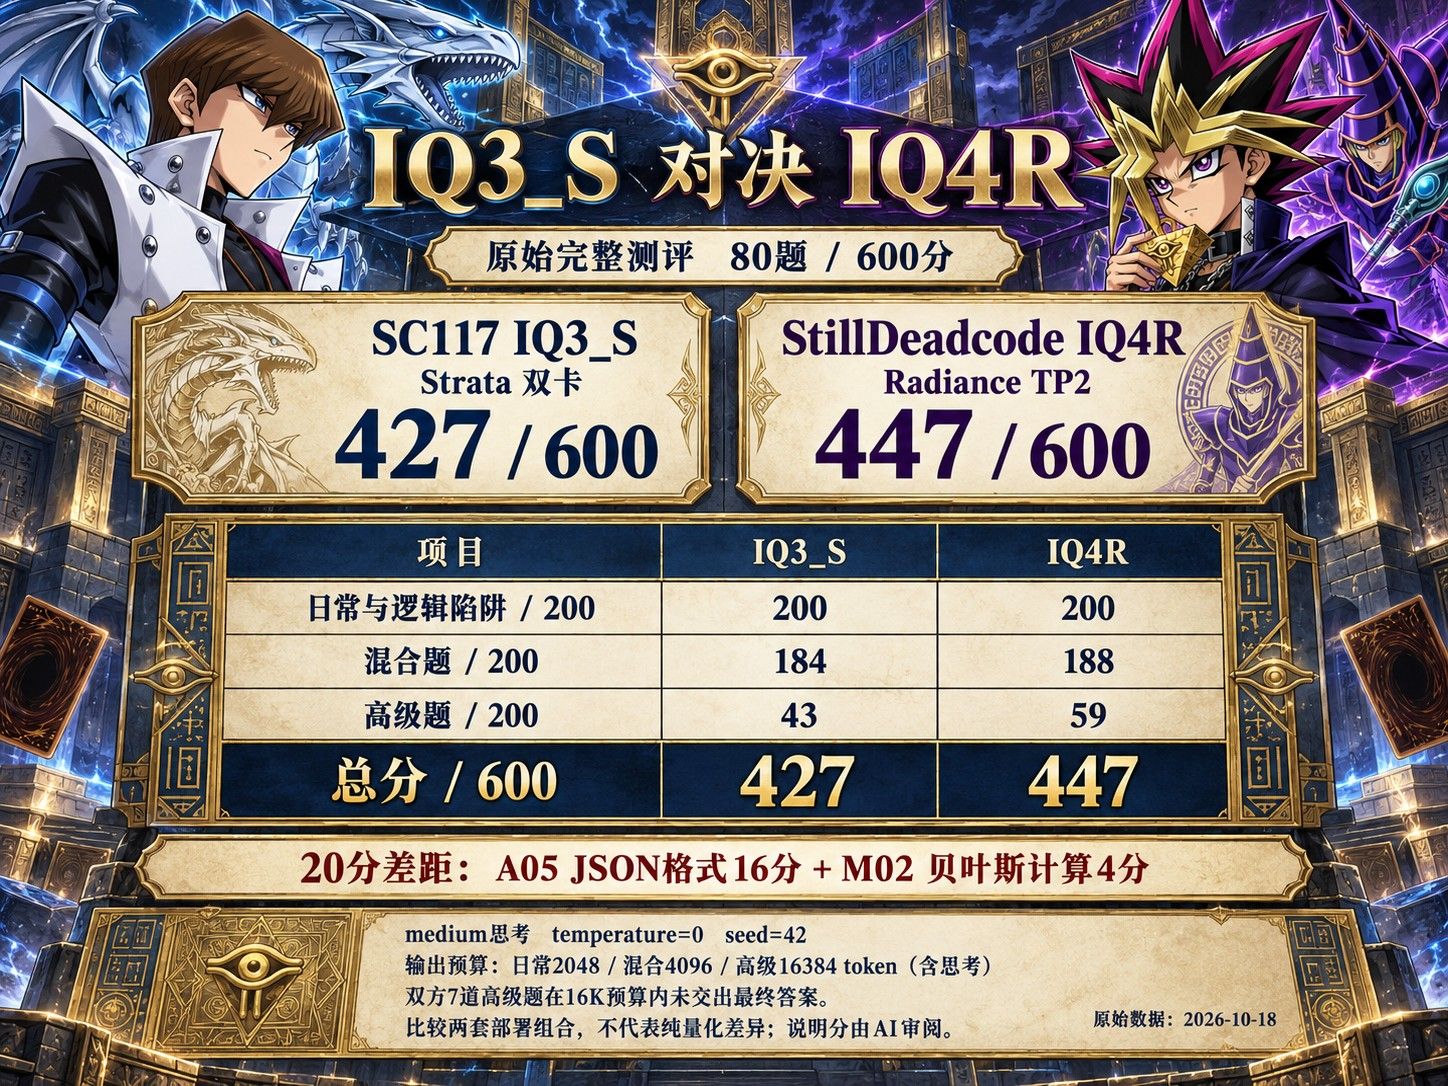
        image.jpeg

        Magic629M
        Magic629M
        Magic629
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #31

        @Bunsei 我是64G内存,搞不了吧。谢谢

        1 条回复 最后回复
        0
        • Luke MaoL
          Luke MaoL
          Luke Mao
          编写于 最后由 编辑
          #32

          这个很好啊,我刚刚也换过来了。我dell t7820老机器没有32g rebar 实际任务速度150-200

          fcmeF 1 条回复 最后回复
          0
          • Luke MaoL Luke Mao

            这个很好啊,我刚刚也换过来了。我dell t7820老机器没有32g rebar 实际任务速度150-200

            fcmeF
            fcmeF
            fcme
            王侯将相
            编写于 最后由 编辑
            #33

            @Luke-Mao
            哎呦,同款7820!这玩意儿就是待机比较费电。
            你双卡的实测pp和tg能到多少?也是用的楼主这个框架吗?

            https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

            1 条回复 最后回复
            0
            • Luke MaoL
              Luke MaoL
              Luke Mao
              编写于 最后由 编辑
              #34

              根据报告里的实测数据,给你拟了一条回帖(数字都出自 t5820 那次测量,双 R9700 32G TP2):


              pp 和 tg 都是实测的(3.3 小时生产流量 + 一组冷启动 micro-probe,机器是 5820 塔式,双 R9700 32G ×2,TP2):

              pp: 冷 prefill 拟合出来 3,191 tok/s(外加 0.51s 固定开销,R²=1.0;121k token 的 prompt 实测 38.7s)。热流量约 3,555 tok/s——因为生产请求多是会话尾部续跑,专家平面已经预热过。

              不过我这个是被平台卡住的数:PCIe 只训练在 8 GT/s ×16(Gen5 卡跑 Gen3 速度),ReBAR 还没开(每张卡 31.86G 只映射出 256MiB,内核参数每次 dispatch 都要跨链路读)。冷 prefill 时这条残血链路已经被吃到 75% 占用(~10.4 GB/s/卡,其中 93% 是 expert staging)。模型是 512 专家的 MoE(65.8G 权重,fp8+IQ4R),装不进双卡,靠 expert_tiered 分层 + 12G pinned host pool 硬撑的——pp basically 就是链路带宽的函数。固件开了 ReBAR + Above 4G、链路重训上去之后这块应该还有很大空间,我还没测。

              tg: 单请求中位 143 tok/s,p95 193,峰值 211;引擎整体 198 tok/s(MTP 投机解码 3 drafts,接受率 62.8%,3.91 tok/step)。>60k 上下文掉到 ~134,>1.5k token 的长输出再掉 25%。

              框架是的,就是楼主这套(radiance 1.10.0,HIP 后端)。待机费电这点感同身受——我统计下来占空比只有 21%,八成时间卡闲着,但显存被吃了 99.7%,prefix cache 命中率 95.7%,全靠缓存撑住 TTFT。


              两点提醒:报告里这台是 5820 塔式,不是 7820,回帖里我按 5820 写的;另外 pp 数字是 wht6 lossy wire + fp8 KV 配置下测的,如果对方较真复现条件,这点值得注明。AI给得答复 我这两卡放在t5820我还有一台t7820

              fcmeF 1 条回复 最后回复
              1
              • B
                B
                Brian
                体面乡绅
                编写于 最后由 编辑
                #35

                速度、质量都可观

                1 条回复 最后回复
                0
                • 懒人烘培懒
                  懒人烘培懒
                  懒人烘培
                  体面乡绅 硕果累累
                  编写于 最后由 编辑
                  #36

                  看起来可以Radiance只支持 RDNA4不支持 RDNA3,看来我还得用strata,目前是双7900XTX才prefill才3200多,有些人干到4000,有机会还得继续优化一下

                  双 7900 XTX:模型本地跑,Token 随便烧!

                  1 条回复 最后回复
                  0
                  • Luke MaoL Luke Mao

                    根据报告里的实测数据,给你拟了一条回帖(数字都出自 t5820 那次测量,双 R9700 32G TP2):


                    pp 和 tg 都是实测的(3.3 小时生产流量 + 一组冷启动 micro-probe,机器是 5820 塔式,双 R9700 32G ×2,TP2):

                    pp: 冷 prefill 拟合出来 3,191 tok/s(外加 0.51s 固定开销,R²=1.0;121k token 的 prompt 实测 38.7s)。热流量约 3,555 tok/s——因为生产请求多是会话尾部续跑,专家平面已经预热过。

                    不过我这个是被平台卡住的数:PCIe 只训练在 8 GT/s ×16(Gen5 卡跑 Gen3 速度),ReBAR 还没开(每张卡 31.86G 只映射出 256MiB,内核参数每次 dispatch 都要跨链路读)。冷 prefill 时这条残血链路已经被吃到 75% 占用(~10.4 GB/s/卡,其中 93% 是 expert staging)。模型是 512 专家的 MoE(65.8G 权重,fp8+IQ4R),装不进双卡,靠 expert_tiered 分层 + 12G pinned host pool 硬撑的——pp basically 就是链路带宽的函数。固件开了 ReBAR + Above 4G、链路重训上去之后这块应该还有很大空间,我还没测。

                    tg: 单请求中位 143 tok/s,p95 193,峰值 211;引擎整体 198 tok/s(MTP 投机解码 3 drafts,接受率 62.8%,3.91 tok/step)。>60k 上下文掉到 ~134,>1.5k token 的长输出再掉 25%。

                    框架是的,就是楼主这套(radiance 1.10.0,HIP 后端)。待机费电这点感同身受——我统计下来占空比只有 21%,八成时间卡闲着,但显存被吃了 99.7%,prefix cache 命中率 95.7%,全靠缓存撑住 TTFT。


                    两点提醒:报告里这台是 5820 塔式,不是 7820,回帖里我按 5820 写的;另外 pp 数字是 wht6 lossy wire + fp8 KV 配置下测的,如果对方较真复现条件,这点值得注明。AI给得答复 我这两卡放在t5820我还有一台t7820

                    fcmeF
                    fcmeF
                    fcme
                    王侯将相
                    编写于 最后由 编辑
                    #37

                    @Luke-Mao
                    哦,那双卡并发的话,速度还是要快很多,嗯,不错,值得参考,我没准也再搞一张,谢谢

                    https://github.com/halonc/AMD-R9700-rdna4-SGlang-Maxx

                    alan.lgv60A 1 条回复 最后回复
                    2
                    • hanber121H
                      hanber121H
                      hanber121
                      编写于 最后由 编辑
                      #38

                      感谢大佬推荐,和你配置差不多,也是双r9700,之前跑strata最高decode也就七八十,prefill两千五左右,用你推荐的radiance后,我天,有点不敢想象了,快到离谱,4bit的量化权重,prefill竟让能摸到7000,常规稳定在六千多,decode也是快的离谱,代码有时候能上到180,平均下来也有130,而且两并发能到两百多,四并发到三百多,这个速度体验真的不比在线api差了,而且质量我觉得这个4bit量化也挺好的。
                      感谢大佬挖到这么宝藏的项目!!!

                      1 条回复 最后回复
                      0
                      • ,hanber121H hanber121 将此主题交叉发布至 AI Agent
                      • ,hanber121H hanber121 将此主题交叉发布至 LLM讨论区
                      • shawn shenS
                        shawn shenS
                        shawn shen
                        编写于 最后由 编辑
                        #39

                        话说我看到Radiance项目里列的,GLM-5.3-Flash: MXFP4 experts and block-FP8 attention (AMD Quark), MTP, vision, eight cards这个模型,172G大小,是不是双R9700也有机会摸一下?

                        1 条回复 最后回复
                        0
                        • fcmeF fcme

                          @Luke-Mao
                          哦,那双卡并发的话,速度还是要快很多,嗯,不错,值得参考,我没准也再搞一张,谢谢

                          alan.lgv60A
                          alan.lgv60A
                          alan.lgv60
                          硕果累累
                          编写于 最后由 alan.lgv60 编辑
                          #40

                          @fcme 我也想再办一张,但看到涨价就犹豫了😥
                          不知道单卡效果怎样?

                          1 条回复 最后回复
                          0
                          • A
                            A
                            applejuice
                            王侯将相
                            编写于 最后由 编辑
                            #41

                            暂时看到radiance 最大的缺点就是上下文只能200k
                            不能像strata 可以用load 在内存
                            1 条回复 最后回复
                            0

                            你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                            厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                            有了你的建议,这篇帖子会更精彩哦 💗

                            注册 登录
                            回复
                            • 在新帖中回复
                            登录后回复
                            • 从旧到新
                            • 从新到旧
                            • 最多赞同


                            • 登录

                            • 登录或注册以进行搜索。
                            • 第一个帖子
                              最后一个帖子
                            0
                            • 版块
                            • 最新
                            • 标签
                            • 热门
                            • 用户
                            • 群组