【双 R9700 折腾记】从 Strata 到 Radiance
-
0x00、前言
最近 Strata 风头正盛,看
 坛里不少友都在用,我也赶了个时髦,跟着折腾了一轮 Qwen3.8 Flash-Next。这一用确实有点回不去了,不过最后留下来日用的引擎,却是 Radiance,于是有了这篇帖子。
论坛里不少拥有 RDNA4 架构显卡的
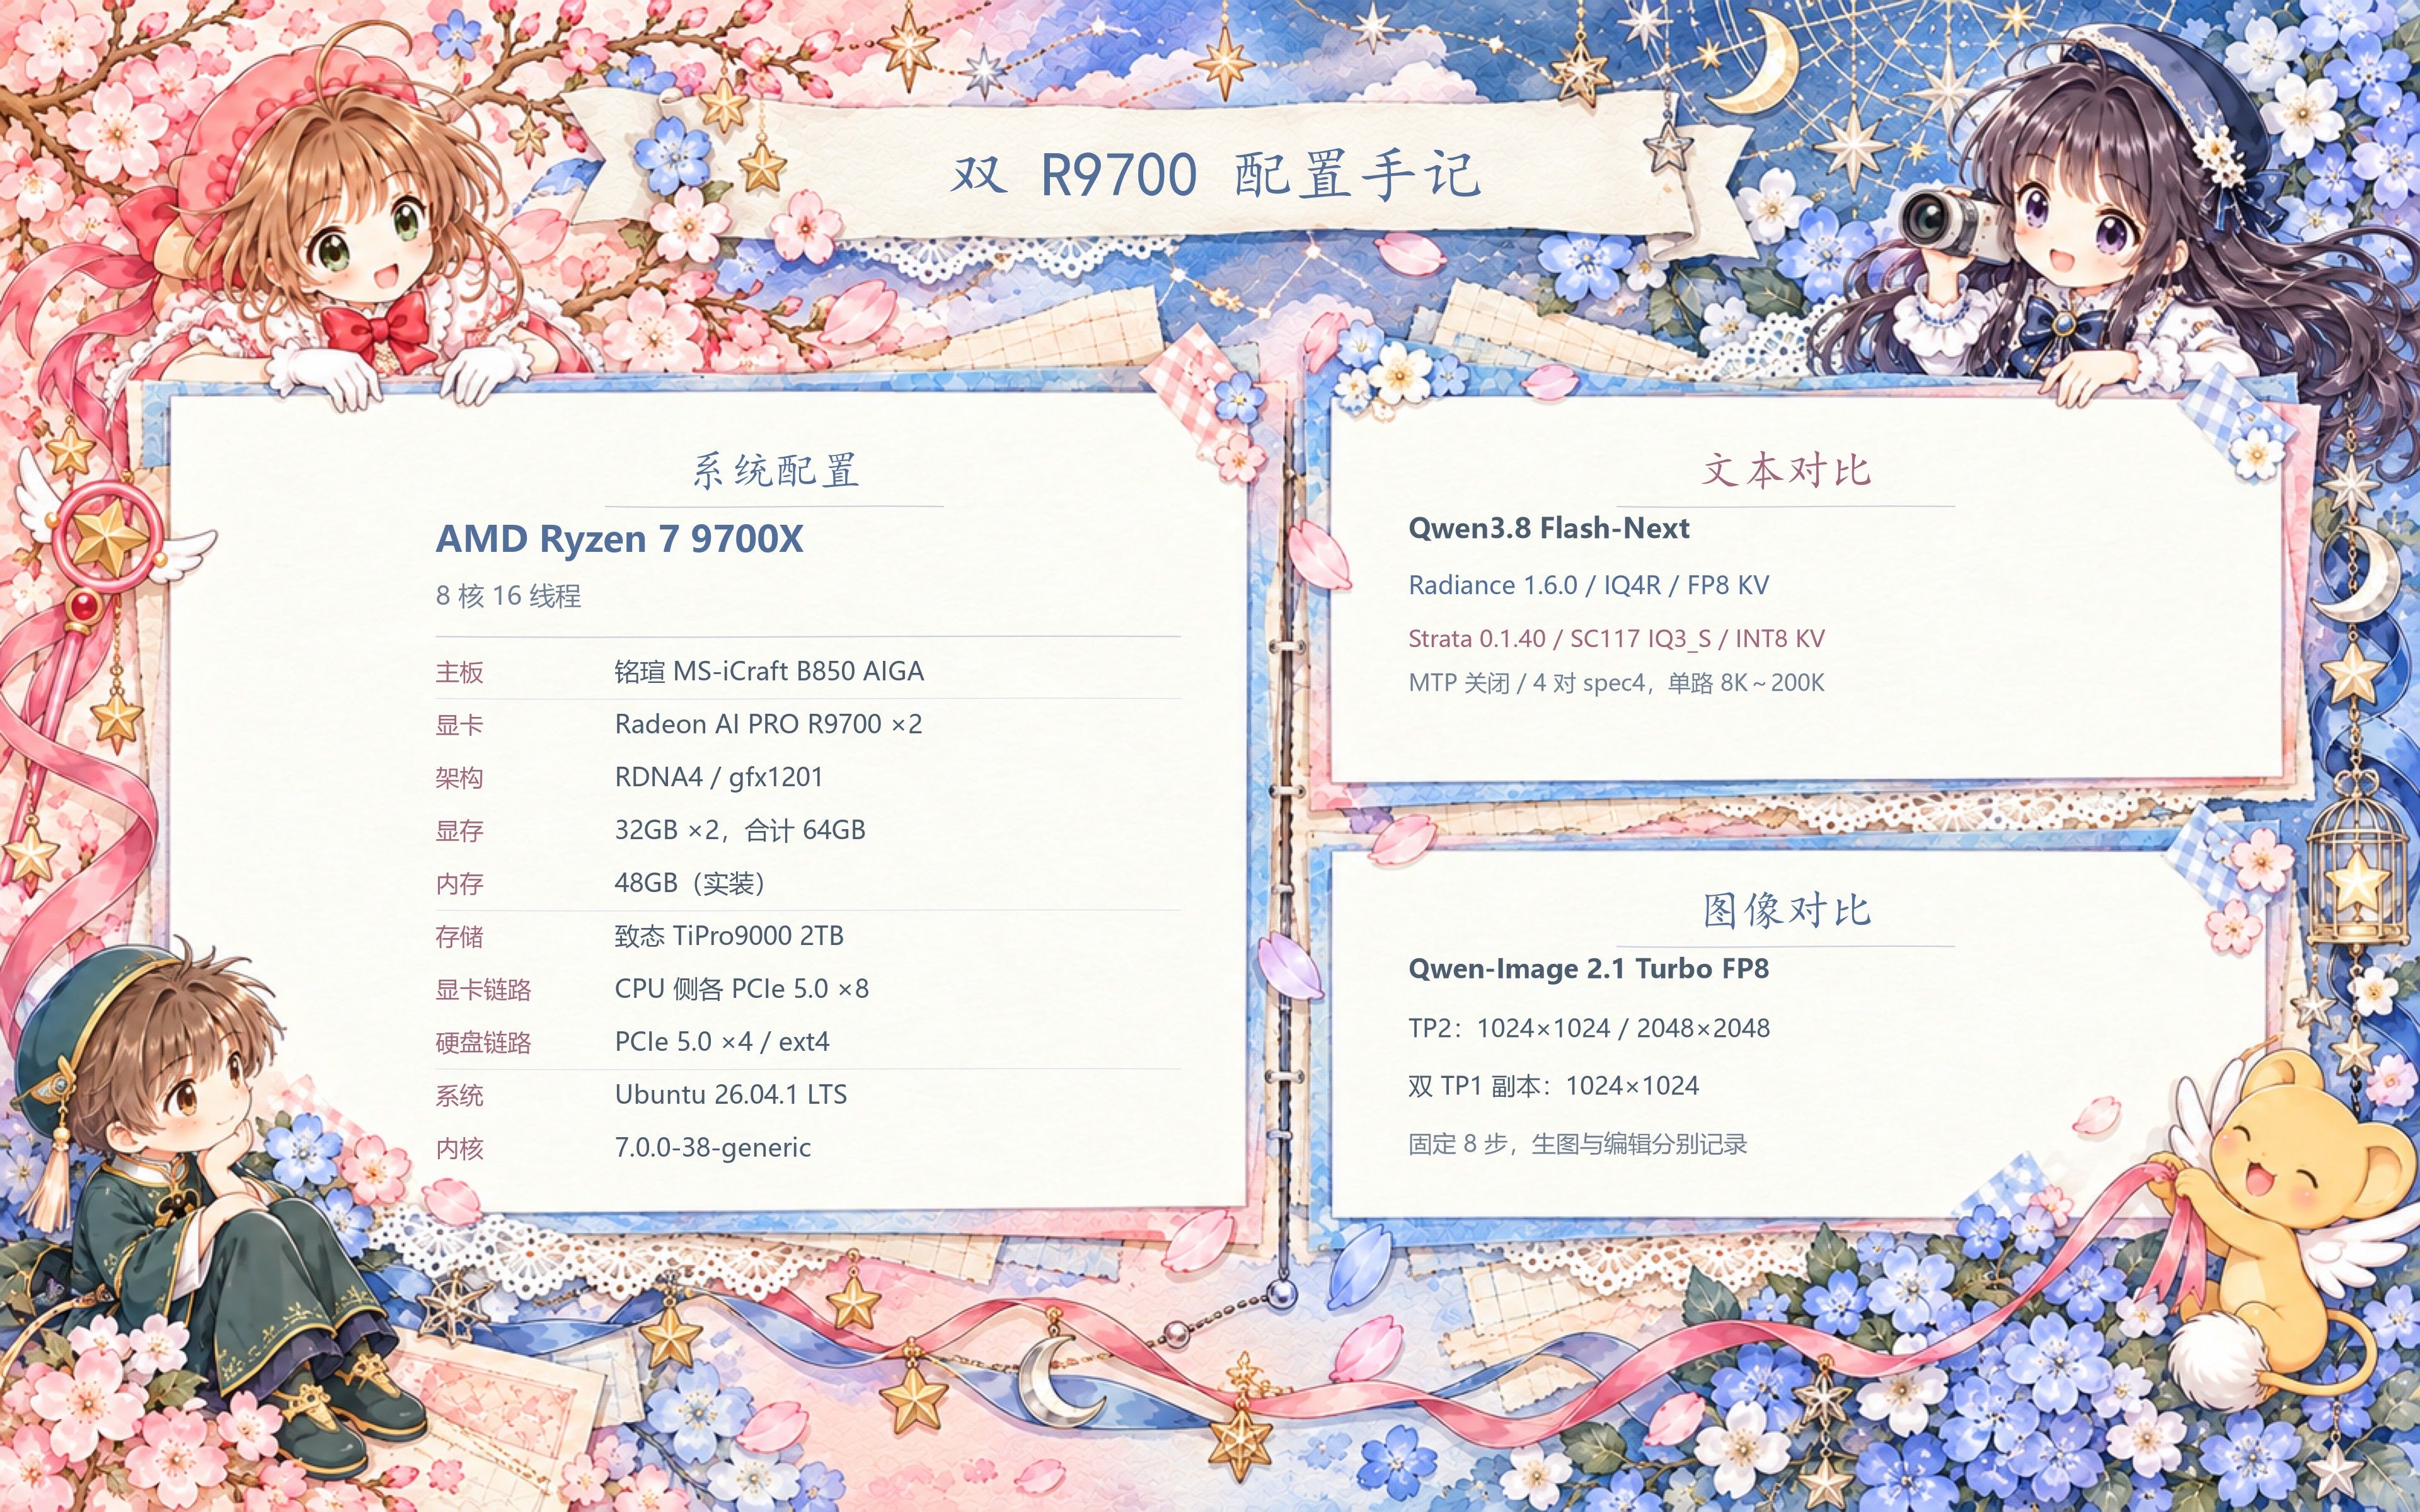
友应该都用过 StillDeadcode 的 vllm-radiance。而我这次想跟大家一起聊聊的是他后来做的独立引擎 Radiance,用 C++/HIP 实现,继续围绕 RDNA4 架构做专项优化。有兴趣的朋友可以先看看。(项目地址)开测之前,我先交代一下这次用的硬件和测试环境以及有关文本、图像相关的测试参数:
OK,话不多说,进入正题!

0x01、文本推理
首先,来看文本推理的速度表现:
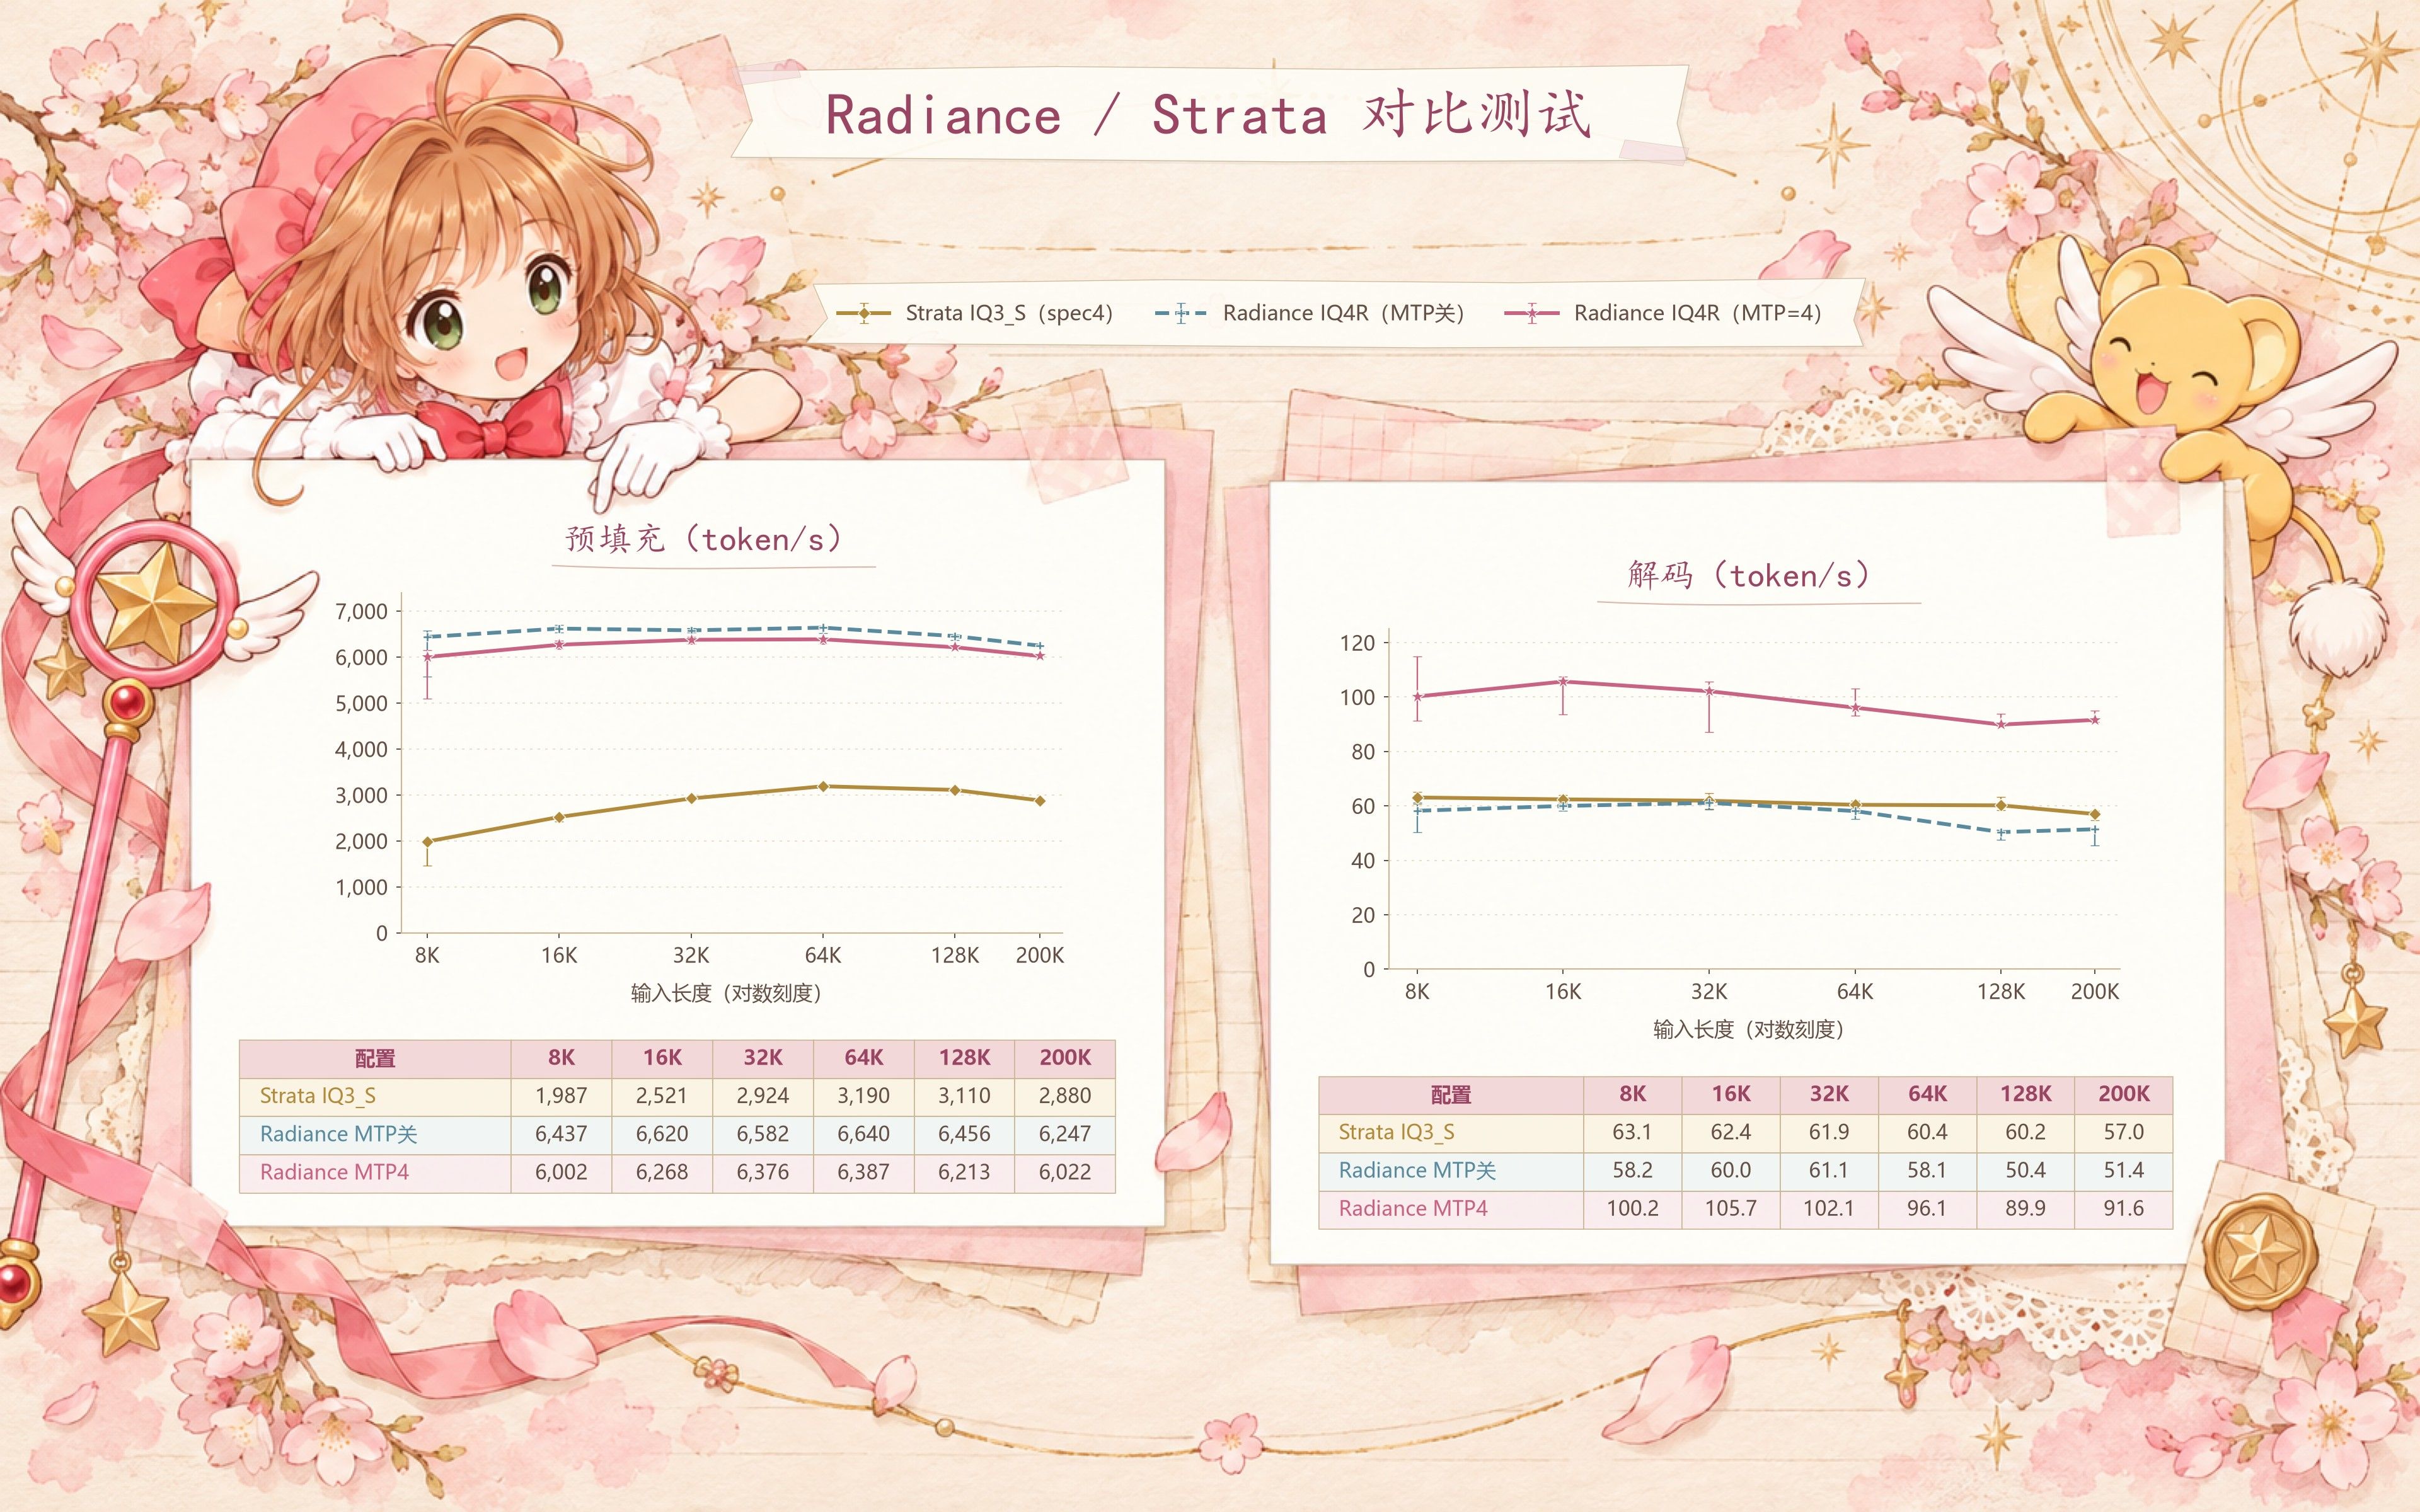
Radiance 这边用的是作者提供的 qwen3.8-next-flash-uncensored-fp8-iq4r-moe,后面简称 IQ4R。名字里虽然带着 FP8,实际采用的是混合量化。大部分路由专家使用 4-bit 量化,主干线性层以 INT8 为主,少量受保护的专家保留 BF16,所以不能把它当作完整 FP8 模型。
而 Strata 这边则使用 SC117 的 Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF 中的 IQ3_S 版本。
双方都采用了显存+内存的专家权重分层,常用专家优先放在显存,其余留在内存中按需调入,体积较大的 Engram 表则保留在 SSD 上按需访问。也就是说,这轮测试中,专家权重主要由显存和内存承载。
具体配置上,Radiance 使用 TP2 张量并行、FP8 KV,分别测试了关闭 MTP 和 MTP=4。Strata 则使用双卡层切分、INT8 KV、spec=4。
从图中结果来看,差别最明显的是预填充速度:Radiance 大约达到 Strata 的 2~3 倍,长输入的优势尤其直观。解码方面,关闭 MTP 时,Radiance 约为 50~61 token/s,略低于 Strata 的 57~63 token/s。开启 MTP=4 后,则提升到了约 90~106 token/s。
对我来说,长上下文不用等那么久,再加上开启 MTP 后的出字速度,这才是最后把 Radiance 留下来日用的主要原因~

详细数据:
输入长度 预填充速度 解码速度 8K 6,002 token/s 100.2 token/s 16K 6,268 token/s 105.7 token/s 32K 6,376 token/s 102.1 token/s 64K 6,387 token/s 96.1 token/s 128K 6,213 token/s 89.9 token/s 200K 6,022 token/s 91.6 token/s (提示:每档三轮取中位数,K 按 1024 token 计算,输出预算为 512 token,两边的量化、KV 精度和执行路径都有区别,因此这张图比较的是两套实际部署方案。手上还缺同权重、同参数的对照,欢迎
友补充。)0x10、并发推理体验
单路速度看完了,老
友们可能还关心另一个问题,那就是“一个请求正在处理长输入时,新来的短请求会不会被堵住”?为此,我专门做了一轮长短请求混合测试,先让 C 处理约 18 万 token 的长输入,确认预填充已经开始推进,再提交 A、B 两个短请求,输入分别为 8K 和 12K。
从 A、B 各自提交的时间开始计时,结果如下:
本轮配置 A 首字延迟 B 首字延迟 C 仍在预填充时,A/B 是否出字 Radiance IQ4R 4.87 秒 17.70 秒 两条都已出字 Strata IQ3_S 62.86 秒 71.14 秒 两条均未出字 这轮差别比较直观,Radiance 的 A、B 已经开始输出时,C 的长预填充还在继续。而Strata 的两个短请求则都等到了 C 预填充结束之后才出字。
对日常使用来说,这一点挺重要的。比如后台正在读一大份代码,前台临时问个短问题,我希望它能穿插处理,而不是跟着长请求一起等。
不过,Radiance 的 B 仍然等了 17.70 秒,说明交错执行时,短请求也可能有明显等待。另外,这轮只观察首字延迟和后续流式输出,A/B 在观察尾段按计划取消,没有测完整回答耗时;单轮结果也只代表当时测试的版本与配置。
对我这种个人使用、偶尔有几个请求碰到一起的场景,这项表现也是最后选择 Radiance 的一个原因。
0x11、图片生成与编辑
怎么样,惊不惊喜,意不意外?Radiance 还能跑 Qwen-Image,生图和图片编辑都支持!
我这次用的是 Qwen-Image 2.1 Turbo FP8 (其实他还有一个去审查版本的
 ),固定 8 步,每次请求输出一张图。除了单卡表现,我也测了双卡的两种用法TP2,让两张卡一起处理一张图,双 TP1 副本,让两张卡各自接活。
先看单请求下的耗时中位数,按本机 HTTP 接口端到端耗时统计:
配置 输出分辨率 生图耗时 图片编辑耗时 单卡 TP1 1024×1024 4.09 秒 5.59 秒 双卡 TP2 1024×1024 2.53 秒 3.52 秒 双卡 TP2 2048×2048 13.19 秒 15.11 秒 编辑测试统一输入一张 1024×1024 图片,输出尺寸按表中配置设置。
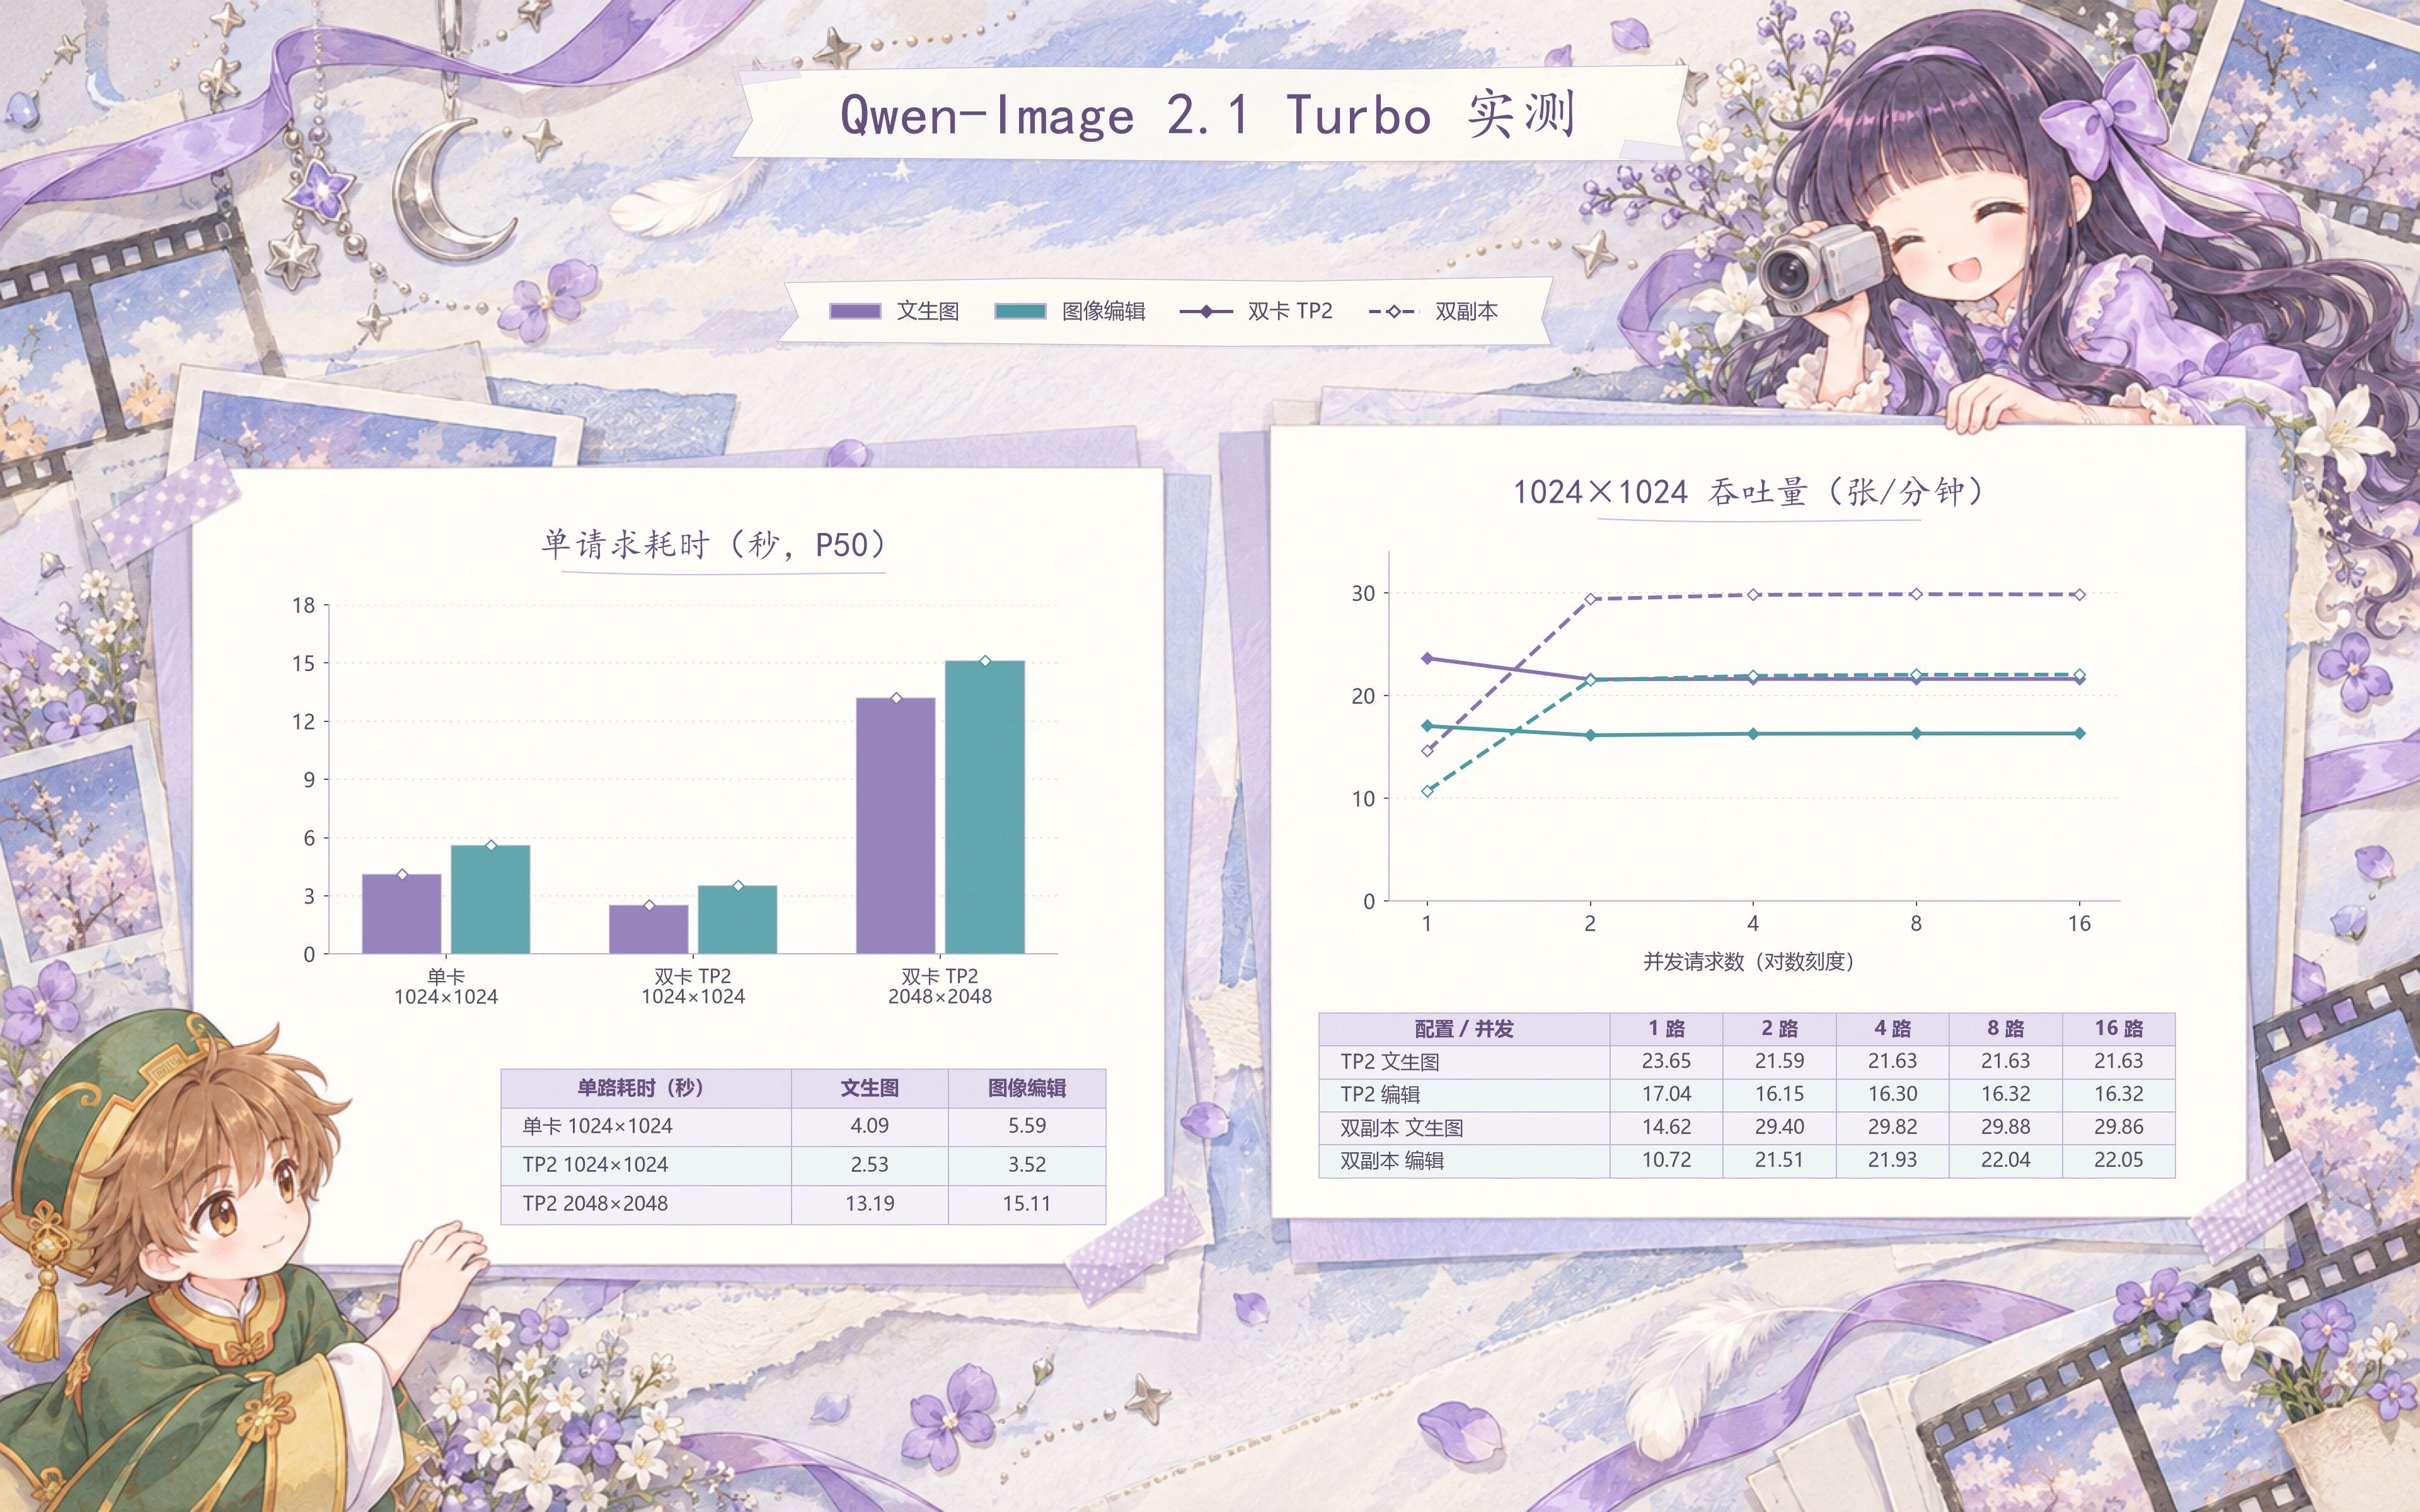
如果是自己一张张地出图,TP2 的等待时间更短。1024 分辨率下,两秒多生成一张,编辑也只要三秒多,临时改个图、反复调整提示词,用起来就比较舒服了。
如果有多张图要连续跑,双副本更适合。在 1024 分辨率、总并发为 2 时,两张卡合计达到了约 29.4 张/分钟的生图速度,图片编辑约为 21.5 张/分钟。
所以双卡也不一定非要绑在一起算~ 想增加图片编辑速度那就TP2,想文生图同时处理多张,就让两张卡各跑一个副本。
0x100、最后
折腾了一圈,我最后还是把 Radiance 留作了日常,毕竟6000多的预处理速度,犹豫一秒就是对Radiance的不尊敬~
 代码、文档一多,预填充速度带来的差别很容易感受到,测试中开启 MTP=4 后,解码速度也有了明显提升。再加上长预填充期间,后来的短请求能够穿插出字,几个请求碰到一起时,用起来更从容一些。
Qwen-Image 2.1 则算是额外的惊喜。生图、编辑都能跑,双卡既可以一起加速一张图,也可以各跑一个副本,按自己的用途来安排。
当然,这次测试里的模型量化、KV 精度和双卡执行方式都有区别,结果代表的是我这台双 R9700 上两套部署的实际表现,Radiance 的并发也仍有等待,不能把一次测试理解成所有场景都调度得很好。
如果你也是 RDNA4 用户,尤其手里有双 R9700,平时又经常处理长上下文,我觉得 Radiance 值得试一试。用过 StillDeadcode 的 vllm-radiance 的
友,也可以看看他这次独立引擎的思路。这篇就先记录到这里。也欢迎坛友贴贴自己的配置和实测,看看不同机器上能折腾出什么结果。
0x101、AI 使用披露
最后交代一下,本文的测试方案、自动化脚本编写与执行、日志核对、数据整理、图表制作及文字润色,均有好女孩(gpt)参与且参与程度较高。
由我提供硬件、提出测试需求并确认关键决策,AI 助手承担了主要的技术执行与成稿工作,包括测试脚本编写、远程操作与自动化测试、日志核对、数据整理、图表制作,以及正文初稿和润色。
性能数字来自真实硬件的运行记录。封面与手账插画由独立的 AI 绘图工具生成,不作为 Qwen-Image 的实测出图样例。
最终的使用选择和个人感受由我自己决定,测试与解读如有疏漏,也欢迎坛友指出。(PS:好女孩自画像
 ️)
-
-
-
-
-
-
-
-
-
终于有人继续讨论vllm radiance
都给strata 抢完风头了 -
-
-
-
好誇張的數據.... 這是vLLM底子去做的嗎? KV緩存命中率如何?會像vLLM一樣悲劇嗎
-
此主題已被删除!
-
-
-
-
-


 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!