
整套洋垃圾Strata機到貨
-
@terry 火速退款,加了80块 换了TF
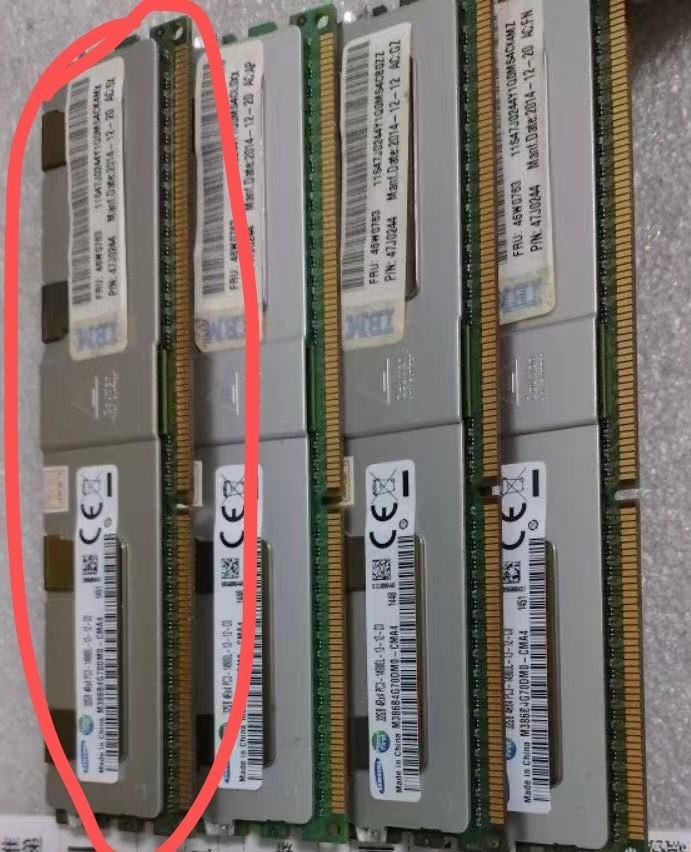
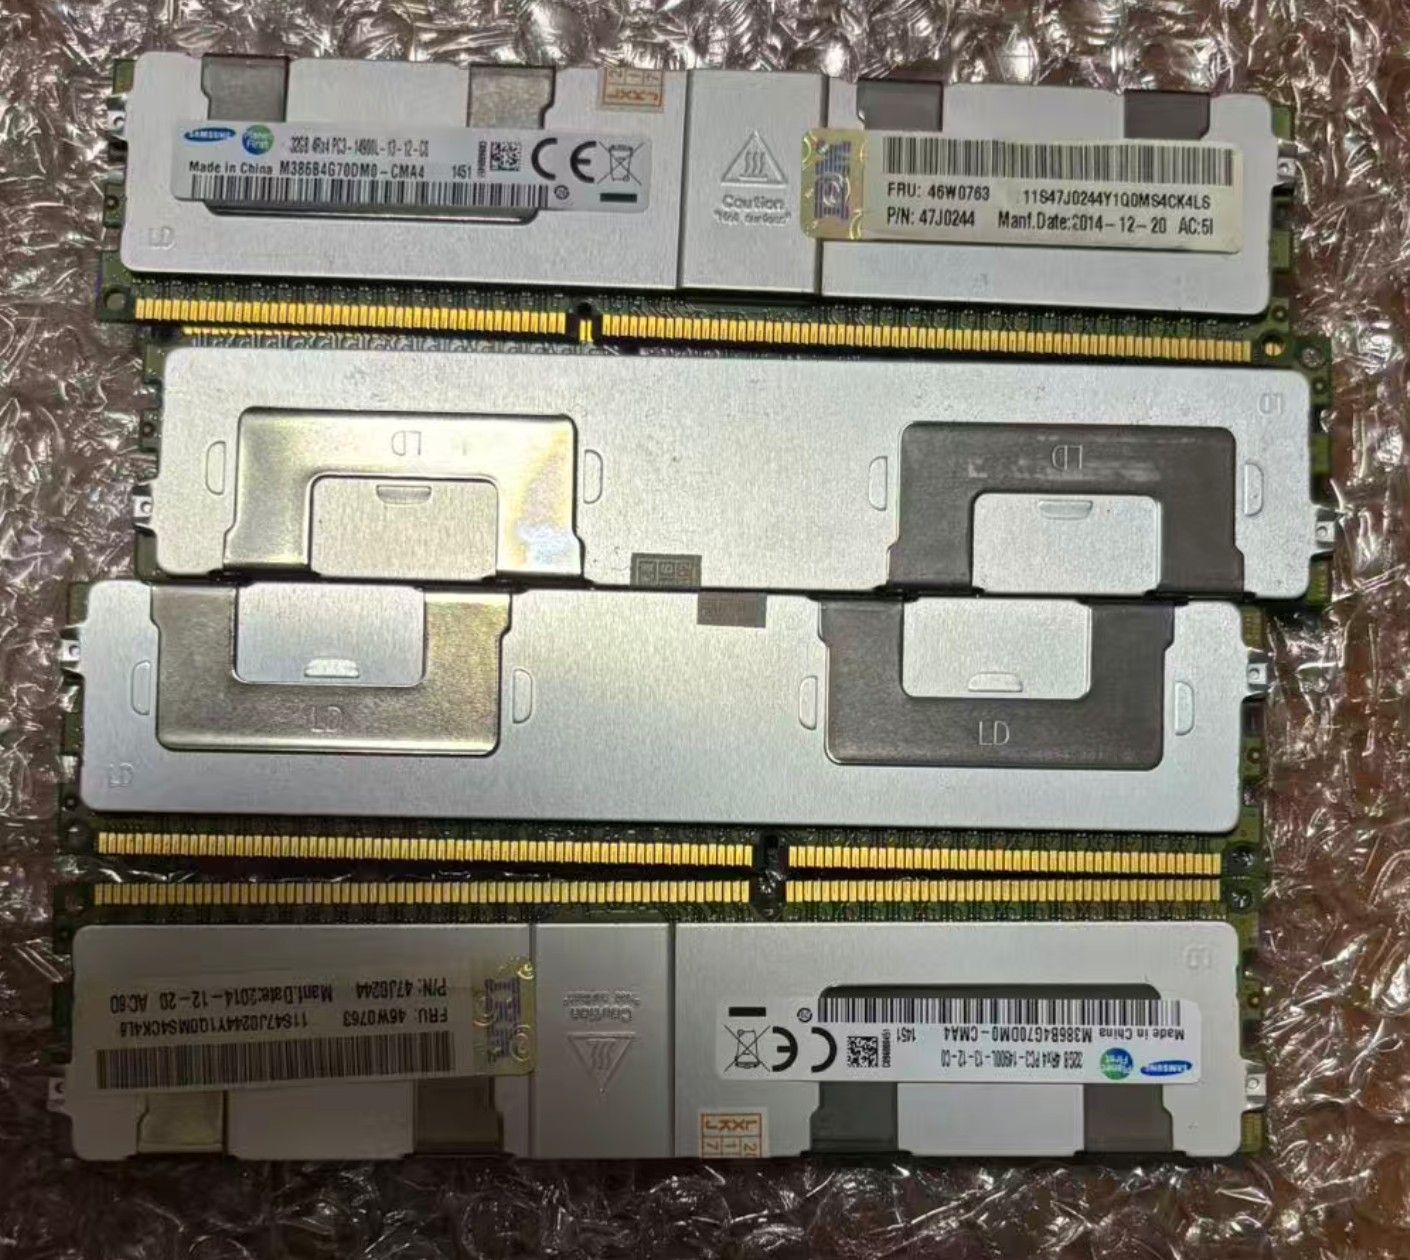
@rongda-weng 对的,我今天测试了内存条,很好,比我上次买的还好,32G的马甲条,品质很好,脚本测试也通过了。玩游戏体验也不错。测试几天再说吧。你说省着点钱干嘛,我过几天有空再测试TF。现在用的CD3,现成的 平台测试的。
-
@rongda-weng 对的,我今天测试了内存条,很好,比我上次买的还好,32G的马甲条,品质很好,脚本测试也通过了。玩游戏体验也不错。测试几天再说吧。你说省着点钱干嘛,我过几天有空再测试TF。现在用的CD3,现成的 平台测试的。
-
-
-
@rongda-weng 买TF,不要买AD3,别省这点钱。
-
先報告簡單實測 還沒有經過調優
項目 狀態 CUDA 12.8.93(ubuntu2404 repo)+ g++-14 完成(下載 3.7GB / 安裝 8.8GB) Strata v0.1.44.1 + llama.cpp pin 3cf0325完成 模型 Qwen3.8-Flash-Next IQ3_S(54.8G+28.8G+mmproj 0.9G) 完成 MTP 草稿頭(4.9G,SHA256 verify 全通過) 完成 sm_70 引擎編譯(含 glibc 2.43 標頭 patch) 完成 雙卡 layer split(0-23 / 24-47)+ 262144 ctx + int8 KV 完成 systemd 開機自啟 strata.serviceactive + enabled 實測 decode 86.0 tok/s(512 tokens,MTP 接受率 77%)、冷啟動 69.6 tok/s 重要注意
STRATA_SM70_TABLE=1已寫入 service(Volta 專用,+10~15% decode)。- NVLink 兩卡皆 inactive,走 PCIe;expert cache 命中 95-96%,影響很小。
實測 prefill(冷啟動、無 prefix 快取):
階段 實際 tokens TTFT 預填速度 10k 10,006 11.8 s 850 tok/s 20k 19,996 16.9 s 1,181 tok/s 50k 50,003 35.2 s 1,421 tok/s 100k 99,993 69.3 s 1,444 tok/s 150k 150,001 105.9 s 1,416 tok/s 200k 199,971 146.7 s 1,363 tok/s - 對照官方 README:RTX 5070 單卡 IQ3_S 32k prompt = 1,620 tok/s——這台雙 V100 長上下文預填跟一張 5070 大致同級。
-
@dardeaw-feng 双卡V100 我看和 3090 24G 已经差不多了,确实有性价比
-
-
V100雙卡還有一種是外接顯卡塢的,噪音應該比渦輪扇低,但是價格普遍接近四千大關,成本面就遠不如渦輪雙卡香了
V100雙卡還有一種是外接顯卡塢的,噪音應該比渦輪扇低,但是價格普遍接近四千大關,成本面就遠不如渦輪雙卡香了
我都用礦電了 我沒在怕吵的 單純是買個玩具
-
@terry TF的四根DDR4條位老特該怎麼處理?會去等未來嗎? 還是當擺設
-
剛剛動手優化了 強了一大截 垃圾變身黃金
1. 調優方法
變更 原值 新值 貢獻(50k prefill 實測) --prefillauto(=8192 chunk)auto:16384+25%(最大功臣) --trim-stage-weights+ 手動--layer-split 24auto(K=23,兩卡載全部 dense weights)每卡只載自己 24 層的 dense weights,VRAM 讓給 expert cache(4807→5614 slots) +12% --pipeline-windows 2關(CUDA 預設關) 開(stage0 讀下一 window 時 stage1 在 verify) prefill ~0%,主要幫 decode 重疊 出處:#3703(手動 split + trim 贏 auto)、#3648/#3724(16384 chunk、pipeline-windows 的雙卡實測配置)。已寫進
/home/itadmin/strata/strata-iq3_s.json並重啟生效。2. Decode 速度(thinking off,512 max,median)
prompt 調優前 調優後 Δ essay 66.6 73.5 +10% code 57.3 77.9 +36% translate 65.9 79.6 +21% explain 67.2 78.1 +16% (decode 的增益來自 trim 釋放的 expert slots 提高 hit rate + pipeline 重疊)
3. Prefill 階梯到 200k(冷預填,TTFT 測法)
階段 調優前 調優後 Δ 10k 850 1181 +39% 20k 1181 1251 +6% 50k 1421 1876 +32% 100k 1444 1884 +30% 150k 1416 1792 +26% 200k 1363 1666 +22% 200k 預填從 147s 縮到 120s。200k 端增幅較小是 int8 KV 超過
kv-resident 32768後走 RAM/PCIe 的瓶頸,與調優無關。 -
,
D dardeaw feng 引用了 此主题



 哎~
 等回来看看吧

