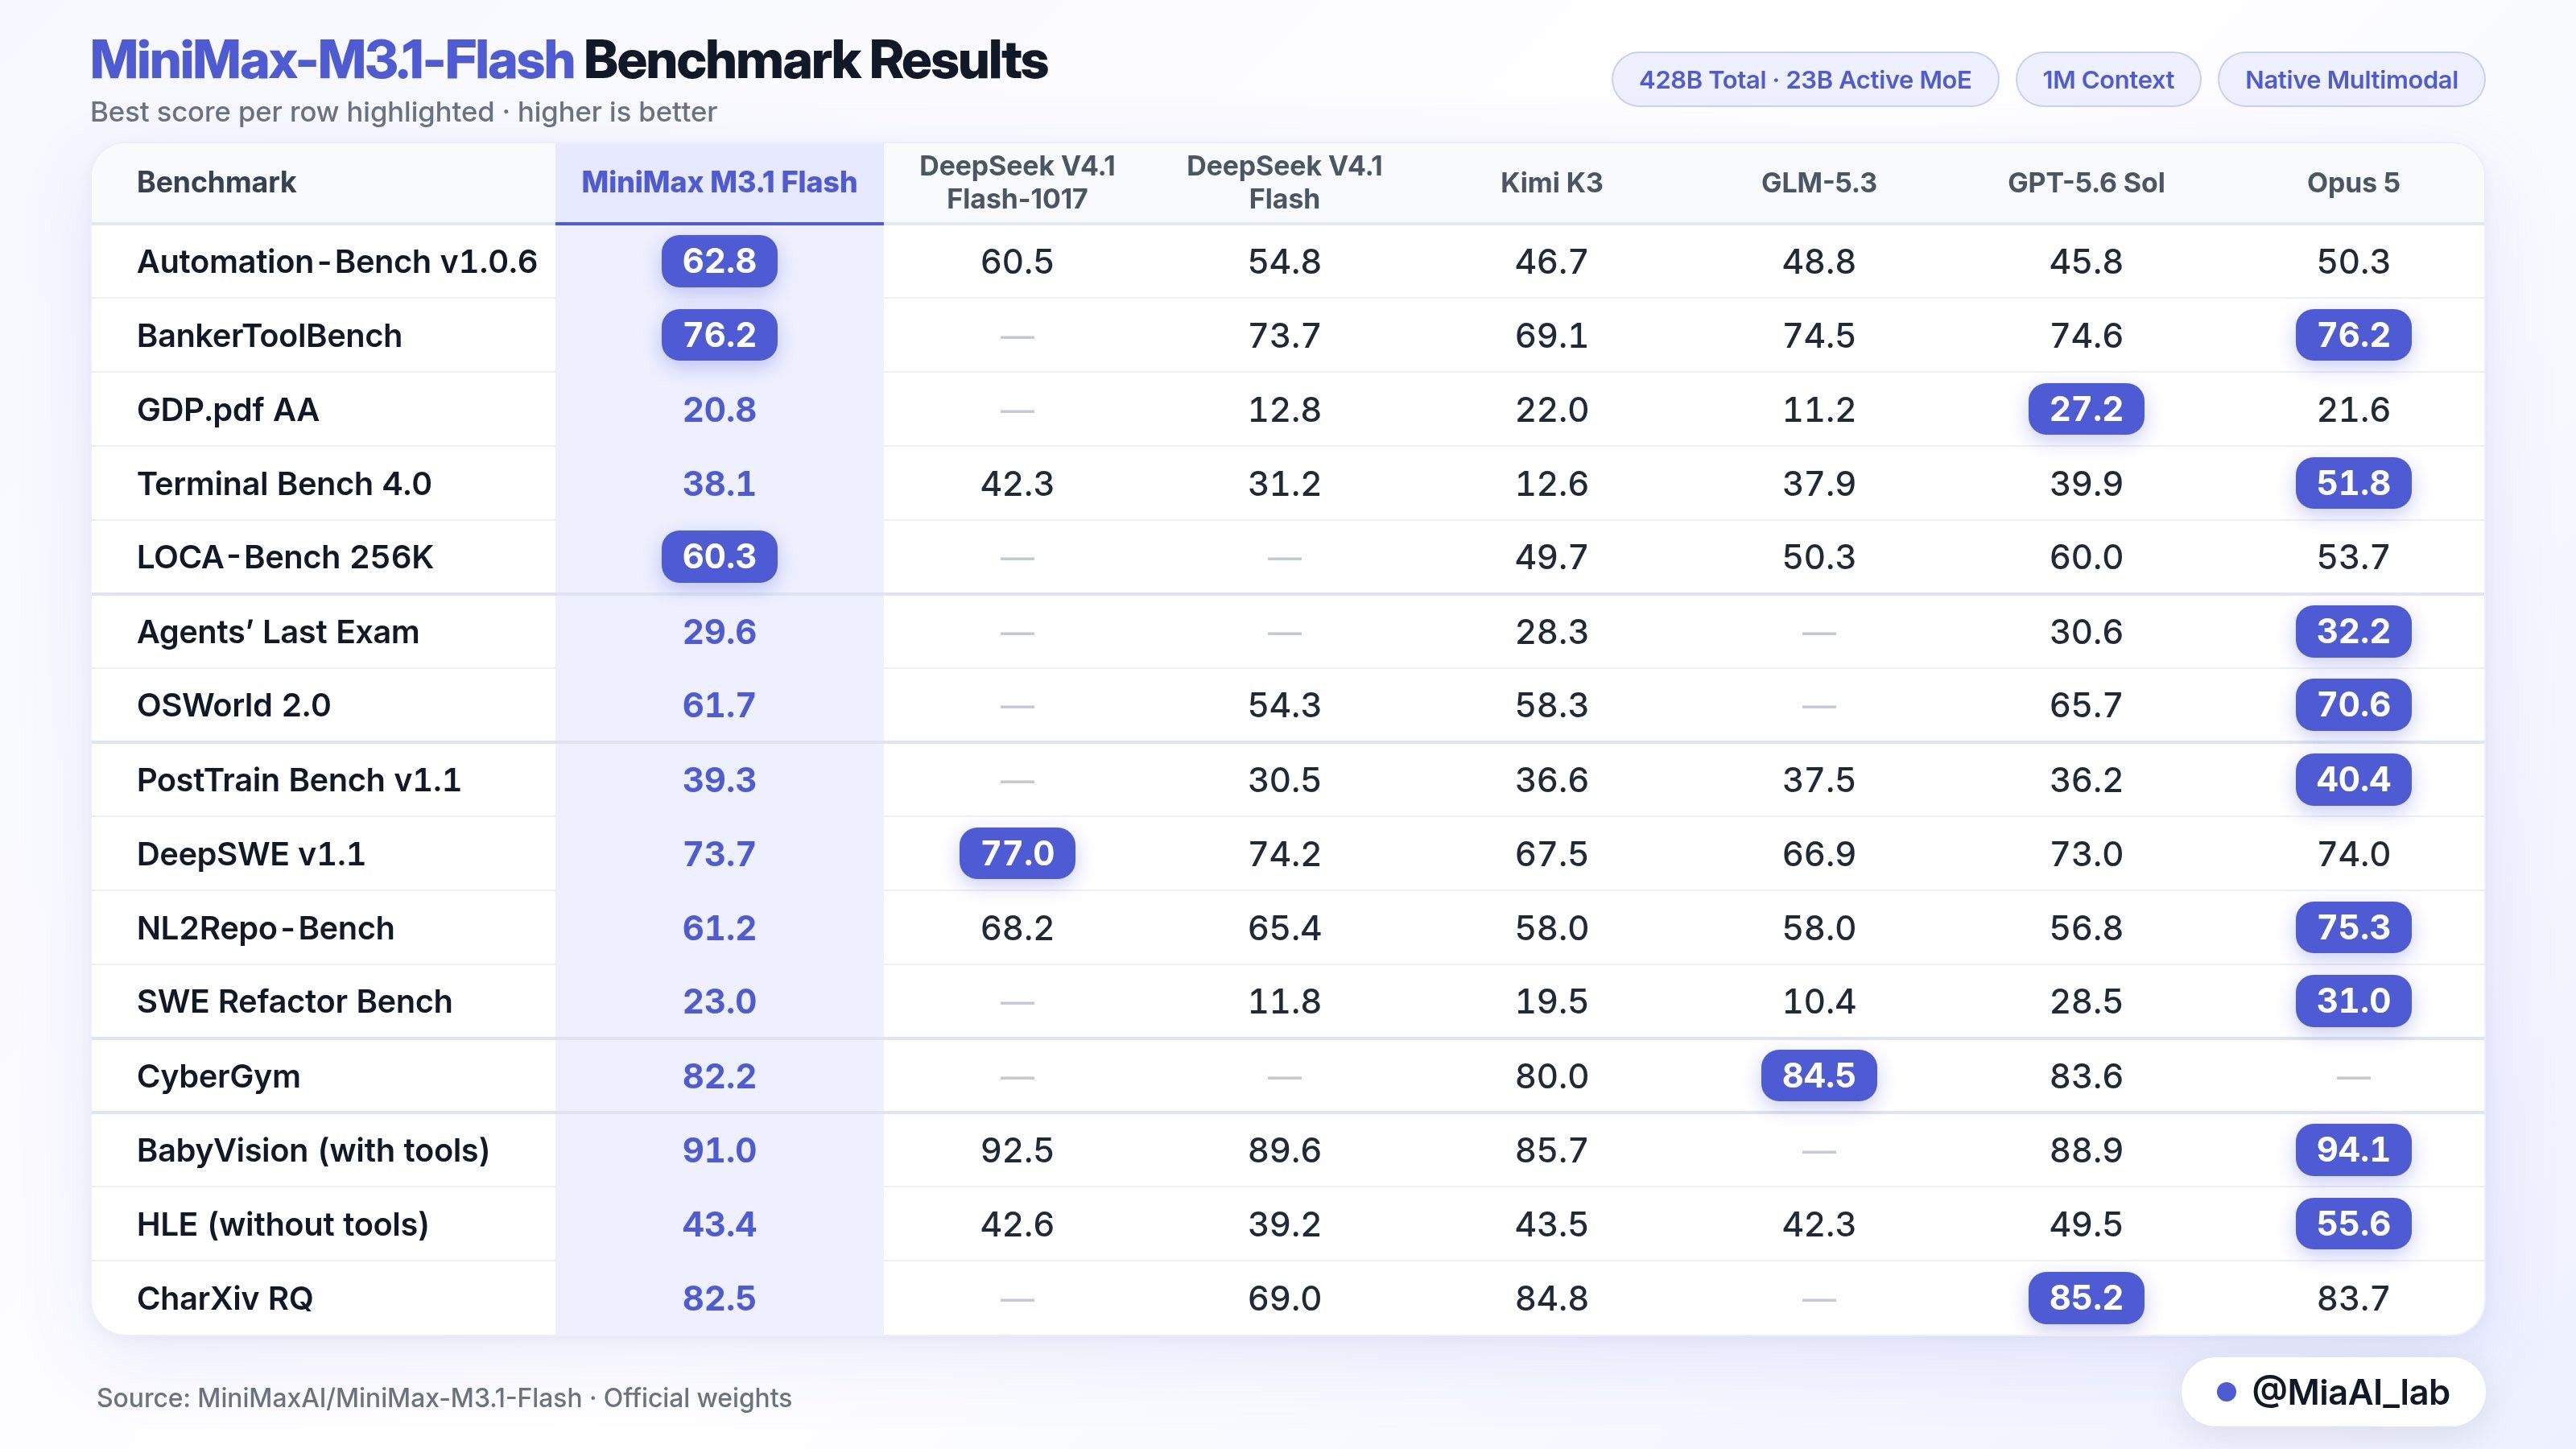
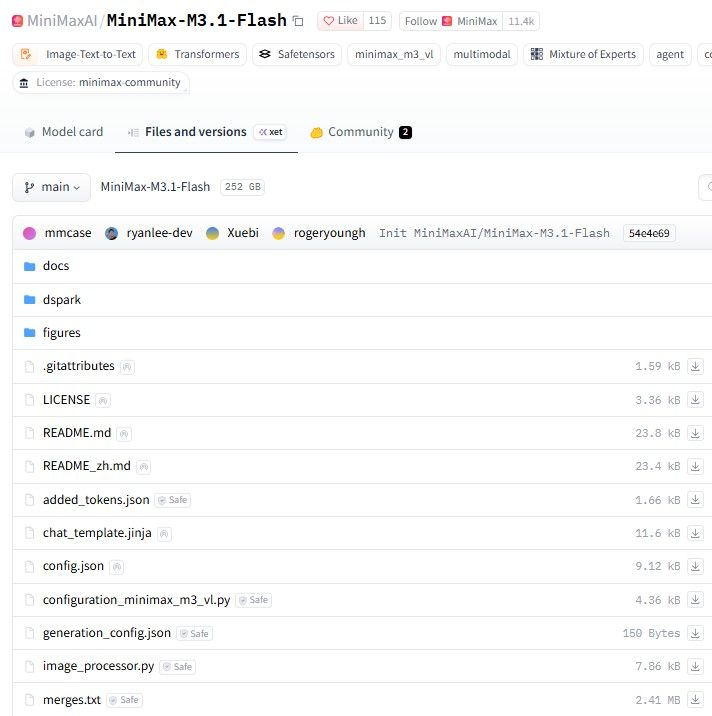
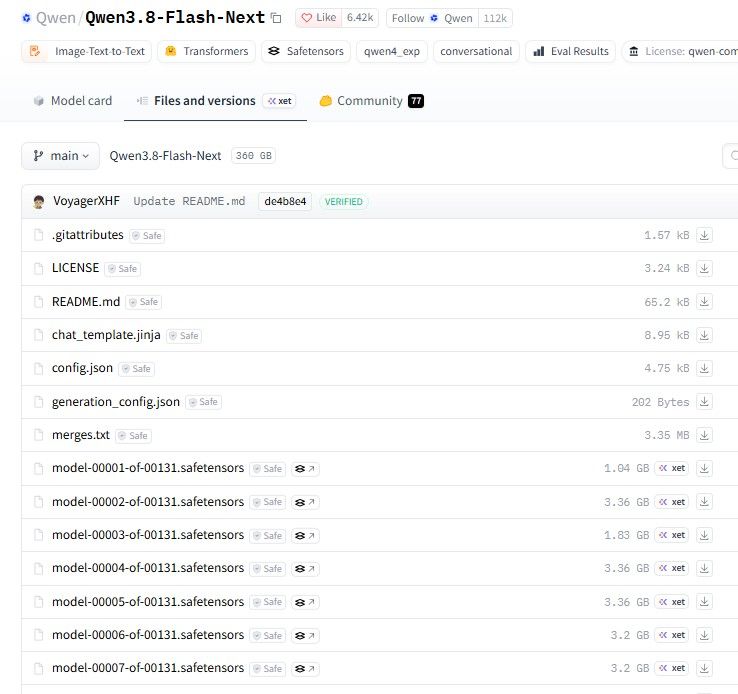
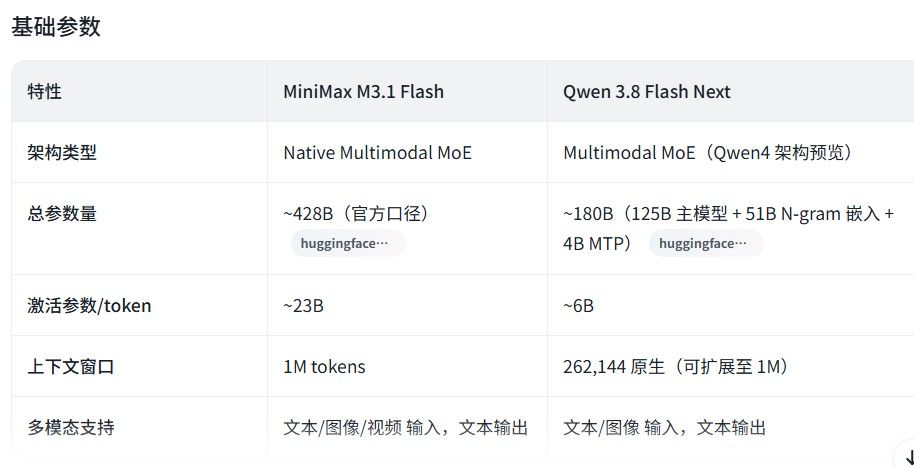
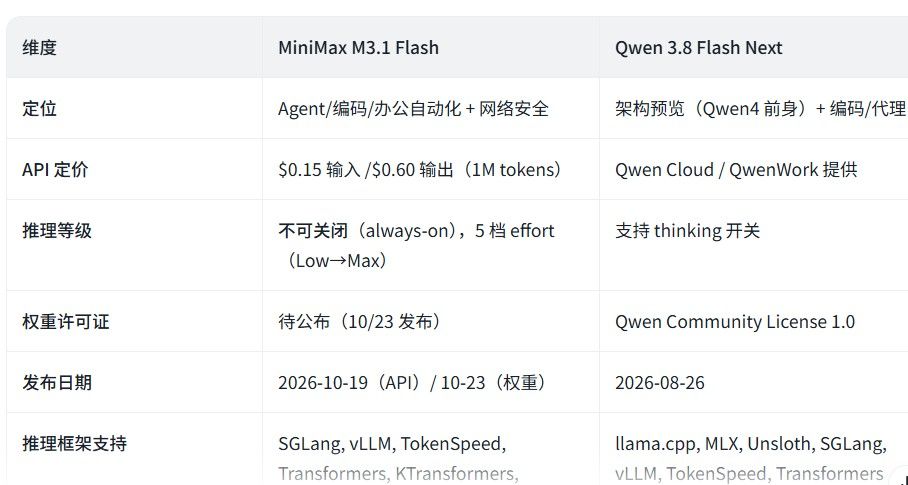
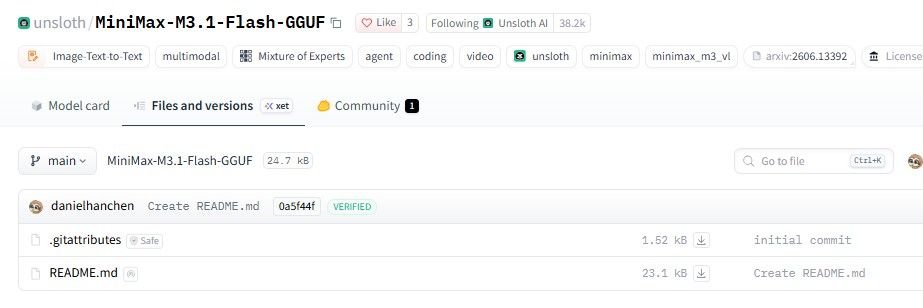
【讨论】 Minimax M3.1 Flash开源了 (26-10-23)
-
-
-
-
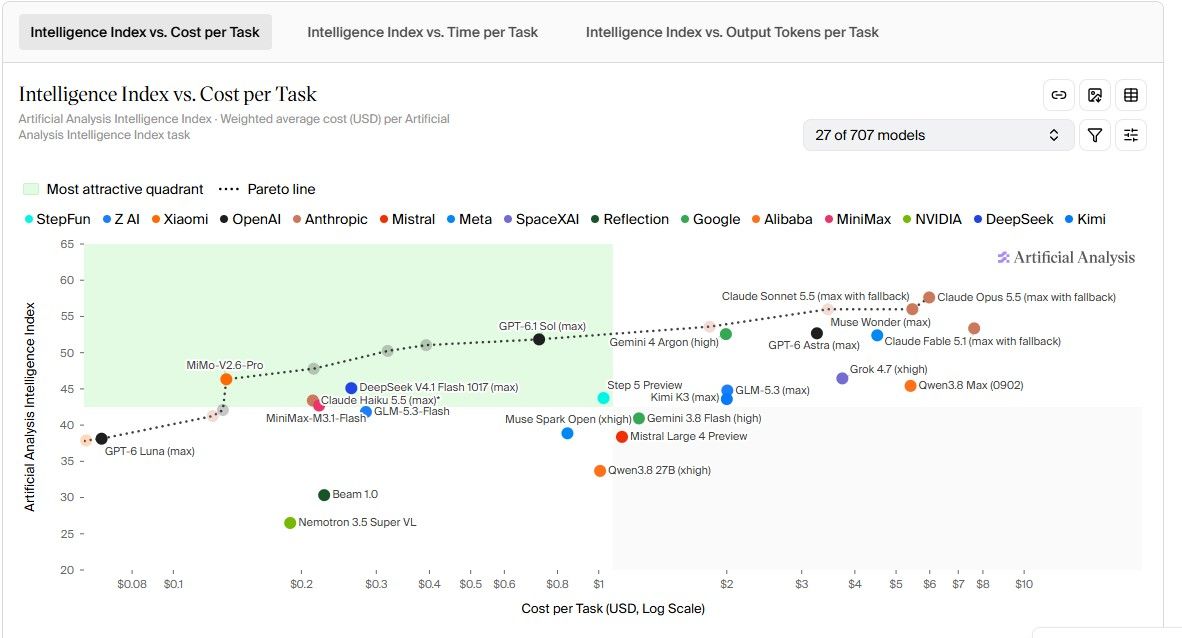
这张图里面qwen 3.8 27b居然比这两个都要高
-
-
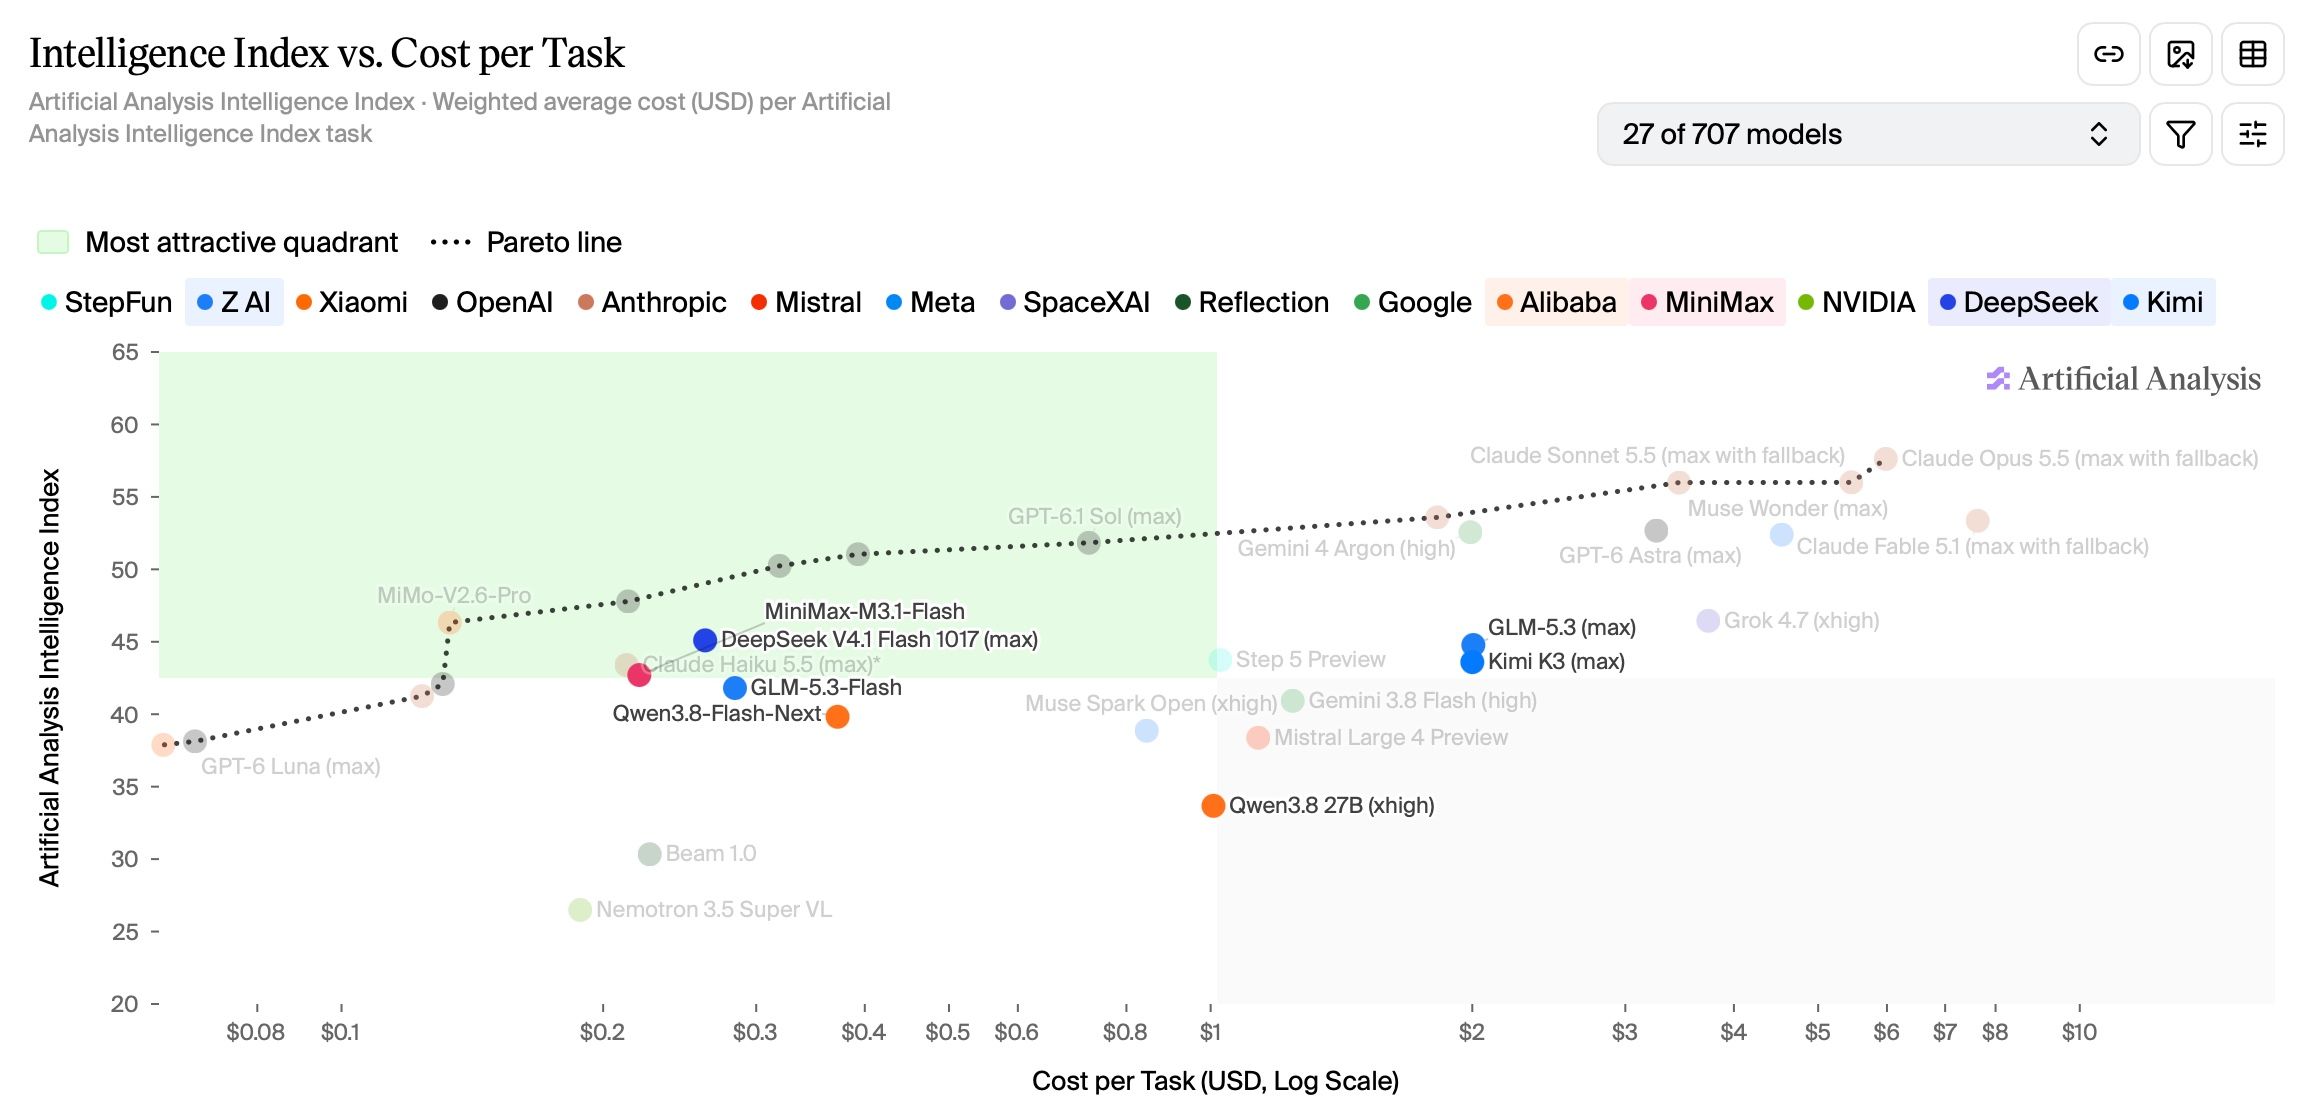
看圖左邊綠框附近這幾個模型(DS V4.1 flash 1017, MiniMax M3.1 flash, GLM 5.3 flash, Qwen3.8 ) 的能力都在伯仲之間,大約40分到45分區間,能力上沒有多少差距,個人測試困難問題的實戰無論是Deepseek或是qwen都是不行的

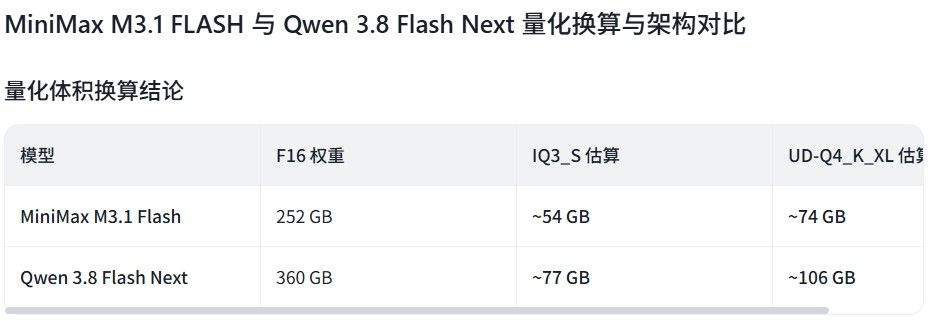
但部署的難度大有不同
比較項目 Qwen3.8 Flash-Next MiniMax M3.1 Flash DeepSeek V4.1 Flash GLM-5.3 Flash 總參數 125B 主幹 + 51B N-gram;另有可選 MTP 428B 552B 主幹 + 196B Engram 320B 活躍參數 6B 23B Prefill 8B/Decode 16B 18B 基本架構 MoE + GDN + QSA MoE + MSA MoE + CED + CSA2 MoE + KDA + Sparse Attention 注意力設計 以 Gated DeltaNet 為主,搭配稀疏注意力 多層 MSA 稀疏注意力 Encoder/Decoder 與跨層 KV 共用 線性注意力搭配稀疏注意力 特殊機制 N-gram、Gated Residual、MTP NVFP4 QAT、DSpark Engram、FP4 KV、DSpark mHC、MTP Context 規格上限 262K 1M 1M 1M 本人Decode 實測 約 86 tok/s 未測 約 17.07 tok/s 未測 -
-
-