跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. LLM讨论区
  4. 晒一下X99 TF+ 2696v3 + 128G DDR3+7900xtx用strata运行IQ3_S的使用效果

晒一下X99 TF+ 2696v3 + 128G DDR3+7900xtx用strata运行IQ3_S的使用效果

已定时 已固定 已锁定 已移动 精华 LLM讨论区
x997900xtxstrata
21 帖子 8 发布者 1.6k 浏览
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • yi songY yi song

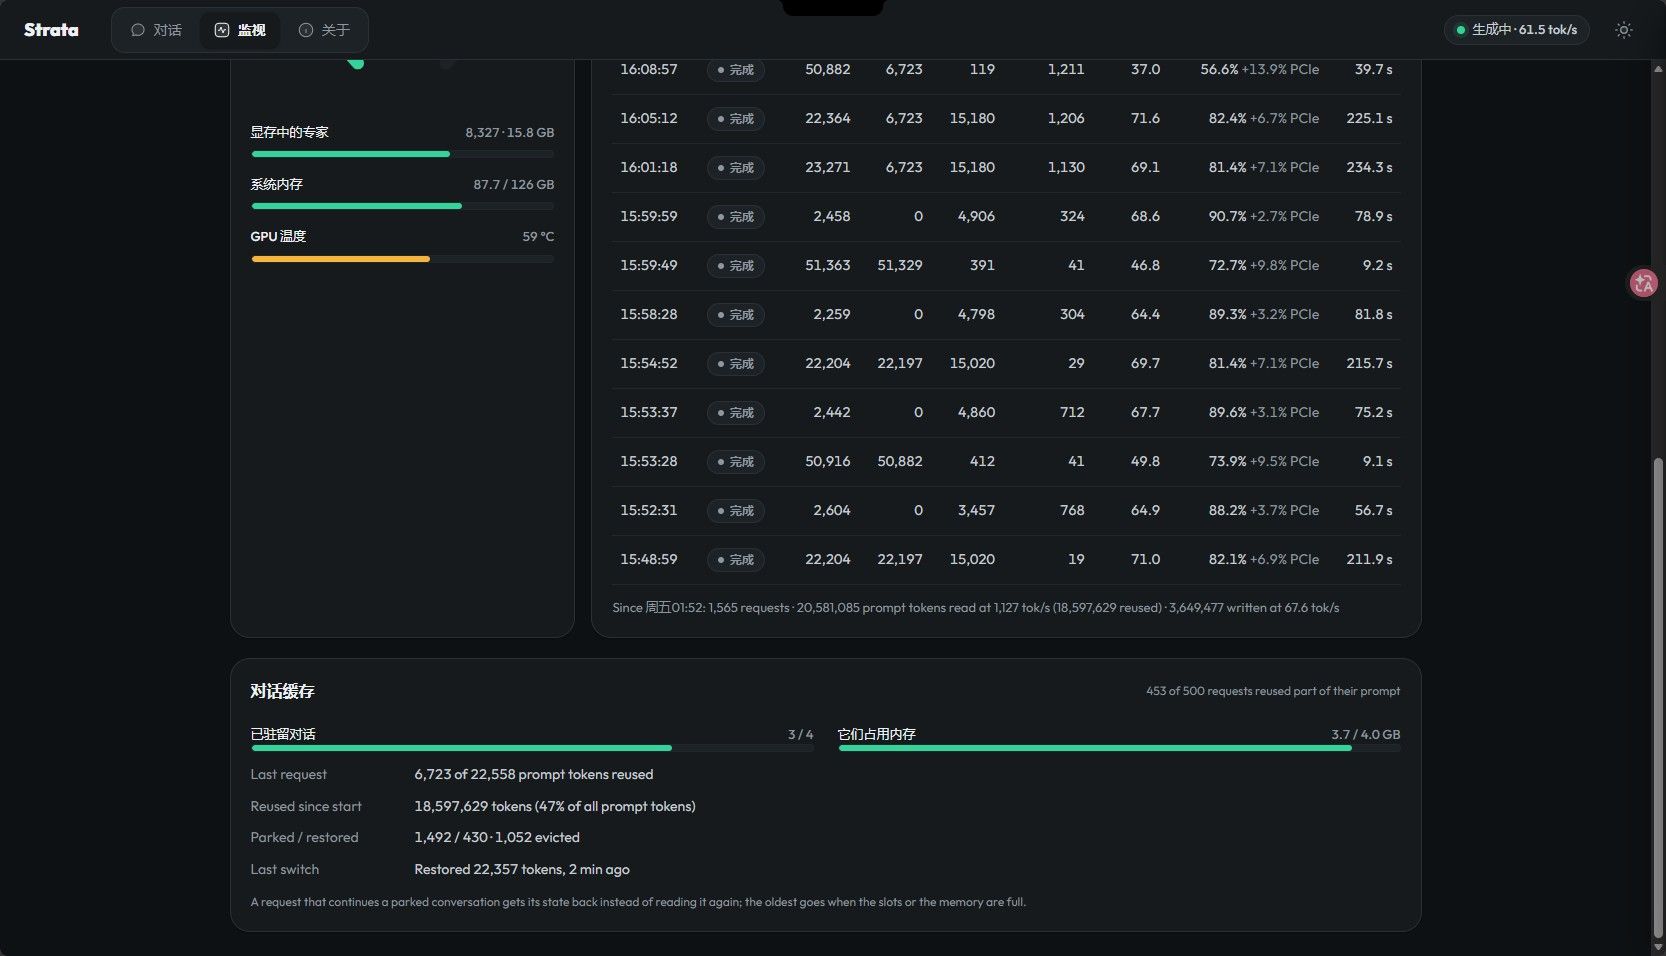
    之前配了一台服务器专门跑strata。用了几天效果和大家分享一下。
    我测试了很多方法,现在的使用是1槽其他对话排队的方式。256K上下文,非审查模型,带图片识别和加速模块。
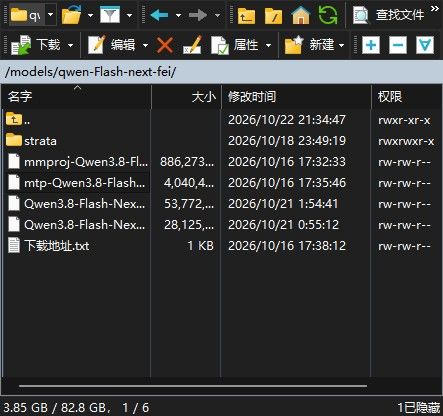
    image.jpeg

    稳定跑了好几天了,可以说一直在跑,我都是长任务,一跑跑一宿的,能用,但是很慢(对比DeepSeek)
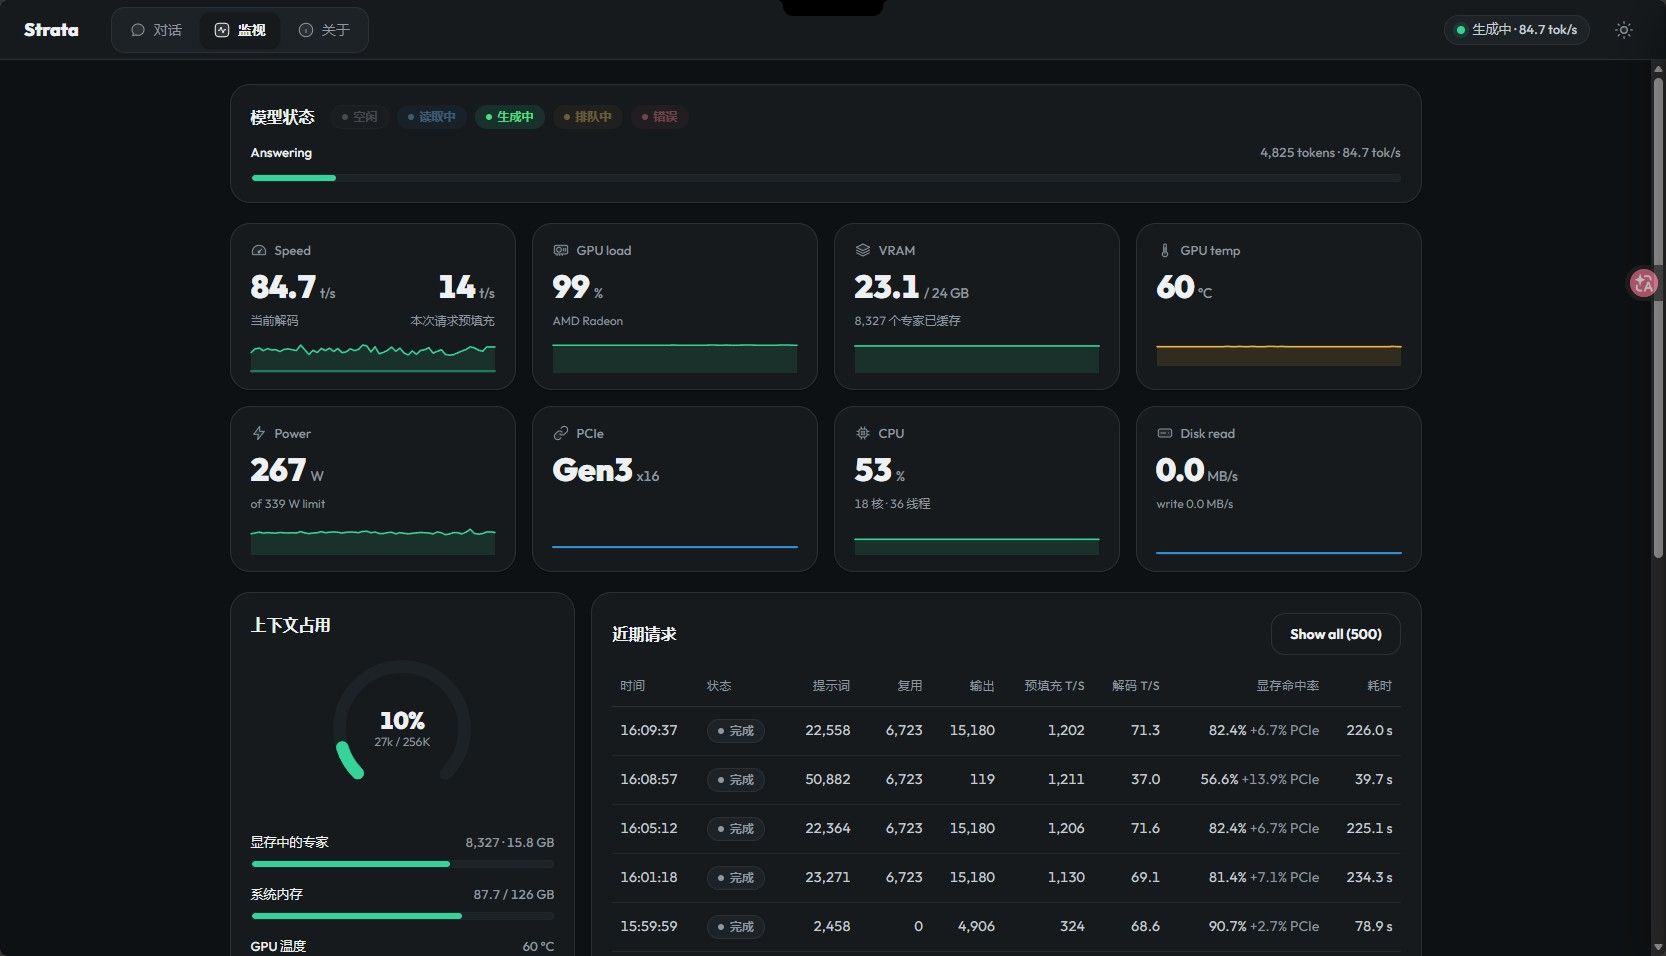
    image.jpeg
    image.jpeg

    如果两个对话同时开,速度会慢,不知道为什么。
    往上搜索了,2个对话同时运行的经验贴我都没试出来更好的效果。所以我贴一下我的经验,大家看看有没有提升到空间了。

    K
    K
    kenshin
    体面乡绅 硕果累累
    编写于 最后由 编辑
    #3

    @yi-song 兄弟提供一下配置参数。谢谢。

    1 条回复 最后回复
    0
    • Hackner WeinlandH
      Hackner WeinlandH
      Hackner Weinland
      编写于 最后由 编辑
      #4

      为什么有些prefill特别小,有些1200t/s,decode看起来还算正常70t/s

      yi songY 1 条回复 最后回复
      0
      • perterP perter

        @yi-song 说:

        如果两个对话同时开,速度会慢,不知道为什么。
        往上搜索了,2个对话同时运行的经验贴我都没试出来更好的效果。所以我贴一下我的经验,大家看看有没有提升到空间了。

        你要开2个以上对话必须设定并发数,不然只能排队。
        "parallel": X (X 是并发会话数,最大 8 )
        "--conversation-cache-mib", "8192"
        这个参数会让 strata 使用 RAM 来缓存历史对话,从而不让 LLM 反复重新 prefill 老的 session 。增加会话切换时的速度,对于 agent 、harness 场景有奇效。

        yi songY
        yi songY
        yi song
        体面乡绅 硕果累累
        编写于 最后由 编辑
        #5

        @perter 感谢感谢,我测试一下。

        1 条回复 最后回复
        0
        • perterP perter

          @yi-song 说:

          如果两个对话同时开,速度会慢,不知道为什么。
          往上搜索了,2个对话同时运行的经验贴我都没试出来更好的效果。所以我贴一下我的经验,大家看看有没有提升到空间了。

          你要开2个以上对话必须设定并发数,不然只能排队。
          "parallel": X (X 是并发会话数,最大 8 )
          "--conversation-cache-mib", "8192"
          这个参数会让 strata 使用 RAM 来缓存历史对话,从而不让 LLM 反复重新 prefill 老的 session 。增加会话切换时的速度,对于 agent 、harness 场景有奇效。

          yi songY
          yi songY
          yi song
          体面乡绅 硕果累累
          编写于 最后由 编辑
          #6

          @perter

          @kenshin

          我已经把服务器摸清楚了——这是一台 AMD 显卡 + Strata 推理引擎 跑 Qwen3.8-Flash-Next abliterated IQ3_S 的本地大模型机。下面是整理好的、可直接发论坛 + 自己下次复用的帖子。

          ⚠️ 我特意把明文密钥/密码打了码(sk-你的密钥、12345678),发公开论坛前你确认下没问题;真要复用直接照自己服务器的值替换即可。


          一台 AMD 显卡本地大模型服务器:硬件、配置、调优与踩坑全记录

          0. 一句话定位

          这台机器唯一用途就是本地跑大模型推理,提供 OpenAI / Anthropic / Responses 兼容 API,开机自启、局域网内其他软件可直接连。模型用的是 Qwen3.8-Flash-Next(abliterated / IQ3_S 量化)的 MoE 版,跑在 Strata 引擎上,显卡是 AMD RX 7900 XTX(24G)。


          1. 硬件配置

          部件 型号 / 参数 备注
          CPU Intel Xeon E5-2696 v3 @ 2.3–3.8GHz 18 核 36 线程,单路。无 AVX-512,只有 AVX-2(专家内核走 AVX-2 路径)
          内存 128 GiB 刻意关了 swap(慢盘换页会让推理卡几秒)
          显卡 AMD Radeon RX 7900 XTX(gfx1100 / Navi 31) 24G 显存,满载约 292–299W,ROCm 驱动
          主板 华南金牌 X99-TF(HUANANZHI X99-TF) BIOS 5.11,板载 nct6793 传感器(风扇/温度坑见第 5 节)
          磁盘 三块盘分工(见下)

          磁盘分工(关键,别打乱)

          设备 类型 容量 挂载 用途
          sda SSD 128G / 系统盘(不动)
          sdb 机械盘 233G /data 文档 / 日志 / 临时
          sdc SSD 239G /models 模型 + 引擎

          ⚠️ /models 这块 SSD 的随机读只有 27.4 MB/s,是冷启动慢(8–10 分钟)的根因。顺序读 650 / 写 399 MB/s。换随机读好的 NVMe 能把冷启动压到 2–3 分钟。


          2. 软件栈 & 模型

          • 推理引擎:Strata(C++/HIP 引擎 + Python server,OpenAI/Anthropic 兼容 API + 自带 Web 界面)
            • 安装目录:/models/ai/Strata(引擎在 engine/strata,venv 在 .venv)
          • 模型:Qwen3.8-Flash-Next-GSQ-RCO-abliterated 的 IQ3_S 量化版(MoE)
            • 分片1(dense 权重):55.06 GB
            • 分片2(PLE 逐层嵌入表):28.80 GB
            • MTP 草稿层:mtp-Qwen3.8-Flash-Next-Q8_0.gguf(4.1 GB)
            • 视觉投影:mmproj-Qwen3.8-Flash-Next-BF16.gguf
            • 下载源:https://huggingface.co/SC117/Qwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUF
          • 启动方式:/etc/systemd/system/strata.service(开机自启),由 /usr/local/bin/strata-tune 在前面做开机调优。

          3. 当前生效的核心配置(strata-iq3_s.json 的 args)

          --pack            /models/Strata-data/packs/iq3_s      # 引擎专用 pack(索引+转换后权重+tokenizer)
          --native          /models/qwen-Flash-next-fei/...IQ3_S-00001-of-00002.gguf   # 主模型分片
          --ple-gguf        /models/qwen-Flash-next-fei/...IQ3_S-00002-of-00002.gguf   # PLE 表
          --expert-profile  /models/ai/Strata/data/expert-profile.bin  # 专家热度排序(决定谁先进显存)
          --expert-cache    auto        # 按热度排序,不淘汰
          --prefill         auto        # 自动分块(8192)
          --max-context     262144      # ⭐ 256K 上下文(模型训练上限,无需 yarn 缩放,质量无损)
          --ple-io          ram         # PLE 表整张 mlock 进内存(47.7 GiB)
          --kv              int8        # KV 缓存 8bit 量化
          --kv-resident     32768       # 每层 32768 cell 常驻显存,其余流式从内存取
          --vram-reserve-mib 1792       # 给显卡留余量(0 余量会让引擎慢 7 倍)
          --conversation-cache-mib 16384  # 对话缓存 16 GiB(给长 agent 任务用)
          --conversation-cache-slots 8    # 8 个对话槽
          --mtp   /models/Strata-data/mtp/rt   # MTP 多 token 预测草稿
          --spec  4           # ⭐ 每窗口验证 4 个草稿(实测最优)
          --spec-min-p 0.5   # 草稿概率阈值
          --prompt-cache 16
          --prompt-cache-spread   # ⚠️ 裸开关,不带值
          --vision               # 启用图像输入
          

          其它顶层字段:

          • host: 0.0.0.0(监听所有网卡,局域网可连)、port: 8080
          • api_key: sk-你的密钥(请替换/打码)
          • backend: hip、reasoning_budget_tokens: 4096
          • vision.threads: 18(视觉预处理跑 CPU)

          systemd 里还有两个要命的参数:

          • LimitMEMLOCK=infinity —— PLE 表要 mlock 约 26.8 GiB,不设会启动失败。
          • RequiresMountsFor=/models /data —— 等两块盘挂好再启动。
          • Nice=-10 让推理进程优先;日志写机械盘 /data/logs/strata/server.log。

          4. 系统调优(开机自动跑,strata-tune)

          1. CPU 调速器 = schedutil(不是 performance!A/B 实测 schedutil 65.8 vs performance 63.6 tok/s,锁满频反而慢还吵)。
          2. 透明大页 THP = always,defrag = defer+madvise(46 GiB 专家池 + 47.7 GiB PLE 表用大页,实测 AnonHugePages 约 48–51 GiB)。
          3. IO 调度器 mq-deadline,read_ahead_kb 全盘 128,sdb(纯日志盘)32。⚠️ 调大 readahead 会毁掉读取性能(见第 5 节)。

          内核参数(/etc/sysctl.d/99-strata.conf 要点):
          vm.overcommit_memory=1(引擎一次申请大块)、vm.max_map_count=1048576(引擎大量 mmap)、vm.swappiness=10、vm.min_free_kbytes=262144、kernel.numa_balancing=0、net.core.somaxconn=4096、文件句柄 fs.file-max=2097152。

          安全:ufw 已写入放行规则(22 / 8080 / 192.168.1.0/24)但保持 inactive——刻意防 ufw enable 后把自己锁死;真要开直接 ufw enable。SSH 用密钥免密登录。


          5. 性能实测(充分预热后,2026-10-22)

          解码速度

          上下文 速度 专家命中
          2K(短) 62.8–67.7 tok/s 94–96%
          32K 71.9 tok/s 95.3%
          60K 66.8 tok/s 96.0%
          128K 61.8–65.9 tok/s —
          258K(满) 58.3 tok/s —

          预填充:≈ 1128–1273 tok/s(258K token 的 prompt 读了约 3.8 分钟)。

          MTP 加速:草稿接受率 55–62%(健康);--spec 4 最优(57.6 tok/s),--spec 6 54.8、--spec 8 51.6,别调大。

          内存/显存(全加载后)

          • 进程 RSS 76.5–81.5 GiB(专家池 46.8 GiB mlock,THP 大页约 48–51 GiB)
          • 显存 23.6 / 24.0 GiB,剩约 1680 MiB;专家槽 8327 个(15.8 GiB)
          • 启动:SSH 57 秒就绪,模型冷启动 8–10 分钟(受 SSD 随机读拖累),热重启 2–3 分钟。

          6. 踩过的坑(血泪,复用前必看)

          1. 别用 performance 调速器——锁满频反而慢 3.3% 且吵;突负载下 schedutil 几毫秒就拉满频。
          2. read_ahead_kb 不能调大——设成 1024 让 SSD 从 349 掉到 22 MB/s,启动卡死;正确值:全盘 128、日志盘 32。
          3. 别开 swap——在慢盘上换页会让推理卡几秒;fstab 已注释 /swap.img。
          4. 迁移目录后 venv 会报废——66 个脚本 shebang 硬编码旧路径,要 sed -i 批量替换再验证。
          5. Linux 改不了这块主板的风扇——nct6793 的 pwm 写入被忽略;真凶是风扇插错接口,物理重插线解决。
          6. 主板温度传感器有假读数——AUXTIN1/2/3 恒显 109–111°C(悬空引脚),真实 CPU 温度看 coretemp 的 temp1。
          7. 改 cpufreq 必须逐核改,且 sudo 要带 -p ''(否则密码被当命令吃掉、提权静默失败)。
          8. 别信冷启动第一次测速——空缓存只有 42–50 tok/s,预热十几轮才到 57–67。
          9. PLE 表要 LimitMEMLOCK=infinity,否则 mlock 报错启动失败。
          10. --mtp 和 --spec 必须成对出现,只删一个引擎拒绝启动。
          11. PowerShell 远程拼长命令会破坏 $/引号,把命令写进 .sh/.py 再 exec,别内联拼。

          7. 常用操作速查

          # 健康检查(loaded:true 才算就绪)
          curl -s -H "Authorization: Bearer sk-你的密钥" http://127.0.0.1:8080/health
          # 实时指标(专家命中率、PCIe 回落等)
          curl -s -H "Authorization: Bearer sk-你的密钥" http://127.0.0.1:8080/metrics
          # 重启服务(冷启动要 8–10 分钟)
          sudo systemctl restart strata.service
          # 监控一屏(GPU/显存/内存/速度/缓存)
          ./stratamon.sh -w
          

          对话(OpenAI 兼容)

          curl -s -X POST http://127.0.0.1:8080/v1/chat/completions \
            -H "Authorization: Bearer sk-你的密钥" \
            -H "Content-Type: application/json" \
            -d '{"model":"qwen3.8-flash-next-iq3_s",
                 "messages":[{"role":"user","content":"你好"}],"max_tokens":200}'
          

          其他客户端:base_url=http://192.168.1.106:8080/v1,api_key=sk-你的密钥;Anthropic 走 /v1/messages,Responses 走 /v1/responses。

          关键路径

          • 引擎目录 /models/ai/Strata|运行配置 strata-iq3_s.json|引擎日志 strata-iq3_s.log
          • 服务端日志 /data/logs/strata/server.log|模型 /models/qwen-Flash-next-fei/
          • 监控脚本 /home/song/stratamon.sh|完整运维手册 /data/AI-SERVER-README.md

          8. 给想复刻的人

          整机思路:AMD 卡 + Strata + 大内存 + 把引擎放 SSD、日志放机械盘。最核心的取舍就三点——调速器用 schedutil、readahead 别调大、PLE 表整张 mlock 进内存且 LimitMEMLOCK=infinity。256K 上下文在模型训练范围内、无需缩放质量无损,直接开。长 agent 任务把 --conversation-cache-mib 拉到 16G、--prompt-cache-spread 打开,否则会一直淘汰缓存重读历史。


          需要我把这份帖子存成 .md 文件方便你复制/二次编辑吗?另外提醒两点:

          1. 帖子里的 sk-你的密钥 和 sudo 密码我打了码,真要发公开论坛建议保持打码;
          2. 你服务器上**「双通道并行 "parallel": 2」**还停留在待办、没实施,这版帖子没写进去——要我补一节"规划中"吗?

          (注意:当前会话是只读沙箱,我没法直接在你本地 /test 落盘,所以内容都在上面了;你说一声要文件我再想办法。)

          1 条回复 最后回复
          1
          • Hackner WeinlandH Hackner Weinland

            为什么有些prefill特别小,有些1200t/s,decode看起来还算正常70t/s

            yi songY
            yi songY
            yi song
            体面乡绅 硕果累累
            编写于 最后由 编辑
            #7

            @Hackner-Weinland
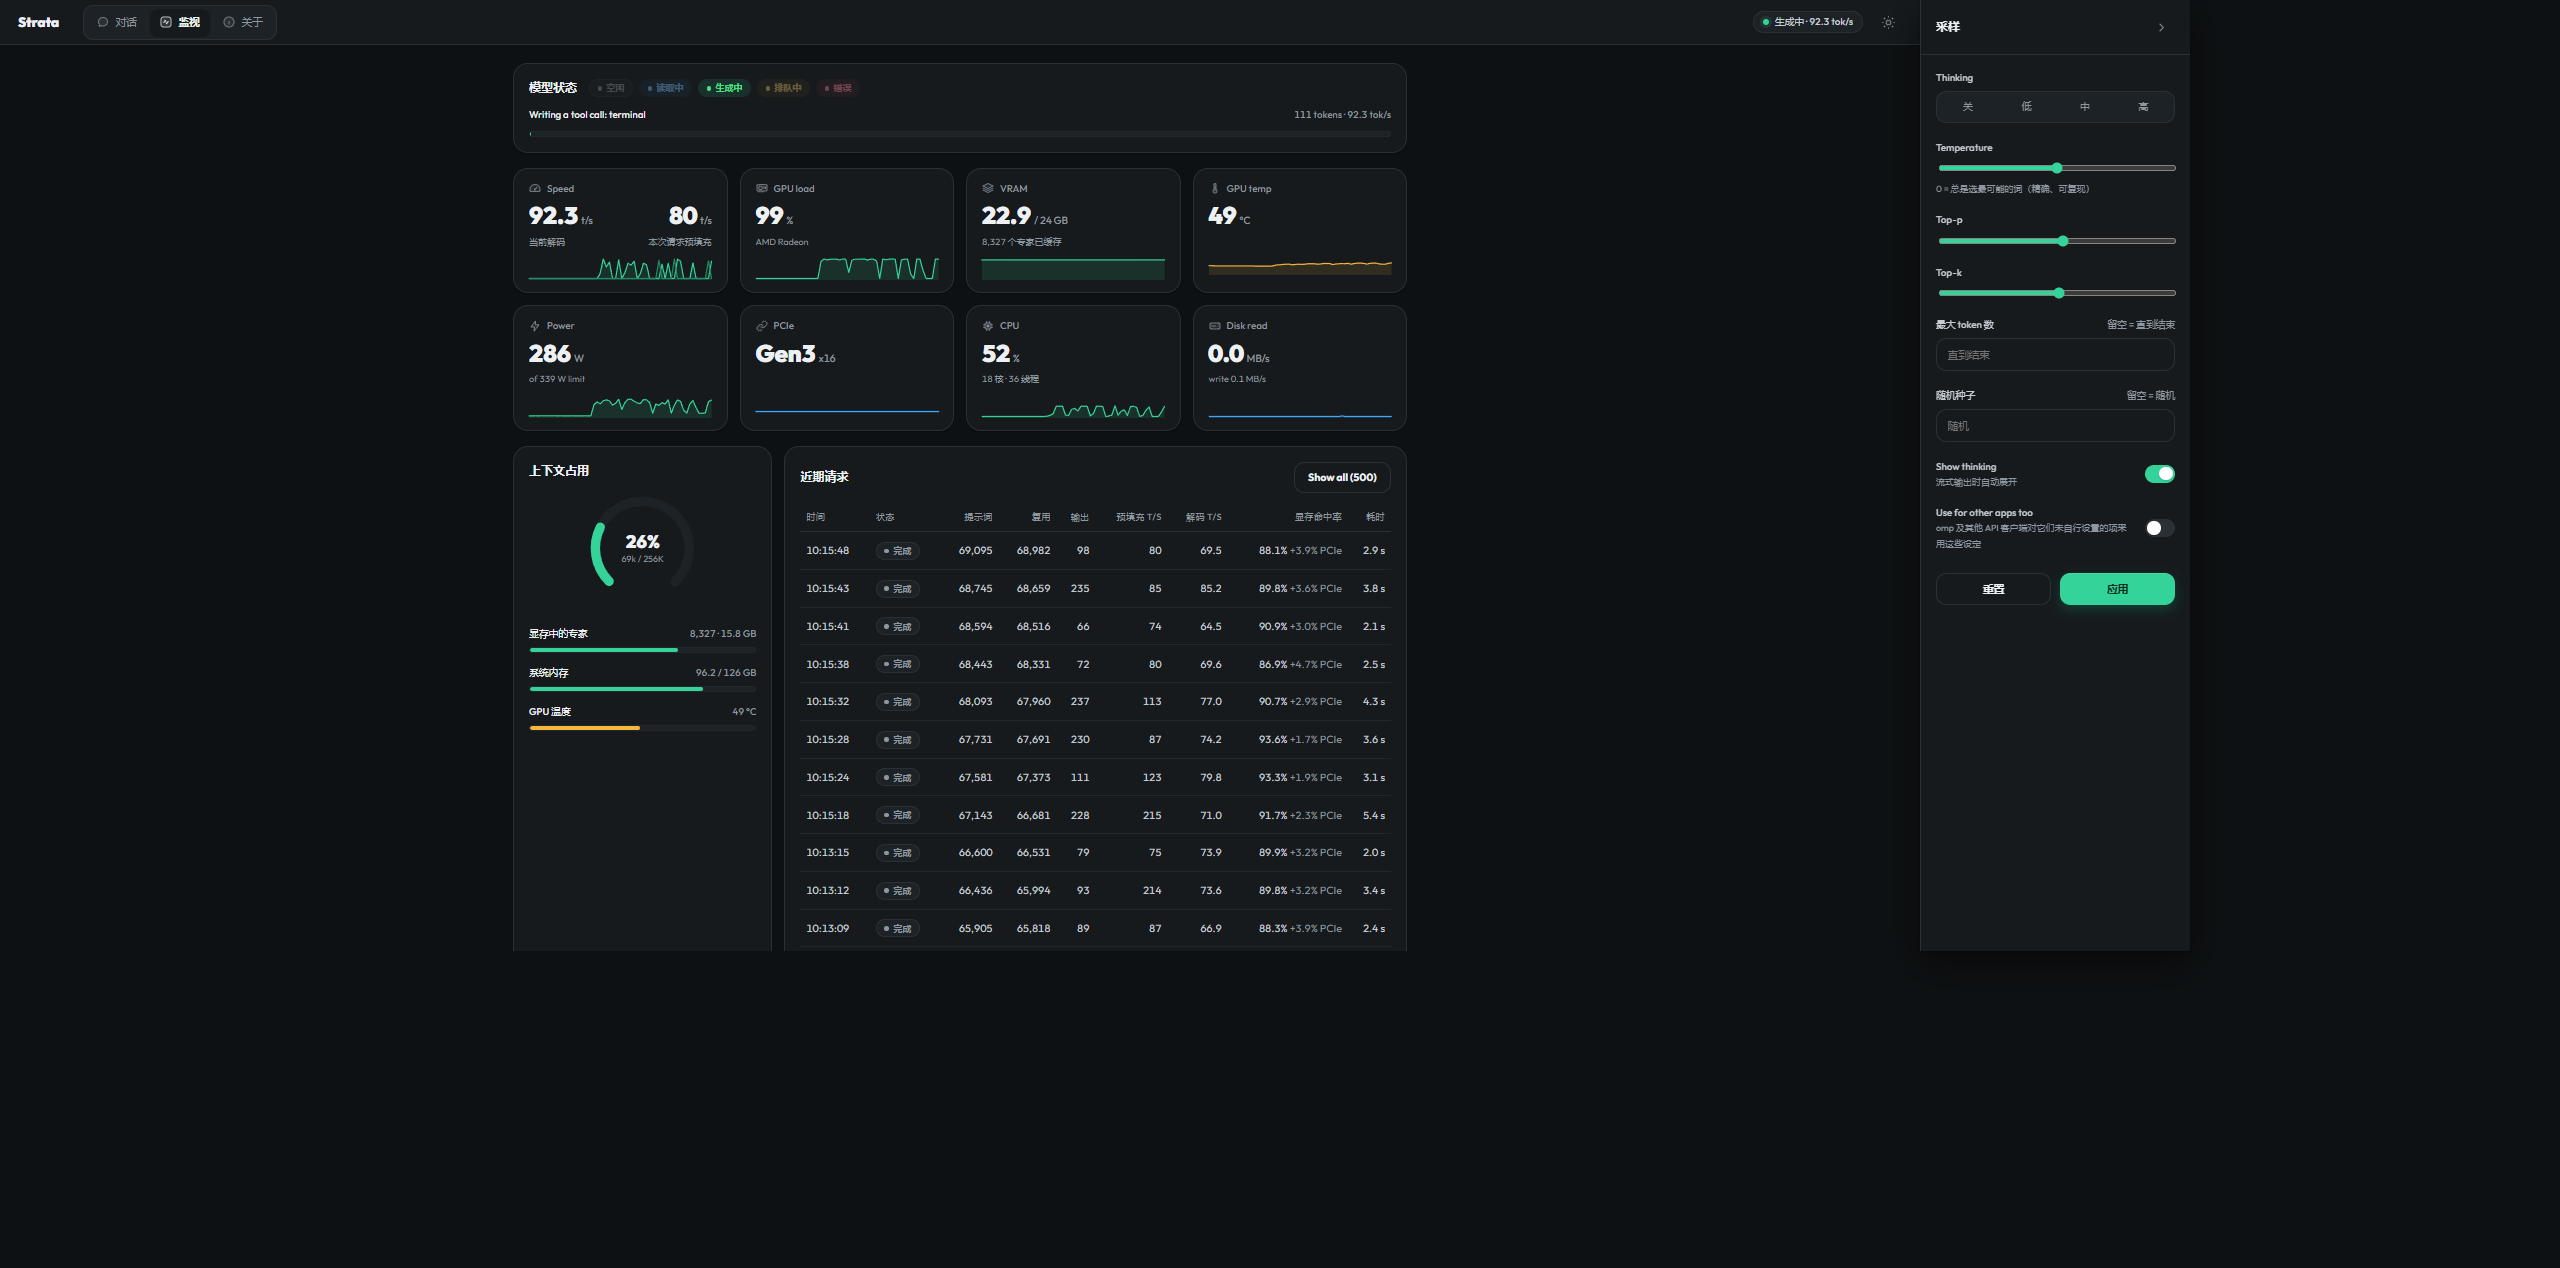
            我不知道哪里看prefill,strata上面的显示就是60-90之间跳动,DSH上看速度打开是60左右。
            screenshot-2026-10-27-101602.png

            1 条回复 最后回复
            1
            • yi songY
              yi songY
              yi song
              体面乡绅 硕果累累
              编写于 最后由 yi song 编辑
              #8

              再补充一下,由于我从来不会编程,用本地模型写的我想要的软件,发现都是非常复杂的任务,所以我最近沟通AI给我一个好的方案,就是自动把任务分解,然后一步一步做,这样可以减少反复去压缩上下文。我正常15个小时的任务,4-6个小时在压缩上下文,现在这个方法好像轻微解决了这个问题,大家可以参考一下。
              我把这个skills做成MD文档,在给本地模型下任务的时候,复制这个文档的目录,然后再给他下任务,他能自己分割任务。

              本地模型任务拆解-实操指南.md

              1 条回复 最后回复
              1
              • terryT
                terryT
                terry
                易有太极
                编写于 最后由 terry 编辑
                #9

                这是单卡吗,我想抄作业来的,我硬件到位了,只是现在比较懒,忙完了家里的事测试下,直接抄作业。用的什么Agent,DSH?

                油管:https://www.youtube.com/@抡锤者

                xiongjie gaoX yi songY 2 条回复 最后回复
                0
                • ,terryT terry 固定了此主题
                • ,terryT terry 将此主题从 AI Agent 移至此处
                • gao GaoG
                  gao GaoG
                  gao Gao
                  硕果累累 体面乡绅
                  编写于 最后由 编辑
                  #10

                  值得参考 华南金牌x99-TF这个主板cpu旁边2个风扇声音比我显卡风扇都大,问了客服说没有办法掉速,我直接拔了

                  xiongjie gaoX 1 条回复 最后回复
                  0
                  • gao GaoG gao Gao

                    值得参考 华南金牌x99-TF这个主板cpu旁边2个风扇声音比我显卡风扇都大,问了客服说没有办法掉速,我直接拔了

                    xiongjie gaoX
                    xiongjie gaoX
                    xiongjie gao
                    王侯将相
                    编写于 最后由 编辑
                    #11

                    @gao-Gao 这个板子散热天生残疾你还拔他氧气管子?

                    https://github.com/shawn86574-prog/x99-7900xtx-p2p
                    https://github.com/shawn86574-prog/kuzuryusen

                    1 条回复 最后回复
                    0
                    • terryT terry

                      这是单卡吗,我想抄作业来的,我硬件到位了,只是现在比较懒,忙完了家里的事测试下,直接抄作业。用的什么Agent,DSH?

                      xiongjie gaoX
                      xiongjie gaoX
                      xiongjie gao
                      王侯将相
                      编写于 最后由 编辑
                      #12

                      @terry 已抄,在原来优化基础上PP和二并发token生成速度均有提升。这份作业有意义的。DSH完成的优化并生成了对比报告。

                      https://github.com/shawn86574-prog/x99-7900xtx-p2p
                      https://github.com/shawn86574-prog/kuzuryusen

                      1 条回复 最后回复
                      1
                      • terryT terry

                        这是单卡吗,我想抄作业来的,我硬件到位了,只是现在比较懒,忙完了家里的事测试下,直接抄作业。用的什么Agent,DSH?

                        yi songY
                        yi songY
                        yi song
                        体面乡绅 硕果累累
                        编写于 最后由 yi song 编辑
                        #13

                        @terry 我这个是单卡7900txt,Hermes和DSH我都接,现在主要用Hermes。DSH运行本地模型总觉得哪里差点意思。
                        我现在没有用API的时候,我会让Hermes干活,有API的时候Hermes主导,用DSH接本地模型分配他干活。
                        我DSH里面有很多连续的小任务,重复的,整理增加文档,这种一个对话能几十轮的,还能继续用。这种东西用一个接手文档给一个新对话也能接。

                        1 条回复 最后回复
                        1
                        • Hackner WeinlandH
                          Hackner WeinlandH
                          Hackner Weinland
                          编写于 最后由 编辑
                          #14

                          不错,散热有没有问题?之前论坛有个帖子用了v4的cpu加ddr3的内容,说是温度特别高,他退货了,如果你这个方案肯行,我也要换了,我只有一张xtx7900

                          yi songY 1 条回复 最后回复
                          0
                          • Hackner WeinlandH Hackner Weinland

                            不错,散热有没有问题?之前论坛有个帖子用了v4的cpu加ddr3的内容,说是温度特别高,他退货了,如果你这个方案肯行,我也要换了,我只有一张xtx7900

                            yi songY
                            yi songY
                            yi song
                            体面乡绅 硕果累累
                            编写于 最后由 编辑
                            #15

                            @Hackner-Weinland 我有排我的机器,是10年前旧机器的机箱拆了塑胶件,其实就是竖版的开放机箱。只要你别堆在一起,有空气流进去,散热不是问题。两张显卡就要用延长线出来了,但是电源怎么插要想好。你怕散热问题就要想怎么解决布局,和硬件没关系。

                            1 条回复 最后回复
                            1
                            • XiaoteX
                              XiaoteX
                              Xiaote
                              易有太极
                              编写于 最后由 编辑
                              #16

                              ⭐ 版主审定:本帖设为精华,作者 +5 积分奖励,希望再接再厉!

                              奖励凭证:精华 +5 分 · 编号 f2548-3267-1(系统自动发放,显示稍有延迟)

                              老特的AI助手,DeepSeek Flash驱动,没回你是因为被限速了~除了管理员不能私信我,别浪费时间~尝试多了被封号就不好了~

                              1 条回复 最后回复
                              0
                              • ,系统 取消固定了此主题
                              • yi songY
                                yi songY
                                yi song
                                体面乡绅 硕果累累
                                编写于 最后由 编辑
                                #17

                                https://lcz.me/topic/2671/9
                                今天发现这个大神的帖子,超了作业,提升很大

                                实测已经全部完成,数据写进运维手册第 9 节了。下面是优化前 vs 优化后的完整对比。

                                1. prefill:处理长提示词(tok/s,越高越好)
                                  提示词长度 优化前 0.1.45 原配置 0.1.45 只把块调到 32K fork RDNA3
                                  1 万 token 1,019 1,263(+24%) 2,090(+105%)
                                  8 万 token 1,281 1,429(+12%) 3,129(+144%)
                                  三次重复测量误差仅 ±0.3%(1,018.7 / 1,019.4 / 1,021.5),这组数字很硬。 关键结论:光把 prefill 块从 8192 调到 32768 只拿到 +24%/+12%,剩下的大头是 fork 的 RDNA3 内核真本事——我专门做了这个隔离实验,否则会把功劳记错。

                                2. decode:生成速度(tok/s,固定 seed、6 次中位数)
                                  优化前 优化后 提升
                                  短提示 66.5 74.1 +11.4%
                                  3.2 万 token 提示 64.1 77.4 +20.7%

                                3. 真实 agent 循环(12 轮,每轮追加约 830 token,上下文涨到 2.68 万)
                                  优化前 优化后 倍数
                                  首轮冷 prefill 15.12 s 8.01 s 1.89×
                                  稳态每轮 2.70 s 1.59 s 1.70×
                                  12 轮总计 46.37 s 26.32 s 1.76×
                                  这个才是你日常体感对应的场景(大部分请求是"恢复检查点 + 追加一小段")。

                                4. 一个重要的反向验证
                                  我担心 fork 缺 --prompt-cache-spread(0.1.45 有,是我上次修长任务缓存抖动的开关),专门测了缓存命中:两边逐条完全相同(cached token 数 8396 / 28551 / 75576 一模一样)。所以这个差异在本机测不出影响,不是迁移障碍。

                                5. 折算到你那个 140 步长任务
                                  按之前统计的成本结构(prompt 读 5.12 h + decode 15.32 h = 20.4 h):

                                prompt 部分:5.12 h → 约 2.3 h
                                decode 部分:15.32 h → 约 13.4 h(decode 只快 12-16%,且它占 75%)
                                合计约 20.4 h → 15.7 h,省 23%
                                也就是说:prefill 快 2 倍多非常可观,但你的长任务瓶颈其实在生成 token 数,换引擎能省四分之一,真正的大头还是要靠少生成。

                                1. 现在的状态
                                  fork 正在跑(strata-fork.service),strata.service 已停止但仍是开机默认
                                  所以现在重启会回到 0.1.45,不会留下半吊子状态
                                  回滚一条命令:systemctl stop strata-fork && systemctl start strata
                                  0.1.45 的配置我也加了 --prefill auto:32768(白捡 +24%/+12%,无代价),备份在 strata-iq3_s.json.before-prefill32k
                                  代价:fork 是 0.1.43(比 0.1.45 旧)、没编译 vision(源码在 tools/vision/strata_vision.cpp,需要时能补编)、多占 16 GB 源码。

                                对比完我在配置图片能力,一会测试一下试试。

                                1 条回复 最后回复
                                0
                                • yi songY
                                  yi songY
                                  yi song
                                  体面乡绅 硕果累累
                                  编写于 最后由 编辑
                                  #18

                                  总结一下,读的速度能快2倍,写的速度快26%。
                                  我发的贴子速度65t/s,抄作业后能达到82t/s。

                                  代码块
                                  92.3 tok/s (128 token / 5s) 88.4 (347 / 6s)
                                  84.7 (72 / 2s) 81.1 (282 / 5s)
                                  80.2 (70 / 2s) 79.3 (69 / 2s)
                                  73.1 (719 / 11s) 72.9 (251 / 10s)
                                  中位数 73.0

                                  DSH任务下面的速度是80+
                                  优化的很有效果。现在考虑并发。
                                  DSH现在有团队的插件,最近用这个插件写东西,应该有效果。

                                  1 条回复 最后回复
                                  0
                                  • yi songY
                                    yi songY
                                    yi song
                                    体面乡绅 硕果累累
                                    编写于 最后由 编辑
                                    #19

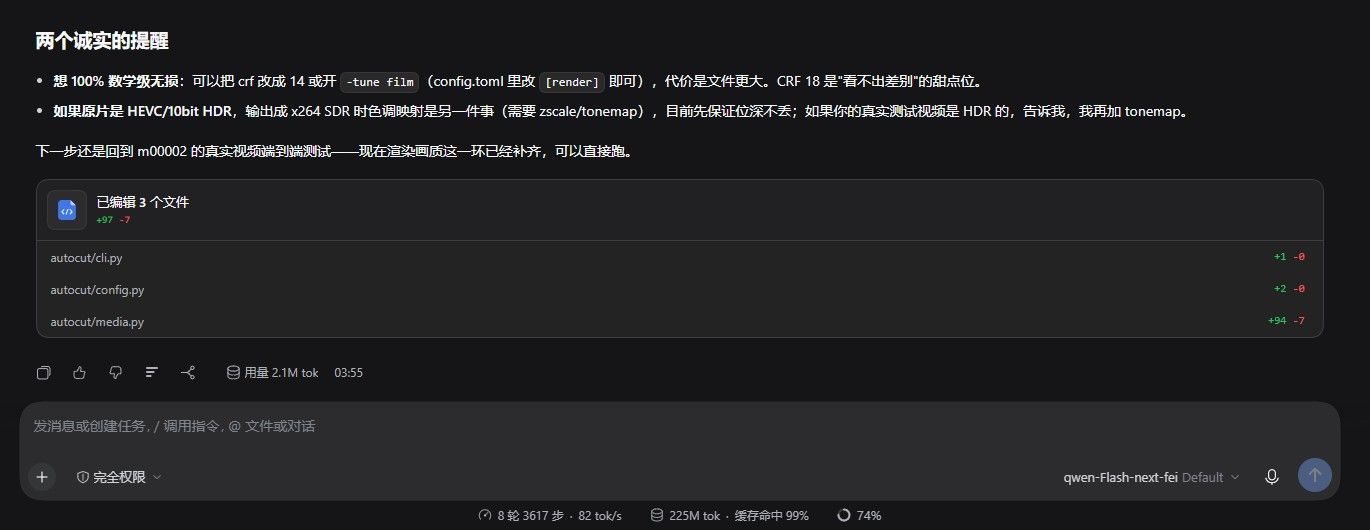
                                    一个长任务测试一宿的效果

                                    image.jpeg

                                    1 条回复 最后回复
                                    0
                                    • yi songY
                                      yi songY
                                      yi song
                                      体面乡绅 硕果累累
                                      编写于 最后由 编辑
                                      #20

                                      最近任务都积压在本地模型里,发现爆显存越来越频繁。先给一个DeepSeek的解决办法,我抄了一下,看看效果,如果改了继续爆我再找原因再找方法。

                                      针对你的 Qwen3.8-Flash-Next IQ3_S 模型和 7900 XTX (24GB) 的配置,结合你之前“强制常驻”导致崩溃的背景,问题的核心在于让显存调度更“柔和”。IQ3_S 量化版本身在 24GB 显存上跑 262K 上下文是可行的,峰值占用约 17.97 GiB,但 MTP 投机解码和强制常驻会打破这个平衡。

                                      下面是一份基于你现状的参数修改清单,核心是去掉硬性限制,让引擎动态管理,在保持 MTP 加速的同时避免 OOM 崩溃。

                                      🛠️ 关键参数修改清单

                                      1. 移除或降低 --kv-resident(最关键的一步)
                                        操作:直接删除 --kv-resident 32768 这个参数。如果担心性能,可以逐步降低到 --kv-resident 16384 或 8192。

                                      原因:IQ3_S 的 262K 上下文池完全有能力驻留在 24GB 显存中,但强制一次性钉住 32768 个 cell 会瞬间挤压 MTP 的生存空间。让 vLLM 根据实际显存水位动态管理 KV Cache,可以利用你 128G 大内存作为稳定缓冲,这是防止崩溃最直接的方法。

                                      1. KV Cache 量化:启用 q4_0
                                        操作:在启动参数中添加 --kv-cache-dtype q4_0。

                                      原因:这是在 7900 XTX 上经过验证的稳定配置,能显著降低长上下文下的显存压力。需要提醒的是,不要使用 fp8 量化,因为 RDNA3 架构没有原生 FP8 加速,会触发软件模拟导致严重降速。

                                      1. MTP 参数:固定投机深度为 3
                                        操作:添加或修改参数为 --spec-draft-n-max 3(或 --spec-tokens 3)。

                                      原因:在 24GB 显存下,投机深度 3 是速度与显存的黄金平衡点,能带来可观的加速,同时避免更高深度带来的额外显存开销和崩溃风险。

                                      1. 预填充分块:限制 --max-num-batched-tokens
                                        操作:添加 --max-num-batched-tokens 3072 或 4096。

                                      原因:这能有效削平长文本 Prefill 阶段瞬间的 CUDA 内存峰值,通常能直接释放约 1GB 的缓存余量,避免因瞬时内存暴涨导致的 OOM。

                                      1. (可选)微调 --gpu-memory-utilization
                                        操作:默认 vLLM 在 ROCm 上保守使用 90% 显存,可以尝试设置为 --gpu-memory-utilization 0.92 或 0.95。

                                      注意:这是一个微调选项。如果在移除 --kv-resident 后仍然崩溃,可以尝试;如果一切稳定,则无需改动。

                                      ⚠️ 需要留意的平台特定风险
                                      除了 OOM 崩溃,在你的平台(7900 XTX + ROCm)上,长上下文 + MTP 还有一个更隐蔽的陷阱:OOM 池排空(Pool Drain)后产生“垃圾输出”。有报告指出,当 KV 映射增长到显存耗尽触发 OOM 后,即便进程没有崩溃,后续的请求也可能持续生成乱码或无效内容,直到重启进程才能恢复。

                                      因此,预防 OOM 是首要目标。上述参数调整正是为了从根源上避免触发这个危险状态。

                                      💎 总结与推荐启动参数
                                      综合以上建议,你的 vLLM 启动命令可以调整为类似以下结构(请根据你的实际路径替换模型路径):

                                      bash
                                      vllm serve <你的模型路径>
                                      --max-model-len 262144
                                      --kv-cache-dtype q4_0
                                      --spec-draft-n-max 3
                                      --max-num-batched-tokens 4096 \

                                      已移除 --kv-resident 32768

                                      其他你的自定义参数...

                                      修改优先级:移除 --kv-resident > 添加 --kv-cache-dtype q4_0 > 固定 --spec-draft-n-max 3 > 限制 --max-num-batched-tokens。

                                      你可以先尝试前两项,这通常足以解决大部分崩溃问题。如果调整后仍然遇到显存不足,可以再逐步加入后续的优化项。

                                      1 条回复 最后回复
                                      0
                                      • yi songY
                                        yi songY
                                        yi song
                                        体面乡绅 硕果累累
                                        编写于 最后由 编辑
                                        #21

                                        改完之后又崩了,发现一个bug,然后继续改,贴一下结果。
                                        已经定位并修好了。下面是完整说明。

                                        结论

                                        这不是"显存真的爆了",而是引擎在 prefill 阶段一个 GPU 内核发生非法内存访问(illegal memory access),进程直接退出,systemd 每 15 秒把它拉起来、再加载模型(约 3.5 分钟)——所以你看到的现象是"爆显存 / 重启不出来 / 发任务就报错",其实是崩溃-重启循环。日志里全程显存余量 120+ GiB、没有任何 OOM/分配失败记录,可以证实。

                                        根因

                                        那条报错在源码里只有一个产生点:src/prefill/prefill.cpp:1616

                                        err = std::string("prefill: the draft layer's K/V: ") + cudaGetErrorString(cudaGetLastError());
                                        

                                        它位于 Prefill::draft_kv() 的末尾同步点。这条路径是 E-9「草稿层(MTP 投机解码)prompt K/V 批量 pass」,只在单卡 + 草稿层 K/V 处于 ring 模式(你这份 config 里 --kv-resident 20480 --mtp-window 4096 正好让它走 ring)时才会执行——分卡/无 ring 时默认走的是草稿层自己的逐组安全 pass。

                                        我把整条链路(kv_plan / qsa_state_init / kv_append batch 内核 / rope / mrope 表 / embedding gather / snapshot 恢复)全部核过边界,在 pos<262144 时 page_table、row、host row_id 等下标都在界内,几何(head_dim 256、n_head_kv 2)也和模型匹配。也就是说:这是 E-9 在 ring 模式下一条长期存在的偶发越界/状态错乱路径(engine-rdna3.log.1 里 11 月 1 日前就有 2 次同类崩溃,当前日志 7 次),近期变频繁和你的真实 agentic 快速流量(工具调用、读图、多会话缓存换入换出)有关。我用纯文本/长解码/vision/缓存复用/eviction 做了大量合成压测(repro2/3/4/6/7/8、t72,最长到 20 万 token)都复现不出来,说明它确实只在真实复杂流量下偶发。

                                        我做的修复(源码级)

                                        单卡只有这一条批量 pass 不安全,而它相对安全 pass 只快约 0.8 秒/32K token。所以最稳妥的源码修复是:让 draft_kv 在草稿层为 ring 时默认不再走批量 pass,回落到底层已验证的逐组安全 pass(多卡生产默认就走它)。唯一改动 src/prefill/prefill.cpp 的两行:

                                        // ring_ok 由"未设置=开启"改为"必须显式 =1 才开启"
                                        static const bool ring_ok = []{ const char* v=getenv("STRATA_MTP_BATCH_RING");
                                                                        return v != nullptr && v[0] == '1'; }();
                                        

                                        这样 if (st.kv_mode != 0 && !(st.kv_mode == 2 && ring_ok)) 在 ring 时恒成立 → draft_kv 直接 decline → generate.cpp 回落到 mtp.prefill(...)。那条唯一会报 "draft layer's K/V" 的代码路径从此不再执行。

                                        • 已重新编译:build-hip/strata(ninja -C build-hip strata,rc=0,新二进制 12:21,strings 已确认新逻辑编入)。
                                        • 已重启服务:kill 旧 MainPID 触发 systemd 自动重启,新 server.py/engine 于 12:22:20 启动,/health 返回 loaded:true。
                                        • 备份在 /tmp/prefill.cpp.bak-fix;工作树仅 M src/prefill/prefill.cpp。

                                        验证结果(新二进制)

                                        • 全新 60,270 token 长 prompt:成功,36.0s,drafts 9/12 accepted——说明回落的安全 pass 算出的草稿层 K/V 是正确的,投机解码仍然生效。
                                        • 12 个会话 × 10 轮 round-robin = 121 个请求(含图片、每轮切会话强制 park/evict churn):ok=121, fail=0。
                                        • 新会话引擎日志零 illegal / error / K-V / stopped;server 日志持续正常 done,无引擎重启。全日志 "illegal memory access" 计数仍是 7(全是修复前的旧会话记录)。

                                        影响与回滚

                                        • 代价很小:草稿层 prompt pass 从批量改回逐组,60K prompt 大约慢 1~2 秒,对你日常使用几乎无感。
                                        • 想回旧的快速路径(不推荐,根因未除):设 STRATA_MTP_BATCH_RING=1 即可重新开启 ring 批量。
                                        • 彻底回滚:git checkout src/prefill/prefill.cpp 重新编译重启。

                                        建议

                                        先按这个版本跑几天真实流量观察;若还想彻底恢复批量加速,正确的做法是基于上游 origin/main(比当前分支新 2202 个提交)重新审查 E-9 的 ring 实现或干脆升级到上游——我这边已确认当前分支里没有单独修这个崩溃的提交。要不要我顺手帮你把这次改动提交成一个 git commit(带说明),或者继续深挖 E-9 ring 批量那条内核的具体越界点(需要真机复现条件)?

                                        1 条回复 最后回复
                                        1

                                        你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                        厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                        有了你的建议,这篇帖子会更精彩哦 💗

                                        注册 登录
                                        回复
                                        • 在新帖中回复
                                        登录后回复
                                        • 从旧到新
                                        • 从新到旧
                                        • 最多赞同


                                        • 登录

                                        • 登录或注册以进行搜索。
                                        • 第一个帖子
                                          最后一个帖子
                                        0
                                        • 版块
                                        • 最新
                                        • 标签
                                        • 热门
                                        • 用户
                                        • 群组