
我觉得大家有空可以多囤几张 RDNA4 显卡…
-
如题,Radiance 实在是太强了。
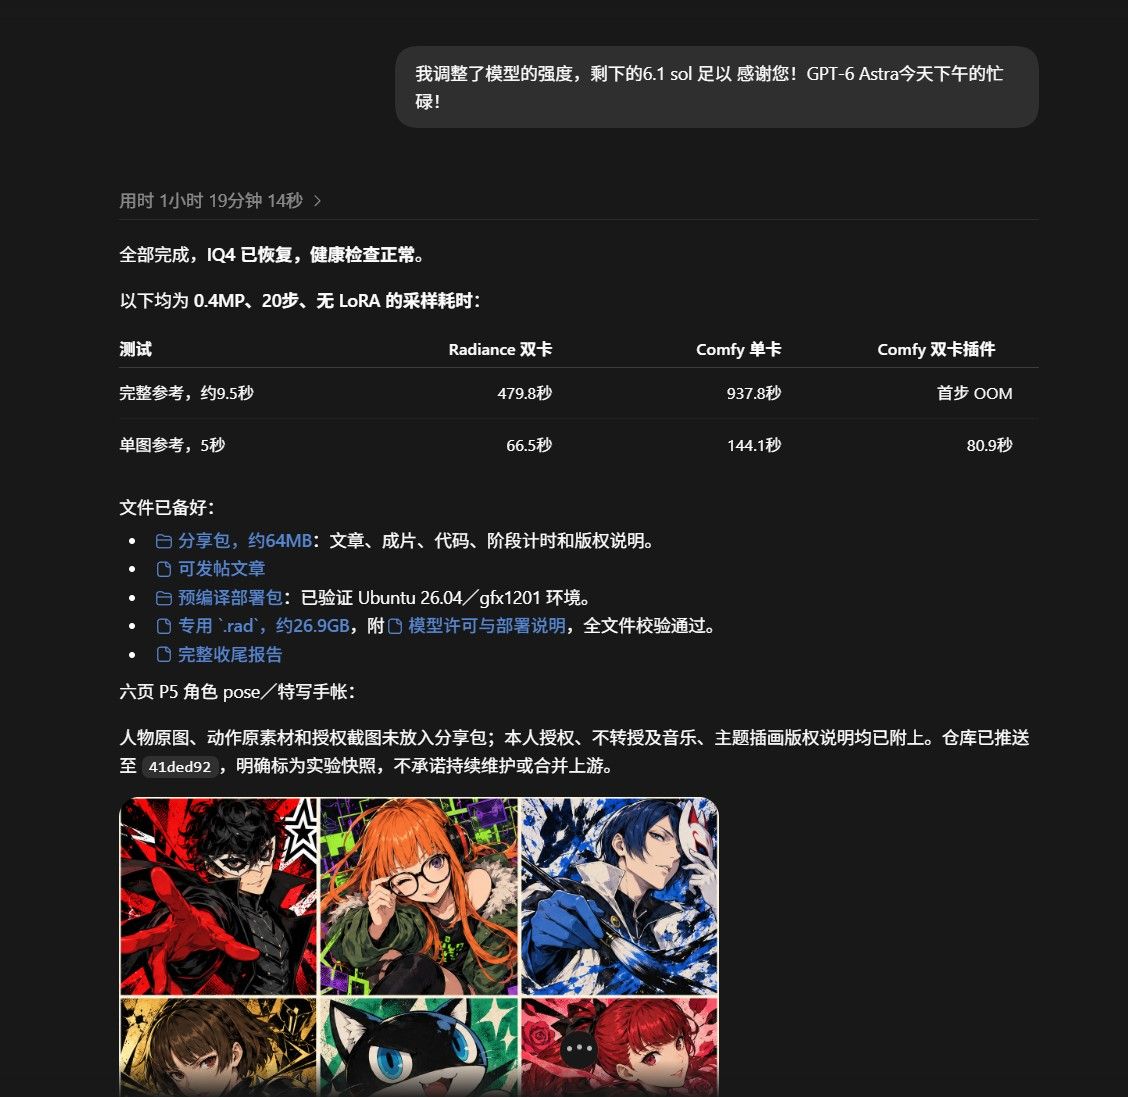
花了一个周末,让 OpenAI Codex 在它的基础上折腾了一轮,补上了 MiniMax-H3 Ref2VA FP8 的全引用支持,图片、动作视频、音乐可以混合输入,已经完整跑出了成品。
这轮主要围绕 RDNA4 优化 GPU 算子、显存布局和双卡调度。在双 R9700 上,既把全引用流程跑通了,也明显缩短了实测生成时间,并完整的利用上了64G显存。
当然,两张 RDNA4 只是这次的实测配置,这种优化思路还有向更多显卡扩展的空间。在主板 PCIe 通道、互联带宽和软件支持到位的前提下,可以把模型权重和计算任务合理分摊到不同显卡上,提高显存与算力的利用率。
我觉得它的吸引力就在这里,通过多卡协作,让相对便宜的硬件也能承担一些原本需要大显存专业卡才能处理的任务,向 Pro 6000 那类显卡的任务承载能力靠拢。当然,实际速度还要看具体负载,显存容量相加也不等于性能直接相加。
具体移植、优化和调试由 Codex 完成的,底子还是原作者的 Radiance,这次真的是站在了“巨人”的肩膀上了。
先发个小预告,详细过程、性能对照和实验分支稍后整理。
AMD 的硬件潜力确实还有得挖一下,就是生态需要多折腾... 趁现在还没反应过来,锤友们想搞的多买几张总不会错的。
想试试的老哥可以: 分支地址
-
-
yea, 现在的让agent 帮我们自动调度的玩法,在资源越多越好的情况之下简直得心应手
-
@imbiplaza-ASUS 之前不是总说 AMD 玩图生视频坑多嘛?这个周末折腾下来,我反而觉得,CUDA 那条“护城河”,至少现在,已经能搭桥过去了...
ComfyUI 里慢那就让 AI 帮忙改算子、调显存、做多卡分工,甚至换个引擎直接跑。对于玩本地AI,实打实的硬件加速单元、显存容量才是硬道理。
-
我买rtxpro 4500 之前,r9700pro 还是白菜的价格,现在。。。。。高攀不起了
-
@imbiplaza-ASUS 按照现在的趋势,后面四卡 Rx9070 XT 能爆掉现有的一切魔改卡方案。当然前提是得肯折腾。
-
-
@imbiplaza-ASUS 卧槽这么贵了吗。我还打算之后跟公司申请点米配四张这个给我们开发小组搭一套支持8路的Q38FN服务呢。

-
@Bunsei
9070xt起价100%,比肩以前的5080 -
-
-
@Bunsei
9070xt起价100%,比肩以前的5080 -
-
-
-
-
-
@kos-or 价钱太贵了 我不买了
自己买到一张r9700 也已经是涨价30-40% 过后的价钱了现在两张3090 跑strata
一张r9700 跑vllm
够用了
只需要压着自己购买欲望就可以了
-

 哎。 A卡也起飞了,现在就看B70啥时候也趟过这道生态的坎了。不对,好像B70已经也起飞了。


