-
@hanber121 我这儿让gpt 核对一下试试。我不确定是不是我这份代码在之前的时候已经改过了。
-
@hanber121 作业呢,分享啊,弟
-
-
-
@hanber121 我提交了一个,分为三档,快速(保留原来的256约 0.066MP)、均衡(1024、约 0.26MP)、质量(最长边 2048、约 1.05MP),但是没有优化,以下(质量)是完整按照COMFYUI的策略来的,完美契合。
-
@hanber121 我提交了一个,分为三档,快速(保留原来的256约 0.066MP)、均衡(1024、约 0.26MP)、质量(最长边 2048、约 1.05MP),但是没有优化,以下(质量)是完整按照COMFYUI的策略来的,完美契合。
-
@Bunsei 您这效率太高啦,我跟小鲸鱼鼓捣一晚上卡在行数预算过不去,最大只有112,160,调到1024就已经122,900爆预算了,抽帧后可以1024,抽狠点也能2048,但是参考视频的遵循度又很差 。您直接给优化到2048了,顶礼膜拜~~~我指挥ai的能力实在比您差太远了

您提交到哪了,之前您发的分支仓库里没找到,我想拉下来学习一下@hanber121 https://codeberg.org/Bunsei/radiance-h3-fullref/src/branch/h3-rdna4-release-20261030 这个分支在采样环境还没有做优化,你得注意哦。
-
@hanber121 https://codeberg.org/Bunsei/radiance-h3-fullref/src/branch/h3-rdna4-release-20261030 这个分支在采样环境还没有做优化,你得注意哦。
-
-
-
@Bunsei 那差距应该挺大的,用同一个素材包,您新提交的质量档(1mp)每步是118秒,fast每步是46秒。之前我用朋友那个5090+comfyui(默认1mp)测每步是77秒。pro6000比5090性能是不是还要强30%呢,那估计每步也就50秒吧,和你的fast档相当。不知道r9700再加一张组TP3会不会有一战之力哈哈

-
@hanber121 虽然两张卡加起来也没有到5090的算力,但有目标不是才能有动力嘛,尽力优化就好!

-
@Bunsei 那差距应该挺大的,用同一个素材包,您新提交的质量档(1mp)每步是118秒,fast每步是46秒。之前我用朋友那个5090+comfyui(默认1mp)测每步是77秒。pro6000比5090性能是不是还要强30%呢,那估计每步也就50秒吧,和你的fast档相当。不知道r9700再加一张组TP3会不会有一战之力哈哈
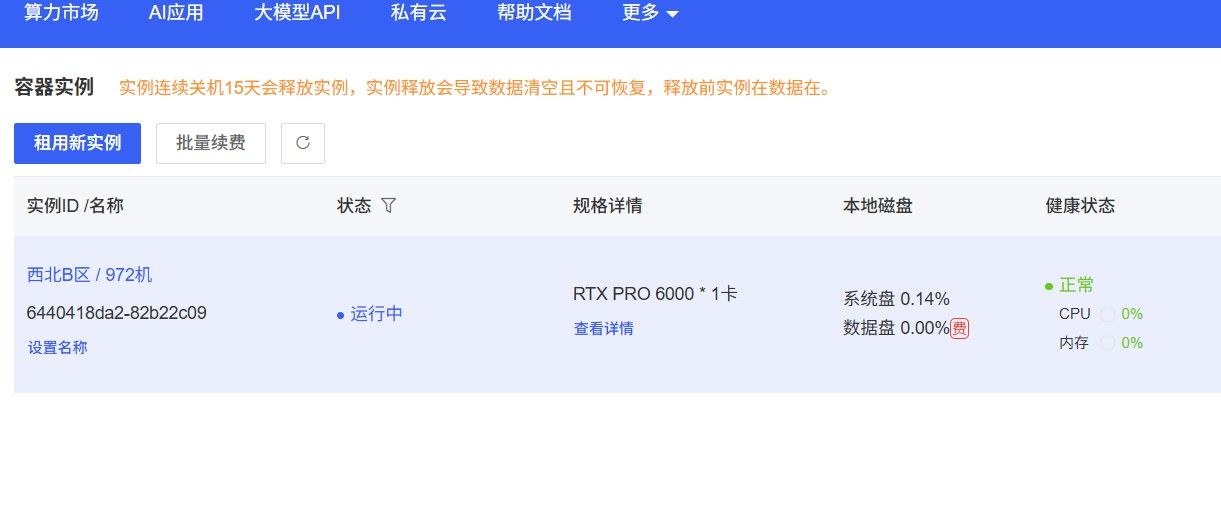
@hanber121 哥,你这朋友啥平台啥配置,我这租的PRO 6000 测了半天也只能测出90S/步还是不带LoRa的。
-
@hanber121 哥,你这朋友啥平台啥配置,我这租的PRO 6000 测了半天也只能测出90S/步还是不带LoRa的。
@Bunsei 您太有行动力了
 我看过帖子了,感觉有两个可能性:
- 注意力后端影响应该是最大的。您是用原生INT8 走 comfy-kitchen/aimdo 的 quant_config 链路 + SDPA attention;我在朋友家是用的 int8_convrot + sage/CK attention。还有TE您用的 NVFP4,我用的 int8
- 我是用采样总时间/步数,不是端到端时间/步数,我测试了20步和8步,平均下来的是76左右。如果用端到端时间/步数大概是96左右
- cpu是7b13, 8通道ddr4-3200内存。但是我感觉跟测试平台关系不大,因为测试刚好顶到显存极限,没有发生卸载惩罚,纯gpu在算,我观察cpu也没什么负载。