跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
  1. 主页
  2. 版块
  3. AI音视频画图
  4. 【双 R9700 折腾记】让 Radiance 跑起 MiniMax-H3 Rer2VA

【双 R9700 折腾记】让 Radiance 跑起 MiniMax-H3 Rer2VA

已定时 已固定 已锁定 已移动 精华 热议 AI音视频画图
radiancer9700minimax
119 帖子 14 发布者 4.2k 浏览 4 关注中
  • 从旧到新
  • 从新到旧
  • 最多赞同
回复
  • 在新帖中回复
登录后回复
此主题已被删除。只有拥有主题管理权限的用户可以查看。
  • F fcys

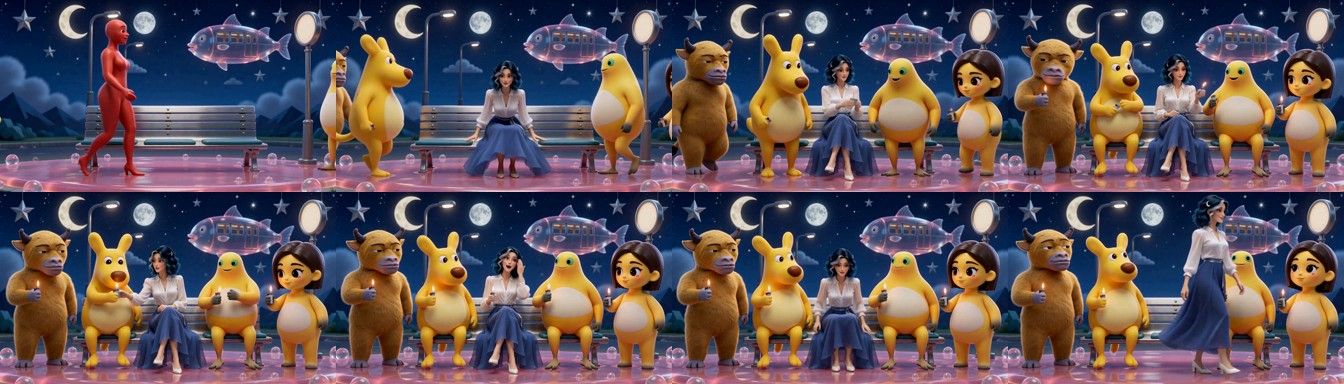
    @terry navi31是能跑通的,但是效果不是特别好,需要优化。我没有两张24G的7900xtx,用的两张W7900试了试,理论上除了显存没差别

    这是跑我自己的素材

    image.jpeg

    Tony WangT
    Tony WangT
    Tony Wang
    易有太极
    编写于 最后由 Tony Wang 编辑
    #85

    @fcys 说:

    @terry navi31是能跑通的,但是效果不是特别好,需要优化。我没有两张24G的7900xtx,用的两张W7900试了试,理论上除了显存没差别

    这是跑我自己的素材

    image.jpeg

    有个问题啊, 百思不得姐姐.

    Diffusion模型不是只能顺序计算吗? 那么不爆显存的情况下, 双卡怎么提升的速度?

    各位老大谁能解释一下? @bunsei @terry @fcys

    BunseiB 1 条回复 最后回复
    0
    • Tony WangT Tony Wang

      @fcys 说:

      @terry navi31是能跑通的,但是效果不是特别好,需要优化。我没有两张24G的7900xtx,用的两张W7900试了试,理论上除了显存没差别

      这是跑我自己的素材

      image.jpeg

      有个问题啊, 百思不得姐姐.

      Diffusion模型不是只能顺序计算吗? 那么不爆显存的情况下, 双卡怎么提升的速度?

      各位老大谁能解释一下? @bunsei @terry @fcys

      BunseiB
      BunseiB
      Bunsei
      王侯将相
      编写于 最后由 编辑
      #86

      @Tony-Wang

      Diffusion 的顺序性在“步”和“层”上。

      第 2 步要等第 1 步算完才能开始,这个确实没法并行,但每一层内部是一大堆可以同时算的矩阵运算。

      以 H3 为例,1344×768、226 帧的视频大约有几万个 token,每层要拿这几万个 token 去乘好几个 5376×5376 量级的权重矩阵。这是巨大的矩阵乘法,本来就是在 GPU 的几千个核上并行完成的。既然一张卡内部能并行,拆到两张卡上同样可以。所以步骤数量没有减少,降低的是每一步的耗时。

      1 条回复 最后回复
      1
      • Tony WangT
        Tony WangT
        Tony Wang
        易有太极
        编写于 最后由 Tony Wang 编辑
        #87

        @bunsei 了解了, 我问了AI,

        下面是AI的回答:

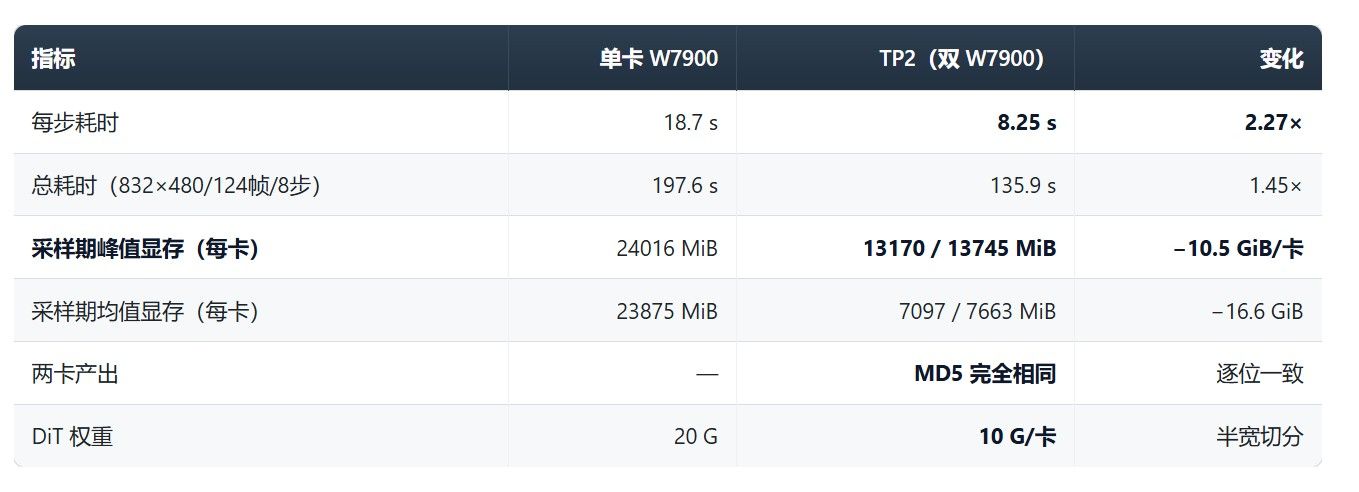
        关于“显存够用时,双卡 TP 为什么还能实现每步提速(2.27x)”的核心逻辑可以总结为以下三点:

        1. 算力与矩阵乘法并行(空间换时间):虽然扩散模型的时间步(采样步数)必须串行迭代,但在单个时间步内部,双卡 TP(张量并行)将原本由单卡独扛的 DiT 模型层计算拆分到了两张卡上,实现了算力叠加,单步耗时直接腰斩。
        2. 规避“显存边缘化”引发的性能惩罚:从实测数据看,单卡时峰值显存被压榨到了 24016 MiB(逼近物理极限),容易导致硬件内部调度开销增大;双卡分摊后峰值降至 13G 左右,彻底释放了计算单元的潜能。
        3. 极高的“计算掩盖通信”效率:像 MiniMax 这样的大视频序列(数万 token 级别),每一层的矩阵计算极其庞大,通过 PCIe 搬运中间结果的开销相比之下非常小(步时增幅仅 1-4% 左右),因此 PCIe 完全不会成为拖后腿的瓶颈。

        简单来说:虽然采样步数不能并行,但单步内的矩阵计算和算力被双卡并行解放了!

        terryT 1 条回复 最后回复
        0
        • Tony WangT Tony Wang

          @bunsei 了解了, 我问了AI,

          下面是AI的回答:

          关于“显存够用时,双卡 TP 为什么还能实现每步提速(2.27x)”的核心逻辑可以总结为以下三点:

          1. 算力与矩阵乘法并行(空间换时间):虽然扩散模型的时间步(采样步数)必须串行迭代,但在单个时间步内部,双卡 TP(张量并行)将原本由单卡独扛的 DiT 模型层计算拆分到了两张卡上,实现了算力叠加,单步耗时直接腰斩。
          2. 规避“显存边缘化”引发的性能惩罚:从实测数据看,单卡时峰值显存被压榨到了 24016 MiB(逼近物理极限),容易导致硬件内部调度开销增大;双卡分摊后峰值降至 13G 左右,彻底释放了计算单元的潜能。
          3. 极高的“计算掩盖通信”效率:像 MiniMax 这样的大视频序列(数万 token 级别),每一层的矩阵计算极其庞大,通过 PCIe 搬运中间结果的开销相比之下非常小(步时增幅仅 1-4% 左右),因此 PCIe 完全不会成为拖后腿的瓶颈。

          简单来说:虽然采样步数不能并行,但单步内的矩阵计算和算力被双卡并行解放了!

          terryT
          terryT
          terry
          易有太极
          编写于 最后由 编辑
          #88

          @Tony-Wang 我哥你特么别用AI,严禁这么搞,大家都用AI助手,这里就完蛋了。

          油管:https://www.youtube.com/@抡锤者

          1 条回复 最后回复
          0
          • Tony WangT
            Tony WangT
            Tony Wang
            易有太极
            编写于 最后由 Tony Wang 编辑
            #89

            @terry

            放心, 绝对没有用AI 来操作论坛.

            只是告诉Agent, 这个帖子网址, 让它分析一下, 给我生成个回答, 只是我先让它报身份了. 然后我是自己粘贴到这里的.

            而且我发帖有个规则, 缺省都是自己手敲. AI回答的部分, 都会跟在 "以下是AI的回答:", 或者"以下由AI生成"...

            我建议大家也用这个规则, 一定要把AI生成的部分, 专门标识出来.

            1 条回复 最后回复
            0
            • Tony WangT
              Tony WangT
              Tony Wang
              易有太极
              编写于 最后由 编辑
              #90

              完全禁止AI生成的内容, 不是很现实, 但是必须要有标识.
              另外可以让AI Agent读, 抄作业, 做一些分析之类的. 但是严禁用AI 自动去巡检阅读, 自动post之类的动作.
              我的建议, 可以大家一起完善一下这个规则.

              1 条回复 最后回复
              0
              • Tony WangT
                Tony WangT
                Tony Wang
                易有太极
                编写于 最后由 编辑
                #91

                @terry 为了防止大家只看一部分, 我把内容改掉了. 避免造成不好的榜样.

                1 条回复 最后回复
                1
                • ,terryT terry 引用了 此主题
                • E
                  E
                  Enigma
                  体面乡绅 硕果累累
                  编写于 最后由 编辑
                  #92

                  抄 2582 的第二组:同一套"宇宙公交站"素材,双 7900XTX(自建 TP2)和单张 4080S 各跑一遍全程

                  0x00 缘起

                  楼主第二组用的"宇宙公交站"素材包(5 张角色图 + 一段动作参考视频 + 原声),我们拿过来按同口径重跑了全程:832×480(0.399MP)、124 帧、20 步 Euler、seed 145、不用加速 LoRA、参考条件与初始噪声共享。手上正好有两台机器,一台 AMD 双卡、一台 N 卡单卡,分段计时都记下来了。

                  先说结论:单张 4080S 比我们的双 7900XTX 快 2.04 倍(10 分 36 秒 vs 5 分 12 秒)。

                  0x01 两台机器的配置

                  机器 A(AMD 双卡,自建 TP2):

                  项目 配置
                  主板 / CPU ASRock X570 ACE / Ryzen 5 3500X(6C6T,无 SMT)
                  内存 94 GB
                  GPU 2 × RX 7900 XTX 24G,拆 x8/x8(实测各 14.2 GB/s,不因第二张卡掉速)
                  P2P 开(BIOS 开 IOMMU + 内核 iommu=pt)
                  系统 / 内核 Ubuntu 24.04.5 / 7.0.0-38-generic
                  ROCm / torch ROCm 7.2.3 / torch 2.12.1+rocm7.2(hip 7.2.53211)
                  ComfyUI 0.39.0
                  跑法 自建 TP2 脚本:每卡装半宽模型,100 个行并行层自己做 int8(_int_mm),列并行保留 ck 算子,--use-ck-attention

                  机器 B(N 卡单卡,标准路径):

                  项目 配置
                  CPU Ryzen 7 9700X(8C16T)
                  内存 92 GB
                  GPU RTX 4080 SUPER 32G
                  驱动 / 内核 595.99.02 / 7.0.0-38-generic
                  CUDA / torch CUDA 13.0 / torch 2.13.0+cu130
                  ComfyUI 0.39.0
                  跑法 上游 h3_comfy_benchmark.py,标准单卡路径,不加任何补丁

                  两边用的是同一个 checkpoint 文件:minimax_h3_ref2va_pruned_fp8_scaled.safetensors,20,958,205,608 字节,日期都一样。

                  0x02 成绩

                  段 双 7900XTX(TP2) 单张 4080S 楼主(双 R9700,Radiance 原生)
                  预处理(VAE 编码 + Qwen3-VL-32B 条件) 141 s 38 s ~5 分钟
                  采样 20 步 438.3 s(20.4 → 22.8 s/步) 255.8 s(12.40 s/步) —
                  VAE 解码 + 合成 33 s 12.0 s —
                  合计 636 s = 10 分 36 秒 312 s = 5 分 12 秒 15 分 35 秒

                  预处理这一段两台差了近 4 倍(141s vs 38s),跟楼主账上"预处理走单卡 PyTorch 路径"那个观察是同一件事,只是 N 卡那边明显更不吃这一项。

                  0x03 逐步曲线(这个差别挺有意思)

                  机器 A(双 XTX)20 步,单位秒:

                  23.05, 20.39, 20.58, 20.69, 20.84, 20.89, 21.12, 21.38, 21.56, 21.73,
                  21.86, 22.03, 22.11, 22.18, 22.29, 22.37, 22.49, 22.56, 22.64, 22.81
                  

                  首步之后单调上升,到第 20 步涨了 12%,不是随机抖动,是热/功耗漂移。

                  机器 B(4080S)20 步全在 12.399 ~ 12.408 之间,基本一条直线。

                  0x04 一个必须说清的事:同 seed 不跨后端复现

                  两台出来的不是同一个画面——两段成片对拍 PSNR 只有 15.6 dB。seed 一样、素材一样、checkpoint 一样,但采样路径的数值实现不同(我们 TP2 是自建 int8 行并行,N 卡是标准 fp8 路径),20 步下来就分叉了。

                  所以上面那张表只能比时间,不能比画质;两台各自的效果请各自看成片。

                  0x05 为什么单卡 4080S 反而快(推断,没逐项隔离)

                  按可能的贡献排序:

                  1. FP8:checkpoint 是 fp8_scaled。Ada 有 FP8 Tensor Core,gfx1100 没有 FP8 硬件,只能反量化成 fp16/bf16 再算。
                  2. TP 通信:我们每个 block 一次 all_reduce(100 个行并行层),走 PCIe x8/x8(各 14.2 GB/s)。单卡完全没有这笔开销。
                  3. 主机差一档:3500X 6C6T 对 9700X 8C16T。
                  4. 热漂移:XTX 这对 +12%,4080S 全程死平。

                  要坐实的话,下一步是在 8.147 上把 TP2 的 all_reduce 单独计时,再用同一份 int8 版 ref2va 跑一遍,把"FP8"和"通信"两项拆开。现在这版结论请当测量结果 + 未验证的解释看。

                  0x06 顺手踩到的两个坑,抄的人可以直接避开

                  第一个:VAE 解码 OOM,根因不是显存不够,是没带 --use-ck-attention。 24G 卡上解 832×480×148 帧会炸,PyTorch 只报了 4.87GB 但卡上只剩 30MB——VAE 解码器里的注意力块用朴素实现,256×256 的 tile 就是 6.5 万 token 的注意力矩阵,20GB 是它吃掉的。带上 ck-attention 之后解码 19.4 秒。我们试过小 tile(256→128)、时间块切小、按时间/空间切两半、MIOpen FIND_MODE、expandable_segments、强制/不强制全载入——全部无效,别浪费时间。

                  第二个:跑过被 OOM 杀掉的 GPU 进程之后,amdgpu 会扣住主机内存不还。 我们这边连续几个解码进程被杀之后,空载 37GB 不在任何进程、不在缓存、不在 slab、不在 GTT 里,模型加载直接开始疯狂换页(302 秒还没起来)。modprobe -r amdgpu 的瞬间 MemFree 从 62.2GB 跳到 97.4GB,重新起就是 42 秒。双卡跑完 GPU 任务,起模型之前先看一眼 MemAvailable,不够就把驱动卸了重载(前提是别让桌面会话占着卡,否则卸不掉)。

                  BunseiB 1 条回复 最后回复
                  0
                  • E Enigma

                    抄 2582 的第二组:同一套"宇宙公交站"素材,双 7900XTX(自建 TP2)和单张 4080S 各跑一遍全程

                    0x00 缘起

                    楼主第二组用的"宇宙公交站"素材包(5 张角色图 + 一段动作参考视频 + 原声),我们拿过来按同口径重跑了全程:832×480(0.399MP)、124 帧、20 步 Euler、seed 145、不用加速 LoRA、参考条件与初始噪声共享。手上正好有两台机器,一台 AMD 双卡、一台 N 卡单卡,分段计时都记下来了。

                    先说结论:单张 4080S 比我们的双 7900XTX 快 2.04 倍(10 分 36 秒 vs 5 分 12 秒)。

                    0x01 两台机器的配置

                    机器 A(AMD 双卡,自建 TP2):

                    项目 配置
                    主板 / CPU ASRock X570 ACE / Ryzen 5 3500X(6C6T,无 SMT)
                    内存 94 GB
                    GPU 2 × RX 7900 XTX 24G,拆 x8/x8(实测各 14.2 GB/s,不因第二张卡掉速)
                    P2P 开(BIOS 开 IOMMU + 内核 iommu=pt)
                    系统 / 内核 Ubuntu 24.04.5 / 7.0.0-38-generic
                    ROCm / torch ROCm 7.2.3 / torch 2.12.1+rocm7.2(hip 7.2.53211)
                    ComfyUI 0.39.0
                    跑法 自建 TP2 脚本:每卡装半宽模型,100 个行并行层自己做 int8(_int_mm),列并行保留 ck 算子,--use-ck-attention

                    机器 B(N 卡单卡,标准路径):

                    项目 配置
                    CPU Ryzen 7 9700X(8C16T)
                    内存 92 GB
                    GPU RTX 4080 SUPER 32G
                    驱动 / 内核 595.99.02 / 7.0.0-38-generic
                    CUDA / torch CUDA 13.0 / torch 2.13.0+cu130
                    ComfyUI 0.39.0
                    跑法 上游 h3_comfy_benchmark.py,标准单卡路径,不加任何补丁

                    两边用的是同一个 checkpoint 文件:minimax_h3_ref2va_pruned_fp8_scaled.safetensors,20,958,205,608 字节,日期都一样。

                    0x02 成绩

                    段 双 7900XTX(TP2) 单张 4080S 楼主(双 R9700,Radiance 原生)
                    预处理(VAE 编码 + Qwen3-VL-32B 条件) 141 s 38 s ~5 分钟
                    采样 20 步 438.3 s(20.4 → 22.8 s/步) 255.8 s(12.40 s/步) —
                    VAE 解码 + 合成 33 s 12.0 s —
                    合计 636 s = 10 分 36 秒 312 s = 5 分 12 秒 15 分 35 秒

                    预处理这一段两台差了近 4 倍(141s vs 38s),跟楼主账上"预处理走单卡 PyTorch 路径"那个观察是同一件事,只是 N 卡那边明显更不吃这一项。

                    0x03 逐步曲线(这个差别挺有意思)

                    机器 A(双 XTX)20 步,单位秒:

                    23.05, 20.39, 20.58, 20.69, 20.84, 20.89, 21.12, 21.38, 21.56, 21.73,
                    21.86, 22.03, 22.11, 22.18, 22.29, 22.37, 22.49, 22.56, 22.64, 22.81
                    

                    首步之后单调上升,到第 20 步涨了 12%,不是随机抖动,是热/功耗漂移。

                    机器 B(4080S)20 步全在 12.399 ~ 12.408 之间,基本一条直线。

                    0x04 一个必须说清的事:同 seed 不跨后端复现

                    两台出来的不是同一个画面——两段成片对拍 PSNR 只有 15.6 dB。seed 一样、素材一样、checkpoint 一样,但采样路径的数值实现不同(我们 TP2 是自建 int8 行并行,N 卡是标准 fp8 路径),20 步下来就分叉了。

                    所以上面那张表只能比时间,不能比画质;两台各自的效果请各自看成片。

                    0x05 为什么单卡 4080S 反而快(推断,没逐项隔离)

                    按可能的贡献排序:

                    1. FP8:checkpoint 是 fp8_scaled。Ada 有 FP8 Tensor Core,gfx1100 没有 FP8 硬件,只能反量化成 fp16/bf16 再算。
                    2. TP 通信:我们每个 block 一次 all_reduce(100 个行并行层),走 PCIe x8/x8(各 14.2 GB/s)。单卡完全没有这笔开销。
                    3. 主机差一档:3500X 6C6T 对 9700X 8C16T。
                    4. 热漂移:XTX 这对 +12%,4080S 全程死平。

                    要坐实的话,下一步是在 8.147 上把 TP2 的 all_reduce 单独计时,再用同一份 int8 版 ref2va 跑一遍,把"FP8"和"通信"两项拆开。现在这版结论请当测量结果 + 未验证的解释看。

                    0x06 顺手踩到的两个坑,抄的人可以直接避开

                    第一个:VAE 解码 OOM,根因不是显存不够,是没带 --use-ck-attention。 24G 卡上解 832×480×148 帧会炸,PyTorch 只报了 4.87GB 但卡上只剩 30MB——VAE 解码器里的注意力块用朴素实现,256×256 的 tile 就是 6.5 万 token 的注意力矩阵,20GB 是它吃掉的。带上 ck-attention 之后解码 19.4 秒。我们试过小 tile(256→128)、时间块切小、按时间/空间切两半、MIOpen FIND_MODE、expandable_segments、强制/不强制全载入——全部无效,别浪费时间。

                    第二个:跑过被 OOM 杀掉的 GPU 进程之后,amdgpu 会扣住主机内存不还。 我们这边连续几个解码进程被杀之后,空载 37GB 不在任何进程、不在缓存、不在 slab、不在 GTT 里,模型加载直接开始疯狂换页(302 秒还没起来)。modprobe -r amdgpu 的瞬间 MemFree 从 62.2GB 跳到 97.4GB,重新起就是 42 秒。双卡跑完 GPU 任务,起模型之前先看一眼 MemAvailable,不够就把驱动卸了重载(前提是别让桌面会话占着卡,否则卸不掉)。

                    BunseiB
                    BunseiB
                    Bunsei
                    王侯将相
                    编写于 最后由 Bunsei 编辑
                    #93

                    @Enigma 提速的关键是合理的内存调度,我针对这个设计了一个新的针对MINIMAX H3的引擎,ComfyUI 自定义节点+IPC方式工作,内部集成了Open-H3-Regenerate-2K 和 SeedVR2的加速。目前vibe了一半,但手头上没有RDNA3的卡,如果后面咱们方便的话能不能在咱们的设备上测试一下?

                    E 1 条回复 最后回复
                    0
                    • BunseiB Bunsei

                      @Enigma 提速的关键是合理的内存调度,我针对这个设计了一个新的针对MINIMAX H3的引擎,ComfyUI 自定义节点+IPC方式工作,内部集成了Open-H3-Regenerate-2K 和 SeedVR2的加速。目前vibe了一半,但手头上没有RDNA3的卡,如果后面咱们方便的话能不能在咱们的设备上测试一下?

                      E
                      E
                      Enigma
                      体面乡绅 硕果累累
                      编写于 最后由 Enigma 编辑
                      #94

                      @Bunsei 说:

                      @Enigma 提速的关键是合理的内存调度,我针对这个设计了一个新的针对MINIMAX H3的引擎,ComfyUI 自定义节点+IPC方式工作,内部集成了Open-H3-Regenerate-2K 和 SeedVR2的加速。目前vibe了一半,但手头上没有RDNA3的卡,如果后面咱们方便的话能不能在咱们的设备上测试一下?

                      可以的啊,你把代码给我,我帮你测。有个平台的3500X CPU太弱,可能很影响成绩

                      BunseiB 1 条回复 最后回复
                      0
                      • E Enigma

                        @Bunsei 说:

                        @Enigma 提速的关键是合理的内存调度,我针对这个设计了一个新的针对MINIMAX H3的引擎,ComfyUI 自定义节点+IPC方式工作,内部集成了Open-H3-Regenerate-2K 和 SeedVR2的加速。目前vibe了一半,但手头上没有RDNA3的卡,如果后面咱们方便的话能不能在咱们的设备上测试一下?

                        可以的啊,你把代码给我,我帮你测。有个平台的3500X CPU太弱,可能很影响成绩

                        BunseiB
                        BunseiB
                        Bunsei
                        王侯将相
                        编写于 最后由 编辑
                        #95

                        @Enigma CPU 这不是问题😳

                        E 1 条回复 最后回复
                        0
                        • BunseiB Bunsei

                          @Enigma CPU 这不是问题😳

                          E
                          E
                          Enigma
                          体面乡绅 硕果累累
                          编写于 最后由 编辑
                          #96

                          @Bunsei 说:

                          @Enigma CPU 这不是问题😳

                          好,需要测喊我

                          1 条回复 最后回复
                          0
                          • A applejuice

                            @shawn-shen 7k prefill 吗?

                            shawn shenS
                            shawn shenS
                            shawn shen
                            编写于 最后由 编辑
                            #97

                            @applejuice 8300pf,200de
                            image.jpeg

                            A 1 条回复 最后回复
                            0
                            • hanber121H
                              hanber121H
                              hanber121
                              编写于 最后由 编辑
                              #98

                              radiance更新到1.14.0可以支持ref2va啦~

                              1 条回复 最后回复
                              0
                              • shawn shenS shawn shen

                                @applejuice 8300pf,200de
                                image.jpeg

                                A
                                A
                                applejuice
                                王侯将相
                                编写于 最后由 编辑
                                #99

                                @shawn-shen amd 卡完爆 nvidia 卡

                                1 条回复 最后回复
                                0
                                • hanber121H
                                  hanber121H
                                  hanber121
                                  编写于 最后由 编辑
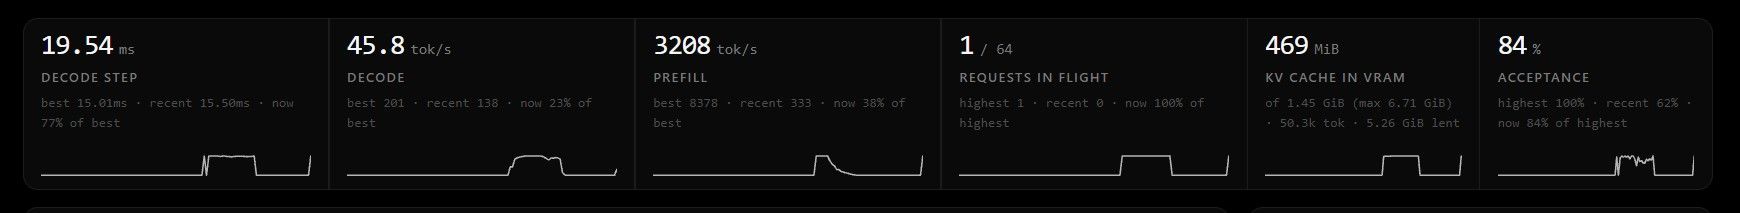
                                  #100

                                  @bunsei 大佬,今天我用radiance更新的ref2va模式测试r9700 TP2和朋友的一张5090对比,有点震惊了,速度竟然是5090的将近两倍,同样的素材包/分辨率/时常,这有点离谱了。我不知道是这引擎的功劳,还是卡的能力,但是这个结果确实有点意外了。而且双r9700用480p最多能生成14.38秒的长度,768p是13.67秒。5090只有10秒左右显存就占满了,再长要用卸载方案,时常应该会大增,我还没试。
                                  但是目前raidance的生成质量感觉不如comfyui,有的时候会重复多个主体,有的时候会有重影,这类小问题不知道会不会修复完善,毕竟社区基础比comfyui弱的多

                                  BunseiB terryT 3 条回复 最后回复
                                  1
                                  • hanber121H hanber121

                                    @bunsei 大佬,今天我用radiance更新的ref2va模式测试r9700 TP2和朋友的一张5090对比,有点震惊了,速度竟然是5090的将近两倍,同样的素材包/分辨率/时常,这有点离谱了。我不知道是这引擎的功劳,还是卡的能力,但是这个结果确实有点意外了。而且双r9700用480p最多能生成14.38秒的长度,768p是13.67秒。5090只有10秒左右显存就占满了,再长要用卸载方案,时常应该会大增,我还没试。
                                    但是目前raidance的生成质量感觉不如comfyui,有的时候会重复多个主体,有的时候会有重影,这类小问题不知道会不会修复完善,毕竟社区基础比comfyui弱的多

                                    BunseiB
                                    BunseiB
                                    Bunsei
                                    王侯将相
                                    编写于 最后由 Bunsei 编辑
                                    #101

                                    @hanber121 你说的这个问题我有注意到,我没啥开发能力都是gpt干的,这个问题GPT目前在处理。

                                    image.jpeg
                                    image.jpeg

                                    1 条回复 最后回复
                                    0
                                    • hanber121H hanber121

                                      @bunsei 大佬,今天我用radiance更新的ref2va模式测试r9700 TP2和朋友的一张5090对比,有点震惊了,速度竟然是5090的将近两倍,同样的素材包/分辨率/时常,这有点离谱了。我不知道是这引擎的功劳,还是卡的能力,但是这个结果确实有点意外了。而且双r9700用480p最多能生成14.38秒的长度,768p是13.67秒。5090只有10秒左右显存就占满了,再长要用卸载方案,时常应该会大增,我还没试。
                                      但是目前raidance的生成质量感觉不如comfyui,有的时候会重复多个主体,有的时候会有重影,这类小问题不知道会不会修复完善,毕竟社区基础比comfyui弱的多

                                      BunseiB
                                      BunseiB
                                      Bunsei
                                      王侯将相
                                      编写于 最后由 编辑
                                      #102

                                      @hanber121 你让你的AI把加速LoRA去掉,使用官方的20步 +res_multistep+simple 再试试看?

                                      hanber121H 1 条回复 最后回复
                                      0
                                      • BunseiB Bunsei

                                        @hanber121 你让你的AI把加速LoRA去掉,使用官方的20步 +res_multistep+simple 再试试看?

                                        hanber121H
                                        hanber121H
                                        hanber121
                                        编写于 最后由 编辑
                                        #103

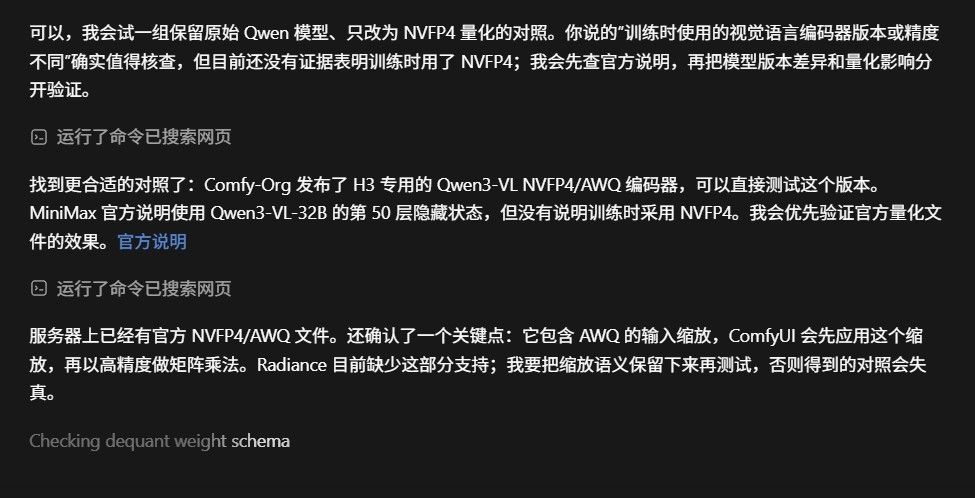
                                        @Bunsei 好的,正在跑。另外我发现为什么radiance r9700比comfyui 5090快那么多了,radiance似乎会把所有参考图参考视频转为256x256, 而comfyui是按照256x256切分多块,所以comfyui相当于用了参考图像的所有像素信息,而radiance损失了大部分。我不知道这是不是生成质量比comfyui差的原因。而且radiance的256x256是没有档位修改的,要改只能改源码
                                        BunseiB 1 条回复 最后回复
                                        0
                                        • hanber121H hanber121

                                          @Bunsei 好的,正在跑。另外我发现为什么radiance r9700比comfyui 5090快那么多了,radiance似乎会把所有参考图参考视频转为256x256, 而comfyui是按照256x256切分多块,所以comfyui相当于用了参考图像的所有像素信息,而radiance损失了大部分。我不知道这是不是生成质量比comfyui差的原因。而且radiance的256x256是没有档位修改的,要改只能改源码
                                          BunseiB
                                          BunseiB
                                          Bunsei
                                          王侯将相
                                          编写于 最后由 编辑
                                          #104

                                          @hanber121 我这儿让gpt 核对一下试试。我不确定是不是我这份代码在之前的时候已经改过了。

                                          terryT 1 条回复 最后回复
                                          1

                                          你好!看起来您对这段对话很感兴趣,但您还没有一个账号。

                                          厌倦了每次访问都刷到同样的帖子?您注册账号后,您下次访问时都将自动回到上次浏览的位置,并可选择接收新回复的通知(通过电子邮件或推送通知)。您还可以收藏帖子、为帖子点赞,以此向其他社区成员表达您的感谢。

                                          有了你的建议,这篇帖子会更精彩哦 💗

                                          注册 登录
                                          回复
                                          • 在新帖中回复
                                          登录后回复
                                          • 从旧到新
                                          • 从新到旧
                                          • 最多赞同


                                          • 登录

                                          • 登录或注册以进行搜索。
                                          • 第一个帖子
                                            最后一个帖子
                                          0
                                          • 版块
                                          • 最新
                                          • 标签
                                          • 热门
                                          • 用户
                                          • 群组