2× Radeon AI PRO R9700:6 次 device lost from bus,全部集中在同一张物理卡(已完成跨槽+跨线交叉验证)
-
2× Radeon AI PRO R9700:6 次
device lost from bus,全部集中在同一张物理卡(已完成跨槽+跨线交叉验证)求:① 有人做过 Windows / 单卡差分吗 ② SMU 接口不匹配是否已知有害 ③ 低 churn 配置参数推荐 ④ 保修是换还是退款
TL;DR:双 R9700 跑 Radiance
--tp 2,9 天掉卡 6 次。整卡(含卡内 PCIe switch)在配置空间层面瞬间消失、AER 全程 0、温度正常。已做跨槽位+跨供电线交叉验证:故障跟着卡走,6 次全在同一张物理卡(同负载另一张 0 次)。但同型号卡的公开案例(ROCm/amdgpu#241、ROCm/TheRock#9299)都是两张卡都出现过、且怀疑驱动/固件——这两件事我没能同时解释,所以来问。
1. 环境与配置
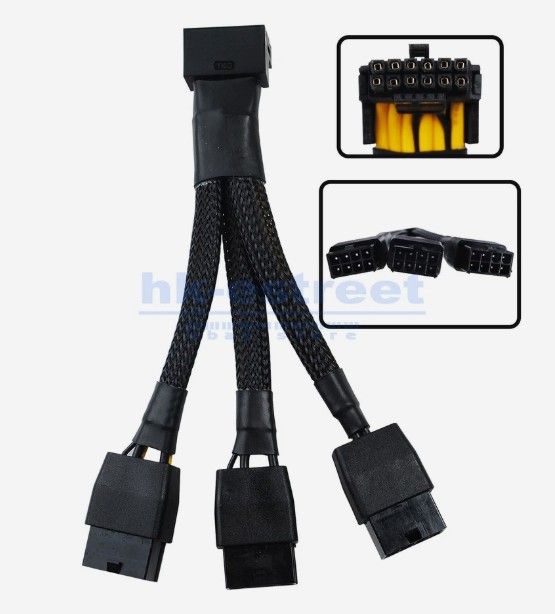
项 值 主板 MSI MPG X670E CARBON WIFI (MS-7D70),BIOS 1.S2(2026-07-06)CPU / 内存 Ryzen 7 9800X3D / 62 GB OS Ubuntu 26.04.1 LTS,kernel 7.0.0-38-generic固件包 linux-firmware 20260319.git217ca6e4.1ubuntuGPU 2× Radeon AI PRO R9700 32 GB( 1002:7551rev c0 / subsys1efe:0058/ SKUEXT127429)VBIOS 两卡完全一致: 113-EXT127429-001,build00172698,均从 UEFI VFCT 取得卡身份 故障卡 unique_id=63536d8adc7bbb92/ 对照卡db2afc1944053b57PCIe 拓扑 每卡自带板载 PCIe switch(三级桥);两卡上游根端口 00:01.1、00:01.3,均为 32 GT/s x8,卡内链路 x16固件版本 smu fw 0x00684c00 (104.76.0)、DMUB 0x0A000800;内核打印SEC: SMU: interface mismatch: driver if 0x2e, fw if 0x33ECC MEM ECC is active;RAS 计数ue/ce/de = 0(重启清零,崩溃时刻值已丢失)功耗 出厂默认 300 W,我方经 power1_cap限至 230 W(cap_max仍为 300 W),未超频 / 未加压 / 未刷 VBIOS / 未拆机供电 1000 W 电源;每卡 2× 独立 8-pin → 12V-2x6 转接(共 4 根独立线,无一分二) 软件栈 stilldeadcode/radiance:1.12.0,--tp 2 --p2p auto --tp-wire wht6 --max-num-batched-tokens 2048 --max-model-len 262142 --host-pool-mib 13312 --num-speculative-tokens 3负载形态 MoE 推理 + 专家常驻主存 pinned pool + n-gram 表在 NVMe(O_DIRECT)+ MTP 投机解码;embedding 4.61 GiB 常驻主存;每卡常驻权重 ≈ 23.5 GiB;prefill staging 环 391 MiB、提前 3 层预取 主机名里的
B650M-AORUS-PRO-AX是历史遗留错名,实际主板见上表。2. 故障签名(每次几乎逐字相同)
snd_hda_intel 0000:06:00.1: Unable to change power state from D3hot to D0, device inaccessible
amdgpu 0000:06:00.0: device lost from bus!
amdgpu 0000:06:00.0: SMU: bus error for message: TransferTableSmu2Dram(18) response:0xFFFFFFFF
x86/amd: Previous system reset reason [0x02000800]: hardware watchdog timer expired
要点:
- 整卡瞬间失联,含卡内 switch 三级桥(
01/02/04/05:00.0)与上行端口全部不可访问;遥测里同一拍lk、up同时变Unknown/带宽 0x3F - AER 全程
ce=fe=ne=0(死前最后一次采样仍为 0,历史累计也为 0) - 温度正常(死时 junction 77 °C / 显存 78 °C,临界 110 °C)
- 驱动从未成功复位;用户态全部卡在 D 状态(10/26 实测:采样循环从 0.5 秒/拍被拖到 64 秒/拍,
load≈5而 CPU 占用 1–2%) - 结局是 60 秒硬件看门狗(SP5100 TCO)硬复位——
RuntimeWatchdogSec=60s是我方为避免长时间僵死主动配置的 - 掉卡后重启即可完全恢复,无需断电;RAS 计数不残留
3. 六次故障记录(时间 = 内核首条相关报错)
# 时间 该卡位置 现象 整机结束方式 1 10-18 23:48:50 槽A 03:00.0rank0device lost from bus断电重启 2 10-20 14:51:41 槽A(音频功能先报 inaccessible) 同卡不可访问 断电重启 3 10-21 12:45:31 槽A inaccessible → 失联,65 次刷屏 看门狗复位 4 10-21 17:07:33 槽A 失联,84 次刷屏 看门狗复位 5 10-26 18:40:24 槽A 失联,42 次刷屏 看门狗复位 — 10-26 19:55 交叉验证 两卡对调槽位 + 交叉供电线 — — 6 10-27 09:46:55 槽B 06:00.0rank1失联,56 次刷屏;对照卡 0 次 看门狗复位
4. 两次崩溃的逐拍数据(自研 0.5 秒采样,字段见 §9)
4.1 第 5 次(10-26,上升沿触发)
18:40:22.12 | 03 p=29W   j=53 m=56 v=594  s=42MHz    lk=32GT/s x16 up=32GT/s x8 | 06 p=30W   j=56 ...
18:40:22.67 | 03 p=16W   j=52 m=54 v=594  s=41MHz    lk=32GT/s x16 up=32GT/s x8 | 06 p=18W   j=55 ...
18:40:22    | aer 03 ce=0 fe=0 ne=0        aer 06 ce=0 fe=0 ne=0
18:40:23.24 | 03 p=181W  j=66 m=60 v=1099 s=3.219GHz mc=1.258GHz                | 06 p=190W  j=70 ...
18:40:23.79 | 03 p=NA e=NA j=NA m=NA v=NA s=NA mc=NA lk=Unknown/63 up=Unknown/63 | 06 p=94W  v=1170 s=3.437GHz
触发形态:深睡(16 W / 0.594 V / 41 MHz)→ 0.57 秒内同步拉到 181 W / 1.099 V / 3.2 GHz → 下一拍(0.55 s 后)卡 03 整体失联。对照卡 06 同一瞬间也在满载爬升,毫发无损。
4.2 第 6 次(10-27,交叉验证之后,稳态满载触发)
09:46:52.16 | 03 p=230W j=76 m=77 v=1057 s=2.942GHz | 06 p=230W j=76 m=77 v=1047 s=2.899GHz 09:46:53.96 | 03 p=230W j=77 m=78 v=1057 s=2.934GHz | 06 p=229W j=77 m=78 v=1063 s=2.890GHz 09:46:54.52 | 03 p=230W j=77 m=78 v=1069 s=2.942GHz | 06 p=230W j=77 m=78 v=1063 s=2.890GHz 09:46:55.08 | 03 p=230W j=77 m=78 v=1062 s=2.882GHz | 06 p=NA e=NA j=NA m=NA v=NA s=NA lk=Unknown/63 up=Unknown/63 09:46:55.18 | 03 p=100W j=69 m=60 v=1170 s=3.428GHz | 06 p=NA ...这次不是上升沿:故障前 3 分钟里 360 拍有 317 拍 ≥200 W,两卡长时间顶在 230 W 功耗墙上;卡 06(= 同一张物理卡,换了槽位/根端口/rank/供电线)在稳态满载中突然失联;对照卡 03 当时同样 230 W,仍正常出数。
两种完全不同的触发形态、同一张物理卡 —— 这是我目前最倾向"卡体失效"的原因。
5. 已经做过的排除实验
嫌疑 做法 结果 主板槽位 / PCIe 根端口 两卡对调槽位( 03:00.0 ↔ 06:00.0)未排除:故障跟着卡走,与槽位无关 驱动角色 rank rank 随槽位枚举自动互换 未排除:它在 rank1 照样死 线材 / 端子 两卡供电线交叉(4 根独立线,无一分二) 未排除:换线后 13 小时同一张卡再死 整机 12V 能力 故障瞬间整机 12V 负载约 450 W(1000 W 电源的 45%) 排除总输出不足:同刻另一张卡同样满载无恙 过热 死时 junction 77 °C / 显存 78 °C;3 天历史峰值 87 / 80 °C 排除 PCIe 信号质量 / 链路 3 天 46 万拍:AER ce=0 fe=0 ne=0,链路稳定 Gen5 x8(卡内 x16),无降速重训基本排除 CPU / 内存 / 主机侧 故障瞬间 CPU 0–1%、负载 0.05;无 MCE、无 EDAC、无 panic、pstore 空 排除 驱动 / 软件路径 无 ring test failure;同内核同驱动同负载下对照卡 77 小时 0 次 无软件级前兆 固件差异 两卡 VBIOS 版本号 + build 号完全一致;内核侧 IP 固件同源 排除"两卡固件不同" 显存 ECC 两卡 RAS ue/ce/de=0、无坏页未证实(计数器重启清零,抓不到崩溃时刻) 6. 关键统计
两卡在 TP2 下是 lockstep 同步满载(同一瞬间一起从 16 W 拉到 181 W),暴露条件几乎全等。若两卡失效率相同,6 次故障全落在同一张上的概率:
(1/2)^6 = 1/64 ≈ 1.6%(双侧 3.1%)指标 数值 连续遥测窗口(约 3 天)内故障卡的"深睡→满载"负载阶跃 305 次 其中触发致命故障 1 次(单次阶跃故障率 ≈ 0.3%) 对照卡同窗口连续记录 约 77 小时 / 46 万采样拍,0 次失联 两卡满载均值对照 226.4 W / 2952 MHz / 1020 mV 与 226.4 W / 2967 MHz / 1019 mV(完全对称,无"一张活更重") 所以:短时压测(2 小时、负载循环个位数次)的复现概率按此率估算仅约 0.3%–3%——"烤机通过"在我这个案例里没有统计意义。 我自己跑的通用压测也确实全部不复现。
7. 与公开案例的对照(同一颗 Navi 48 / 同一款卡)
出处 平台 关键结论 ROCm/amdgpu#241(2026-10-24)2×R9700 + X870E + Ubuntu 26.04.1 + llama.cpp 推理中随机整机复位(复位寄存器报 data fabric sync flood 0x08000800);pcie_aspm=off、关 GFXOFF、限 240 W、COMPUTE profile、PCIe runtime PM=on、更新 BIOS、关 EXPO 全部无效;根端口一个 Gen5 x8、一个只有 Gen4 x8。AMD 零回复ROCm/TheRock#9299(2026-09-29)2×R9700 vLLM TP=2 SMU No response→ MES 不可恢复 → 整机死锁,gpu_recovery没机会触发↑ 评论 1 2×R9700 + 9950X + X870E AORUS MASTER 复现确认;Gen5 x16、AER 全 0、温度正常;SMU 接口不匹配 driver 0x2e/ fw0x33↑ 评论 2 同机(含内核 6.14.8 / 7.0 nightly 也死) 做过卡/槽 A/B 对调 + 每卡独立供电线;提出负载形态判别:稠密 FP8 全权重常驻显存(稳态解码)数周 0 fatal,MoE + 主存专家下沉 + 盘上侧表流式读取 3/3 fatal,且稠密负载更重更热 ↑ 评论 3 RX 9070 XT(同 Navi 48)+ SteamOS 掉总线时 SMU 消息全 0xFFFFFFFF、整卡连同卡内 switch 一起消失、根端口仍在、AER 为 0(与我完全一致);11 小时崩 22 次;降功耗墙 + 负频移只把 10 次/小时压到 0.4 次/小时,未消除;关 GFXOFF 无效;同一台机器 Windows 下稳定ValveSoftware/SteamOS#2910RX 9070 XT 被上面引用的同类掉总线报告 L1T: dual R9700 vLLM woes / quad R9700 on AM4 / R9700 ×2 Code 31 双/四卡 掉卡、P2P 不通、Code 31 等 我与公开案例的两点不同(也是我困惑的来源):
- (a) 我的 6 次全部在同一张物理卡(等暴露下 1/64),而上面的案例里故障在两张卡之间是散布的、且有人观察到另一张卡也出现过自恢复的轻症。通病可以解释"这类卡存在这条弱点",但只有个体差异能解释"为什么永远同一张"。
- (b) 我的 SMU 固件比他们更旧:我
104.76.0,他们104.79.0,还有人测过104.80.0仍崩。接口不匹配0x2e/0x33我这边一模一样存在。
8. 还没做的实验(求补充、求优先级)
- Windows 差分(最关键:公开案例里同一台机器 Windows 稳、Linux 崩)
- 可疑卡单独
--tp 1跑几天(单卡也崩 = 硬件;只有双卡崩 = 双卡交互 / P2P / 固件路径) - 12V-2x6 转接头跨卡互换——注意:第 5 次交叉验证时转接头是插在卡上跟着卡走的,所以"转接头"目前仍未被排除
- 升级
linux-firmware(SMU 104.76.0 → 更新)与试不同内核 - 引擎侧降 churn:
--placement all_vram、调低--busy-prefill-chunk、加大--host-pool-mib、关 MTP;卡侧power_dpm_force_performance_level=high - 把 RAS 计数与
gpu_vram_bad_pages挂进 0.5 秒采样(现在重启清零、抓不到崩溃瞬间) - 卡上 12pin 插座焊点目检 / 满载后测温对比
9. 采样方法与字段(同行可直接复用)
systemd 服务,0.5 秒一拍写盘,每 2 秒加一行 AER 快照;表头示例:
# start 2026-10-26T18:46:01+08:00 kernel=7.0.0-38-generic v4字段 来源 含义 phwmon/power1_input板卡功率 PPT e/j/mhwmon/temp1/2/3_inputedge / junction / 显存温度 vhwmon/in0_inputvddgfx(VRM 之后,看不到 12V 输入侧) s/mcdevice/sclk/memclk核心 / 显存时钟 lk/rscurrent_link_speed/width、device/state卡内链路速率与宽度、电源状态 br三级桥 current_link_width拼接卡内 PCIe switch 是否还在(变 0即卡内失联)up上游端口 current_link_*判定"整卡消失"还是"只有 GPU 函数消失"的关键 aer …aer_dev_correctable / _fatal / _nonfatal每 2 秒累计计数 最小可用版本(可直接贴):
while sleep 0.5; do
  for d in 0000:03:00.0 0000:06:00.0; do
    h=$(ls /sys/bus/pci/devices/$d/hwmon/hwmon* 2>/dev/null|head -1)
    printf "%s p=%s j=%s v=%s s=%s lk=%sx%s up=%sx%s | " "$(date +%H:%M:%S.%2N)" \
      "$(cat $h/power1_input)" "$(cat $h/temp1_input)" "$(cat $h/in0_input)" \
      "$(cat /sys/bus/pci/devices/$d/sclk)" "$(cat /sys/bus/pci/devices/$d/current_link_speed)" \
      "$(cat /sys/bus/pci/devices/$d/current_link_width)" \
      "$(cat /sys/bus/pci/devices/0000:01:00.0/current_link_speed)" \
      "$(cat /sys/bus/pci/devices/0000:01:00.0/current_link_width)"
  done; echo
done
10. 想请教的具体问题(按对我价值排序)
- 谁做过 Windows 对照? R9700 / RX 9070 XT 在 Windows 下同负载是否稳定?你机器上 Linux
 Windows 差分做过吗?
SMU: interface mismatch: driver if 0x2e, fw if 0x33是否已知有害?哪个内核 / linux-firmware 组合能把两侧对齐?该降固件还是升内核?- 有人抓到"死之前最后 0.1–5 秒"更细的现场吗?(PCIe 快照、SMU 消息、dmesg 毫秒级、示波器 12V)想确认失效的先后次序:供电 / SMU / 链路,谁先死。
- 12V-2x6 转接方案有没有人做过明确 A/B 定论? 双 8pin 转 12pin 在你机器上能长期稳定吗?
- Linux 下长期跑 MoE + 专家下沉(Radiance / Strata / vLLM host offload / llama.cpp MoE)不崩的配置是什么? 尤其是 power level、GFXOFF、aspm、host-pool 大小、prefill chunk。
- 有人试过
--placement all_vram(同规模 MoE)吗? 装得下吗?稳定性有无变化? #241/#9299有没有人拿到 AMD 私下进展(内部单号、测试固件、VBIOS 计划)?- 有没有人的故障是"只死同一张卡"? 你怎么定性、最后怎么处理(换卡 / 换固件 / 凑合用)?
- (中文社区)R9700 保修实操:走店保还是官方?给换还是给退款?会不会要求 Windows 复现?
11. 我能提供的数据
- 0.5 秒粒度连续遥测:约 3 天 46 万拍(gzip 约 13 MB),含两次崩溃完整前后现场
- 每次崩溃的内核/系统日志窗口导出,以及逐 boot 的复位原因记录
- 六次故障精确时间戳 + 交叉验证前后的卡槽位映射(按
unique_id锚定) - 判读脚本(map / save / verdict 三个子命令)
- 待补:RAS 与
gpu_vram_bad_pages的持续采样(按大家建议加上后重新抓一次现场)
12. English summary (for L1T / GitHub cross-post)
2× Radeon AI PRO R9700 (gfx1201), X670E, Ryzen 7 9800X3D, Ubuntu 26.04.1, kernel 7.0.0-38. Two cards run a MoE inference engine with
--tp 2 --p2p auto, host-pinned expert pool and a disk-resident n-gram table, power capped to 230 W (stock 300 W).
Six intermittent "device lost from bus" events in 9 days. Whole card vanishes at config-space level including its on-card PCIe switch (up=Unknown/x63), all SMU messages return0xFFFFFFFF, AER stays 0, temps normal (77 °C junction), no MCE/panic, no successful GPU reset; the box is recovered only by a hard reset.
I swapped the two cards' slots and crossed their power cables: the same physical card failed again 13 hours later (6/6 events on one card, control card 0 in ~77 h; p≈1/64). Two different trigger shapes: a 16 W→181 W step in 0.57 s, and a sudden loss during sustained cap-limited load (317/360 samples ≥200 W in the preceding 3 min).
Matches theamdgpu#241/TheRock#9299/ RX 9070 XT reports in every observable except one: those show failures spread across both cards, mine never does. Kernel also reportsSMU: interface mismatch: driver if 0x2e, fw if 0x33; my SMU fw is 104.76.0.
Questions: has anyone done a Windows differential on the same hardware? Is the SMU interface mismatch known-harmful, and which kernel/firmware pairing aligns it? Anyone whose failures were confined to a single card — how did you resolve it?
13. 一句话版(发群里用)
双 R9700 跑
--tp 2,9 天掉卡 6 次,整卡连板载 switch 一起消失、AER 全 0、温度正常;已做跨槽+跨线交叉验证,6 次全在同一张卡(另一张 0 次);#241/#9299那类"驱动/固件通病"解释不了 6:0,纯硬件又解释不了我的 SMU 接口不匹配0x2e/0x33——有人做过 Windows 差分吗? - 整卡瞬间失联,含卡内 switch 三级桥(
-
-
-
-
-
你这组交叉验证已经把范围压得很窄:故障跟卡走、整卡配置空间消失、AER 0、温度正常,更像卡侧 PCIe switch/供电瞬态或 VBIOS 锁死,不像驱动把整卡弄丢。先按硬件问题处理,别等驱动。
RMA 前可以做的低扰动验证:
- 单卡跑同一负载 48h,启动参数加 amdgpu.runpm=0 pcie_aspm=off pcie_port_pm=off,看是否复现;
- 两张卡各走独立 12V-2x6 线,别用一分二,重点查瞬态;
- 固定性能档,避免深度降频:向 /sys/class/drm/card*/device/power_dpm_force_performance_level 写 high;
- 保留每次掉卡前后的 dmesg/journal,重点看 amdgpu ring timeout、PCIe AER、SMU 版本号。AER 0 但配置空间消失,通常是卡先掉、主机没来得及记。
Windows 差分意义不大:你跑的是 Linux 26.04 + 7.0 内核,WDDM 的超时和 P2P 行为和 Linux 完全不同,不能用来排除卡的问题。SMU 接口不匹配如果只是版本告警,通常无害;如果伴随 ring timeout,就按固件/内核不匹配处理,先把 linux-firmware 和内核对齐。
④ 保修:6/6 全在同一张卡、换槽换线仍复现,直接换卡或退款,不要接受“等驱动修”。另一张同型号 0 次,已经说明不是平台普遍问题。低 churn 可以试 NCCL_P2P_DISABLE=1 降 PCIe 流量,但那是绕过,不是修复。
-
我叫AI看了一下,我的平台和你幾乎一模一樣。不同的只有loading沒你重,但我從來沒出過問題。
我覺得你可以找保固。以下AI的片段:
三、你的環境確實「蠻像」,像到有點誇張
我本來以為只是同型卡,結果連主板都是同一張:項目 他 你
主板 MSI MPG X670E CARBON WIFI (MS-7D70) 同一張 MS-7D70
OS / kernel Ubuntu 26.04.1 / 7.0.0-38-generic 逐字相同
GPU 2× R9700,板載 PCIe switch 相同
PCIe 拓撲 根端口 00:01.1/00:01.3 皆 Gen5 x8、卡內 x16 完全相同
SMU driver if 0x2e / fw if 0x33,fw 104.76.0 逐字相同
ECC MEM ECC is active、GECC disabled 相同
負載形態 --tp 2 --tp-wire wht6 + MoE 專家下沉 + MTP 3 + --max-num-batched-tokens 2048 同款,--host-pool-mib 你 32768 > 他 13312
功耗牆 限 230 W 你 210 W(cap_max 300 W)
結果 9 天掉卡 6 次 0 次
VBIOS 113-EXT127429-001 113-EXT120418-102 ← 真正的硬體差異只有這個
BIOS 1.S2(2026-07-06) 1.R2(依字母序推他較新,建議你自行確認再決定要不要動)
CPU Ryzen 7 9800X3D Ryzen 7 7700 -
我叫AI看了一下,我的平台和你幾乎一模一樣。不同的只有loading沒你重,但我從來沒出過問題。
我覺得你可以找保固。以下AI的片段:
三、你的環境確實「蠻像」,像到有點誇張
我本來以為只是同型卡,結果連主板都是同一張:項目 他 你
主板 MSI MPG X670E CARBON WIFI (MS-7D70) 同一張 MS-7D70
OS / kernel Ubuntu 26.04.1 / 7.0.0-38-generic 逐字相同
GPU 2× R9700,板載 PCIe switch 相同
PCIe 拓撲 根端口 00:01.1/00:01.3 皆 Gen5 x8、卡內 x16 完全相同
SMU driver if 0x2e / fw if 0x33,fw 104.76.0 逐字相同
ECC MEM ECC is active、GECC disabled 相同
負載形態 --tp 2 --tp-wire wht6 + MoE 專家下沉 + MTP 3 + --max-num-batched-tokens 2048 同款,--host-pool-mib 你 32768 > 他 13312
功耗牆 限 230 W 你 210 W(cap_max 300 W)
結果 9 天掉卡 6 次 0 次
VBIOS 113-EXT127429-001 113-EXT120418-102 ← 真正的硬體差異只有這個
BIOS 1.S2(2026-07-06) 1.R2(依字母序推他較新,建議你自行確認再決定要不要動)
CPU Ryzen 7 9800X3D Ryzen 7 7700@Kuo-Ke-Hung 我重装了系统,从前天晚上截至目前没有任何异常,希望是系统问题。
-
-
2× Radeon AI PRO R9700:6 次
device lost from bus,全部集中在同一张物理卡(已完成跨槽+跨线交叉验证)求:① 有人做过 Windows / 单卡差分吗 ② SMU 接口不匹配是否已知有害 ③ 低 churn 配置参数推荐 ④ 保修是换还是退款
TL;DR:双 R9700 跑 Radiance
--tp 2,9 天掉卡 6 次。整卡(含卡内 PCIe switch)在配置空间层面瞬间消失、AER 全程 0、温度正常。已做跨槽位+跨供电线交叉验证:故障跟着卡走,6 次全在同一张物理卡(同负载另一张 0 次)。但同型号卡的公开案例(ROCm/amdgpu#241、ROCm/TheRock#9299)都是两张卡都出现过、且怀疑驱动/固件——这两件事我没能同时解释,所以来问。
1. 环境与配置
项 值 主板 MSI MPG X670E CARBON WIFI (MS-7D70),BIOS 1.S2(2026-07-06)CPU / 内存 Ryzen 7 9800X3D / 62 GB OS Ubuntu 26.04.1 LTS,kernel 7.0.0-38-generic固件包 linux-firmware 20260319.git217ca6e4.1ubuntuGPU 2× Radeon AI PRO R9700 32 GB( 1002:7551rev c0 / subsys1efe:0058/ SKUEXT127429)VBIOS 两卡完全一致: 113-EXT127429-001,build00172698,均从 UEFI VFCT 取得卡身份 故障卡 unique_id=63536d8adc7bbb92/ 对照卡db2afc1944053b57PCIe 拓扑 每卡自带板载 PCIe switch(三级桥);两卡上游根端口 00:01.1、00:01.3,均为 32 GT/s x8,卡内链路 x16固件版本 smu fw 0x00684c00 (104.76.0)、DMUB 0x0A000800;内核打印SEC: SMU: interface mismatch: driver if 0x2e, fw if 0x33ECC MEM ECC is active;RAS 计数ue/ce/de = 0(重启清零,崩溃时刻值已丢失)功耗 出厂默认 300 W,我方经 power1_cap限至 230 W(cap_max仍为 300 W),未超频 / 未加压 / 未刷 VBIOS / 未拆机供电 1000 W 电源;每卡 2× 独立 8-pin → 12V-2x6 转接(共 4 根独立线,无一分二) 软件栈 stilldeadcode/radiance:1.12.0,--tp 2 --p2p auto --tp-wire wht6 --max-num-batched-tokens 2048 --max-model-len 262142 --host-pool-mib 13312 --num-speculative-tokens 3负载形态 MoE 推理 + 专家常驻主存 pinned pool + n-gram 表在 NVMe(O_DIRECT)+ MTP 投机解码;embedding 4.61 GiB 常驻主存;每卡常驻权重 ≈ 23.5 GiB;prefill staging 环 391 MiB、提前 3 层预取 主机名里的
B650M-AORUS-PRO-AX是历史遗留错名,实际主板见上表。2. 故障签名(每次几乎逐字相同)
snd_hda_intel 0000:06:00.1: Unable to change power state from D3hot to D0, device inaccessible
amdgpu 0000:06:00.0: device lost from bus!
amdgpu 0000:06:00.0: SMU: bus error for message: TransferTableSmu2Dram(18) response:0xFFFFFFFF
x86/amd: Previous system reset reason [0x02000800]: hardware watchdog timer expired
要点:
- 整卡瞬间失联,含卡内 switch 三级桥(
01/02/04/05:00.0)与上行端口全部不可访问;遥测里同一拍lk、up同时变Unknown/带宽 0x3F - AER 全程
ce=fe=ne=0(死前最后一次采样仍为 0,历史累计也为 0) - 温度正常(死时 junction 77 °C / 显存 78 °C,临界 110 °C)
- 驱动从未成功复位;用户态全部卡在 D 状态(10/26 实测:采样循环从 0.5 秒/拍被拖到 64 秒/拍,
load≈5而 CPU 占用 1–2%) - 结局是 60 秒硬件看门狗(SP5100 TCO)硬复位——
RuntimeWatchdogSec=60s是我方为避免长时间僵死主动配置的 - 掉卡后重启即可完全恢复,无需断电;RAS 计数不残留
3. 六次故障记录(时间 = 内核首条相关报错)
# 时间 该卡位置 现象 整机结束方式 1 10-18 23:48:50 槽A 03:00.0rank0device lost from bus断电重启 2 10-20 14:51:41 槽A(音频功能先报 inaccessible) 同卡不可访问 断电重启 3 10-21 12:45:31 槽A inaccessible → 失联,65 次刷屏 看门狗复位 4 10-21 17:07:33 槽A 失联,84 次刷屏 看门狗复位 5 10-26 18:40:24 槽A 失联,42 次刷屏 看门狗复位 — 10-26 19:55 交叉验证 两卡对调槽位 + 交叉供电线 — — 6 10-27 09:46:55 槽B 06:00.0rank1失联,56 次刷屏;对照卡 0 次 看门狗复位
4. 两次崩溃的逐拍数据(自研 0.5 秒采样,字段见 §9)
4.1 第 5 次(10-26,上升沿触发)
18:40:22.12 | 03 p=29W   j=53 m=56 v=594  s=42MHz    lk=32GT/s x16 up=32GT/s x8 | 06 p=30W   j=56 ...
18:40:22.67 | 03 p=16W   j=52 m=54 v=594  s=41MHz    lk=32GT/s x16 up=32GT/s x8 | 06 p=18W   j=55 ...
18:40:22    | aer 03 ce=0 fe=0 ne=0        aer 06 ce=0 fe=0 ne=0
18:40:23.24 | 03 p=181W  j=66 m=60 v=1099 s=3.219GHz mc=1.258GHz                | 06 p=190W  j=70 ...
18:40:23.79 | 03 p=NA e=NA j=NA m=NA v=NA s=NA mc=NA lk=Unknown/63 up=Unknown/63 | 06 p=94W  v=1170 s=3.437GHz
触发形态:深睡(16 W / 0.594 V / 41 MHz)→ 0.57 秒内同步拉到 181 W / 1.099 V / 3.2 GHz → 下一拍(0.55 s 后)卡 03 整体失联。对照卡 06 同一瞬间也在满载爬升,毫发无损。
4.2 第 6 次(10-27,交叉验证之后,稳态满载触发)
09:46:52.16 | 03 p=230W j=76 m=77 v=1057 s=2.942GHz | 06 p=230W j=76 m=77 v=1047 s=2.899GHz 09:46:53.96 | 03 p=230W j=77 m=78 v=1057 s=2.934GHz | 06 p=229W j=77 m=78 v=1063 s=2.890GHz 09:46:54.52 | 03 p=230W j=77 m=78 v=1069 s=2.942GHz | 06 p=230W j=77 m=78 v=1063 s=2.890GHz 09:46:55.08 | 03 p=230W j=77 m=78 v=1062 s=2.882GHz | 06 p=NA e=NA j=NA m=NA v=NA s=NA lk=Unknown/63 up=Unknown/63 09:46:55.18 | 03 p=100W j=69 m=60 v=1170 s=3.428GHz | 06 p=NA ...这次不是上升沿:故障前 3 分钟里 360 拍有 317 拍 ≥200 W,两卡长时间顶在 230 W 功耗墙上;卡 06(= 同一张物理卡,换了槽位/根端口/rank/供电线)在稳态满载中突然失联;对照卡 03 当时同样 230 W,仍正常出数。
两种完全不同的触发形态、同一张物理卡 —— 这是我目前最倾向"卡体失效"的原因。
5. 已经做过的排除实验
嫌疑 做法 结果 主板槽位 / PCIe 根端口 两卡对调槽位( 03:00.0 ↔ 06:00.0)未排除:故障跟着卡走,与槽位无关 驱动角色 rank rank 随槽位枚举自动互换 未排除:它在 rank1 照样死 线材 / 端子 两卡供电线交叉(4 根独立线,无一分二) 未排除:换线后 13 小时同一张卡再死 整机 12V 能力 故障瞬间整机 12V 负载约 450 W(1000 W 电源的 45%) 排除总输出不足:同刻另一张卡同样满载无恙 过热 死时 junction 77 °C / 显存 78 °C;3 天历史峰值 87 / 80 °C 排除 PCIe 信号质量 / 链路 3 天 46 万拍:AER ce=0 fe=0 ne=0,链路稳定 Gen5 x8(卡内 x16),无降速重训基本排除 CPU / 内存 / 主机侧 故障瞬间 CPU 0–1%、负载 0.05;无 MCE、无 EDAC、无 panic、pstore 空 排除 驱动 / 软件路径 无 ring test failure;同内核同驱动同负载下对照卡 77 小时 0 次 无软件级前兆 固件差异 两卡 VBIOS 版本号 + build 号完全一致;内核侧 IP 固件同源 排除"两卡固件不同" 显存 ECC 两卡 RAS ue/ce/de=0、无坏页未证实(计数器重启清零,抓不到崩溃时刻) 6. 关键统计
两卡在 TP2 下是 lockstep 同步满载(同一瞬间一起从 16 W 拉到 181 W),暴露条件几乎全等。若两卡失效率相同,6 次故障全落在同一张上的概率:
(1/2)^6 = 1/64 ≈ 1.6%(双侧 3.1%)指标 数值 连续遥测窗口(约 3 天)内故障卡的"深睡→满载"负载阶跃 305 次 其中触发致命故障 1 次(单次阶跃故障率 ≈ 0.3%) 对照卡同窗口连续记录 约 77 小时 / 46 万采样拍,0 次失联 两卡满载均值对照 226.4 W / 2952 MHz / 1020 mV 与 226.4 W / 2967 MHz / 1019 mV(完全对称,无"一张活更重") 所以:短时压测(2 小时、负载循环个位数次)的复现概率按此率估算仅约 0.3%–3%——"烤机通过"在我这个案例里没有统计意义。 我自己跑的通用压测也确实全部不复现。
7. 与公开案例的对照(同一颗 Navi 48 / 同一款卡)
出处 平台 关键结论 ROCm/amdgpu#241(2026-10-24)2×R9700 + X870E + Ubuntu 26.04.1 + llama.cpp 推理中随机整机复位(复位寄存器报 data fabric sync flood 0x08000800);pcie_aspm=off、关 GFXOFF、限 240 W、COMPUTE profile、PCIe runtime PM=on、更新 BIOS、关 EXPO 全部无效;根端口一个 Gen5 x8、一个只有 Gen4 x8。AMD 零回复ROCm/TheRock#9299(2026-09-29)2×R9700 vLLM TP=2 SMU No response→ MES 不可恢复 → 整机死锁,gpu_recovery没机会触发↑ 评论 1 2×R9700 + 9950X + X870E AORUS MASTER 复现确认;Gen5 x16、AER 全 0、温度正常;SMU 接口不匹配 driver 0x2e/ fw0x33↑ 评论 2 同机(含内核 6.14.8 / 7.0 nightly 也死) 做过卡/槽 A/B 对调 + 每卡独立供电线;提出负载形态判别:稠密 FP8 全权重常驻显存(稳态解码)数周 0 fatal,MoE + 主存专家下沉 + 盘上侧表流式读取 3/3 fatal,且稠密负载更重更热 ↑ 评论 3 RX 9070 XT(同 Navi 48)+ SteamOS 掉总线时 SMU 消息全 0xFFFFFFFF、整卡连同卡内 switch 一起消失、根端口仍在、AER 为 0(与我完全一致);11 小时崩 22 次;降功耗墙 + 负频移只把 10 次/小时压到 0.4 次/小时,未消除;关 GFXOFF 无效;同一台机器 Windows 下稳定ValveSoftware/SteamOS#2910RX 9070 XT 被上面引用的同类掉总线报告 L1T: dual R9700 vLLM woes / quad R9700 on AM4 / R9700 ×2 Code 31 双/四卡 掉卡、P2P 不通、Code 31 等 我与公开案例的两点不同(也是我困惑的来源):
- (a) 我的 6 次全部在同一张物理卡(等暴露下 1/64),而上面的案例里故障在两张卡之间是散布的、且有人观察到另一张卡也出现过自恢复的轻症。通病可以解释"这类卡存在这条弱点",但只有个体差异能解释"为什么永远同一张"。
- (b) 我的 SMU 固件比他们更旧:我
104.76.0,他们104.79.0,还有人测过104.80.0仍崩。接口不匹配0x2e/0x33我这边一模一样存在。
8. 还没做的实验(求补充、求优先级)
- Windows 差分(最关键:公开案例里同一台机器 Windows 稳、Linux 崩)
- 可疑卡单独
--tp 1跑几天(单卡也崩 = 硬件;只有双卡崩 = 双卡交互 / P2P / 固件路径) - 12V-2x6 转接头跨卡互换——注意:第 5 次交叉验证时转接头是插在卡上跟着卡走的,所以"转接头"目前仍未被排除
- 升级
linux-firmware(SMU 104.76.0 → 更新)与试不同内核 - 引擎侧降 churn:
--placement all_vram、调低--busy-prefill-chunk、加大--host-pool-mib、关 MTP;卡侧power_dpm_force_performance_level=high - 把 RAS 计数与
gpu_vram_bad_pages挂进 0.5 秒采样(现在重启清零、抓不到崩溃瞬间) - 卡上 12pin 插座焊点目检 / 满载后测温对比
9. 采样方法与字段(同行可直接复用)
systemd 服务,0.5 秒一拍写盘,每 2 秒加一行 AER 快照;表头示例:
# start 2026-10-26T18:46:01+08:00 kernel=7.0.0-38-generic v4字段 来源 含义 phwmon/power1_input板卡功率 PPT e/j/mhwmon/temp1/2/3_inputedge / junction / 显存温度 vhwmon/in0_inputvddgfx(VRM 之后,看不到 12V 输入侧) s/mcdevice/sclk/memclk核心 / 显存时钟 lk/rscurrent_link_speed/width、device/state卡内链路速率与宽度、电源状态 br三级桥 current_link_width拼接卡内 PCIe switch 是否还在(变 0即卡内失联)up上游端口 current_link_*判定"整卡消失"还是"只有 GPU 函数消失"的关键 aer …aer_dev_correctable / _fatal / _nonfatal每 2 秒累计计数 最小可用版本(可直接贴):
while sleep 0.5; do
  for d in 0000:03:00.0 0000:06:00.0; do
    h=$(ls /sys/bus/pci/devices/$d/hwmon/hwmon* 2>/dev/null|head -1)
    printf "%s p=%s j=%s v=%s s=%s lk=%sx%s up=%sx%s | " "$(date +%H:%M:%S.%2N)" \
      "$(cat $h/power1_input)" "$(cat $h/temp1_input)" "$(cat $h/in0_input)" \
      "$(cat /sys/bus/pci/devices/$d/sclk)" "$(cat /sys/bus/pci/devices/$d/current_link_speed)" \
      "$(cat /sys/bus/pci/devices/$d/current_link_width)" \
      "$(cat /sys/bus/pci/devices/0000:01:00.0/current_link_speed)" \
      "$(cat /sys/bus/pci/devices/0000:01:00.0/current_link_width)"
  done; echo
done
10. 想请教的具体问题(按对我价值排序)
- 谁做过 Windows 对照? R9700 / RX 9070 XT 在 Windows 下同负载是否稳定?你机器上 LinuxWindows 差分做过吗?
SMU: interface mismatch: driver if 0x2e, fw if 0x33是否已知有害?哪个内核 / linux-firmware 组合能把两侧对齐?该降固件还是升内核?- 有人抓到"死之前最后 0.1–5 秒"更细的现场吗?(PCIe 快照、SMU 消息、dmesg 毫秒级、示波器 12V)想确认失效的先后次序:供电 / SMU / 链路,谁先死。
- 12V-2x6 转接方案有没有人做过明确 A/B 定论? 双 8pin 转 12pin 在你机器上能长期稳定吗?
- Linux 下长期跑 MoE + 专家下沉(Radiance / Strata / vLLM host offload / llama.cpp MoE)不崩的配置是什么? 尤其是 power level、GFXOFF、aspm、host-pool 大小、prefill chunk。
- 有人试过
--placement all_vram(同规模 MoE)吗? 装得下吗?稳定性有无变化? #241/#9299有没有人拿到 AMD 私下进展(内部单号、测试固件、VBIOS 计划)?- 有没有人的故障是"只死同一张卡"? 你怎么定性、最后怎么处理(换卡 / 换固件 / 凑合用)?
- (中文社区)R9700 保修实操:走店保还是官方?给换还是给退款?会不会要求 Windows 复现?
11. 我能提供的数据
- 0.5 秒粒度连续遥测:约 3 天 46 万拍(gzip 约 13 MB),含两次崩溃完整前后现场
- 每次崩溃的内核/系统日志窗口导出,以及逐 boot 的复位原因记录
- 六次故障精确时间戳 + 交叉验证前后的卡槽位映射(按
unique_id锚定) - 判读脚本(map / save / verdict 三个子命令)
- 待补:RAS 与
gpu_vram_bad_pages的持续采样(按大家建议加上后重新抓一次现场)
12. English summary (for L1T / GitHub cross-post)
2× Radeon AI PRO R9700 (gfx1201), X670E, Ryzen 7 9800X3D, Ubuntu 26.04.1, kernel 7.0.0-38. Two cards run a MoE inference engine with
--tp 2 --p2p auto, host-pinned expert pool and a disk-resident n-gram table, power capped to 230 W (stock 300 W).
Six intermittent "device lost from bus" events in 9 days. Whole card vanishes at config-space level including its on-card PCIe switch (up=Unknown/x63), all SMU messages return0xFFFFFFFF, AER stays 0, temps normal (77 °C junction), no MCE/panic, no successful GPU reset; the box is recovered only by a hard reset.
I swapped the two cards' slots and crossed their power cables: the same physical card failed again 13 hours later (6/6 events on one card, control card 0 in ~77 h; p≈1/64). Two different trigger shapes: a 16 W→181 W step in 0.57 s, and a sudden loss during sustained cap-limited load (317/360 samples ≥200 W in the preceding 3 min).
Matches theamdgpu#241/TheRock#9299/ RX 9070 XT reports in every observable except one: those show failures spread across both cards, mine never does. Kernel also reportsSMU: interface mismatch: driver if 0x2e, fw if 0x33; my SMU fw is 104.76.0.
Questions: has anyone done a Windows differential on the same hardware? Is the SMU interface mismatch known-harmful, and which kernel/firmware pairing aligns it? Anyone whose failures were confined to a single card — how did you resolve it?
13. 一句话版(发群里用)
双 R9700 跑
--tp 2,9 天掉卡 6 次,整卡连板载 switch 一起消失、AER 全 0、温度正常;已做跨槽+跨线交叉验证,6 次全在同一张卡(另一张 0 次);#241/#9299那类"驱动/固件通病"解释不了 6:0,纯硬件又解释不了我的 SMU 接口不匹配0x2e/0x33——有人做过 Windows 差分吗? - 整卡瞬间失联,含卡内 switch 三级桥(
-
@Kuo-Ke-Hung 我重装了系统,从前天晚上截至目前没有任何异常,希望是系统问题。
上机箱显卡照片看下布线
-
-
@xiongjie-gao 目前情况是这样的,电源是非ATX3.0/3.1 振华23年1000w的电源。4个8pin供电 二合一转12pin 支撑两卡供电 按道理说 300+300 也就600 加整机和cpu 也最多加300 一共900 不应该是电源的问题。
-
@杨乾基 AER问题大概率不会是因为电源功能跟着卡走。主要是看你有没有使用延长线。
比起延长线材的接触或是信号传输中的干扰问题,显卡可比它皮实多了。
-
@杨乾基 AER问题大概率不会是因为电源功能跟着卡走。主要是看你有没有使用延长线。
比起延长线材的接触或是信号传输中的干扰问题,显卡可比它皮实多了。
@xiongjie-gao 并没有使用延长线,延长线质量参差不齐,目前所有线材都是原装的
-
以前很不错的振华1000w 但是是非ATX3.0/3.1 规范
我用的應該是和你同一顆的Sunflower 振华1000w 白金
當時的配置是這樣的 :
GPU0 掉卡/掉驅動 => 第一顆振华850w 金牌 x 1 (供電 主板 CPU + GP0 5070 Ti 300W) + 第二顆振华850w 金牌 x 1 (供電 GP1 5070 Ti 300W)GPU0, GPU1 正常=> 第一顆振华1000w 白金 x 1 (供電 主板 CPU + GP0 5070 Ti 300W) + 第二顆振华850w 金牌 x 1 (供電 GP1 5070 Ti 300W)
GPU0, GPU1 正常=> 振华1000w 白金 x 1 (供電 主板 CPU + GP0 5070 Ti 300W + GPU1 5070 Ti 300W)振华1000w 白金 可以支援主板跑兩張 RTX 5070 Ti Qwen3.8-27B, Strata-Qwen Flash
但基本上兩張GPU 5070 Ti 一般耗電量總共約300~450瓦以內 因為記憶體bottleneck, 無法滿載600W
如果兩張AI PRO R9700 常常滿載 600W 或許會有不同的狀況? -
@xiongjie-gao 我是用了转接线,是原卡附赠的 双8合一 一共4个8pin 合成了两个12pin
-