
【结论:可行!】双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3 的可行性实测报告
-
早上还在跟AI聊天,谈复刻Radiance的路径的可能性。中午就被老特投喂了个贴子:
https://lcz.me/topic/2643/这个兄弟是个人才,看完大概心里就有数了,这事能成。
因为没搞通内网穿透的问题,所以不能跟论坛的几个大神一样远程评测,回到家把任务交待给AI,做饭去了。洗完碗回来,一看AI给的结论,是比预想的还要好。
先给结论,因为AI在测Lora时掉了未生效,擅自画了另一个片子。我现在让它重跑这一段。但不会影响结论。重点就三条
1,可行性
成立!RDNA3 上纯 INT8/INT4 通路 + 自写 TP=2 能稳定出片,两卡逐像素一致,画质与单卡同构图。2,速度:本机上限被 PCIe 3.0 x16 锁死。832×480 只 1.19×;1344×768 1.42×。若换成帖子那种 12.93 GB/s 的链路,按实测计算量推算可到 ~1.6×。
上面是AI说的,我回顾了下GPU当时的功率以及内存占用的情况看,1.42×应该已经是摸着天花板了。就算是升级Gen 4不动其他硬件的情况下,超超频的情况下勉强能摸着1.5×,如此说来,X99简直香得很。相当于东拼西凑了些板子围成了桶,几乎没短板。
还有,这个,是给论坛中很多声称P2P没意义的朋友一记响亮的回应。如果这数据是在走CPU中转的情况下TP=2的提升将会被死死卡在卡间通信的速率上。(没记错走CPU中转速率大概3G不到每秒)。
老特鸟人说我拥护P2P是附庸拍马。同志我早年也是图吧混迹的,知识框架可能过时了底层原理还是通晓的,你不能说我这是拍马,起码是同样的高度下有的雷同视角。
3,显存才是主要收益。int8 权重 19.53 GiB 单卡跑不动,TP=2 在 1344×768 只要 16.9 GB/卡,还剩 7 GB 余量(可以再上更长的帧数/更高的分辨率)尤其是在高分辨率下,说明大分辨率下通信占比被摊薄,分辨率越大,TP>1 更划算。(分界线暂不明)
好了我去收一下重跑的数据,贴出来跟大伙分享一下。
---------------再现手动分割线--------------
双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3 的可行性实测
平台:2 × RX 7900 XTX 24GB(gfx1100 / RDNA3)· ROCm 7.2 · ComfyUI 0.43 · 量化走
comfy_kitchen
实现路线对齐 lcz.me/topic/2643(int8/convrot + 自写张量并行),参数口径对齐 lcz.me/topic/2582(双 R9700)
一句话结论
能用,而且画质过关;但“加速比”被本机的 PCIe 3.0 x16 卡住了。
DiT 的计算确实按卡减半(11.23 s → 5.71 s/步,1.97×),可 all_reduce 只能跑到 ~4 GB/s(P2P 实测 4.7–5.0 GB/s,链路 KFD 只报 8000 MB/s),单步里又加回 ~3.7 s。最终:832×480 1.19×、1344×768 1.42×(单卡 43.72 s → 双卡 30.78 s/步)。
真正的价值在显存:int8 权重(19.53 GiB)单卡跑不动,TP=2 后 1344×768/124 帧只要 16.9 GB/卡,还能保持 30.8 s/步。网络上,参照贴 2×W7900 的 all_reduce 是 12.93 GB/s,本机上限大约是它的 1/3,这是差距的唯一来源。
场景 每步耗时 相对单卡 备注 832×480 · 124 帧 · 8 步 9.44 s/步 1.19×(单卡 11.23 s) w4a8 + bf16 reduce 1344×768 · 124 帧 · 8 步 30.78 s/步 1.42×(单卡 43.72 s) 6m15s 端到端 纯计算(跳过 all_reduce) 5.71 s/步 1.97× 切分本身很干净 int8 @1344×768 显存 16.9 GB/卡 — 单卡不可能装下 19.53 GiB 权重
1. 实现方式(与帖子 2643 同路线,没有走 Radiance/FP8)
-
双实例锁步:两个 ComfyUI 进程,
HIP_VISIBLE_DEVICES=0/1,各跑同一工作流,RCCL(nccl) +init_method=env://。 -
权重按 rank 切半(在
load_diffusion_model_state_dict之前改 state_dict,模型从形状自动推出 heads=28 / ffn=7168,源码零改动):
层 并行方式 每卡形状 通信 qkv_proj 列并行(q/k/v 各自按头切,56→28 头) [10752, 5376] 无 out_proj 行并行(切 K=7168→3584) [5376, 3584] all_reduce fc1 列并行(gate/up 各切一半) [14336, 5376] 无 fc2 行并行(切 K=14336→7168) [5376, 7168] all_reduce -
LoRA 同步切分:
lora_B(up)跟输出维切(qkv / fc1),lora_A(down)只在行并行层切 K(out_proj / fc2)。模型文件用的是 diffusers 命名,见第 8 节踩坑。 -
通信精度:默认 bf16 上线(流量减半)。fp32 reduce 每步多 4.1 s,画质只差 0.01 dB(18.84 vs 18.85),没有理由用。
-
不能被切的元数据:
weight_s_channel[N] 与weight_codebook[16] 原样复制,[N,1]的 per-row scale 在列切分时保持不动。
2. 实测:832×480 / 124 帧 / 8 步(seed 145,turbo LoRA 已生效)
配置 每步耗时 8 步端到端 显存峰值/卡 每步通信量 单卡 · w4a8 11.23 s 168.8 s 22.0 GB — TP=2 · w4a8 · bf16 reduce 9.44 s 150–169 s 22.4 GB 14.9 GB(114 次 AR) TP=2 · w4a8 · 关 int8 attention 11.23 s 168.2 s 22.4 GB 14.9 GB TP=2 · int8 · bf16 reduce 9.43 s 170.5 s 22.6 GB 14.9 GB TP=2 · w4a8 · fp32 reduce 13.34 s 179.3 s 22.4 GB 29.8 GB TP=2 · 跳过 all_reduce(仅计时) 5.71 s 104.9 s 22.1 GB 0 端到端时间差异主要来自模型加载 / 文本编码器 / VAE 解码(不并行),不是采样本身;采样部分按 8 步算:单卡 89.8 s vs TP2 75.2 s。
瓶颈拆解
-
114 次 all_reduce/步 × 155 MB(bf16)= 14.9 GB/步;9.44 − 5.71 ≈ 3.7 s 花在这里,等效带宽 ≈ 4.0 GB/s。
-
RCCL 现走
P2P/IPC(isAllDirectP2p 1、bad=0),4MB/16MB 分别 4.70 / 4.97 GB/s;KFD 链路报 8000 MB/s、PCIe 3.0 x16(E5-2696 v4 平台)。 -
对比 2643:2×W7900 的 all_reduce 12.93 GB/s。按 12.93 GB/s 复算,本配置单步会是 5.71 + 1.15 ≈ 6.9 s(1.63×),与帖子 1.66× 几乎重合 —— 说明切分实现本身没问题,差距全在链路上。
3. 实测:1344×768 / 124 帧 / 8 步(对齐 2582 的分辨率)
配置 每步耗时 8 步端到端 显存峰值/卡 可行性 单卡 · w4a8 43.72 s — 18.8 GB 要大量权重换出,明显掉速 TP=2 · w4a8 30.78 s 375 s(6m15s) 16.8 GB 舒适 TP=2 · int8 30.84 s 368 s(6m08s) 16.9 GB 单卡装不下,双卡可跑 1344×768 / 124 帧的 token 数 S = 37×24×42 = 37296(是 832×480 的 2.6 倍),每步通信量涨到 37.8 GB,但耗时的增长(9.4→30.8 s)远小于 token 倍数,说明大分辨率下通信占比被摊薄,TP 更划算。
4. 画质:同 seed 与单卡的 PSNR
对比 全局 PSNR 逐帧中位数 判定 单卡  单卡(同配置重跑,噪声底)
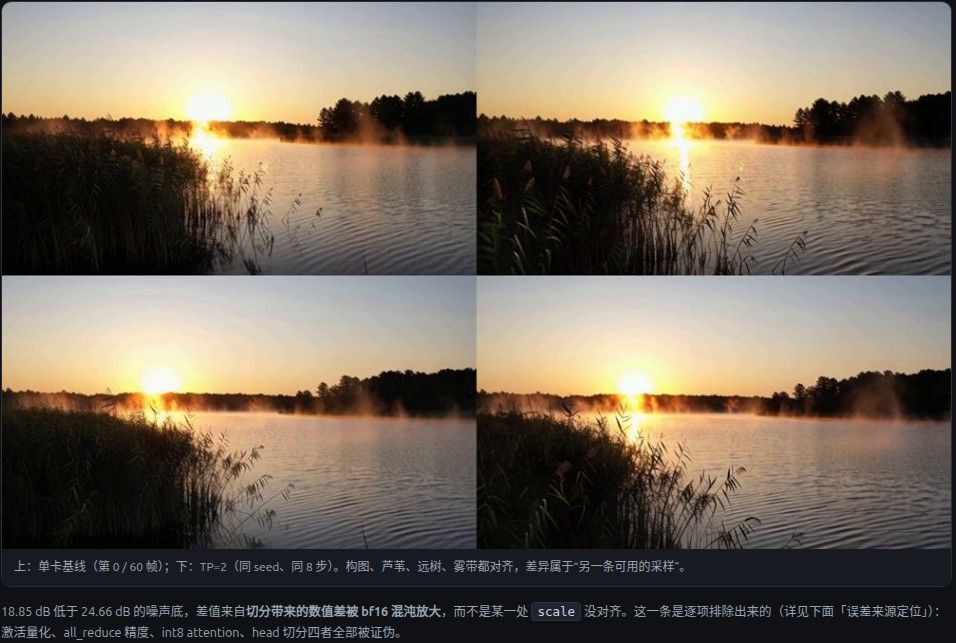
24.66 dB 24.56 dB 模型链路本身对内核/调度非确定(split-K atomics) 单卡 TP=2(w4a8,LoRA 已正确切分)18.85 dB 18.72 dB 构图/主体/光照一致 单卡 TP=2(fp32 all_reduce,29.8 GB/步)18.84 dB 18.76 dB reduce 精度无关 单卡 TP=2(out_proj/fc2 强制 bf16 GEMM)19.08 dB — +0.23 dB,但每步 +0.87 s 单卡 单卡(仅把 int8 attention 换成 bf16 SDPA)22.90 dB 22.83 dB 单卡换 attention 后端就有这么大差 单卡 TP=2(两边都关 int8 attention)18.43 dB 18.35 dB 关掉后更差 → int8 attention 不是误差源 单卡 TP=2(LoRA 未生效,修复前)12.77 dB 12.64 dB 画的是另一条片子 TP=2 rank0 rank199.00 dB 99.00 dB 逐像素完全相同 对比帧(单卡基线第 0/60 帧 vs TP=2 同 seed 同 8 步)见 HTML 版报告:构图、芦苇、远树、雾带都对齐,差异属于“另一条可用的采样”。
误差来源定位(本报告最花时间的部分)
假设 验证方法 结论 行并行层两半的激活量化 scale 不同 真实 blocks.0.attn.out_proj权重 + 合成激活,比较「整 K 一次量化」与「两半各自量化后相加」,并复现 2643 的all_reduce(MAX)共享 scale证伪:两法 rel 0.0091 vs 共享 0.0104;把激活整体乘 2 再除回,结果 rel=0 —— 该 kernel 的激活量化本身尺度不变,共享 scale 是空操作 TP2 下 A8 激活量化在跑 读 comfy/ops.py的cast_bias_weight:LoRA 补丁存在时len(fns)>0强制 dequant 成 bf16,_use_quantized也要求len(weight_function)==0证伪:8 步 LoRA 覆盖 104 层,实际走的是 bf16 GEMM,A8 量化根本不在执行路径里 all_reduce 用 bf16 累加损失精度 同一 seed 只改 COMFY_TP_AR_DTYPE=fp32证伪:fp32 18.84 dB / 13.34 s/步,bf16 18.85 dB / 9.44 s/步,画质无差别、速度差 41% int8 attention 在 28 头下换了量化尺度/kernel 路径 同一份 q/k/v 分别以 56 头、2×28 头调 comfy_kitchen.int8_attention,S=25/519/4810证伪:前 28 头输出逐位相同(rel 0.000e+00);关掉 int8 attention 重跑,TP2 单卡反而降到 18.43 dB行并行层的部分和 bf16 舍入 真实 w4a8 权重反量化成 bf16,比较整 K 与切半相加,含 fp32 部分和对照 量级不够:单层 rel 2.9e-3,与 bf16 存储舍入同量级;强制 bf16 GEMM 只换回 +0.23 dB 剩下的一条证据链:逐层 dump(320×192/22 帧/1 步)显示 refiner(25 token)处单卡
TP2 的 rel 与「单卡单卡」同级(3.1e-3 vs 2.3e-3),但到视频 token(S=519)的 block0 attention 输出突然变成 4.09e-2,而两组同配置重跑只有 6.2e-3 / 6.7e-3;输入侧三者都是 2.5–2.9e-3。也就是说:输入没有问题,误差在长序列 attention 里被非线性放大 —— 这与「单卡仅更换 attention 后端就差到 22.90 dB」是同一现象。结论:本栈的端到端采样对 bf16 级扰动本身就非常敏感,TP 只是提供了另一个扰动源,不存在可以「对齐 scale」修掉的单点 bug。
5. 新增的验证测试(本轮为定位误差写的,可独立复跑)
脚本 测什么 关键结果 tp2/attn_test.pycomfy_kitchen.int8_attention对 head 数是否敏感;int8 attention 对输入扰动的放大率S=25 / 519 / 4810,56 头结果切片与 2×28 头调用 rel=0.000e+00(逐位相同);同张量重复调用 equal=True;S=519 时 int8 vs fp32 SDPA rel 1.425e-02,而 0.3% 输入扰动经 int8 attn 放大到 1.354e-02(fp32 仅 4.809e-03)→ int8 attention 本身是噪声放大器,不是 scale 错配tp2/split_err.py真实 w4a8 权重反量化成 bf16 后,行并行切 K 的单层误差(手写 safetensors 头解析,不加载整模型) out_proj(K=7168, S=519):两半相加 rel 2.859e-03,fp32 部分和对照同为 2.859e-03,纯数学 fp32 仅 9.535e-07(|out|=5.336);fc2(K=14336):2.860e-03 / 2.860e-03 / 1.424e-06(|out|=13.747)→ 误差就是最终 bf16 输出舍入,不是切分数学tp2/atest.pykernel 级:整 K 量化 vs 两半各自量化;复现 2643 的 all_reduce(MAX)共享激活 scale切分 rel 0.00912 / 共享 amax 0.01035 / 共享逐行 0.01039 / 激活整体乘 2 再除回 0.00000 → 共享 scale 是空操作,还略差 tp2/ar_dtype_test.pyall_reduce 用 bf16 还是 fp32(同 seed 只改 COMFY_TP_AR_DTYPE)fp32 18.84 dB / 13.34 s/步;bf16 18.85 dB / 9.44 s/步 → 精度无收益,慢 41% tp2/cmp_dbg.py+TP2DumpLatent逐层 dump 定位误差从哪一层开始放大(320×192 / 22 帧 / 1 步) refiner(25 token)单卡 TP2 rel 3.1e-3 ≈ 噪声底 2.3e-3;视频 token(S=519)block0 attention 输出 4.09e-2,同配置重跑 6.2e-3 / 6.7e-3;输入侧三者 2.5–2.9e-3tp2/cmp_latent.py/tp2/psnr.py两实例 latent 逐元素比对;mp4 逐帧 PSNR( psnr.py <a> <b> <W> <H>)rank0 rank1 99.00 dB(逐像素相同);TP2单卡 18.85 dB / 18.72 中位新增脚本都在
/home/jay/tp2/,除split_err.py需读 safetensors 权重外均可在sglang-venv里直接python <script>复跑。复跑命令
cd /home/jay/tp2
/home/jay/sglang-venv/bin/python attn_test.py      # head 数敏感性 + 扰动放大率
/home/jay/sglang-venv/bin/python split_err.py      # 行并行单层 bf16 误差
/home/jay/sglang-venv/bin/python atest.py          # kernel 等价性 / 共享 scale
/home/jay/sglang-venv/bin/python ar_dtype_test.py  # bf16 vs fp32 all_reduce
6. 与 2643 / 2582 的横向对照
项目 2×W7900(2643) 2×R9700(2582) 本机 2×7900 XTX 显存/卡 48 GB 32 GB(报告 31.86) 24 GB 量化 int8 + convrot(25?) FP8 权重 + Radiance(RDNA4 专用内核) w4a8 / int8 + convrot,全走 INT8 通路 all_reduce 12.93 GB/s 有分片,未量化带宽 ~4.0 GB/s(P2P 4.7–5.0) 832×480 采样 12.8 s/步 → 7.7 s(1.66×) 20 步 15.5 min → 8 min 11.23 → 9.44 s/步(1.19×) 1344×768 / 8 步 — 总 15m35s(含约 5 min 预处理) 总 6m15s,30.8 s/步 显存峰值/卡 12.9 / 13.2 GiB 27.9 GiB 16.8 / 16.9 GiB(1344×768) 软件栈 ComfyUI + 自写 TP2 非 ComfyUI 自研管线 ComfyUI + 自写 TP2 怎么读这张表:2582 的 1344×768 那组含参考图/参考视频/参考音频的全量 Ref2VA 条件,还含约 5 分钟预处理,口径比我们更重,只能当量级参照;2582 的“等效容量 ≈ 32N − 11.55(N−1)”也是它自家显存池算出来的,和我们不是同一套分配器,不能直接换算。真正同口径的是 2643:同为 ComfyUI + 自写 TP2 + INT8 通路,唯一差别是链路带宽。
7. 踩过的坑(都已修,值得记下来)
现象 原因 处理 TP2 画质 12.77 dB,画的是另一条片子 LoRA 键名是 lora_A/lora_B,只按lora_down/lora_up匹配 → 切分命中 0/416,补丁形状不符后 ComfyUI 静默跳过兼容两种命名; lora split keys=208/416,PSNR 升到 18.85 dB报 codebook must have shape (16,), got (8,)weight_codebook是全局 16 值码本,被当成普通权重切了切分白名单跳过 codebook 与 comfy_quant rank1 在列切分层 IndexError [N,1]的 per-rowweight_s_channel被沿 dim=1 切列模式对 1 维 / 末维为 1 的张量原样保留 怀疑切分数学不对 convrot 是否块对角 kernel 级验证:int8 整 K 与切半求和 rel_max 0.0109 / 0.0118;w4a8 两法互差 6e-5 → 等价 bench 打出旧实例、显存不释放 上一轮实例还占着端口 run_case.sh起实例前按端口清理fp32 all_reduce 更稳? 假设不成立 实测 13.34 s/步、PSNR 18.84(bf16 18.85),无收益且每步多 4.1 s,bf16 定为默认 假设行并行层两半的激活量化 scale 不一致是 18.85 vs 24.66 dB 的主因(2643 用 all_reduce(MAX)对齐)本栈 A8 内核的激活量化是尺度不变的:真权重上复现「整 K 量化」vs「两半各自量化后求和」rel 0.0091 vs 0.0104,共享 scale 反而略差;把激活乘 2 再除回结果 rel=0 不做。共享 scale 在本内核上是空操作,不需要改 comfy_kitchen的 hip kernel想用 fp16 做 all_reduce 再省一半流量 行并行层输出是部分和,amax 实测到 1.8e6,超 fp16 上限(65504)直接 NaN 删掉 fp16 分支,只留 bf16 / fp32 怀疑 int8 attention 切到 28 头后走了另一套量化尺度 同一份 q/k/v 以 56 头与 2×28 头分别调用,前 28 头输出 rel = 0.000e+00(逐位相同)排除。误差来自长序列 attention 对输入的混沌放大,不是 head 切分
8. 结论与后续建议
-
可行性:成立。 RDNA3 上纯 INT8/INT4 通路 + 自写 TP=2 能稳定出片,两卡逐像素一致,画质与单卡同构图。
-
速度:本机上限被 PCIe 3.0 x16 锁死。 832×480 只 1.19×;1344×768 1.42×。若换成帖子那种 12.93 GB/s 的链路,按实测计算量推算可到 ~1.6×。
-
显存才是主要收益。 int8 权重 19.53 GiB 单卡跑不动,TP=2 在 1344×768 只要 16.9 GB/卡,还剩 7 GB 余量(可以再上更长的帧数/更高的分辨率)。
-
还能再抠的地方(按收益排序):
-
画质目前没有单点可修。 18.85 vs 24.66 dB 的差已定位为 bf16 级数值扰动被端到端采样混沌放大:激活量化(尺度不变)、all_reduce 精度(fp32 只差 0.01 dB)、int8 attention(28 头逐位相同、关掉反而 18.43 dB)、行并行部分和舍入(单层 2.9e-3,全局切换 bf16 GEMM 也只 +0.23 dB)四项全部证伪。想再提升只能整体抬数值精度——最直接的是把
out_proj/fc2强制 bf16 GEMM(COMFY_TP_ROW_BF16=1,19.08 dB,代价 +0.87 s/步); -
把
out_proj/fc2的 all_reduce 与下一层 norm 的独立计算做流水重叠(当前是纯串行等待); -
不再需要
bf16→fp32→bf16中间转换;以及确认 114 次/步里是否有可合并的重复 reduce。
-
复现入口
-
插件:
/home/jay/ComfyUI/custom_nodes/comfyui-tp2/__init__.py(权重切分 + LoRA 切分 + all_reduce + 计时 + latent 导出节点) -
编排:
/home/jay/tp2/run_case.sh <tag> <world> <W> <H> <F> <steps>→ 起实例 → 投工作流 → 收耗时/显存/latent -
对比:
cmp_latent.py(latent 逐元素)、psnr.py(mp4 逐帧)、bw.py/ktest.py(链路带宽 / 量化等价性) -
环境变量:
COMFY_TP_AR_DTYPE=bf16|fp32、COMFY_TP_AR_SKIP=1(跳 reduce 仅计时)、COMFY_TP_ROW_BF16=1(行并行层走 bf16 GEMM)、EXTRA_ARGS=""(关掉--use-ck-attention)
-
-
-
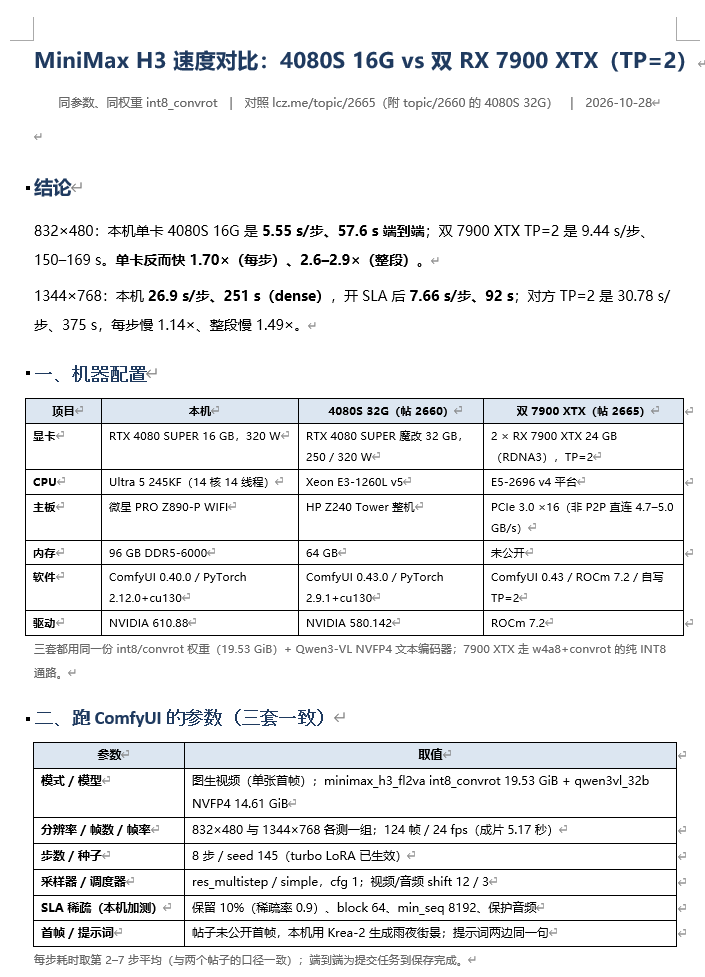
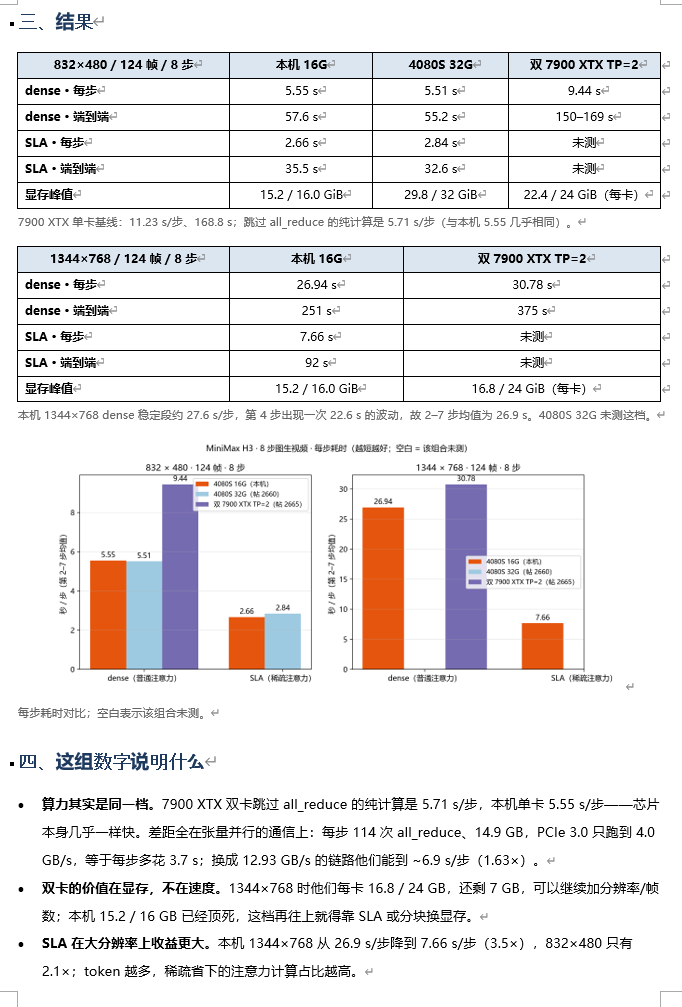
双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3和单K 4080S 32GB,就跑comfyui来说,选择哪个更有效率?反正4080S也有3年质保嘛,楼主大神建议一下。
@Michael-ZHANG 你喜欢折腾就搞A,你喜欢安逸就选N。
劈头盖脸问我是要娶柳岩好还是孙燕姿好,你也是把我问到了。 -
-
-
出1344乘768分辨率的视频,测试是16g显存就够,其实双7900xtx可以测试一下生成1920或者2048分辨率,甚至更高,看看速度怎么样
@Werther-Wang 常规工作流是跑个低分辨率低桢的视频来校验关键词,没问题通过专门的节点补桢并提升分辨率。起手高分辨率我看来意义不大。
-
@Werther-Wang 常规工作流是跑个低分辨率低桢的视频来校验关键词,没问题通过专门的节点补桢并提升分辨率。起手高分辨率我看来意义不大。
-
@xiongjie-gao 直出高分辨率画质会好一些。对画质有极致要求的可以尝试,一般也都用不到。
@Werther-Wang anyway,作为测试其能力边界,是有意义的。而且TP=2明显摊薄通信短板,已经安装上在跑了。
-
出1344乘768分辨率的视频,测试是16g显存就够,其实双7900xtx可以测试一下生成1920或者2048分辨率,甚至更高,看看速度怎么样
-
@Werther-Wang 谢谢你的对比测试,有参考意义.
@Michael-ZHANG 不过你还要考虑cpu和内存有没有影响,这个我不知道,我测试用的cpu和内存你也考虑下。
-
谢谢老哥的对比测试, 目前单卡起步跑儿童频道, 多几个月买多一张了过来抄作业. 🤩 也感谢各位a卡发热的老哥们

 现在好稀罕几个月前买下的7900xtx 下了班折腾折腾还挺好玩

-
@Michael-ZHANG 不过你还要考虑cpu和内存有没有影响,这个我不知道,我测试用的cpu和内存你也考虑下。
@Werther-Wang 我的配置:
CPU:AMD EPYC 7k62
内存:镁光DDR4 3200 RECC 32GB x2
硬盘:SSD致钛1TB NVme
主板:华南金牌H12D-8D(单路)
电源:长城F16白金1600W
显卡:AMD MI50x2
机箱:长城黑匣子AI09
网卡:主板自带2.5GBx2
C PU,内存,SSD,显卡是公司淘汰的,其他的我自己买的。目前准备再买2条32GB REC C内存。再买显卡把MI50换了,之前考虑A卡Pro9700一张或者2张, 看了大家的测评,感觉买一张N卡就可以了。这套系统主要跑comfyui。LLM用在线API,主要用Deepseek/MiniMax/千问三家的。 -
@Michael-ZHANG 不过你还要考虑cpu和内存有没有影响,这个我不知道,我测试用的cpu和内存你也考虑下。
@Werther-Wang CPU和内存不会是瓶颈
通信摊薄曲线:640×352 → 1536×864(124 帧,均为 4–8 步实测)
分辨率 S(token) 单卡 s/步 TP=2 s/步 加速比 all_reduce 通信耗时占单步 640×352 8 140 5.80 5.28 1.10× 8.6 GB 45% 832×480 14 430 11.23 9.44 1.19× 14.9 GB 40% 1024×576 21 312 19.10 14.99 1.27× 21.8 GB 36% 1280×704 32 560 35.49 26.00 1.37× 33.0 GB 32% 1344×768 37 296 43.72 30.78 1.42× 37.8 GB 29% 1536×864 47 952 65.60 44.49 1.47× 48.5 GB 26% 通信耗时 = TP2 单步 − 单卡单步/2(把「计算完美二分」当基准),等效带宽稳定在 3.6–4.2 GB/s。加速比随 S 单调上升,S 从 8.1k 到 48k(5.9×)时单卡单步涨 11.3×,因为 attention 是 S²、all_reduce 只是 S——这就是“摊薄”的来源。
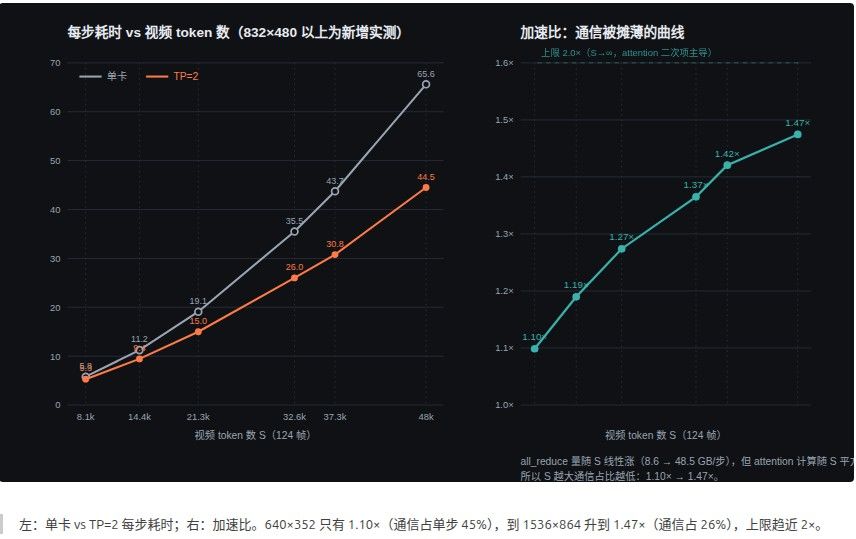
左:单卡 vs TP=2 每步耗时;右:加速比。640×352 只有 1.10×(通信占单步 45%),到 1536×864 升到 1.47×(通信占 26%),上限趋近 2×。
基本印证跟我的对提升上限1.50×的猜想
-
@Werther-Wang CPU和内存不会是瓶颈
通信摊薄曲线:640×352 → 1536×864(124 帧,均为 4–8 步实测)
分辨率 S(token) 单卡 s/步 TP=2 s/步 加速比 all_reduce 通信耗时占单步 640×352 8 140 5.80 5.28 1.10× 8.6 GB 45% 832×480 14 430 11.23 9.44 1.19× 14.9 GB 40% 1024×576 21 312 19.10 14.99 1.27× 21.8 GB 36% 1280×704 32 560 35.49 26.00 1.37× 33.0 GB 32% 1344×768 37 296 43.72 30.78 1.42× 37.8 GB 29% 1536×864 47 952 65.60 44.49 1.47× 48.5 GB 26% 通信耗时 = TP2 单步 − 单卡单步/2(把「计算完美二分」当基准),等效带宽稳定在 3.6–4.2 GB/s。加速比随 S 单调上升,S 从 8.1k 到 48k(5.9×)时单卡单步涨 11.3×,因为 attention 是 S²、all_reduce 只是 S——这就是“摊薄”的来源。
左:单卡 vs TP=2 每步耗时;右:加速比。640×352 只有 1.10×(通信占单步 45%),到 1536×864 升到 1.47×(通信占 26%),上限趋近 2×。
基本印证跟我的对提升上限1.50×的猜想
-
@xiongjie-gao 分辨率还能再提高么?最高能生成多大的分辨率,我比较好奇。
@Werther-Wang 我的两张卡性能开关都在均衡上,要测极限还要动硬件。太累了

-
,
 T terry 固定了此主题
-
-
双 RX 7900 XTX 以 TP=2 跑 MiniMax-H3和单K 4080S 32GB,就跑comfyui来说,选择哪个更有效率?反正4080S也有3年质保嘛,楼主大神建议一下。
-
@Werther-Wang 这是你的测试结果吗?怎么最近我有段时间没玩了,视频的要求已经这么低了?原生高分辨率的意义就是在正式出片时,大显存强算力单卡生产。否则试错成本太高不值得。放大也有专门的节点和工作流,虽然没原生好,调试下,也能用。
-
-
,T terry 引用了 此主题
-




 版主审定:本帖设为精华,作者 +6 积分奖励,希望再接再厉!