
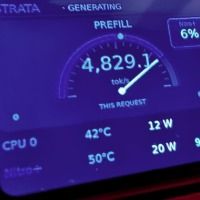
【 爆卖理由+2】双7900 XTX Strata IQ3_S:262K Prefill 6,264 可抄作业
-
@Eric-Seto 刚刚实测,沿用本机 Strata RDNA3 0.1.43 配置,只临时改变队列数。每组完成两次生成,生成结束后各观察 45 秒,结果如下(中位数):
状态 GPU0 占用 / 功耗 GPU1 占用 / 功耗 Strata 未启动 1% / 11 W 0% / 19 W GPU_MAX_HW_QUEUES=8,生成结束100% / 69 W 100% / 106 W GPU_MAX_HW_QUEUES=6,生成结束100% / 77 W 0% / 18 W Strata 进程退出后 1% / 14 W 0% / 20 W 我这边双 7900 XTX 也复现了。设为 8,生成结束后双卡仍持续显示 100% 占用;改为 6,第二张卡恢复空闲,但第一张卡仍显示 100%。关闭 Strata 进程后两张卡都恢复正常。功耗也明显下降,因此不只是占用率显示的问题。
-
@懒人烘培 我去,我还以为我上面的显卡温度太高被烤出毛病了,原来大家都有这个情况。。。哈哈
-
@Simon-Li-0 不得,显卡没有这么脆弱,刚使用双7900XTX的时候,由于没有控制好温度,一卡长时间在110°满载,最后优化后就好了。
-
@懒人烘培 我上面这张卡100+,下面的才80+,正常能差15-20度
-
@Simon-Li-0 哦,你那只要不几个小时连续满载,应该问题不大,夏天温度应该还要高点。可以把单卡功率锁定在300W或者250W试试,看看温度有没有改善
@懒人烘培 用strata非常合适,他不会一直满功耗,双卡27B是真顶不住,跑起来就直接110度纹丝不动。

-
@Simon-Li-0 不得,显卡没有这么脆弱,刚使用双7900XTX的时候,由于没有控制好温度,一卡长时间在110°满载,最后优化后就好了。
-
@Eric-Seto 不是的,烘焙老哥在说我的显卡温度高的问题,这个空转问题是另一回事,还没找到怎么解决
-
-
-
Strata/AMD ROCm:GPU_MAX_HW_QUEUES=8 待機 GPU 持續 100% 負載的核心修補實測
**背景:雖然將
GPU_MAX_HW_QUEUES設為6解決了我的GPU 持續 100% 負載問題,但在多數已測項目中,prefill(提示處理)與 decode(生成)速度比目前 queue=8 的配置慢。因此我嘗試保留 queue=8,改從核心驅動修補這個問題。根本原因(Root Cause)
在 AMD ROCm/Ubuntu 環境下執行 Strata 推論引擎(v0.143,搭配社群 #pr1 fork)時,即使處於待機狀態,GPU 使用率仍持續維持在 100%,通常是由一個已知的硬體排程器錯誤所造成,涉及多媒體引擎排程器(Multimedia Engine Scheduler,MES)的韌體。
當 HIP/ROCm streams 透過 MES(
mes_v11_0_add_hw_queue)建立多個硬體佇列,或與這些佇列互動時,引擎會觸發amdgpu_ring_commit內部的緊密輪詢迴圈。這會使rocm-smi與作業系統持續回報 100% GPU 使用率,並讓顯示卡維持在高功耗狀態,即使當下完全沒有進行任何推論工作。相關討論:ROCm/TheRock issue #9141。該討論涵蓋不同 GPU 世代與軟體;本文只記錄我的 GFX11/
gfx1100雙卡實測,不能推論所有 AMD GPU 的相同症狀都能用這份修補解決。下文那次長提示停滯的根因,也仍然未確認。
修正方法:Kernel修補(Fix — Kernel Patch)
重要:任何想嘗試這個修補的人,都必須先備份並保留原本可正常開機的核心、對應的
/lib/modules/<原核心版本>/與 initramfs,並確認 GRUB 仍可選擇舊核心。不要覆蓋或刪除唯一可用的核心。若新核心無法開機,應能從 GRUB 切回原版;若完全當機,可能需要實體重啟電腦。修補附件:ubuntu-7.0.0-38-mesfix.patch「此附件僅在 Ubuntu 26.04.1、核心套件 7.0.0-38.38 上驗證;其他核心版本需要確認或移植。」
附件是這次實際使用的核心原始碼修補檔,並非一鍵安裝程式或預先編譯的核心套件。它是針對 Ubuntu
linux-source-7.0.0套件7.0.0-38.38移植;該份原始碼的 Makefile 版本為 7.0.14。其他核心版本可能需要重新移植,不能假設能直接套用。如果想自行compile mesfix patch 參考這個指南: Strata-ROCm-MES-核心修補編譯指南.md
修補來源是 AMD 維護者的 MES workaround backport 分支,包括 MES 通知 API、KFD 與 user queue workaround、計時器微秒單位修正,以及 SR-IOV 的區別處理。另納入 GPU reset 期間跳過 user-queue 通知的保護。為配合 Ubuntu 7.0 原始碼,調整了 queue removal 的對應位置,並補上
amdgpu_reset.hinclude。這是上游修補的本機移植與整合,並非我原創的排程器修正。本機採用獨立核心版本
7.0.14-strata-mesfix1,保留原版7.0.0-38-generic及其復原選項。這是另外安裝一個核心,不需要重新安裝 Ubuntu。測試時的設定:
# /etc/modprobe.d/amdgpu.conf options amdgpu sched_policy=0GPU_MAX_HW_QUEUES=8前者是開機載入 AMDGPU 驅動時使用的設定;後者是 Strata 引擎程序的環境變數。更改前者後,本機有重新產生 initramfs 並重新開機。進入修補核心後,已以
uname -r與/sys/module/amdgpu/parameters/sched_policy確認核心版本及實際值為 0,並確認 ROCm/HIP 可偵測兩張 GPU。本機測試環境為 Ubuntu 26.04.1 LTS、雙 Xeon E5-2673 v4、256 GiB RAM、Sapphire Nitro+ 與 XFX MERC 310 RX 7900 XTX 雙卡,模型為 Qwen3.8-Flash-Next GSQ-RCO abliterated IQ3_S,context 上限 262,144 tokens。Strata 使用私有 ROCm/HIP 執行環境。本機此前讀到的 MES 韌體版本為
0x86;這套修補中的通知 API 會檢查韌體是否至少為0x70。待機 100% 負載似乎已修復
修補後,以
GPU_MAX_HW_QUEUES=8載入雙卡模型,在初始載入後、各組提示測試後,以及最後壓力測試後觀察待機負載,沒有再看到持續 100% 使用率的情況。觀察方法是在 API 狀態為 idle、沒有排隊請求時,每 2 秒取樣一次;大部分觀察區間為 60 秒。本次合計有 9 組 60 秒觀察,另外有一組 10 秒確認;兩張 GPU 在這些待機取樣中都沒有出現 95% 或以上使用率。
最後一輪壓力測試完成後,模型仍保持載入,60 秒待機結果為:
GPU 使用率 功耗中位數 Sapphire Nitro+ RX 7900 XTX 0% 24 W XFX MERC 310 RX 7900 XTX 0% 21 W 因此,這裡的「似乎修復」是指持續卡在 100% 的症狀未再重現;
GPU_MAX_HW_QUEUES=8壓力測試結果一次 150K 提示測試失敗:模型引擎在 prefill 階段停滯,之後由 watchdog 自行終止。重新載入同一 queue=8 配置後,同一引擎程序連續完成了 12 次 150K 以上的長提示請求,全部通過。
- 本輪修補核心測試總計 27 次請求:26 次成功、1 次失敗,包含暖機及 1K/8K/15K/32K 的短提示組。
- 其中 150K 以上長提示共有 15 次:14 次成功、1 次失敗。
- 失敗發生在初次測試的第二次 150K 正式量測。記錄顯示在 prompt chunk 起點 token 25,088、layer 4 處停止進展;watchdog 偵測到 60 秒無進展後,以
SIGABRT終止引擎,server 回報 exit code-6。 - 之後重新載入模型,先完成 6 次長提示重試(每個長度為 1 次暖機及 2 次量測,組間有待機觀察),再以同一引擎程序完成 6 次交替長提示壓力測試。最後這 6 次請求之間沒有刻意加入等待,也沒有重新載入引擎。
後續 12 次成功結果如下;速度採引擎回報的原生 timings,並非包含 HTTP、tokenization 及 conversation-cache 存放時間的整段牆鐘耗時。
階段 請求 輸入 tokens Prefill tokens/s Decode tokens/s 結果 重新載入後重試/暖機 150K-WARMUP150,000 4,999.7 85.8 通過 重新載入後重試/量測 150K-FIRST150,000 4,504.7 96.0 通過 重新載入後重試/量測 150K-SECOND150,000 4,484.2 99.6 通過 重新載入後重試/暖機 262K-WARMUP261,632 4,857.1 91.7 通過 重新載入後重試/量測 262K-FIRST261,632 4,631.9 93.2 通過 重新載入後重試/量測 262K-SECOND261,632 4,677.6 96.3 通過 交替壓力測試/壓力測試 150K-CYCLE1-STRESS150,000 4,744.4 95.5 通過 交替壓力測試/壓力測試 262K-CYCLE1-STRESS261,632 5,083.3 104.0 通過 交替壓力測試/壓力測試 150K-CYCLE2-STRESS150,000 4,693.3 105.6 通過 交替壓力測試/壓力測試 262K-CYCLE2-STRESS261,632 5,060.5 101.6 通過 交替壓力測試/壓力測試 150K-CYCLE3-STRESS150,000 4,899.3 107.6 通過 交替壓力測試/壓力測試 262K-CYCLE3-STRESS261,632 4,952.4 101.7 通過 每次長提示輸出上限及實際輸出均為 256 tokens,關閉 thinking,使用 temperature=0、top-k=1、top-p=1、min-p=0、seed=42。所有成功長提示的
cache_n=0,沒有重用已處理的輸入 tokens;模型都正確找出放在提示開頭、中間及結尾的三組驗證碼。這是合成檢索壓力測試,不代表所有真實工作負載都已驗證。最後獨立的 6 次交替壓力測試,合計處理 1,234,896 個輸入 tokens,中位速度如下:
輸入長度 成功次數 Prefill 中位數 Decode 中位數 150,000 tokens 3/3 4,744.4 tokens/s 105.6 tokens/s 261,632 tokens(接近 262K) 3/3 5,060.5 tokens/s 101.7 tokens/s 結論(Conclusion)
**這份核心修補似乎解決了我這組雙 RX 7900 XTX 在 queue=8 下「沒有推論仍持續 100% GPU 負載」的問題。
但我仍然不確定這是否已經是一個長期穩定的解法,因為測試中確實發生過一次 150K watchdog 停滯。後面的重試及壓力測試通過,並不能消除這次失敗,也不足以證明所有工作負載都穩定。
目前我會把它視為有初步實測支持、仍需更長時間驗證的實驗性 workaround。歡迎其他具有相近 GFX11 環境的人,在先備份並保留原版核心的前提下測試與回報;不要把這篇當作所有 AMD ROCm 系統的通用修復保證。ubuntu-7.0.0-38-mesfix.patch
-
Strata/AMD ROCm:GPU_MAX_HW_QUEUES=8 待機 GPU 持續 100% 負載的核心修補實測
**背景:雖然將
GPU_MAX_HW_QUEUES設為6解決了我的GPU 持續 100% 負載問題,但在多數已測項目中,prefill(提示處理)與 decode(生成)速度比目前 queue=8 的配置慢。因此我嘗試保留 queue=8,改從核心驅動修補這個問題。根本原因(Root Cause)
在 AMD ROCm/Ubuntu 環境下執行 Strata 推論引擎(v0.143,搭配社群 #pr1 fork)時,即使處於待機狀態,GPU 使用率仍持續維持在 100%,通常是由一個已知的硬體排程器錯誤所造成,涉及多媒體引擎排程器(Multimedia Engine Scheduler,MES)的韌體。
當 HIP/ROCm streams 透過 MES(
mes_v11_0_add_hw_queue)建立多個硬體佇列,或與這些佇列互動時,引擎會觸發amdgpu_ring_commit內部的緊密輪詢迴圈。這會使rocm-smi與作業系統持續回報 100% GPU 使用率,並讓顯示卡維持在高功耗狀態,即使當下完全沒有進行任何推論工作。相關討論:ROCm/TheRock issue #9141。該討論涵蓋不同 GPU 世代與軟體;本文只記錄我的 GFX11/
gfx1100雙卡實測,不能推論所有 AMD GPU 的相同症狀都能用這份修補解決。下文那次長提示停滯的根因,也仍然未確認。
修正方法:Kernel修補(Fix — Kernel Patch)
重要:任何想嘗試這個修補的人,都必須先備份並保留原本可正常開機的核心、對應的
/lib/modules/<原核心版本>/與 initramfs,並確認 GRUB 仍可選擇舊核心。不要覆蓋或刪除唯一可用的核心。若新核心無法開機,應能從 GRUB 切回原版;若完全當機,可能需要實體重啟電腦。修補附件:ubuntu-7.0.0-38-mesfix.patch「此附件僅在 Ubuntu 26.04.1、核心套件 7.0.0-38.38 上驗證;其他核心版本需要確認或移植。」
附件是這次實際使用的核心原始碼修補檔,並非一鍵安裝程式或預先編譯的核心套件。它是針對 Ubuntu
linux-source-7.0.0套件7.0.0-38.38移植;該份原始碼的 Makefile 版本為 7.0.14。其他核心版本可能需要重新移植,不能假設能直接套用。如果想自行compile mesfix patch 參考這個指南: Strata-ROCm-MES-核心修補編譯指南.md
修補來源是 AMD 維護者的 MES workaround backport 分支,包括 MES 通知 API、KFD 與 user queue workaround、計時器微秒單位修正,以及 SR-IOV 的區別處理。另納入 GPU reset 期間跳過 user-queue 通知的保護。為配合 Ubuntu 7.0 原始碼,調整了 queue removal 的對應位置,並補上
amdgpu_reset.hinclude。這是上游修補的本機移植與整合,並非我原創的排程器修正。本機採用獨立核心版本
7.0.14-strata-mesfix1,保留原版7.0.0-38-generic及其復原選項。這是另外安裝一個核心,不需要重新安裝 Ubuntu。測試時的設定:
# /etc/modprobe.d/amdgpu.conf options amdgpu sched_policy=0GPU_MAX_HW_QUEUES=8前者是開機載入 AMDGPU 驅動時使用的設定;後者是 Strata 引擎程序的環境變數。更改前者後,本機有重新產生 initramfs 並重新開機。進入修補核心後,已以
uname -r與/sys/module/amdgpu/parameters/sched_policy確認核心版本及實際值為 0,並確認 ROCm/HIP 可偵測兩張 GPU。本機測試環境為 Ubuntu 26.04.1 LTS、雙 Xeon E5-2673 v4、256 GiB RAM、Sapphire Nitro+ 與 XFX MERC 310 RX 7900 XTX 雙卡,模型為 Qwen3.8-Flash-Next GSQ-RCO abliterated IQ3_S,context 上限 262,144 tokens。Strata 使用私有 ROCm/HIP 執行環境。本機此前讀到的 MES 韌體版本為
0x86;這套修補中的通知 API 會檢查韌體是否至少為0x70。待機 100% 負載似乎已修復
修補後,以
GPU_MAX_HW_QUEUES=8載入雙卡模型,在初始載入後、各組提示測試後,以及最後壓力測試後觀察待機負載,沒有再看到持續 100% 使用率的情況。觀察方法是在 API 狀態為 idle、沒有排隊請求時,每 2 秒取樣一次;大部分觀察區間為 60 秒。本次合計有 9 組 60 秒觀察,另外有一組 10 秒確認;兩張 GPU 在這些待機取樣中都沒有出現 95% 或以上使用率。
最後一輪壓力測試完成後,模型仍保持載入,60 秒待機結果為:
GPU 使用率 功耗中位數 Sapphire Nitro+ RX 7900 XTX 0% 24 W XFX MERC 310 RX 7900 XTX 0% 21 W 因此,這裡的「似乎修復」是指持續卡在 100% 的症狀未再重現;
GPU_MAX_HW_QUEUES=8壓力測試結果一次 150K 提示測試失敗:模型引擎在 prefill 階段停滯,之後由 watchdog 自行終止。重新載入同一 queue=8 配置後,同一引擎程序連續完成了 12 次 150K 以上的長提示請求,全部通過。
- 本輪修補核心測試總計 27 次請求:26 次成功、1 次失敗,包含暖機及 1K/8K/15K/32K 的短提示組。
- 其中 150K 以上長提示共有 15 次:14 次成功、1 次失敗。
- 失敗發生在初次測試的第二次 150K 正式量測。記錄顯示在 prompt chunk 起點 token 25,088、layer 4 處停止進展;watchdog 偵測到 60 秒無進展後,以
SIGABRT終止引擎,server 回報 exit code-6。 - 之後重新載入模型,先完成 6 次長提示重試(每個長度為 1 次暖機及 2 次量測,組間有待機觀察),再以同一引擎程序完成 6 次交替長提示壓力測試。最後這 6 次請求之間沒有刻意加入等待,也沒有重新載入引擎。
後續 12 次成功結果如下;速度採引擎回報的原生 timings,並非包含 HTTP、tokenization 及 conversation-cache 存放時間的整段牆鐘耗時。
階段 請求 輸入 tokens Prefill tokens/s Decode tokens/s 結果 重新載入後重試/暖機 150K-WARMUP150,000 4,999.7 85.8 通過 重新載入後重試/量測 150K-FIRST150,000 4,504.7 96.0 通過 重新載入後重試/量測 150K-SECOND150,000 4,484.2 99.6 通過 重新載入後重試/暖機 262K-WARMUP261,632 4,857.1 91.7 通過 重新載入後重試/量測 262K-FIRST261,632 4,631.9 93.2 通過 重新載入後重試/量測 262K-SECOND261,632 4,677.6 96.3 通過 交替壓力測試/壓力測試 150K-CYCLE1-STRESS150,000 4,744.4 95.5 通過 交替壓力測試/壓力測試 262K-CYCLE1-STRESS261,632 5,083.3 104.0 通過 交替壓力測試/壓力測試 150K-CYCLE2-STRESS150,000 4,693.3 105.6 通過 交替壓力測試/壓力測試 262K-CYCLE2-STRESS261,632 5,060.5 101.6 通過 交替壓力測試/壓力測試 150K-CYCLE3-STRESS150,000 4,899.3 107.6 通過 交替壓力測試/壓力測試 262K-CYCLE3-STRESS261,632 4,952.4 101.7 通過 每次長提示輸出上限及實際輸出均為 256 tokens,關閉 thinking,使用 temperature=0、top-k=1、top-p=1、min-p=0、seed=42。所有成功長提示的
cache_n=0,沒有重用已處理的輸入 tokens;模型都正確找出放在提示開頭、中間及結尾的三組驗證碼。這是合成檢索壓力測試,不代表所有真實工作負載都已驗證。最後獨立的 6 次交替壓力測試,合計處理 1,234,896 個輸入 tokens,中位速度如下:
輸入長度 成功次數 Prefill 中位數 Decode 中位數 150,000 tokens 3/3 4,744.4 tokens/s 105.6 tokens/s 261,632 tokens(接近 262K) 3/3 5,060.5 tokens/s 101.7 tokens/s 結論(Conclusion)
**這份核心修補似乎解決了我這組雙 RX 7900 XTX 在 queue=8 下「沒有推論仍持續 100% GPU 負載」的問題。
但我仍然不確定這是否已經是一個長期穩定的解法,因為測試中確實發生過一次 150K watchdog 停滯。後面的重試及壓力測試通過,並不能消除這次失敗,也不足以證明所有工作負載都穩定。
目前我會把它視為有初步實測支持、仍需更長時間驗證的實驗性 workaround。歡迎其他具有相近 GFX11 環境的人,在先備份並保留原版核心的前提下測試與回報;不要把這篇當作所有 AMD ROCm 系統的通用修復保證。ubuntu-7.0.0-38-mesfix.patch
-
-




 版主审定:本帖设为优秀,作者 +3 积分奖励,继续加油!