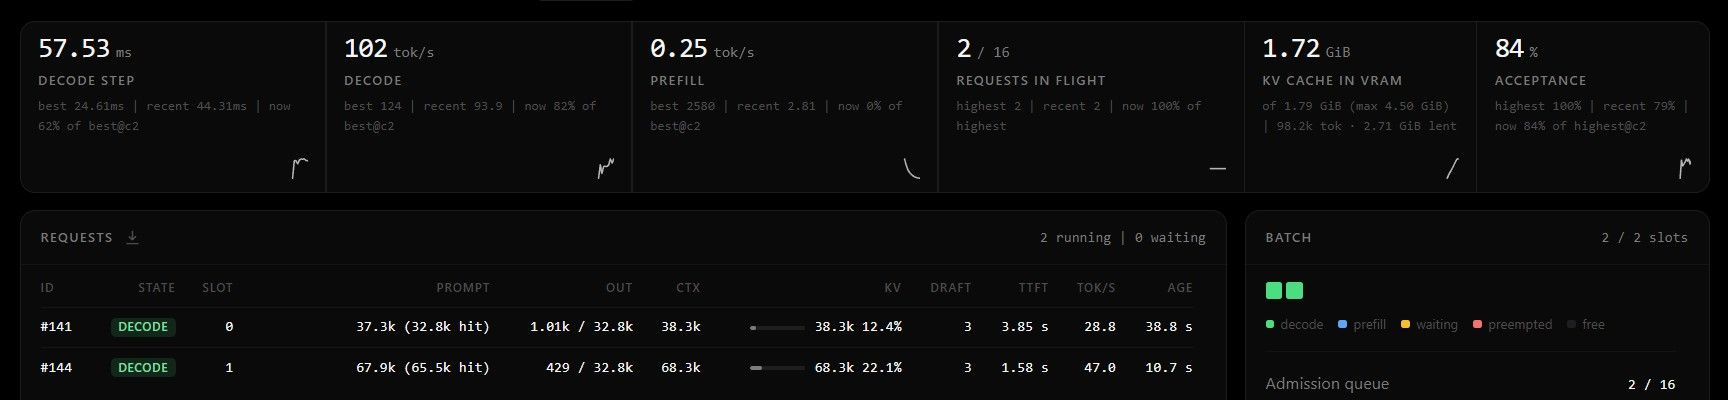
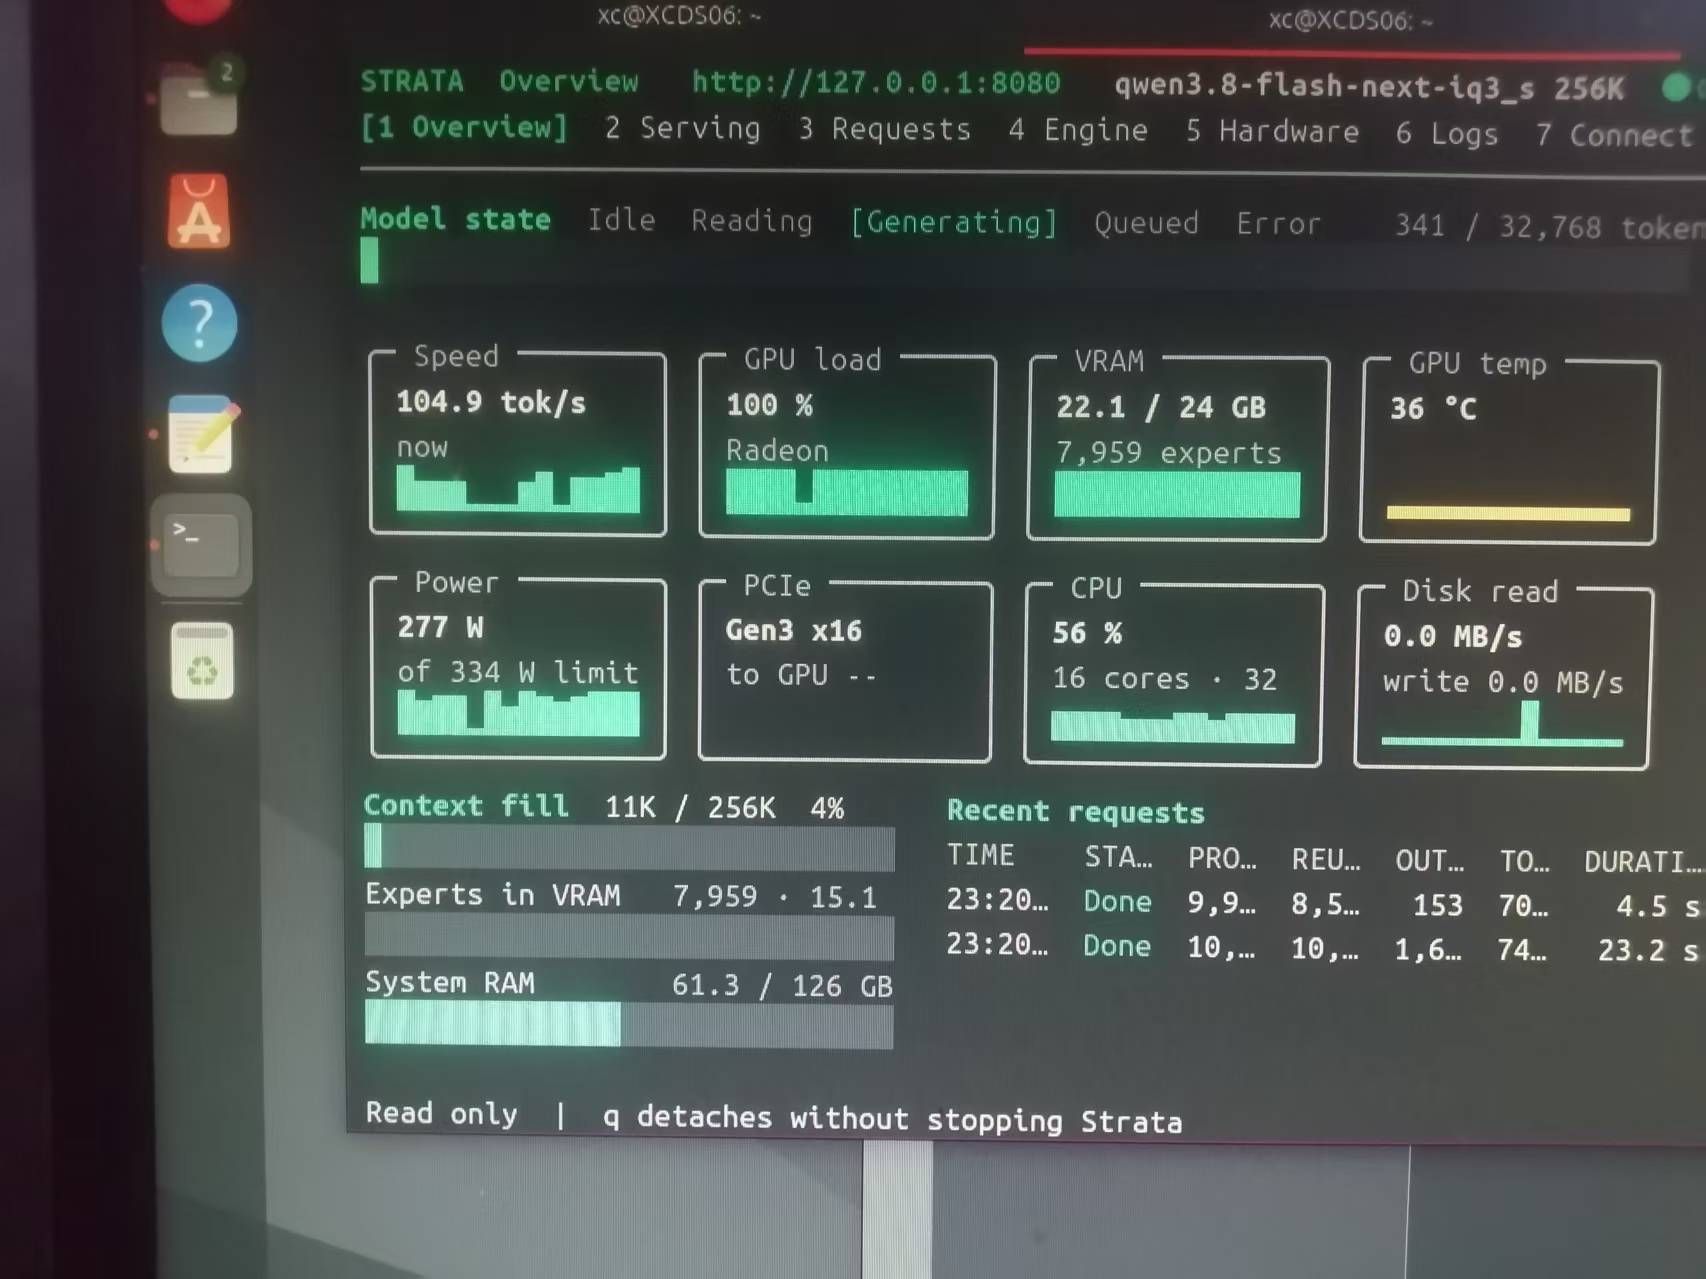
【分享】原地升天!R9700x2 从 Qwen3.8-27B-MXFP4 到 Qwen3.8-Flash-Next IQ4_R
-
最近用RADIANCE都是用這個模型
https://huggingface.co/frank8465/Swift-1.5-Qwen3.8-Flash-Next-GPTQ-W4A8-Radiance-AMD-R9700
比原廠慢一點,但品質好。@paul-hou 请问未审查的模型有推荐的吗?我现在用的是作者转的https://huggingface.co/StillDeadcode/qwen3.8-next-flash-uncensored-fp8-iq4r-moe
-
-
-
@terry 已经从vllm 分出来了
之前是vllm 的fork
现在完全脱离出来 用c++重写 -
@paul-hou 请问未审查的模型有推荐的吗?我现在用的是作者转的https://huggingface.co/StillDeadcode/qwen3.8-next-flash-uncensored-fp8-iq4r-moe
-
-
最近用RADIANCE都是用這個模型
https://huggingface.co/frank8465/Swift-1.5-Qwen3.8-Flash-Next-GPTQ-W4A8-Radiance-AMD-R9700
比原廠慢一點,但品質好。 -
@linkdesu 测一测512k context context offload 去ram strata 唯一的好处就是长上下文几乎没衰减
radiance用qfn也幾乎沒衰減,27B就衰減的很快比不上 sly vllm和paiton vllm,現在的radiance不算是vllm,已經是獨立的引擎和框架了,優點就是啟動不用一分鐘,vllm都是3分鐘起步。
说的我都心动了,现在是2块7900XTX 在跑QFN 。另两块9700 闲置。
已经采购电源模块准备折腾
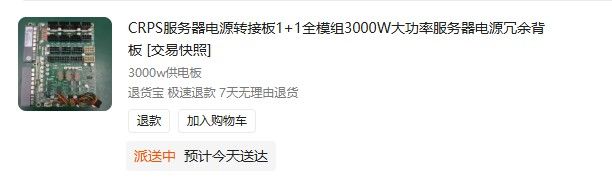
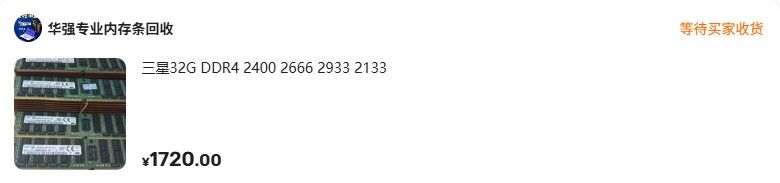
-
-
-
-
-
-
-
-
-
-
@linkdesu 国内的魔塔社区没这个模型吗?
-
-






 本帖参与讨论人数已达 10+,入选热议,作者 +3 积分奖励!