跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
坤

坤坤

@坤坤
德高望重 劳动模范
取消关注 关注
关于
帖子
55
主题
6
分享
0
群组
2
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 关于双AMD RX7900XTX的使用感受
    坤 坤坤
    AI硬件 7900xtx amd 多卡部署

    我的主板是
    处理器 Intel Core i7-10700K @ 3.80GHz(8核16线程)
    显卡 2张 AMD Radeon RX 7900 XTX(gfx1100)——XFX 一块 + Sapphire 一块
    内存 62GiB(约64GB)ddr4
    磁盘 1块 NVMe 1.9TB:系统盘 /(190G ext4,已用93%)+ 新加卷(1.7T ntfs,挂载到 /media/qiankun/新加卷)
    系统 Ubuntu 22.04.5 LTS(内核 6.8.0-138-generic,GNOME Wayland)
    主板是 华硕 z590 吹雪
    部署到模型:Qwen3.8-27B-Uncensored-GPTQ-Int4-sym-G128-MTP-BF16

    我是按照https://github.com/StevenChenSE/vllm/tree/feat/dflash-perf-opt 这个项目去编译本地vllm的
    关于速度的话其实我已经满意了,聚合测试下,2并发达到85t/s,4并发达到40t/s
    长上下文的话接近200k是基本在50t/s左右
    这个速度是我连接codex调用模型和hermes还有DSH调用模型观察出来的,不是机器短测试
    模型运行起来,第一句话会久一点,大概1分钟半,第二句话的就基本在5秒左右就能看懂响应
    用起来给我的体感特别好,就像用在线模型一样,然后我是驾校文员嘛,本地处理学员资料的话
    调用Qwen3.8-27b的这个模型都能完成我的任务
    用codex目前也在按照我的想法制作《我的世界》,看看多久才能做出来
    Hermes作为主智能体就是工作干活
    DSH基本作为玩具,经常就是调用模型来写插件
    总体来说,已经非常棒了,两张卡二手,一张去年4000收的,一张今年4700收的,加上主板其他总价值在1w5左右的机器
    耗电来说我正常使用下来白天干活,我睡觉就关机,耗电是4.5度电,运行时间早上9点到晚上12点
    因为处理器是10代的原因,主板走的是PCIE3.08的通道 速度才这么些,如果我换了cpu支持PCIE4.0的话,速度将会更快,如果换了主板,支持原生Pcle4.016或者pcie5.0点话,我估计无论是输入速度或者输出速度,会更快
    还有就是我用的双电源,另外一张电源是给一张显卡独立供电的
    下面是我让我的hermes总结编译踩的坑,如果有什么其他问题可以给我留言,我会让我的小马获取数据发出来

    从 GitHub 源码编译 vLLM(ROCm 版)踩坑全记录

    环境:Ubuntu 22.04 裸机 + 双 AMD Radeon RX 7900 XTX(gfx1100)+ ROCm 7.2
    源码:GitHub fork(含 DFlash2 / MTP 投机解码魔改,feat/dflash-perf-opt 分支,1282 个提交)
    安装方式:venv(Python 3.12)+ pip install -e . 可编辑安装
    成品版本:0.1.dev1159+gd9d13a27b.rocm721(rocm 后缀 = ROCm 构建,这是正常的)

    先说结论:整条路走通了。编译阶段 6 个坑,运行阶段 3 个坑,全部踩平。最终测试结果:单请求实测 73.2 ~ 82.6 tok/s(Qwen3.8-27B GPTQ Int4 + 自带 MTP 投机解码,双卡 TP2,草稿接受率 84%)。下面按时间顺序讲每个坑怎么踩的、怎么解决的。


    一、源码阶段:3 个坑

    坑 1:GitHub 国内直连不通,大仓库拉不下来

    症状:git clone https://github.com/... 直接超时,连网页都打不开。

    解决:换 ghfast.top 镜像代理:

    git clone https://ghfast.top/https://github.com/StevenChenSE/vllm.git
    

    小仓库直连有时能过,但 vLLM 这种仓库体积大,必须走镜像。ghproxy.net 和 mirror.ghproxy.com 实测不通,别浪费时间试。

    坑 2:浅克隆让版本管理器报警(虚惊)

    症状:编译一开始就刷警告:

    UserWarning: "/home/qiankun/vllm-dflash" is shallow and may cause errors
    

    还顺带导致版本号算出来是 0.1.dev1159+g... 这种丑样子,看起来像编译出问题了。

    解决:不用解决。git clone --depth 1 浅克隆会让 setuptools_scm 没法从 tag 推算正式版本号,于是退化成 dev 版本号。它自己说了"may cause errors"——实测没造成影响,功能完好。为了一个好看的版本号去 git fetch --unshallow 重拉几个 G,不值。

    坑 3:PyPI 的默认 wheel 是 CUDA 版,装了也白装

    症状:之前图省事 pip install vllm 装的是 PyPI 默认包,结果在 AMD 卡上直接失败——因为 PyPI 上的 wheel 是给 NVIDIA CUDA 编的。

    解决:AMD 卡必须走 ROCm 构建。先装了官方 ROCm wheel(vllm 0.28.0+rocm723)顶着用,后来要跑魔改分支的投机解码功能,只能回退到源码编译:

    /home/qiankun/vllm-venv/bin/pip install -e /home/qiankun/vllm-dflash
    

    -e(editable)的好处:改一行源码,重启就生效,不用反复重新打包。安装时 pip 自动发现并卸载了旧的 0.28.0+rocm723 wheel,干净替换,这一步没出幺蛾子。


    二、编译阶段:3 个坑

    坑 4:C++ 扩展编译时满屏 deprecated 警告

    症状:编译 csrc 阶段(C++/HIP 代码编译成 .so)刷出一堆:

    csrc/cumem_allocator_compat.h:45:26: warning:
    'hipError_t hipCtxGetCurrent(ihipCtx_t**)' is deprecated:
    This API is marked as deprecated and might not be supported in future releases
    

    看着很吓人,像要挂。

    解决:不用管,全是警告不是错误。ROCm 在标一批旧 HIP API 弃用,vLLM 的兼容层还在用。只要最后看到 Successfully installed ... vllm-0.1.dev1159+...rocm721 就是成功。判别标准只有一条:error 才是事故,warning 是噪音。

    坑 5:GLIBCXX_3.4.31 not found(最隐蔽的一个)

    症状:编译明明成功了,一跑 import vllm 直接崩:

    ImportError: /lib/x86_64-linux-gnu/libstdc++.so.6:
    version 'GLIBCXX_3.4.31' not found
    (required by .../torch/lib/libtorch_python.so)
    

    torch 的 ROCm 版是按较新的系统 C++ 运行时编的,Ubuntu 22.04 自带的 libstdc++ 只有 GLIBCXX 3.4.28,差一个版本都不行。这个坑最隐蔽——它不在编译期暴露,编译全绿、安装成功,直到第一次 import 才炸。

    解决:从 ROCm/torch 包里拿一个新版 libstdc++ 放到独立目录,启动时用 LD_LIBRARY_PATH 指过去:

    # /home/qiankun/libs/libstdc++.so.6 携带 GLIBCXX_3.4.32
    export LD_LIBRARY_PATH=/home/qiankun/libs:/opt/rocm/lib:/opt/rocm/lib64
    

    这个 export 必须写进启动脚本(start-kernelogic.sh 第一行),漏掉它 torch 就起不来。注意:这条只影响 vllm 自己的环境——我后来用系统 python 查 GPU 风扇的时候就因为没带这个路径,"GPU 负载测试"白跑了两分钟,GPU 根本没收到负载,还以为风扇有问题。教训:测 GPU 之前先确认 python 进程真的活着在吃卡。

    坑 6:编译日志没有时间戳,耗时算不清

    症状:想知道编译到底花了多久,翻 vllm-build.log 发现里面除了 pip 的输出什么都没有时间戳,948 行里全是 "Running command xxx: started / finished"。

    解决:用日志文件修改时间 + 启动日志里的时间戳交叉推算:编译完成时间(build log mtime 22:30 前后)到 serve 日志里第一条 worker 时间戳(23:05)的间隔,再加上引擎自报的 "compilation: 54.87 s",基本能对上是十几分钟的量级。以后想精确计时,编译命令套一层 time pip install -e . 2>&1 | tee build.log 就一劳永逸——这次是事后补的,没留干净数据,不装懂。


    三、运行阶段:3 个坑

    坑 7:双卡 TP=2 一启动就 NCCL 崩

    症状:--tensor-parallel-size 2 启动直接崩,NCCL 通信初始化失败。

    解决:ROCm 双卡 IPC 的祖传问题,两行环境变量钉死:

    export HSA_ENABLE_IPC_MODE_LEGACY=0    # 关旧 IPC 模式
    export HSA_FORCE_FINE_GRAIN_AMDGPU=1    # 强制细粒度内存
    

    一个都不能少。TP=1 能跑但模型塞不下,TP=2 又必崩——卡就这两张,没得选,只能修。

    坑 8:首次启动"卡死"3 分钟,其实是在编译

    症状:启动后日志停在 CUDA graph 捕获进度条上,几分钟没动静,人已经准备 ctrl+c 了。

    解决:等。真实数据在这台机器上的日志里写得明明白白:

    init engine (profile, create kv cache, warmup model) took 174.56 s
    (compilation: 54.87 s)
    Capturing CUDA graphs (PIECEWISE): 27/27 [00:11]
    Capturing CUDA graphs (FULL):      15/15 [00:05]
    

    首次启动总耗时约 3 分钟:torch.compile 编译 55 秒 + Triton 按 shape JIT 编译 kernel + 两轮 CUDA graph 捕获(分段图 11 秒 + 完整图 5 秒)。这是正常流程不是死锁。之后缓存落盘,重启只要约 2 分钟。唯一的例外:清掉 ~/.triton/cache 会重新计时。

    坑 9:进程杀不干净,重启必 OOM

    症状:APIServer 崩了(exit 1,日志里没 traceback),端口空了、curl /health 不通,感觉服务没了——但下次一重启就报:

    ValueError: Free memory on device cuda:0 (1.29/23.98 GiB) on startup
    is less than desired GPU memory utilization (0.95, 22.79 GiB)
    

    根因:vLLM 是多进程架构,主 API 进程崩了,Worker/EngineCore 会变成孤儿进程残留继续霸占显存。更坑的是 rocm-smi --showpids | grep python 查不到它们——孤儿进程名是 VLLM::Worker_TP / VLLM::EngineCor,不带 "python" 字样。

    解决:

    rocm-smi --showpids          # 找 VLLM:: 开头、显存占用非 0 的进程
    kill -9 <PID1> <PID2> ...    # Worker_TP0/TP1 + EngineCore 全杀
    rocm-smi --showpids | grep VLLM   # 确认清空再重启
    

    另外别用 pkill -9 -f vllm——会把自己 shell 命令里带 "vllm" 字样的部分一起杀掉,进程看起来"杀了又复活",其实是 pgrep 匹配到了自己。判真伪只认两条:端口(ss -ltn)和显存(rocm-smi)。


    四、最终测试结果(真实数据)

    服务起在 8655 端口,模型为 kernelogic Qwen3.8-27B(GPTQ Int4 + 自带 MTP 投机解码,双卡 TP2)。

    项目 结果
    健康检查 /health 返回 200
    单请求速度(400 token,实时实测) 400 tok / 5.5s = 73.2 tok/s
    单请求速度(800 token,复测) 82.6 tok/s
    稳定区间 77.8 ~ 82.6 tok/s
    MTP 草稿接受率 84%(接受 1 次出 2 个 token)
    引擎初始化(首次) 174.56 秒(其中编译 54.87 秒)
    CUDA graph 捕获 PIECEWISE 27 档 11 秒 + FULL 15 档 5 秒
    KV cache 10.99 GiB,max-model-len 200000 撑得住

    对照:加 MTP 之前同模型同双卡是 ~58 tok/s,加了自带 MTP 之后到 77.8+,提速约 34%。这个提速是接口口径的均速(completion_tokens ÷ 总耗时,含思考 token),不是峰值——自回归生成是稳态过程,均速就等于实际速度。

    回答"体感慢"的常见疑问:这个模型思考很长,而思考部分和正文是同一个解码速度,所以体感慢的锅不在引擎,在思考长度。想快只能压思考(--reasoning-parser qwen3 已配,把思考抽到 reasoning 字段不污染正文),再往上提只能换模型。


    五、一张表总结所有坑

    # 坑 阶段 症状 解法
    1 GitHub 直连不通 拉源码 clone 超时 走 ghfast.top 镜像
    2 浅克隆版本报警 编译 "shallow may cause errors" 虚惊,忽略
    3 PyPI wheel 是 CUDA 版 安装 AMD 卡上直接失败 用 ROCm 构建(rocm 后缀)
    4 HIP API deprecated 警告 编译 满屏 warning 是 warning 不是 error,忽略
    5 GLIBCXX_3.4.31 缺失 运行 import 崩,最隐蔽 LD_LIBRARY_PATH 指新版 libstdc++
    6 日志无时间戳 计时 算不清编译耗时 以后 tee + 交叉验证
    7 TP=2 NCCL 崩 运行 双卡通信失败 两行 HSA 环境变量
    8 首启"卡死"3 分钟 运行 像死锁 等,实际在 JIT 编译 + 捕图
    9 孤儿进程霸显存 运行 重启必 OOM rocm-smi 按 VLLM:: 精确杀

    一句话血泪总结:编译阶段 6 个坑里只有 GLIBCXX 是真坑(其余是虚惊或镜像问题),运行阶段 3 个坑个个"差一个参数就崩"。坑不可怕,可怕的是每个坑的报错都像别的事——NCCL 崩像驱动问题、OOM 像显存不够、import 崩像编译失败。诊断顺序永远是:看进程是不是真的活着(端口+显存)→ 看日志里第一条真实报错 → 再动手。
  • RX7900xtx白金版 24G 跑Qwen3.8-27B Q4_0_ROCMFP4_FAST 模型 单卡60tok/s
    坤 坤坤
    AI Agent 7900xtx qwen-27b rocm

    系统:win11
    主板:Gigabyte B560M D2V
    CPU:i7-10700K
    内存:64GB ddr4
    后端:llama.cpp+后编译的rocmFB4版(这个版本我是让ai去调取官方仓库为和这个模型和根据本地配置编译的)

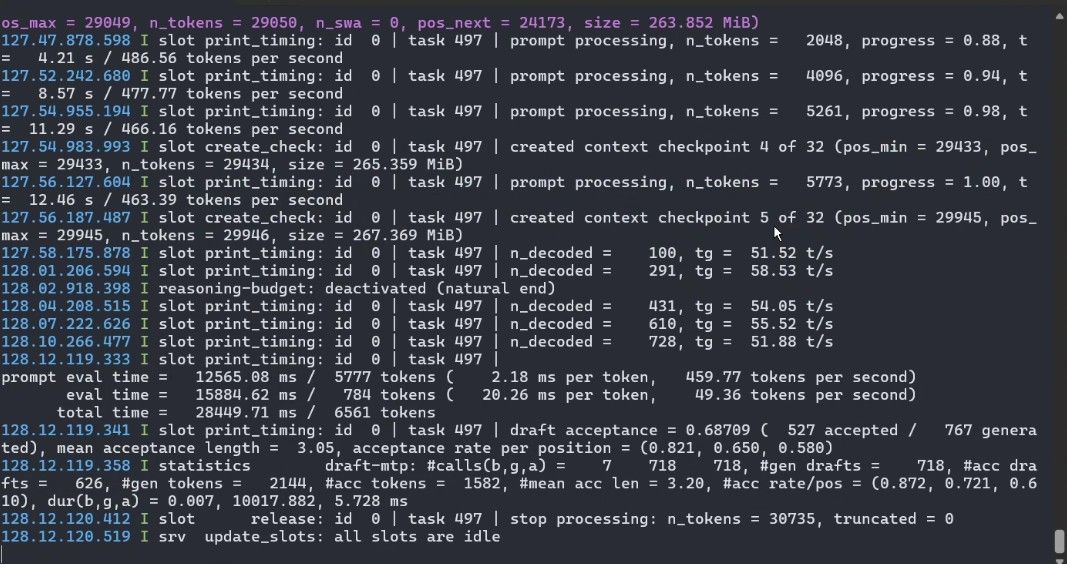
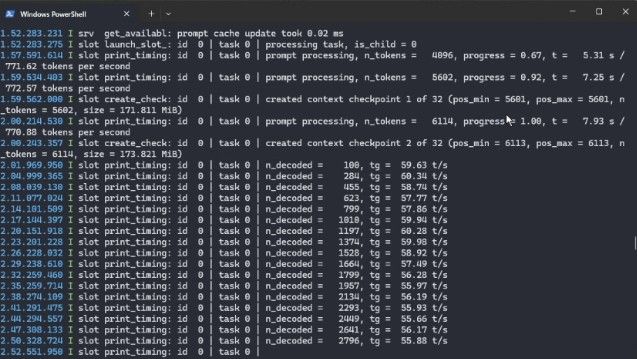
    先说下我的情况,模型第一次冷启动基本2分钟左右,然后初始速度是60tok/s左右
    26f3ec14-7745-4bde-9ba8-75d8ee17e74f-image.jpeg
    这个时候上下文在16k左右
    如果是开着思考的话,那么一次任务的思考,会造成上下文越来越多

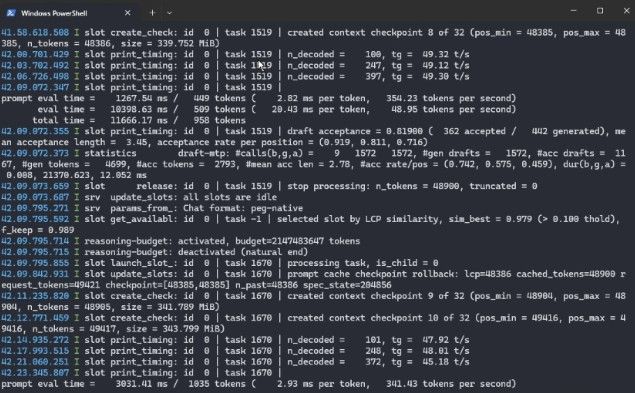
    在上下文达到32k左右,那么速度回降到45tok/s
    4c0d4292-9f9b-4aff-bd22-6d78527e0e91-image.jpeg
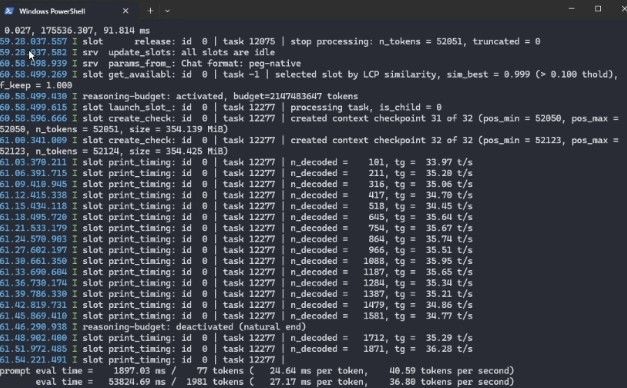
    如果上下文达到64k左右,那么速度会继续降到30tok/s附近
    54dec9e1-5a6e-4f63-9d0a-aaf1476ddb75-image.jpeg

    我试过用128k上下文,基本模型的上下文达到64k后,速度就稳定在30附近了
    对此,如果是短任务的话只能坐一次然后手动去停掉模型然后重新启动,并且dsh这边要手动压缩上下文

    当然,关掉思考模式的话确实像锤哥说的一样,体感反应速度真的很舒服,单纯聊聊天还是可以的

    我也不想没错开关思考模型都要启动模型一遍,就让它自己加上了网页端可以设置思考或者不思考的选

    任务方面的话我已经测试过了,短任务,比如登录某个网站上去查询数据下来放表格,我工作上的事情已经能做并且完美完成,唯一的确定就是慢。

    思考链又臭又长,我只能交代繁琐重复的任务让他执行,然后我去干别的活,长代码方面我就没试过了,但是根据别的朋友反馈说代码能力很强

    关于这个降速的问题我怀疑是因为思考时候产生的上下文溢出到内存了,才导致速度变慢,我打算看什么时候再收一张7900xtx进行双卡测试,如果真的是这个原因,并且得到解决的话,那我真的不用花钱去订阅了,60tok/s对我来说刚好

    下面是我的启动参数
    .\llama-server.exe -m moxing\Qwen3.8-27B-Q4_0_ROCMFP4_FAST.gguf
    --model-draft moxing\mtp-Qwen3.8-27B-Q8_0.gguf
    --spec-type draft-mtp
    --spec-mtp-strict-qwen
    --spec-draft-ngl 99
    --spec-draft-n-max 3
    --spec-draft-n-min 0
    --spec-draft-p-min 0.0
    --host 0.0.0.0 --port 8655
    -c 128000 -b 2048 -ub 512
    --flash-attn on -np 1
    --kv-unified
    --cache-ram 8192
    --cache-type-k q4_0
    --cache-type-v q4_0
    --repeat-last-n 64
    --repeat-penalty 1.05
    --presence-penalty 0.0
    --frequency-penalty 0.0
    --temp 0.6 --top-p 0.85
    --top-k 40 --min-p 0.05
    --mmap
    --jinja -fit off -dio --jinja --chat-template-file chat_template.jinja

    .\llama-server.exe -m moxing\Qwen3.8-27B-Q4_0_ROCMFP4_FAST.gguf --model-draft moxing\mtp-Qwen3.8-27B-Q8_0.gguf --spec-type draft-mtp --spec-mtp-strict-qwen --spec-draft-ngl 99 --spec-draft-n-max 3 --spec-draft-n-min 0 --spec-draft-p-min 0.0 --host 0.0.0.0 --port 8655 -c 70000 -b 2048 -ub 512 --flash-attn on -np 1 --kv-unified --cache-ram 8192 --cache-type-k q4_0 --cache-type-v q4_0 --repeat-last-n 64 --repeat-penalty 1.05 --presence-penalty 0.0 --frequency-penalty 0.0 --temp 0.6 --top-p 0.85 --top-k 40 --min-p 0.05 --mmap --jinja -fit off -dio --jinja --chat-template-file chat_template.jinja
    

    同样显卡的兄弟可以去试试,结果跟我说下我看看你们是不是也是同样情况,如果有双卡的哥们试完记得跟我说下


  • 加3080 20G 还是 7900XTX 24G?
    坤 坤坤
    AI硬件 rtx3080 7900xtx

    @neo 给这哥们补充下,7900xtx用llamacpp跑的话q4量化,加mtp,初速是60tps。载入我没关注,上下文超过32k情况下,开始降速,也就是占用显存超过24g了,速度会到45左右,如果上下文超过64k,那么速度会降到30tps左右,如果是开128上下文的话,经过两轮压缩,qwen3.8的占用显存kv池会吧我剩下50多g内存全部吃完然后内存爆炸
    然后关于minmah3的话实际测试下载512521图片40秒左右生成,视频的话也是512512是1秒1分钟16帧数,我不知道为啥生视频居然还更快
    优缺点呢主要是看显存,7900xtx的带宽是960g,如果模型不超过显存24g的话那速度非常快
    如果是部署ornith1.5-35b-a3b的话 128k上下文,初始速度95tps。64k上下文情况下会降速到80tps。上下文到130k的时候会降速到65~70tps附近
    以上数据均用dsh实际场景测试出来,做一个网页ai新闻的收集,最后是qwen3.8完成了,ornith失败了


  • 又下单了一张3090 24G, 但是还是有关于AI硬件的迷惑, 求解… …
    坤 坤坤
    AI硬件 rtx3090

    不不,首先你得问下自己,这个事情做的时候,你喜欢么,你会不会因为这张卡的到来而欣喜,你把未来价值和单纯的兴趣爱好绑定在了一起,你担心你为了兴趣而买东西的时候,是对自己的资源造成浪费,但是你要知道,这其实就是用钱,买了你的快乐,你既然已经花出去了,为什么还要纠结价值损失,你已经有付出了,而且得到收获了,后面你就算不要买了,就算只价值一半,其实就可以认为你用更少的钱提前获取了当前的快乐,你要理清楚,我需要什么?我改付出什么


  • 关于双AMD RX7900XTX的使用感受
    坤 坤坤
    AI硬件 7900xtx amd 多卡部署

    @farmer-node 没有诶,可能你不是死循环,而是思考内容太多太多了,思考开中就行,就是,medium


  • 【求助】关注论坛3个月,没有搞定3090 单卡qwen3.6/3.8 27b模型的生产力部署。求抄作业。
    坤 坤坤
    LLM讨论区 rtx3090 qwen-27b

    上下文的个硬伤,而且这些模型你不能说像api一样完整完成任务,你需要自己去细分,规划,做一个项目号规划书,每个模块都拆成不同的小模块然后制定规范让它去干活才行


  • RX7900xtx白金版 24G 跑Qwen3.8-27B Q4_0_ROCMFP4_FAST 模型 单卡60tok/s
    坤 坤坤
    AI Agent 7900xtx qwen-27b rocm

    @kos-or 97509e2d-8012-4baa-9572-f3b31ddc425d-image.jpeg


  • 双 RX 7900 XTX 跑 88GB 的 MoE:Strata HIP 后端单卡/双卡实测 + 踩坑全记录
    坤 坤坤
    LLM讨论区 7900xtx strata 多卡部署

    环境:i7-10700K(8C16T,无 AVX-512)+ 2× RX 7900 XTX 24GB + 64GB DDR4 + Ubuntu 22.04 / ROCm 7.2.1
    模型:Qwen3.8-Flash-Next-AD-4.27bpw-Q4_K_M-M64(33 分片,89GB,512 专家)
    引擎:Strata v0.1.38 HIP 后端 · 32K 上下文 · int8 KV · --spec 4 投机解码
    实测日期:2026-10-04


    首先说明,这是ai生成的报告,如果不想看内容,建议直接复制丢给ai总结

    TL;DR

    1. 能跑。 单卡 7900 XTX 就能带起 89GB 的 MoE —— 专家权重常驻内存、最热的缓进显存。单卡稳态 decode ≈ 63~66 tok/s、prefill 600+ tok/s。
    2. 双卡只在 prefill 上赢。 多轮对话的追加延迟从 1444ms 砍到 754ms(快 1.9 倍);decode 反而略降(66 → 63),因为 decode 是显存带宽瓶颈,layer-split 每步多一次跨卡同步。
    3. prefill 原本比官方低 35%,根因是自己踩的坑:hipBLASLt 调优表按「架构 + 库版本」精确匹配,官方 gfx1100 只给了 100100/100200 两张,我这台是 100202 → 无表可用 → dense GEMM 走默认路径。自己标定一张接进去,fresh 8.8K prefill 722 → 1016 tok/s(+41%),直接反超官方。
    4. 一共踩了 7 个坑,第 5 个(调优表)是最大的性能损失,第 7 个(大页)是「看起来该做、实测完全没用」的反面教材。

    1. Strata 是什么

    Strata 是一个 MoE 专用推理引擎(https://github.com/Niko1221/Strata)。核心思路和 llama.cpp 不一样:

    • 专家权重不像传统做法那样全塞进显存,而是常驻主机内存,只把路由最频繁的一小撮专家缓存进显存;
    • 显存里的专家直接由 GPU 算,没命中的走 CPU/SSD 路径;
    • 于是 24GB 的消费级卡也能跑 89GB 的大模型。

    它还带一个 opt-in 的 gfx1100 HIP 后端,让 RDNA3 的 A 卡能用上 MMQ、校准过的 hipBLASLt dense GEMM、MTP 投机解码这些优化。

    对「双 7900 XTX + 大内存」这种配置来说,这是目前少数能让两张 XTX 真正一起干活的路径 —— llama.cpp 跑这种体量的 MoE,要么装不下、要么慢到没法用。


    2. 硬件配置(全部实测,非标称)

    项 值
    CPU Intel Core i7-10700K @ 3.80GHz,8C/16T,L3 16MB,无 AVX-512(只有 AVX2)
    主板 ASUS ROG STRIX Z590-A GAMING WIFI
    内存 64GB(2×32GB Corsair DDR4-3200),无 swap,系统可用 62.64 GiB
    GPU 2× Radeon RX 7900 XTX 24GB,gfx1100,PCIe host→device 实测 6.9 GB/s
    存储 aigo NVMe SSD P7000Z 2TB(数据都在这块盘上)
    系统 Ubuntu 22.04.5 LTS,内核 6.8.0-138
    ROCm 7.2.1(HIP 7.2.53211,AMD clang 22)
    hipBLASLt 1.2.2,版本号 100202 ← 记住这个数,坑 5 全靠它

    两个先天短板(后面会反复出现):

    1. CPU 没有 AVX-512 —— 引擎启动时直接点名:
      strata generate: this CPU has no AVX-512: the expert kernels run on AVX-2
      
      官方测试机是 Ryzen 9 7950X3D(16C32T + AVX-512),CPU 侧算专家比我快不少。
    2. 内存只有 64GB 且无 swap —— 而模型光专家就要 47.17 GiB。双卡全驻留会压到危险线。

    3. 模型与引擎:真实的加载方式

    这部分我一开始理解错了,写出来给后来人少走弯路。

    模型:Qwen3.8-Flash-Next-AD-4.27bpw-Q4_K_M-M64,33 个分片共 89GB,架构 qwen4exp,512 个专家。

    Strata 不是把 89GB 全重新打包一遍。 它生成的 pack 目录只有 1.4 GiB:

    packs/iq3_xxs/
      dense.bin          1.42 GiB   ← 只有非专家的 dense/attention 权重
      native_experts.txt     8 KB   ← 48 层专家的清单(偏移表)
      index.txt             91 KB
      tokenizer/
    

    native_experts.txt 的头两行说明了关键机制:

    # strata native experts v4: ... (n_expert 512, total 50646220800;
    #   absolute offsets in Qwen3.8-Flash-Next-AD-4.27bpw-Q4_K_M-M64-00001-of-00033.gguf ...)
    0 21 20 0 2329600 1193596736 1561038656 719996736 ...00003-of-00033.gguf
    

    专家权重根本没被搬走 —— 它们原样留在原来的 33 个 GGUF 分片里,引擎记下每层每专家 gate/up/down 的绝对偏移,运行时直接从分片读。50646220800 字节 = 47.17 GiB,正好等于引擎启动时那句 loaded 47.17 GiB。

    另外两个附件:

    文件 大小 作用
    ple-q5_0.gguf 32.78 GiB PLE(per-layer embedding 表),放 SSD 上按需读
    mtp/rt 787 MiB MTP 草稿层,投机解码用

    磁盘预留:原 GGUF 89GB + Strata-data 41GB ≈ 130GB,而且原 GGUF 必须留着(专家从它读)。

    引擎:Strata v0.1.38,HIP 后端。实测启动参数:

    --expert-cache auto --prefill auto --spec 4 --spec-min-p 0.5
    --mtp .../mtp/rt --max-context 32768 --kv int8 --ple-gguf .../ple-q5_0.gguf
    --layer-split auto
    

    4. 部署步骤

    # 1) 编译(用系统已装的 ROCm 7,不必再下 10GB 的 wheel)
    ./setup.sh --backend hip --family qwen --model IQ3_XXS \
      --gguf-dir /path/to/Qwen3.8-Flash-Next-AD-4.27bpw-Q4_K_M-M64 \
      --data-dir /path/to/Strata-data --context 32768 \
      --gpu 0 --build --no-start --yes
    
    # 2) 单卡启动
    run-iq3_xxs.sh
    #    内部即 serve/server.py --engine strata --config strata-iq3_xxs.json --port 8080
    
    # 3) 双卡:setup 时把 --gpu 0 换成 --gpus 1,0(自动 layer split)
    

    我这台 8C16T 编译耗时 8 分钟(官方标称 10~20 分钟)。


    5. 实测速度

    方法:用官方 tools/hip/bench_prefill.py,同一份合成 prompt(140/280 个 rule 函数),每档先 warmup 一次、再跑 2 轮,每轮先 fresh(零复用 KV)、紧跟一个 followup(带缓存追加)。输出固定 128 token,温度 0 / top-k 1。每组配置独立重启引擎后测量。

    单位 tok/s,括号内是波动范围。

    指标 单卡 双卡 native 双卡 low-RAM
    fresh prefill 4.2K 607 (537~677) 702 (701~703) 479 (439~519)
    fresh prefill 8.8K 628 (621~634) 722 (722~722) 543 (542~543)
    followup prefill(113 token 追加) 78.6 149.8 107.8
    ↳ 这一轮的实际耗时 1444 ms 754 ms 1053 ms
    fresh decode 4.2K 52.0 (40~64) 57.5 (54~60) 52.5 (46~59)
    fresh decode 8.8K 66.0 (65~67) 62.9 (62~64) 60.7 (60~61)
    followup decode 4.2K / 8.8K 50.2 / 61.7 58.3 / 55.8 53.3 / 56.1
    稳态 decode(去掉每档第一枪) ~63 ~59 ~57
    额外内存 ~47GB 常驻,最省 双卡全驻留,最紧 自适应退回 mmap
    VRAM 剩余 624 MiB 598 MiB —

    加调优表之后(见坑 5):

    指标 双卡 native 双卡 native + 调优表 变化
    fresh prefill 4.2K 702 773 (710~836) +10%
    fresh prefill 8.8K 722 1016 (992~1040) +41%
    followup prefill 4.2K 150 221 +47%
    followup prefill 8.8K 153 175 +14%
    decode(各档) 55.8~62.9 55.2~58.5 基本不动

    引擎日志里的关键指标(同一批请求):

    • 显存专家缓存命中率:96.9% ~ 99.5%(第一个冷请求 87.7%,长 prompt 越接近 99.5%)
    • 投机解码接受率:70.6%(3116/4412)
    • layer split 决策:K=22,CUDA1 跑第 22~47 层 + head,CUDA0 跑第 0~21 层;CUDA1 专家缓存 8704 槽(16.81 GiB)
    • PCIe 探测:单卡 6.9 GB/s → pcie_frac 0.19(默认 0.55)

    6. 三个反直觉的结论

    ① 双卡的收益全在 prefill,decode 甚至倒退。

    decode 阶段每生成一个 token 只算一遍专家,瓶颈是显存带宽;layer-split 让每层之后都要跨卡同步一次,纯亏。而 prefill 是把上万 token 一次性塞进去算,compute-bound,两张卡并行摊分,稳赚。

    所以 「双卡加速」是有条件的:看你负载是长 prompt(RAG / 代码库分析 / 长文档)还是长输出(写作 / 聊天)。

    ② followup 那一行的 78.6 → 149.8,不是「吞吐翻倍」,是「每轮固定开销减半」。

    它只处理 113 个新 token,却花了 1444ms(单卡)/ 754ms(双卡)—— 这是 prompt 分块的固定成本。换成体感:多轮对话里,第二轮开始每轮只等 1.44s 还是 0.76s,差一倍。这个才是双卡对聊天场景的实际价值。

    ③ low-RAM 模式掉得比想象中多。

    4.2K prefill 只有 479,比单卡的 607 还低 21%,比双卡 native 低 32%。它换来的是内存安全垫 —— 如果你内存不够又要开双卡,这是唯一能稳跑的选择。


    7. 踩的 7 个坑(含解法)

    坑 1:Strata 不直接吃 GGUF,下载又慢到不能看

    引擎要自己的 pack 目录(见第 3 节)。同时还要额外拿 PLE(32.78 GiB)和 MTP 草稿层(787 MiB)。

    解法:预留 130GB 磁盘,下载走本地代理(我这边是 2080 端口的本地代理),直连速度没法看。原 GGUF 千万别删 —— 专家是从它读的。

    坑 2:引擎要现场编译

    ./setup.sh --backend hip --build。我这台 8C16T 编了 8 分钟(官方标称 10~20 分钟)。依赖 build-essential git;系统要是已经装了 ROCm 7,可以直接复用,不用再下 10GB 的 TheRock wheel。

    坑 3:47GB 常驻内存是硬门槛

    引擎启动时把专家权重常驻主机内存:

    strata generate: loaded 47.17 GiB at 2.58 GiB/s
    

    64GB 的机器单卡勉强够;双卡同时做全量驻留会直接把内存压到危险线。官方为此提供了低内存模式(自适应驻留、装不下就退回 mmap),代价是 prefill 掉 32%(见对照表)。

    注意:双卡 layer-split 模式下引擎还会警告:

    WARNING: the resident RAM mode (--resident-experts) does not support a layer split yet:
    the experts the GPUs do not hold are read through the OS file cache (--mmap-experts),
    and RAM may fill up during long prompts
    

    也就是 GPU 不持有的专家会走 OS 文件缓存,长 prompt 下 RAM 可能要涨。

    坑 4:hipBLASLt 调优表没有可用的(本次最大性能损失)

    官方的调优表是按 (架构 + hipBLASLt 版本) 精确匹配的,表头直接写着版本:

    STRATA_HIPBLASLT_TUNING_V1 gfx1100 100200
    

    引擎会硬校验架构和版本号,对不上就整张拒绝:

    tuning architecture mismatch: file=... runtime=...
    hipBLASLt version mismatch: file=... runtime=...
    

    仓库里 gfx1100 只有两张表:-100100.txt 和 -100200.txt。我这台是 hipBLASLt 1.2.2 = 版本号 100202 —— 两张都对不上。(有意思的是同一个目录里 gfx1200 / gfx1201 都有 100202 的表,唯独 gfx1100 没有。)

    结果:配置里根本没有 STRATA_HIPBLASLT_TUNING,dense 矩阵乘法走默认 GEMM 路径。

    官方在 gfx1200 上量化过这张表的收益:2.4K prompt 提速 1.5x,65K/130K prompt 约 2x。gfx1100 官方没给数字,但机制相同。

    解法 —— 自己标定一张(官方工具就摆在仓库里):

    cmake --build build-hip --target tune_hipblaslt
    
    CASES=$(awk 'NR>2 {printf " --case %s,%s,%s,%s,%s", $1, $5, $2, $3, $4}' \
            tools/hip/gfx1100-hipblaslt-100100.txt)
    ./build-hip/tune_hipblaslt $CASES --tuning-out tools/hip/gfx1100-hipblaslt-100202.txt
    

    几个要点:

    • 形状集取仓库两张 gfx1100 表的并集(30 个形状,100200 那张是它的子集),覆盖更全;
    • 工具自带精度门(relative L2 / max abs / padding 写入检查),跑完 30 条全过、零 reject;
    • 产出的表头就是运行时的真实版本:STRATA_HIPBLASLT_TUNING_V1 gfx1100 100202;
    • 跑完几分钟,然后接进配置(strata-iq3_xxs.json 加一个 env 键):
    "env": {
      "STRATA_HIPBLASLT_TUNING": ".../tools/hip/gfx1100-hipblaslt-100202.txt"
    }
    

    重启后引擎日志会确认(两张卡各一行):

    prefill gemm: hipBLASLt tuning enabled (30 rows, gfx1100, version 100202)
    

    效果:fresh 8.8K prefill 722 → 1016 tok/s(+41%),一次把「比官方低 35%」打成反超。

    ⚠️ 别被工具自己的输出骗了:它报的 speedup_vs_blas 中位数是 5x(最高 18x),那是单条 GEMM 对 plain hipBLAS 的微基准,不是端到端收益。端到端看上面那张表。

    ⚠️ 维护提醒:表是绑死 (架构 + hipBLASLt 版本) 的。升级 ROCm 后版本号一变,表就被拒,要重跑一次标定。

    坑 5:冷启动第一枪很慢

    第一次请求(显存专家缓存未热)decode 只有 39.9 tok/s(warmup 那枪甚至 19),第二枪才回到 64+。

    解法:做基准测试必须先 warmup,否则平均分被第一枪拖死。这也是很多「评测翻车」的来源。

    坑 6:NVMe 卷是 NTFS,断电后拒挂

    这块数据盘是 NTFS 格式。强制断电后重新开机,Linux 会因为 dirty bit 直接拒绝挂载($MFTMirr does not match $MFT)。

    解法:sudo ntfsfix -d /dev/nvmeXnY,再 mount 即可。盘本身没坏,只是上次没正常卸载。

    坑 7:大页 —— 看起来该做,实测完全没用(反面教材)

    引擎启动时会抱怨:

    expert arena: cudaHostRegister PORTABLE ok;
      MAP_HUGETLB unavailable (needed 24152 2 MiB pages, vm.nr_hugepages=0); using 4 KB pages
    

    4KB 页下 47 GiB 要 1200 万个 TLB 项,任何 TLB 都装不下。官方的设计注释也说大页能把 TLB 覆盖翻倍以上。看起来是个大便宜 —— 我去试了,结论是:不值得。

    第一关:运行时根本开不起来。

    引擎要 24152 个 2 MiB 页(= 47.17 GiB,正好等于专家 arena),而 MAP_HUGETLB 是全有全无:池子少一页,整个映射就跟没有池子一样失败。

    尝试 拿到的页数
    sysctl vm.nr_hugepages=24152 12557
    丢 page cache + 反复补池 搬到 19570,然后每次只 +几页
    内存压缩(compact_memory)+ 丢缓存 + 反复补 卡在 19698(38.5 GiB)
    整池释放、压缩、一次性要满 还是 19698(复现两次,非随机)

    根因在 /proc/buddyinfo:运行中的内核 order-9(2 MiB 连续块)恒为 0。内存虽然有 15 GiB 空闲,但已被切碎到没有 2 MiB 连续块,压缩也合并不出来。只能开机预留(内存未碎片化时才能一次拿到):

    # /etc/sysctl.d/99-strata-hugepages.conf
    vm.nr_hugepages = 24152
    

    第二关:代价太大。 62.64 GiB 里内核/驱动先占掉约 9.8 GiB(iommu=pt + amdgpu),能给人用的只有 53 GiB。预留 47.17 GiB 后只剩 5.7 GiB 给整个系统(还没 swap)—— 开个浏览器就可能 OOM,ComfyUI / vLLM 全废。等于把这台机改成「Strata 专用机」。

    第三关:就算成了,也没用。 我换了条零成本的路验证 —— 把 THP(透明大页) 从 madvise 切成 always,arena 的匿名内存在分配时就直接拿 2 MiB 页,不占任何预留:

    引擎进程 RSS 49.56 GiB,其中 AnonHugePages = 38.38 GiB(77%)
    

    覆盖率和预留大页池能给到的 38.5 GiB 几乎一样。但压测结果:

    档位 有调优表 + THP
    fresh 8.8K prefill(第 1 / 第 2 轮) 1040.1 / 991.5 900.0 / 1035.9
    fresh 4.2K prefill(第 1 / 第 2 轮) 710.2 / 835.6 512.6 / 703.6
    followup 4.2K prefill 270.3 / 171.3 269.9 / 170.5
    decode(各档) 52.0~60.0 51.4~59.8

    逐轮看,差值全在 run-to-run 噪声里(THP 组 8.8K 第二轮反而更高),followup 和 decode 两边几乎完全一致。

    为什么? 因为官方讲 TLB reach 的前提是「专家 arena 就是工作集」(小显存卡、流式取专家)。而这台机器 --expert-cache auto 拿了 8704~9724 个显存槽、命中率 96.9%~99.5% —— 绝大多数专家访问直接命中显存,主机 arena 的 TLB 根本没被压到。

    结论:大页(预留池也好、THP 也好)在这台机器上没有可测收益,不值得拿 47 GiB 去换。

    (THP 已还原成 madvise,机器状态和之前一致。)


    8. 我的数字 vs 官方:差距在哪

    官方在同型号 IQ3_XXS 上的数据(单卡 RX 7900 XTX / Ryzen 9 7950X3D 16C32T / 64GiB / Fedora / ROCm 7.1 / 272W 功耗墙 / 已启用 100100 调优表 / --resident-cpu-experts --mmap-experts 路径 / --max-context 262144 / --pool-workers 15):

    指标 官方(单卡,有表) 我这台(单卡,原先无表) 我这台(双卡 + 自标表)
    4.2K fresh prefill 447.5 首次 / 901.1 热 607 (537~677) 773
    8.8K fresh prefill 873.7 首次 / 966.5 热 628 (621~634) 1016
    decode 55.5 ~ 59.2 66 (65~67) 58.5 (双卡) / 66 (单卡)

    修好调优表之前,我的 prefill 低约 35%,decode 反而略高。 根因:

    1. hipBLASLt 调优表无表可用 —— 主因,现已修复(+41%);
    2. CPU 没有 AVX-512 —— 官方是 Zen4,CPU 侧算专家吃亏;
    3. CPU 核心数只有一半(8C16T vs 16C32T),引擎默认开 7 个 expert-pool worker;
    4. 官方配置里还有 STRATA_PREFILL_MMQ=1、STRATA_PREFILL_RING=96、STRATA_IO_THREADS=32 这些运行时变量,我没启用;
    5. 专家的驻留路径不同(官方 --mmap-experts --resident-cpu-experts,我是 pinned arena)。

    公道说一句:这个对比不是干净的对照。官方是单卡 + 开了表 + 完全不同的专家路径 + 一个核心数是我两倍的 CPU。所以「我反超了官方」只在 8.8K fresh prefill 这一格成立,别当普遍结论。

    decode 我略高的原因:24GB 单卡就能全量缓存最热专家(命中率 96.9~99.5%),加上投机解码接受率 70.6%,恰好把官方在更大上下文下的缓存优势抹平了。


    9. 复现清单

    # 1) 编译(HIP 后端,复用系统 ROCm 7)
    ./setup.sh --backend hip --family qwen --model IQ3_XXS \
      --gguf-dir /path/to/Qwen3.8-Flash-Next-AD-4.27bpw-Q4_K_M-M64 \
      --data-dir /path/to/Strata-data --context 32768 \
      --gpu 0 --build --no-start --yes
    
    # 2) 单卡启动
    run-iq3_xxs.sh
    # 3) 双卡:setup 时用 --gpus 1,0(layer split 自动分配)
    
    # 4) 标定本机 hipBLASLt 调优表(关键!)
    cmake --build build-hip --target tune_hipblaslt
    CASES=$(awk 'NR>2 {printf " --case %s,%s,%s,%s,%s", $1, $5, $2, $3, $4}' \
            tools/hip/gfx1100-hipblaslt-100100.txt)
    ./build-hip/tune_hipblaslt $CASES --tuning-out tools/hip/gfx1100-hipblaslt-<arch>-<version>.txt
    #    然后在 config 的 "env" 里加 STRATA_HIPBLASLT_TUNING 指向它
    
    # 5) 压测(每档会 warmup 一次)
    python3 tools/hip/bench_prefill.py --model MODEL_NAME --url http://127.0.0.1:8080 \
      --engine-log engine.log --label candidate --output candidate.json
    

    引擎关键参数:

    --expert-cache auto --prefill auto --spec 4 --spec-min-p 0.5 
    --mtp .../mtp/rt --max-context 32768 --kv int8 --ple-gguf .../ple-q5_0.gguf
    

    10. 结论

    • 单卡就够用:不跑长文档/代码的话,7900 XTX 单卡 + Strata 是能真正把 89GB MoE 跑起来、而且速度可用的方案(decode 63~66 tok/s 对本地大模型来说相当体面)。
    • 双卡要挑场景:长 prompt(RAG、代码库分析、长文档)收益显著(fresh prefill +15%,多轮追加延迟 −48%);纯聊天生成没收益,还多占内存。
    • 务必自己标定 hipBLASLt 调优表:这是投入产出比最高的一步(+10%~41%),官方工具就在仓库里,几分钟的事。不做的代价是 prefill 直接少三分之一。
    • 大页别折腾:运行时开不起来,开机预留要拿 47 GiB 换,而且实测零收益。这条是省时间,不是省事。
    • 写评测先 warmup:冷启动第一枪 decode 掉到 40 以下,不 warmup 的跑分会误伤一半结论。

    数据来源:bench-single.json / bench-dual-native.json / bench-dual.json / bench-dual-table.json / bench-dual-table-thp.json 原始输出 + 引擎 v0.1.38 运行日志。每组配置独立重启引擎,每档 warmup 1 次 + 2 轮,同一台机器、同一份 prompt。


  • 魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec
    坤 坤坤
    AI硬件 7900xtx sg-lang 多卡部署

    我是双卡的,经过测试速度vllm满意多了,

    这是30k左右上下文的速度
    [2026-09-09 19:50:38 TP0] Decode batch, #running-req: 1, #full token: 33103, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.77, accept rate: 0.59, cuda graph: True, gen throughput (token/s): 60.85, #queue-req: 0
    [2026-09-09 19:50:39 TP0] Decode batch, #running-req: 1, #full token: 33215, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.85, accept rate: 0.62, cuda graph: True, gen throughput (token/s): 62.58, #queue-req: 0
    [2026-09-09 19:50:41 TP0] Decode batch, #running-req: 1, #full token: 33332, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.88, accept rate: 0.62, cuda graph: True, gen throughput (token/s): 62.95, #queue-req: 0
    [2026-09-09 19:50:43 TP0] Decode batch, #running-req: 1, #full token: 33434, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.55, accept rate: 0.52, cuda graph: True, gen throughput (token/s): 55.82, #queue-req: 0
    [2026-09-09 19:50:45 TP0] Decode batch, #running-req: 1, #full token: 33542, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 2.73, accept rate: 0.57, cuda graph: True, gen throughput (token/s): 59.54, #queue-req: 0
    [2026-09-09 19:50:47 TP0] Decode batch, #running-req: 1, #full token: 33665, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.10, accept rate: 0.70, cuda graph: True, gen throughput (token/s): 66.78, #queue-req: 0
    [2026-09-09 19:50:49 TP0] Decode batch, #running-req: 1, #full token: 33810, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.62, accept rate: 0.88, cuda graph: True, gen throughput (token/s): 79.26, #queue-req: 0
    [2026-09-09 19:50:50 TP0] Decode batch, #running-req: 1, #full token: 33943, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.33, accept rate: 0.78, cuda graph: True, gen throughput (token/s): 72.62, #queue-req: 0
    [2026-09-09 19:50:52 TP0] Decode batch, #running-req: 1, #full token: 34081, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.38, accept rate: 0.79, cuda graph: True, gen throughput (token/s): 73.58, #queue-req: 0
    [2026-09-09 19:50:54 TP0] Decode batch, #running-req: 1, #full token: 34213, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.38, accept rate: 0.79, cuda graph: True, gen throughput (token/s): 73.63, #queue-req: 0
    [2026-09-09 19:50:56 TP0] Decode batch, #running-req: 1, #full token: 34358, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.62, accept rate: 0.88, cuda graph: True, gen throughput (token/s): 79.04, #queue-req: 0
    [2026-09-09 19:50:58 TP0] Decode batch, #running-req: 1, #full token: 34485, full token usage: 0.14, mamba num: 4, mamba usage: 0.20, accept len: 3.12, accept rate: 0.71, cuda graph: True, gen throughput (token/s): 68.08, #queue-req: 0
    
    这是64k上下文左右的
    [2026-09-09 19:59:43 TP0] Decode batch, #running-req: 1, #full token: 67798, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.40, accept rate: 0.80, cuda graph: True, gen throughput (token/s): 62.86, #queue-req: 0
    [2026-09-09 19:59:45 TP0] Decode batch, #running-req: 1, #full token: 67933, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.38, accept rate: 0.79, cuda graph: True, gen throughput (token/s): 62.37, #queue-req: 0
    [2026-09-09 19:59:47 TP0] Decode batch, #running-req: 1, #full token: 68056, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.08, accept rate: 0.69, cuda graph: True, gen throughput (token/s): 56.86, #queue-req: 0
    [2026-09-09 19:59:49 TP0] Decode batch, #running-req: 1, #full token: 68170, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.92, accept rate: 0.64, cuda graph: True, gen throughput (token/s): 53.99, #queue-req: 0
    [2026-09-09 19:59:52 TP0] Decode batch, #running-req: 1, #full token: 68298, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.20, accept rate: 0.73, cuda graph: True, gen throughput (token/s): 59.00, #queue-req: 0
    [2026-09-09 19:59:54 TP0] Decode batch, #running-req: 1, #full token: 68418, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.00, accept rate: 0.67, cuda graph: True, gen throughput (token/s): 55.36, #queue-req: 0
    [2026-09-09 19:59:56 TP0] Decode batch, #running-req: 1, #full token: 68532, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.77, accept rate: 0.59, cuda graph: True, gen throughput (token/s): 51.23, #queue-req: 0
    [2026-09-09 19:59:58 TP0] Decode batch, #running-req: 1, #full token: 68636, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.60, accept rate: 0.53, cuda graph: True, gen throughput (token/s): 47.93, #queue-req: 0
    [2026-09-09 20:00:00 TP0] Decode batch, #running-req: 1, #full token: 68729, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.35, accept rate: 0.45, cuda graph: True, gen throughput (token/s): 43.04, #queue-req: 0
    [2026-09-09 20:00:02 TP0] Decode batch, #running-req: 1, #full token: 68822, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.30, accept rate: 0.43, cuda graph: True, gen throughput (token/s): 42.36, #queue-req: 0
    [2026-09-09 20:00:05 TP0] Decode batch, #running-req: 1, #full token: 68901, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.05, accept rate: 0.35, cuda graph: True, gen throughput (token/s): 37.75, #queue-req: 0
    [2026-09-09 20:00:07 TP0] Decode batch, #running-req: 1, #full token: 69001, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.48, accept rate: 0.49, cuda graph: True, gen throughput (token/s): 45.58, #queue-req: 0
    [2026-09-09 20:00:09 TP0] Decode batch, #running-req: 1, #full token: 69130, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 3.25, accept rate: 0.75, cuda graph: True, gen throughput (token/s): 59.83, #queue-req: 0
    [2026-09-09 20:00:11 TP0] Decode batch, #running-req: 1, #full token: 69247, full token usage: 0.28, mamba num: 4, mamba usage: 0.20, accept len: 2.85, accept rate: 0.62, cuda graph: True, gen throughput (token/s): 52.28, #queue-req: 0
    

    使用codex和用dsh和hermes调用的话非常舒服

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组