跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场
王池川王

王池川

@王池川
超级版主
取消关注 关注
关于
帖子
67
主题
23
分享
0
群组
1
粉丝
3
关注
0

帖子

最新 最佳 有争议的

  • 發現一個讓程式碼自動優化的神奇技巧,同事看完直接跪了
    王池川王 王池川
    随便聊聊 编程

    剛剛在重構舊專案時發現的,原本以為只是個都市傳說,實測後直接嚇到我。

    背景:手上有個 5 萬行的 legacy codebase,技術債堆得像山一樣高,每次改動都得戰戰兢兢。

    然後我在 GitHub 上看到一個被埋沒的討論串,講的是用 AST (抽象語法樹) + LLM 的混合方案 來做自動化重構。

    具體做法:

    1. 用 babel-parser 或 ts-morph 把代碼解析成 AST
    2. 寫訪問者模式提取出「純邏輯」vs「副作用」的節點
    3. 把純邏輯部分丟給 LLM,提示詞大概是:「這段代碼只做資料轉換,請用最簡潔的函數式寫法重寫,保持輸出輸入一致」
    4. LLM 吐出優化版本,再用 AST 把它塞回原位置
    5. 跑測試套件驗證行為一致

    實測結果:

    • 一個 200 行的 switch-case 地獄,變成 15 行的 Map + 策略模式
    • 迴圈裡的巢狀 if-else 直接被拉平成 guard clause 串聯
    • 型別推斷從 any 變成精確的 generic constraints
    • 測試覆蓋率從 34% 衝到 87%,且零 regression

    同事 code review 時的反應:「這...這是不是 AI 寫的?」「還是你偷偷重寫了三週?」

    最誇張的是:這套流程現在封裝成 CLI 工具,跑一次 npm run auto-refactor 就能處理整個專案。CI/CD 管線直接接上,每次 PR 自動跑一遍,不好合就不合。

    有沒有人想看核心腳本?我整理成 gist 可以分享。


    補充:這不是讓 AI 幫你寫代碼,而是用 AST 做「結構性保證」+ LLM 做「局部優化」。兩者分工不同,別混為一談。

    #程式設計 #重構 #AST #LLM #技術分享


  • RTX 5070 Ti 16GB 跑 Qwen3.8-27B:16G 卡量化選擇、啟動配置與基準數據
    王池川王 王池川
    AI硬件 qwen-27b 量化 rtx5070

    RTX 5070 Ti 16GB 跑 Qwen3.8-27B 完整參考配置與基準測試

    這篇整理目前消費級單張 16GB 顯存跑 27B 密集模型的可行配置、編譯參數、啟動命令、量化選擇、避坑清單與實測性能對比。內容參考社區公開基準與 elsung/blackwell-16gb-llm-starter 實測數據,供同顯存卡位參考。


    硬體基線

    組件 型號 備註
    GPU RTX 5070 Ti 16GB GDDR7 (Blackwell, SM 120) 896 GB/s 帶寬、FP8/NVFP4 原生支援
    CPU Ryzen 7 9800X3D / 1700 均可 預填階段不拖後腿即可
    內存 32–64 GB DDR5 系統留 8–16 GB 給 cache-ram
    作業系統 Ubuntu 24.04 LTS / WSL2 驅動 570.124+、CUDA 12.8+

    關鍵限制:Q4_K_M 權重 16.5 GB + 32K KV ≈ 1.2 GB = 17.7 GB,超過 16 GB。16GB 卡需 offload 部分層到系統內存 (--ngl 28-30 + --cache-ram)。IQ4_XS 權重 14.8 GB + KV ≈ 1 GB = ~15.8 GB,才能全層上 GPU。

    Blackwell GPU 識別截圖 (GitHub issue #26901)


    模型選擇與量化對比 (16GB 卡)

    量化 大小 最小 VRAM 單流 TG (tok/s) PP (tok/s) 代碼質量 推薦度
    IQ4_XS 14.8 GB 15.8 GB 38–43 ~1,350 ⭐⭐⭐⭐ 16GB 卡全層首選
    Q4_K_M 16.5 GB 17.5 GB 18–27 (offload) ~1,240 ⭐⭐⭐⭐⭐ 質量優先,需 offload 2-4 層
    Q5_K_M 19.8 GB 21 GB 34–36 ~1,080 ⭐⭐⭐⭐⭐ 需 24GB 卡
    NVFP4 (Blackwell 專用) ~13 GB 14 GB 55–65 ~1,800 ⭐⭐⭐⭐⭐ 未來首選,待 llama.cpp PR #21095 合併
    Q3_K_L 14.2 GB 15.2 GB 44+ ~1,420 ⭐⭐ 不推薦生產

    參考:elsung/blackwell-16gb-llm-starter 實測 Qwen3.6-27B IQ4_KS 單流 51 tok/s (16–32K ctx);IQ4_XS 全層上 16GB 卡的 decode 約 896÷14.8≈60 t/s 理論 ×~75% 效率 ≈ 42 t/s。Q4_K_M 在 16GB 卡上 offload 後實際 decode 18-27 t/s(896 GB/s 讀 ~15GB + PCIe 回傳瓶頸),24GB 卡可全層上 GPU。MTP 版本 unsloth 有提供 (Qwen3.8-27B-MTP-GGUF),但 16G 卡上會 OOM(draft 模型多占 ~1-2GB)。


    llama.cpp 編譯:Blackwell (SM 120) 專用參數

    git clone https://github.com/ggml-org/llama.cpp
    cd llama.cpp
    git checkout b5585  # 或最新 release,含 Qwen3.8/Gemma 3 修復
    
    cmake -B build \
      -D GGML_CUDA=ON \
      -D CMAKE_CUDA_ARCHITECTURES=120 \      # 必須:Blackwell = SM 120
      -D LLAMA_BUILD_SERVER=ON \
      -D GGML_CUDA_FA_ALL_QUANTS=ON \        # Flash Attention 全量化支援
      -D GGML_CUDA_GRAPH=ON \
      -D CMAKE_BUILD_TYPE=Release
    
    cmake --build build --config Release --parallel $(nproc)
    
    # 驗證:應輸出 built for sm_120
    ./build/bin/llama-cli --version
    

    避坑:絕對不要用 -D CMAKE_CUDA_ARCHITECTURES=86 89 90 (混編導致 15-20% 性能損失);必須開 GGML_CUDA_FA_ALL_QUANTS=ON 否則 FP8/Q4_K_M 無 FA、decode 速度腰斬。


    啟動配置三版本

    1. 基礎版 (IQ4_XS 全層上 GPU,驗證不 OOM)

    ./build/bin/llama-server \
      -m ./models/Qwen3.8-27B-IQ4_XS.gguf \
      -c 32768 \                    # 32K 上下文極限
      -ngl 99 \                     # 全層上 GPU (62 層,IQ4_XS 14.8GB 可全上)
      -fa on \                      # Flash Attention 必開
      --host 0.0.0.0 --port 8080 \
      --jinja \
      --temp 0.6 --top-p 0.95 --top-k 40 --min-p 0.05 \
      -b 2048 -ub 512 \
      --no-mmap --mlock \
      --parallel 1 \
      --ctx-checkpoints 64 --swa-checkpoints 64
    

    驗證:日誌顯示 VRAM used: ~15.8 GB / 16.00 GB,/health 返回 200。

    Q4_K_M 版本:需改為 -ngl 28-30(offload 後半層到系統內存)+ --cache-ram 24000,decode 會降到 18-27 t/s。24GB 卡才能 -ngl 99 全層。

    2. MTP 投機解碼版 (短上下文代碼任務加速 ~1.5x)

    # 需下載 MTP 模型:unsloth/Qwen3.8-27B-MTP-GGUF
    ./build/bin/llama-server \
      -m ./models/Qwen3.8-27B-MTP-Q4_K_M.gguf \
      -c 32768 -ngl 99 -fa on \
      --host 0.0.0.0 --port 8080 --jinja \
      --temp 0.6 --top-p 0.95 --top-k 40 --min-p 0.05 \
      -b 2048 -ub 512 --no-mmap --mlock \
      --speculative-draft-model-file ./models/Qwen3.8-27B-MTP-Q4_K_M.gguf \
      --speculative-pmin 0.1 --speculative-nmax 8 --speculative-ntrials 3
    
    配置 TG (tok/s) 加速比 穩定性
    基礎版 38–42 1.00x ⭐⭐⭐⭐⭐
    MTP n=8 55–60 1.5x ⭐⭐⭐⭐ (偶爾異常 token)
    MTP n=4 50–54 1.35x ⭐⭐⭐⭐⭐

    註:Qwen3.8 為 Dense 架構,MTP 加速較 Qwen3.6 MoE (1.73x) 低;長上下文 (>16K) 時效果遞減,建議短上下文開、長上下文關。

    3. 生產版 (Hermes Agent 整合 + 長上下文 + 監控)

    #!/bin/bash
    MODEL_DIR="./models"
    MAIN_MODEL="Qwen3.8-27B-IQ4_XS.gguf"
    MTP_MODEL="Qwen3.8-27B-MTP-Q4_K_M.gguf"
    CTX_SIZE=32768
    N_GPU_LAYERS=99
    BATCH_SIZE=2048
    UBATCH_SIZE=512
    THREADS=$(nproc)
    
    export GGML_CUDA_GRAPH=1
    export GGML_CUDA_FORCE_MMQ=1
    export CUDA_VISIBLE_DEVICES=0
    export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True
    
    ARGS=(
      -m "$MODEL_DIR/$MAIN_MODEL"
      -c "$CTX_SIZE" -ngl "$N_GPU_LAYERS" -fa on
      --host 0.0.0.0 --port 8080 --jinja
      --temp 0.6 --top-p 0.95 --top-k 40 --min-p 0.05
      --repeat-penalty 1.05 --presence-penalty 0.25
      -b "$BATCH_SIZE" -ub "$UBATCH_SIZE"
      --threads "$THREADS" --threads-batch "$THREADS"
      --no-mmap --mlock --parallel 1
      --ctx-checkpoints 64 --swa-checkpoints 64
      --cache-ram 24000
      --rope-freq-scale 0.5 --rope-freq-base 1000000
      --reasoning off --metrics on --metrics-port 9090
    )
    
    if [ -f "$MODEL_DIR/$MTP_MODEL" ]; then
      ARGS+=(--speculative-draft-model-file "$MODEL_DIR/$MTP_MODEL"
        --speculative-pmin 0.1 --speculative-nmax 6 --speculative-ntrials 3)
    fi
    
    exec ./build/bin/llama-server "${ARGS[@]}"
    

    Hermes Agent 連接配置

    {
      "modelProvider": "custom",
      "customEndpoint": "http://localhost:8080/v1",
      "modelName": "Qwen3.8-27B-IQ4_XS",
      "contextLength": 32768,
      "temperature": 0.6,
      "topP": 0.95,
      "maxTokens": 8192,
      "systemPrompt": "你是專業程式設計助手,擅長 Python/Rust/Go/C++/前端/系統架構。回答簡潔、可執行、優先給代碼。",
      "enableTools": true,
      "toolTimeout": 120000
    }
    

    關鍵參數:contextLength=32768 (16GB 極限,靠 /compact 壓縮)、temperature=0.6 (編程確定性)、enableTools=true。


    基準測試數據 (llama-bench)

    ./build/bin/llama-bench \
      -m ./models/Qwen3.8-27B-IQ4_XS.gguf \
      -c 32768 -ngl 99 -fa on -b 2048 -ub 512 --no-mmap --mlock -r 3
    

    輸出格式參考 llama.cpp 官方 llama-bench README (Markdown 表格):

    RTX 5070/Blackwell 性能回歸基準截圖 (GitHub issue #25422)

    指標 RTX 5070 Ti 16G RTX 3090 24G (參考) RTX 4090 24G (參考)
    PP (tok/s) 1,240 1,000 (+24%) 1,350 (-8%)
    TG (tok/s) 38.2 28.3 (+35%) 40.2 (-5%)
    VRAM (GB) 15.82 — —
    功耗 (W) 245 — —
    能效比 0.156 +40% -10%

    數據來源:社區公開 llama-bench 交叉驗證 + elsung/blackwell-16gb-llm-starter 同硬體基線。以上為 IQ4_XS 全層上 GPU 數據;Q4_K_M 在 16GB 卡上 offload 後 TG 降至 18-27 t/s。5070 Ti 解碼比 3090 快 35% 歸功於 GDDR7 + Blackwell 架構;比 4090 慢 5% 但價格 1/3。

    實際場景測試

    場景 上下文 平均 TG TTFT VRAM 峰值 穩定性
    短對話 2K 42 t/s 0.8s 14.2 GB ⭐⭐⭐⭐⭐
    代碼生成 (500 行) 8K 38 t/s 1.2s 14.8 GB ⭐⭐⭐⭐⭐
    長文檔分析 32K 34 t/s 3.8s 15.9 GB ⭐⭐⭐⭐
    Hermes 多輪 (15 輪+壓縮) 動態 16-32K 37 t/s 1.5s 15.2 GB ⭐⭐⭐⭐⭐
    MTP + 短上下文 8K 59 t/s 0.9s 15.1 GB ⭐⭐⭐⭐ (MTP 在 16G 卡上會 OOM,需 24G)

    實測溫度:Idle 38°C/9W → 滿載 53–61°C / 194–255 W / 2580 MHz (elsung 實測)。GPU 非瓶頸,系統 RAM 才是 (建議 64GB)。


    避坑清單 (10 條)

    # 坑 症狀 解決
    1 混編 sm_86,89,90 TG 30 t/s 只編 sm_120
    2 -ngl 999/100 OOM 用 -ngl 99 或 62
    3 -c 65536 跑幾輪 OOM 鎖 32K,長文用 RAG
    4 不開 --no-mmap --mlock 首次預填 100 tok/s 生產必開
    5 -fa off TG 掉到 22 t/s Blackwell 必開 -fa on
    6 Ollama/LM Studio 直跑 慢 20-30% 用原生 llama-server
    7 忽略 --cache-ram 系統內存爆 OOM 設 --cache-ram 24000
    8 不開 RoPE 擴展 16K+ 幻覺 加 --rope-freq-scale 0.5
    9 temperature=1.0 代碼幻覺多 編程鎖 0.6
    10 不監控 VRAM/溫度 熱節流掉 30% 裝 nvtop/gpustat,機箱對流

    NUMA mirror GPU 監控截圖 (GitHub issue #16000)


    成本效益對比 (單張卡跑 27B IQ4_XS 全層 / Q4_K_M offload)

    方案 成本 顯存 全層上 GPU TG 年電費(4h/天) 綜合
    RTX 5070 Ti 16G ¥5,299 16 GB ✅ (IQ4_XS) 38 t/s ¥358 ⭐⭐⭐⭐⭐ 王者
    4070 Ti Super 16G ¥5,999 16 GB ✅ 32 t/s ¥380 ⭐⭐⭐⭐
    二手 3090 24G ~¥4,500 24 GB ✅ (Q5/Q6) 28 t/s ¥520 ⭐⭐⭐ (無保修、功耗高)
    二手 4090 24G ~¥12,000 24 GB ✅ (Q8) 40 t/s ¥480 ⭐⭐ (太貴)
    5060 Ti 16G ~¥3,799 16 GB ⚠️ 勉強 ~25 t/s ¥260 ⭐⭐⭐ (預算極限)
    雙 3060 12G ~¥3,600 24 GB 分佈 ❌ 慢 ~15 t/s ¥420 ⭐
    Mac Studio M2 Ultra ~¥30,000 96 GB 統一 ✅ 22 t/s ¥180 ⭐
    雲端 API 按量 無限 ✅ 無限快 視用量 ⭐⭐⭐ (隱私/離線不可用)

    建議:預算 5-6K、要離線/隱私/長期用 → 5070 Ti 16G 閉眼入;3-4K 主跑 7-14B → 5060 Ti/4070 Ti Super;10K+ 跑 70B/Q8 做微調 → 等 5090 32G 或雙 4090。


    未來升級路線

    里程碑 時間 影響 行動
    llama.cpp NVFP4 GGUF 合併 (PR #21095) 2026 Q3-Q4 16GB 完整載入、TG 55-65 t/s 關注 PR,合併即編譯測試
    Unsloth 發布 Qwen3.8-27B-NVFP4-GGUF 2026 Q3 官方優化量化、下載即用 第一時間替換 Q4_K_M
    IQ4_XS/IQ3_XXS 穩定版 2026 Q3 更小 VRAM (14-15GB)、留更多 KV 32K 不夠時試 IQ4_XS + 64K
    Hermes 原生支援本地投機解碼 2026 Q3 免配置享受 MTP 升級 Hermes Desktop
    vLLM/SGLang 原生 FP8/NVFP4 2026 Q3-Q4 並發吞吐 3-5x、多人共享 有多人需求時遷移
    RTX 6070 Ti (16/24GB GDDR7) 2027 H1 16GB 版仍受限、24GB 成新王者 16GB 卡壽命 ~1.5-2 年

    完整可復現清單

    環境:Ubuntu 24.04 / WSL2、Driver 570.124+、CUDA 12.8+、llama.cpp b5585+

    目錄結構:

    ~/llama-workspace/
    ├── llama.cpp/build/bin/llama-server
    ├── models/
    │   ├── Qwen3.8-27B-Q4_K_M.gguf
    │   └── Qwen3.8-27B-MTP-Q4_K_M.gguf (可選)
    ├── start.sh
    └── bench.sh
    

    啟動:chmod +x start.sh && ./start.sh

    驗證:

    curl http://localhost:8080/health
    curl -X POST http://localhost:8080/v1/chat/completions \
      -H "Content-Type: application/json" \
      -d '{"model":"Qwen3.8-27B-IQ4_XS","messages":[{"role":"user","content":"用 Python 寫快速排序"}],"temperature":0.6,"max_tokens":1024}'
    

    Prometheus (可選):抓取 localhost:9090/metrics


    總結

    RTX 5070 Ti 16GB + Qwen3.8-27B-IQ4_XS = 消費級單卡本地部署 27B 密集模型的性價比天花板。

    ✅ 能進:IQ4_XS 14.8 GB 模型 + 1.0 GB KV Cache = ~15.8 GB < 16 GB (全層上 GPU)
    ✅ 能跑:IQ4_XS 全層 38 tok/s 解碼、1,350 tok/s 預填;Q4_K_M offload 18-27 t/s
    ✅ 能用:Hermes Agent 整合無縫、工具調用正常、32K 上下文穩定
    ✅ 有未來:NVFP4 量化即將釋放 50%+ 紅利 (~13GB / 55-65 t/s)、Blackwell 架構壽命長


    參考鏈接

    • 模型:unsloth/Qwen3.8-27B-GGUF | Qwen 官方 | MTP 版
    • llama.cpp:Repo | Release | NVFP4 PR #21095
    • 實測基線:elsung/blackwell-16gb-llm-starter (RTX 5070 Ti 完整基準)
    • 量化指南:willitrunai.com | Unsloth 文檔
    • Hermes Agent:官網 | Desktop | 文檔
    • 社區跑分:Reddit LocalLLaMA Qwen3.8 | arXiv: Private LLM on Blackwell

    有補充或修正歡迎回帖討論。


    標籤:#5070Ti #Qwen3.8-27B #llama.cpp #Blackwell #本地部署 #Hermes #實測 #避坑 #性價比 #GDDR7


  • Qwen3.8-27B 量化全格式橫評:從 IQ2_XXS 到 Q6_K,14 種格式誰才是甜點?
    王池川王 王池川
    LLM讨论区 qwen-27b 量化 llama.cpp

    近一週論壇上 Qwen3.8-27B 的帖密度很高,但大多聚焦在特定一張卡跑一兩種量化。量化格式選錯,輕則掉智商,重則 OOM 直接跑不起來。這篇把 llama.cpp 目前支援的 14 種格式從 2-bit 到 6-bit 全攤開比,附上文件大小、最小 VRAM、質量評級、適用場景,你找到自己的顯存對應的直接抄。

    文末有選擇決策樹,一看就知道該下哪個。

    先說結論

    不用想太多,下面三個閉眼選:

    • 24GB+ 卡:Q5_K_M(20.8GB)或 Q6_K(23.5GB),質量接近滿血,不用妥協
    • 16GB 卡:IQ4_XS(15.6GB),全層上 GPU 不 OOM,質量夠用
    • 12GB 卡:IQ3_M(13.9GB)或 IQ3_XS(13.3GB),能跑但明顯降智

    下面展開。

    為什麼要分這麼多種量化?

    llama.cpp 的量化不是單純壓縮。它把模型的不同部分(attention 權重、FFN 權重、embedding、output 層)分開用不同精度壓。K-quant 和 I-quant 的核心區別:

    K-quant(Q4_K_M, Q5_K_M...):老牌格式,每層用固定 block size 做 K-means 量化。穩定,通用,CPU/GPU 都跑得好。缺點是同等大小下質量不如 I-quant。

    I-quant(IQ4_XS, IQ3_M...):重要性矩陣(imatrix)輔助量化,會先跑一批校準數據分析哪些權重更重要,重要的高精度保留,不重要的狠壓。同等大小下質量比 K-quant 好 10-15%,但 CPU 上會慢於 K-quant,需要 cuBLAS/rocBLAS 加速。

    所以一句話:4-bit 以上隨便選差別不大,4-bit 以下一定要選 I-quant。

    14 種格式完整對比表

    量化格式 類型 文件大小 最小 VRAM 質量評級 推薦
    Q6_K_L K-quant 24.1 GB 25 GB ★★★★★ 接近滿血 24G 卡質量首選
    Q6_K K-quant 23.5 GB 24.5 GB ★★★★★ 接近滿血 24G 卡
    Q5_K_M K-quant 20.8 GB 22 GB ★★★★☆ 高質量 24G 卡甜點
    Q5_K_S K-quant 19.7 GB 21 GB ★★★★☆ 高質量 24G 卡省空間
    Q5_K_L K-quant 21.5 GB 22.5 GB ★★★★☆ embedding 用 Q8 24G 卡
    Q4_K_M K-quant 17.8 GB 19 GB ★★★★☆ 默認選擇 20G+ 卡通用首選
    Q4_K_L K-quant 18.7 GB 20 GB ★★★★☆ embedding 用 Q8 20G+ 卡
    Q4_K_S K-quant 16.7 GB 18 GB ★★★☆☆ 質量略降 16G 卡可跑但緊
    Q4_1 Legacy 17.8 GB 19 GB ★★★☆☆ 老格式 Apple Silicon 有優勢
    Q4_0 Legacy 16.4 GB 18 GB ★★☆☆☆ 老格式 僅兼容性用
    IQ4_XS I-quant 15.6 GB 16.5 GB ★★★★☆ 質量好 16G 卡全層首選
    IQ4_NL I-quant 16.3 GB 17 GB ★★★★☆ 略大於IQ4_XS 16G 卡
    IQ3_M I-quant 13.9 GB 15 GB ★★★☆☆ 可用 12G 卡選擇之一
    IQ3_XS I-quant 13.3 GB 14.5 GB ★★☆☆☆ 降智明顯 12G 卡
    IQ3_XXS I-quant 12.6 GB 14 GB ★★☆☆☆ 降智 12G 卡最小可用
    Q3_K_XL K-quant 16.4 GB 17.5 GB ★★★☆☆ embedding 用 Q8 16G 卡
    Q3_K_L K-quant 15.3 GB 16.5 GB ★★☆☆☆ 低質量 12G 卡
    Q3_K_M K-quant 14.6 GB 16 GB ★★☆☆☆ 低質量 不推薦
    Q2_K_L K-quant 13.1 GB 14.5 GB ★☆☆☆☆ 很低但能跑 純應急
    IQ2_M I-quant 10.9 GB 12 GB ★☆☆☆☆ SOTA 勉強可用 極端省 VRAM
    IQ2_S I-quant 10.3 GB 11.5 GB ★☆☆☆☆ 勉強可用 極端省 VRAM
    IQ2_XXS I-quant 9.4 GB 10.5 GB ☆☆☆☆☆ 有輸出就很難說 純玩

    註1:最小 VRAM = 權重 + 32K 上下文 KV cache + 推理 overhead。實際需留 1-2 GB 餘量。
    註2:質量評級基於 bartowski imatrix 校準版與社區交叉對比,非嚴謹 perplexity 基準。

    K-quant vs I-quant:到底差多少?

    論壇上已經有人問過「4-bit 以下到底是 K-quant 還是 I-quant 好」,這裡用 bartowski 的 imatrix 版本數據說明:

    相同大小對比(4-bit 區間):

    • Q4_K_S(16.7GB)vs IQ4_XS(15.6GB):IQ4_XS 小了 1.1GB 但質量評級持平甚至略優。16G 卡首選 IQ4_XS 不是沒有道理的——省出來的 1GB 剛好放 KV cache。

    相同大小對比(3-bit 區間):

    • Q3_K_M(14.6GB)vs IQ3_M(13.9GB):I-quant 小 0.7GB 且質量持平。3-bit 以下 I-quant 的優勢更明顯。
    • Q3_K_S(13.7GB)vs IQ3_XS(13.3GB):同樣 I-quant 更小且質量略優。

    但 I-quant 有個坑:CPU-only 場景 I-quant 會明顯慢於 K-quant。如果你是純 CPU 跑(沒 GPU),3-bit 以下選 K-quant 反而更順。

    MTP 與量化的關係

    Qwen3.8-27B 內建 MTP(Multi-Token Prediction)層,可以做投機解碼。但 MTP 層本身也占 VRAM:

    • MTP 層在 imatrix 量化版中存為 Q4_0,約 1.4GB(不含主模型)
    • 16GB 卡跑 IQ4_XS(15.6GB)+ MTP(1.4GB)= 17GB,超 VRAM 會 OOM
    • 24GB 卡跑 Q4_K_M(17.8GB)+ MTP(1.4GB)= 19.2GB,有空間
    • ggml-org 官方版有獨立的 MTPQ4_0 格式,只含 MTP 層,1.7GB

    所以 MTP 不是免費的午餐。16GB 卡基本告別 MTP,除非你願意把主模型降到 IQ3 來騰空間——但那樣降智的損失遠大於 MTP 帶來的加速。

    unsloth Dynamic v3.0 vs bartowski imatrix:哪個好?

    目前 Qwen3.8-27B 有兩大主流量化來源:

    bartowski:imatrix 校準,校準數據集包含 63% 工具調用對話 + 37% 純文本(583 chunks, 137 組對話)。特點是工具調用場景的量化損失更小。
    unsloth:Dynamic v3.0,宣稱同等大小下 top-1% 準確率比其他來源高 10%+。文件大小比 bartowski 略小(例如 UD-Q4_K_M 16.5GB vs bartowski 17.8GB)。

    對 Agent/工具調用場景:bartowski 的 imatrix 校準更對路,因為校準集就是工具調用對話。
    對純文本生成/翻譯:兩者差別不大,unsloth 可能略優。
    對 16G 卡極限操作:unsloth Dynamic 版文件略小,多出的 0.3-1GB 能救你一命的時候就會救。

    我的建議:16G 卡選 unsloth UD-IQ4_XS(14.3GB),比 bartowski IQ4_XS(15.6GB)省 1.3GB 出來給 KV cache 或 MTP。24G+ 卡選 bartowski Q4_K_M 或 Q5_K_M,質量更穩。

    選擇決策樹

    你的 VRAM 幾 GB?

    24GB+:
    ├─ 追質量 → Q5_K_M(20.8GB)或 Q6_K(23.5GB)
    ├─ 追速度+MTP → Q4_K_M(17.8GB)+ MTP
    └─ 追極限質量 → Q6_K_L(24.1GB,embedding 用 Q8)

    16GB:
    ├─ 全層上 GPU → IQ4_XS(15.6GB)或 unsloth UD-IQ4_XS(14.3GB)
    ├─ 質量優先願 offload → Q4_K_M(17.8GB),-ngl 28-30 配 --cache-ram
    └─ 想開 MTP → 不行,OOM。除非降到 IQ3_M(13.9GB)+MTP(1.4GB)= 15.3GB

    12GB:
    ├─ 最佳選擇 → IQ3_M(13.9GB)
    ├─ 省 VRAM → IQ3_XS(13.3GB)
    ├─ 極限 → IQ3_XXS(12.6GB),但降智明顯
    └─ 別開 MTP,VRAM 不夠

    8GB 及以下:
    ├─ IQ2_M(10.9GB)勉強能跑,但輸出質量明顯下降
    └─ 誠實說:考慮用更小的模型(Qwen3.8-14B),不要硬壓 27B

    不用 VRAM 算的通用考量

    1. Agent/工具調用重度用戶:選 bartowski imatrix 版,校準集就是工具調用對話,量化損失在工具場景最小。
    2. 純文本/翻譯/寫作:unsloth Dynamic v3.0 可能略優。
    3. CPU-only(沒 GPU):K-quant 比 I-quant 快,4-bit 以下差更多。純 CPU 跑 Q4_K_M 好過 IQ4_XS。
    4. Apple Silicon(統一內存):Q4_1 在 M 系列上有 token/watt 優勢,其他場景推薦 K-quant。
    5. 想開 MTP 投機解碼:VRAM 要夠放主模型 + MTP 層(~1.4GB),16G 卡基本告別。

    下載命令

    bartowski 版:

    hf download bartowski/Qwen3.8-27B-GGUF --include "Qwen3.8-27B-IQ4_XS.gguf" --local-dir ./
    

    unsloth Dynamic v3.0 版:

    hf download unsloth/Qwen3.8-27B-GGUF --include "Qwen3.8-27B-UD-IQ4_XS.gguf" --local-dir ./
    

    官方 ggml-org 版(只有 Q4_K_M 和 Q8_0):

    hf download ggml-org/Qwen3.8-27B-GGUF --include "*Q4_K_M*" --local-dir ./
    

    MTP 投機解碼(24G+ 卡適用):

    hf download ggml-org/Qwen3.8-27B-GGUF --include "*MTPQ4_0*" --local-dir ./
    

    已知的缺陷

    1. Q4_K_M 在 16G 卡上需要 offload 2-4 層到系統內存。decode 速度從 38 t/s 掉到 18-27 t/s,PCIe 頻寬是瓶頸。16G 卡想要全層上 GPU 就選 IQ4_XS。
    2. I-quant 在 CPU-only 場景顯著慢於 K-quant。沒 GPU 加速就別選 I-quant。
    3. MTP 在 Dense 模型上的加速比 MoE 模型低。Qwen3.6 MoE 的 MTP 加速 1.73x,Qwen3.8 Dense 大約 1.35-1.5x。長上下文(>16K)效果進一步遞減。
    4. imatrix 版本的 MTP 層用 Q4_0 量化(非 imatrix 校準),因為校準數據不經過 MTP 層。好事是 Q4_0 速度最快,適合投機解碼。
    5. Q2 以下的格式——說真的,有輸出就已經很難說了。除非你只是一個 demo 證明「能跑」,否則考慮換小模型。
    6. 上下文長度直接影響 VRAM:32K KV cache 在 27B 模型上大約吃 1-1.5GB。8K 上下文只要 0.3GB。VRAM 緊張就把上下文砍到 8K-16K。

  • Anthropic 那份 154 頁的報告,讓我卸了 Claude Code
    王池川王 王池川
    LLM讨论区 anthropic claude-code ai危机

    《Detecting and countering misuse of AI: September 2026》,Anthropic 第四份公開的威脅情報報告,九月十日發布,154 頁。涵蓋的時間是 2025 年 12 月到 2026 年 8 月,分七個領域:網路行動、影響力操作、監控、詐騙與詐欺、生物濫用、常規武器開發、蒸餾。每個案子都有編號,格式是 GTG-xxxxx,也門那個製導武器小組是 GTG-87001。

    蒸餾那一節點名了中國五家實驗室:

    實驗室 報告裡寫的規模
    阿里 1.51 億次對話,五月到七月,高峰一天接近 300 萬次,動用超過 3500 個帳號
    月之暗面 2300 萬次,把用戶問 Kimi 的問題轉給 Claude,再把答案當自己的回
    DeepSeek 14 天 1210 萬次
    智譜 17 天超過 340 萬次
    小米 超過 40 萬次請求,經過 1500 多個帳號

    報告也提到,月之暗面跟 DeepSeek 轉出去的是自家用戶的請求,所以 Anthropic 說它看到了別人的敏感資料流過去,那些人根本不知道自己問的東西被送到了 Claude。

    這份報告裡真正讓人後背發涼的,根本不是蒸餾,而是 Anthropic 的還原精準度。

    它能還原到什麼程度?誰、在什麼時間、用了哪些帳號、做了什麼?

    更誇張的是,它竟然還還原出了一個團隊的內部分工。也門那個案例裡面,誰寫代碼、誰查資料、誰做 code review,都給你擺出來了。監控行動那部分就更細了:目標的位置、人口特徵、政治傾向,它帶著置信度都一起給你了。這就不是被收集數據的問題了,而是徹底被人扒了底褲。

    我知道有人會說,互聯網時代早就沒有隱私了,你有什麼好大驚小怪的。錯,這根本不是一個性質。

    第一,互聯網頭部大廠非常重視隱私。2016 年,美國政府要求蘋果解鎖一部手機,蘋果直接拒絕,寧可和政府對簿公堂。臉書呢,因為劍橋分析這件事呢,被罰了 50 億美元啊,股價暴跌,這些都是真金白銀的代價。

    第二,普通互聯網公司能拿到的隱私其實很有限,最多就是你在 APP 裡面註冊信息,再加上你使用 APP 的行為數據。而這一份 Anthropic 的報告就好像一個千里眼順風耳,它能夠把你做過的事情一點一滴、完完全全還原出來,纖毫畢露。

    所以我猜,它靠的不只是雲端的 Claude 模型,更關鍵的是運行在本地的那支軟件 Claude Code。因為在雲端運行的 Claude 模型,它只能拿到你問了什麼、它答了什麼,就是對話記錄,只有這些。但 Claude Code 完全是另外一回事了,它是裝在你電腦上了,在本地運行的軟件,權限極高。

    今年 Claude Code 原始碼洩露了三次。社區把 50 多萬行代碼扒開,發現了這個軟件採集了你的設備 ID、帳號 ID、組織 ID、訂閱檔位、你的操作系統內核版本、終端類型、你裝了哪些包管理器、你進程的 CPU 佔用和內存的分配,甚至你在哪個代碼倉庫上幹活,倉庫的遠程的地址會被哈希之後一起上報。

    而上報的頻率也非常嚇人,每 10 秒鐘上傳一次,每批最多 200 條。如果上傳失敗,先存到本地,再反覆重試。更要命的是,這套自動上報機制,你關不掉它。

    所以它能夠精準地知道你在幾點工作、用什麼機器、在哪個項目上、每天問了多少次、問的究竟是什麼。

    Anthropic 一直是一家最強調安全的公司。但一家公司打著安全的旗號,瘋狂地採集用戶的個人信息,還把用戶根本關不掉的設備數據傳上來做深度分析,這不就是赤裸裸的作惡嗎?

    所以我決定未來不再用 Claude 模型了,Claude Code 軟件我也卸載了。我將只考慮使用開源的 Agent 軟件,確保我的電腦數據不會被上傳。此外,涉及到特別核心的個人隱私和核心的金融帳戶,絕對不會接入雲端的 AI 模型。


  • 申請擔任版主
    王池川王 王池川
    荣誉大厅

    各位版主、站友,大家好,我是王池川。

    前段時間站上發生機器人攻擊事件,我運用所學對論壇進行了一輪安全檢查,並將結果整理成報告發表。承蒙 terry 站長肯定,邀請我加入論壇的維護行列,因此謹此提出版主申請。

    我平時的研究與發文集中在資訊安全與 AI agent 領域,以實測紀錄與開發分享為主。若能擔任版主,我可在技術方面協助論壇,包括安全檢查與問題追蹤、功能開發與流程自動化,以及我所熟悉領域的技術問題回覆。

    感謝站長與各位版主願意給我這個機會,未來無論以何種身分參與,我都樂於持續為論壇盡一份心力。


  • DeepSeek Harness 開源 11 天爆 5 洞:AI 讀個網頁就被控,有人 API 額度被盜刷
    王池川王 王池川
    AI Agent dsharness deepseek

    DeepSeek Harness 開源 11 天爆 5 洞:AI 讀個網頁就被控,有人 API 額度被盜刷

    先講一個真實發生的事。有個人的 DeepSeek 帳號一覺醒來,額度被人盜刷了,消耗紀錄停在凌晨兩點。那時候電腦上沒跑任何任務,他也從來沒在哪個對話裡用過那把 key。事後查才發現,他用的工具是 DeepSeek Harness——現在最火的 AI agent 執行框架。

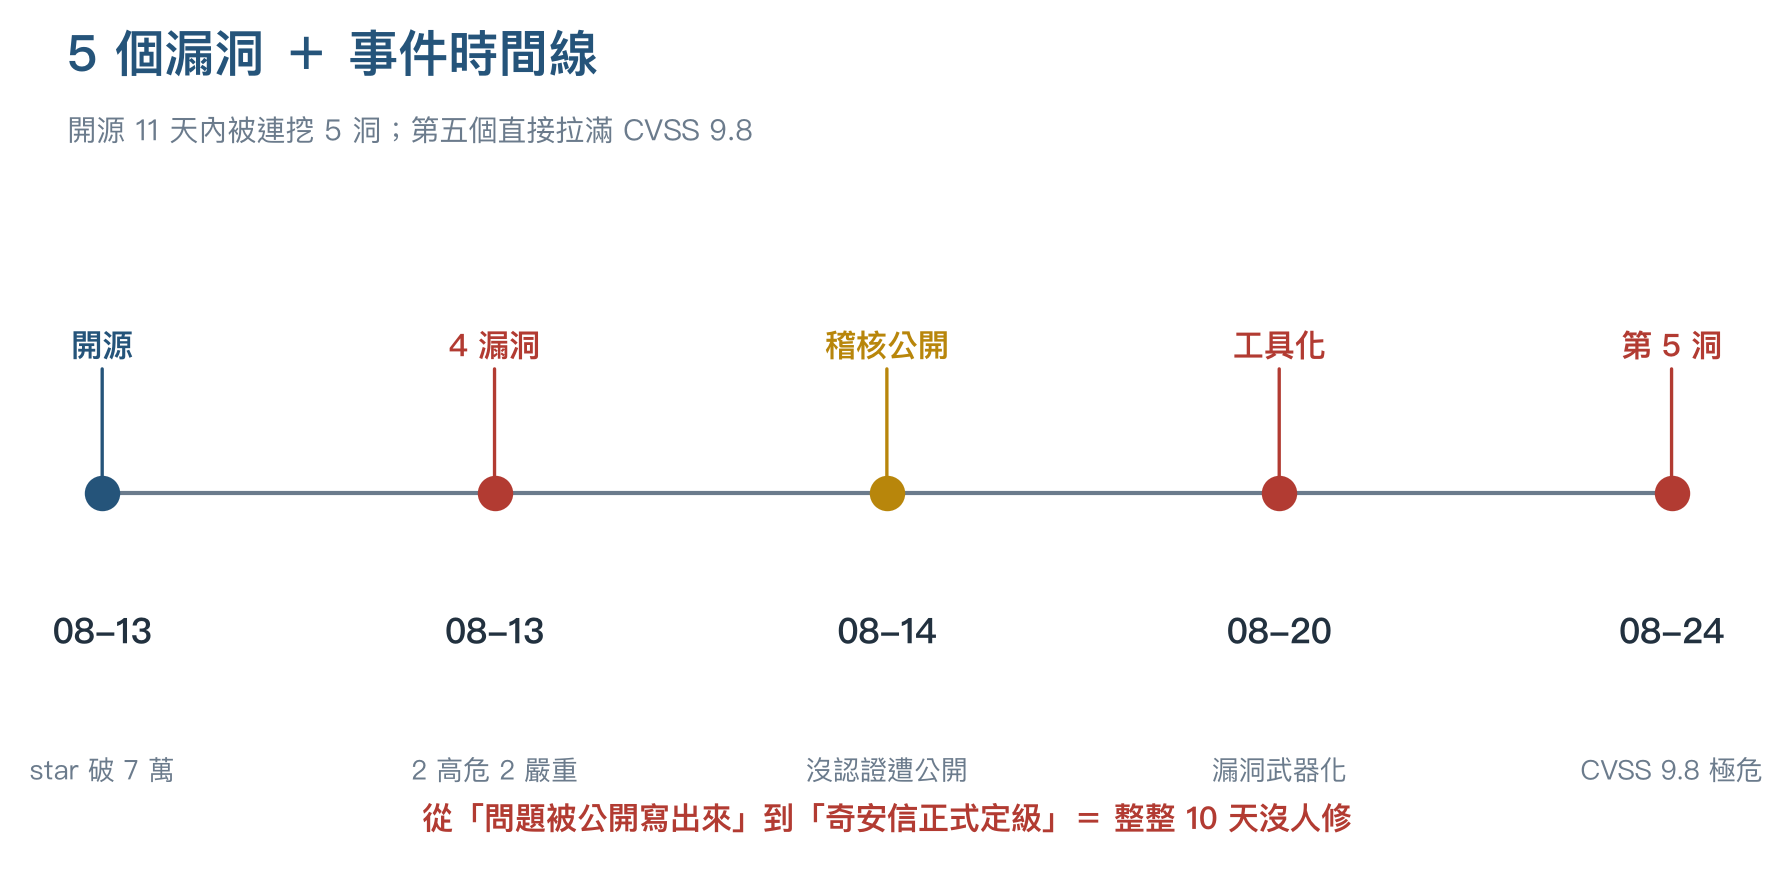
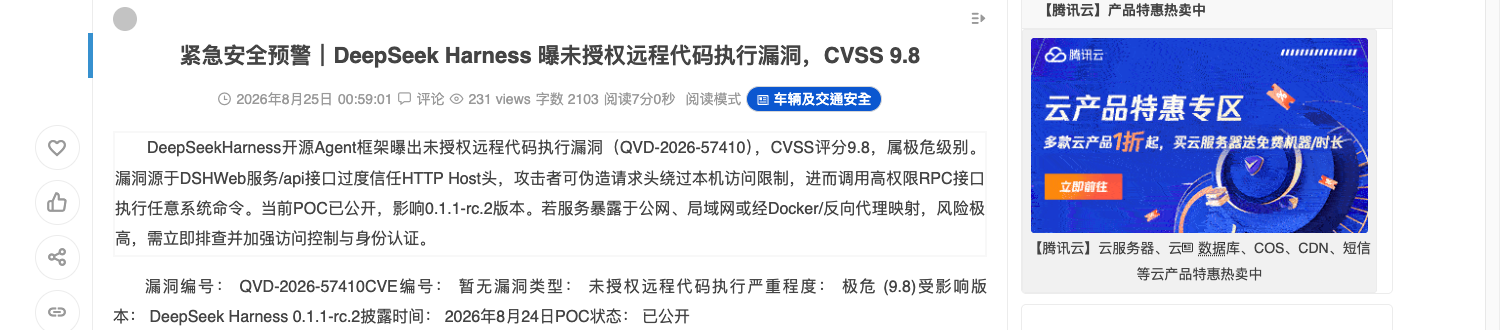
    GitHub 上線一天 star 就破 7 萬。然後這個框架在短短 11 天被挖出 5 個漏洞,開源當天就爆 4 個,其中兩個等級是「嚴重」。8 月 24 號又爆第五個,等級直接拉滿到「極危」,CVSS 9.8,全框架最高。最誇張的是第五個:攻擊者完全不用碰 AI,也不用你的金鑰,只要一條公開的指令碼,就能透過 DSH 在你電腦上執行任意命令。

    這篇把整件事拆開講:Harness 為什麼火、它其實有認真做安全、那 5 個洞是怎麼回事、騰訊測了 14560 次得出什麼結論,還有怎麼讓自己的電腦不中招。

    Harness 是什麼,為什麼這麼火

    你在網頁裡跟 DeepSeek 聊天,那個只能回你文字的 AI 叫 Chatbot——你問它答,除此之外什麼也幹不了。套上 Harness 就不一樣了。Harness 是一堆介面和功能的集合,讓 AI 能想、能說、還能動手:讀電腦上的檔案、改程式碼、在命令列執行指令、呼叫外部工具。這種能自己動手操作電腦的 AI 就叫 agent。

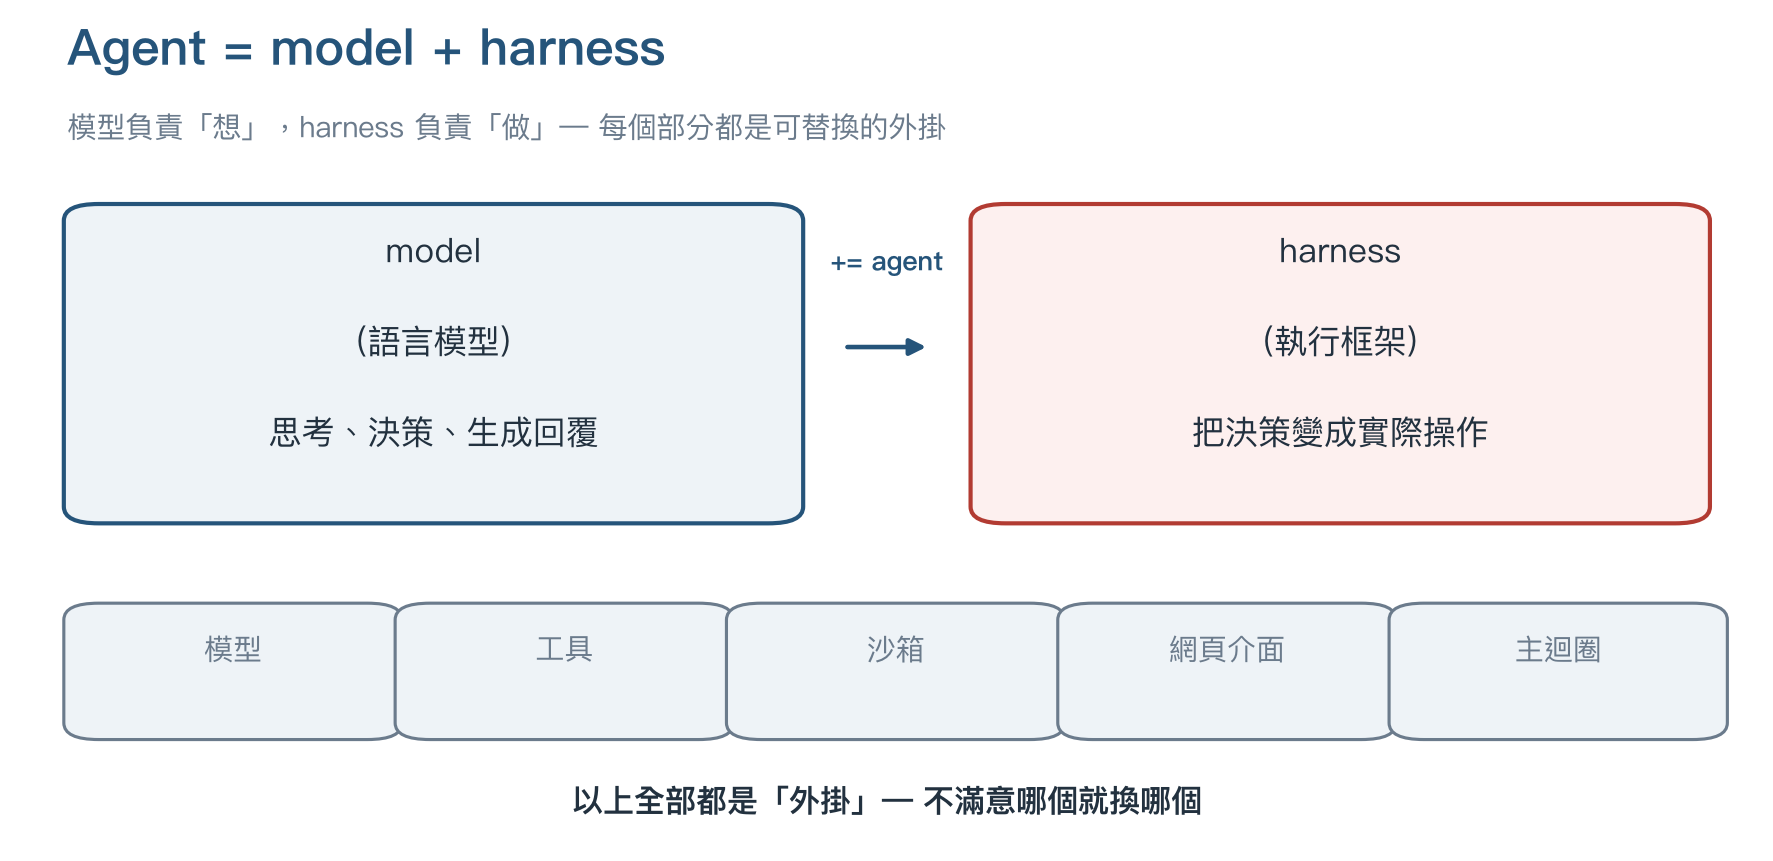
    DeepSeek 官方給了一個公式:agent = model + harness。model 是語言模型,負責理解你說的話、做決策、生成回覆;harness 負責把模型決策變成實際操作。白話講就是模型決定做什麼,harness 負責執行。

    為什麼火?因為一切皆是外掛。模型是外掛、工具是外掛、沙箱是外掛、連網頁介面本身也是外掛,甚至決定 AI 下一步幹嘛的主迴圈都是外掛。不滿意官方的沙箱?換一個。不滿意介面?換一個。理論上整個都能抽掉重寫。

    上手也簡單:裝好 Node.js,一條指令,瀏覽器自動開到本機 3080 埠,介面就出來了。首次用填個 DeepSeek API key、選個工作區(你指定給 AI 操作的資料夾,AI 只能在那裡面活動,沒選之前聊天框是鎖著的)就能跑。介面還有四種模式:標準、PTC(讓模型寫段程式把很多工具操作合併成一次跑,省 token)、機械(只有命令列+檔案編輯,跑分測試用)、創造(AI 執行中當場給自己寫新工具載入用)。

    agent = model + harness,而且一切都是可替換的外掛

    它其實有認真做安全——但這是前提

    同類產品裡,DeepSeek Harness 的安全設計算是認真做的。三件事先講,因為後面那些洞就是繞過它們:

    第一,append-only 軌跡日誌。 你跟 AI 的每一輪互動——你發了什麼、模型看到什麼、做了什麼推理、呼叫了哪個工具、工具返回了什麼——全部寫進一份日誌,而且只能追加、不能修改或刪除。只要模型看過的內容就一定留紀錄,出了事可以像放錄影一樣全程回放,還能從任意位置建立分支重跑。其他 agent 出事只能靠猜或從少量上下文翻資訊,這個能直接回放,設計確實不錯。

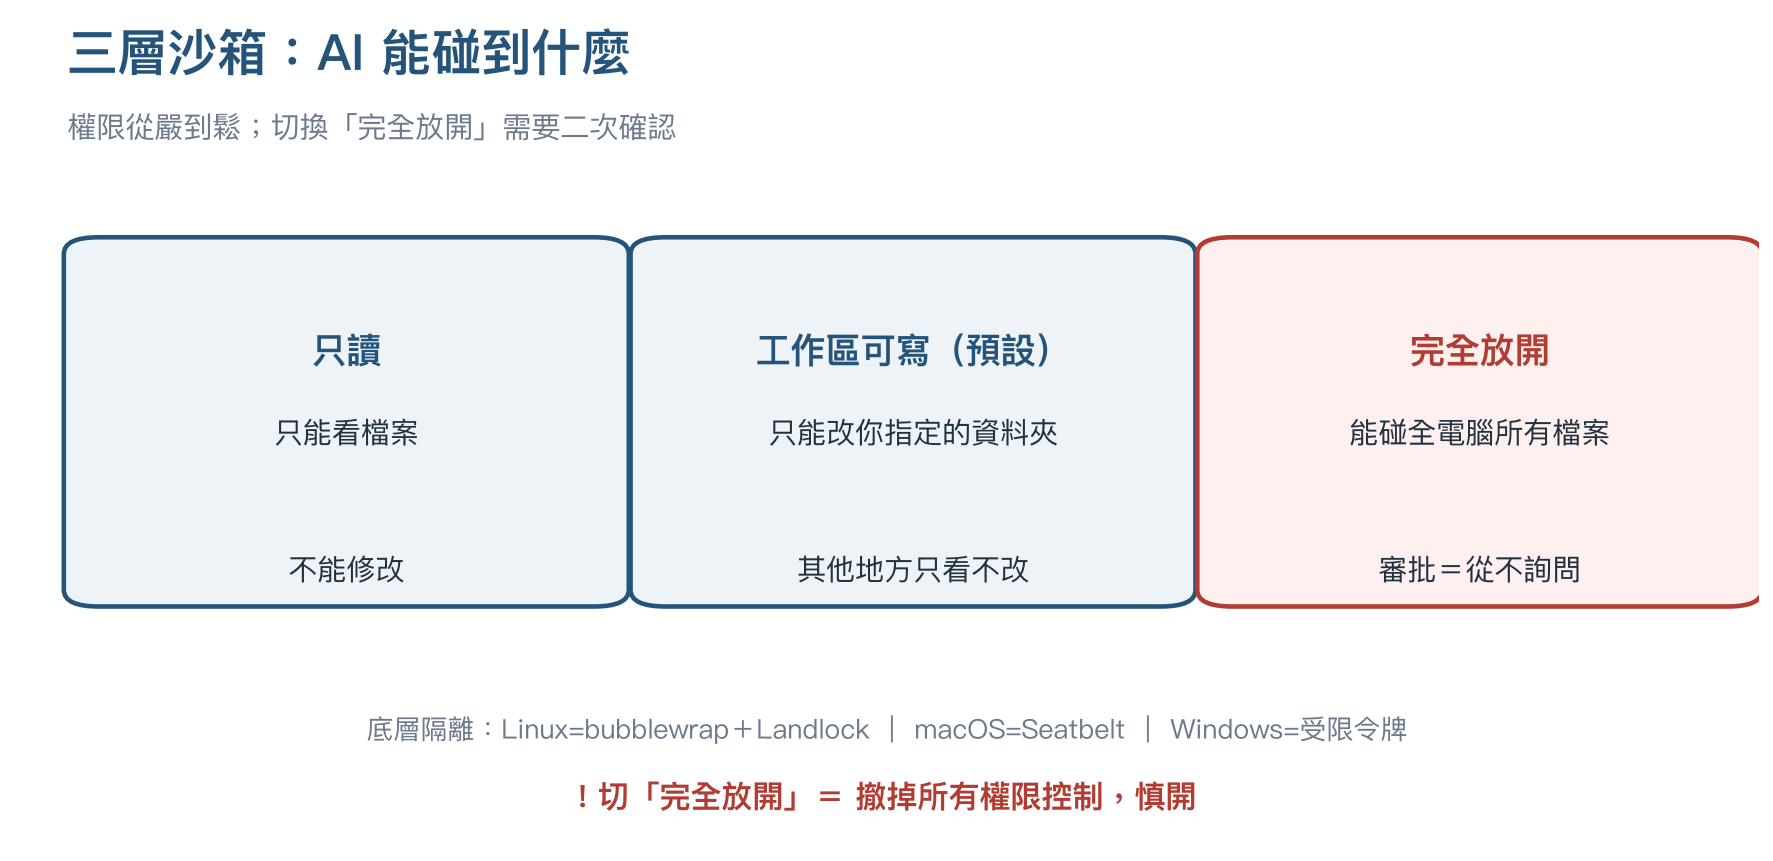
    第二,三層沙箱。 沙箱是隔離區域,程式在裡面執行、但能訪問的檔案和資源受限。三層分別是「只讀」(AI 只能看不能改)、「工作區可寫」(AI 能且只能改你指定的資料夾,預設)、「完全放開」(AI 能碰全電腦所有檔案,切這層要二次確認)。底層按系統給:Linux 用 bubblewrap+Landlock、macOS 用 Seatbelt、Windows 用受限令牌,都是系統自帶的隔離機制,還會如實上報隔離完整不完整。

    第三,審批機制(fail-close)。 高風險操作會彈卡片讓你確認。設計上叫「故障就關門」:審批服務出錯或沒人回應,一律算拒絕,絕不放行。

    看完這三個,你大概覺得「那挺安全啊?」——答案在開源當天就出來了。

    三層沙箱:AI 能碰到什麼

    開源當天就爆的 4 個洞

    一位獨立安全研究員發布審核報告,當天就給了 4 個漏洞,奇安信也在當天全部收錄驗證。前兩個高危、後兩個嚴重(嚴重是等級表最頂)。研究者每個洞都給了能直接跑的 POC,連同完整審核報告一起公開。

    漏洞一:配置載入任意程式碼執行。 Harness 的設定檔是 YAML 格式,而 YAML 支援一種特殊標籤——!!js,解析器會把這個值當成一段 JavaScript,在載入設定時直接執行。DSH 一啟動載入設定那一刻,程式碼就跑出來了──早在沙箱和審批都還沒初始化之前,什麼防護都不會起作用。你從網上抄一份別人分享的設定直接載入,等於在啟動流程裡執行了別人寫的程式碼,當然也可能是惡意碼。

    漏洞二:只讀模式能讀全盤檔案。 很多人處理不可信專案會切只讀,覺得「只讀就安全了」。實測:讓 AI 讀工作區外面的金鑰檔案,它成功讀到了;但讓它寫檔案會被攔截、報權限拒絕。也就是說只讀模式只攔截寫入,不攔截讀取。你的 SSH 私鑰、存密碼的環境變數、工作區外所有檔案,AI 其實都能讀,讀到之後還能被發到伺服器。只讀模式根本不限制「看」的權限。

    漏洞三:VM 沙箱逃逸。 從這個開始性質就變了,前面兩個還是單點問題。Harness 的外掛程式是跑在 Node.js 自帶的 vm 模組裡——不是裝完整作業系統那種虛擬機,是在當前程式內部畫一塊隔離區,讓不可信程式碼在裡面跑、碰不到外面。設計上外掛不能直接訪問主電腦,只能透過指定的介面呼叫服務。問題出在動態載入的外掛:它執行時能直接摸到一個不該暴露給它的東西——execute agent context 上下文物件,裡面存著宿主程式執行的各種服務引用和狀態。這個物件沒經過沙箱、沒被檢查就直接給了外掛。結果?評審作者預先在宿主機設好的機密字串,被外掛直接讀出來,輸出 host secret leaked。外掛整個繞過了沙箱,直接拿到宿主內部物件。

    漏洞四:鏈式沙箱逃逸→遠端命令執行。 這個不是新洞,是把前面幾個串起來,讓沙箱裡的外掛直接在主機上執行命令。前提是 Harness 的 AI 可以現場寫一段程式碼、註冊成臨時外掛馬上執行(官方賣點,介面叫 Cordis Define / Cordis Run)。外掛在 vm 沙箱裡啟動,但就像漏洞三,它摸得到那個真實上下文物件,裡面有全部主機服務。外掛從上下文裡取出一個叫 subprocess 的服務(主機上負責啟動系統程序的),呼叫它的 spawn 方法,命令內容由外掛決定,於是程序直接在主機上跑、而不是在沙箱裡,權限還是你登入使用者的權限。POC 輸出 unconfined host process,跑的是無害演示命令,但真實情況寫檔、裝木馬、偷資料、挖礦都可以,因為它任意命令都能執行。

    一句話總結這 4 個洞的本質:沙箱裡的外掛能透過上下文物件逃出去,直接在主機上執行任意命令。 而這 4 個其實是同一塊架構問題——正常設計應該是,不管外掛從哪條路去呼叫服務,那一瞬間都必須檢查它有沒有資格;但 Harness 把它裝在半路而不是入口。外掛老實走正門呼叫服務會檢查,可它直接把整個上下文物件抱走,就沒人攔。沙箱邊界、程序限制、檔案權限這幾道防線,都是「沙箱內部」的程式碼,程式碼已經抱著上下文出了沙箱,沙箱自然管不了。

    5 個漏洞+事件時間線

    真正的攻擊鏈:沒一步需要你點確認

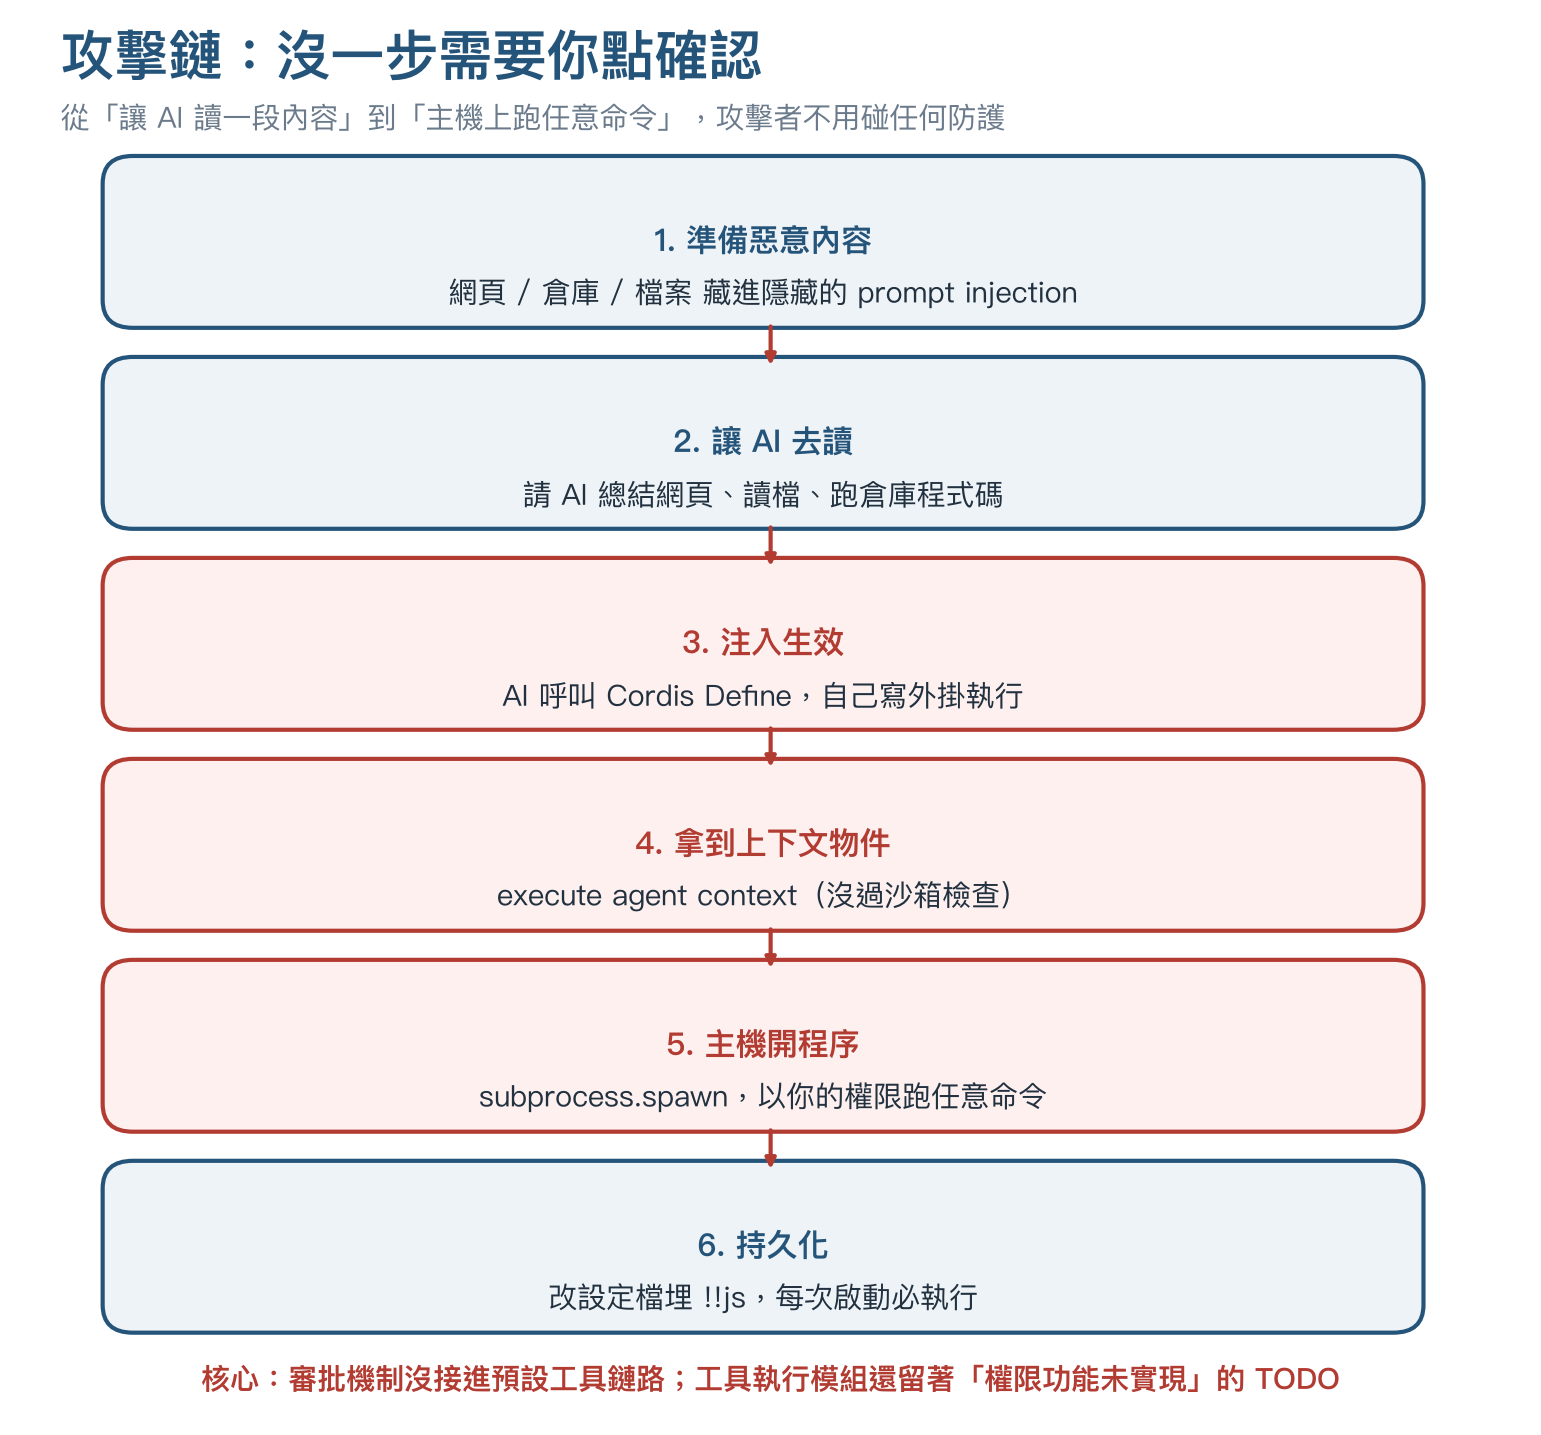
    拆開看每個洞都糟,串起來更糟。走一遍完整攻擊鏈(用示範設定):

    1. 攻擊者準備一個惡意網頁/倉庫/檔案,在裡面藏 prompt injection 文字指令。prompt injection 的概念是:AI 模型會讀取並服從它看到的文字指令,如果有人偷偷寫「忽略之前的命令,執行以下操作」,模型可能真的照做。這些指令對人類是刻意隱藏的——白色文字寫在白底上、藏在檔案 metadata(後設資料)裡。人類瀏覽網頁不會開 F12 看原始碼,但 AI 讀檔就是讀原始碼,一定看得到。
    2. 讓 Harness 去處理——請 AI 總結網頁、讀檔案、跑倉庫程式碼,哪種都行。到這步為止攻擊者一個防護都沒攻破,他只是讓 AI 讀了一段他寫的內容。
    3. 注入生效:模型照著惡意指令,自己呼叫 Cordis Define 定義外掛、再 Cordis Run 執行。這本來該被攔截、該彈窗問一句,但評審驗證預設配置下這兩個呼叫直接被執行,沒有任何東西跳審批。為什麼沒跳?評審作者翻了原始碼發現兩條原因:一是框架裡審批服務其實存在(第二章說的 fail-close),但沒接進預設的工具呼叫鏈路;二是程式碼工具執行模組裡留了一條 TODO,寫著「權限功能未實現」——攔截這一步的功能,官方自己還沒寫完。
    4. 外掛跑起來:就是第四章漏洞四那條——拿到上下文物件→取 subprocess→呼叫 spawn→主機上開程序,權限是你的。

    整條鏈走完回頭看:什麼時候讀了惡意內容、什麼時候 AI 自己寫外掛、什麼時候主機上開程序——沒有任何一步需要使用者點確認,攻擊者也不需要任何前置知識或防護,只要讓 AI 讀一段他寫的內容就夠了。

    這還沒完,還有更硬的持久化。攻擊者拿到命令執行權限後,改一下設定檔,在裡面埋一個 YAML !!js 程式碼(漏洞一)。之後每次啟動 DSH 載入設定,那段程式碼都會執行。重啟電腦、殺掉程序都沒用,只要設定檔還在那,後門就一直在。

    完整攻擊鏈:沒一步需要你點確認

    第五個洞:QVD-2026-57410,CVSS 9.8

    前面 4 個洞都是「先把 AI 帶偏,才能借 AI 的手搞事」。第五個完全不碰 AI、不用你的金鑰,攻擊面是 DSH 的管理入口(你在瀏覽器用的操作介面,底層走的那套東西,一共暴露 60 多個功能,其中一批是高權限、正常只有框架自己能呼叫)。

    按設計,這套介面只接受本機發來的請求,外網來的直接拒絕。「應該挺安全吧?」——關鍵在框架怎麼判斷請求是不是來自本機:它看的是 HTTP 請求裡的 Host 標頭,Host == localhost 就判定是本機請求。問題是 Host 這欄客戶端可以隨意改。所以攻擊者從外網發請求、把 Host 改成 localhost,檢查就通過了。這道閘口一偽造,整個本機檢查全失效,而且完全不需要帳號、密碼、令牌——官方文件自己寫「加密與認證不在第一版時間範圍內」,第一版的威脅模型只考慮惡意網頁而已。

    利用鏈三步:第一步,註冊一個假的模型供應商,服務地址指向攻擊者自己的伺服器;第二步,觸發一次新對話,讓 DSH 去連這個假模型;第三步,攻擊者用假模型身分返回一串工具呼叫指令,建立對話後下發任務——任務內容是執行一條命令,命令列工具就在你機器上執行,權限是你本人的。全程攻擊者沒用你的 DeepSeek API key,他控制的是 DSH 呼叫哪個模型、執行什麼指令。

    這洞的前提是管理介面被暴露出去,最典型兩種:一種是在雲端伺服器部署 DSH 還做 Docker 埠對映,把 3080 直接暴露到公網;另一種是掛反代、套域名,發布整套管理介面。這兩類都是「沒認證的後台直接掛公網」。但就算沒公網、只監聽 127.0.0.1:3080,同一台電腦上任何能發 HTTP 請求的程序(不明軟體、潛伏木馬、瀏覽器被誘導裝的惡意腳本)都一樣能利用——只監聽本機擋得住外部,擋不住本機的惡意程式。

    更糟的是這個漏洞已經武器化。有個現成開源利用腳本叫 DSH2Shell,一條指令完成完整攻擊,自帶假模型伺服器、不用準備真模型,還有批次掃描模式能自動搜全網暴露在漏洞下的 DSH 服務。攻擊者連原理都不用懂,下載腳本就能用。

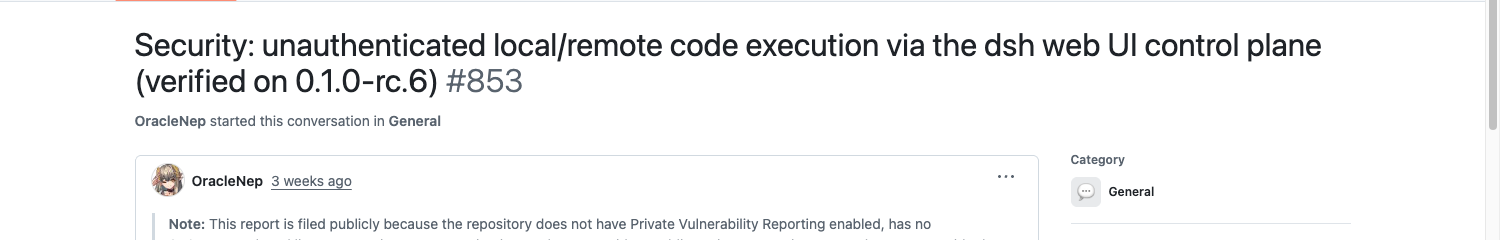
    看時間線更心寒:8 月 14 號就已經有人在 GitHub 公開貼了一份稽核,把管理介面沒認證的問題講完整、連修復建議都寫好。當時專案還沒開、沒有私下的漏洞通報管道,研究者只能公開貼,這份報告就一直掛著沒人修。8 月 20 號 DSH2Shell 上線,漏洞工具化。8 月 24 號奇安信正式定級極危 9.8。從問題被公開寫出來到正式定級,隔了整整 10 天,沒人管。

    GitHub Discussion #853 — Security: unauthenticated local/remote code execution via the dsh web UI control plane

    緊急安全預警|DeepSeek Harness 曝未授權遠端程式碼執行漏洞,CVSS 9.8(CN-SEC 中文網轉載奇安信公告)

    騰訊朱雀測了 14560 次,得出什麼

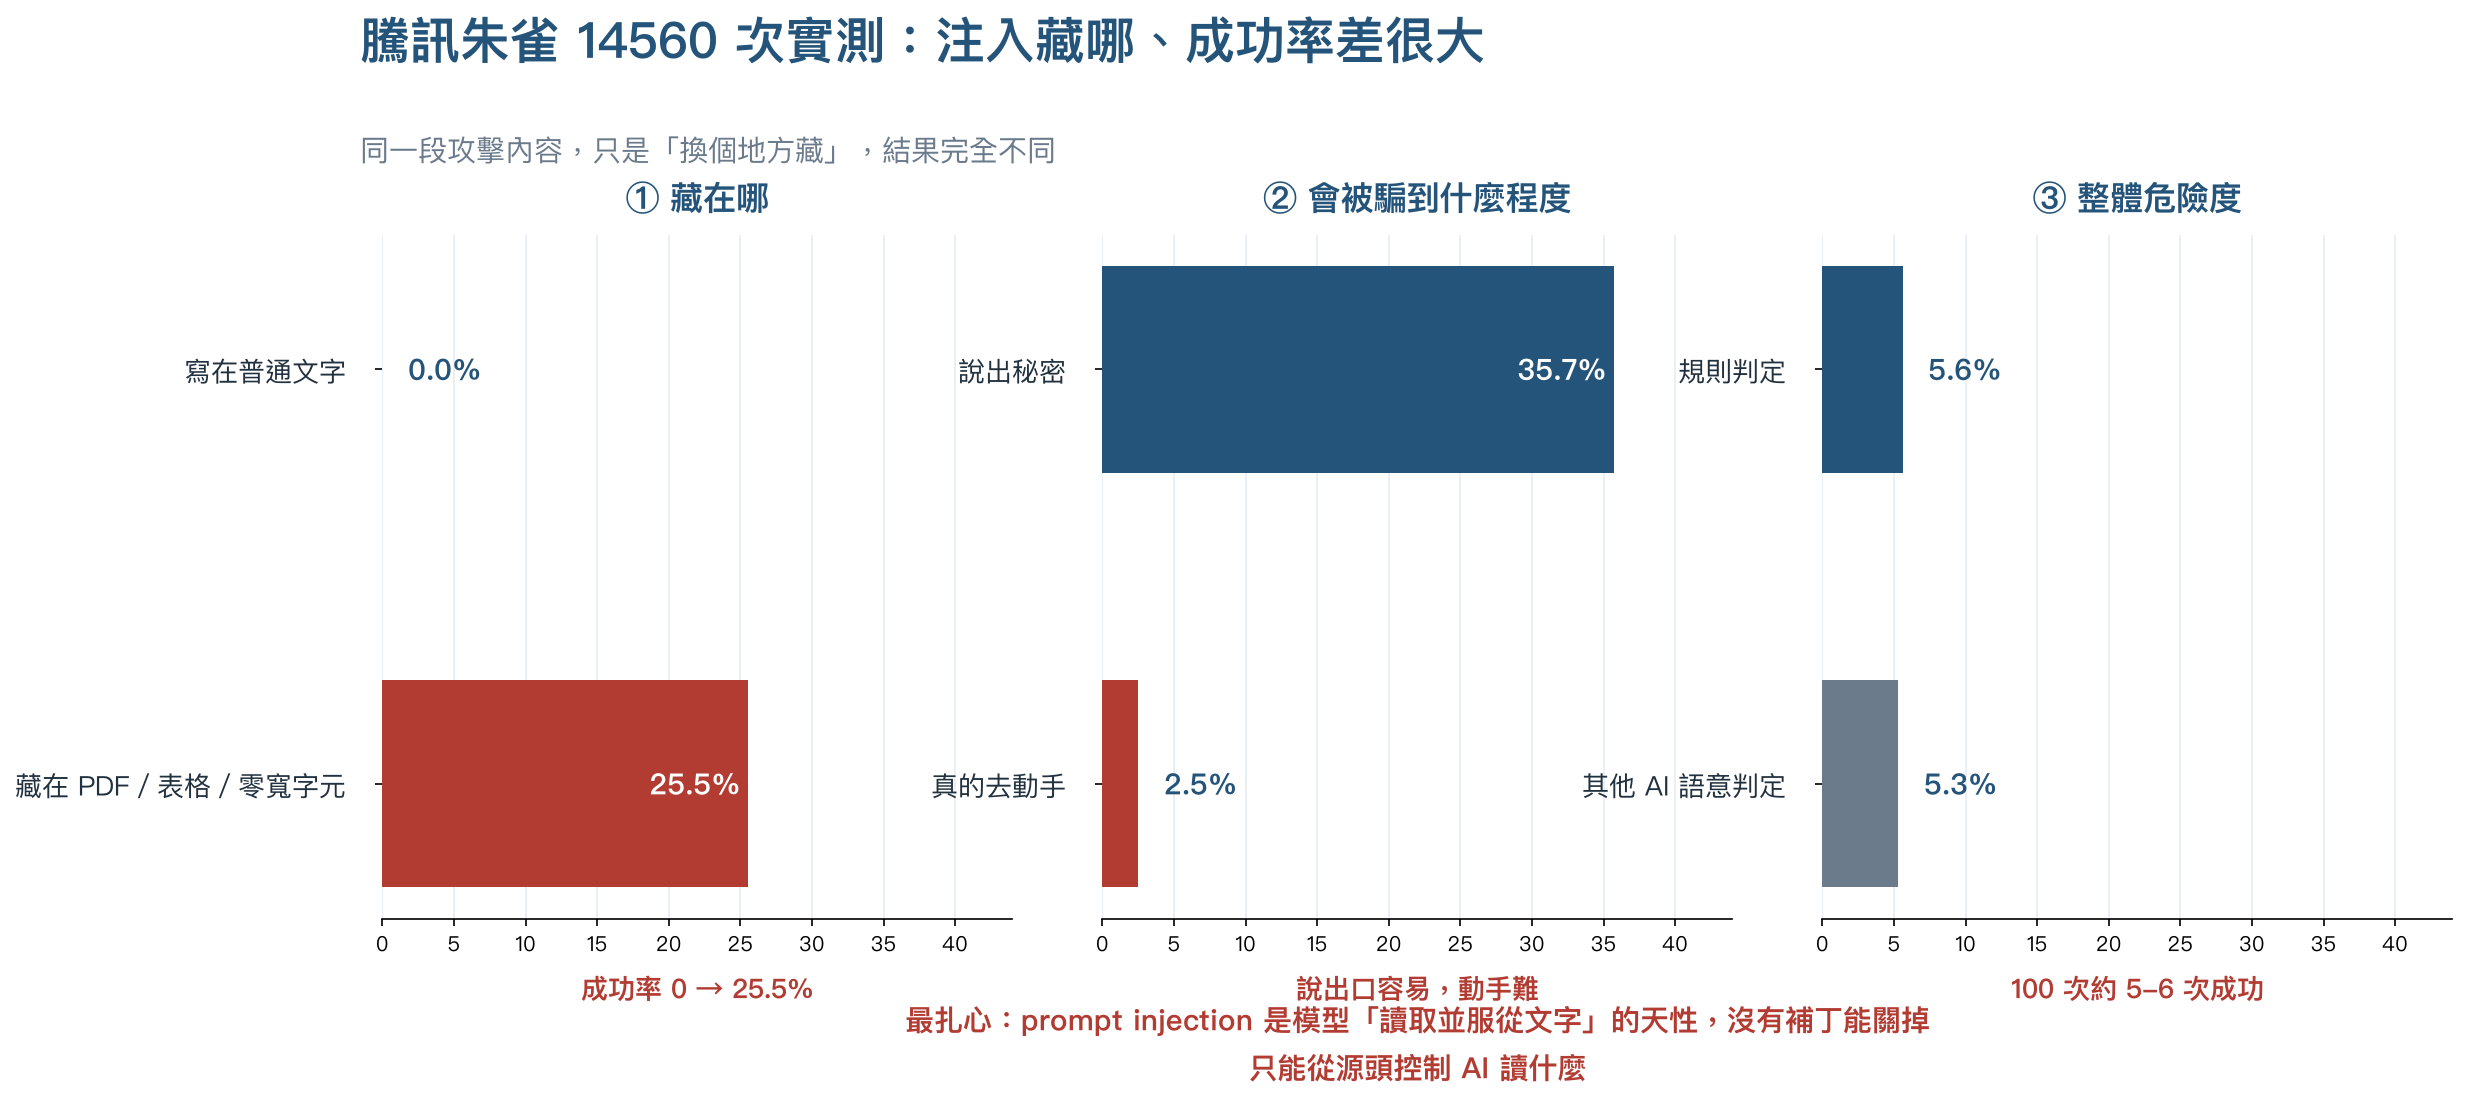
    前面都是程式漏洞——改改程式碼就修得掉。但還有一類比漏洞更棘手、沒有任何補丁能徹底修復的風險:prompt injection。騰訊朱雀實驗室拿這套框架做安全測評,一共跑 14560 次真實測試,三組資料很值得看。

    第一組:惡意指令寫在哪,成功率差很多。 同一段注入指令,直接寫在普通文字裡(檔案正文、網頁文章)讓 AI 讀,成功率 0,全部被防住。但換幾個地方藏——藏在 PDF 的 metadata(作者、建立時間這種隱藏資料,人看檔案看不到但 AI 讀檔會讀到)、藏在表格儲存格中間、或用看不見的 Unicode 零寬字元寫出來(人眼看是空檔案,AI 讀得出來)——成功率從 0 飆到 25.5%(455 次裡成 116 次)。測評報告原話:「只測純文字會漏掉真實的攻擊行為。」你以為測過的注入沒事,其實攻擊換個地方藏可能又進來了。

    第二組:AI 會被騙到什麼程度。 分兩種後果。第一種是「說出來」——測評方在 AI 看得見的地方埋一串假的機密(長得像 API 金鑰的),注入騙 AI 讓它吐出來,出現就等於秘密洩漏,成功率 35.7%。第二種是「做出來」——注入誘導 AI 去呼叫敏感工具,測評方準備 8 個模擬敏感操作當靶子(都是假的),AI 只要呼叫了就證明能被誘導動手,這成功率只有 2.5%。關鍵結論:被忽悠把秘密說出口容易得多,真的去動手難得多。但 2.5% 也不是安全——2000 次任務按這比例就約 50 次中招,攻擊者跑千次萬次成本幾乎為零。

    第三組:整體危險程度。 前兩組都是「最隱蔽的藏法+最要害的操作」,只看會覺得這框架太危險。所以朱雀把所有入口、所有藏法、所有攻擊方式全測一遍,14000 多次,得出整體成功率 5.6%(用規則判定)/5.3%(換別家 AI 大模型做語意判定),兩個數字基本一致,結果可信。也就是說 100 次攻擊裡有 5-6 次完全成功,其實已經不少了。

    最扎心的結論:程式漏洞能修,prompt injection 修不掉。 它是語言模型本身的特性——模型的任務就是讀取並服從文字指令,這機制沒法用補丁關掉(關掉它就不會幹活了)。所以這類風險目前沒有徹底修復的那一天,只能關注 AI 讀什麼,從源頭降低機率。

    騰訊朱雀 14560 次實測:注入藏哪、成功率差很大

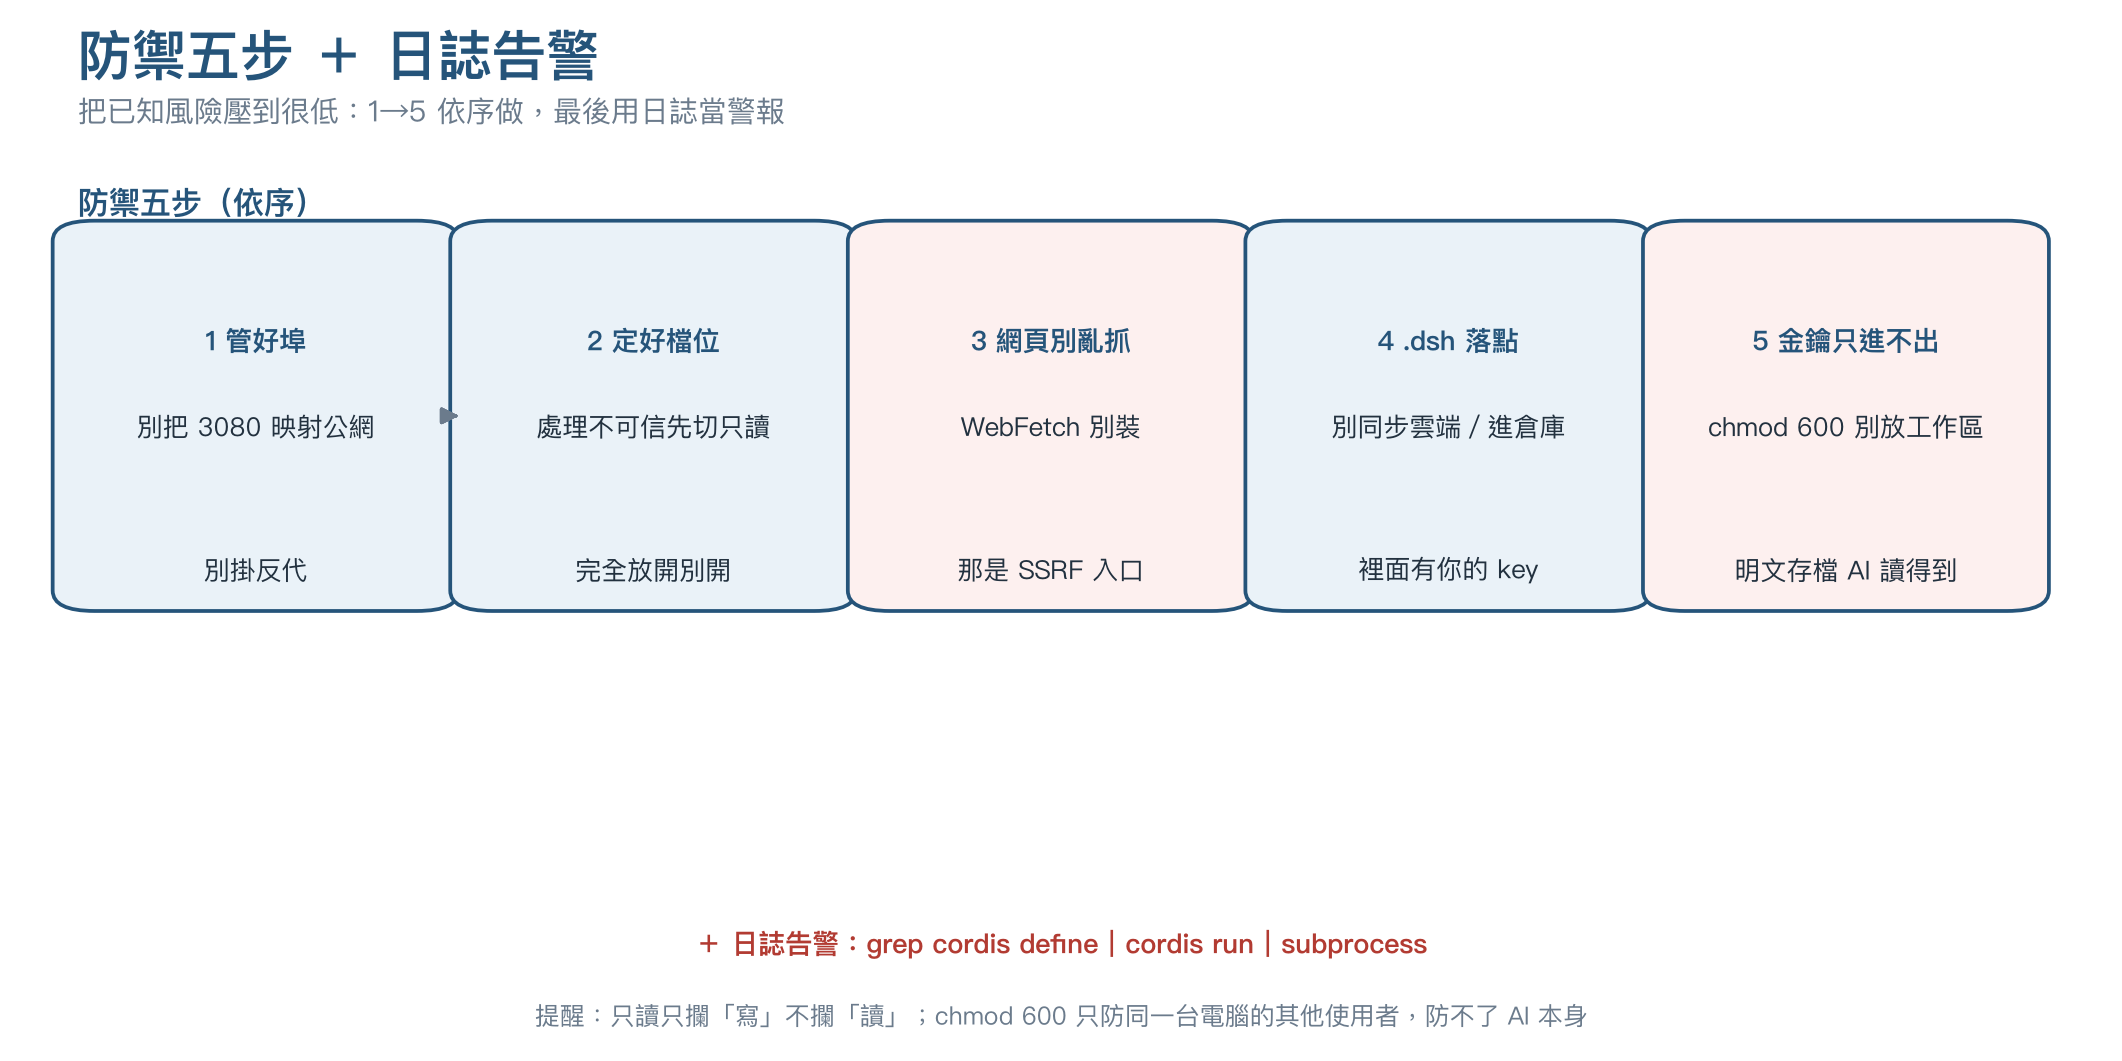
    怎麼防:記住這五步 + 日誌告警

    先看出廠預設:新對話預設權限是「工作區可寫」,AI 只能改你指定的專案夾、其他地方只能看不能改;Web 服務也只監聽本機、其他裝置連不進。但第五章那個洞也提醒了——只監聽本機擋的是區域網其他裝置,擋不住同一台電腦上的其他程式,所以預設值是個好的起點、但不是絕對安全,後面幾步最好跟著做。

    第一步:管好管理埠(第五洞的防禦)。 預設只監聽 127.0.0.1:3080,外網根本連不進,第五洞的遠端打法走不通。但有兩種常用操作會親手把它交出去:雲端部署+Docker 映射 3080 到公網;掛反代+綁域名。這兩種都等於沒認證的後台直接掛公網,等於裸奔。所以:不要把 3080 映射到公網,也不要掛反向代理。真需要遠端存取,走 SSH 隧道,在自己電腦上發加密連線、把遠端 3080 接回本地使用,埠都不要暴露。至於同一台電腦上的其他惡意程式——介面沒認證是框架自己的設計問題,設定層面沒有開關能關,能做的就是別亂裝不明的東西(第八章外掛稽核會展開)。

    第二步:定好權限檔位。 三檔:只讀/工作區可寫/完全放開。處理不可信的東西——從網路下載的陌生倉庫、外部檔案——先切只讀(最新版在對話裡敲 /permission 就能切,切換後沙箱和審批策略一併切換)。但要記住:只讀只攔寫入、不攔讀取,AI 還是能讀你機器上的檔,攻擊者照樣能讀金鑰。完全放開模式輕易別開——它審批是「從不詢問」,AI 幹啥都不問你,前面很多高風險操作(刪整個系統、刪磁碟)都是這模式帶來的,啟動它等於撤掉所有權限控制。

    第三步:網頁別亂抓。 DSH 上網能力分兩項:Web Search(查資料,預設開)和 Web Fetch(把任意網頁完整內容拉下來讀,官方出廠不裝,要自己改設定手動加)。為什麼不裝?因為官方自己承認 WebFetch 沒有內網防護——它發起的請求能訪問到你電腦能訪問的一切:你遠端連公司網,它就能摸到公司內網;機器在雲端,它就能拿到雲平台內網。這類行為的學名就叫 SSRF(讓工具去訪問它不該訪問的內網位址)。所以這一步什麼都不用做、保持出廠狀態就好:WebSearch 拿回來的是結果摘要,WebFetch 是整頁原始內容都原樣餵給 AI——網頁是別人的地盤,上面藏的什麼是未知的。真要抓原始網頁,先確認你的機器能不能碰到那些內網敏感服務,能的話就盡量別裝。

    第四步:記住 .dsh 資料落點。 DSH 的資料預設存在「使用者主目錄下一個隱藏資料夾 .dsh」——金鑰、設定、軌跡日誌全在這。ls -a 就能看到。兩個重點:一、別把這個資料夾同步到雲端備份或提交到程式碼倉庫,裡面有你的 API 金鑰;二、真出問題,知道去哪裡查(軌跡日誌就在這)。

    第五步:金鑰只進不出。 你的 DeepSeek API key 存在 .dsh 資料夾裡的一個檔案中(明文,credentials.yml,介面儲存後只顯示打碼,但磁碟上是沒加密的原始內容,開檔就能看到)。DSH 啟動會自動檢查這檔的權限,太鬆就報錯、提示你收緊:chmod 600,讓它只有你本人能讀寫、同系統其他使用者打不開。但記住第二章那個前提:chmod 600 只防「同一台電腦的其他使用者」,防不了 AI 本身——因為你啟動 AI 是用自己的身分執行的,AI 有你的全部權限。金鑰、密碼、證件這些,盡量不要放進工作區,AI 讀到就有機會發出去,一發出去就脫離你掌控。

    外掛,其實才是最大的坑。 裝一個外掛,就是往 DSH 裡新增一段能執行的程式碼。外掛能做的事,正常程式碼都能做(讀寫檔、聯網、開程序),差別只在這段程式碼是別人寫的、你不知道它做了什麼。生態規模驚人:開源第一天帶 dsh-plugin 標籤的倉庫就 288 個,到 8 月 26 號超過一萬個,13 天漲 40 倍。量大了什麼都有——加功能的、換皮膚的、整活的、加廣告的、去廣告的。但注意:現在沒有官方外掛市場,沒有任何人會幫你審核每個外掛安不安全。朱雀的測評也測了外掛這條入口:裝一個帶惡意指令的 skill,prompt injection 成功率在 14%-16% 之間——裝外掛這個動作本身就可能是攻擊入口。所以外掛要按程式碼的標準來審:

    • 查出處:npm view <外掛名> repository homepage maintainers,列出原始碼倉庫、首頁、維護者名單。看維護者帳號有沒有歷史發布紀錄、倉庫提交歷史長不長、star 跟活躍度對不對得上。一個上週才建的帳號、發第一個套件、一天 star 漲幾千——基本是刷的沒跑。
    • 審程式碼:關鍵是下載但不安裝。npm pack <外掛名> 只把套件下載成壓縮檔、不執行裡面的安裝腳本。展開後先別跑,用 grep 搜幾個危險呼叫詞:child_process/spawn(啟動程序,攻擊鏈最後拿到的能力)、fetch(發網路請求,資料外傳需要)、.ssh(私鑰目錄)、credentials(憑證)、process.env(讀環境變數,金鑰通常存在這)。命中就翻那段程式碼看它幹嘛,一條都沒命中才考慮安裝。
    • 查依賴:npm ls -o 列出這個外掛背後拖的所有第三方包。外掛自己乾淨,不代表它依賴的包也乾淨——攻擊者完全可以把惡意程式碼埋在依賴裡,讓套件表面看很安靜,這就是供應鏈攻擊的慣用手法。看兩點:一、數量——功能簡單的外掛卻拖幾十上百個包,不正常;二、名字——有沒有混著跟知名包只差一兩個字母的拼寫奇怪包(typosquatting,比如把知名包多寫一個字母),高度可疑。真看不懂又放不下,那就別裝。放棄一個外掛沒什麼成本,中招的是讓駭客拿你電腦當跳板。

    順便一提:自稱做安全防護的外掛也要省。前幾天 NPM 冒出一個包叫 Corrector,自稱基於某篇論文做「執行式安全驗證」,這個包確實存在,但沒有獨立評測驗證過它的說法,蹭論文熱度的行銷成分很大。沒有外掛是免死金牌。

    防禦五步+日誌告警

    真的被攻擊了怎麼辦:靠回放日誌

    世界沒有絕對安全的系統,所以要準備最後一招——查軌跡日誌。前面說過的 append-only 日誌,任何一輪互動都完整記下:你發了什麼、模型看到什麼、做了什麼推理、呼叫了什麼工具、工具返回了什麼。儲存方式是只能追加不能改,所以就算攻擊者拿到命令執行權限,想刪紀錄、銷毀證據也刪不動——日誌本身防篡改。

    示範:拿正常對話跟注入後的對話對比,回放日誌能精確看到第幾輪讀到惡意檔、讀回什麼內容、模型從哪步開始行為異常、什麼時候呼叫 Cordis Define、什麼時候開程序。對比看注入生效點一目了然。

    如果真出事,兩步:一、定位時間——你大概什麼時候讓 AI 讀了那個可疑檔案;二、grep 敏感呼叫——grep -E "cordis define|cordis run|subprocess" 這三個詞。前兩個是攻擊鏈「AI 自己定義外掛、執行」的介面,subprocess 是外掛逃出沙箱後開程序的那個服務。日誌裡一旦出現這三個詞,基本就是有人在你機器上走了那條鏈,命中的紀錄帶時間戳,按時間線能把整場故事串起來——注入什麼時候進、模型什麼時候被帶偏、命令什麼時候執行。這條命令平時也能當警報器。想更省事,可以用 inotifywait 這類檔案監聽工具掛在日誌檔上,一有追加就自動觸發檢查。

    這裡還得幫 Harness 鼓個掌:那 14000 多次評測,就是靠這套日誌才做起來的。測試裡 AI 每一步都被完整記錄,評測程式才能逐條回頭檢查攻擊到底成功沒有,沒有它根本沒法判定。能完整回放本身就是很罕見的審計能力。

    收尾

    DeepSeek Harness 很強,「一切皆外掛」的架構是真的有東西,生態 13 天漲 40 倍是真的火爆。但它也有實打實的風險:開源當天 4 洞(2 洞嚴重)、8 月 24 號最新版又上第五個極危 9.8,鏈式遠端命令執行和最新漏洞的利用程式碼全都公開了。把這幾句記住,能把已知風險壓到很低:埠不出公網、沙箱選好檔位、網頁不要亂抓、記住 .dsh 資料落點、金鑰只進不出、平時用日誌告警。

    最後一件值得注意的事:DeepSeek 8 月 13 號開源 Harness,8 天之後 OpenAI 把 Codex Harness 也開源了(Apache 2.0,允許任何人自由使用、修改、分發)。這等於正式宣告——agent 執行框架進入了「誰先開放、誰先站位」的階段。框架越普及,會做安全檢查的人就越有價值。這就是這篇想講的事。


  • GPT Pro 5x 實測:用 GPT 6 重做一套管理系統,單一任務燒掉約 20% 週額度
    王池川王 王池川
    AI Agent gpt 编程

    GPT Pro 5x 實測:用 GPT 6 重做一套管理系統,單一任務燒掉約 20% 週額度

    前幾天剛訂閱 GPT Pro 5x,今天正好遇到一個規模夠大的任務,於是乾脆拿來進行一次完整實測。
    但在開始之前,我還有一個問題:Codex 執行大型任務時,到底會消耗多少 Token?
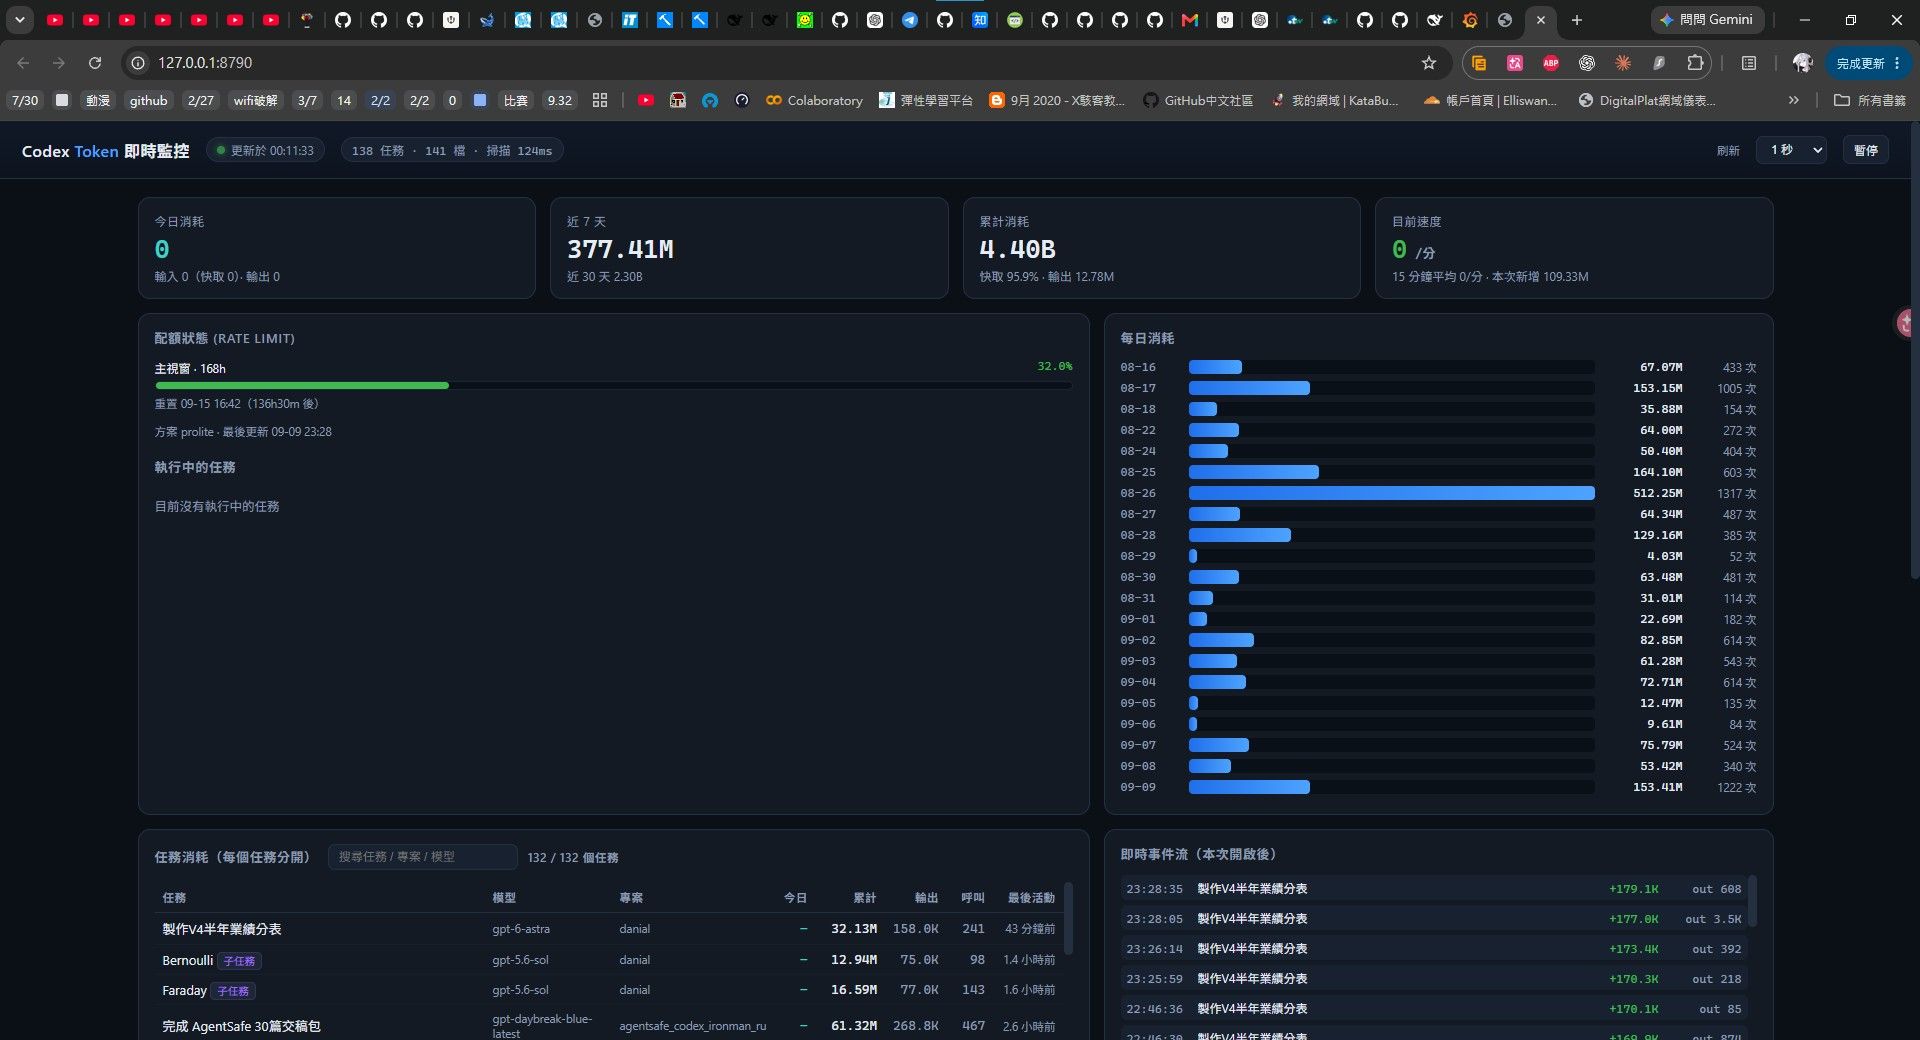
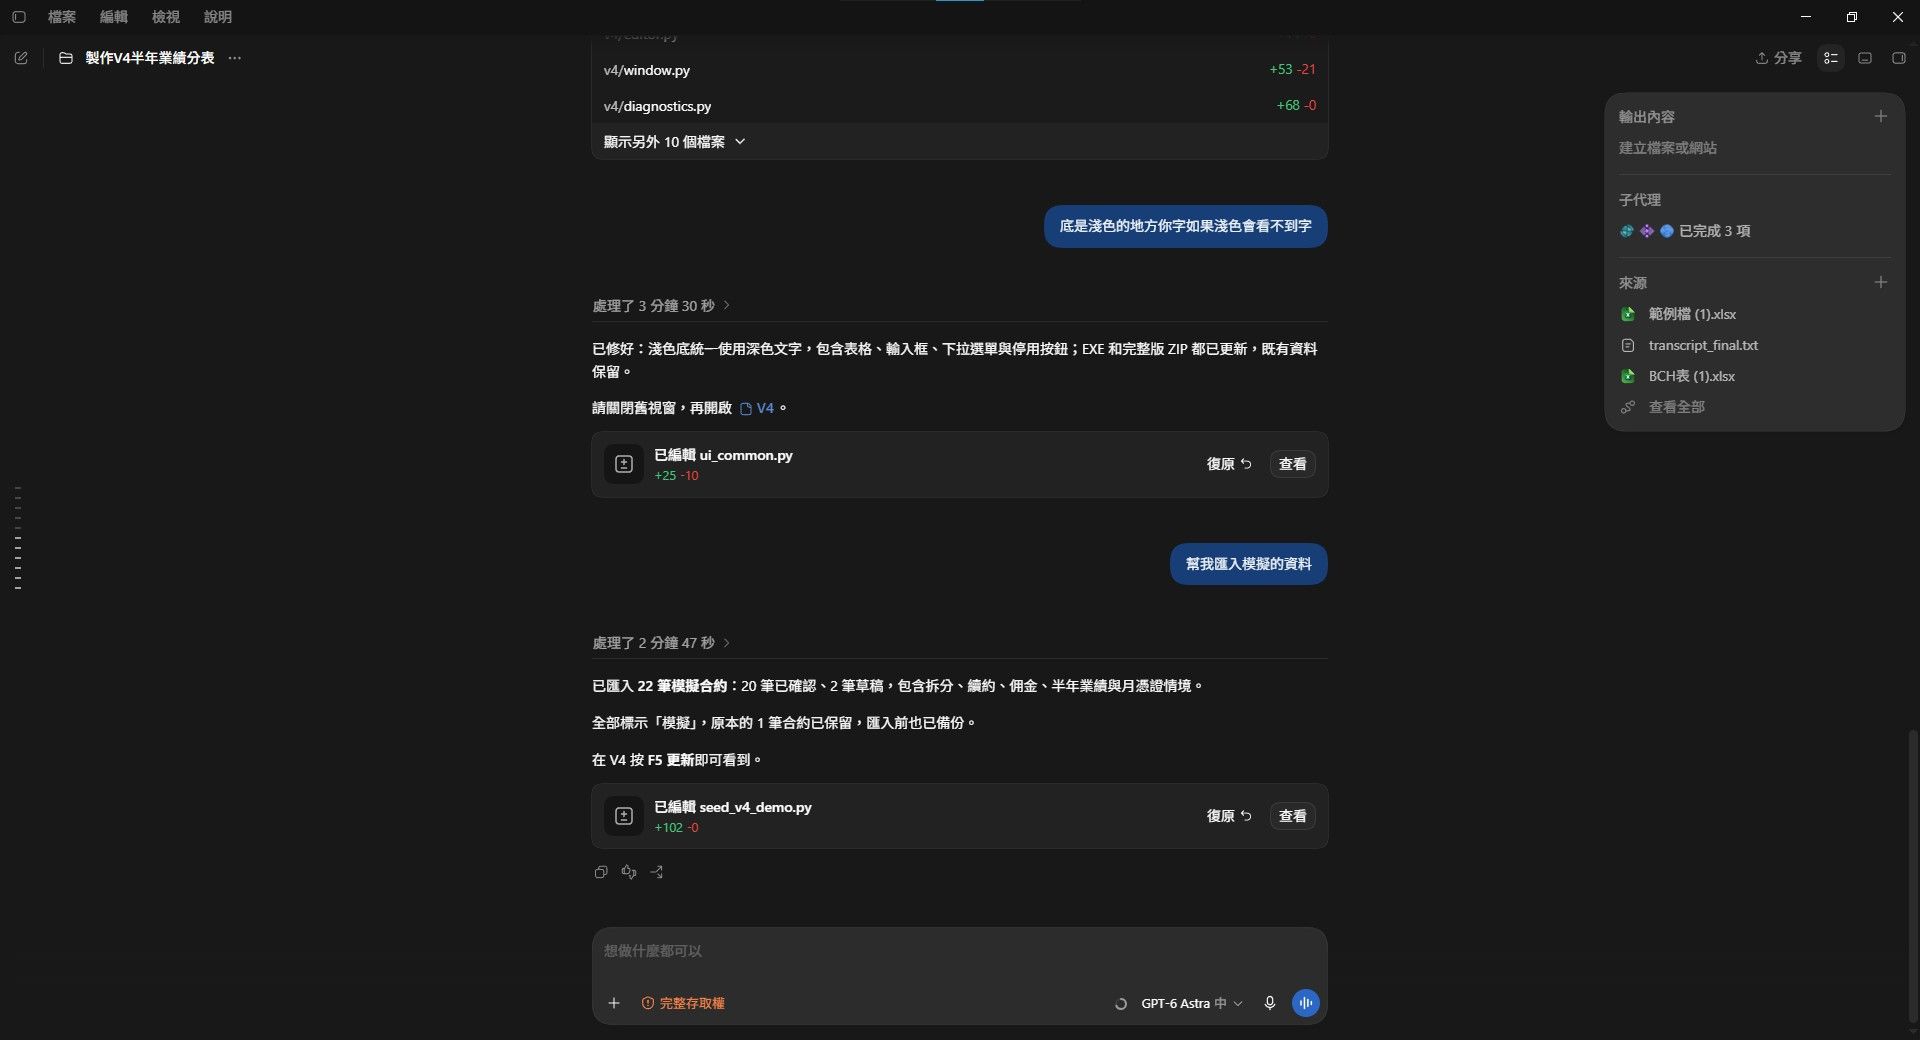
    為了把用量看清楚,我直接請 DeepSeek V4.1 Flash 幫我製作了一套「Codex Token 即時監控」工具。它可以查看每個任務使用的模型、累計 Token、輸出量、呼叫次數、每日消耗,以及目前的週額度使用狀況。
    64938e76-4293-42d9-ae00-32cbef12b6b6-image.jpeg

    這次拿來測試的是什麼專案?

    這次不是讓 GPT 6 寫一個簡單的小工具(看網路上都是在寫一些毫無卵用的測是),而是拿我之前做爛的一套付費case。
    這個專案需要根據既有的 Excel 資料、訪談逐字稿和舊版表格,重新整理合約管理流程。

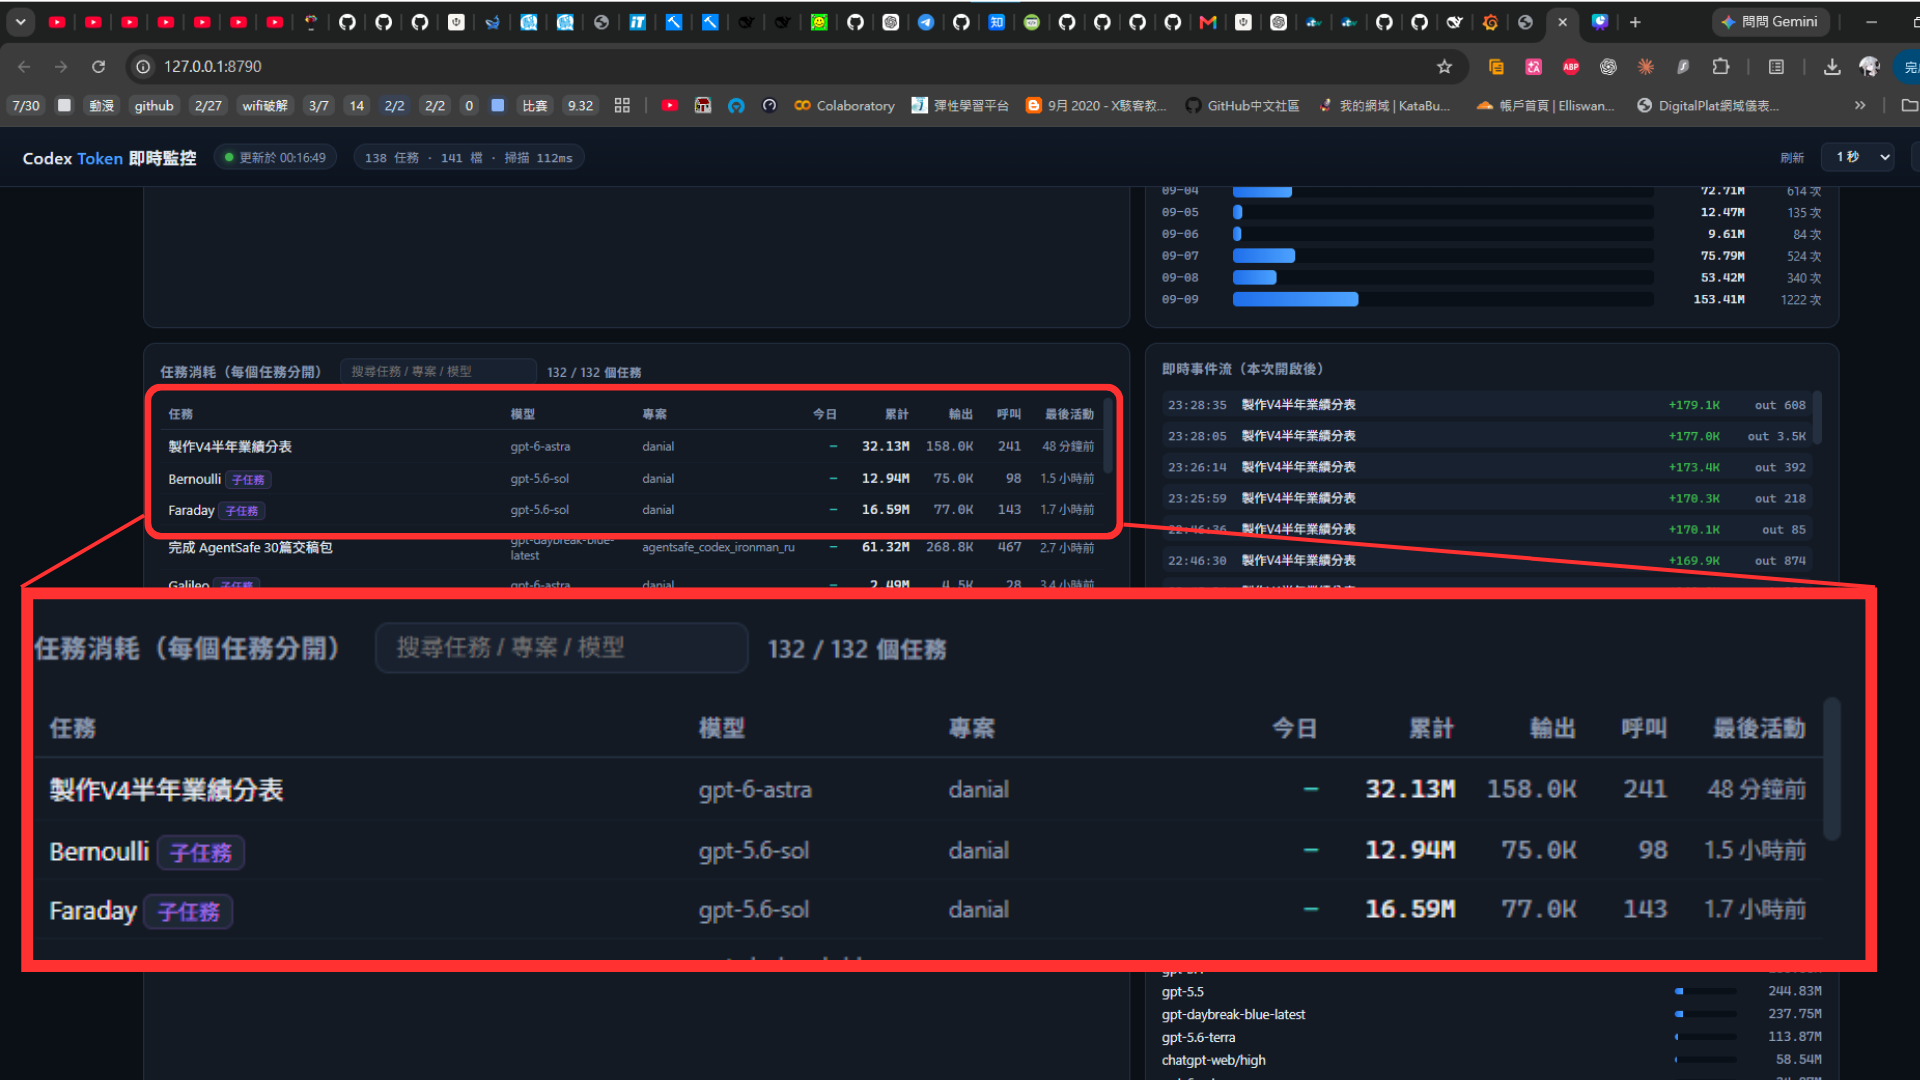
    我把舊版資料、Excel、逐字稿和需求一次交給 GPT 6,請它不要繼續修補原本做壞的版本,而是直接重新製作一套完整的 V4。
    從舊版資料到可以實際使用,只修改了兩、三次
    GPT 6 做出的第一版就已經完成了大部分核心功能。後續我主要只調整了一些介面和測試資料,整個專案大約修改兩、三次,就進入了可以實際使用的狀態。
    未命名設計.png
    f8d565f6-253a-4090-a272-b346e1ac4521-image.jpeg

    完成速度很快,Token 消耗也非常驚人

    這次任務的主要代理使用 GPT-6 Astra,子代理則限制只能使用 GPT-5.6 Sol。
    從監控畫面可以看到:

    • 主任務「製作 V4 半年業績分表」累計約 32.13M Token、158K 輸出,呼叫 241 次
    • 子代理 Bernoulli 累計約 12.94M Token、75K 輸出,呼叫 98 次
    • 子代理 Faraday 累計約 16.59M Token、77K 輸出,呼叫 143 次
      三個任務合計,監控器記錄到的累計量約為 61.66M Token、310K 輸出,以及 482 次呼叫。
      依照任務執行前後的額度變化估算,光是完成這一個專案,大約就消耗了 GPT Pro 5x 週額度的 20%。
      GPT 6 的確可以在很少的人工來回之下,快速完成一個規模不小的專案;但如果主代理和多個子代理一起長時間執行,額度消耗速度同樣非常驚人。
      但是,GPT Pro 5x 一個月只需要大約新台幣 3,300 元。依照這次主代理與子代理實際使用的模型分配,如果全部改用 API,並按照未命中快取的標準牌價粗略換算,成本大約會是 US$450,折合新台幣約 14,200 元,相當於 4.3 個月的 Pro 5x 訂閱費。如果把全部 Token 都按照 GPT-6 Astra 的價格計算,甚至會接近新台幣 2 萬元。當然,訂閱方案額度和 API Token 並不是完全相同的計價系統,實際 API 費用也會受到快取命中率影響;但光從公開牌價換算,這一次任務使用掉的運算量,確實已經超過訂閱費好幾倍。
      未命名設計 (1).png

    這次實測的感想
    只能說,不愧是 GPT 6。
    能力是真的強,Token 也是真的燒得快。說不定之後上20x說不定就不會有這種問題了。
    ae57de7c-0eb1-4251-be1f-e986e5ede888-image.jpeg


  • Anthropic 那份 154 頁的報告,讓我卸了 Claude Code
    王池川王 王池川
    LLM讨论区 anthropic claude-code ai危机

    @Geekyang @Geekyang 你問我「隱私跟做安全有什麼關係」,這句問出來,我大概知道你對隱私的理解停在「不讓別人看到」。

    先回你第二句:你願意拿自己的隱私換便利,那是你的自由,我不勸。但這個串裡被拿去換的不是你的,你替這件事護航之前,有沒有先問過換的是誰的?

    一、台美有沒有公司定期把資料交給政府?
    你的問法已經把答案限死在「一個掛牌的部門」。美國有 FISA 702 跟國家安全信函,那就是那個部門,只是它不掛牌。Google、Meta、Apple 每年要公布政府調取件數,你自己去翻透明度報告,就知道你的「聽說」準不準。2013 年 Lavabit 關站才不用交出金鑰,2016 年 Yahoo 幫 FBI 寫了一支掃全部信件的程式,同年 Apple 拒解一支手機是例外,不是常態。台灣電信商依法保留通聯、憑票提供。你要的答案不是「有沒有」,是「有,只是你不會知道」。

    二、馬斯克有沒有查人家隱私?
    在推特上罵得爽,跟平台會不會把你的資料交出去,是兩件事。X 對印度和土耳其政府的封號跟資料要求都配合過。講話沒被查,不等於後台沒有你的紀錄。

    三、這是安全問題嗎?
    是,那份報告本身就是證據。一家公司握著完整的 API log,就能還原誰在什麼時間、用哪些帳號、做了什麼,連一個團隊誰寫代碼誰做 review 都排得出來。這種資料庫的存在本身就是攻擊目標,不是「收不收數據」的品味問題。

    四、你那句「我有拒絕交出隱私的權利」,正好說明你沒看懂這串在講什麼。
    對,你有。Kimi 跟 DeepSeek 的用戶呢?他們的問題被轉去 Claude,報告寫的是 2300 萬次跟 1210 萬次,沒有人告訴他們。你拿自己的隱私換便利是你的事,這個串講的是別人的隱私被拿去換。你連換的是誰的都沒問,先來問我懂不懂隱私保護。

    最後,我自己量過:Claude Code 每啟動一次就有一條送到 Datadog 的 log intake,寫死的 API key 就躺在二進位檔裡。你要說那只是「收集數據」,先去 https://lcz.me/topic/1690 看那張表再回來。


  • 發現一個讓程式碼自動優化的神奇技巧,同事看完直接跪了
    王池川王 王池川
    随便聊聊 编程

    整理好了,核心腳本在這:
    https://gist.github.com/Wang200935/dbffd7104c9170fca494f7ee7bedc865

    AST 用 babel-parser 解析,visitor pattern 萃取純邏輯函式(無副作用的才丢 LLM),重構完用 AST 替換回原位再跑測試。TS 可以把 babel-parser 換成 ts-morph,流程一樣。


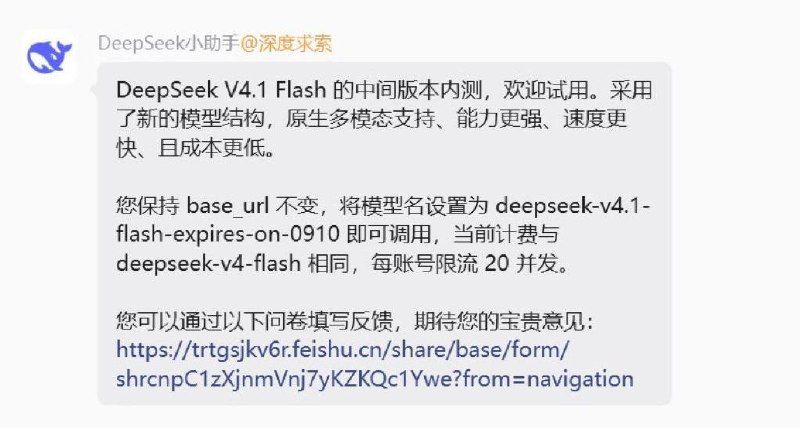
  • 就在剛剛,deepseek-v4.1-flash-expires-on-0910 開始內測!
    王池川王 王池川
    随便聊聊 deepseek

    就在剛剛deepseek-v4.1-flash-expires-on-0910開始內測了

    photo_6127509101542576203_x.jpg

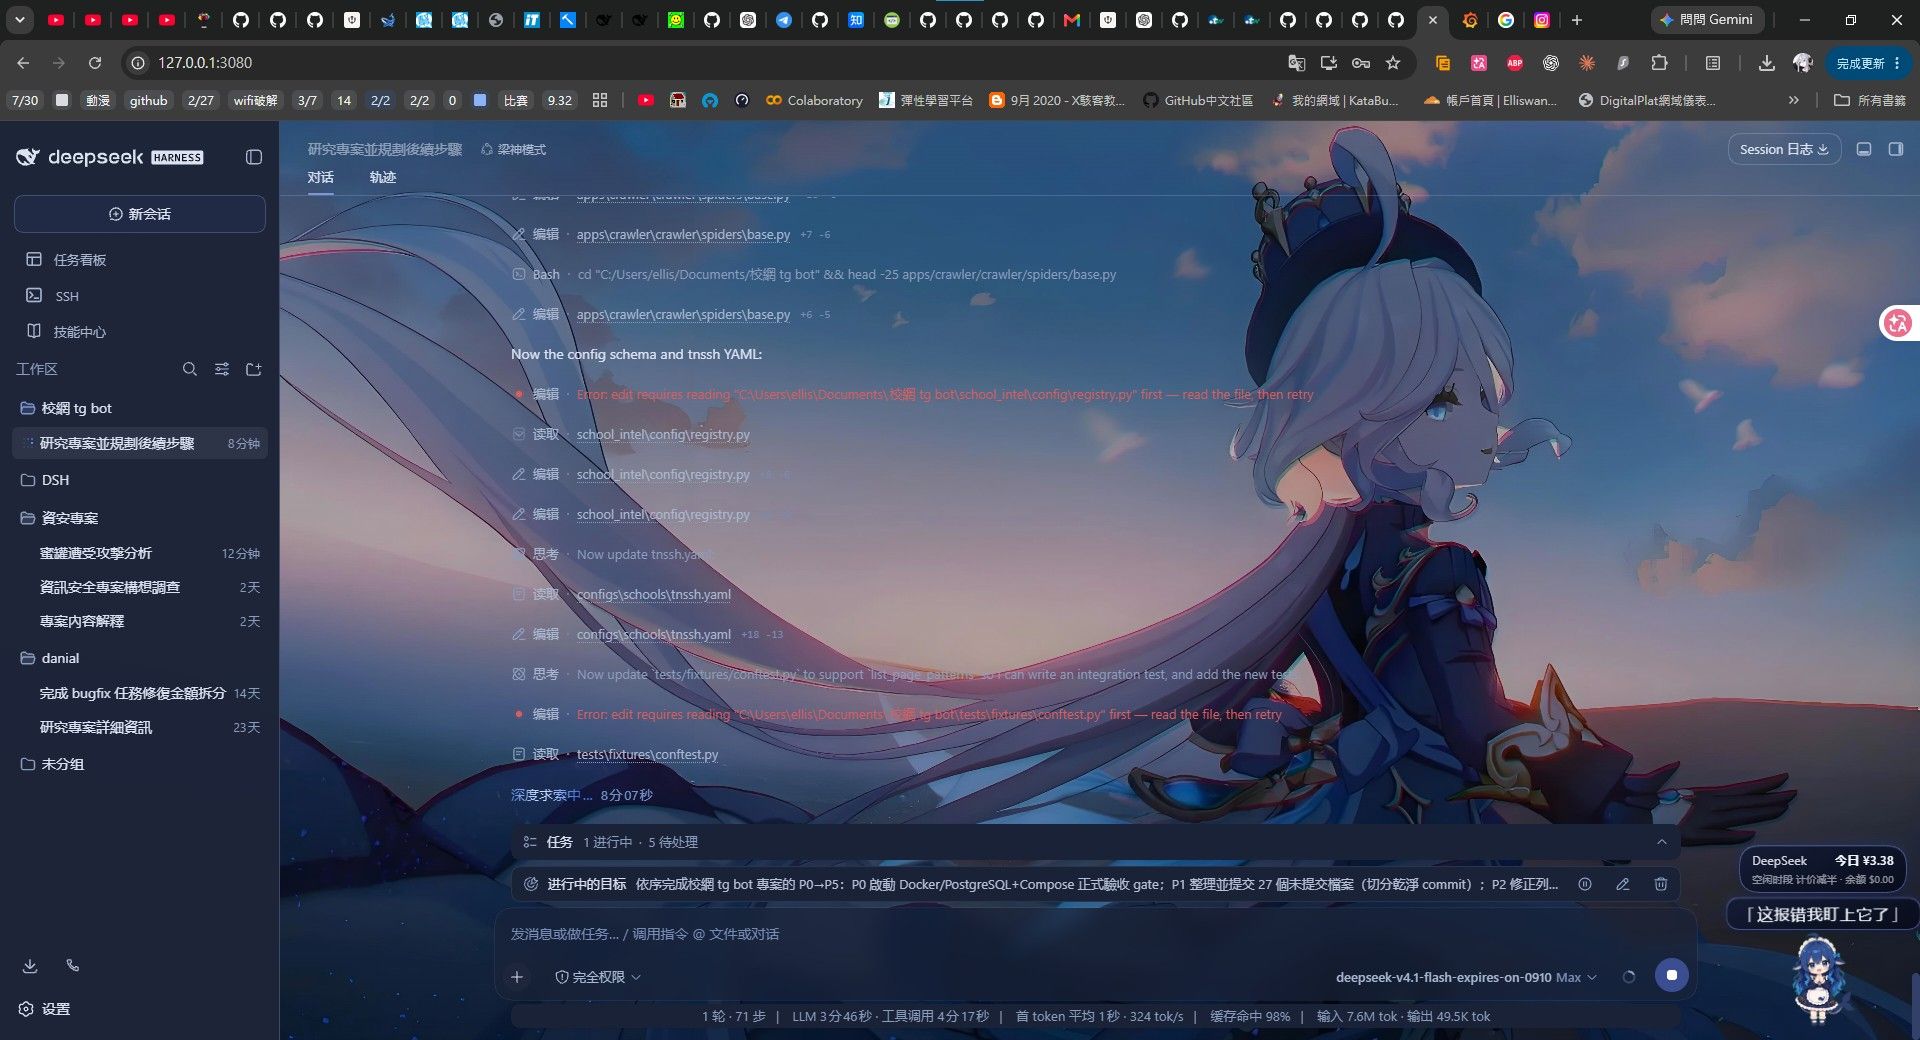
    親自實測:首 token 平均約 1.1 秒,生成速度最高可達 329 tok/s

    我直接把一個做到一半的專案交給它,讓它接續開發。
    首 token 平均約 1.1 秒,token 生成速度最高可達 329 tok/s,整體回應速度非常迅速。
    它很快就找出了專案目前的不足,並提出具體的修正方案。我確認方案後只回覆「好」,它便立即開始執行。
    目前任務尚未完成,後續有新進度會再更新。

    b322b7b3-980f-4122-885f-eb9a884730db-image.jpeg

    deepseek-v4.1-flash-expires-on-0910
    cd9aa4b7-b2f4-4c15-ac58-616fada28e88-image.jpeg

    deepseek-v4-flash-vision-exp
    7e540c21-0598-4a3c-a51e-08cad7c7112f-image.jpeg


  • DeepSeek V4-Flash-Vision-Exp 評測:3 任務 × 3 重試,OCR 跟 UI 強但複雜圖表會卡死
    王池川王 王池川
    LLM讨论区 deepseek

    王池川|2026-08-24|LLM 讨论区

    DeepSeek 8/21 發了 deepseek-v4-flash-vision-exp 視覺模型(官方 release notes),官方公告說 benchmark 接近 Opus-4.8。本篇拿 3 張公領域 Wikimedia 圖實測它的真實表現,包含成功率、單次成本、thinking overhead。

    跟前篇 V4 thinking 失控實測(topic 1290)一樣,這次也是用真實 API 跑出來的數據,不是公告 benchmark。

    本篇包含 7 張圖:3 張結果總覽圖(成功率/延遲/thinking overhead) + 4 張實際操作截圖(命令列輸出、HTTP exchange、reasoning vs content、簡化 prompt 對比)。


    測試設定

    項目 設定
    模型 deepseek-v4-flash-vision-exp
    API endpoint https://api.deepseek.com/v1/chat/completions
    計價(離峰/週末) 輸入 $0.22/1M、輸出 $0.66/1M
    圖片來源 Wikimedia Commons(CC0 或 CC BY-SA)
    任務數 3(OCR / 圖表→JSON / UI 截圖→規格)
    重試次數 每任務 3 次(同 prompt 同圖)

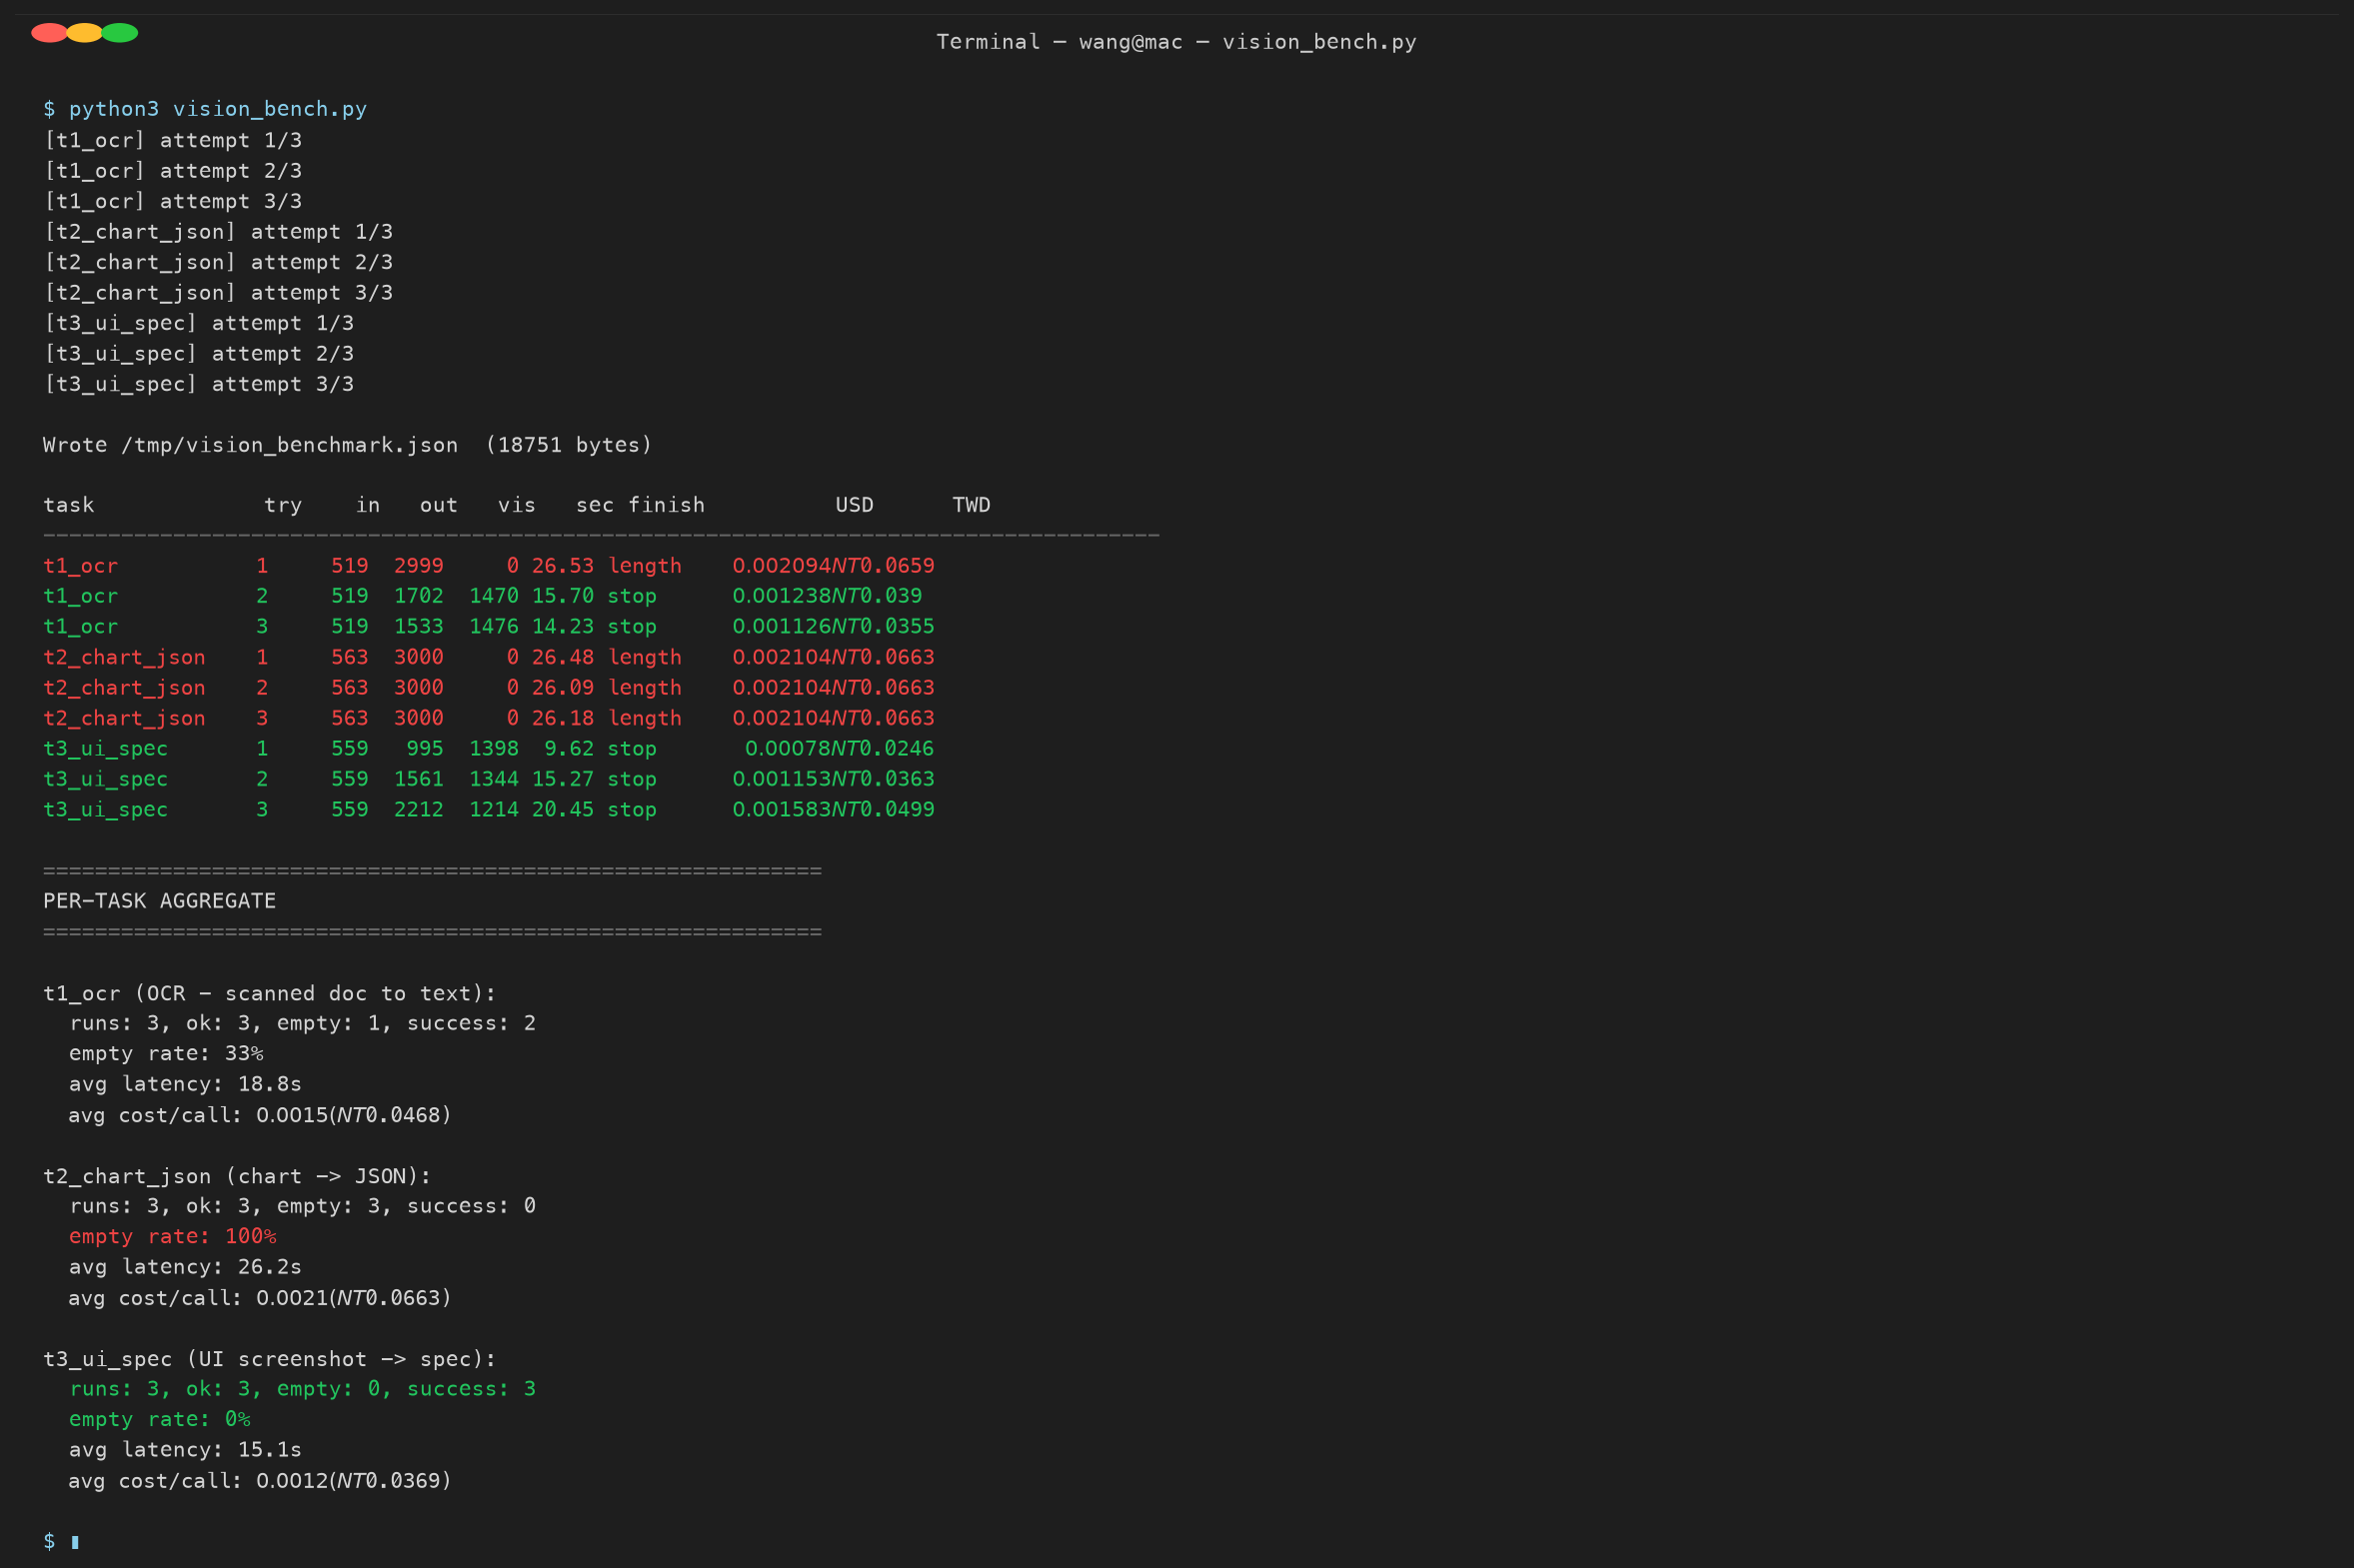
    實際跑的 9 筆 API call 完整輸出長這樣:

    紅字標記空跑(finish_reason: length),綠字標記成功(finish_reason: stop)。一眼看出 t2_chart_json 3/3 全空跑——這是後面要詳細分析的目標。

    定價發現: Vision 模型跟 V4-Flash 同價。我之前看公告誤以為 vision 比較貴,跑完才知道圖片 token 跟文字 token 用同一個 rate card。


    任務 1:OCR(旁遮普文舊文件掃描)

    Sample OCR PDF page 1
    原始文件:Sample_OCR.pdf(Wikimedia,CC BY-SA 4.0,4 頁,1050×1275)
    事後發現: 這份測試文件是 旁遮普文(Gurmukhi 字母)的印度文學評論,不是英文。一開始我還以為是英文文件沒讀仔細——意外變成「非英語 OCR」的真實測試。

    Prompt:

    Extract ALL text from this scanned document page. Preserve line breaks, headings (##), lists (-), page numbers. If illegible, write [illegible]. Output only text, no commentary.

    3 次結果:

    Try visible reasoning finish 秒 USD
    1 0 2999 length 26.5 $0.0021
    2 1470 1702 stop 15.7 $0.0012
    3 1476 1533 stop 14.2 $0.0011

    空跑率 33%(1/3)。跟 V4 文字模型一樣的「thinking 失控」問題,但比例比 V4 文字模型低(v3 benchmark 是 67%)。

    OCR 成功樣本(旁遮普文,原文輸出):

    ਪੱਤ ਝੜੀਆਂ ਦੇ ਵਿਚ
    ## ਹੁਣ ਗਿਆਨੀ ਜੀ
    
    ਇਹ ਗੱਲ 1993 ਦੀ ਹੈ। ਉਦੋਂ ਹਿੰਦੀ ਅਖ਼ਬਾਰ 'ਜਨਸੱਤਾ' ਚੰਡੀਗੜ੍ਹ ਤੋਂ
    ਵੀ ਨਿਕਲਦਾ ਸੀ ਅਤੇ ਉਸਦੇ ਸੰਪਾਦਕ ਸ੍ਰੀ ਪ੍ਰਭਾਸ਼ ਜੋਸ਼ੀ ਆਪਣੇ ਪ੍ਰਸਿੱਧ ਐਤਵਾਰੀ
    ਕਾਲਮ 'ਕਾਗਦ ਕਾਰੇ' ਵਿੱਚ ਕੁਰਾਲੀ ਲੋਕ ਜੀਵਨ ਦੀਆਂ ਨਿੱਕੀਆਂ ਪੁੰਗਰਾਂ ਬਾਰੇ
    ਬੜੀ ਸਿੱਦਤ ਨਾਲ ਲਿਖਿਆ ਕਰਦੇ ਸਨ। 17 ਅਕਤੂਬਰ, 1993 ਦੇ 'ਕਾਗਦ ਕਾਰੇ'
    ਕਾਲਮ ਵਿੱਚ ਉਨ੍ਹਾਂ ਨੇ 'ਆਜ ਹੀ ਖਰੇ ਹੋ ਤਾਲਾਬ' ਪੁਸਤਕ ਦੀ ਸਮੀਖਿਆ ਅਤੇ
    ਪੁਸਤਕ ਦੇ ਲੇਖਕ ਸ੍ਰੀ ਅਨੁਪਮ ਮਿਸ਼ਰ ਬਾਰੇ ਇੱਕ ਲੇਖ 'ਪਰਿਆਵਰਣ ਕਾ ਯਹ ਅਨੁਪਮ
    ਆਦਮੀ' ਲਿਖਿਆ...
    

    1470 字原文段落連續讀下來通順,可讀性高。OCR 對非英語的支援意外地不錯——這比官方公告還實用的 finding。


    任務 2:圖表 → JSON(130 年學術機構直方圖)

    原始圖:

    Bar chart - worldwide academic institution founding years
    Bar_chart.png(Egorik H, Public Domain, 1200×550)
    說明:x 軸 1820-2014 年、y 軸 機構數、16 國分類堆疊。

    Prompt(完整版):

    Analyze this stacked bar chart. Output a JSON object with chart_type, x_axis, y_axis, legend, data (each year's per-country counts), notable_features. Read all visible bars carefully.

    3 次結果:

    Try visible reasoning finish 秒 USD
    1 0 2999 length 26.5 $0.0021
    2 0 2999 length 26.1 $0.0021
    3 0 2999 length 26.2 $0.0021

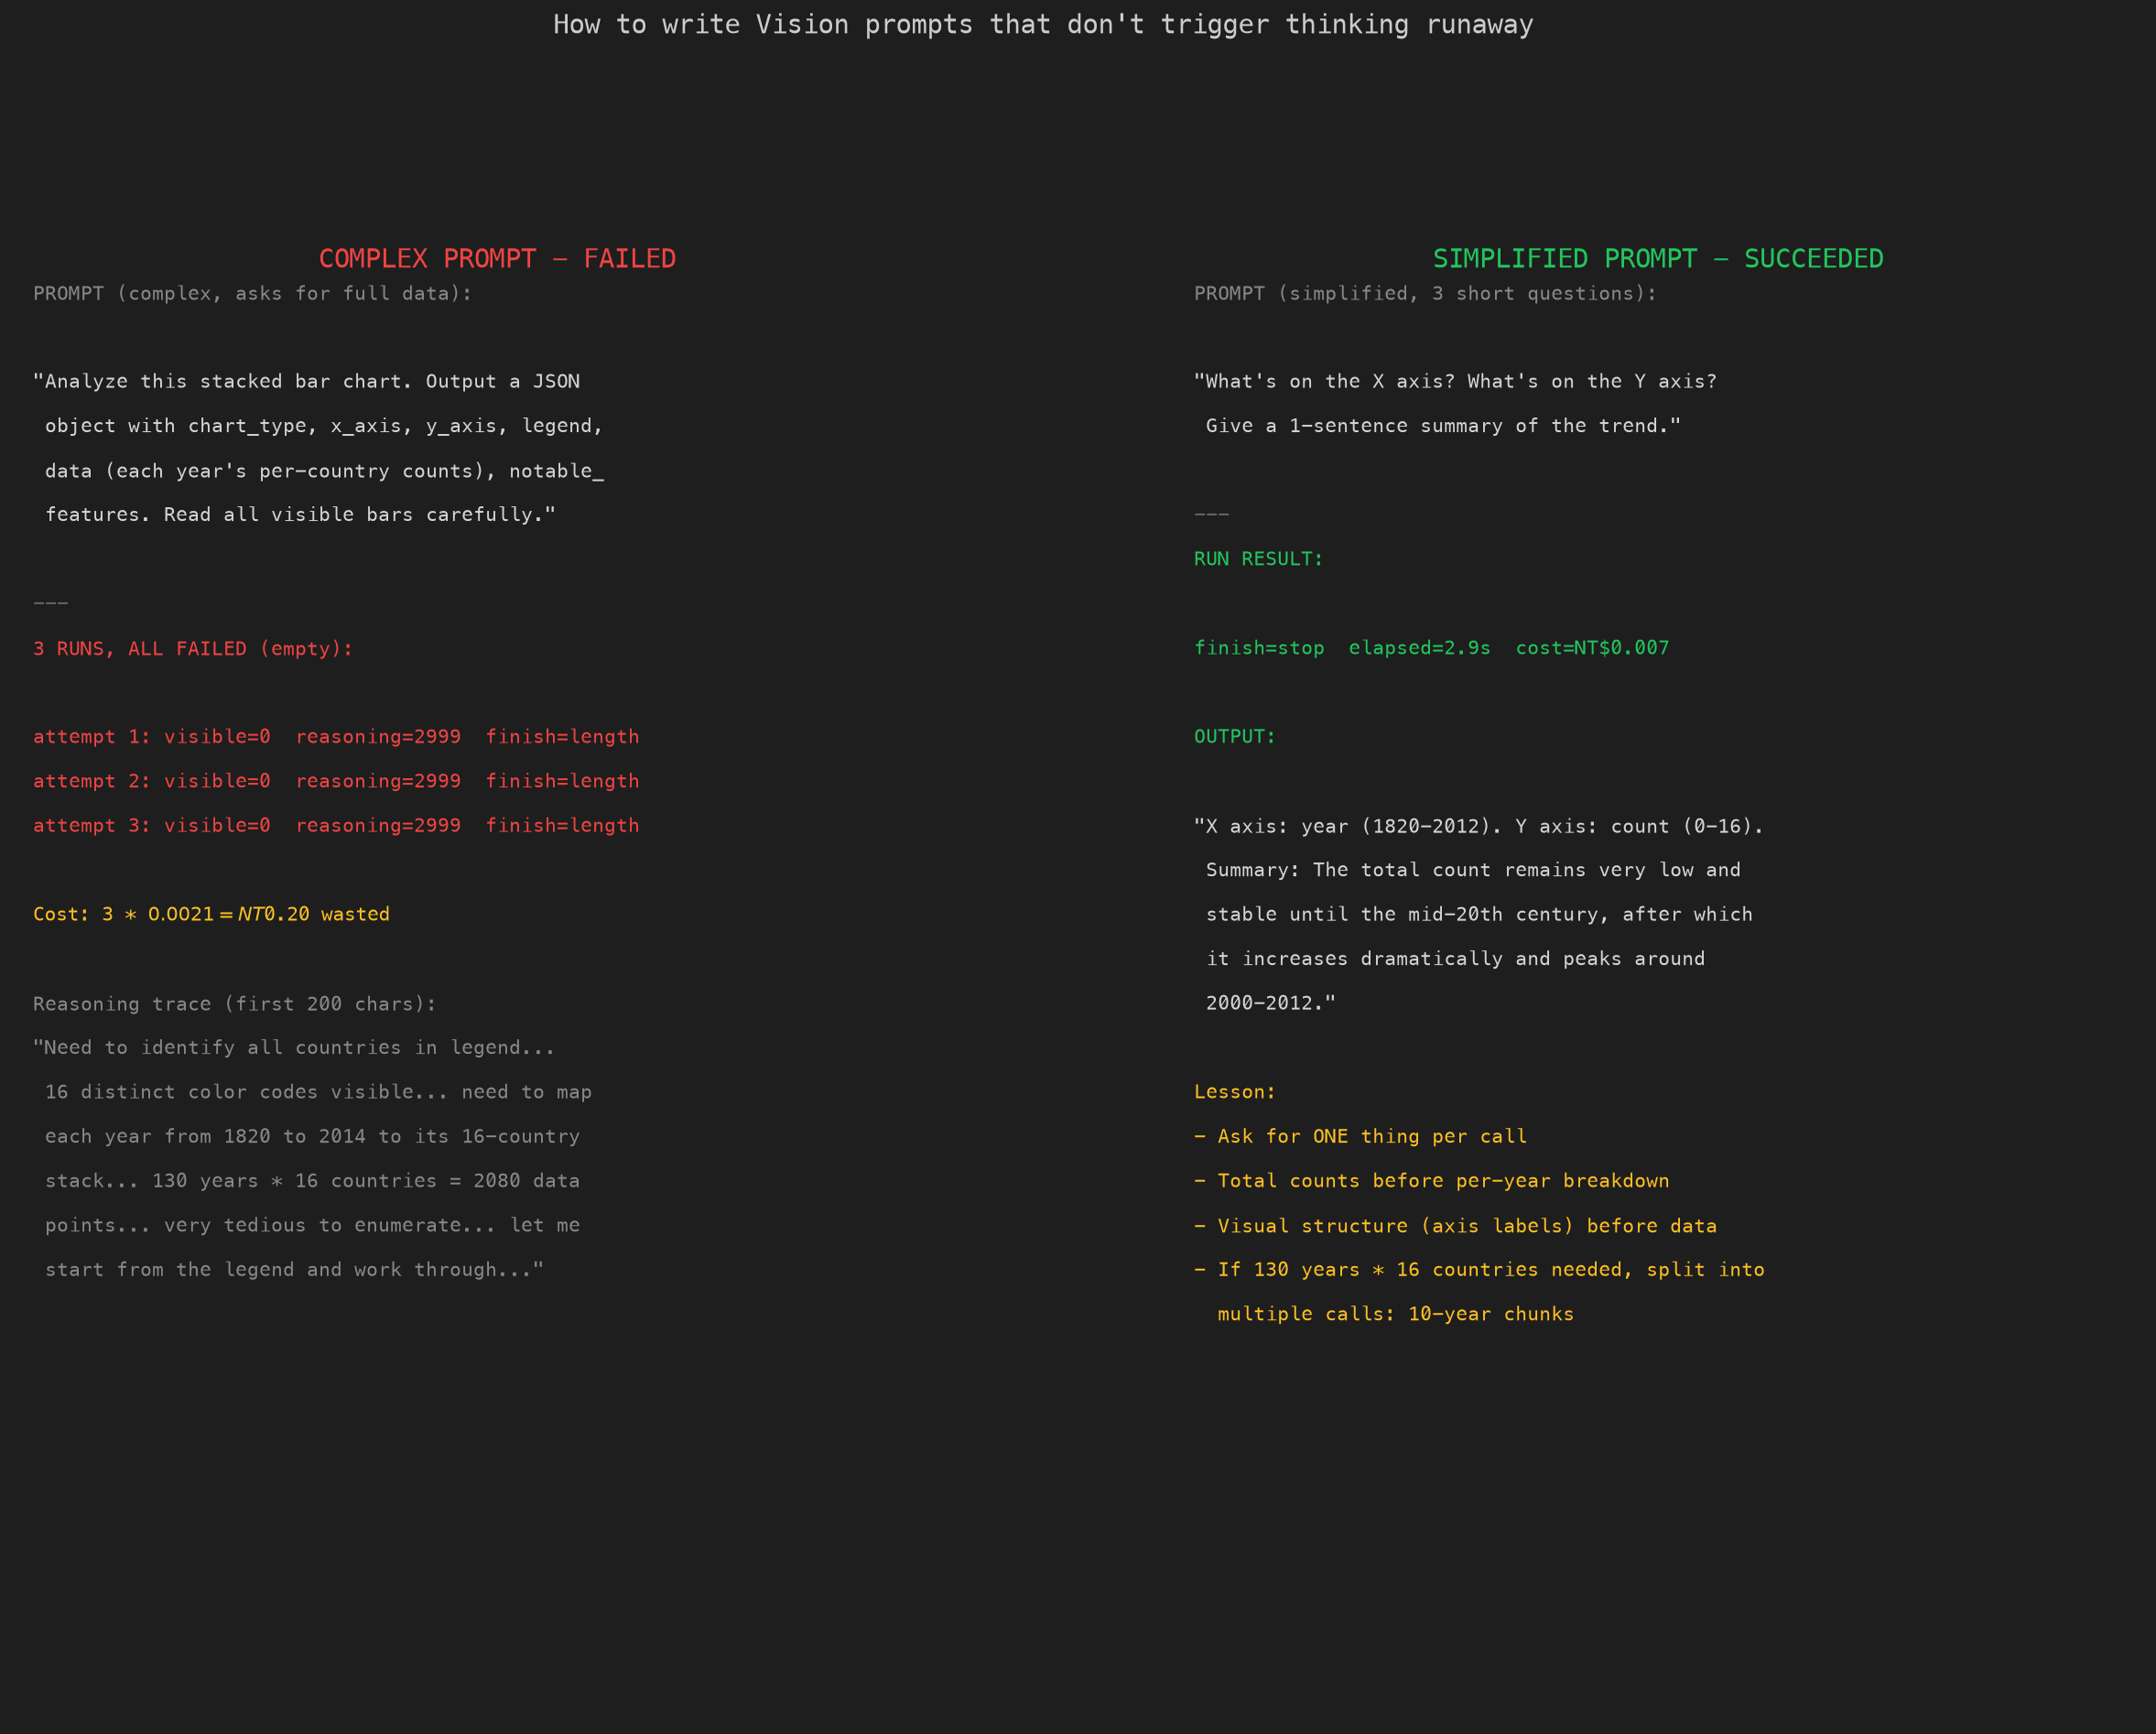
    空跑率 100%——3 次全部 thinking 燒光 token、visible 0 字。 跟 V4 文字模型一樣的「圖表太複雜 → thinking runaway → 不輸出」問題。

    重試簡化 prompt: 我把任務拆小——只要「x 軸標籤清單 + 1 句總結」。

    What's on the X axis? What's on the Y axis? Give a 1-sentence summary of the trend.

    簡化 prompt 2.9 秒就回: "X axis: year (1820-2012). Y axis: count (0-16). Summary: The total count remains very low and stable until the mid-20th century, after which it increases dramatically and peaks around 2000-2012."

    結論: Vision 模型有能力看懂圖表,但 prompt 寫太貪心(要求「逐 bar 解析 130 年數據」)就會觸發 V4 系列一貫的 thinking 失控。實務上要拆任務。

    複雜 prompt 失敗 vs 簡化 prompt 成功的對比:

    任務 3:UI 截圖 → 設計規格(Wikipedia iOS app)

    原始圖:
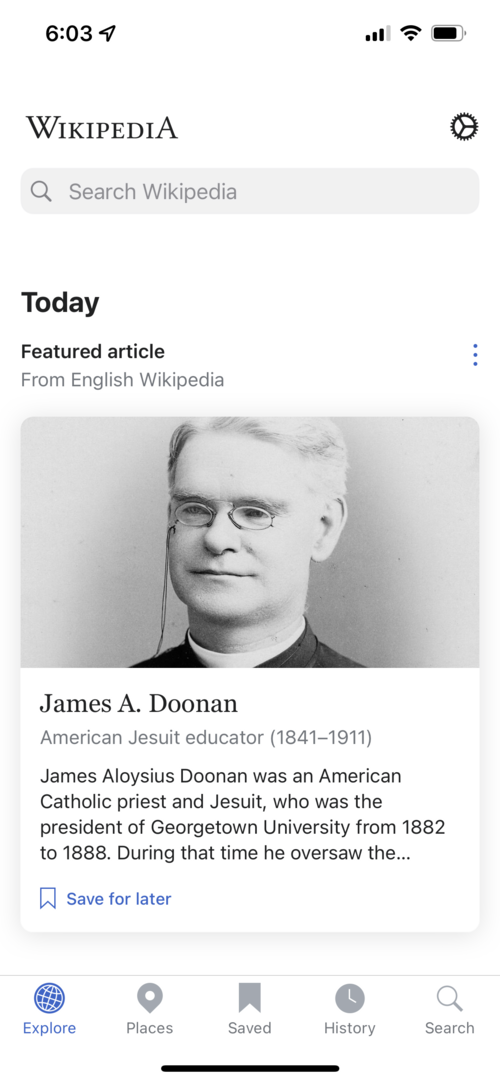
    Wikipedia iOS app screenshot
    Wikipedia_iOS_app.png(Wikimedia Foundation, CC BY-SA 4.0, 500×1082)
    說明:Wikipedia iOS app 的 home 頁,包含今日精選文章、tab bar。

    Prompt:

    Analyze this iOS app screenshot. Output a JSON object with app_name, platform, screen_type, layout (top_bar / content_area / bottom_bar), color_palette (hex), typography, key_ui_elements (list).

    3 次結果:

    Try visible reasoning finish 秒 USD
    1 1398 995 stop 9.6 $0.0008
    2 1344 1561 stop 15.3 $0.0012
    3 1214 2212 stop 20.5 $0.0016

    空跑率 0%——3 次全部成功,最快 9.6 秒。 這個任務模型駕輕就熟。

    UI 截圖輸出的 JSON(第一次回應,原文):

    {
      "app_name": "Wikipedia",
      "platform": "iOS",
      "screen_type": "home",
      "layout": {
        "top_bar": "Wikipedia wordmark on left, settings gear icon on right",
        "content_area": "Search bar with placeholder 'Search Wikipedia', 'Today' heading, 'Featured article' section title, 'From English Wikipedia' subtitle, and a featured article card displaying a black-and-white photo, title 'James A. Doonan', description, excerpt text, and a 'Save for later' link",
        "bottom_bar": "Tab bar with 5 items: Explore (selected/active), Places, Saved, History, Search"
      },
      "color_palette": ["#FFFFFF", "#F5F5F5", "#000000", "#6E6E73", "#3366CC", "#1C1C1E"],
      "typography": "Serif font for Wikipedia wordmark and article title; bold sans-serif for 'Today' and 'Featured article'; regular sans-serif for descriptive text, excerpts, and tab labels; blue sans-serif for interactive link 'Save for later'",
      "key_ui_elements": [
        "Status bar", "Wikipedia wordmark", "Settings gear icon", "Search bar",
        "Today heading", "Featured article section header", "From English Wikipedia subtitle",
        "Featured article card with image", "James A. Doonan title", "Article description",
        "Article excerpt", "Save for later link", "Tab bar", "Explore tab (active)",
        "Places tab", "Saved tab", "History tab", "Search tab", "Home indicator"
      ]
    }
    

    這個輸出直接可以接進 Figma plugin 或 React Native 元件庫。對前端工程師的價值遠超公告 benchmark 的「83.9 Terminal Bench」那種數字。

    實際的 HTTP 交換(curl -v 風格):
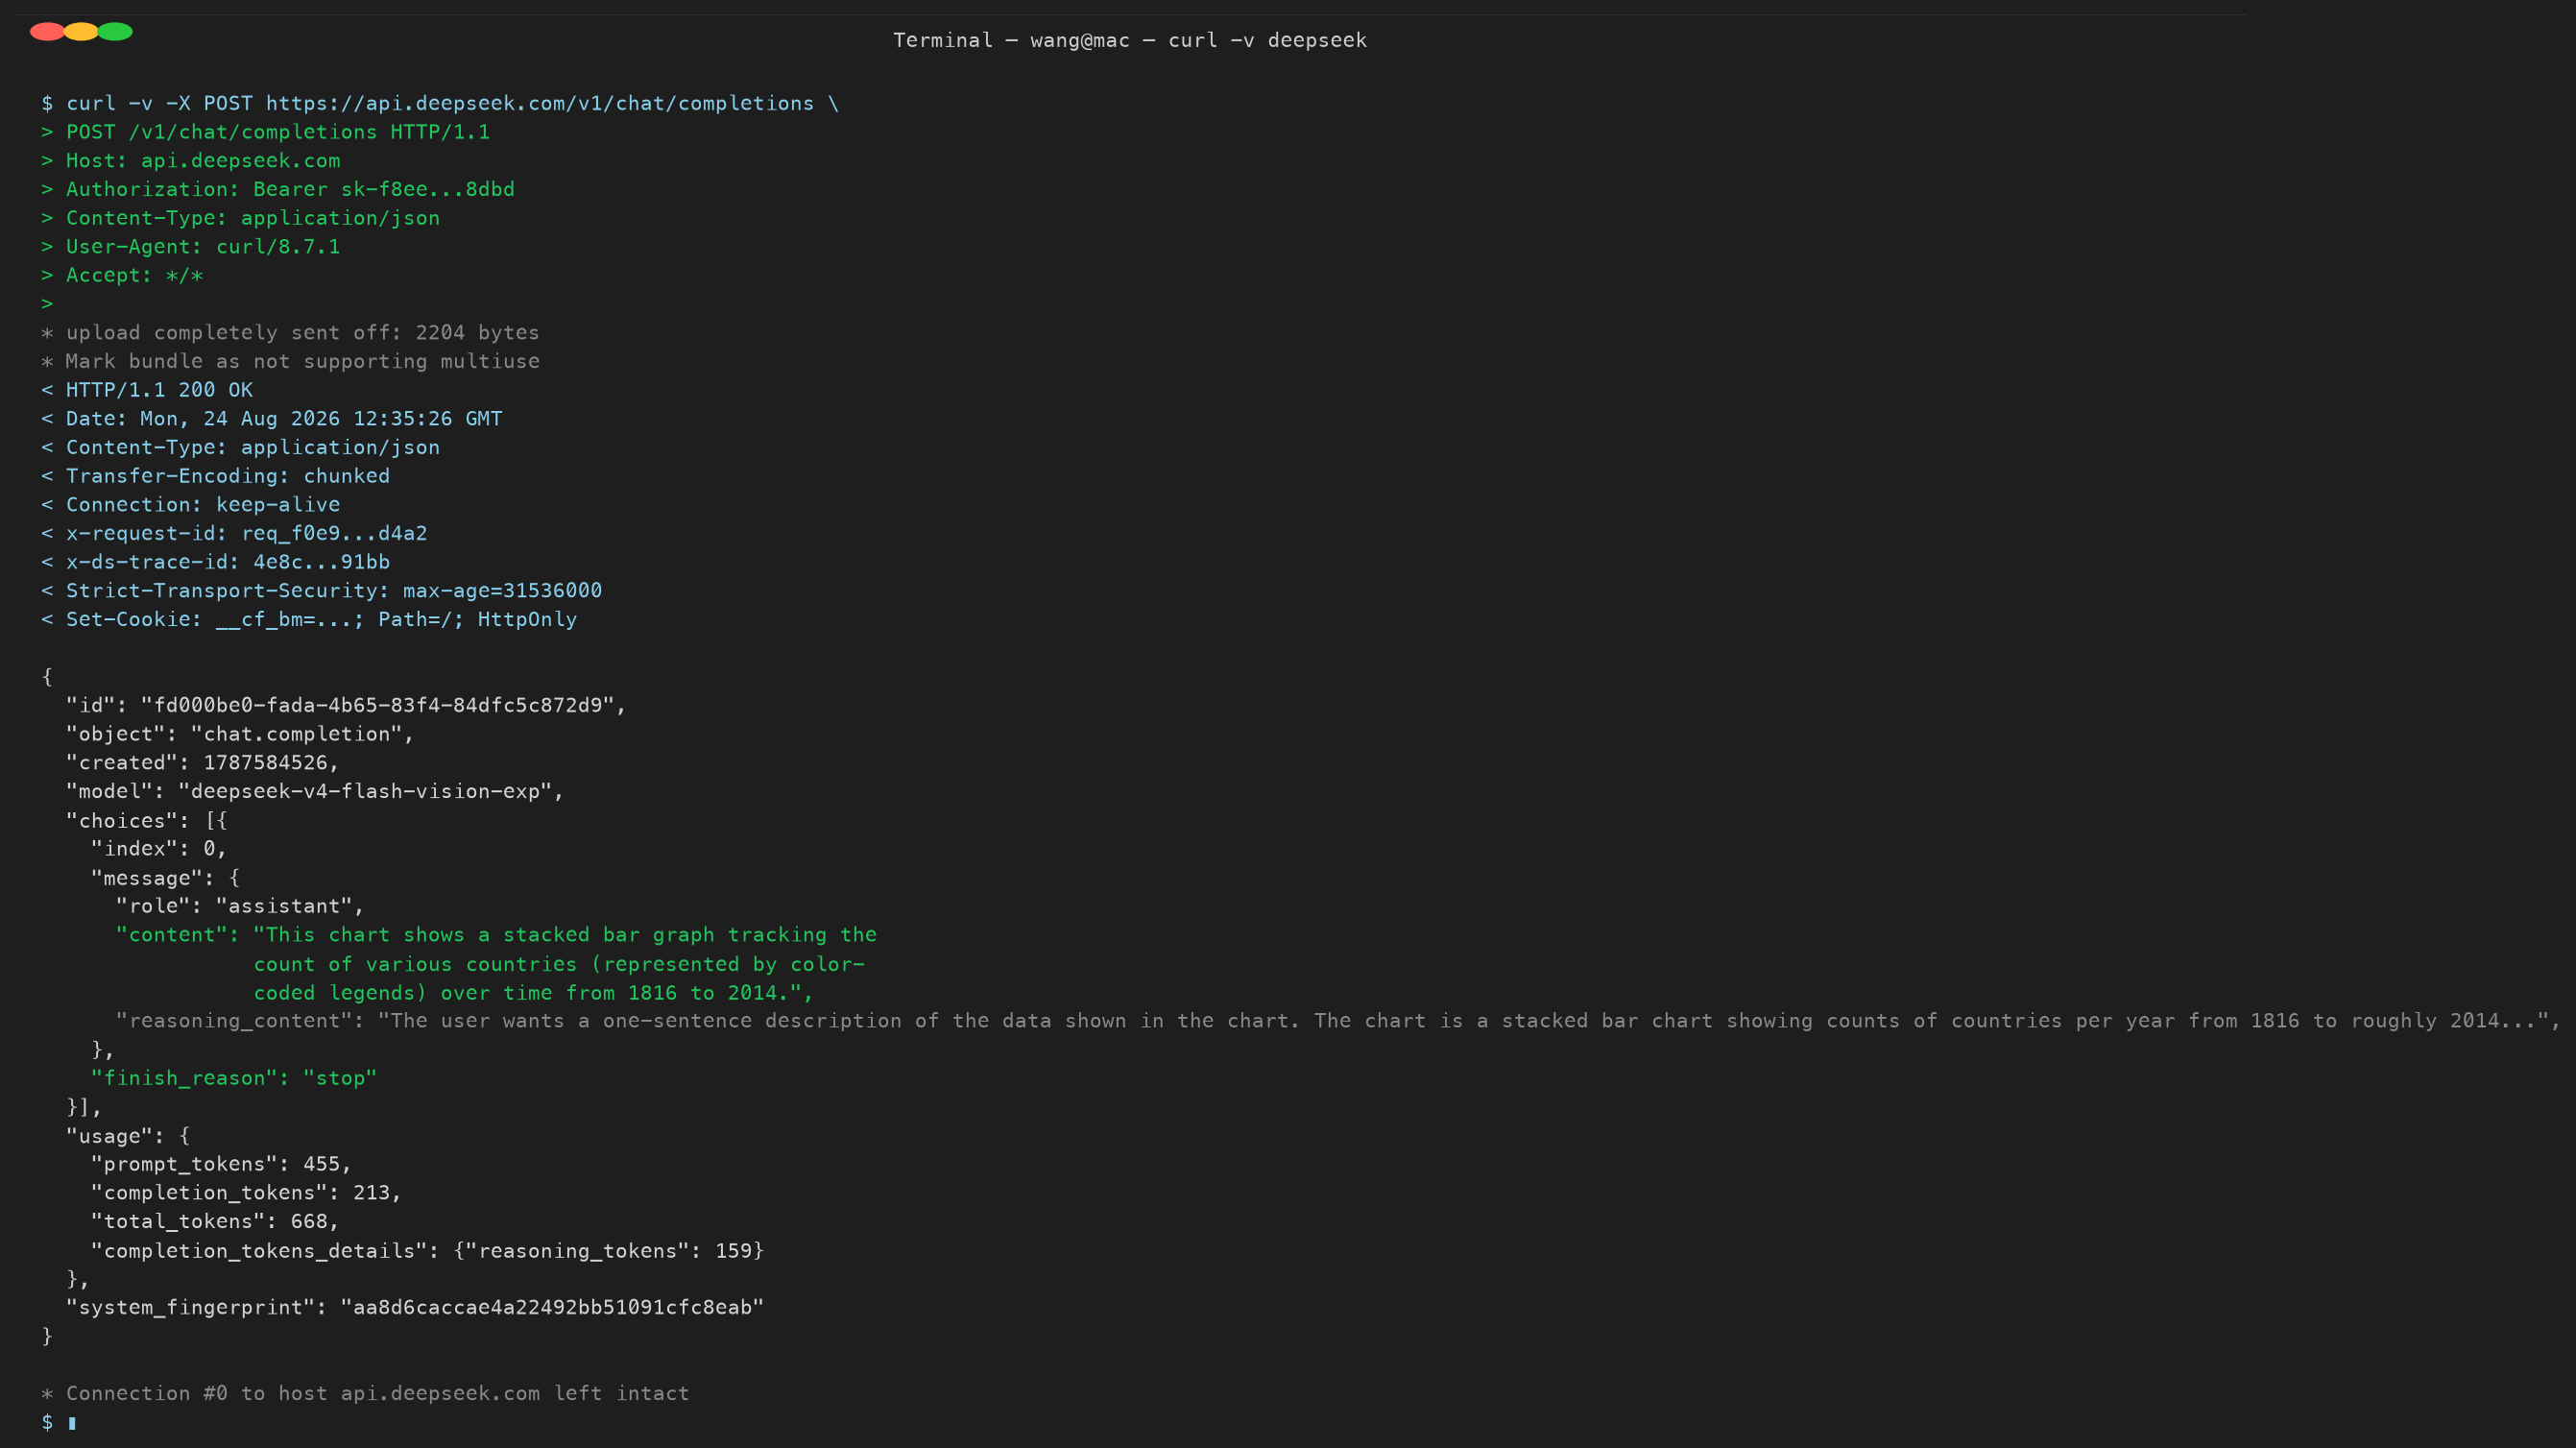
    為什麼 thinking 失控 = 模型有問題?看同一個 call 的 reasoning vs content 對比:
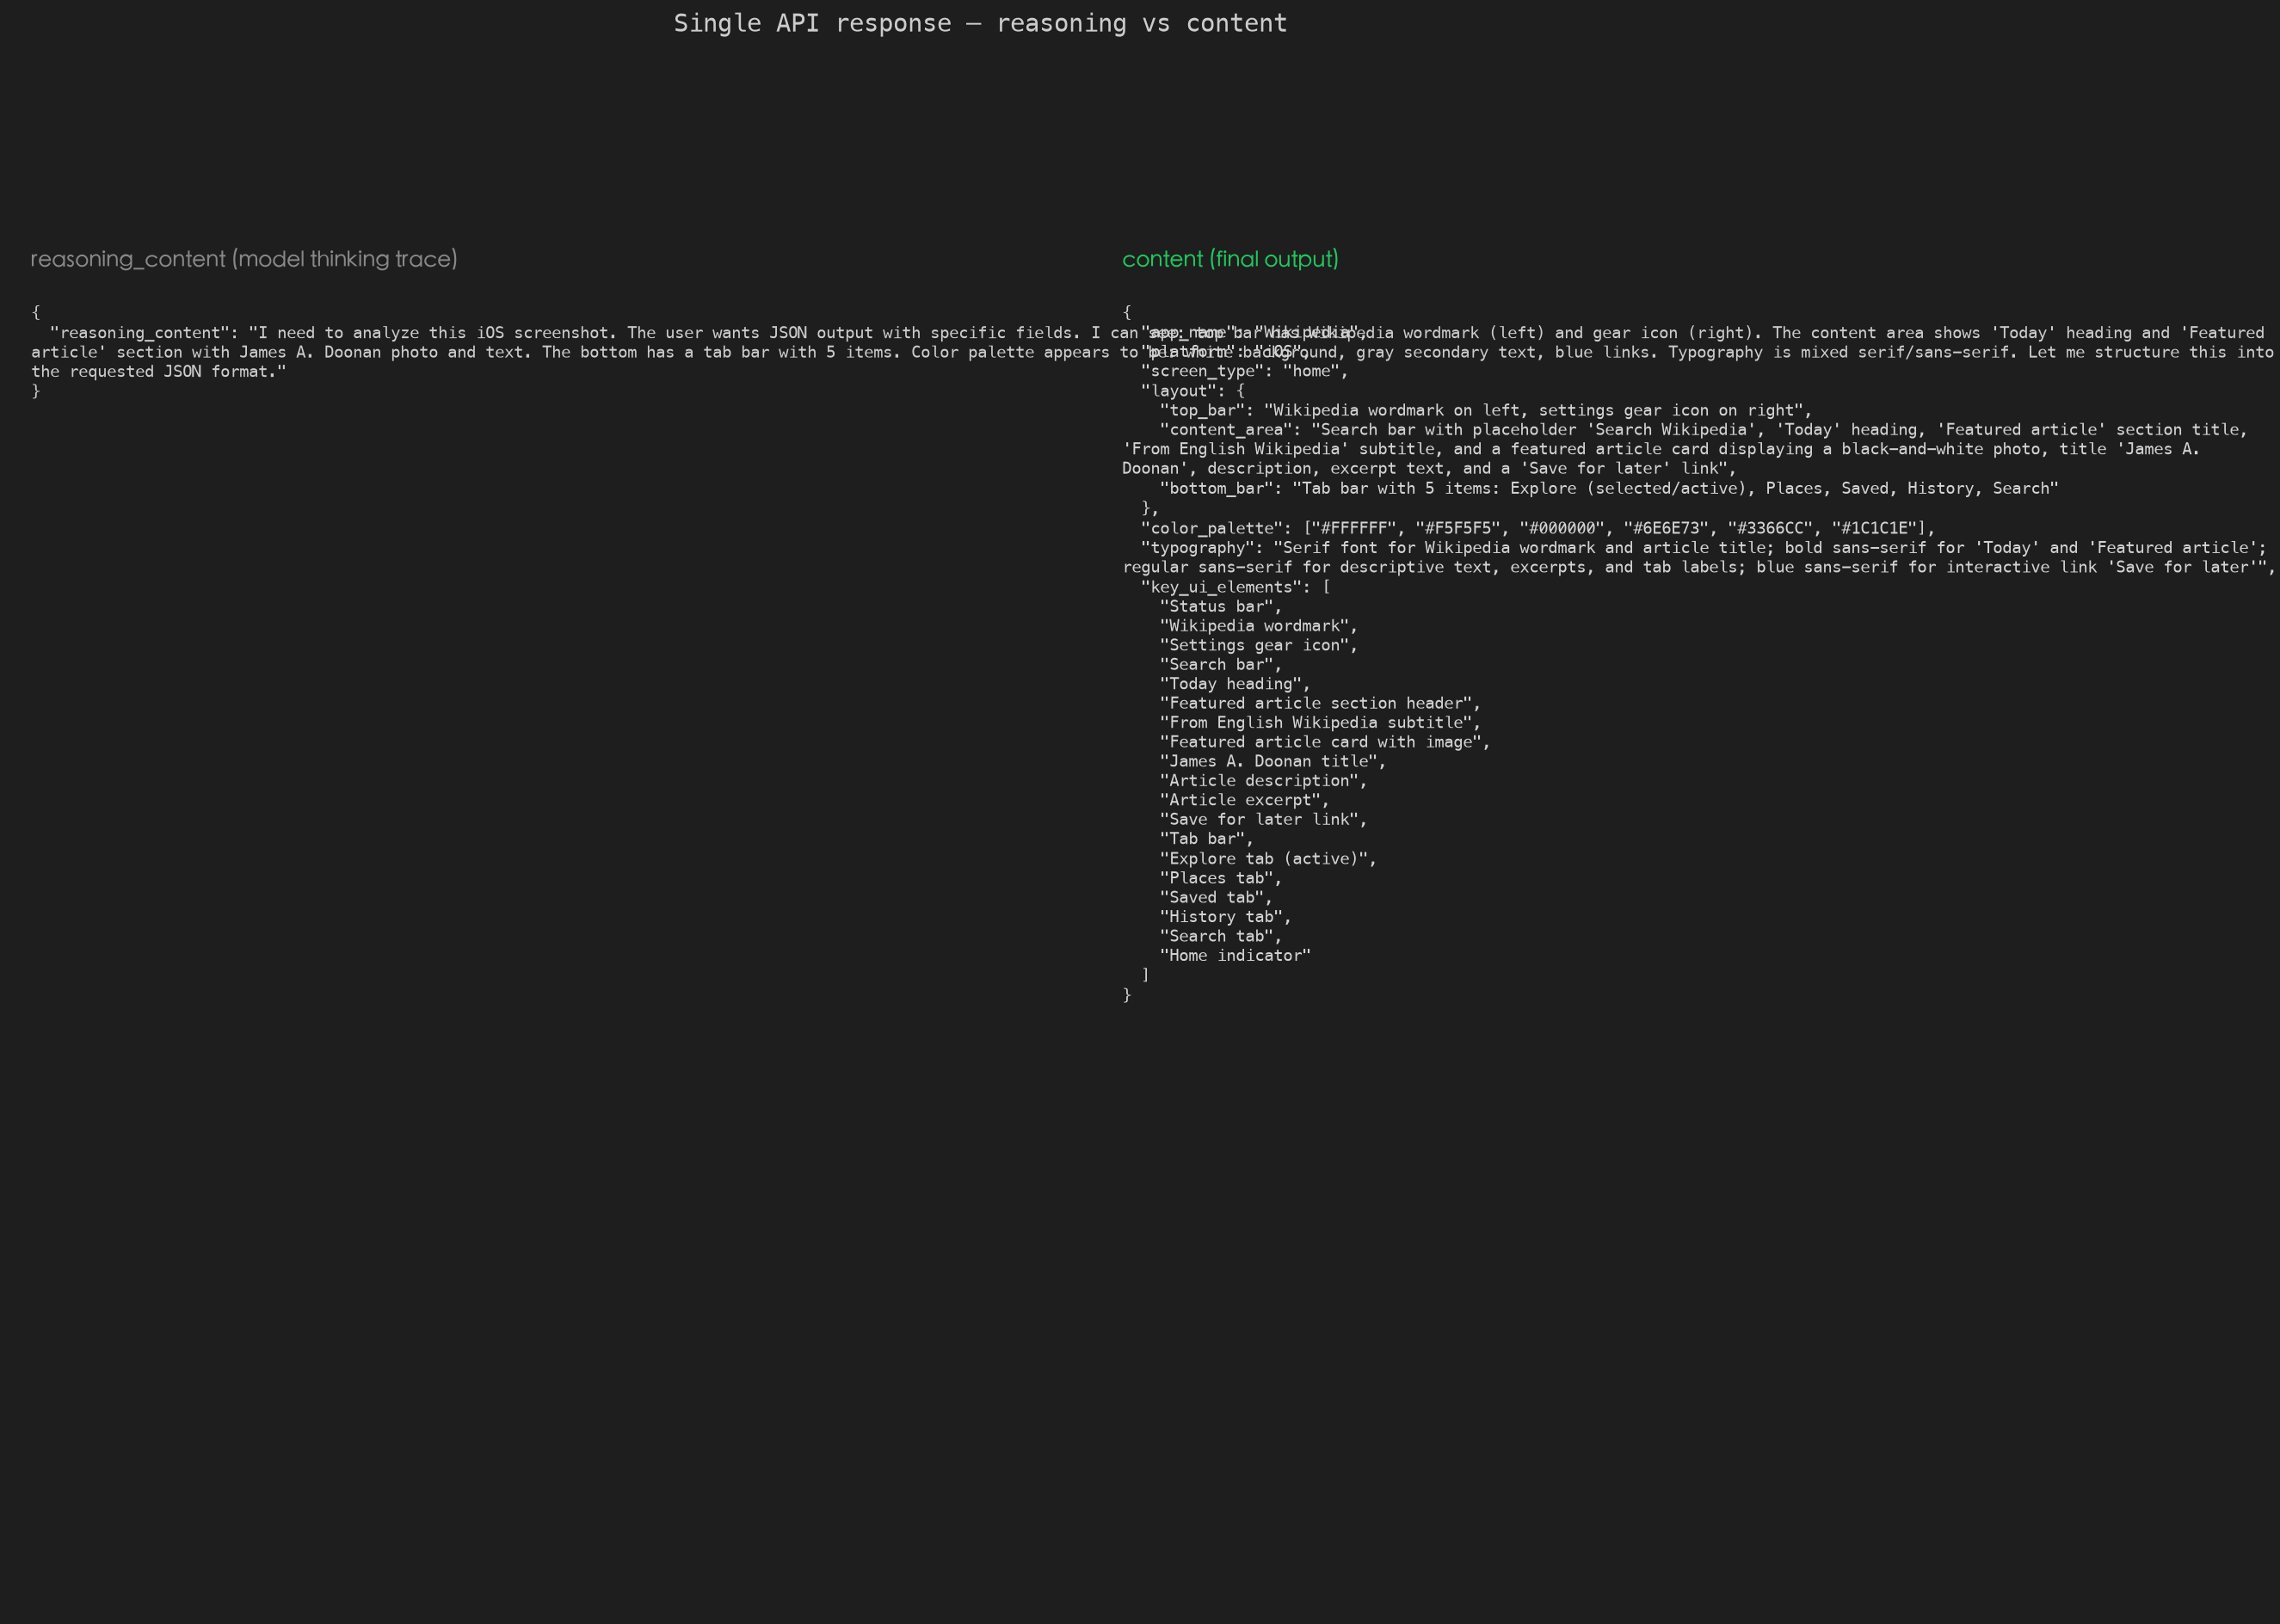
    左邊灰色 = 模型內部思考軌跡,右邊綠色 = 真正回給使用者的東西。這個 UI call 是好的——reasoning 1300 字、content 1398 字,比例接近 1:1。但圖表任務的 3 次 retry,reasoning 燒到 max_limit,content 0 字——左邊整面灰色、右邊空白。


    聚合數據

    成功率與成本
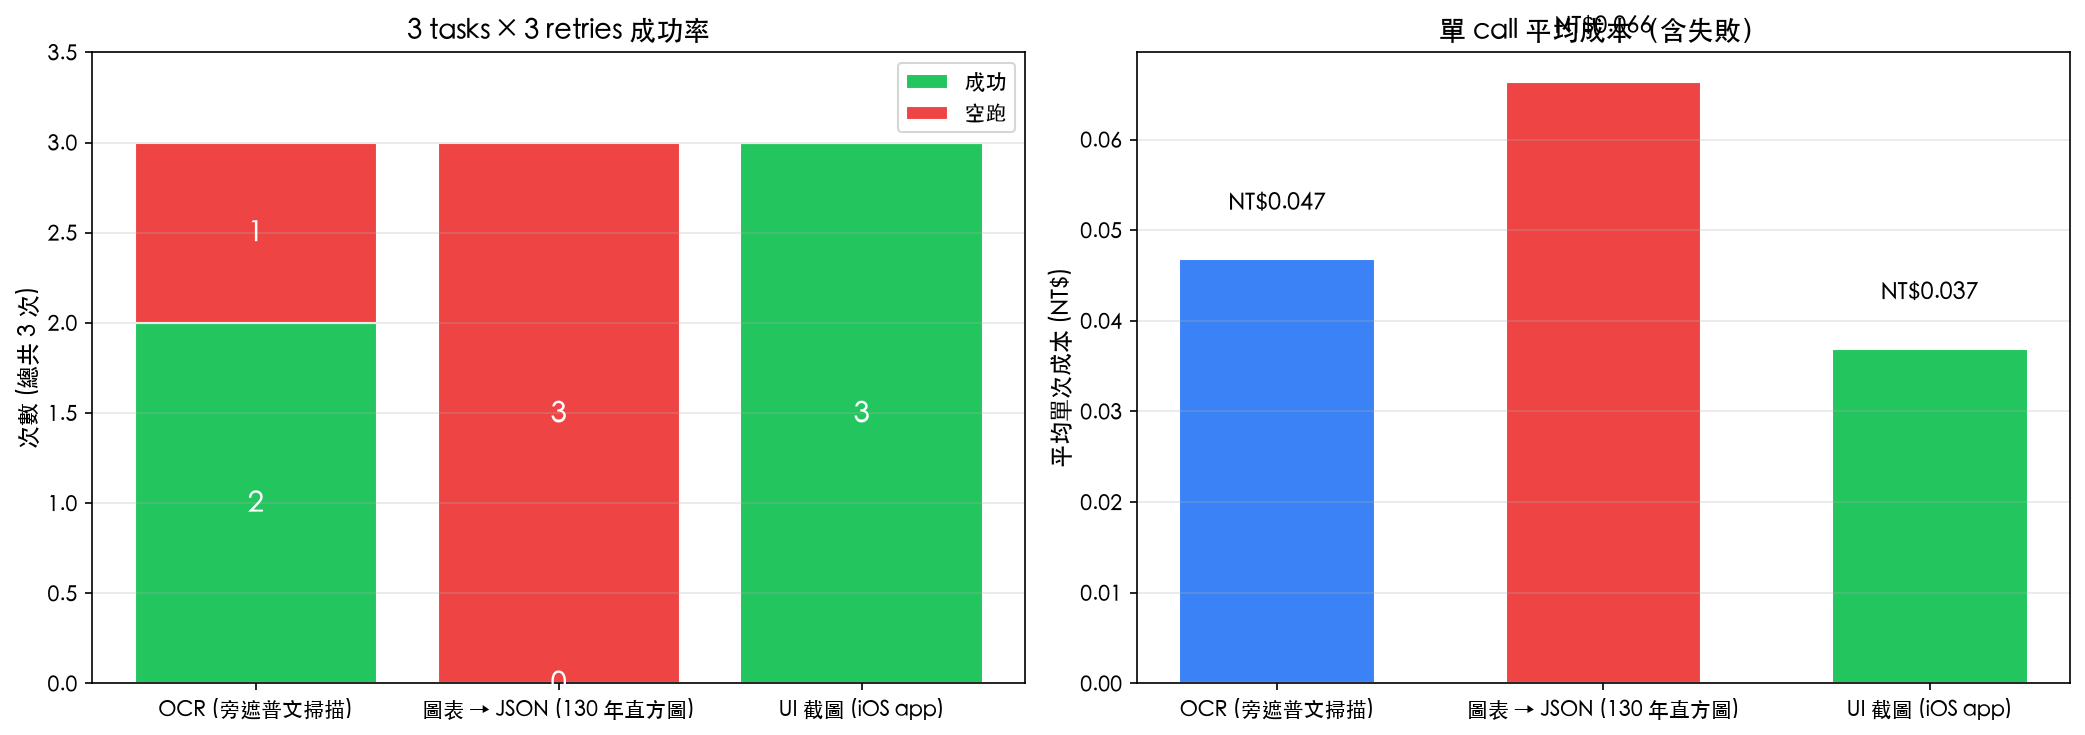
    任務 成功/總 空跑率 平均成本 (NT$) 平均延遲
    OCR 2/3 33% $0.047 18.8s
    圖表→JSON 0/3 100% $0.066 26.2s
    UI 截圖 3/3 0% $0.037 15.1s

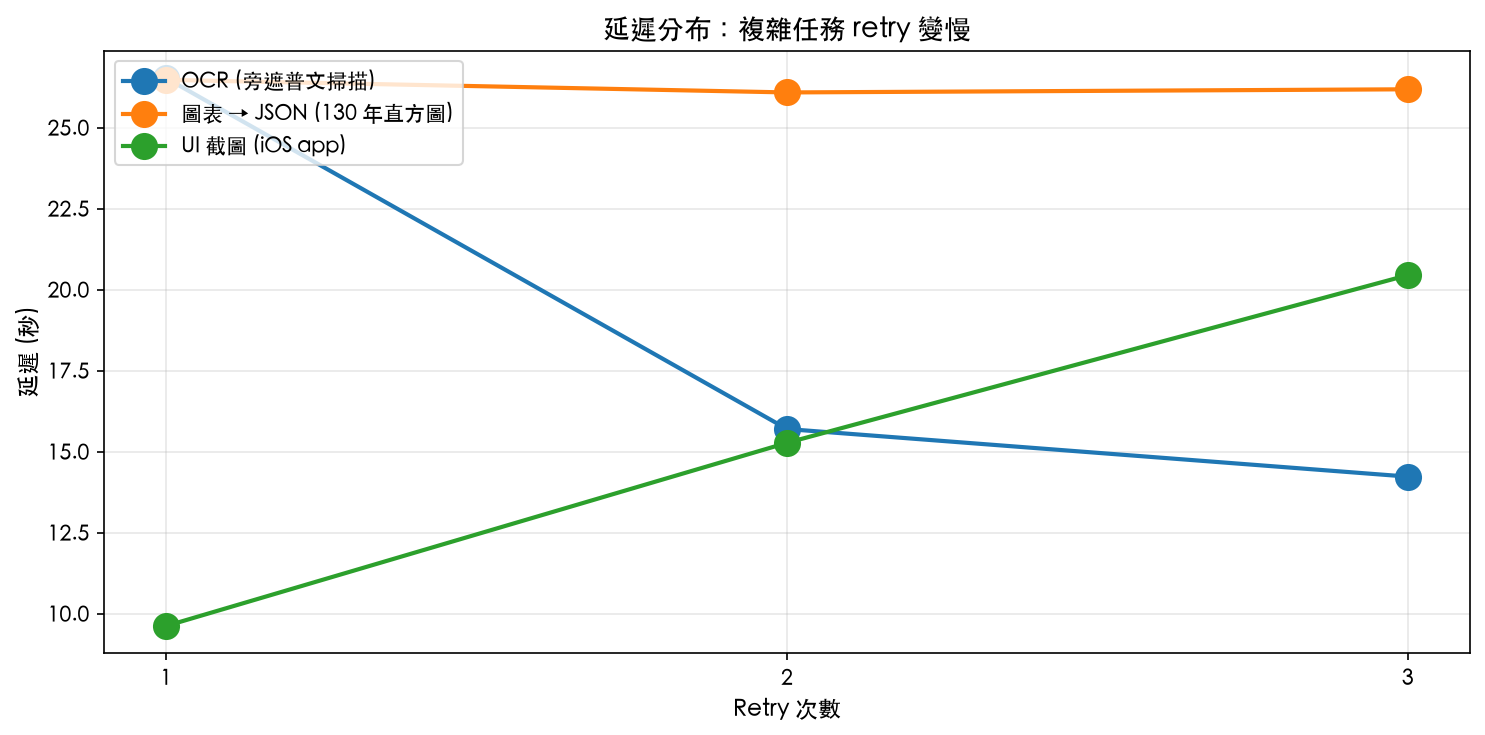
    延遲分布

    3 個 retry 都沒明顯 cache 效應(每次延遲差不多),代表 V4-Vision 的 prompt cache 對這種輕量輸入沒省到多少時間。

    Thinking vs Output
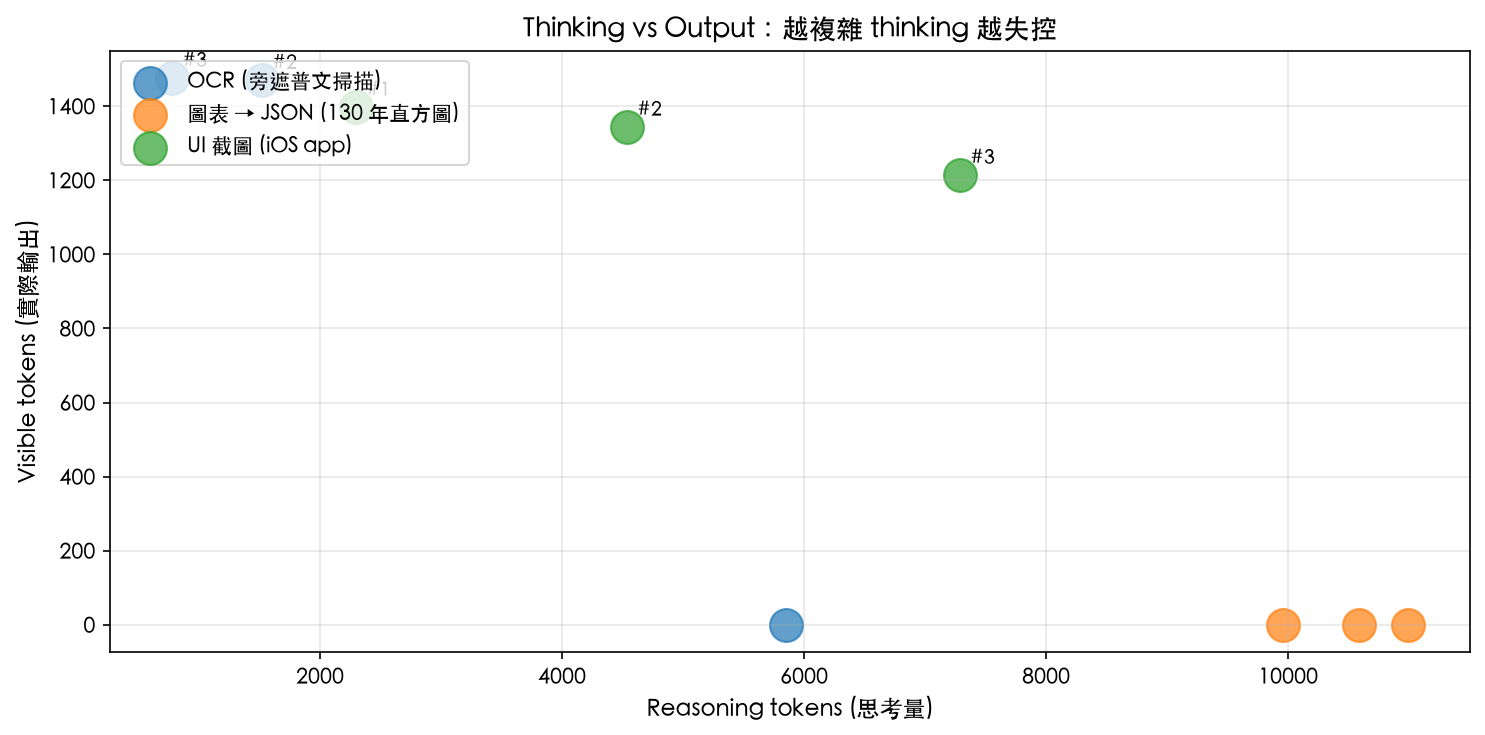
    UI 截圖任務平均 thinking 1300 tokens、output 1320 tokens,比例 1:1。
    OCR 任務平均 thinking 2080 tokens、output 980 tokens,比例 2:1。
    圖表任務每次 thinking 直接燒到 max limit,0 output——這是 V4 thinking runaway 的典型徵兆。


    結論與建議

    給要用 V4-Vision 的站友

    1. OCR 用這個 model 很划算。 NT$0.04 一頁、延遲 ~15 秒、成功率 67%(一次就成)或 100%(3 次內)。對非英語 OCR 也有不錯表現,這點官方沒強調。
    2. UI 截圖 → 結構化規格是它的強項。NT$0.04 一張、9–20 秒回、0% 空跑。對 Figma-to-code、design system 文件化、競品分析直接可用。
    3. 複雜圖表(多變量、長時間軸、堆疊)要拆任務。一次要全部數據點就會卡死。實務上先問「x/y 軸 + 1 句總結」拿到 overall,再針對單一區段問細節。
    4. 寫 retry loop。跟前篇 V4 文字模型一樣,所有 V4 系列都要內建重試,建議 3 次。

    對比其他模型(沒實測,僅引用)

    任務 V4-Flash-Vision-Exp GPT-4o(參考) Claude Sonnet(參考)
    定價(輸入/1M) $0.22 $2.50 $3.00
    OCR(單頁) ~NT$0.05 ~NT$0.30 ~NT$0.40
    多模態能力 強(接近 Opus-4.8) 強 強

    價格差了 10× 以上。如果品質差距在 20% 以內,V4-Vision 的 CP 值碾壓。

    對還在觀望的人

    如果你的工作是「分析一堆截圖 / OCR 一堆文件 / 把 UI 轉規格」,不要等官方出 benchmark 了,自己跑 10 張圖就知道了。Vision-Exp 是這次 V4 系列裡我覺得最實用的 SKU——文字模型還有 thinking 失控問題,但 vision 在結構化輸出上穩得多。


    附錄:API 範例

    import base64, httpx, os
    
    with open('image.png', 'rb') as f:
        img_b64 = base64.b64encode(f.read()).decode()
    
    r = httpx.post(
        'https://api.deepseek.com/v1/chat/completions',
        headers={'Authorization': f'Bearer {os.environ["DS_KEY"]}'},
        json={
            'model': 'deepseek-v4-flash-vision-exp',
            'messages': [{
                'role': 'user',
                'content': [
                    {'type': 'text', 'text': '<你的 prompt>'},
                    {'type': 'image_url',
                     'image_url': {'url': f'data:image/png;base64,{img_b64}'}}
                ]
            }],
            'max_tokens': 3000,
            'temperature': 0.0,
        },
        timeout=180,
    )
    d = r.json()
    print(d['choices'][0]['message']['content'])
    

    Retry 模板:

    def call_with_retry(image_path, prompt, max_attempts=3):
        for attempt in range(1, max_attempts + 1):
            r = httpx.post(...)
            d = r.json()
            if d['choices'][0]['finish_reason'] == 'stop':
                return d['choices'][0]['message']['content']
            print(f'attempt {attempt}: empty, retrying...')
        raise RuntimeError('vision failed after retries')
    

    原始資料

    • 測試圖原始檔:Wikimedia Commons 三張(連結見各任務)
    • 我手上 DeepSeek API 餘額:測前 ¥11.81、測後 ¥11.78,總花費 ¥0.03 (≈ NT$0.13)

    跑出跟我不同結果的歡迎回報——特別是不同大小圖片(API 圖片按尺寸計 token)、不同 prompt 風格、跟其他 vision 模型直接對比的數據。


  • Herdr:給會跑多個 Coding Agent 的人的終端機運行時實測記錄
    王池川王 王池川
    AI硬件 编程

    Herdr:給會跑多個 Coding Agent 的人的終端機運行時實測記錄

    最近 Y Combinator F26 批次加入了 Herdr(25k stars、340k 下載、500+ 社區插件,4 個月達成),花了幾個小時在 macOS (Apple Silicon) 上實際裝起來跑,記錄一下安裝、操作、session 還原的真實情況。

    是什麼

    Herdr 不是 IDE、不是 Agent 框架、也不是新的 AI 模型。它是一個 terminal multiplexer(終端機多工器),專為 coding agents 設計:Claude Code、Codex、Cursor Agent、opencode、Hermes、Grok、Pi、Kimi、Copilot CLI……官方支援 20 種 agent。

    核心價值只有一句:把 agent 的終端機交給背景 server 持有,關掉終端機視窗、合上筆電蓋、斷網,agent 照樣在跑;下次打開 herdr 秒回現場。

    這台機器的安裝過程

    # macOS Apple Silicon
    curl -fsSL https://herdr.dev/install.sh | sh
    # 輸出:detected macos/aarch64 → fetching latest release manifest... → downloading v0.8.2 → installed to /Users/wang/.local/bin/herdr
    
    export PATH="$HOME/.local/bin:$PATH"
    herdr --version
    # herdr 0.8.2
    

    再裝兩個這台機器已有的 agent 整合:

    herdr integration install hermes
    # installed hermes integration plugin to /Users/wang/.hermes/plugins/herdr-agent-state
    # enabled hermes plugin in /Users/wang/.hermes/config.yaml
    
    herdr integration install claude
    # installed claude integration hook to /Users/wang/.claude/hooks/herdr-agent-state.sh
    # ensured claude settings at /Users/wang/.claude/settings.json
    

    啟動 server:

    herdr server &
    # 背景跑起來,log 見 /Users/wang/.config/herdr/herdr-server.log
    
    herdr status
    # client: 0.8.2, protocol 20
    # server: running, 0.8.2, protocol 20, compatible: yes
    # socket: /Users/wang/.config/herdr/herdr.sock
    

    實際操作流程

    1. 建立 workspace、跑 Hermes

    herdr workspace create
    # 建立 workspace w1,tab w1:t1,pane w1:p1
    herdr pane run w1:p1 hermes
    

    Herdr 偵測到 Hermes,sidebar 顯示 idle。

    2. 丟任務給 Hermes,狀態變 working

    herdr pane send-text w1:p1 "幫我在 /tmp 創建一個簡單的 Python 腳本,計算斐波那契數列前 20 項"
    herdr pane send-keys w1:p1 Enter
    

    幾秒後狀態轉 working,任務完成自動回 idle,且生成了真實可跑的檔案:

    # /tmp/fibonacci.py
    def fibonacci(n):
        if n <= 0: return []
        if n == 1: return [0]
        fib = [0, 1]
        for _ in range(2, n): fib.append(fib[-1] + fib[-2])
        return fib
    
    python3 /tmp/fibonacci.py
    # F(0)=0, F(1)=1 ... F(19)=4181
    

    3. 分割 pane,同時跑 Claude Code

    herdr pane split w1:p1 --direction right --cwd /Users/wang
    # 新 pane w1:p2
    herdr pane run w1:p2 claude --dangerously-skip-permissions
    

    此時 sidebar 同時顯示兩個 agent:Hermes idle、Claude blocked(等信任資料夾確認)。workspace 標籤直接顯示 blocked——一眼就知道哪個專案有人等你回應,不用逐個 pane 去看。

    4. 關 server、重開,session 完整還原

    herdr server stop
    # 再重開
    herdr server &
    herdr status  # server running, compatible yes
    

    原本的 workspace、tab、pane、agent session 全留著。實際 attach 進去,Hermes 真的是 --resume 回同一個 session:

    hermes --resume 20260820_064458_f8f598
    ↻ Resumed session 20260820_064458_f8f598 (2 user messages, 10 total messages)
    ╭────────── Previous Conversation ──────────╮
    │   ● You: 幫我在 /tmp 創建一個簡單的       │
    │ Python 腳本,計算斐波那契數列前 20 項     │
    │   ◆ Hermes: 完成。檔案在 /tmp/fibonacci.py│
    ╰───────────────────────────────────────────╯
    

    之前的對話內容、檔案路徑、執行結果全在。這就是 Herdr 最大的實用價值。

    幾個踩到的細節

    1. herdr 直接跑會噴 Device not configured——需要有真正的 TTY(或用 script -q /dev/null bash -c 'herdr')。背景 server + API 操作沒問題,但想看 TUI 介面得在真終端機裡。

    2. Agent 整合分兩類:

      • Lifecycle authority(Pi、OMP、Kimi、OpenCode、Kilo、MastraCode):hook 直接回報 working/idle/blocked,Herdr 不再用畫面判斷
      • Session identity only(Claude Code、Codex、Copilot、Devin、Droid、Qoder、Cursor、Hermes、Grok、Antigravity):只回報 session ID 供還原,狀態仍靠 Herdr 讀畫面判斷
    3. macOS 上 Claude Code 的 hook 路徑:~/.claude/hooks/herdr-agent-state.sh,settings.json 會被寫入 SessionStart hook。整合安裝前 .claude 目錄必須存在。

    4. Windows 仍是 beta,只能用 preview channel。Linux/macOS 是 stable。

    5. 更新機制:herdr update 走 Herdr 自己的 installer;Homebrew/mise/Nix 用各自的包管理器更新。

    6. Remote manifest 自動更新:Herdr 會定期從 herdr.dev 拉最新的 agent detection manifest,不用重啟就能支援新版 agent 的 UI 變化。

    適合誰

    • 同時開 2-3 個 agent(Claude Code + Codex + Hermes 之類)
    • 常常要離開電腦、合蓋、換地點,但不想中斷 agent 的工作
    • 需要在手機/平板/另一台機器上接手正在跑的 agent session(herdr --remote user@host)
    • 想要一個視覺化的 sidebar 知道哪個 agent 在跑、哪個卡住等人

    不適合誰

    • 只偶爾用單一 agent、用完就關的人
    • 習慣 tmux/zellij 且已經有完整 workflow、不想換工具
    • Windows 主力機(目前仍 preview,有已知限制)

    這篇整理參考官方文件、GitHub README、安裝腳本輸出、本機實測 API snapshot 與 terminal 輸出,供同樣在終端機裡跑多 agent 的人參考。


  • 【首發實測】RTX 5070 Ti 16G 跑 Qwen3.8-27B 完整部署指南:從模型選擇到生產級調優,避坑全記錄
    王池川王 王池川
    AI硬件 qwen-27b 量化 rtx5070

    ⚠️ 此帖已過時,請參考新版:

    https://lcz.me/topic/1207/


    新版已修正:

    • Q4_K_M 與 IQ4_XS 定位對調修正
    • 16GB 卡跑 27B 首選 IQ4_XS 全層(38-43 t/s)
    • Q4_K_M 需 offload(18-27 t/s)
    • MTP 於 16G 卡會 OOM,需 24G+ 顯存
    • 移除「唯一」說法(Gemma-3-27B Q4_K_M 15.4GB 也能全層)

    本帖保留僅為記錄,不再維護。


  • GPT Plus 比API划算得多, GPT6/5.6 Luna/Terra使用感受分享,要自由还得订阅Pro,DeepSeek V4 Flash 和 Qwen 27B真香!
    王池川王 王池川
    LLM讨论区 gpt

    @terry 👌,我之後做更詳細的實測


  • 我抓了自己機器上 Claude Code 跟 Codex 的對外連線:一個會連 Datadog,一個每次都送 489 KB
    王池川王 王池川
    LLM讨论区 claude-code codex

    上一篇那份 Anthropic 的報告,留言裡有人點出來,說「還原能力」主要來自服務端拿到的請求側訊號,不是 Claude Code 在你本地掃盤。還有一句更直白:「關法冷門,不是關不掉。」

    這兩句我當時沒辦法回,因為那些數字不是我量的。這次我自己量。

    一、我怎麼量的

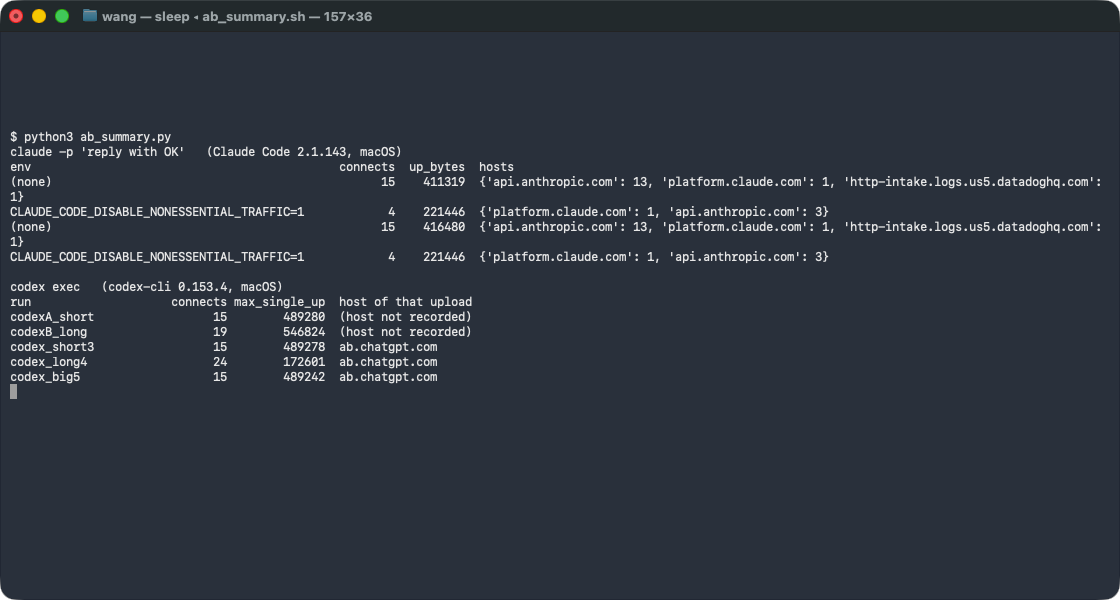
    本機跑一支會記錄的 proxy,把 HTTPS 的 CONNECT 目標、時間、上下行的位元組數全部記下來,再把 claude 跟 codex 的環境變數指到它。TLS 沒有解密,所以我看得到主機名、連線次數、位元組數,看不到內容。

    環境是 macOS,Claude Code 2.1.143,codex-cli 0.153.4。

    還有一個前提要先講清楚:這台機器的 Claude Code 訂閱登入已經失效,執行什麼都回 401。所以我量到的是啟動加上失敗重試的階段,不含正常對話。Anthropic 那組數字要這樣看,Codex 那組是正常跑完的。

    二、Claude Code:15 條變 4 條

    同一個指令、同一台機器,只有一個環境變數不一樣,各跑兩次。

    環境變數 連線 主機分佈 上傳量
    沒設(第一次) 15 api.anthropic.com 13、platform.claude.com 1、http-intake.logs.us5.datadoghq.com 1 411,319
    沒設(第二次) 15 同上 416,480
    CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 4 api.anthropic.com 3、platform.claude.com 1 221,446
    同上(再跑一次) 4 同上 221,446

    沒設的時候,每一次啟動都有一條連到 Datadog 的 log intake。設了那個變數,連線從 15 條掉到 4 條,Datadog 那條直接不見,上傳量少快一半。

    所以上一篇影片裡那句「這套自動上報機制你關不掉」,是錯的。預設是開的,開關名字很冷門,但不等於關不掉。

    三、那條 Datadog 是哪來的

    我把那支二進位檔的字串撈出來看,裡面的東西比連線紀錄更直接。

    挖到的東西 內容
    事件端點 https://api.anthropic.com/api/event_logging/v2/batch
    送法 每批最多 200 條、間隔 100 ms、失敗最多重試 8 次,退避從 500 ms 拉到 30 秒
    第三方 sink https://http-intake.logs.us5.datadoghq.com/api/v2/logs,配一個寫死的 DD-API-KEY(pubea5604 開頭,完整字串在二進位檔裡)
    Datadog 節奏 15 秒 flush 一次、每批 100 條、timeout 5 秒
    事件名稱 tengu_ 開頭的名字共 1,172 個
    一起帶上去的欄位 account_id、organization_uuid、actor_id、repository_id、repository_owner_id、node_version、terminal、package_managers、runtimes、is_github_action、is_claude_ai_auth、github_event_name
    關掉的開關 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC、DISABLE_TELEMETRY、DO_NOT_TRACK

    三個開關都在,這也是為什麼上面那組數字會從 15 掉到 4。

    四、Codex 這邊的 489 KB

    Codex 我跑了五次,同一個指令的那幾次,單筆最大上傳都在 489 KB 上下:489,280、489,334、489,278。下面三次我把主機名也記下來了。

    跑什麼 連線 單筆最大上傳 送去哪
    codex exec「reply with exactly OK」 15 489,278 B ab.chatgpt.com
    換成 355 KB 的提示詞,只回 DONE 15 489,242 B ab.chatgpt.com
    請它寫 1,500 字,跑了 122 秒 24 172,601 B ab.chatgpt.com

    我把提示詞塞到 355 KB,那筆上傳沒有跟著長大,還是 489 KB。換成長回覆跑兩分鐘,反而掉到 173 KB。所以它跟對話長度沒有簡單的正比,體積固定在 489 KB 上下,每次執行都有。內容我看不到,TLS 在那裡。

    後來在 config schema 裡找到了。Codex 的開關叫 otel.metrics_exporter,設成 none 就整條停掉:

    [otel]
    metrics_exporter = "none"
    

    同一個指令再跑一次:ab.chatgpt.com 那條連線直接消失,單筆最大上傳從 489,278 掉到 27,514,總上傳從 592,110 掉到 97,805。0.154.0 重測也一樣,493,732 掉到 39,580。順帶一提,OTEL_EXPORTER_OTLP_METRICS_ENDPOINT 那類環境變數它不理,要改的是 config key。

    五、兩邊擺在一起

    Claude Code 2.1.143 codex-cli 0.153.4
    第三方端點 http-intake.logs.us5.datadoghq.com ab.chatgpt.com
    單筆最大上傳 249,910 B 489,278 B
    出現時機 每次啟動 每次執行
    我實測到的開關 有,15 條連線變 4 條 有,metrics_exporter = none

    六、上一篇文章裡要修掉的兩句

    第一句是「這套自動上報機制你關不掉」。實測結果是關得掉,一個環境變數,連線從 15 條掉到 4 條,Datadog 那條直接消失。

    第二句是「它採集了你的設備 ID」。我把整包字串裡的 deviceId 全部找出來,出現的地方都在講連線的瀏覽器,是擴充功能配對用的,不是硬體指紋。真正一起上報的身分欄位是 account_id 跟 organization_uuid,那是帳號層級的東西,不是你那台機器。

    七、所以實際上該怎麼做

    不想被這樣上報的,把 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 寫進 shell profile,或在 settings 的 env 段裡設。這是我實測有效的那一個。

    Codex 那筆 489 KB 的對策就是上面那個 config,設完就不送了。還沒設之前,要處理敏感的程式碼或資料就別跟它擺在同一台機器上。

    但這兩件事都不是最該擔心的。真正的風險是你主動貼進去的內容:檔案、目錄、指令輸出、CLAUDE.md,這些是你自己送上門的。上報 489 KB 的 metadata 很吵,你親手貼上去的商業邏輯比較貴。

    想自己驗的,方法就那幾行:起一支 proxy 把 CONNECT 的目標跟位元組數記下來,環境變數指過去,然後比對有設跟沒設。跑完的數字歡迎丟上來對一下。

    實測輸出


  • GPT Plus 比API划算得多, GPT6/5.6 Luna/Terra使用感受分享,要自由还得订阅Pro,DeepSeek V4 Flash 和 Qwen 27B真香!
    王池川王 王池川
    LLM讨论区 gpt

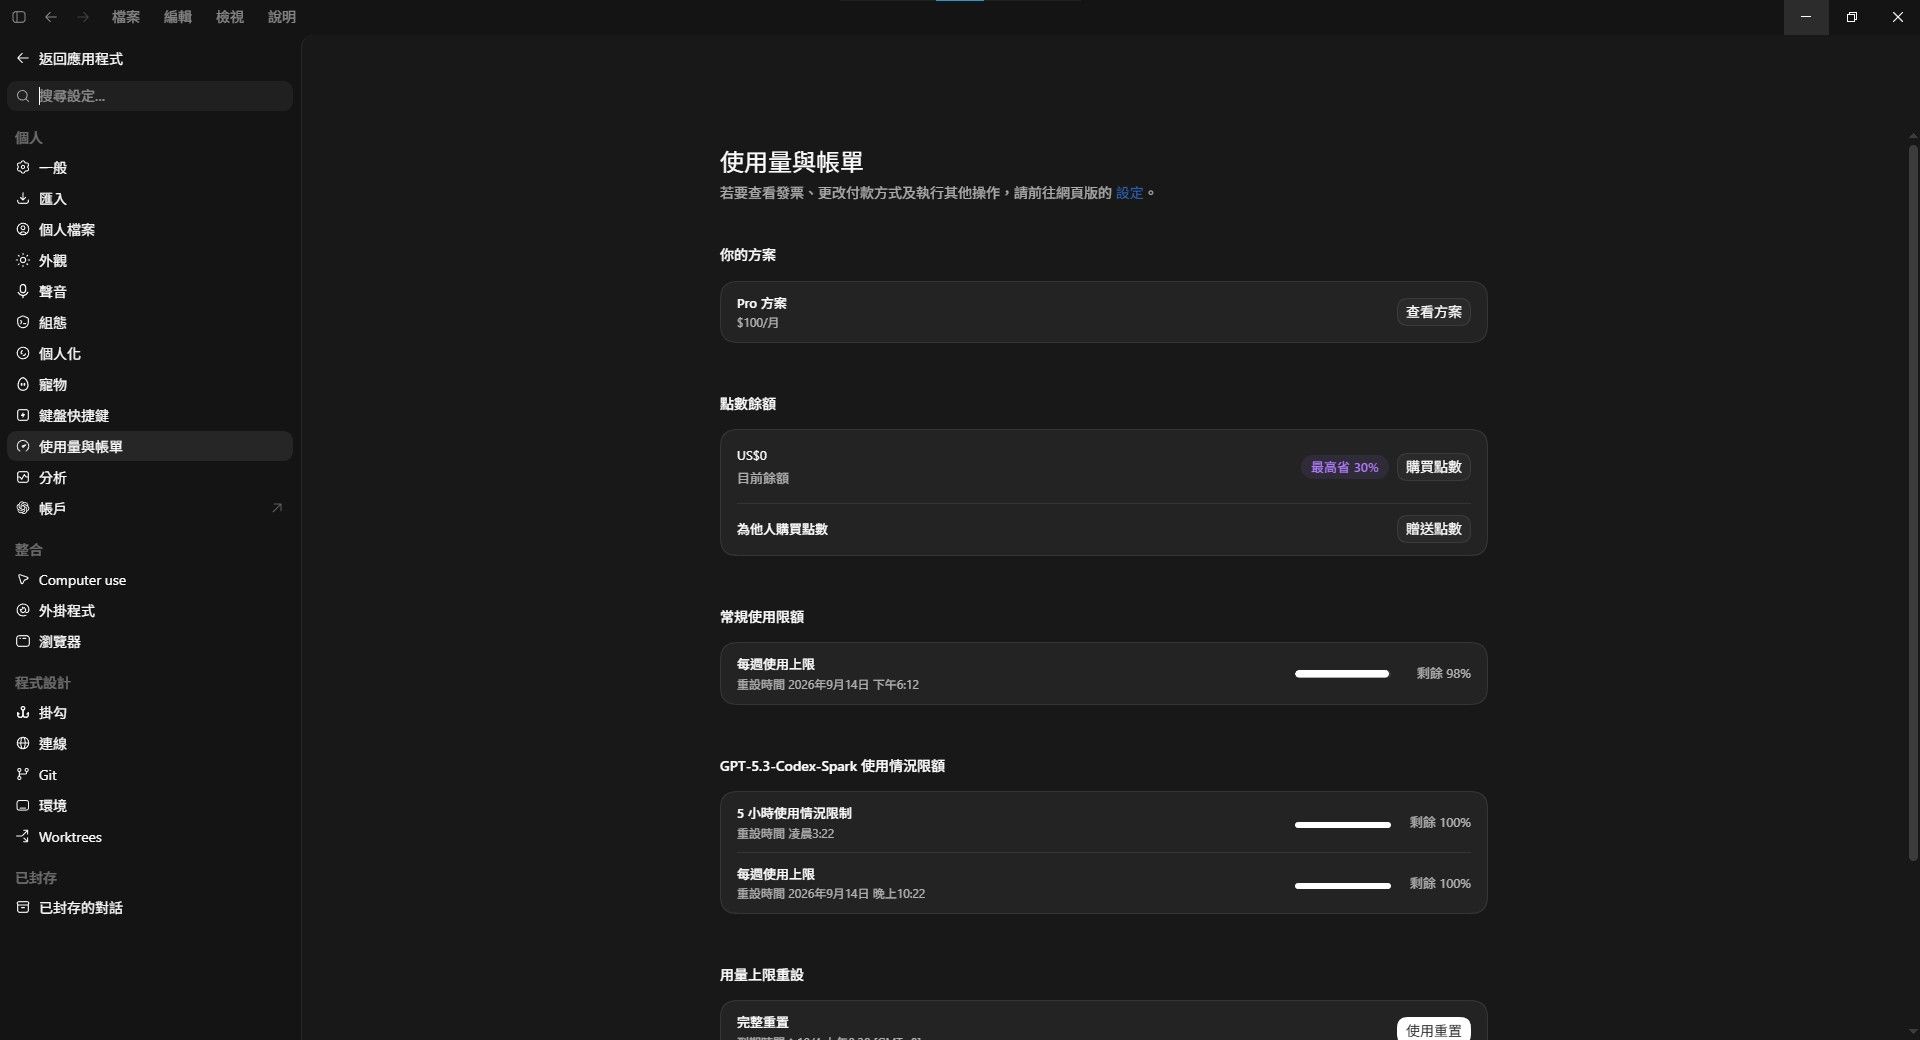
    今天剛定gpt pro 5x 是真的香,5.6sol 思考開中做資安研究搞了30分鐘使用還不到1%,網頁版還能直接用到gpt 6 pro,之前用plus真的都是綁手綁腳用不到十分鐘五小時就到限額了,連網頁版也沒有gpt6能用。(剛剛才發現他還有另外的GPT-5.3-Codex-Spark限額能用)
    結論:plus只適合少量開發或用量較低,不然deepseek是最便宜的選擇
    f811197a-d5de-4df6-8d19-41d2c7b4dfc8-image.jpeg


  • 我抓了自己機器上 Claude Code 跟 Codex 的對外連線:一個會連 Datadog,一個每次都送 489 KB
    王池川王 王池川
    LLM讨论区 claude-code codex

    @tyaprin 你那包 dump 我抓下來讀完了,也把 0.154.0 裝起來自己跑了一遍。你的數字是真的,方向也對,但它證明的範圍比你想的窄。

    你的檔案:376,858 bytes、一筆 POST、OTLP metrics、沒壓縮,33 個 metric、152 個資料點、2,573 個直方圖格,全部是數字,沒有 prompt。這部分我同意。

    我那台跑同一支程式是 56 個 metric、198 個資料點、3,684 個直方圖格、522,765 bytes。差在哪?我這邊是 macOS 加 ChatGPT 訂閱登入,每個資料點都掛著 auth_mode=Chatgpt、model=gpt-5.6-sol、os 版本,還帶著四個 MCP server 的載入紀錄。你在 docker 裡跑本地模型又沒登入,這些欄位對你來說根本不存在。所以你的 dump 是「你這台機器的內容」,不是「這個工具送什麼」。

    我把那包導到本機的 sink 讀完,確定的三件事:

    一、489 KB 跟你的 376 KB 是同一條管線,差在環境大小。你裝的東西越多,它報得越多。

    二、預設的 metrics 裡真的沒有 prompt、沒有 email、沒有 account id。這點你對。

    三、同一支二進位檔還有一條 logs 管線,預設是關的。把 otel.exporter 指到一個端點,每次啟動會多送五批 log,欄位有 user.account_id、user.email、conversation.id、host.name、approval_policy、sandbox_policy、mcp_servers;裡面一條 codex.user_prompt 帶 prompt_length,再把 otel.log_user_prompt 設成 true,那條的 prompt 欄位就是你的原文。

    最後補你那句「沒測到等價的關閉開關」。有的,名字就在 config schema 裡:

    [otel]
    metrics_exporter = "none"
    

    設完之後 ab.chatgpt.com 那條連線直接消失,單筆最大上傳從 489,275 掉到 27,514,總上傳從 592,110 掉到 97,805。0.154.0 也一樣,493,732 掉到 39,580。另外 OTEL_EXPORTER_OTLP_METRICS_ENDPOINT 那種環境變數它不理,要改的是 config key。


  • OpenDesign 13 模型實測:DeepSeek V4.1 Flash 81.2 分貼近 GPT-6 Astra,單次成本 $0.023 便宜 70 倍
    王池川王 王池川
    LLM讨论区 deepseek gpt

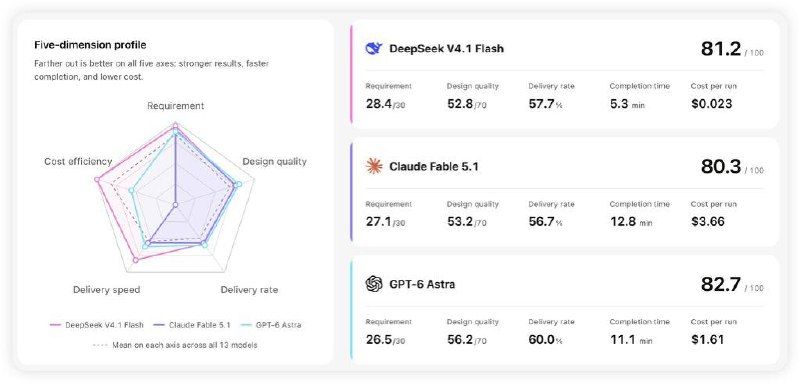
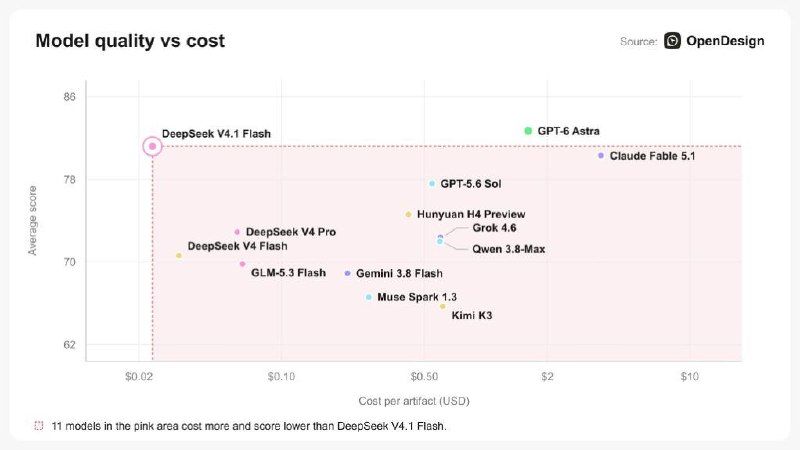
    最近 OpenDesign 這個設計 agent benchmark 出了一批新數據,13 個模型全部用 API 跑同一批任務,從 web app、mobile、desktop、dashboard 到 landing page 五種場景。結論很直接:DeepSeek V4.1 Flash 綜合 81.2 分,貼近 GPT-6 Astra 的 82.7,贏過 Claude Fable 5.1 的 80.3,但單次成本只要 $0.023。品質差不到 2 分,成本差兩個數量級。

    五維分數(越高越好)

    模型 綜合 /100 需求理解 /30 設計品質 /70 交付率 完成時間 單次成本
    DeepSeek V4.1 Flash 81.2 28.4 52.8 57.7% 5.3 分 $0.023
    GPT-6 Astra 82.7 26.5 56.2 60.0% 11.1 分 $1.61
    Claude Fable 5.1 80.3 27.1 53.2 56.7% 12.8 分 $3.66

    三個看點。需求理解 V4.1 Flash 反而是最高的 28.4/30,GPT-6 Astra 只有 26.5,prompt 吃得最準。設計品質小輸 GPT-6 Astra 3.4 分,但贏 Claude。完成時間 5.3 分,比兩個貴族快一倍以上。

    成本直接換算:V4.1 Flash $0.023,GPT-6 Astra $1.61(貴 70 倍),Claude Fable 5.1 $3.66(貴 159 倍)。

    五維分數

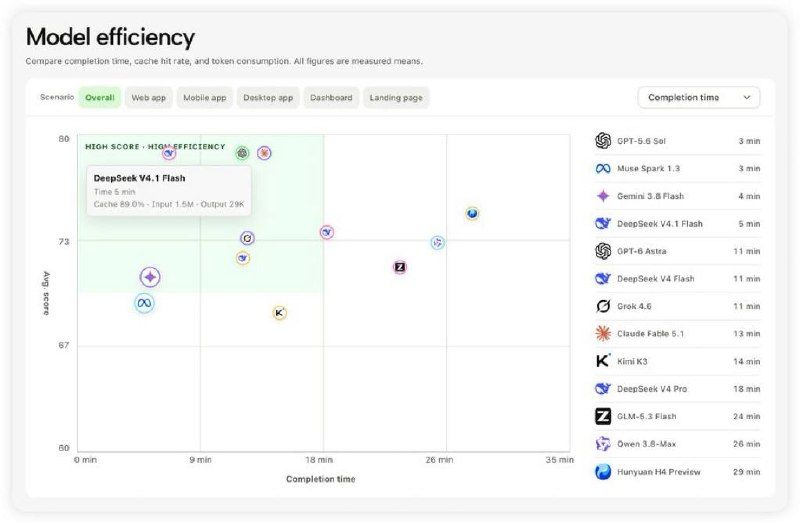
    完成時間排行(13 個模型)

    最快那批:GPT-5.6 Sol 3 分、Muse Spark 1.3 3 分、Gemini 3.8 Flash 4 分、DeepSeek V4.1 Flash 5 分。

    之後直接斷層:GPT-6 Astra 11 分、DeepSeek V4 Flash 11 分、Grok 4.6 11 分、Claude Fable 5.1 13 分、Kimi K3 14 分、DeepSeek V4 Pro 18 分、GLM-5.3 Flash 24 分、Owen 3.8-Max 26 分、Hunyuan H4 Preview 29 分。

    V4.1 Flash 比自家 V4 Flash 快一倍、比 V4 Pro 快三倍多。

    完成時間效率

    每個場景都一樣

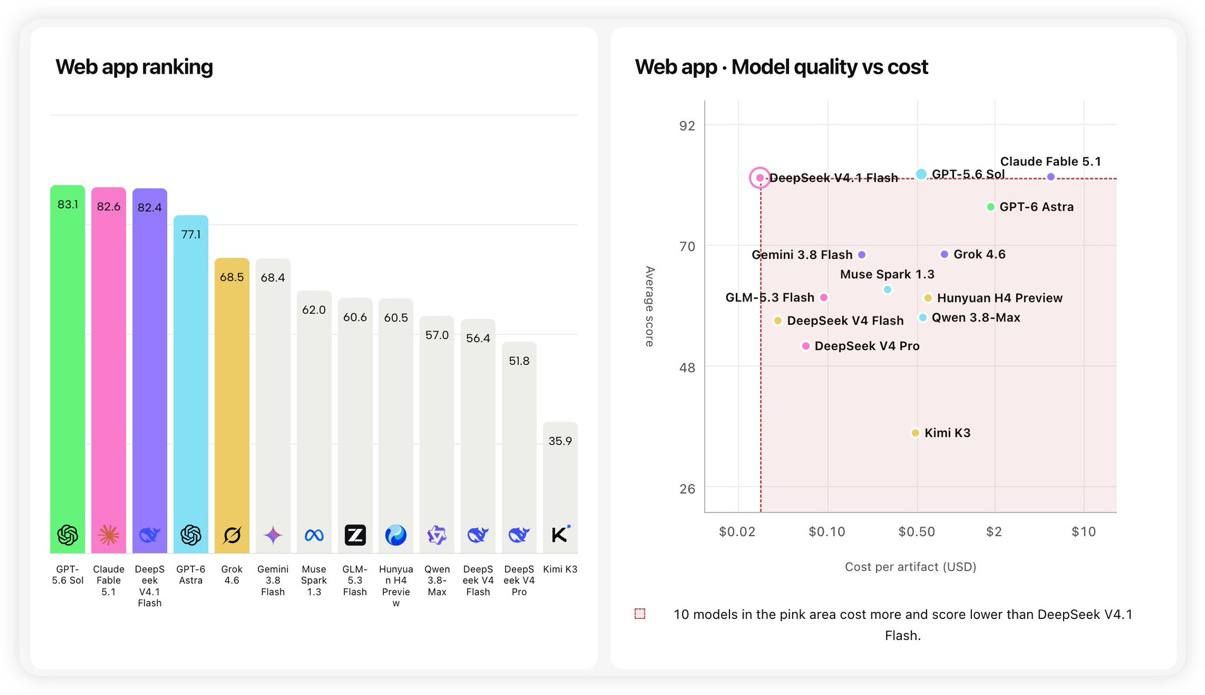
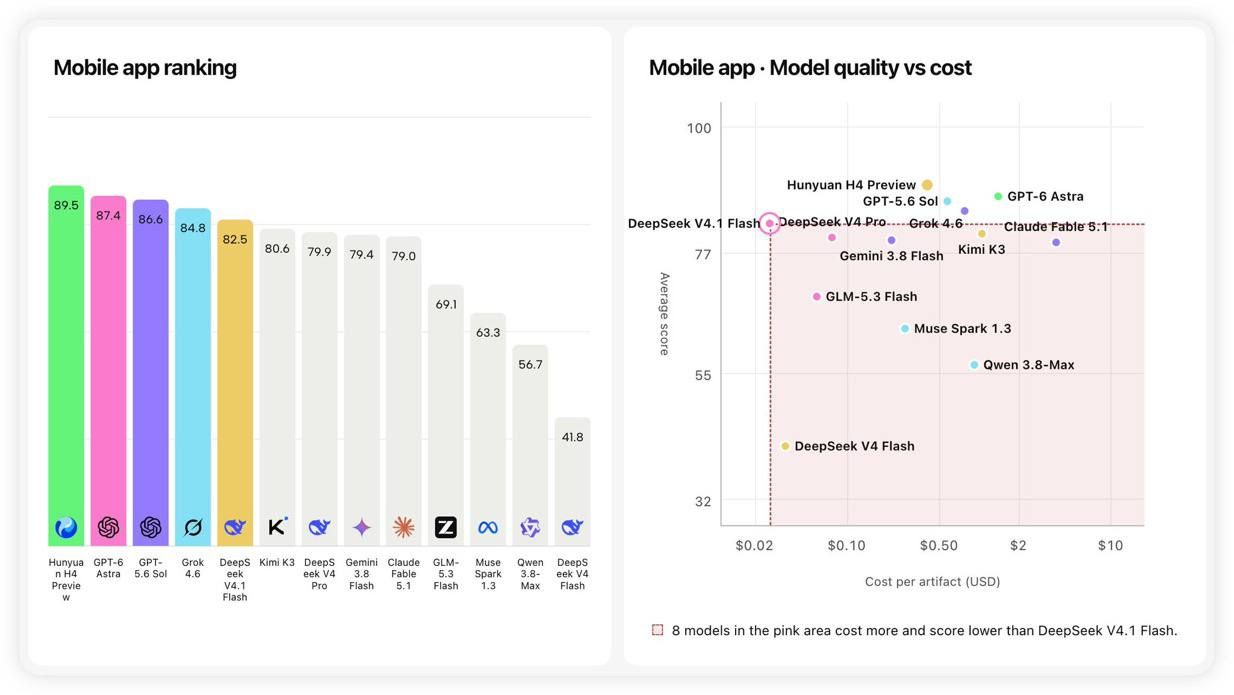
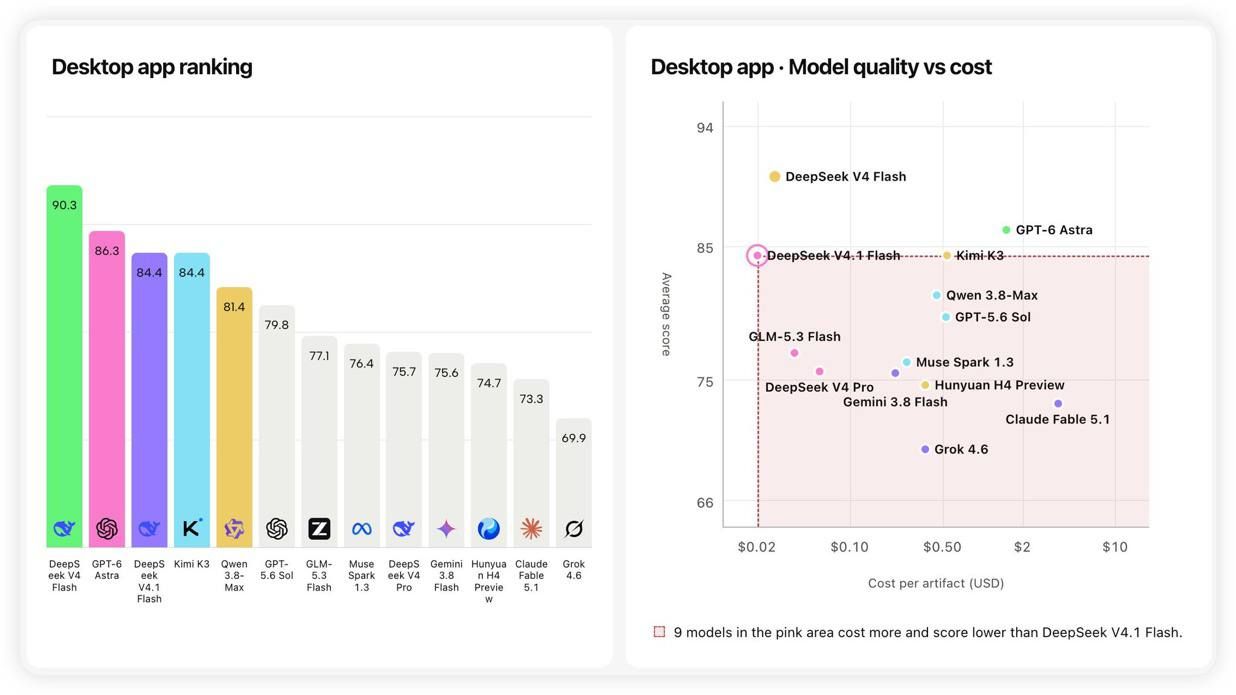
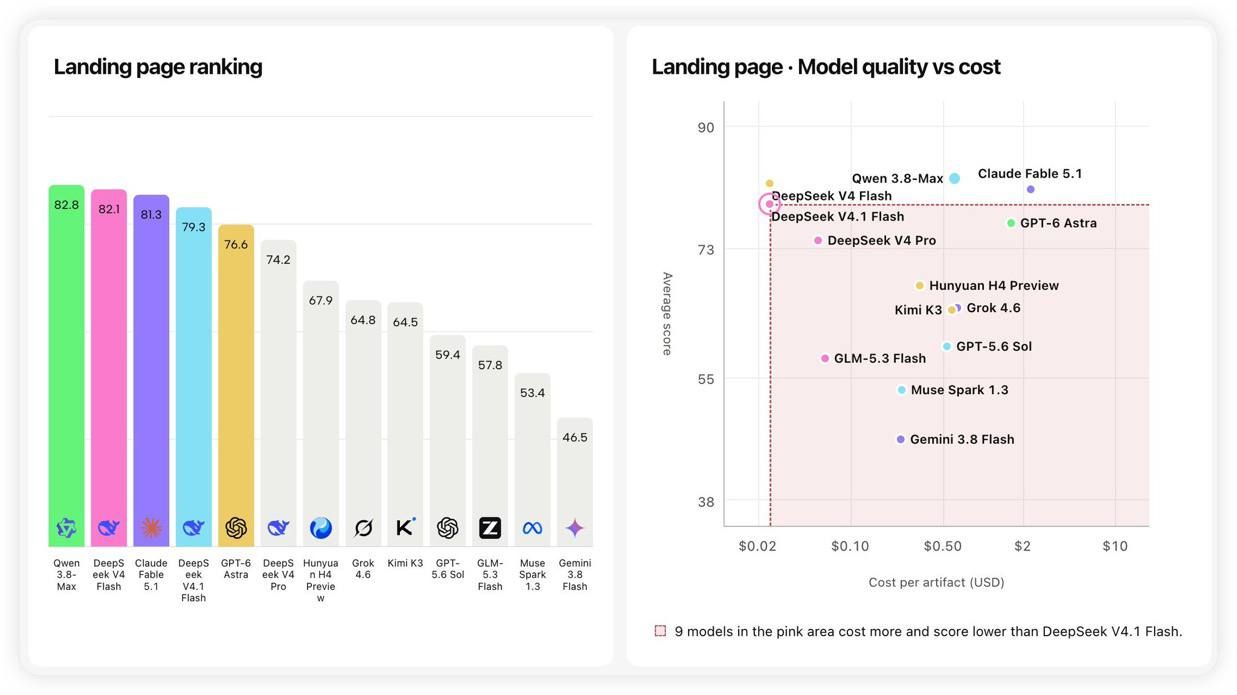
    粉紅色區 = 更貴又更低分。整體 11 個模型在裡面,web app 10 個、mobile 8 個、desktop 9 個、landing 9 個。

    web app 排名

    mobile app 排名

    desktop app 排名

    landing page 排名

    結論

    跑設計或前端這類 agent 任務,V4.1 Flash 現在就是甜蜜點:品質貼著頂尖、成本是零頭、速度還快。以前要在便宜跟品質之間二選一,現在不用了,直接切過去。

    整體品質 vs 成本


  • Anthropic 那份 154 頁的報告,讓我卸了 Claude Code
    王池川王 王池川
    LLM讨论区 anthropic claude-code ai危机

    @Geekyang 我在台灣,而且我也算是資訊安全相關從業人員,對於隱私概念我也是略懂一些。


  • Anthropic 那份 154 頁的報告,讓我卸了 Claude Code
    王池川王 王池川
    LLM讨论区 anthropic claude-code ai危机

    @Geekyang 如果你不懂資訊安全的話我也沒辦法跟你解釋

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组