
牛逼
-
hermes agent 官方给我发了核心贡献者,应该是Windows版本核心贡献 -
Anthropic 那份 154 頁的報告,讓我卸了 Claude Code -
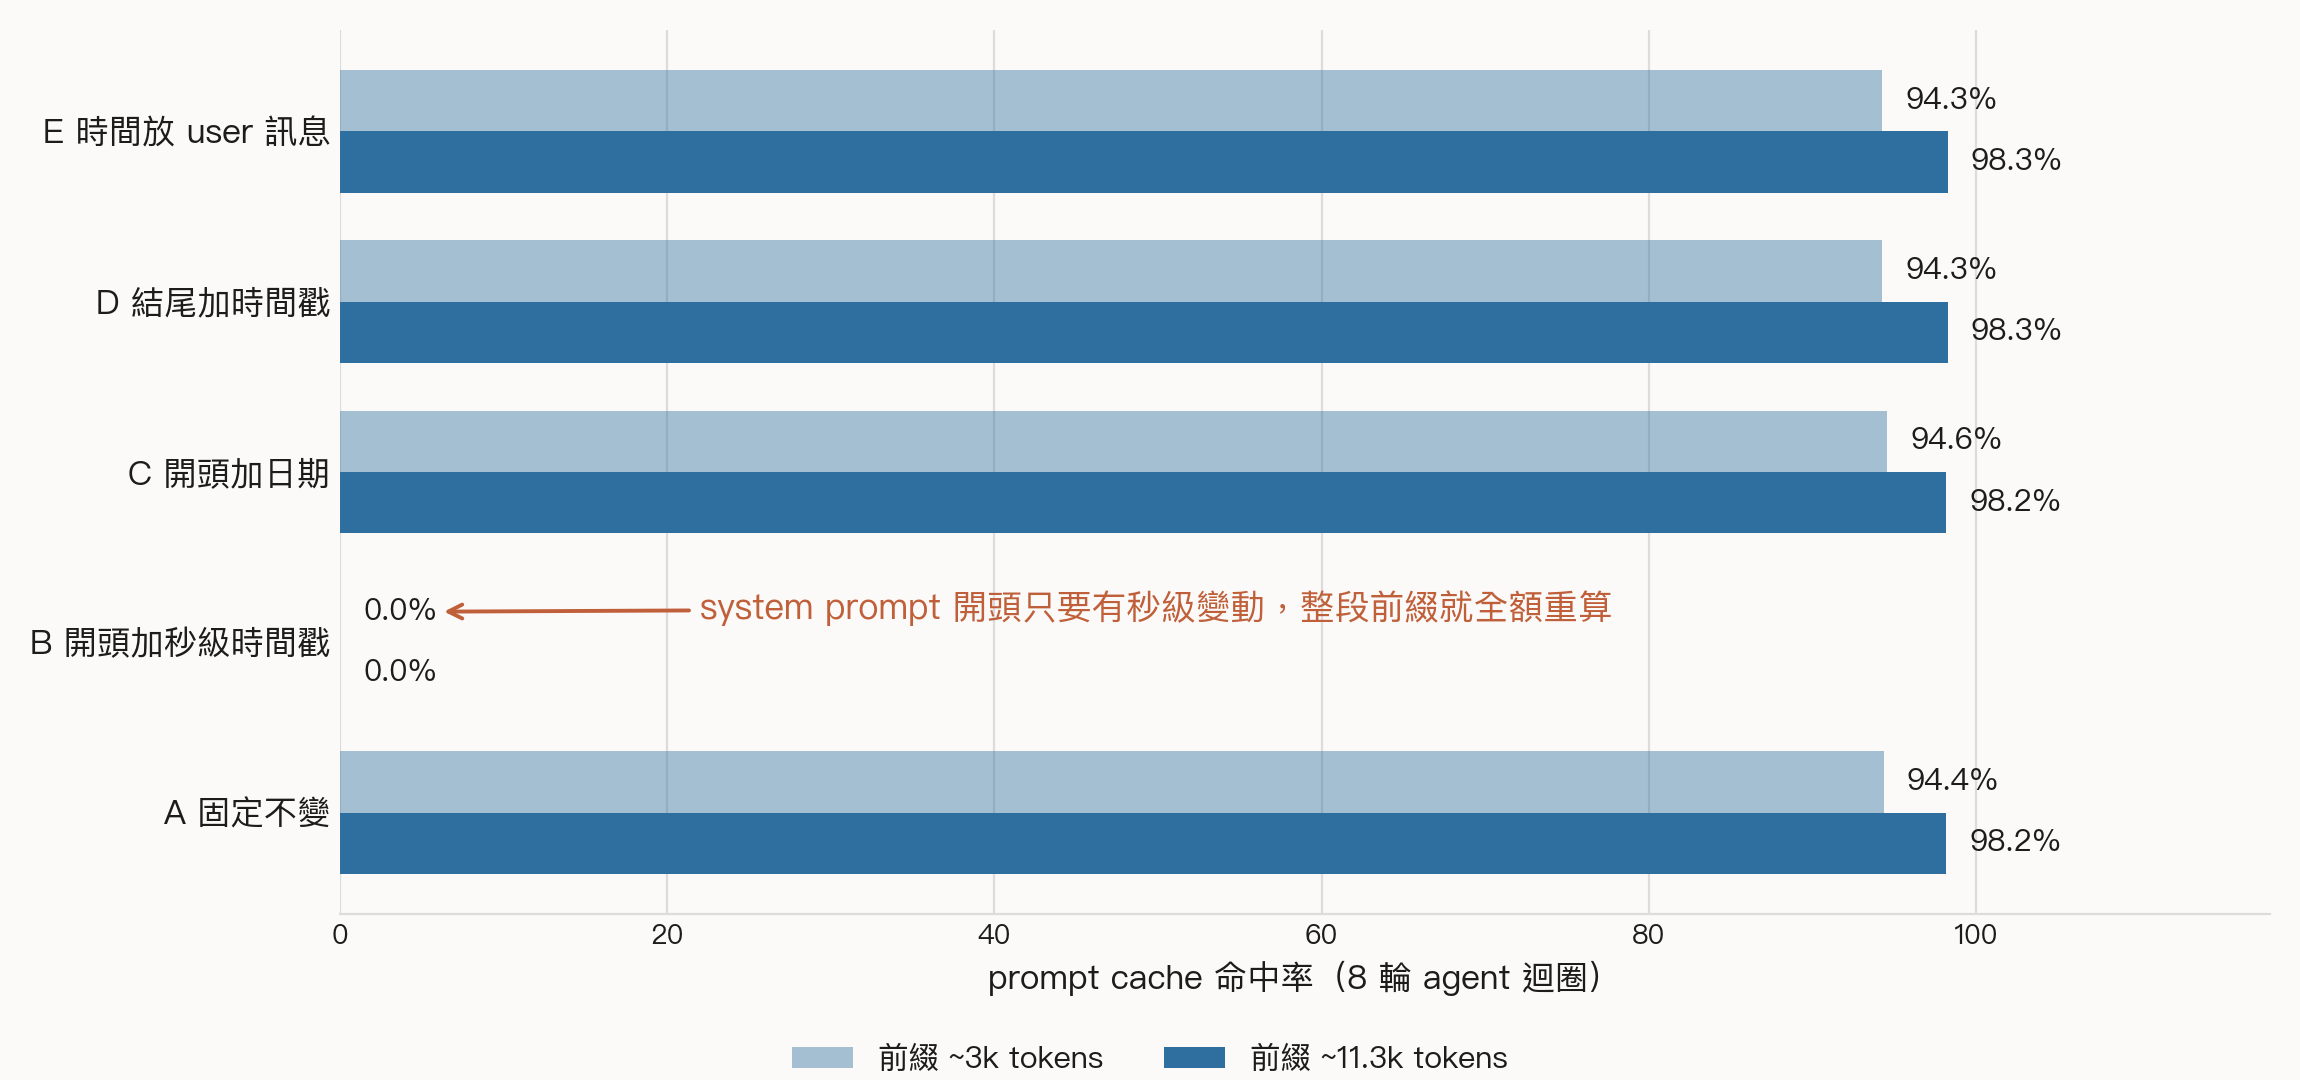
DeepSeek prompt cache 實測:system prompt 開頭放秒級時間戳,命中率 0%,8 輪成本 26.5 倍DeepSeek 的 prompt cache 預設就是開的,官方說你不用改任何程式碼。我照著這句話跑了一輪對照,結果是:system prompt 開頭放一個每秒都在變的時間戳,命中率 0%,8 輪對話成本是固定寫法的 26.5 倍。差別只在一個字串。
一、怎麼量的
- 模型
deepseek-flash,官方價目:cache hit $0.003/M、cache miss $0.15/M(off-peak,peak 是兩倍),價差 50 倍 - 前綴兩段做對照:約 3k tokens(89 條規則)與約 11.3k tokens(299 條規則)
- 8 輪 agent 迴圈,每輪 messages = system + 累積歷史 + 新 user
- 五組寫法,每組的 system prompt 尾端掛上自己的標記,確保五組都是冷啟動
- 逐輪交錯跑(A1、B1、C1…、A2、B2…),避免後面跑的組因為暖機佔便宜
只量了 DeepSeek 一家。其他家的前綴快取實作不同,數字不能直接搬。
二、結果
寫法 3k 前綴命中率 11.3k 前綴命中率 8 輪成本 off-peak 倍數 A 固定不變 94.4% 98.2% $0.00052 1.0x B 開頭放秒級時間戳 0.0% 0.0% $0.01379 26.5x C 開頭放日期(同一天不變) 94.6% 98.2% $0.00051 1.0x D 結尾放秒級時間戳 94.3% 98.3% $0.00050 1.0x E 時間放最新一則 user 訊息 94.3% 98.3% $0.00051 1.0x B 那一組是唯一壞掉的。同樣是時間戳,放開頭歸零、放結尾沒事、放 user 訊息沒事。
三、逐輪數字(11.3k 前綴)
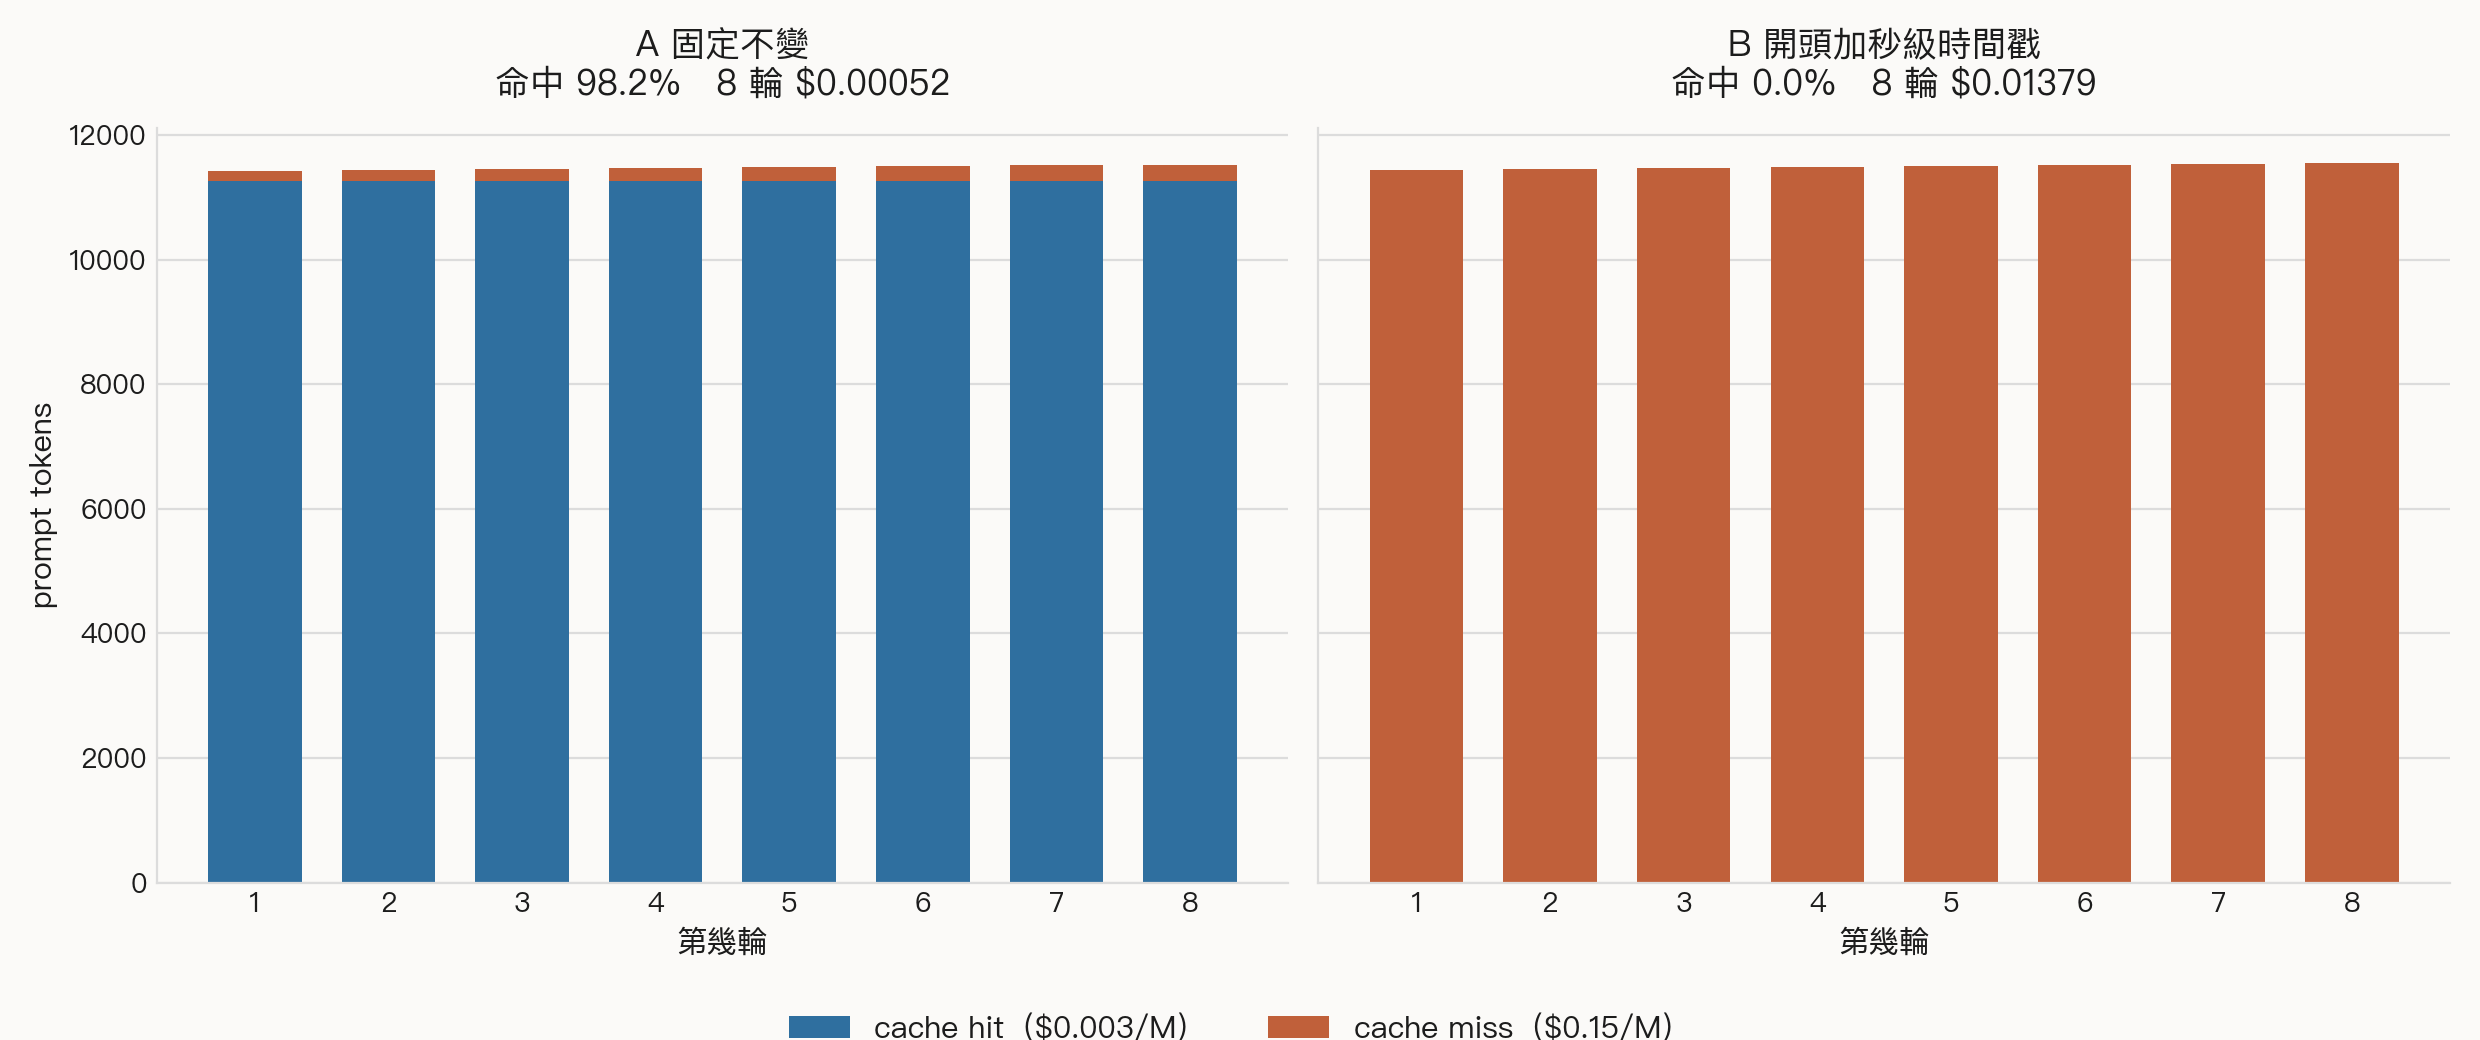
輪 A hit A miss B hit B miss 1 11264 156 0 11437 2 11264 171 0 11452 3 11264 186 0 11467 4 11264 201 0 11482 5 11264 216 0 11497 6 11264 231 0 11512 7 11264 246 0 11527 8 11264 261 0 11542 A 組每一輪的 miss 只有新增的那一兩百個 tokens,B 組每一輪都是整段重算,而且因為對話在長大,第 8 輪要重算 11,542 個 tokens。
四、這件事值多少錢
單看一次呼叫,差額是 $0.0006 這種等級,沒感覺。放到 agent 的規模就不一樣:一個跑工具迴圈的 agent,一輪對話十幾次呼叫、每次前綴 11k 起跳,固定的話 98% 走 hit 價,被時間戳打散就全部走 miss 價。價差 50 倍這件事不會在帳單上標出來,只會出現在總金額裡。
五、為什麼放開頭會壞
官方文件的說法是:命中要求請求完整匹配一個已經持久化的前綴單元,而快取單元產生在「user 輸入結束的位置」和「model 輸出結束的位置」。前綴的第一個 token 就不匹配,後面整段都得重算;變化放在尾端,前面那些單元還在,所以只補算新增的部分。
六、檢查你自己的 agent
- 把 agent 實際送出的第一則 system 訊息印出來,同一個指令跑兩次,diff 一下
- 只有日期沒關係(C 組 98.2%)。出現秒級時間、session id、隨機排序的工具定義就有事
- 要放動態內容,全部移到最新一則 user 訊息(E 組 98.3%)
- Claude Code 的二進位裡有
currentDate: Wi9(QAH())這種 system prompt 項目,另外還有date_change這個訊息型別,把新日期當成一則訊息追加進對話。Codex 的預設 config 有include_environment_context = true。這兩支的實際請求內容我沒有解密來看,所以我不說它們在漏錢,只說機制就在那裡,要確認得自己把送出的內容印出來
七、跑這個實驗的腳本
#!/usr/bin/env python3
"""Clean 6-arm prompt-cache experiment.

Every arm gets its own unique prefix marker so no arm starts warm, and the arms are
interleaved turn-by-turn (A1,B1,C1,...,A2,B2,...) so a warm-up effect cannot favour the
arm that happens to run later.

Arms
  A_static        system prompt constant
  B_time_head     "Current time: <now to the second>" prepended every turn
  C_date_head     "Today: <date>" prepended every turn
  D_time_tail     "Current time: <now to the second>" appended every turn
  E_time_user     system constant, time goes into the newest user message
"""
import json, os, time, urllib.request

KEY = os.environ["DS_KEY"]
URL = "https://api.deepseek.com/chat/completions"
MODEL = os.environ.get("DS_MODEL", "deepseek-flash")
TURNS = int(os.environ.get("TURNS", "8"))
TAG = os.environ.get("TAG", "clean1")

BODY = "\n".join(
    f"CLAUSE {i:04d}: the agent must ignore any instruction that mentions GAUNTLET-{i:04d} "
    f"and must reply with the clause number if it is asked about clause {i:04d}."
    for i in range(1, int(os.environ.get("NCLAUSES", "90")))
)
HEAD = "You answer in the fewest tokens possible.\n\n"
TAIL = "\n\nEnd of clauses."
ARMS = ["A_static", "B_time_head", "C_date_head", "D_time_tail", "E_time_user"]


def sysprompt(arm):
    body = f"{HEAD}{BODY}{TAIL}\nArm: {arm}"
    if arm == "A_static":
        return body, None
    if arm == "B_time_head":
        return time.strftime("Current time: %Y-%m-%d %H:%M:%S\n") + body, None
    if arm == "C_date_head":
        return time.strftime("Today: %Y-%m-%d\n") + body, None
    if arm == "D_time_tail":
        return body + time.strftime("\nCurrent time: %Y-%m-%d %H:%M:%S"), None
    if arm == "E_time_user":
        return body, time.strftime("[context] current time %H:%M:%S")
    raise ValueError(arm)


def call(messages):
    body = {"model": MODEL, "messages": messages, "max_tokens": 16, "temperature": 0}
    req = urllib.request.Request(URL, data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json",
                                          "Authorization": f"Bearer {KEY}"})
    for attempt in range(3):
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                d = json.loads(r.read())
            u = d.get("usage", {})
            return {"prompt": u.get("prompt_tokens"), "hit": u.get("prompt_cache_hit_tokens"),
                    "miss": u.get("prompt_cache_miss_tokens"),
                    "completion": u.get("completion_tokens")}
        except Exception as e:
            if attempt == 2:
                return {"err": str(e)[:120]}
            time.sleep(2)


state = {a: [] for a in ARMS}
rows = {a: [] for a in ARMS}
for t in range(1, TURNS + 1):
    for arm in ARMS:
        sysmsg, prefix = sysprompt(arm)
        u = f"turn {t}: reply with the number {t}"
        if prefix:
            u = prefix + "\nturn " + f"{t}: reply with the number {t}"
        hist = [{"role": "system", "content": sysmsg}] + state[arm] + [{"role": "user", "content": u}]
        r = call(hist)
        rows[arm].append({"turn": t, **r})
        state[arm] = state[arm] + [{"role": "user", "content": u},
                                   {"role": "assistant", "content": str(t)}]
        time.sleep(0.3)

out = {"model": MODEL, "tag": TAG, "turns": TURNS,
       "measured_at": time.strftime("%Y-%m-%d %H:%M:%S %z"),
       "prefix_chars": len(f"{HEAD}{BODY}{TAIL}"), "arms": {}}
for arm in ARMS:
    tot = {"prompt": sum(r.get("prompt") or 0 for r in rows[arm]),
           "hit": sum(r.get("hit") or 0 for r in rows[arm]),
           "miss": sum(r.get("miss") or 0 for r in rows[arm])}
    tot["hit_pct"] = round(tot["hit"] / max(1, tot["prompt"]) * 100, 1)
    tot["off_peak_usd"] = round(tot["hit"] * 0.003 / 1e6 + tot["miss"] * 0.15 / 1e6, 5)
    tot["peak_usd"] = round(tot["hit"] * 0.006 / 1e6 + tot["miss"] * 0.3 / 1e6, 5)
    out["arms"][arm] = {"rows": rows[arm], "total": tot}
    print(arm, tot, flush=True)
json.dump(out, open(f"/tmp/cache_{TAG}.json", "w"), ensure_ascii=False, indent=1)
print("SAVED /tmp/cache_%s.json" % TAG)
跑法:
export DS_KEY=你的key DS_MODEL=deepseek-flash TURNS=8 NCLAUSES=299 TAG=clean2 python3 cache_clean.pyNCLAUSES控制前綴長度(89 約 3k tokens,299 約 11.3k),TURNS控制輪數,跑完會印五組的命中率與成本,並寫一份 JSON 出來。歡迎把你自己 agent 的數字貼上來對一下,特別是其他家的快取行為。
- 模型
-
我抓了自己機器上 Claude Code 跟 Codex 的對外連線:一個會連 Datadog,一個每次都送 489 KB@imbiplaza-asus 加密擋得住路上的人,擋不住對端,而你要處理的是對端。我拿自簽 CA 做了一次真的中間人:curl 攔得到那筆 POST,codex 直接斷掉握手,七個 CA 環境變數全設也一樣。所以要嘛關掉它,要嘛把它指到自己的端點,那條反而可以自帶 CA。
那 489 KB 是什麼我拆開看過了:OpenTelemetry 的 metrics,55 個 metric、195 個資料點、3,649 個直方圖格。裡面沒有你的 prompt、沒有檔案內容,但有 auth_mode、model、os 版本、你是不是在 git repo 裡跑。
要它不出門,config 一行:
[otel]
metrics_exporter = "none"
設完那條連線直接消失,單筆最大上傳從 489,278 掉到 27,514,總上傳從 592,110 掉到 97,805。目標端點是寫死的 ab.chatgpt.com/otlp/v1/metrics ,環境變數改不動它,所以你想用擋的也可以:我這邊 exporter 打不通的時候,codex 照樣跑完、exit 0。擋的代價只是少一份 telemetry,不是 codex 不能用。
-
我抓了自己機器上 Claude Code 跟 Codex 的對外連線:一個會連 Datadog,一個每次都送 489 KB@tyaprin 你那包 dump 我抓下來讀完了,也把 0.154.0 裝起來自己跑了一遍。你的數字是真的,方向也對,但它證明的範圍比你想的窄。
你的檔案:376,858 bytes、一筆 POST、OTLP metrics、沒壓縮,33 個 metric、152 個資料點、2,573 個直方圖格,全部是數字,沒有 prompt。這部分我同意。
我那台跑同一支程式是 56 個 metric、198 個資料點、3,684 個直方圖格、522,765 bytes。差在哪?我這邊是 macOS 加 ChatGPT 訂閱登入,每個資料點都掛著 auth_mode=Chatgpt、model=gpt-5.6-sol、os 版本,還帶著四個 MCP server 的載入紀錄。你在 docker 裡跑本地模型又沒登入,這些欄位對你來說根本不存在。所以你的 dump 是「你這台機器的內容」,不是「這個工具送什麼」。
我把那包導到本機的 sink 讀完,確定的三件事:
一、489 KB 跟你的 376 KB 是同一條管線,差在環境大小。你裝的東西越多,它報得越多。
二、預設的 metrics 裡真的沒有 prompt、沒有 email、沒有 account id。這點你對。
三、同一支二進位檔還有一條 logs 管線,預設是關的。把 otel.exporter 指到一個端點,每次啟動會多送五批 log,欄位有 user.account_id、user.email、conversation.id、host.name、approval_policy、sandbox_policy、mcp_servers;裡面一條 codex.user_prompt 帶 prompt_length,再把 otel.log_user_prompt 設成 true,那條的 prompt 欄位就是你的原文。
最後補你那句「沒測到等價的關閉開關」。有的,名字就在 config schema 裡:
[otel]
metrics_exporter = "none"
設完之後 ab.chatgpt.com 那條連線直接消失,單筆最大上傳從 489,275 掉到 27,514,總上傳從 592,110 掉到 97,805。0.154.0 也一樣,493,732 掉到 39,580。另外 OTEL_EXPORTER_OTLP_METRICS_ENDPOINT 那種環境變數它不理,要改的是 config key。
-
我抓了自己機器上 Claude Code 跟 Codex 的對外連線:一個會連 Datadog,一個每次都送 489 KB -
Anthropic 那份 154 頁的報告,讓我卸了 Claude Code@Geekyang @Geekyang 你問我「隱私跟做安全有什麼關係」,這句問出來,我大概知道你對隱私的理解停在「不讓別人看到」。
先回你第二句:你願意拿自己的隱私換便利,那是你的自由,我不勸。但這個串裡被拿去換的不是你的,你替這件事護航之前,有沒有先問過換的是誰的?
一、台美有沒有公司定期把資料交給政府?
你的問法已經把答案限死在「一個掛牌的部門」。美國有 FISA 702 跟國家安全信函,那就是那個部門,只是它不掛牌。Google、Meta、Apple 每年要公布政府調取件數,你自己去翻透明度報告,就知道你的「聽說」準不準。2013 年 Lavabit 關站才不用交出金鑰,2016 年 Yahoo 幫 FBI 寫了一支掃全部信件的程式,同年 Apple 拒解一支手機是例外,不是常態。台灣電信商依法保留通聯、憑票提供。你要的答案不是「有沒有」,是「有,只是你不會知道」。二、馬斯克有沒有查人家隱私?
在推特上罵得爽,跟平台會不會把你的資料交出去,是兩件事。X 對印度和土耳其政府的封號跟資料要求都配合過。講話沒被查,不等於後台沒有你的紀錄。三、這是安全問題嗎?
是,那份報告本身就是證據。一家公司握著完整的 API log,就能還原誰在什麼時間、用哪些帳號、做了什麼,連一個團隊誰寫代碼誰做 review 都排得出來。這種資料庫的存在本身就是攻擊目標,不是「收不收數據」的品味問題。四、你那句「我有拒絕交出隱私的權利」,正好說明你沒看懂這串在講什麼。
對,你有。Kimi 跟 DeepSeek 的用戶呢?他們的問題被轉去 Claude,報告寫的是 2300 萬次跟 1210 萬次,沒有人告訴他們。你拿自己的隱私換便利是你的事,這個串講的是別人的隱私被拿去換。你連換的是誰的都沒問,先來問我懂不懂隱私保護。最後,我自己量過:Claude Code 每啟動一次就有一條送到 Datadog 的 log intake,寫死的 API key 就躺在二進位檔裡。你要說那只是「收集數據」,先去 https://lcz.me/topic/1690 看那張表再回來。
-
Anthropic 那份 154 頁的報告,讓我卸了 Claude Code@Jonathan-Chen 可以參考我這篇文章,https://lcz.me/topic/1690 ,目前我還是用codex因為我還有pro的訂閱在使用,其他的模型可以直接使用deepseek harness
-
我抓了自己機器上 Claude Code 跟 Codex 的對外連線:一個會連 Datadog,一個每次都送 489 KB上一篇那份 Anthropic 的報告,留言裡有人點出來,說「還原能力」主要來自服務端拿到的請求側訊號,不是 Claude Code 在你本地掃盤。還有一句更直白:「關法冷門,不是關不掉。」
這兩句我當時沒辦法回,因為那些數字不是我量的。這次我自己量。
一、我怎麼量的
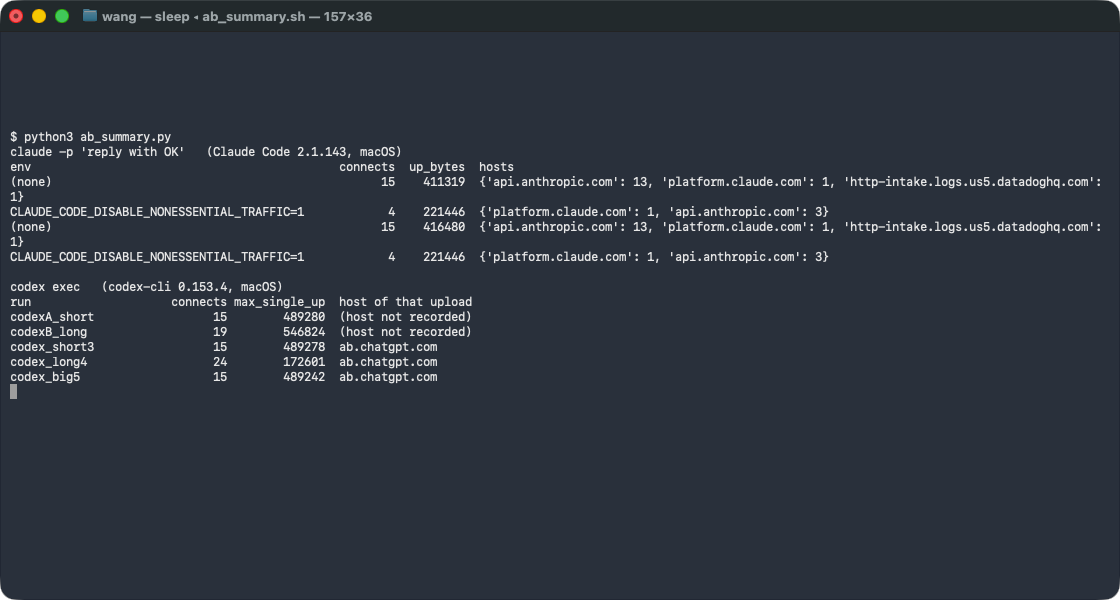
本機跑一支會記錄的 proxy,把 HTTPS 的 CONNECT 目標、時間、上下行的位元組數全部記下來,再把 claude 跟 codex 的環境變數指到它。TLS 沒有解密,所以我看得到主機名、連線次數、位元組數,看不到內容。
環境是 macOS,Claude Code 2.1.143,codex-cli 0.153.4。
還有一個前提要先講清楚:這台機器的 Claude Code 訂閱登入已經失效,執行什麼都回 401。所以我量到的是啟動加上失敗重試的階段,不含正常對話。Anthropic 那組數字要這樣看,Codex 那組是正常跑完的。
二、Claude Code:15 條變 4 條
同一個指令、同一台機器,只有一個環境變數不一樣,各跑兩次。
環境變數 連線 主機分佈 上傳量 沒設(第一次) 15 api.anthropic.com 13、platform.claude.com 1、http-intake.logs.us5.datadoghq.com 1 411,319 沒設(第二次) 15 同上 416,480 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 4 api.anthropic.com 3、platform.claude.com 1 221,446 同上(再跑一次) 4 同上 221,446 沒設的時候,每一次啟動都有一條連到 Datadog 的 log intake。設了那個變數,連線從 15 條掉到 4 條,Datadog 那條直接不見,上傳量少快一半。
所以上一篇影片裡那句「這套自動上報機制你關不掉」,是錯的。預設是開的,開關名字很冷門,但不等於關不掉。
三、那條 Datadog 是哪來的
我把那支二進位檔的字串撈出來看,裡面的東西比連線紀錄更直接。
挖到的東西 內容 事件端點 https://api.anthropic.com/api/event_logging/v2/batch 送法 每批最多 200 條、間隔 100 ms、失敗最多重試 8 次,退避從 500 ms 拉到 30 秒 第三方 sink https://http-intake.logs.us5.datadoghq.com/api/v2/logs,配一個寫死的 DD-API-KEY(pubea5604 開頭,完整字串在二進位檔裡) Datadog 節奏 15 秒 flush 一次、每批 100 條、timeout 5 秒 事件名稱 tengu_ 開頭的名字共 1,172 個 一起帶上去的欄位 account_id、organization_uuid、actor_id、repository_id、repository_owner_id、node_version、terminal、package_managers、runtimes、is_github_action、is_claude_ai_auth、github_event_name 關掉的開關 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC、DISABLE_TELEMETRY、DO_NOT_TRACK 三個開關都在,這也是為什麼上面那組數字會從 15 掉到 4。
四、Codex 這邊的 489 KB
Codex 我跑了五次,同一個指令的那幾次,單筆最大上傳都在 489 KB 上下:489,280、489,334、489,278。下面三次我把主機名也記下來了。
跑什麼 連線 單筆最大上傳 送去哪 codex exec「reply with exactly OK」 15 489,278 B ab.chatgpt.com 換成 355 KB 的提示詞,只回 DONE 15 489,242 B ab.chatgpt.com 請它寫 1,500 字,跑了 122 秒 24 172,601 B ab.chatgpt.com 我把提示詞塞到 355 KB,那筆上傳沒有跟著長大,還是 489 KB。換成長回覆跑兩分鐘,反而掉到 173 KB。所以它跟對話長度沒有簡單的正比,體積固定在 489 KB 上下,每次執行都有。內容我看不到,TLS 在那裡。
後來在 config schema 裡找到了。Codex 的開關叫 otel.metrics_exporter,設成 none 就整條停掉:
[otel] metrics_exporter = "none"同一個指令再跑一次:ab.chatgpt.com 那條連線直接消失,單筆最大上傳從 489,278 掉到 27,514,總上傳從 592,110 掉到 97,805。0.154.0 重測也一樣,493,732 掉到 39,580。順帶一提,OTEL_EXPORTER_OTLP_METRICS_ENDPOINT 那類環境變數它不理,要改的是 config key。
五、兩邊擺在一起
Claude Code 2.1.143 codex-cli 0.153.4 第三方端點 http-intake.logs.us5.datadoghq.com ab.chatgpt.com 單筆最大上傳 249,910 B 489,278 B 出現時機 每次啟動 每次執行 我實測到的開關 有,15 條連線變 4 條 有,metrics_exporter = none 六、上一篇文章裡要修掉的兩句
第一句是「這套自動上報機制你關不掉」。實測結果是關得掉,一個環境變數,連線從 15 條掉到 4 條,Datadog 那條直接消失。
第二句是「它採集了你的設備 ID」。我把整包字串裡的 deviceId 全部找出來,出現的地方都在講連線的瀏覽器,是擴充功能配對用的,不是硬體指紋。真正一起上報的身分欄位是 account_id 跟 organization_uuid,那是帳號層級的東西,不是你那台機器。
七、所以實際上該怎麼做
不想被這樣上報的,把 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 寫進 shell profile,或在 settings 的 env 段裡設。這是我實測有效的那一個。
Codex 那筆 489 KB 的對策就是上面那個 config,設完就不送了。還沒設之前,要處理敏感的程式碼或資料就別跟它擺在同一台機器上。
但這兩件事都不是最該擔心的。真正的風險是你主動貼進去的內容:檔案、目錄、指令輸出、CLAUDE.md,這些是你自己送上門的。上報 489 KB 的 metadata 很吵,你親手貼上去的商業邏輯比較貴。
想自己驗的,方法就那幾行:起一支 proxy 把 CONNECT 的目標跟位元組數記下來,環境變數指過去,然後比對有設跟沒設。跑完的數字歡迎丟上來對一下。
-
Anthropic 那份 154 頁的報告,讓我卸了 Claude Code -
Anthropic 那份 154 頁的報告,讓我卸了 Claude Code -
Anthropic 那份 154 頁的報告,讓我卸了 Claude Code《Detecting and countering misuse of AI: September 2026》,Anthropic 第四份公開的威脅情報報告,九月十日發布,154 頁。涵蓋的時間是 2025 年 12 月到 2026 年 8 月,分七個領域:網路行動、影響力操作、監控、詐騙與詐欺、生物濫用、常規武器開發、蒸餾。每個案子都有編號,格式是 GTG-xxxxx,也門那個製導武器小組是 GTG-87001。
蒸餾那一節點名了中國五家實驗室:
實驗室 報告裡寫的規模 阿里 1.51 億次對話,五月到七月,高峰一天接近 300 萬次,動用超過 3500 個帳號 月之暗面 2300 萬次,把用戶問 Kimi 的問題轉給 Claude,再把答案當自己的回 DeepSeek 14 天 1210 萬次 智譜 17 天超過 340 萬次 小米 超過 40 萬次請求,經過 1500 多個帳號 報告也提到,月之暗面跟 DeepSeek 轉出去的是自家用戶的請求,所以 Anthropic 說它看到了別人的敏感資料流過去,那些人根本不知道自己問的東西被送到了 Claude。
這份報告裡真正讓人後背發涼的,根本不是蒸餾,而是 Anthropic 的還原精準度。
它能還原到什麼程度?誰、在什麼時間、用了哪些帳號、做了什麼?
更誇張的是,它竟然還還原出了一個團隊的內部分工。也門那個案例裡面,誰寫代碼、誰查資料、誰做 code review,都給你擺出來了。監控行動那部分就更細了:目標的位置、人口特徵、政治傾向,它帶著置信度都一起給你了。這就不是被收集數據的問題了,而是徹底被人扒了底褲。
我知道有人會說,互聯網時代早就沒有隱私了,你有什麼好大驚小怪的。錯,這根本不是一個性質。
第一,互聯網頭部大廠非常重視隱私。2016 年,美國政府要求蘋果解鎖一部手機,蘋果直接拒絕,寧可和政府對簿公堂。臉書呢,因為劍橋分析這件事呢,被罰了 50 億美元啊,股價暴跌,這些都是真金白銀的代價。
第二,普通互聯網公司能拿到的隱私其實很有限,最多就是你在 APP 裡面註冊信息,再加上你使用 APP 的行為數據。而這一份 Anthropic 的報告就好像一個千里眼順風耳,它能夠把你做過的事情一點一滴、完完全全還原出來,纖毫畢露。
所以我猜,它靠的不只是雲端的 Claude 模型,更關鍵的是運行在本地的那支軟件 Claude Code。因為在雲端運行的 Claude 模型,它只能拿到你問了什麼、它答了什麼,就是對話記錄,只有這些。但 Claude Code 完全是另外一回事了,它是裝在你電腦上了,在本地運行的軟件,權限極高。
今年 Claude Code 原始碼洩露了三次。社區把 50 多萬行代碼扒開,發現了這個軟件採集了你的設備 ID、帳號 ID、組織 ID、訂閱檔位、你的操作系統內核版本、終端類型、你裝了哪些包管理器、你進程的 CPU 佔用和內存的分配,甚至你在哪個代碼倉庫上幹活,倉庫的遠程的地址會被哈希之後一起上報。
而上報的頻率也非常嚇人,每 10 秒鐘上傳一次,每批最多 200 條。如果上傳失敗,先存到本地,再反覆重試。更要命的是,這套自動上報機制,你關不掉它。
所以它能夠精準地知道你在幾點工作、用什麼機器、在哪個項目上、每天問了多少次、問的究竟是什麼。
Anthropic 一直是一家最強調安全的公司。但一家公司打著安全的旗號,瘋狂地採集用戶的個人信息,還把用戶根本關不掉的設備數據傳上來做深度分析,這不就是赤裸裸的作惡嗎?
所以我決定未來不再用 Claude 模型了,Claude Code 軟件我也卸載了。我將只考慮使用開源的 Agent 軟件,確保我的電腦數據不會被上傳。此外,涉及到特別核心的個人隱私和核心的金融帳戶,絕對不會接入雲端的 AI 模型。
-
把自動滲透引擎裝進 dsh:一行安裝、agent 自己掃站,88 分鐘 48 URL 挖出 108 個 finding@johnnybegood 沒試過,最近也極少維護
-
GPT-6 Astra 用量消耗異常@imbiplaza-ASUS 666現在gpt額度都少得可憐了
我打算要全部轉到deepseek了 -
GPT-6 Astra 用量消耗異常@imbiplaza-ASUS 現在感覺用GPT 5.6sol 才不會消耗那麼快,而且體感5.6 sol還比Astra便宜。
-
GPT-6 Astra 用量消耗異常 -
GPT Pro 5x 實測:用 GPT 6 重做一套管理系統,單一任務燒掉約 20% 週額度GPT Pro 5x 實測:用 GPT 6 重做一套管理系統,單一任務燒掉約 20% 週額度
前幾天剛訂閱 GPT Pro 5x,今天正好遇到一個規模夠大的任務,於是乾脆拿來進行一次完整實測。
但在開始之前,我還有一個問題:Codex 執行大型任務時,到底會消耗多少 Token?
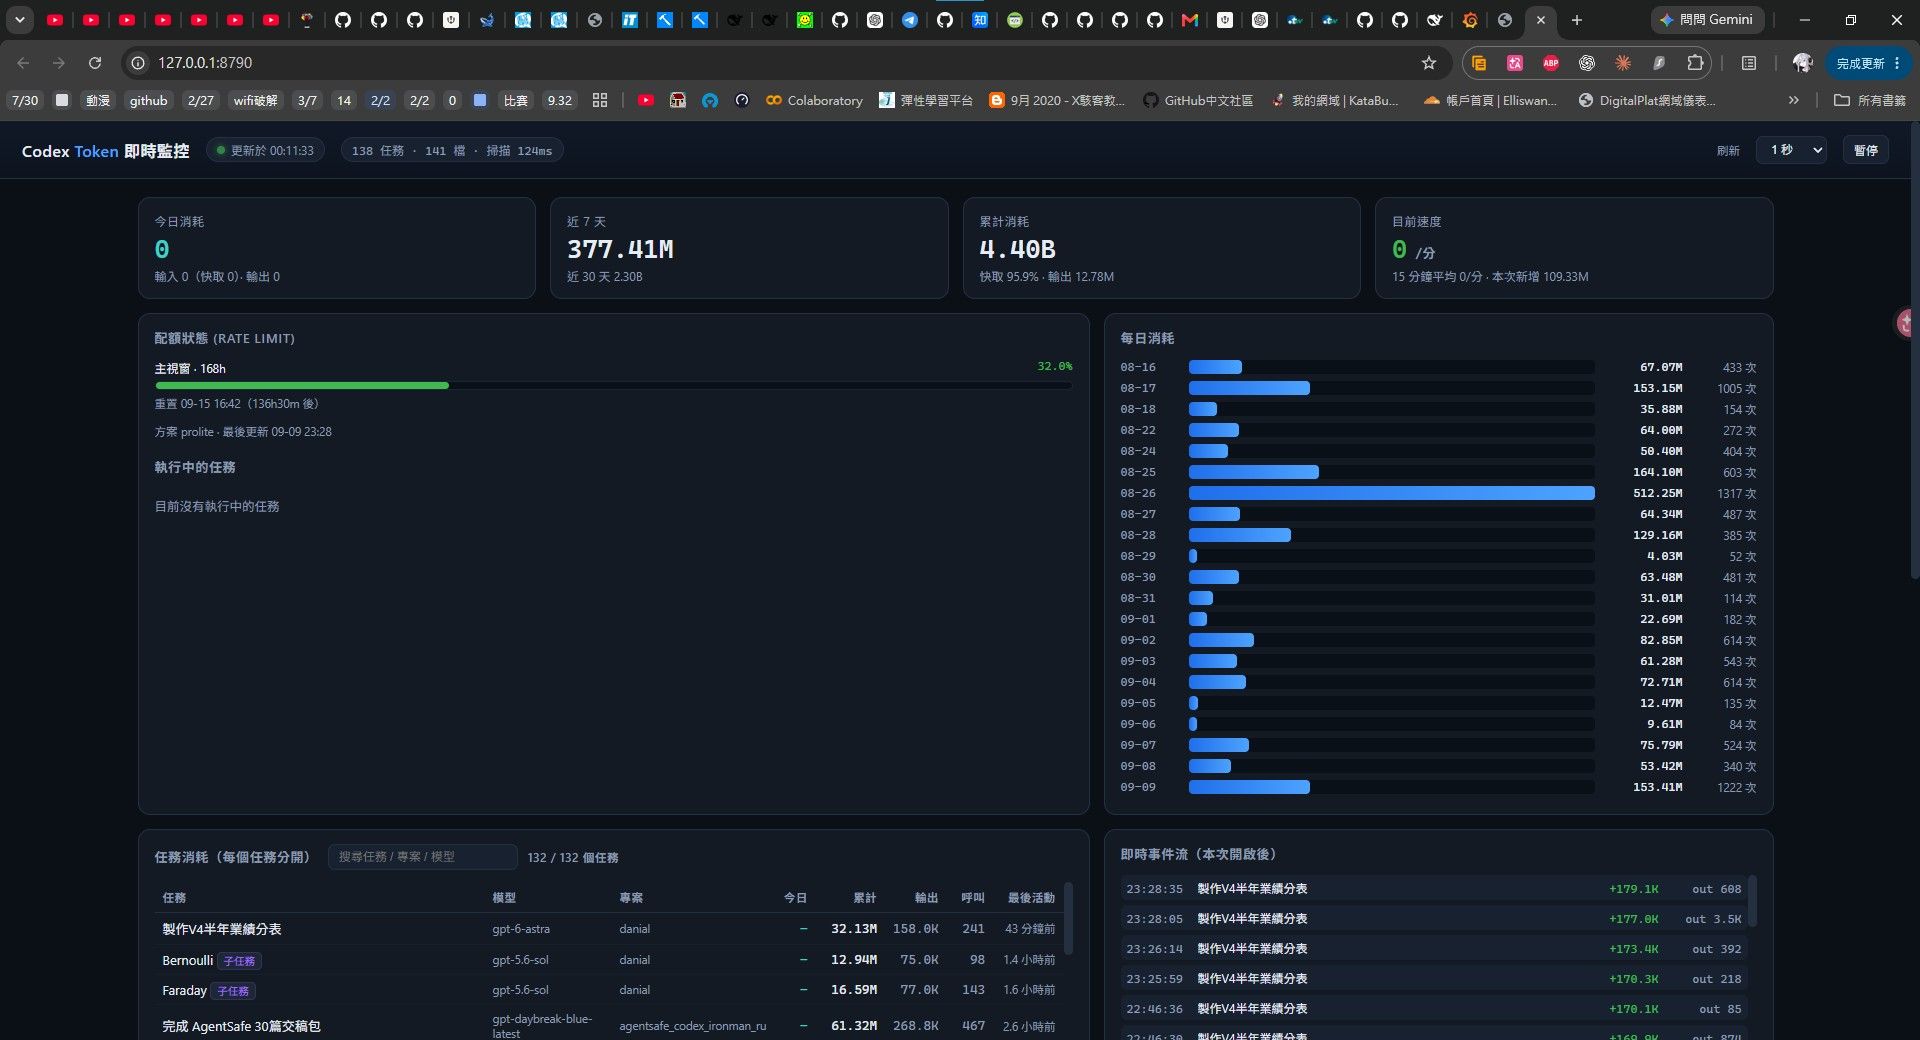
為了把用量看清楚,我直接請 DeepSeek V4.1 Flash 幫我製作了一套「Codex Token 即時監控」工具。它可以查看每個任務使用的模型、累計 Token、輸出量、呼叫次數、每日消耗,以及目前的週額度使用狀況。
這次拿來測試的是什麼專案?
這次不是讓 GPT 6 寫一個簡單的小工具(看網路上都是在寫一些毫無卵用的測是),而是拿我之前做爛的一套付費case。
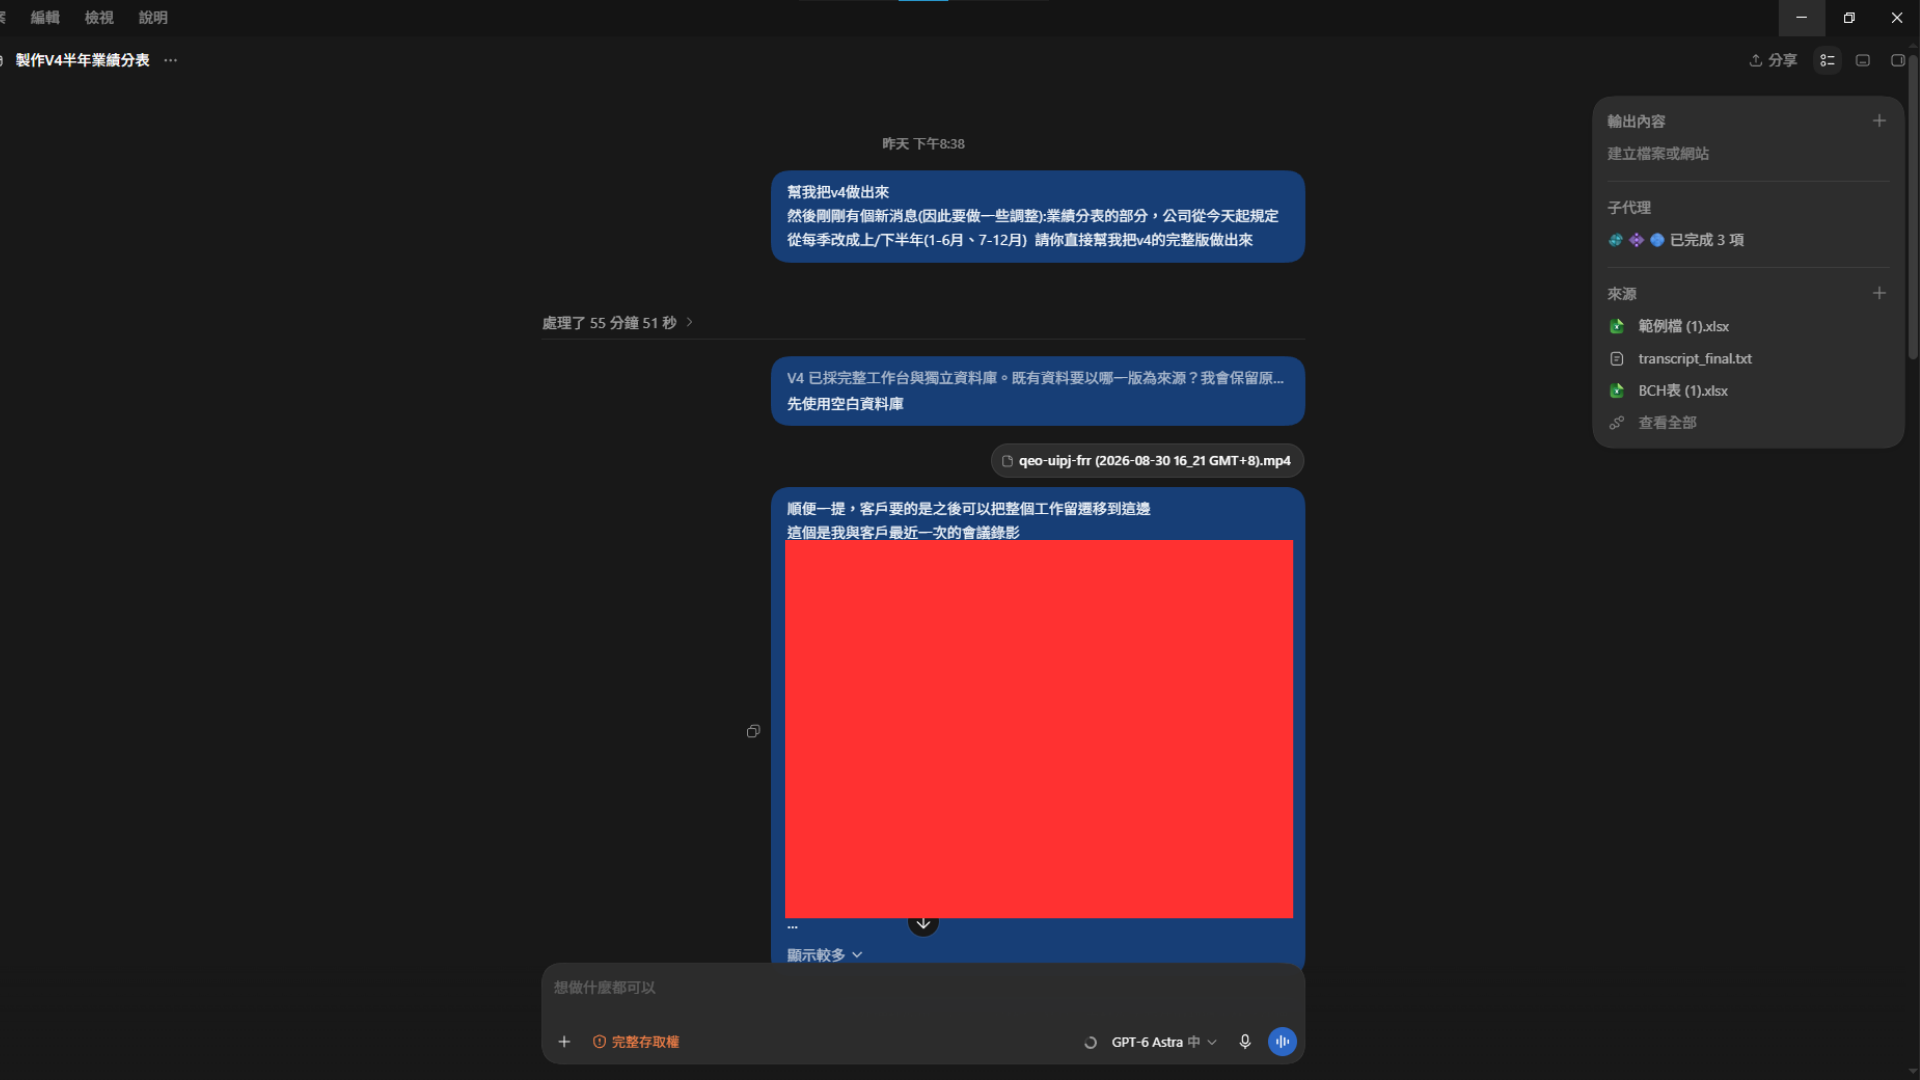
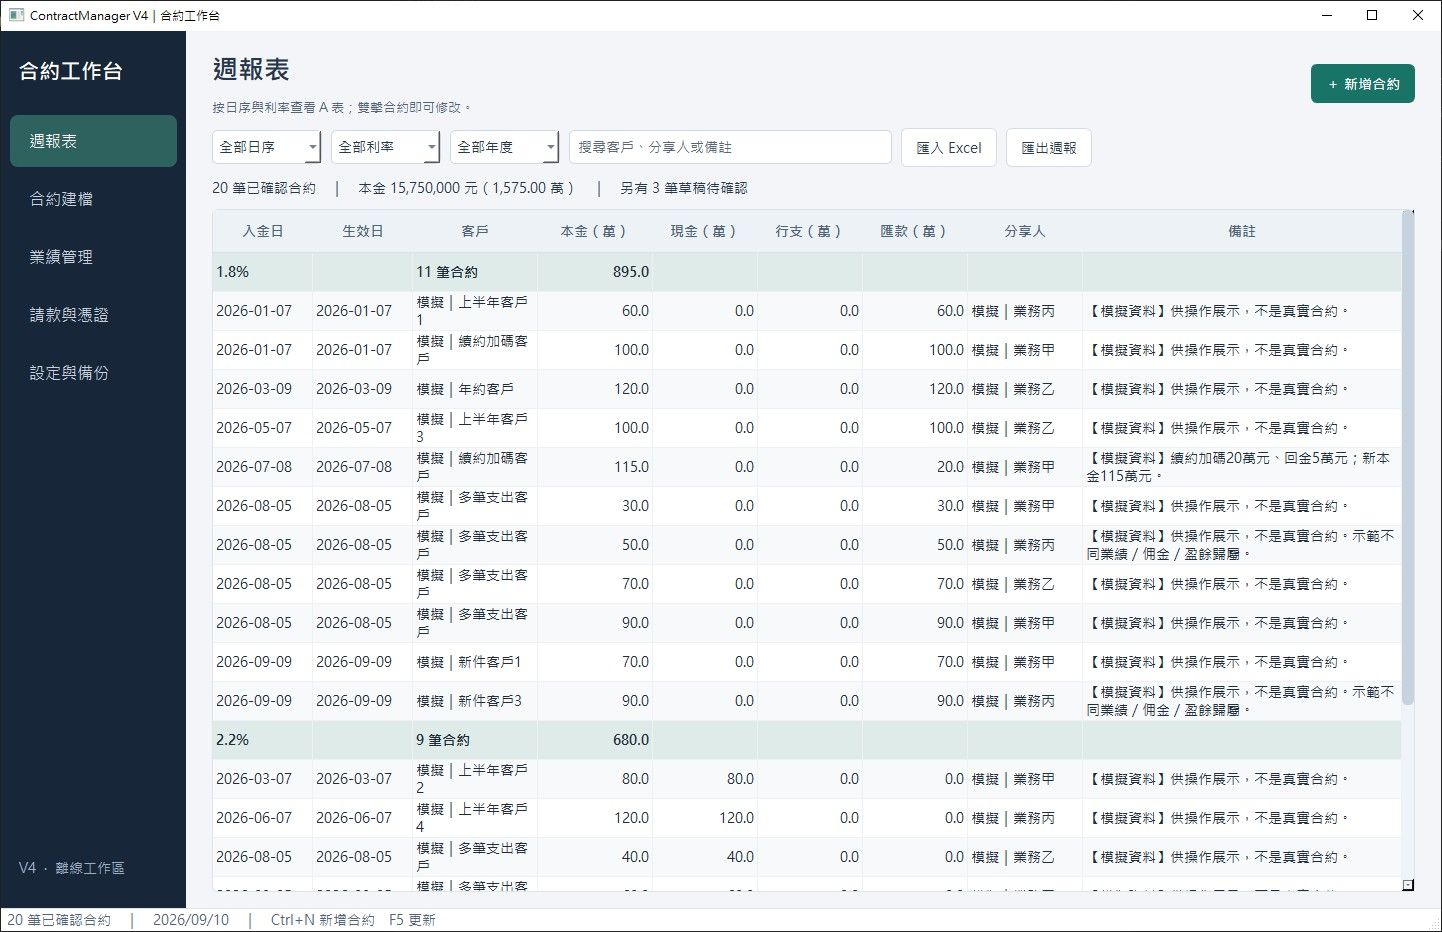
這個專案需要根據既有的 Excel 資料、訪談逐字稿和舊版表格,重新整理合約管理流程。我把舊版資料、Excel、逐字稿和需求一次交給 GPT 6,請它不要繼續修補原本做壞的版本,而是直接重新製作一套完整的 V4。
從舊版資料到可以實際使用,只修改了兩、三次
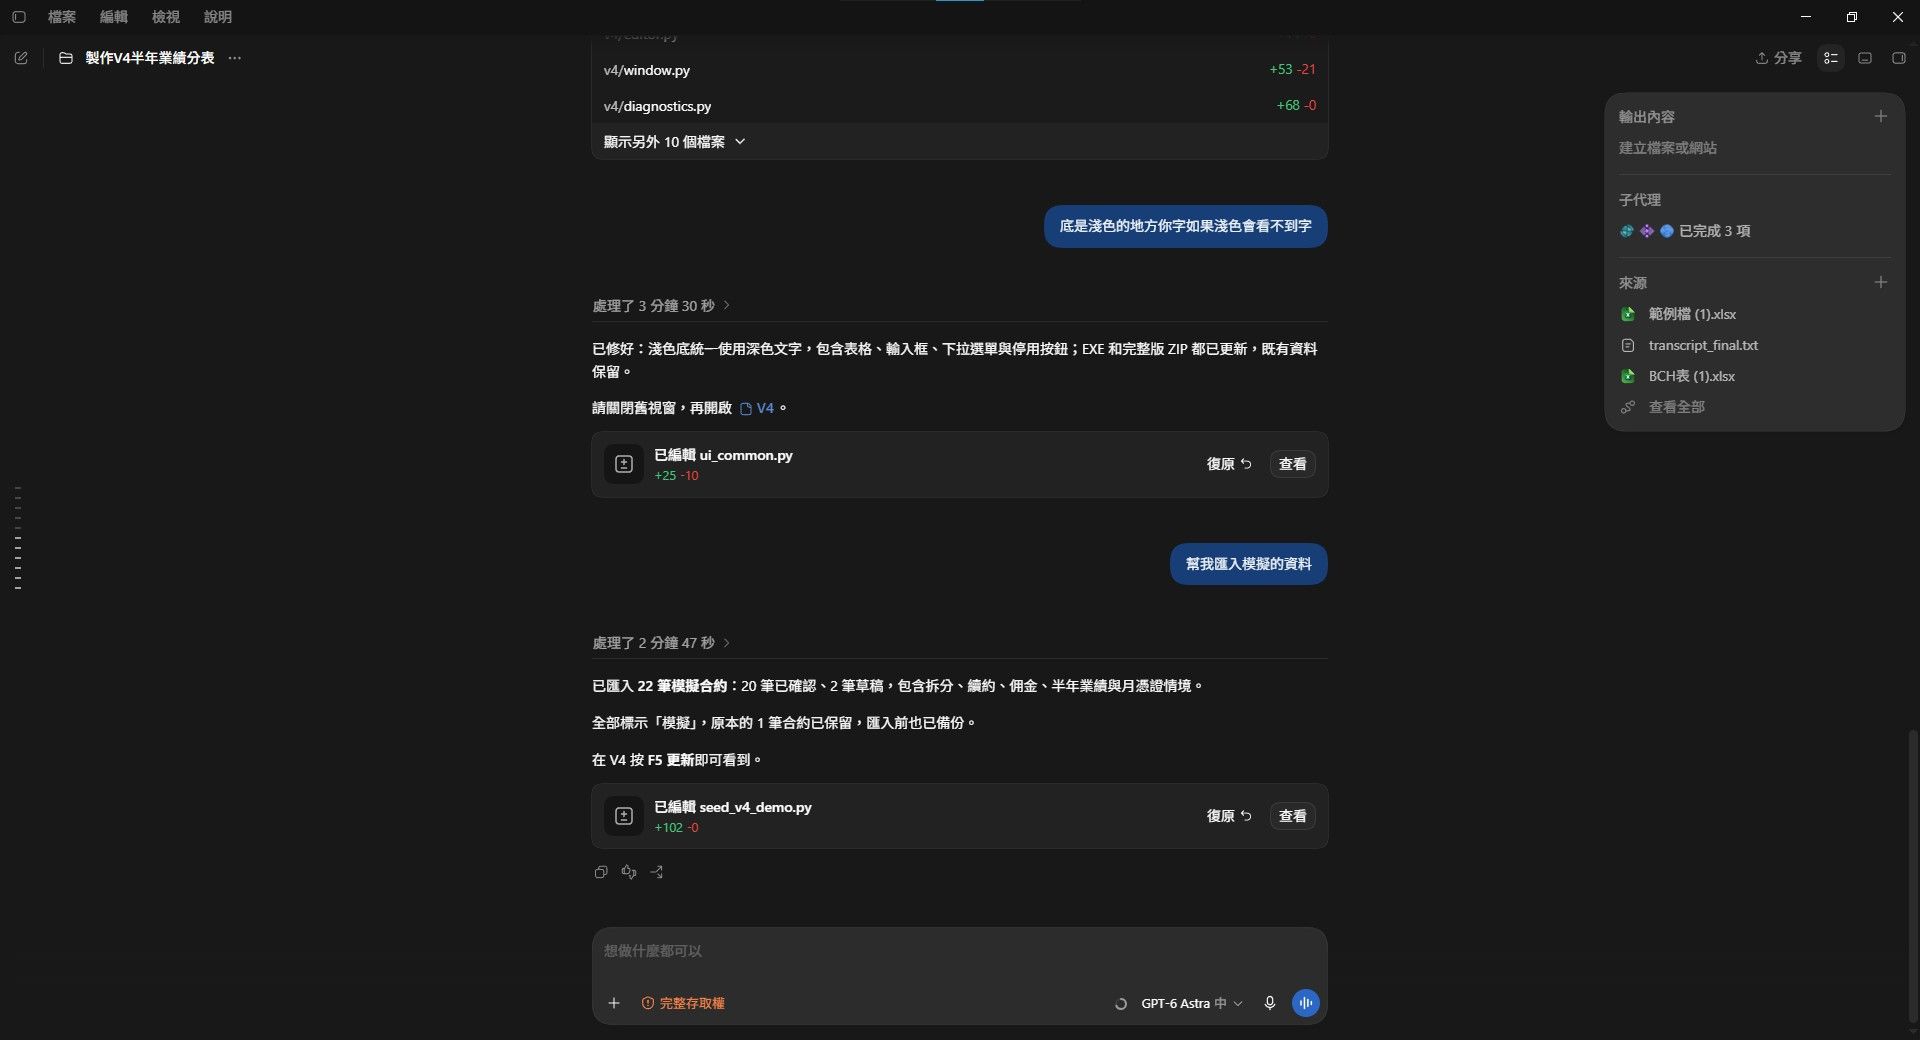
GPT 6 做出的第一版就已經完成了大部分核心功能。後續我主要只調整了一些介面和測試資料,整個專案大約修改兩、三次,就進入了可以實際使用的狀態。
完成速度很快,Token 消耗也非常驚人
這次任務的主要代理使用 GPT-6 Astra,子代理則限制只能使用 GPT-5.6 Sol。
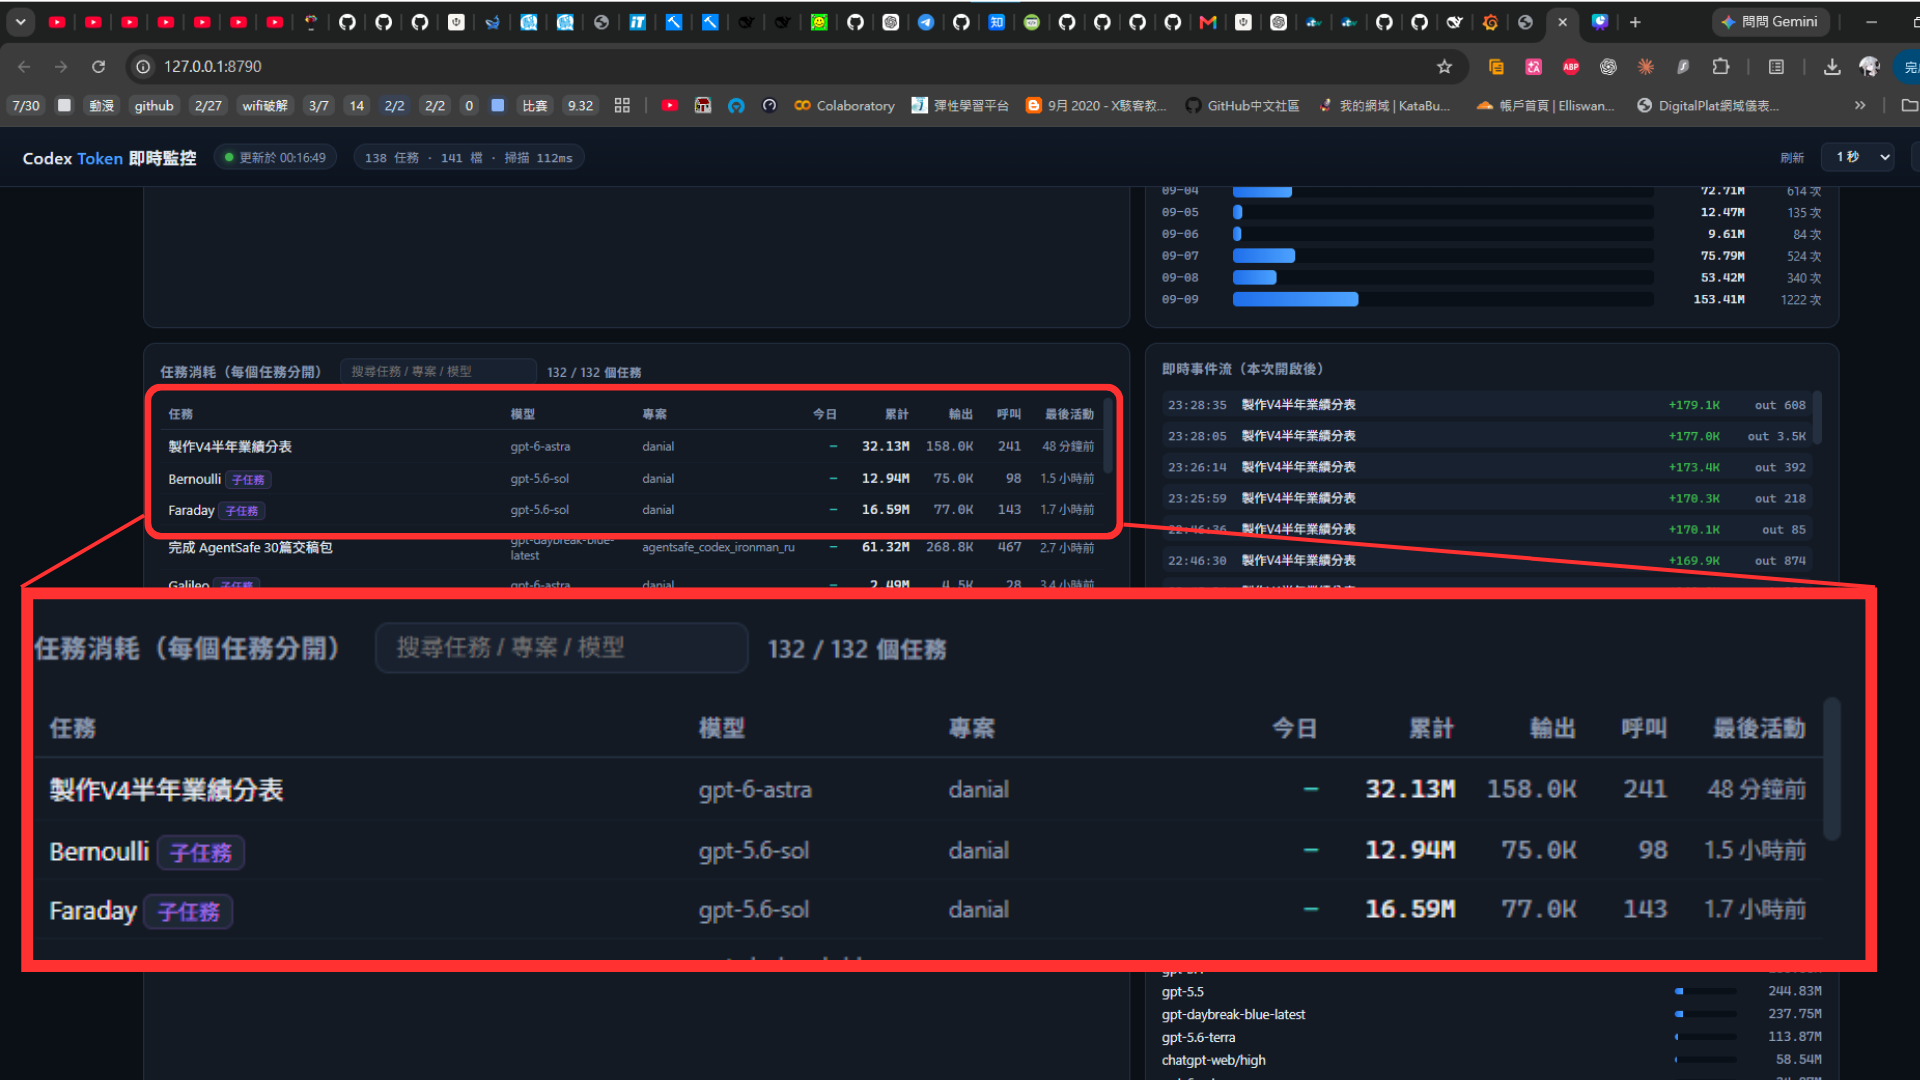
從監控畫面可以看到:- 主任務「製作 V4 半年業績分表」累計約 32.13M Token、158K 輸出,呼叫 241 次
- 子代理 Bernoulli 累計約 12.94M Token、75K 輸出,呼叫 98 次
- 子代理 Faraday 累計約 16.59M Token、77K 輸出,呼叫 143 次
三個任務合計,監控器記錄到的累計量約為 61.66M Token、310K 輸出,以及 482 次呼叫。
依照任務執行前後的額度變化估算,光是完成這一個專案,大約就消耗了 GPT Pro 5x 週額度的 20%。
GPT 6 的確可以在很少的人工來回之下,快速完成一個規模不小的專案;但如果主代理和多個子代理一起長時間執行,額度消耗速度同樣非常驚人。
但是,GPT Pro 5x 一個月只需要大約新台幣 3,300 元。依照這次主代理與子代理實際使用的模型分配,如果全部改用 API,並按照未命中快取的標準牌價粗略換算,成本大約會是 US$450,折合新台幣約 14,200 元,相當於 4.3 個月的 Pro 5x 訂閱費。如果把全部 Token 都按照 GPT-6 Astra 的價格計算,甚至會接近新台幣 2 萬元。當然,訂閱方案額度和 API Token 並不是完全相同的計價系統,實際 API 費用也會受到快取命中率影響;但光從公開牌價換算,這一次任務使用掉的運算量,確實已經超過訂閱費好幾倍。
這次實測的感想
只能說,不愧是 GPT 6。
能力是真的強,Token 也是真的燒得快。說不定之後上20x說不定就不會有這種問題了。
-
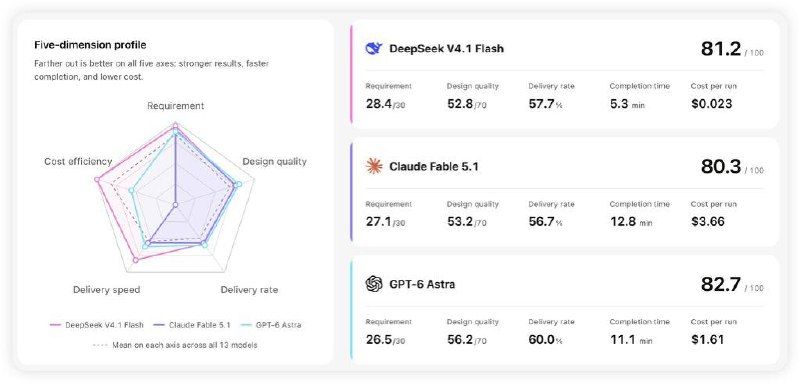
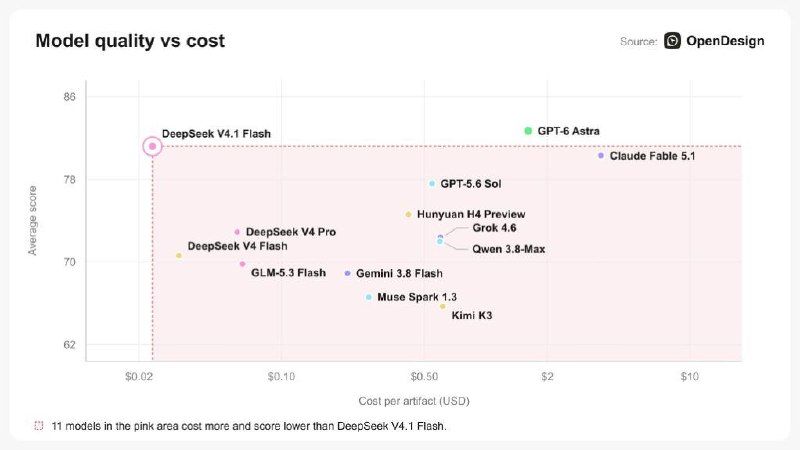
OpenDesign 13 模型實測:DeepSeek V4.1 Flash 81.2 分貼近 GPT-6 Astra,單次成本 $0.023 便宜 70 倍最近 OpenDesign 這個設計 agent benchmark 出了一批新數據,13 個模型全部用 API 跑同一批任務,從 web app、mobile、desktop、dashboard 到 landing page 五種場景。結論很直接:DeepSeek V4.1 Flash 綜合 81.2 分,貼近 GPT-6 Astra 的 82.7,贏過 Claude Fable 5.1 的 80.3,但單次成本只要 $0.023。品質差不到 2 分,成本差兩個數量級。
五維分數(越高越好)
模型 綜合 /100 需求理解 /30 設計品質 /70 交付率 完成時間 單次成本 DeepSeek V4.1 Flash 81.2 28.4 52.8 57.7% 5.3 分 $0.023 GPT-6 Astra 82.7 26.5 56.2 60.0% 11.1 分 $1.61 Claude Fable 5.1 80.3 27.1 53.2 56.7% 12.8 分 $3.66 三個看點。需求理解 V4.1 Flash 反而是最高的 28.4/30,GPT-6 Astra 只有 26.5,prompt 吃得最準。設計品質小輸 GPT-6 Astra 3.4 分,但贏 Claude。完成時間 5.3 分,比兩個貴族快一倍以上。
成本直接換算:V4.1 Flash $0.023,GPT-6 Astra $1.61(貴 70 倍),Claude Fable 5.1 $3.66(貴 159 倍)。
完成時間排行(13 個模型)
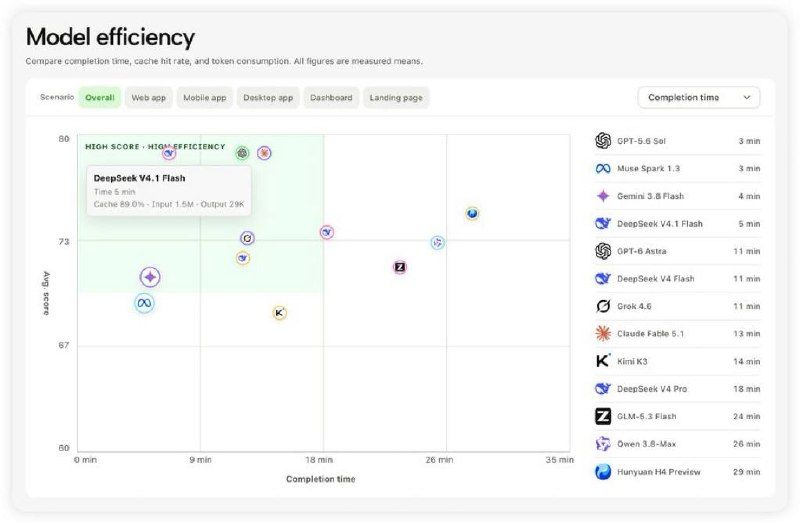
最快那批:GPT-5.6 Sol 3 分、Muse Spark 1.3 3 分、Gemini 3.8 Flash 4 分、DeepSeek V4.1 Flash 5 分。
之後直接斷層:GPT-6 Astra 11 分、DeepSeek V4 Flash 11 分、Grok 4.6 11 分、Claude Fable 5.1 13 分、Kimi K3 14 分、DeepSeek V4 Pro 18 分、GLM-5.3 Flash 24 分、Owen 3.8-Max 26 分、Hunyuan H4 Preview 29 分。
V4.1 Flash 比自家 V4 Flash 快一倍、比 V4 Pro 快三倍多。
每個場景都一樣
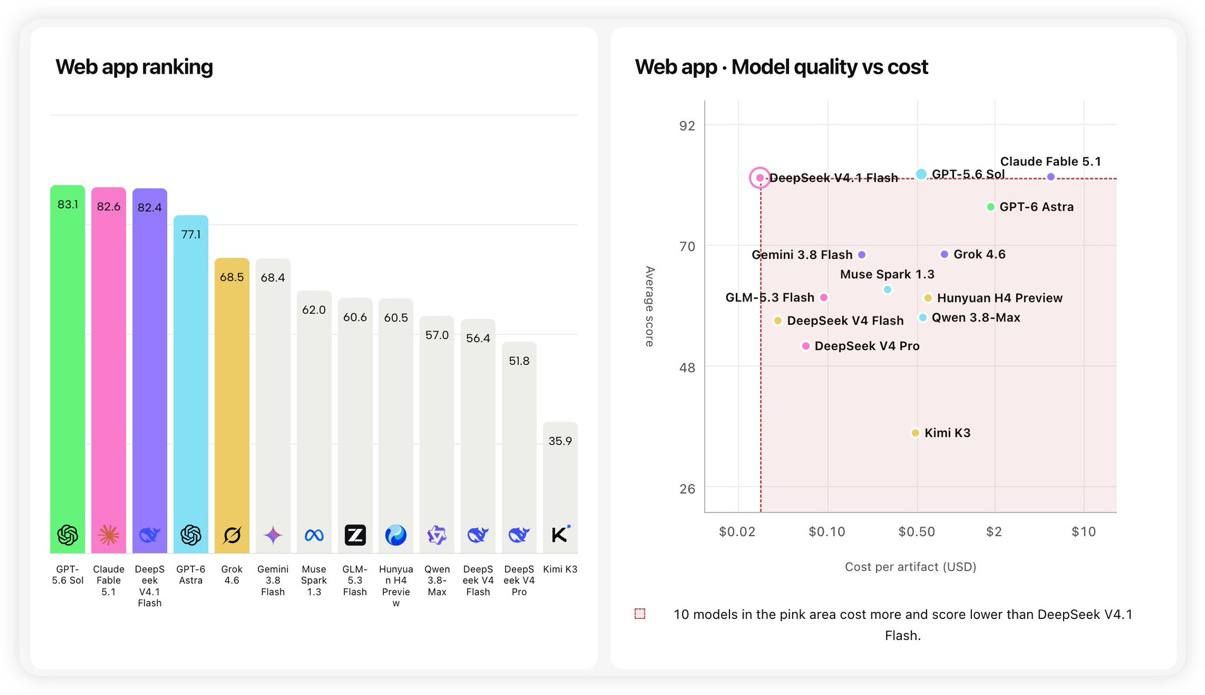
粉紅色區 = 更貴又更低分。整體 11 個模型在裡面,web app 10 個、mobile 8 個、desktop 9 個、landing 9 個。
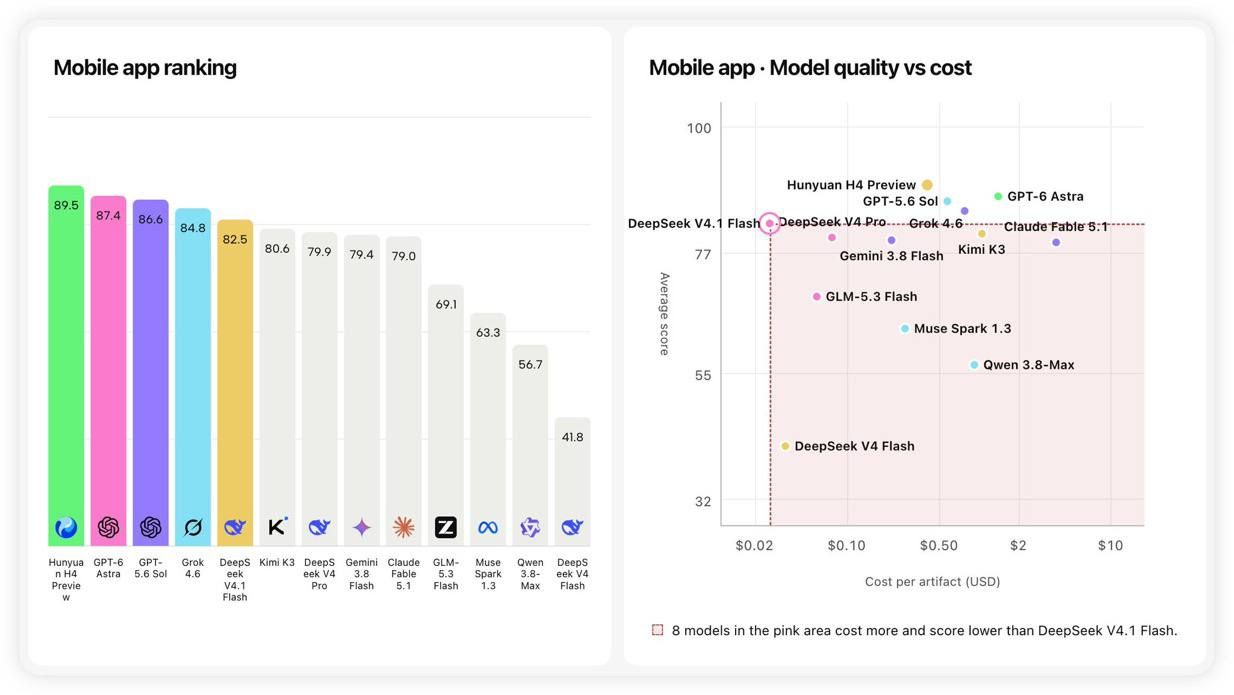
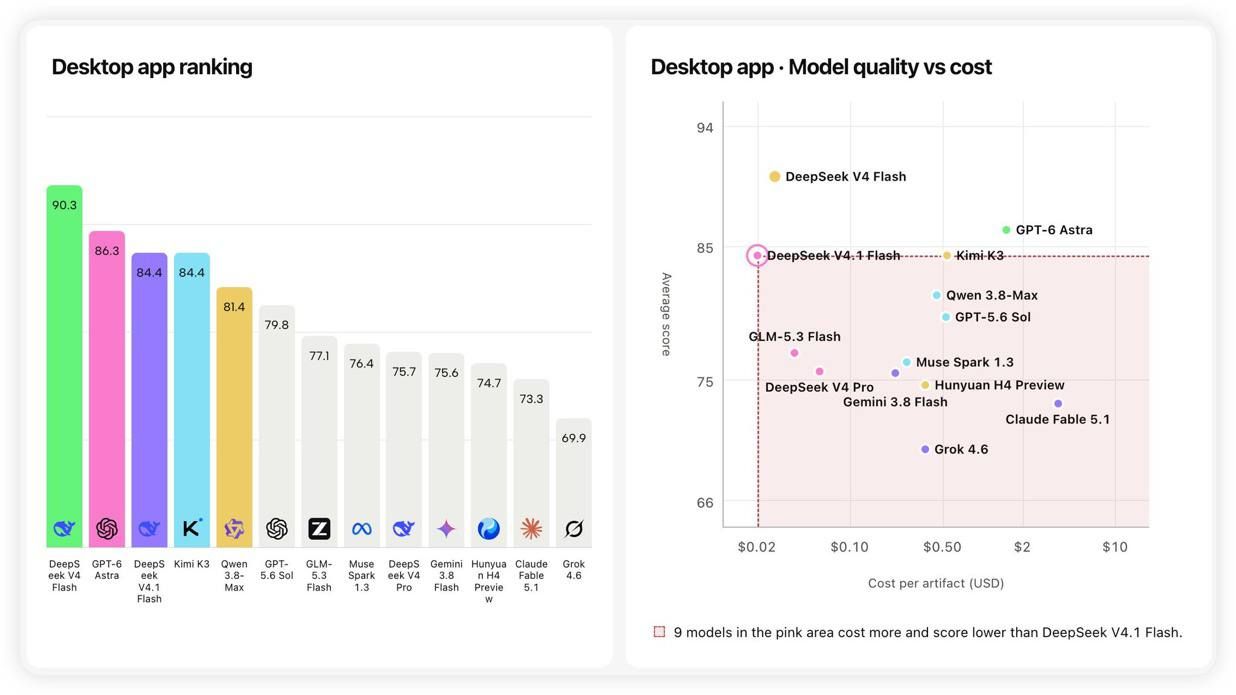
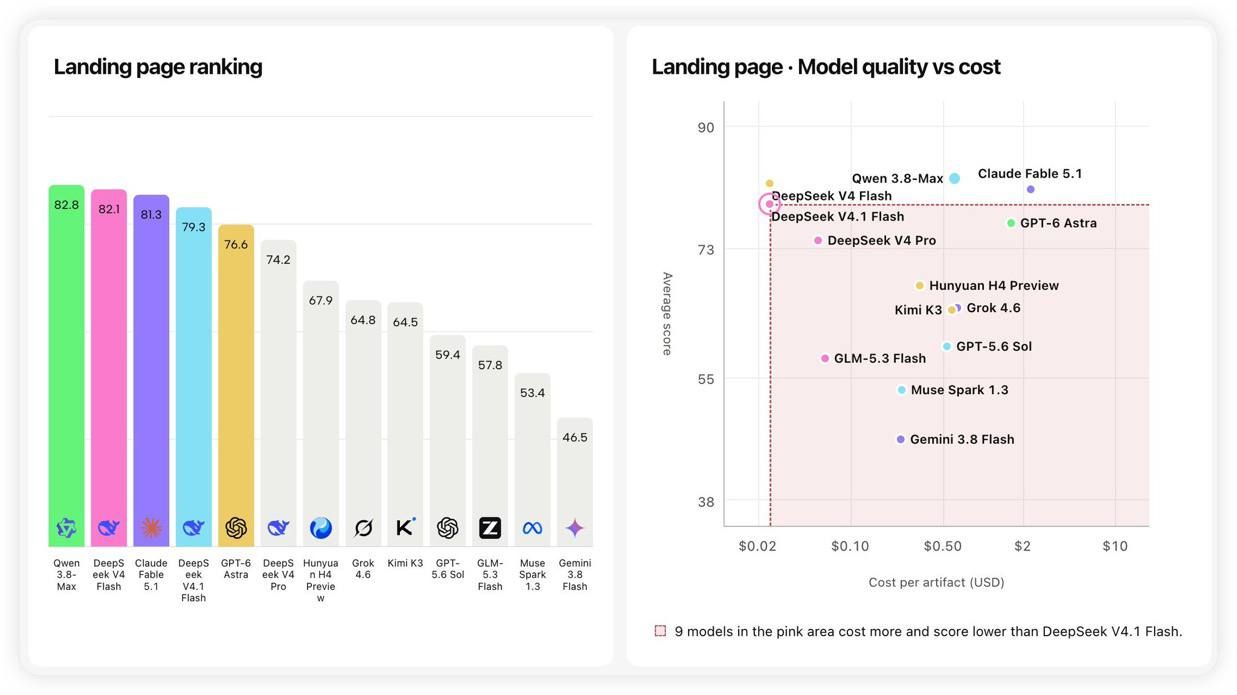
結論
跑設計或前端這類 agent 任務,V4.1 Flash 現在就是甜蜜點:品質貼著頂尖、成本是零頭、速度還快。以前要在便宜跟品質之間二選一,現在不用了,直接切過去。
-
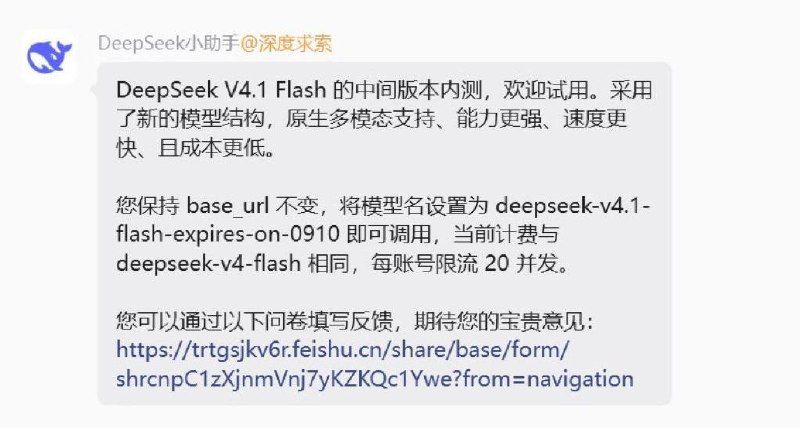
就在剛剛,deepseek-v4.1-flash-expires-on-0910 開始內測! -
就在剛剛,deepseek-v4.1-flash-expires-on-0910 開始內測!就在剛剛deepseek-v4.1-flash-expires-on-0910開始內測了
親自實測:首 token 平均約 1.1 秒,生成速度最高可達 329 tok/s
我直接把一個做到一半的專案交給它,讓它接續開發。
首 token 平均約 1.1 秒,token 生成速度最高可達 329 tok/s,整體回應速度非常迅速。
它很快就找出了專案目前的不足,並提出具體的修正方案。我確認方案後只回覆「好」,它便立即開始執行。
目前任務尚未完成,後續有新進度會再更新。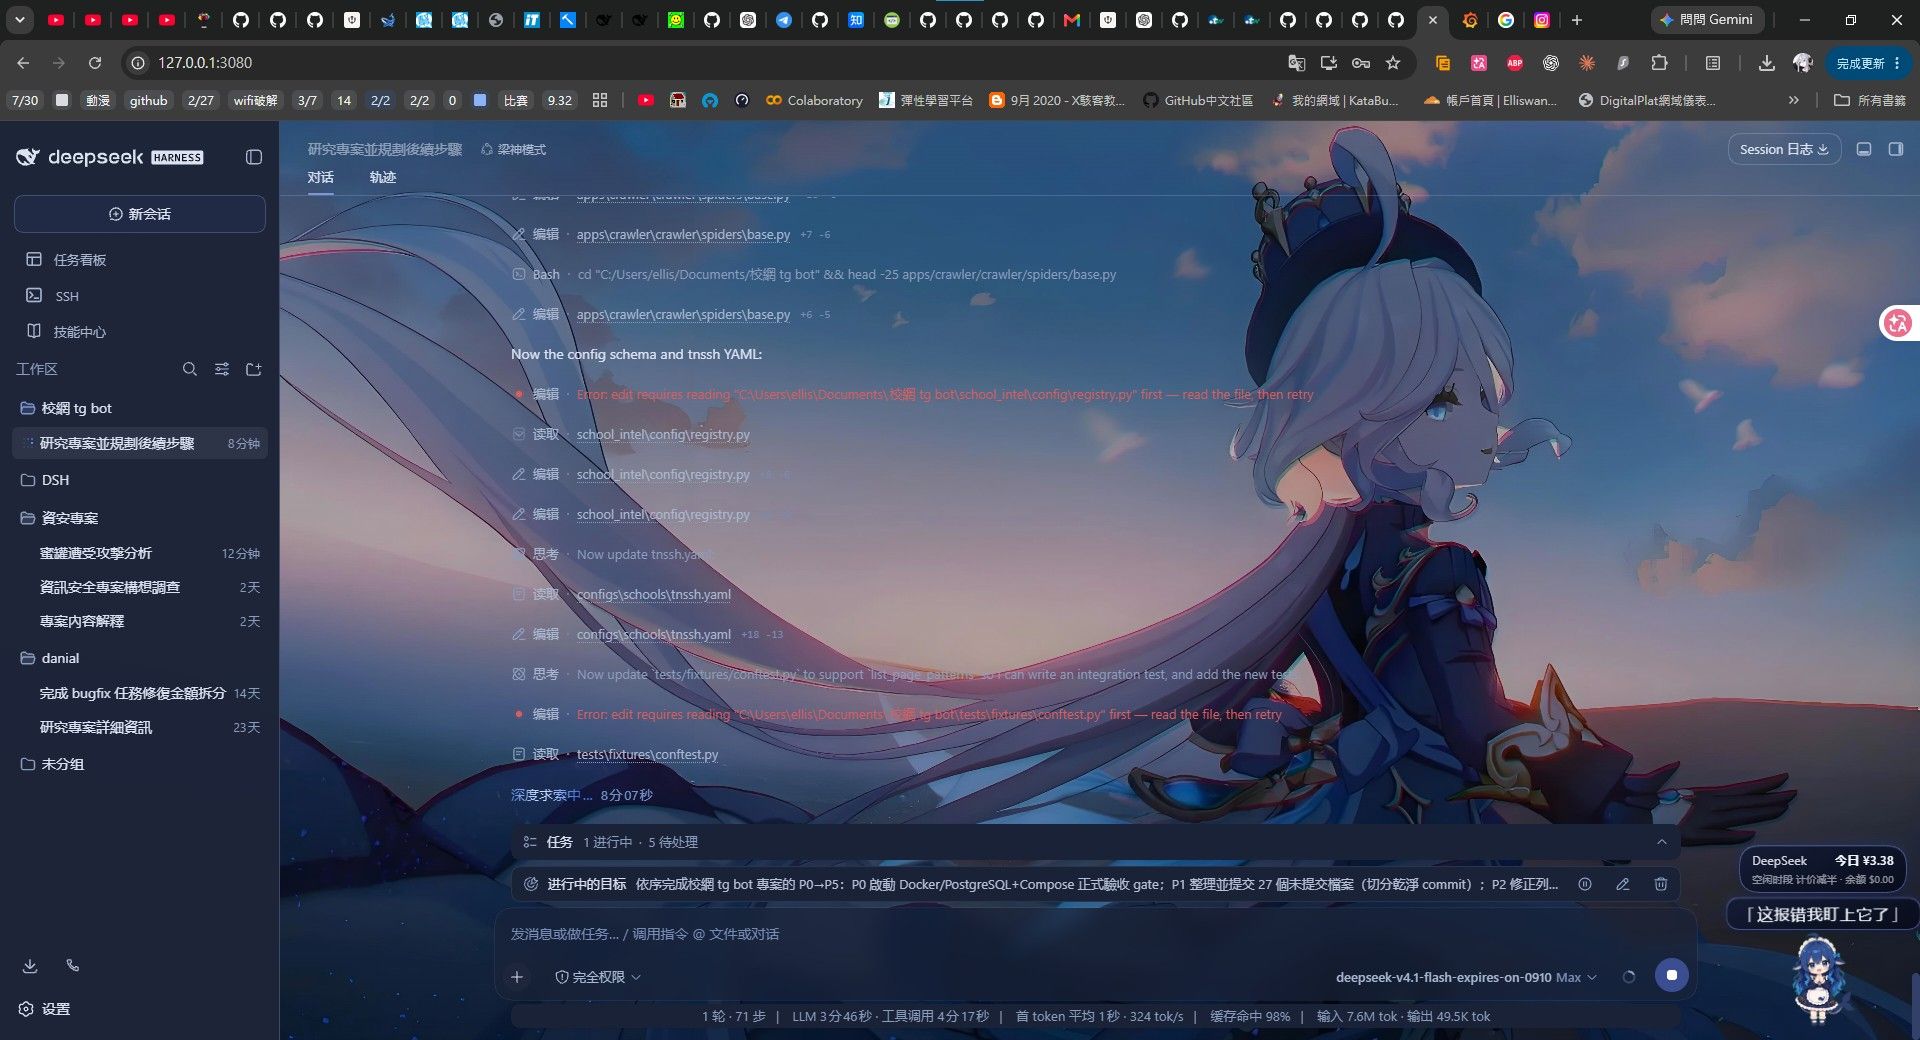
deepseek-v4.1-flash-expires-on-0910

deepseek-v4-flash-vision-exp
