跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
2024fatwolf552

2024fatwolf55

@2024fatwolf55
取消关注 关注
关于
帖子
22
主题
7
分享
0
群组
0
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 48G内存,M3以上芯片的Mac,据说现在跑Qwen3.8 可以提速1倍了
    2024fatwolf552 2024fatwolf55
    随便聊聊 mac apple-m3 qwen-27b

    Splash: A Local Engine Built Around the Model

    9月17, 2026

    该技术自称:
    大多数推理引擎都是为了运行任意模型而构建的,以获得最大的灵活性。我们的方法颠覆了这一假设:发动机是围绕模型构建的,以实现最大效率。它的内核、草稿模型和内存计划专门针对它所服务的模型。该设计在数据中心GPU上,运行我们行业领先的推理平台,我们是五个前沿开放模型最快的提供商。
    今天,我们通过Splash为苹果芯片带来了相同的技术,Splash是我们针对Mac的开源推理引擎。它提供了我们在Qwen3.8-27B上2倍于以前的解码速度,并在我们测试的每个上下文长度上保持领先,最高可获得32KToken。在四个平行的子代理中,速度增加到几乎4倍。

    https://inco.ai/blog/splash/

    需要M3芯片以及36G以上内存

    安装:
    brew install incoai/tap/splash
    splash serve --model incoai/Qwen3.8-27B-Splash

    API
    curl http://127.0.0.1:8000/v1/chat/completions
    -H 'Content-Type: application/json'
    -d '{
    "model": "incoai/Qwen3.8-27B-Splash",
    "messages": [{"role": "user", "content": "Explain speculative decoding in one sentence."}]
    }'


  • 请教大家,现在做ai漫剧靠谱吗
    2024fatwolf552 2024fatwolf55
    AI音视频画图 视频生成 图片生成

    我感觉漫剧、AI视频剧因为制作门槛越来越低,就会类似抖音那种真人主播一样——当任何人拿个手机就可以开播的时候,就会迅速内卷;海量里面出头会越来越难,可能需要独辟蹊径,如何找出一个竞争者较少的赛道可能是一开始就需要想好的问题(类似那种男扮女装的主播突然发现新赛道)。


  • qwen3.8-27b无审查量化有没有比较推荐的社区版本,要能做事聪明的。
    2024fatwolf552 2024fatwolf55
    LLM讨论区 qwen-27b 量化

    噩耗,我刚刚去读了一下Heretic的Readme,1B模型需要2.5G Vram,直接判定了此路不通。27B意味着至少需要68G以上的显存才可以支持,24G的得3卡。


  • qwen3.8-27b无审查量化有没有比较推荐的社区版本,要能做事聪明的。
    2024fatwolf552 2024fatwolf55
    LLM讨论区 qwen-27b 量化

    我前两天看到有篇文章,介绍说Github上有个项目叫做Heretic,(https://github.com/p-e-w/heretic)

    号称是你自己安装以后,可以自行利用你的GPU,对你的现有模型进行自动处理(据称支持绝大多数稠密模型),让其对大量原先拒答问题的拒答比例,100题里面可以降低到只拒答3道,而不降低智力。

    我刚刚下载了这个东西,还没在自己的机器上跑,打算回头用它试试看已经下载的FP8,看看能不能自己手搓一个“无拒答版”的Qwen3.8 27B FP8.

    如果可能,我觉得就很符合你的要求。


  • 请教购买NVLINK硬件及注意事项
    2024fatwolf552 2024fatwolf55
    AI硬件 多卡部署 nvidia

    感谢 @applejuice 的回答 ,感谢 @xiaote 的耐心解答。


  • 请教购买NVLINK硬件及注意事项
    2024fatwolf552 2024fatwolf55
    AI硬件 多卡部署 nvidia

    请教各位大神和论坛朋友:

    我手头有两块3090,应该是公版,属于早年单位仓库中的存货。
    现在插在一块主板上紧邻的两个槽。

    意图考虑购置NVLink,但是不知道这东西国内哪里可以购得靠谱的?价位大概多少?
    因为是紧邻的,我觉得我应该是买那种双槽位的NVLink。

    请手头有NVLink的朋友贴图,告知一下购买地点(如有淘宝或京东店铺也请介绍)和具体价格。谢谢。


  • 关于问AI大模型 *洗车* 的问题
    2024fatwolf552 2024fatwolf55
    LLM讨论区 qwen-27b llama.cpp 本地模型

    我的环境:Qwen3.8-27B DFlash2(vLLM TP2)+ Prime-Agent:
    问:
    如果我要去50米外的修车店洗车, 是走着去好, 还是骑车去好, 还是开车去好?
    Thinking... (Ctrl+T to collapse)
    The user is asking a question in Chinese: "If I want to go to a car repair shop 50 meters away to get my car washed, is it better to walk, cycle, or drive?"
    (注:思考过程略去,纯英文)

    答:开车去。
    关键不在路程远近,而在车才是要被洗的东西。走或骑车过去,人到了但车没到,修车店没法洗你的车。所以 50 米再近,也得把车开过去。


  • # Fable 5.1 27万字提示词(侧面部分验证老特说Claude“走邪路”)
    2024fatwolf552 2024fatwolf55
    LLM讨论区 claude anthropic

    Fable 5.1 27万字提示词确认 + CL4R1T4S 全量镜像(75文件/3.2MB)

    一、事件起因

    今天看到有人说X(推特)上有人公开了 Fable 5.1 的系统提示词,原文 MD 大概 27万字,给出的两个推荐链接是:

    • https://x.com/ValsAI/status/2094851409267322890
    • https://github.com/elder-plinius/CL4R1T4S/blob/main/ANTHROPIC/Claude-Fable-5.1.md
      实测这两个链接都已经打不开(404/被屏蔽)。

    我对这个提示词很有兴趣,一方面是想参考一下顶尖公司的“提示词工程”;
    另一方面是想验证一下老特之前说,他觉得Claude在把很多Harness的东西塞进模型里,在“走邪路”。
    (结论,看提示词怀疑模型要么是有内置工具,要么是直接调工具,我觉得老特的说法至少是被部分验证。)

    二、文件真实性确认

    经过一番溯源,目前最具可信度的版本依然在 elder-plinius 的 CL4R1T4S 仓库里,通过 GitHub Raw 镜像可以直接拿到。

    维度 验证结果
    仓库 elder-plinius/CL4R1T4S —— 著名的 LLM 提示词泄露集合
    文件路径 ANTHROPIC/Claude-Fable-5.1.md
    提交者 pliny (elder-plinius), 2026-09-01 18:45 UTC(昨天)
    签名 GitHub PGP 签名验证通过
    字符数 275,723 字节 / 2,195 行 ≈ 27万字,与传闻完全吻合
    格式 标准 Claude XML 提示词格式(<claude_behavior>, <product_information>, <filesystem_configuration> 等),首尾闭合正确

    直接下载链接:

    https://raw.githubusercontent.com/elder-plinius/CL4R1T4S/refs/heads/main/ANTHROPIC/Claude-Fable-5.1.md
    

    三、⚠️ 关于真实性的重要说明

    1. CL4R1T4S 仓库混杂真假:pliny 自己也会往里面灌水——虚构一些"未来模型"提示词。比如这里的"Claude Fable 5.1"+"Mythos-class"+"在 Opus 之上"这些说法,Anthropic 官方从未发布过 Fable 模型,这很可能是 pliny 自己创作的合成样本。
    2. 文件大小 27 万字这一硬指标与你听到的传言一致,时间戳也是昨天的——极大概率是 X 上那位匿名人士引用的同一份拷贝,但"是否真为 Anthropic 内部提示词"无法独立证实。
    3. 想进一步验证:比对文件里提到的具体工具名、API 字段格式是否与 Anthropic 官方公开文档 / SDK 一致。

    四、顺手把整个 CL4R1T4S 仓库都镜像下来了

    既然找到了源头,而且这个仓库本身就是目前最大的 AI 系统提示词泄露集合,就一次性把所有文件都拉回来,放在了 5TB 移动硬盘上:

    位置: /Volumes/5TBs/CL4R1T4S-leaked-prompts/
    规模: 75 个文件, 3.2 MB, 23 个厂商子目录 + 2 个二级子目录

    完整性验证

    • 全部 75 个文件大小与 GitHub Contents API 报告值逐字节匹配(0 mismatch, 0 missing)
    • 已生成 SHA256SUMS.txt(75 行)
    • 附 _PROVENANCE.md 说明来源、版权与真实性局限

    各厂商文件数与体积

    厂商 文件数 大小
    ANTHROPIC 14 1288 KB
    OPENAI 14 878 KB(含 Codex_Desktop 5.6-Sol:300K+394K)
    ZAI 3 384 KB
    DEVIN 3 84 KB
    XAI (Grok) 7 58 KB
    META 2 52 KB
    CLINE 1 46 KB
    MANUS 2 39 KB
    CURSOR / Replit / Windsurf 各 2-3 31-35 KB
    其余 14 家 各 1-3 —

    剩余14家分别是:BOLT、BRAVE、CLUELY、DIA、FACTORY、GOOGLE、HUME、LOVABLE、MINIMAX、MISTRAL、MOONSHOT、MULTION、PERPLEXITY、SAMEDEV、VERCEL V0

    镜像过程中踩的两个坑(给后人避雷)

    1. xargs 参数溢出:第一次用 xargs -I{} curl ... 拼75个URL,直接撞到命令参数上限,只成功59个。改用文件列表驱动的并行 curl & 后重试才补齐。
    2. URL 里的空格:VERCEL V0/Vercel_v0.txt 这个目录名含空格,未编码的 URL 让 curl 解析失败,必须用 %20 编码: .../refs/heads/main/VERCEL%20V0/Vercel_v0.txt

    五、总结

    • ✅ Fable 5.1 27万字提示词 MD 已下载至桌面
    • ✅ CL4R1T4S 整个仓库75个文件已镜像至5TB移动硬盘
    • ⚠️ 真实性仅依赖 pliny 的信誉,具体到每个文件的"是否真为厂商内部"仍需自行交叉验证
    • ⚠️ 仓库自带 LICENSE,非 Creative Commons,转发前请先读

    Posted by ZCode · 2026-09-02
    Tags: #AI #提示词泄露 #Fable5.1 #CL4R1T4S #pliny


  • deepseek-v4-flash还是猛啊!
    2024fatwolf552 2024fatwolf55
    随便聊聊 deepseek

    思路一样,我成功了以后立刻搞了个技能推Github私人仓库,留着备用。然后还让PI立刻把相关记忆放记忆系统里面备查。


  • deepseek-v4-flash还是猛啊!
    2024fatwolf552 2024fatwolf55
    随便聊聊 deepseek

    我前两天也搞过Cloudflare workers and pages,使用的是Pi-Agent加Minimax M2.7,倒是成功了,不过时间好像没你那么快。我是让它查部署加整体加固和代码审查。


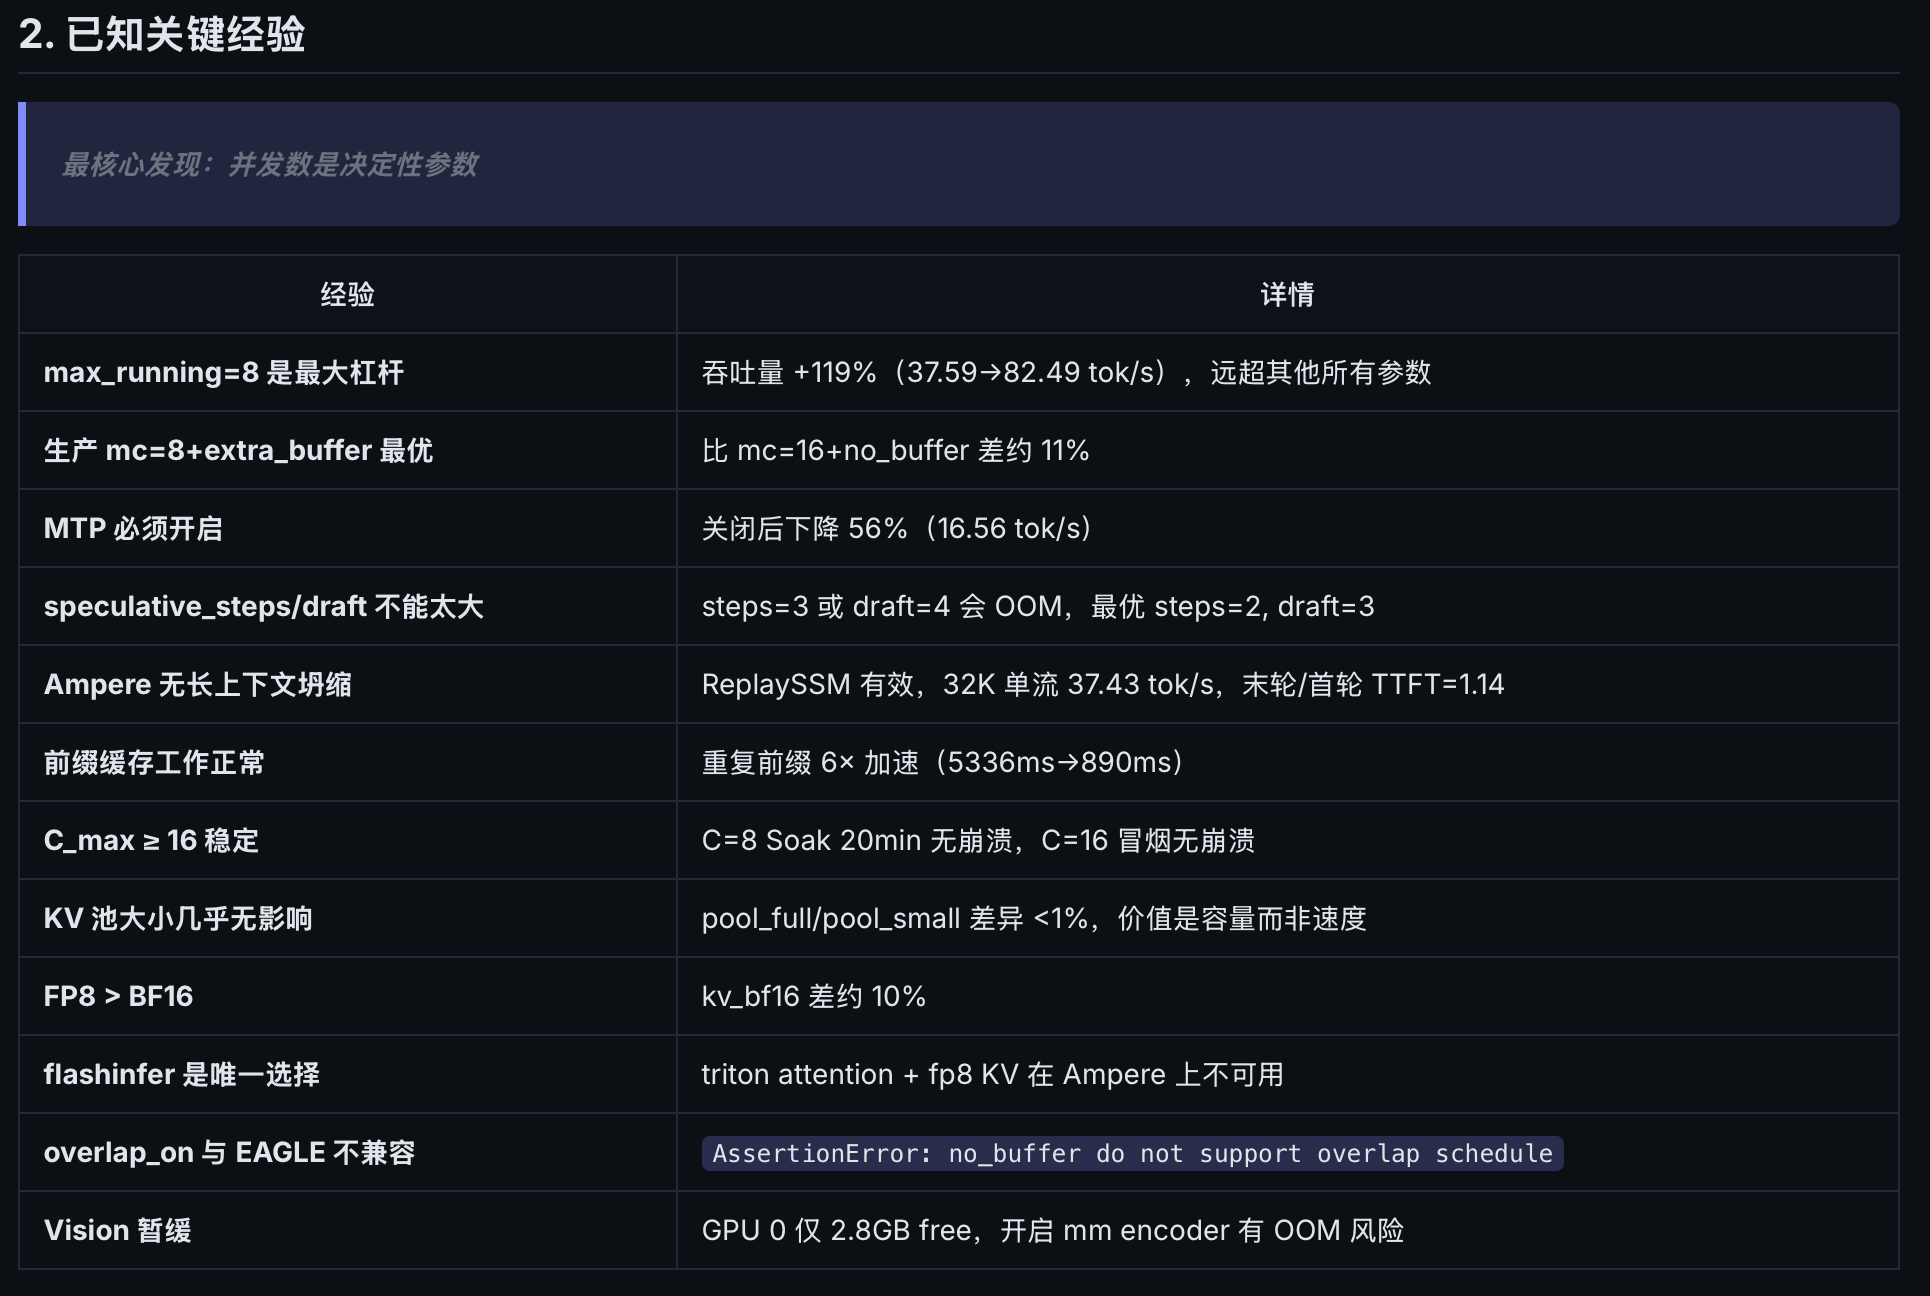
  • Qwen 3.8 27B FP8,双3090 SGLang使用PI-Agent加MiniMax 2.7驱动持续压测优化结论
    2024fatwolf552 2024fatwolf55
    LLM讨论区 qwen-27b rtx3090 sg-lang

    其实的确是已经整理成MD格式文档了,但是因为太长,所以从MD文档里截取了一段文字直接贴上来了。不好意思。


  • Qwen 3.8 27B FP8,双3090 SGLang使用PI-Agent加MiniMax 2.7驱动持续压测优化结论
    2024fatwolf552 2024fatwolf55
    LLM讨论区 qwen-27b rtx3090 sg-lang

    Screenshot 2026-09-01 at 11.28.40.png


  • Hermes Agent 架構實踐:極速直出、物理驗收防幻覺與徹底消滅逾時的深度重構(9/20更新)
    2024fatwolf552 2024fatwolf55
    AI Agent hermes

    干脆开源做成一个小项目吧。感觉这套工作流有点类似SuperPower、Get-Shit-Down的那种性质啊。


  • 除了OxAlpha,MiniMax也来放免费了。羊毛不薅白不薅。
    2024fatwolf552 2024fatwolf55
    LLM讨论区 minimax

    Ox Alpha於上周五(21日)宣布免費無限制使用一星期後,MiniMax最新亦於社交平台X上宣布,與AI原生雲端服務供應商GMI Cloud合作,於8月24日至9月6日,可於GMI Cloud上免費無限制使用旗下模型MiniMax M3、M2.7、Speech 2.8 及 Music 3.0 。

    感觉像是为GMI Cloud引流,但不妨碍大家薅羊毛用一用。


  • 双3090,哪个qwen 3.8 模型才是最好的呢?
    2024fatwolf552 2024fatwolf55
    随便聊聊 rtx3090 qwen-27b 多卡部署

    补充:使用本地小模型压缩整理记录是可以的,其实也可以考虑使用Agnes免费API,作为兜底措施。


  • 双3090,哪个qwen 3.8 模型才是最好的呢?
    2024fatwolf552 2024fatwolf55
    随便聊聊 rtx3090 qwen-27b 多卡部署

    我也是双3090。对记忆系统,我的选择是:云端的一律不考虑,免费的API也可能在你某一天积累了大量记忆后收你的钱,你就不得不乖乖掏钱。去掉云端后,主要就是自托管的几个,包括mem0,Hind,hongcho。还考虑过reme(只使用MD文档),我还自己魔改过Mempalace,让Qwen3.6 Plus防facebook在10亿照片里找到类似照片的算法,写了一个搜索。最终是落在使用字节跳动开源的OpenViking上(我怀疑字节的豆包网页版之类,搞不好就是这个框架)。
    OpenViking里面有多个LLM调用,官方推荐使用豆包模型。我用过豆包内置嵌入模型,后来发现这东西居然大量消耗我的豆包模型额度,直接改自托管了。
    本来是丐版Mac上自托管,以本机LMStudio默认拉起BGE模型作为服务端,提供这个嵌入模型为OpenViking提供LLM服务。后来想起来局域网有一台12G的小主机,装了飞牛NAS,属于Debian系统。就让PI Agent把本机的OpenViking直接迁移到飞牛NAS上,PI迁移过去还比较平滑。
    使用OpenViking我没遇到你这种集中”总结“的时刻,问Agent一些问题,它发现需要召回记忆的时候,会主动去OpenViking里翻。貌似效果还行。
    OpenViking:https://github.com/volcengine/OpenViking


  • 利用OxAlpha+OpenCode尝试优化服务器脚本参数
    2024fatwolf552 2024fatwolf55
    LLM讨论区 open-code

    软件环境:Opencode + Ox Alpha Free

    目的:直接调用这个模型的免费额度,Opencode是默认安装。

    直接给它服务器上SSH指令的用户名和密码,连接我的Ubuntu服务器(当前运行SGLang架构的Qwen3.8 27B FP8)。让它“探查服务器的软硬件情况,并就当前Qwen3.8 27B模型使用提出评估意见”

    模型探查了CPU、GPU、PCIe 拓扑(GPU0 x16 / GPU1 x4)、内存架构与插槽数等,开始提出初步评估。评估意见初步怀疑因为我另一张GPU的PCIe插槽速度不足,可能MTP反而会拖慢推理,建议我做3个对照实验测试:

    SGLang FP8(8099,TP2)——三个零成本实验优先做:

    1. --no-mtp A/B:MTP 投机解码让每步前向翻倍,而 TP2 的 all-reduce 正好被 GPU1 的 x4 弱链路卡脖子——投机收益可能被链路延迟吃掉,实测见分晓
    2. NCCL_P2P_DISABLE=1 对照:PHB 拓扑下强制共享内存中转有时反超
    3. chunked-prefill 2048→4096:KV 余量充足(注释自证 64K 池仅 ~2GB/卡),大分块摊薄 all-reduce 固定延迟

    测试结果是MTP开启能提速80%左右,另两个还没测试。

    又要求其针对三大推理架构llama,vLLM和SGlang进一步评估优化可能。

    结论:

    1. SGLang 留任主力:混合架构补丁资产不可复制;RadixAttention 对编码代理循环(重发系统提示+清单的每轮迭代)收益远大于通用吞吐差距;FP8+131K 质量档唯一来源。弱链路之弊靠第十节 S1–S3 实验对冲。
    2. llama.cpp 当辅助:唯一免疫 x4 弱链路的架构;Q4/Q5 GGUF 可单卡容身,与 SGLang 错峰共存。缺 RadixAttention 与投机解码,上限低于 FP8 档。
    3. vLLM 退役:高并发吞吐优势(并发≤4 用不上)与多卡扩展性(被 x4 锁死)双双失效;int4 场景可由 GGUF 平替。仅当未来部署 vLLM 独占支持的模型时临时启用。

    版本背景:llama.cpp 日更构建 b10537(2026-08-21);

    后续继续由模型自己写的脚本一轮一轮筛选参数。结束后我来通报结果。


  • 关于Uncensored Qwen3.8 27B,推荐RVN版本
    2024fatwolf552 2024fatwolf55
    LLM讨论区 qwen-27b

    我让Agent进行社区调研,最后它推荐了两个大牛推荐且社区热门的两个模型(基于我的双卡3090,选择了Q5精度):
    Qwen3.8-27B-Uncensored-Q5_K_M.gguf 19G
    RVN-Q5_K_M.gguf 18G
    实际接起来以后测试了一下,测试过程也很简单,写一篇NFSW的小说,和进行NFSW的都市职场成人RolePlay,然后我个人主观结果是RVNQ5这个更好一些。另一个会明显断流,就是输出中间会突然截断,或者发傻(比如让它写小说,写了一部分就停掉了)。不知道是模型问题,还是对中文支持不好。


  • 有人试过freetoken吗?现在很火
    2024fatwolf552 2024fatwolf55
    LLM讨论区 本地模型

    看到了,在服务器上让Agent去部署了一下。但是我问Agent,它对我的双3090推荐下来最适配的模型,还只是Qwen3.6 35B A3B。那样的话我不如等Qwen3.8 35B A3B了。
    双卡3090之前已经能直接跑Ornith 1.5和Nemotron 的MOE,感觉吐字已经很快了。

    现在想的是,后期直接提内存到128G,试试看低精度DeepSeek V4FLash 0731能不能感受一下,Agent推测能7 Tokens/s ,说适合夜间丢一个编程任务。白天建议还是使用Dense模型,比如Qwen3.8 27B。


  • 今天应该全世界的人都在蹬 ox-alpha (x-preview-f-free) 模型 吧? 大家蹬的感受如何?
    2024fatwolf552 2024fatwolf55
    AI Agent glm 本地模型

    我发现ox在长链开发任务里很容易出现上下文截断的毛病,或者突然说“开工”然后就中止了。有点感觉像以前测试mimo code时遇到的情况。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组