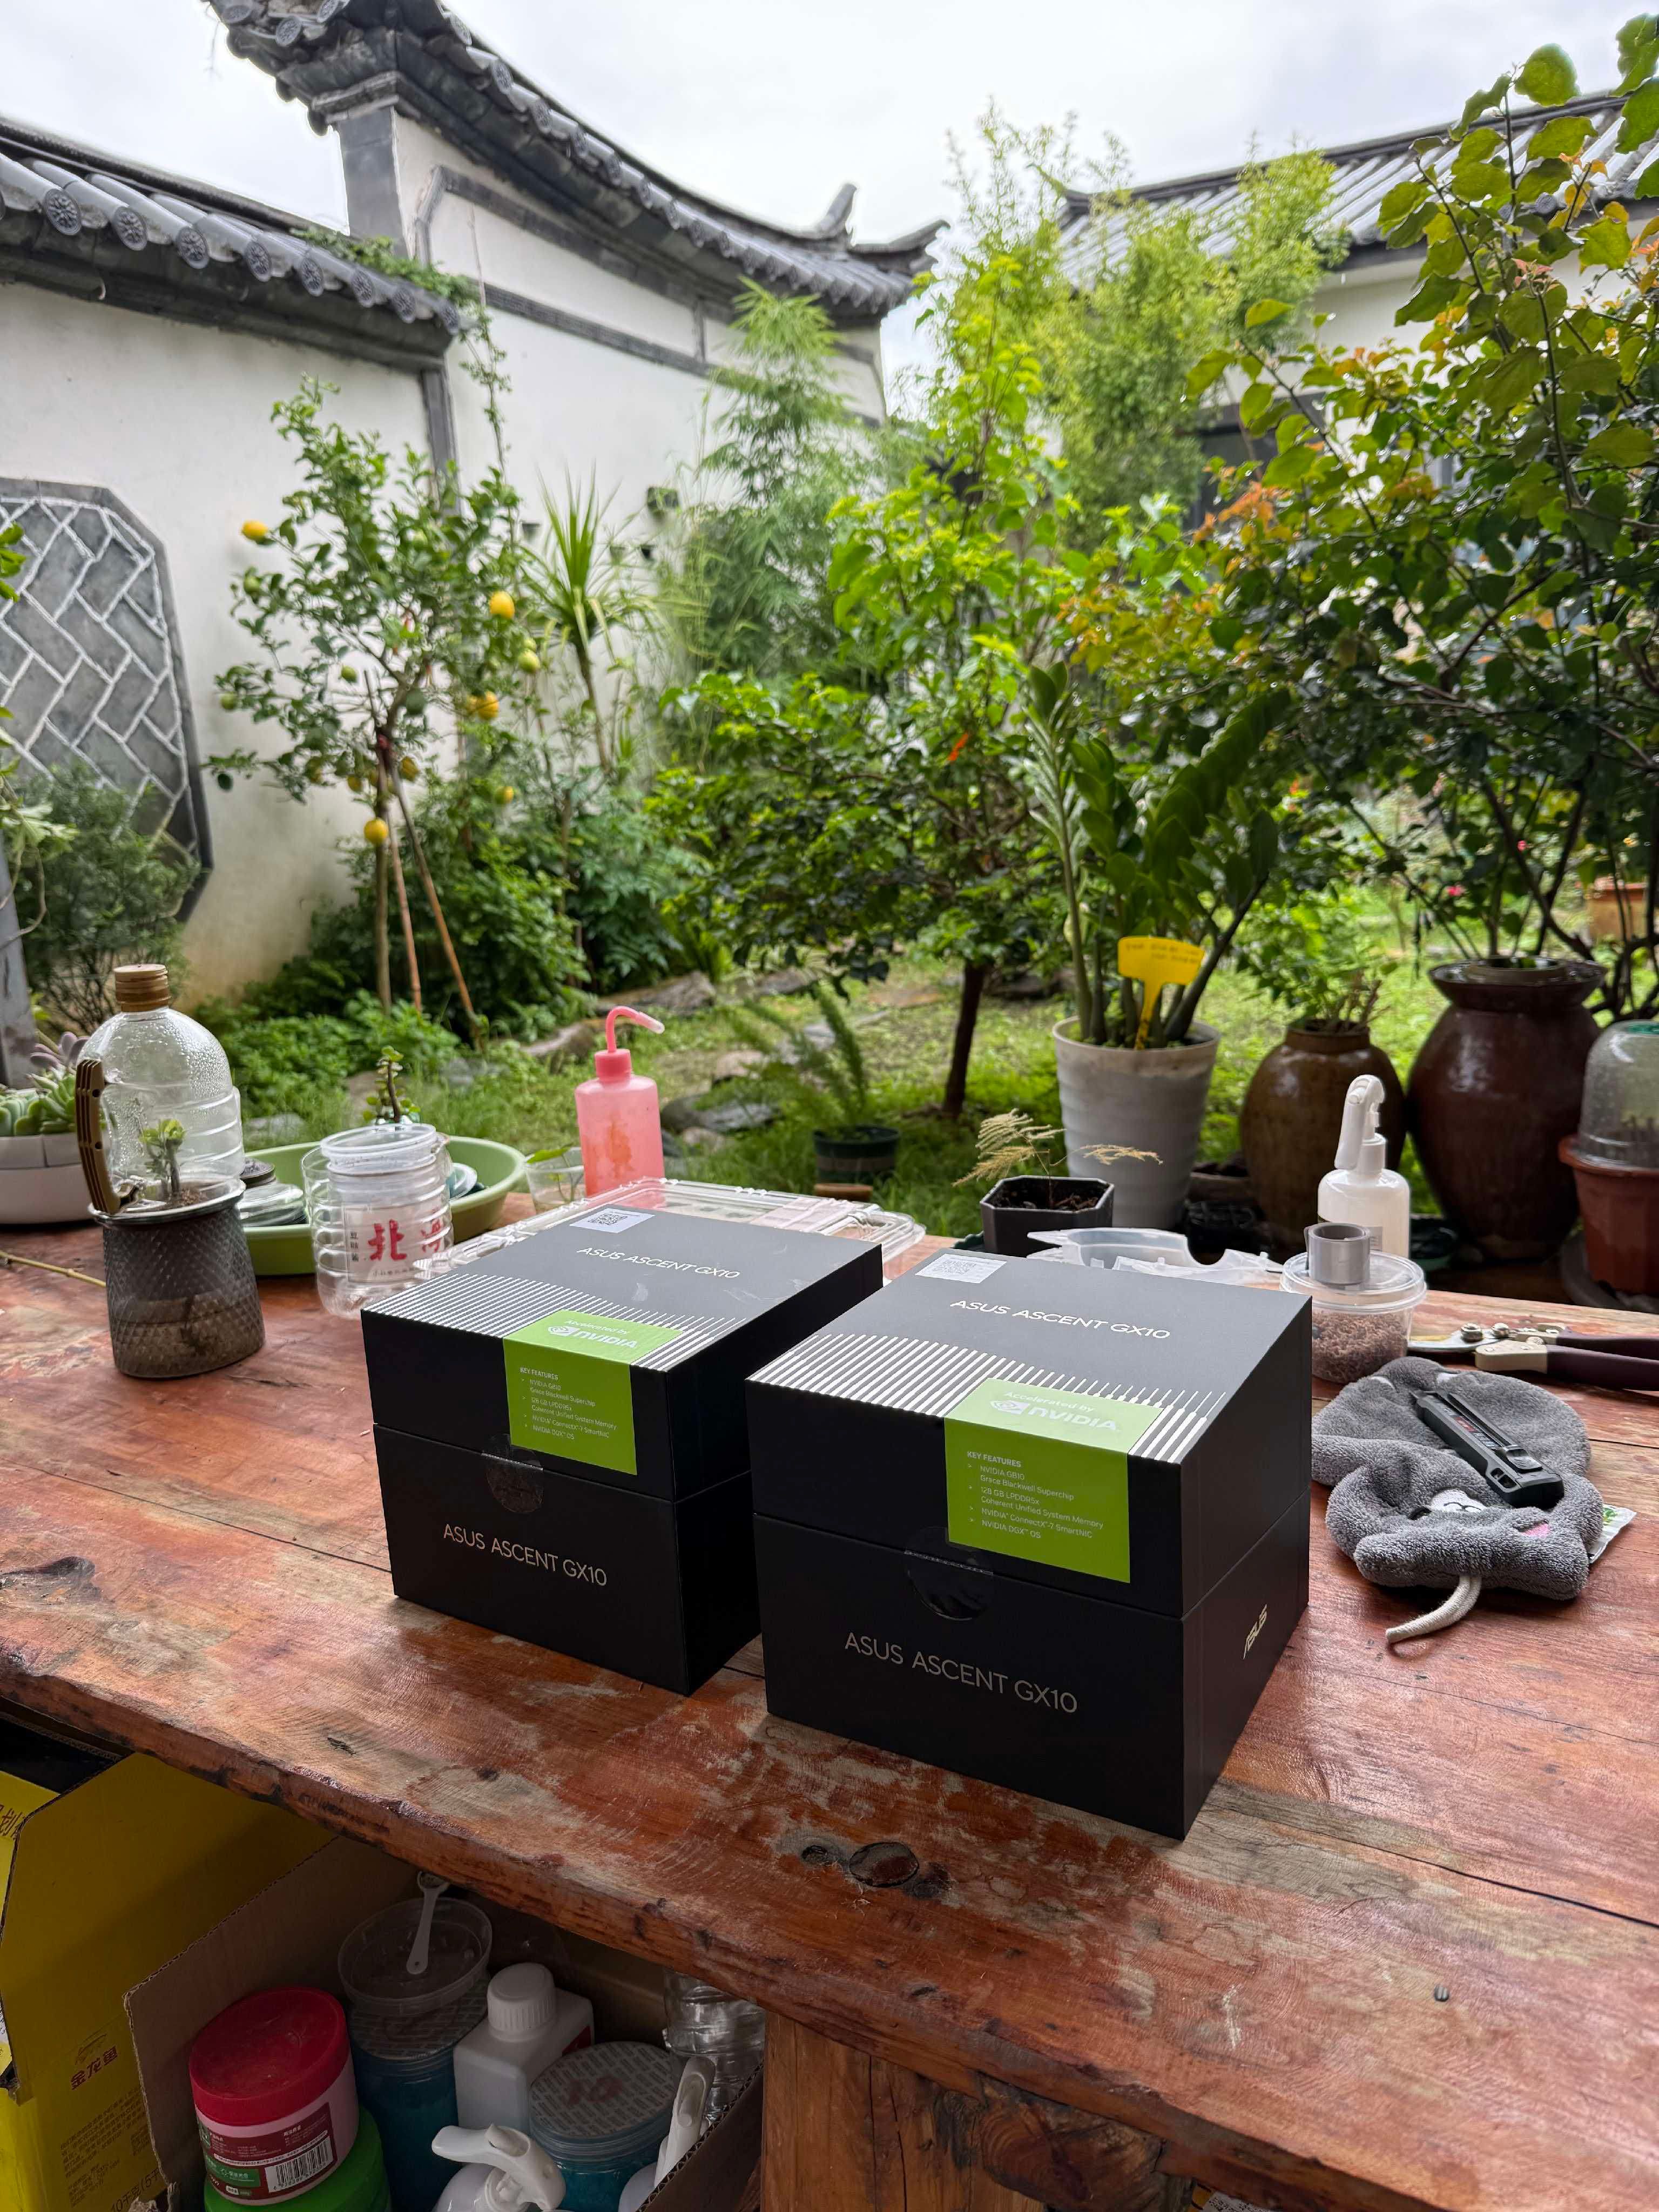
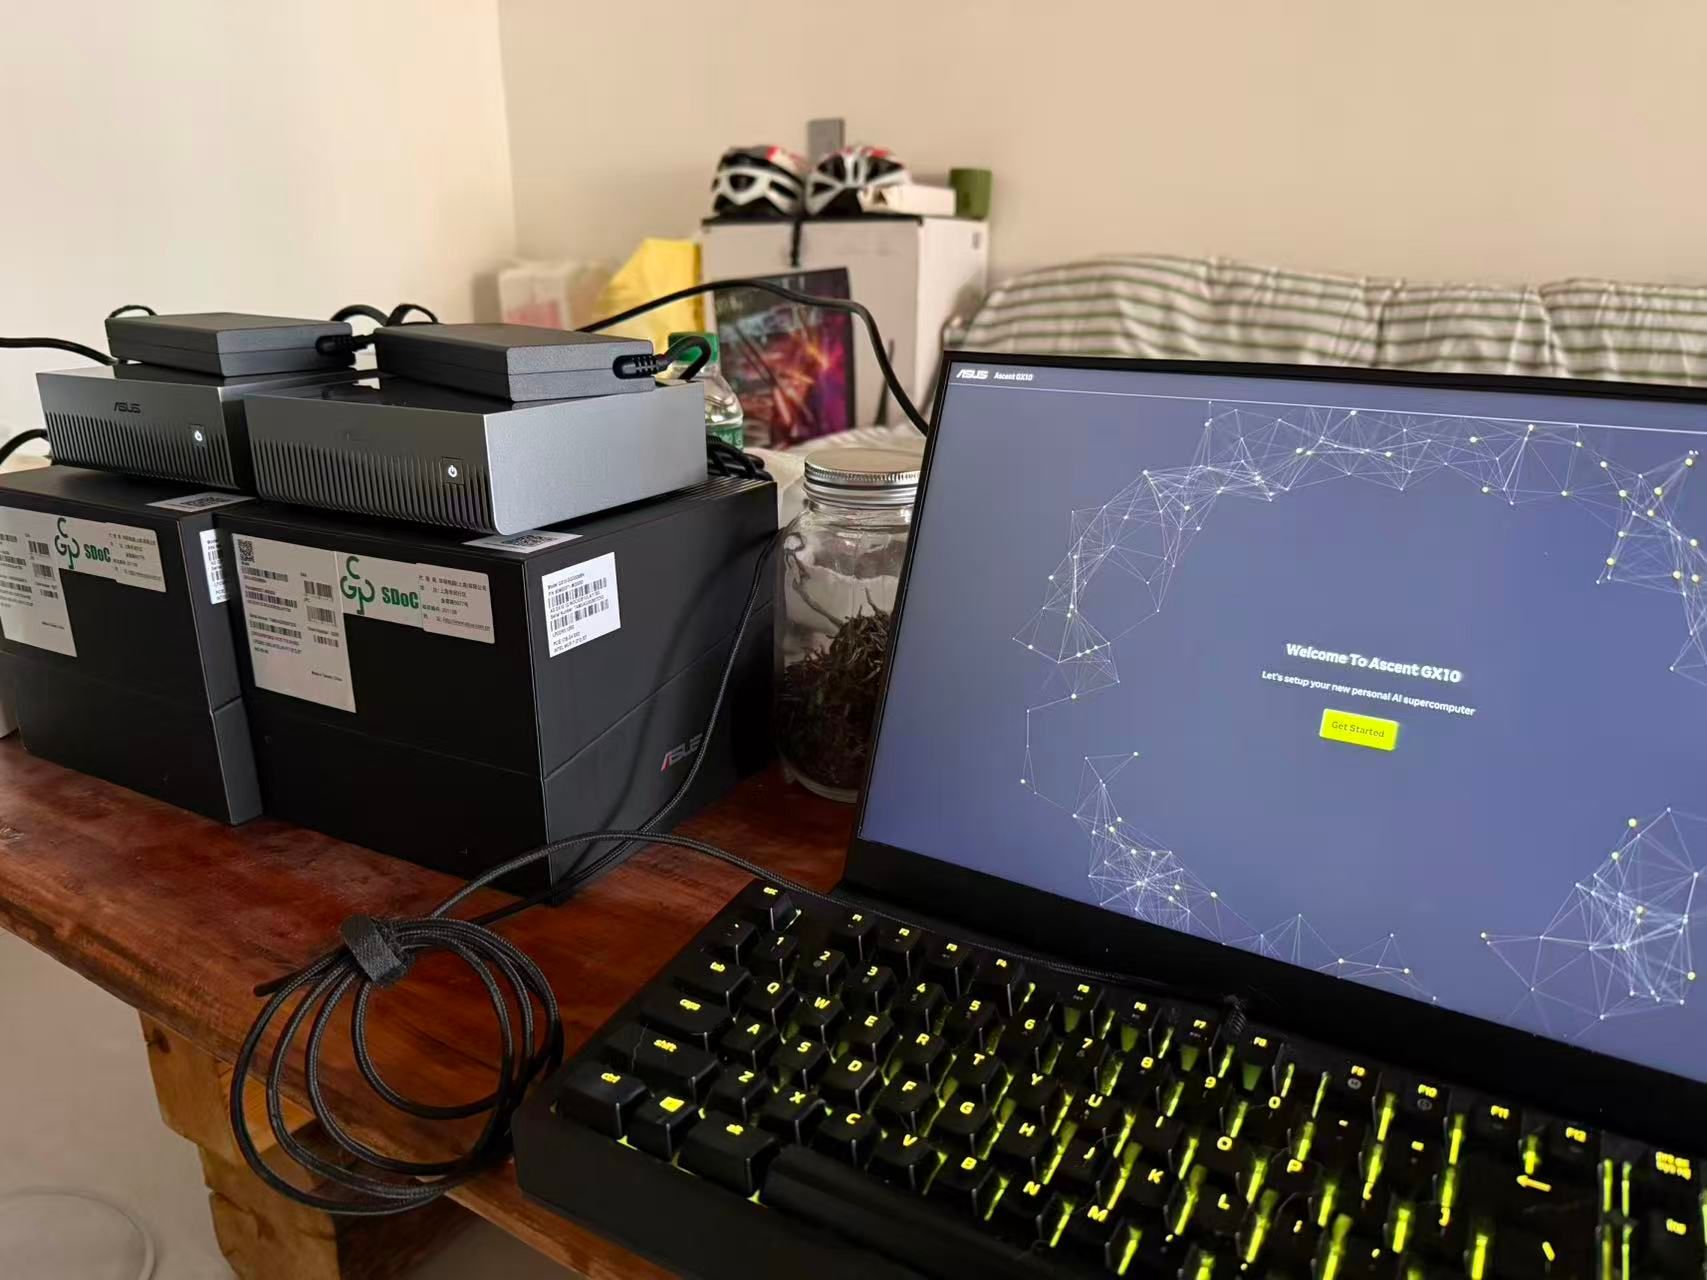
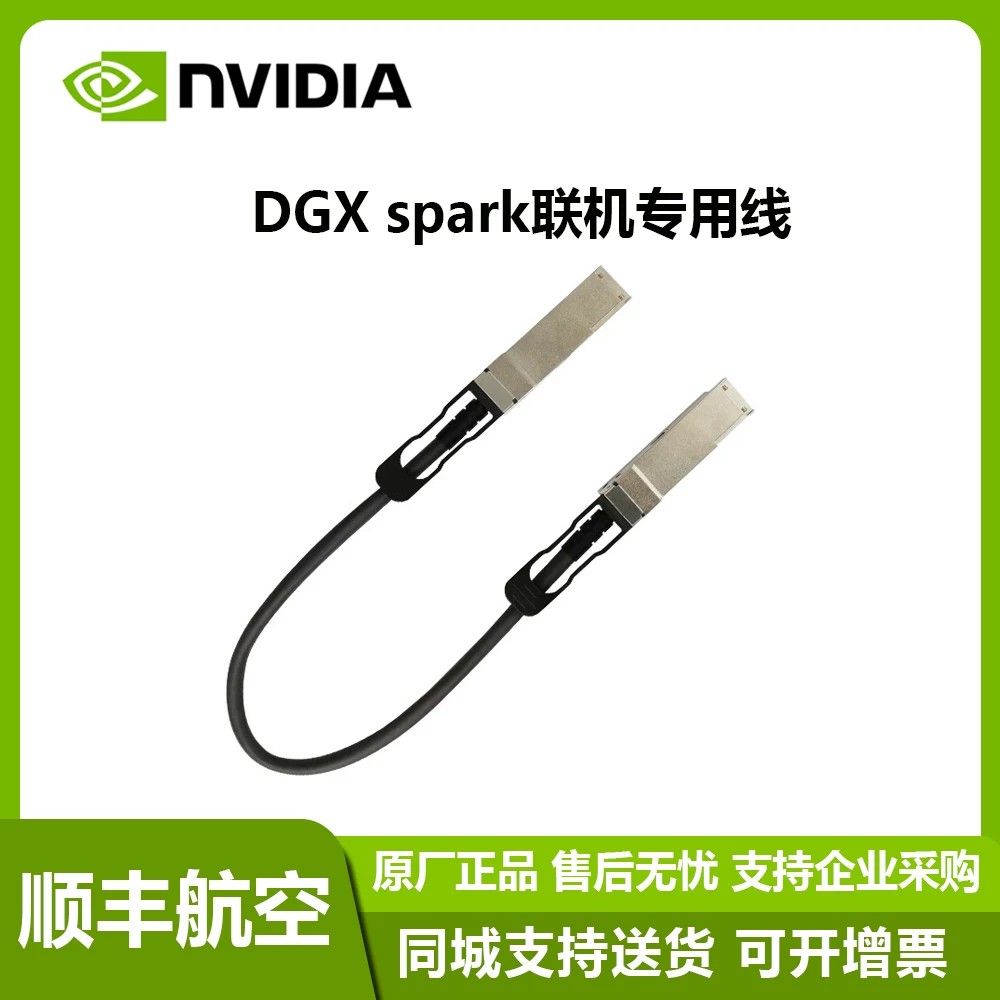
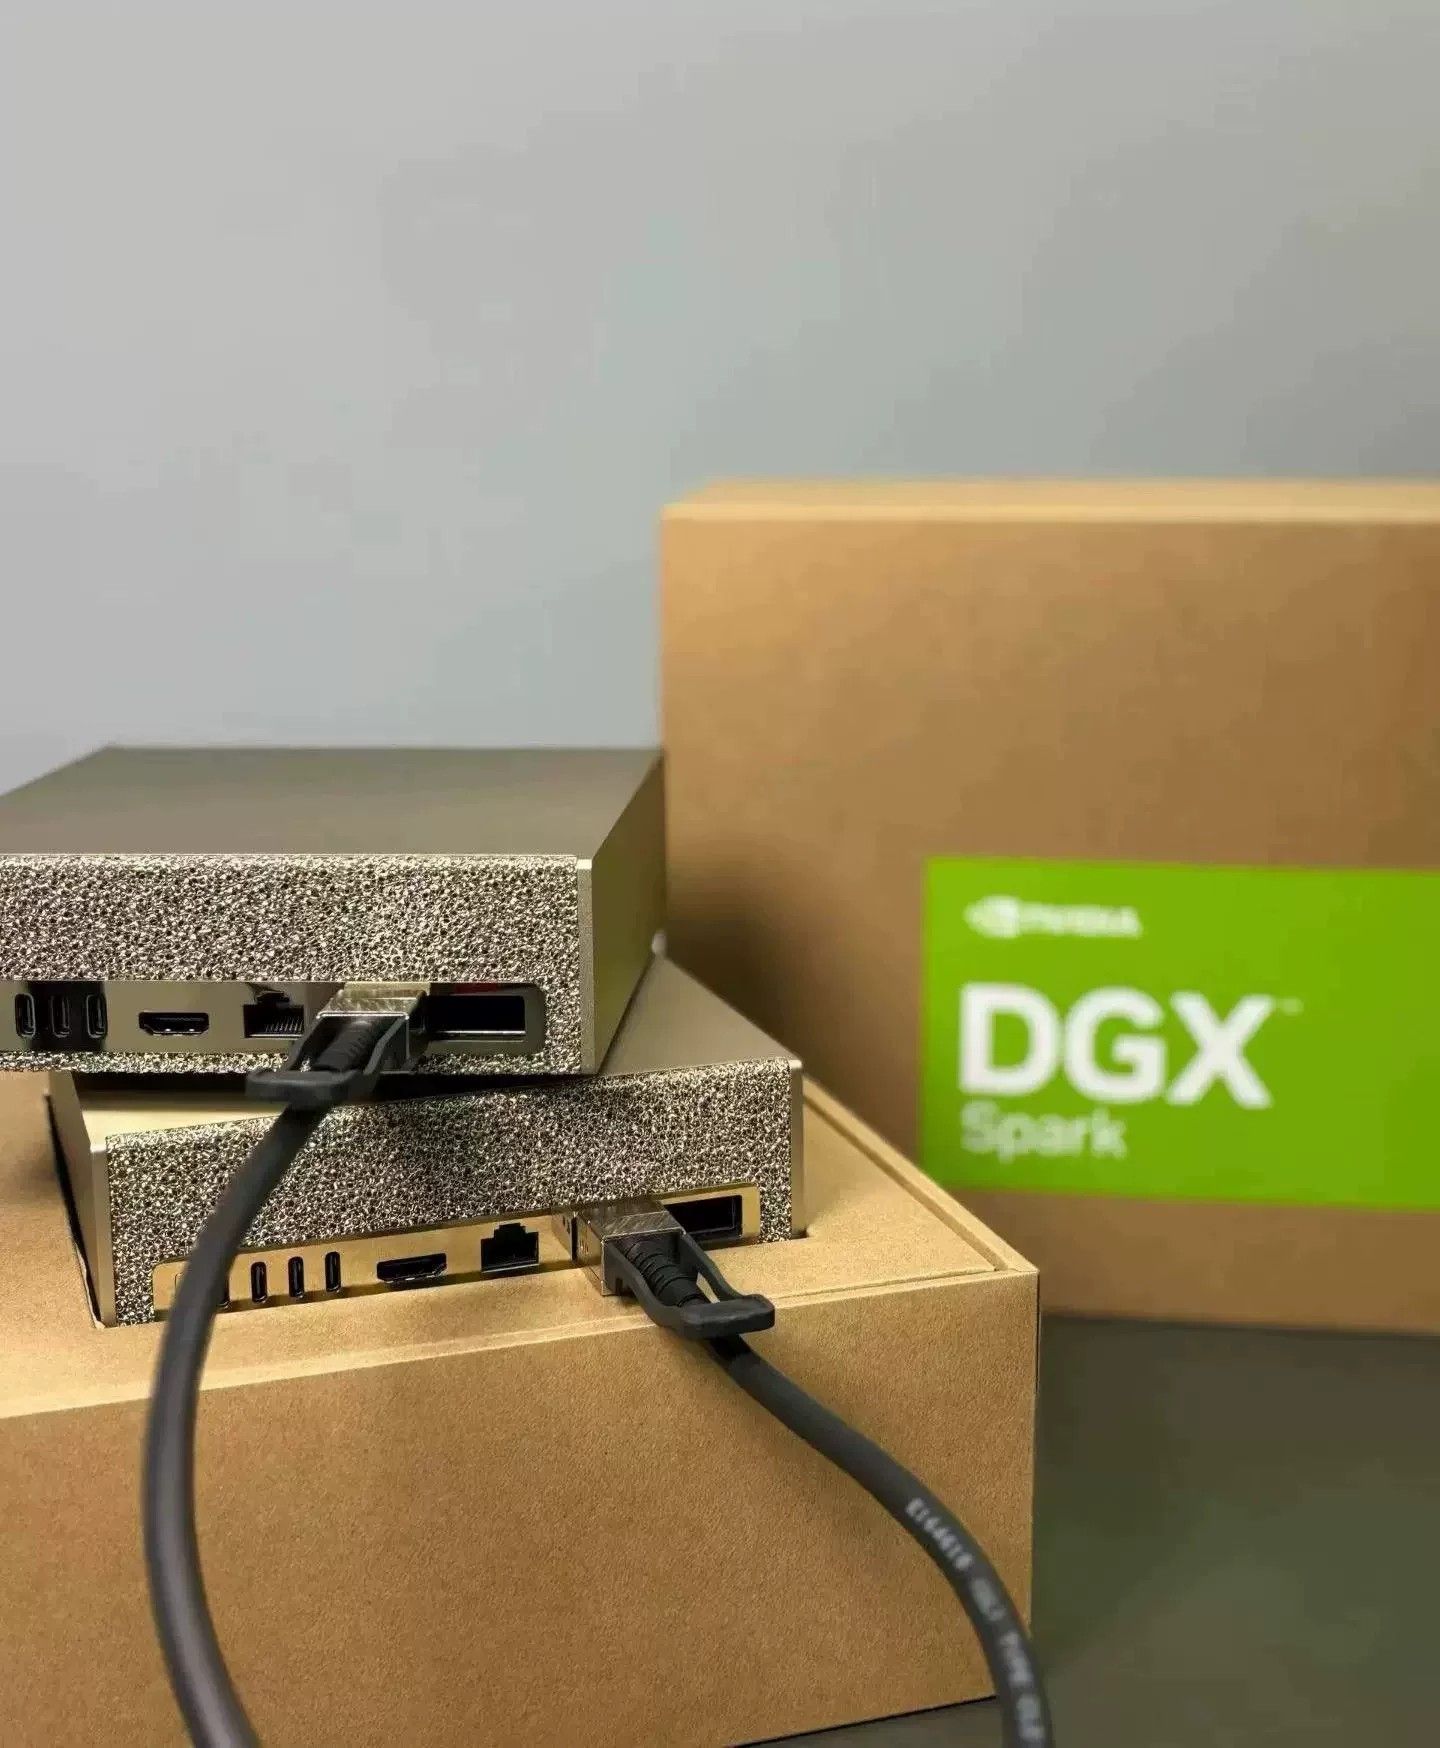
论坛上已经有一帖分享 V4.1 flash 配方(Deepseek v4.1 flash , 4台DGX spark GB10, TP=4)基本默认要一台 200G 交换机做四机全互联。我这套是用 4 根 DAC 线把四台 GB10 直接接成一个闭环——没有交换机,对面节点(rank0 rank2)互不可直连,通信要靠邻居转发——走的是 SparkRing 的无交换机环(switchless cycle)路线,NCCL 需要打补丁才肯在这种拓扑上起来。
实测结果是可以用,而且不比交换机组网差:单流解码 75–108 tok/s,满并发(8 路)聚合解码 280→703 tok/s,16K 上下文 prefill ≈4.4k tok/s,1M 上下文单流 TTFT 71.6s / prefill 3.58k tok/s。今天把并发 × 上下文的二维矩阵整跑了一遍,数据附在下面。
使用方案:FujitsuPolycom/sparkring(Apache-2.0,自带 NCCL 补丁)的 deepseek-v41-flash-tp4 profile,模型是官方原始权重。
DeepSeek-V4.1-Flash TP4(四机环)部署与测试总结报告
一、模型与服务基本信息
- 模型名称:
DeepSeek-V4.1-Flash(服务名 DeepSeek-V4.1-Flash-TP4)
- 权重版本:官方 checkpoint,pinned revision
dba1be0a40aa,48 个 safetensors 分片,476 GiB
- 上游原生路线:
github.com/FujitsuPolycom/sparkring — profile deepseek-v41-flash-tp4(recommendation: recommended,装机器镜像 dev-20261013-dcp2prefill-status038-sircl-tp6)
- 推理引擎:vLLM(SparkRing "Kraken" 分支
0.1.dev21553+gab86b7073)+ B12X 内核 + SIRCL 传输插件
- 硬件环境:4× NVIDIA DGX Spark(GB10,aarch64,单机 121 GiB 统一内存)
- rank0
aitopatom-aca1(技嘉 AI TOP ATOM,Node A / 服务出口)| rank1 gx10-white(ASUS GX10)| rank2 gx10-black(ASUS GX10)| rank3 aitopatom-a9b6(技嘉 AI TOP ATOM)
- 两家 OEM 的系统版本不同(GX10 = DGX OS 7.2.3 / 内核 6.17.0-1031-nvidia;AI TOP ATOM = DGX OS 7.4.0 / 内核 7.0.0-1019-nvidia),实测混装可以跑通
- 高速网络互连:无交换机环形拓扑,4 根 QSFP DAC 直连(p0 → 下一台 p1,无对角线),每台 2 个 CX7 200G 端口(每个端口两个 Socket Direct 功能,共 4 个 fabric netdev),整环 8 条逻辑通道
- 环序:
aitopatom-aca1 → gx10-white → gx10-black → aitopatom-a9b6 →(回到 aca1)
- fabric 地址段
198.18.0.0/21,每根缆两个 /24;控制面走 WireGuard sr-control(10.253.255.1–4)
权重存储与挂载:环上没有贯通全环的 NFS 通路(对面节点不直连),所以四台各存一份完整 476 GiB 权重,本机 NVMe 直读;四机 × 48 分片全量 sha256 比对一致(192/192)。这跟交换机组网"HEAD 挂 NFS 给 worker 只读"的做法不同,是环拓扑的硬约束,也是安装前要预留 ~620 GB/台 空间的原因。
二、核心规格与配置参数
| 核心参数 |
数值 / 设定 |
说明 |
| Context Length |
1,048,576(1M tokens) |
模型原生完整长度,本次部署跑满 1M |
| Max Running Requests |
8 |
--max-num-seqs 8,CUDA Graph 捕获尺寸覆盖到 96 |
| KV Cache Pool |
12,715,913 tokens(可用 KV 显存 15.89 GiB) |
1M 上下文时可支撑 12.13 路并发;FP8 |
| 静态显存比例 |
0.83(≈100.9 GiB / 121.6 GiB) |
每 rank 权重常驻 74.4 GiB,服务中每机仍余 9–10 GiB |
| 分块预填充 |
--max-num-batched-tokens 8192 + chunked prefill |
抑制长上下文 attention logits 峰值张量,500K+ 不 OOM |
| 前缀缓存 / 调度 |
prefix caching + async scheduling |
同一前缀重复请求命中即省 prefill |
| 推测解码 |
DSpark,num_speculative_tokens 5、概率式草稿、块级拒绝、自适应验证 |
引擎实测:平均接受长度 3.65、平均草稿接受率 61.0%、逐位接受率 0.851 / 0.684 / 0.546 / 0.463 / 0.392 |
| Engram 卸载 |
table_memory=disk + disk_resident_scales |
两张 FP8 n-gram 表(各 ~94.6 GiB)不占显存,按 token 需要从本机 NVMe 直读——这是 4 台能装下 1M 上下文的关键 |
| 环网传输 |
SIRCL(SIRCL_FABRIC=ring:4、SIRCL_GROUPS=tp、NCCL never) |
补齐的 NCCL 2.32.3 提供 NCCL_SWITCHLESS_RING_ONLY=1,跳过 tree/PAT 建链(环上对面 rank 无直连) |
| 多模态视觉 |
原生支持,limit-mm-per-prompt {"image":4} |
256×128 测试图消耗 202 vision tokens |
| 思考控制 |
默认 on · high;级别 low / high / xhigh(mx) / 1–100 |
可请求级关闭(chat_template_kwargs: {"thinking": false});默认开启且思考链吃 token,max_tokens 给小了会返回空 content |
| 工具 / 推理解析器 |
deepseek_v41(tool-call + reasoning)+ auto tool choice |
支持强制工具调用 |
| 端点 |
http://192.168.10.10:8015/v1 |
无鉴权(不带 key 与带假 key 都返回 200):方便接线,但别把它暴露到局域网之外 |
| 启动耗时 |
热重启 4 分 29 秒(22:58:47 起容器 → 23:03:16 API 就绪) |
权重 50.4 s 载完(74.4 GiB/rank),引擎 init 150 s;首次冷装(含校验 + 编译内核)约 20 分钟 |
三、验证与测试数据
测试口径(全部一致):
- 每档输出 128 tokens,填充文本带唯一 nonce + 递增编号 → 不命中 prefix 缓存;温度 0.6
- 单流 pp/tg = 各请求均值;聚合 pp = Σprompt / max(TTFT);聚合 tg = Σcompletion / (max 总时长 − max TTFT)
- 并发 1/2/4/8(8 = 本部署的并发上限),上下文档位 1K → 512K
1. 基础功能与能力验证(栈自检,本机环上实跑)
| 测试项 |
输入 |
结果 |
状态 |
| 计数 |
1…20 顺序输出 |
全对 |
PASS |
| 算术 |
17 × 23 |
391 |
PASS |
| 代码生成 |
Python is_prime(n) |
完整可用实现 |
PASS |
| 工具调用 |
get_weather(Paris) |
正确发起 tool call |
PASS |
| 强制工具调用 |
tool_choice=required |
正确发起 get_weather(Rome) |
PASS |
| 原生视觉 |
左红右蓝 128×64 PNG |
The left half is red and the right half is blue. |
PASS |
| 思考开关 |
关→直答 / 开→带思考链 |
thinking on 时 391 + 62 字符思考链 |
PASS |
| 传输层 |
本次集合通信走哪条路 |
Transport: sircl, NCCL: absent |
PASS |
| 频率 |
四机 SM 时钟 |
2483–2522 MHz,无降频事件(仅 idle) |
PASS |
四机环上自检全绿:All checks passed.
2. 长上下文阶梯压测(并发 1)
| 目标上下文 |
实际 prompt tokens |
TTFT |
单流 prefill |
单流解码 |
墙钟 |
状态 |
| 1K |
1,116 |
0.47s |
2,362.7 tok/s |
91.0 tok/s |
1.9s |
PASS |
| 4K |
4,070 |
0.99s |
4,118.6 tok/s |
96.5 tok/s |
2.3s |
PASS |
| 8K |
7,958 |
1.76s |
4,529.1 tok/s |
89.4 tok/s |
3.2s |
PASS |
| 16K |
15,686 |
3.43s |
4,569.8 tok/s |
75.1 tok/s |
5.1s |
PASS |
| 32K |
31,741 |
7.93s |
4,001.6 tok/s |
74.9 tok/s |
9.7s |
PASS |
| 64K |
63,524 |
14.35s |
4,425.9 tok/s |
90.7 tok/s |
15.8s |
PASS |
| 128K |
127,784 |
32.14s |
3,976.0 tok/s |
86.7 tok/s |
33.6s |
PASS |
| 256K |
256,355 |
71.61s |
3,579.8 tok/s |
107.9 tok/s |
72.8s |
PASS |
| 512K |
513,344 |
175.55s |
2,924.2 tok/s |
79.0 tok/s |
177.2s |
PASS |
1M 上下文是配置上限,实跑验证到 512K:512K 单请求 TTFT 175.6s、prefill 2.92k tok/s,全程无 OOM、无换页。
3. 高并发 × 上下文 二维扫描
并发 2
| 上下文 |
prompt/请求 |
TTFT(max) |
单流 pp |
单流 tg |
聚合 pp |
聚合 tg |
墙钟 |
| 1K |
1,094 |
0.64s |
1,723.3 |
55.2 |
3,443.3 |
110.4 |
3.0s |
| 4K |
4,154 |
2.02s |
3,029.8 |
60.3 |
4,067.2 |
143.6 |
3.8s |
| 8K |
7,958 |
3.52s |
3,394.1 |
52.4 |
4,525.3 |
135.4 |
5.4s |
| 16K |
15,686 |
6.92s |
3,421.6 |
44.3 |
4,579.8 |
127.8 |
8.9s |
| 32K |
31,094 |
14.02s |
3,239.3 |
34.1 |
4,481.6 |
107.5 |
16.4s |
| 64K |
62,240 |
28.28s |
3,204.5 |
42.7 |
4,401.8 |
153.7 |
30.0s |
| 128K |
125,240 |
62.84s |
2,955.3 |
36.5 |
4,026.3 |
137.8 |
64.7s |
| 256K |
256,355 |
146.02s |
2,640.5 |
34.6 |
3,511.3 |
134.9 |
148.0s |
| 512K |
503,240 |
349.99s |
2,185.7 |
43.7 |
2,904.6 |
171.8 |
351.6s |
并发 4
| 上下文 |
prompt/请求 |
TTFT(max) |
单流 pp |
单流 tg |
聚合 pp |
聚合 tg |
墙钟 |
| 1K |
1,094 |
1.06s |
1,036.2 |
50.5 |
4,136.7 |
189.3 |
3.8s |
| 4K |
4,070 |
3.65s |
1,678.6 |
40.1 |
4,486.7 |
199.0 |
6.2s |
| 8K |
8,123 |
7.02s |
2,321.6 |
30.1 |
4,580.0 |
193.3 |
9.7s |
| 16K |
16,012 |
14.87s |
2,235.5 |
24.5 |
4,262.4 |
206.1 |
17.4s |
| 32K |
31,094 |
28.89s |
2,208.7 |
18.7 |
4,327.3 |
185.8 |
31.7s |
| 64K |
63,524 |
59.54s |
2,170.9 |
18.4 |
4,202.9 |
237.4 |
61.7s |
| 128K |
125,240 |
125.14s |
2,023.9 |
20.9 |
4,023.6 |
302.8 |
126.9s |
| 256K |
251,290 |
288.52s |
1,842.5 |
22.4 |
3,519.0 |
339.4 |
290.1s |
| 512K |
513,344 |
695.75s |
1,516.5 |
24.8 |
2,922.3 |
379.3 |
697.3s |
并发 8(满并发,= max-num-seqs)
| 上下文 |
prompt/请求 |
TTFT(max) |
单流 pp |
单流 tg |
聚合 pp |
聚合 tg |
墙钟 |
| 1K |
1,094 |
2.27s |
883.7 |
35.0 |
3,888.2 |
280.7 |
5.9s |
| 4K |
4,070 |
7.30s |
1,245.4 |
25.3 |
4,503.8 |
256.9 |
11.3s |
| 8K |
8,123 |
14.24s |
1,512.7 |
16.9 |
4,565.0 |
268.7 |
18.1s |
| 16K |
16,012 |
28.80s |
1,519.1 |
12.6 |
4,402.4 |
280.3 |
32.5s |
| 32K |
31,094 |
57.46s |
1,450.2 |
10.4 |
4,351.9 |
335.6 |
60.5s |
| 64K |
62,240 |
117.68s |
1,418.9 |
9.7 |
4,252.8 |
437.9 |
120.1s |
| 128K |
125,240 |
253.92s |
1,340.2 |
10.8 |
3,965.8 |
576.3 |
255.8s |
| 256K |
256,355 |
571.94s |
1,190.9 |
10.4 |
3,550.3 |
574.0 |
573.9s |
| 512K |
503,240 |
1,396.56s |
982.6 |
12.3 |
2,904.4 |
703.5 |
1,398.4s |
4. 汇总对照
聚合解码吞吐(tokens/s)
| 上下文 |
并发 1 |
并发 2 |
并发 4 |
并发 8 |
| 1K |
91.0 |
110.4 |
189.3 |
280.7 |
| 4K |
96.5 |
143.6 |
199.0 |
256.9 |
| 8K |
89.4 |
135.4 |
193.3 |
268.7 |
| 16K |
75.1 |
127.8 |
206.1 |
280.3 |
| 32K |
74.9 |
107.5 |
185.8 |
335.6 |
| 64K |
90.7 |
153.7 |
237.4 |
437.9 |
| 128K |
86.7 |
137.8 |
302.8 |
576.3 |
| 256K |
107.9 |
134.9 |
339.4 |
574.0 |
| 512K |
79.0 |
171.8 |
379.3 |
703.5 |
单流解码吞吐(tokens/s)
| 上下文 |
并发 1 |
并发 2 |
并发 4 |
并发 8 |
| 1K |
91.0 |
55.2 |
50.5 |
35.0 |
| 4K |
96.5 |
60.3 |
40.1 |
25.3 |
| 8K |
89.4 |
52.4 |
30.1 |
16.9 |
| 16K |
75.1 |
44.3 |
24.5 |
12.6 |
| 32K |
74.9 |
34.1 |
18.7 |
10.4 |
| 64K |
90.7 |
42.7 |
18.4 |
9.7 |
| 128K |
86.7 |
36.5 |
20.9 |
10.8 |
| 256K |
107.9 |
34.6 |
22.4 |
10.4 |
| 512K |
79.0 |
43.7 |
24.8 |
12.3 |
聚合 prefill 吞吐(tokens/s)
| 上下文 |
并发 1 |
并发 2 |
并发 4 |
并发 8 |
| 1K |
2,362.7 |
3,443.3 |
4,136.7 |
3,888.2 |
| 4K |
4,118.6 |
4,067.2 |
4,486.7 |
4,503.8 |
| 8K |
4,529.1 |
4,525.3 |
4,580.0 |
4,565.0 |
| 16K |
4,569.8 |
4,579.8 |
4,262.4 |
4,402.4 |
| 32K |
4,001.6 |
4,481.6 |
4,327.3 |
4,351.9 |
| 64K |
4,425.9 |
4,401.8 |
4,202.9 |
4,252.8 |
| 128K |
3,976.0 |
4,026.3 |
4,023.6 |
3,965.8 |
| 256K |
3,579.8 |
3,511.3 |
3,519.0 |
3,550.3 |
| 512K |
2,924.2 |
2,904.6 |
2,922.3 |
2,904.4 |
几条结论:
- Prefill 与并发无关:1K→256K 区间聚合 prefill 基本贴在 4.0k–4.6k tok/s,四档并发几乎重合,直到 512K 才降到 2.9k。说明环拓扑的瓶颈不在 prefill 聚合带宽(8 条 200G 通道够用),而在单请求的长序列 attention。
- Decode 随并发放大:满并发 8 路时聚合解码从 1K 的 280.7 一路涨到 512K 的 703.5 tok/s——上下文越长、每步计算越"重",批次填得越满,环上 all-reduce 的固定开销被摊得越薄。
- 单流解码 ~75–108 tok/s(与换长上下文无关,1K–512K 都在这个带内)——比交换机组网公开数据的 58–68 tok/s 略高,主要差在推测解码接受率(平均接受长度 3.65 / 接受率 61%)。
- 128 tokens 的短输出会低估真实吞吐:单流 tg 里含首几步的调度开销,实际长任务(几百到几千 token)会明显更好。
5. 与交换机组网公开数据的量级对照
| 上下文 |
本机(无交换机环,单流) |
论坛交换机组网(单流,64 输出) |
| 32K |
TTFT 7.93s / prefill 4,001.6 / 解码 74.9 |
TTFT 10.02s / prefill 3,271.0 / 解码 67.5 |
| 128K |
TTFT 32.14s / prefill 3,976.0 / 解码 86.7 |
TTFT 48.46s / prefill 2,704.8 / 解码 67.5 |
| 256K |
TTFT 71.61s / prefill 3,579.8 / 解码 107.9 |
TTFT 87.46s / prefill 2,997.3 / 解码 59.4 |
| 512K |
TTFT 175.55s / prefill 2,924.2 / 解码 79.0 |
TTFT 268.94s / prefill 1,859.1 / 解码 58.2(500K) |
口径不完全相同(输出长度 128 vs 64、软件栈不同),仅作量级参考:环拓扑在 TTFT / prefill 上明显更快,解码在一个带内偏上。"不用交换机就跑不动 TP=4"这个结论,至少在这套栈上可以推翻了。
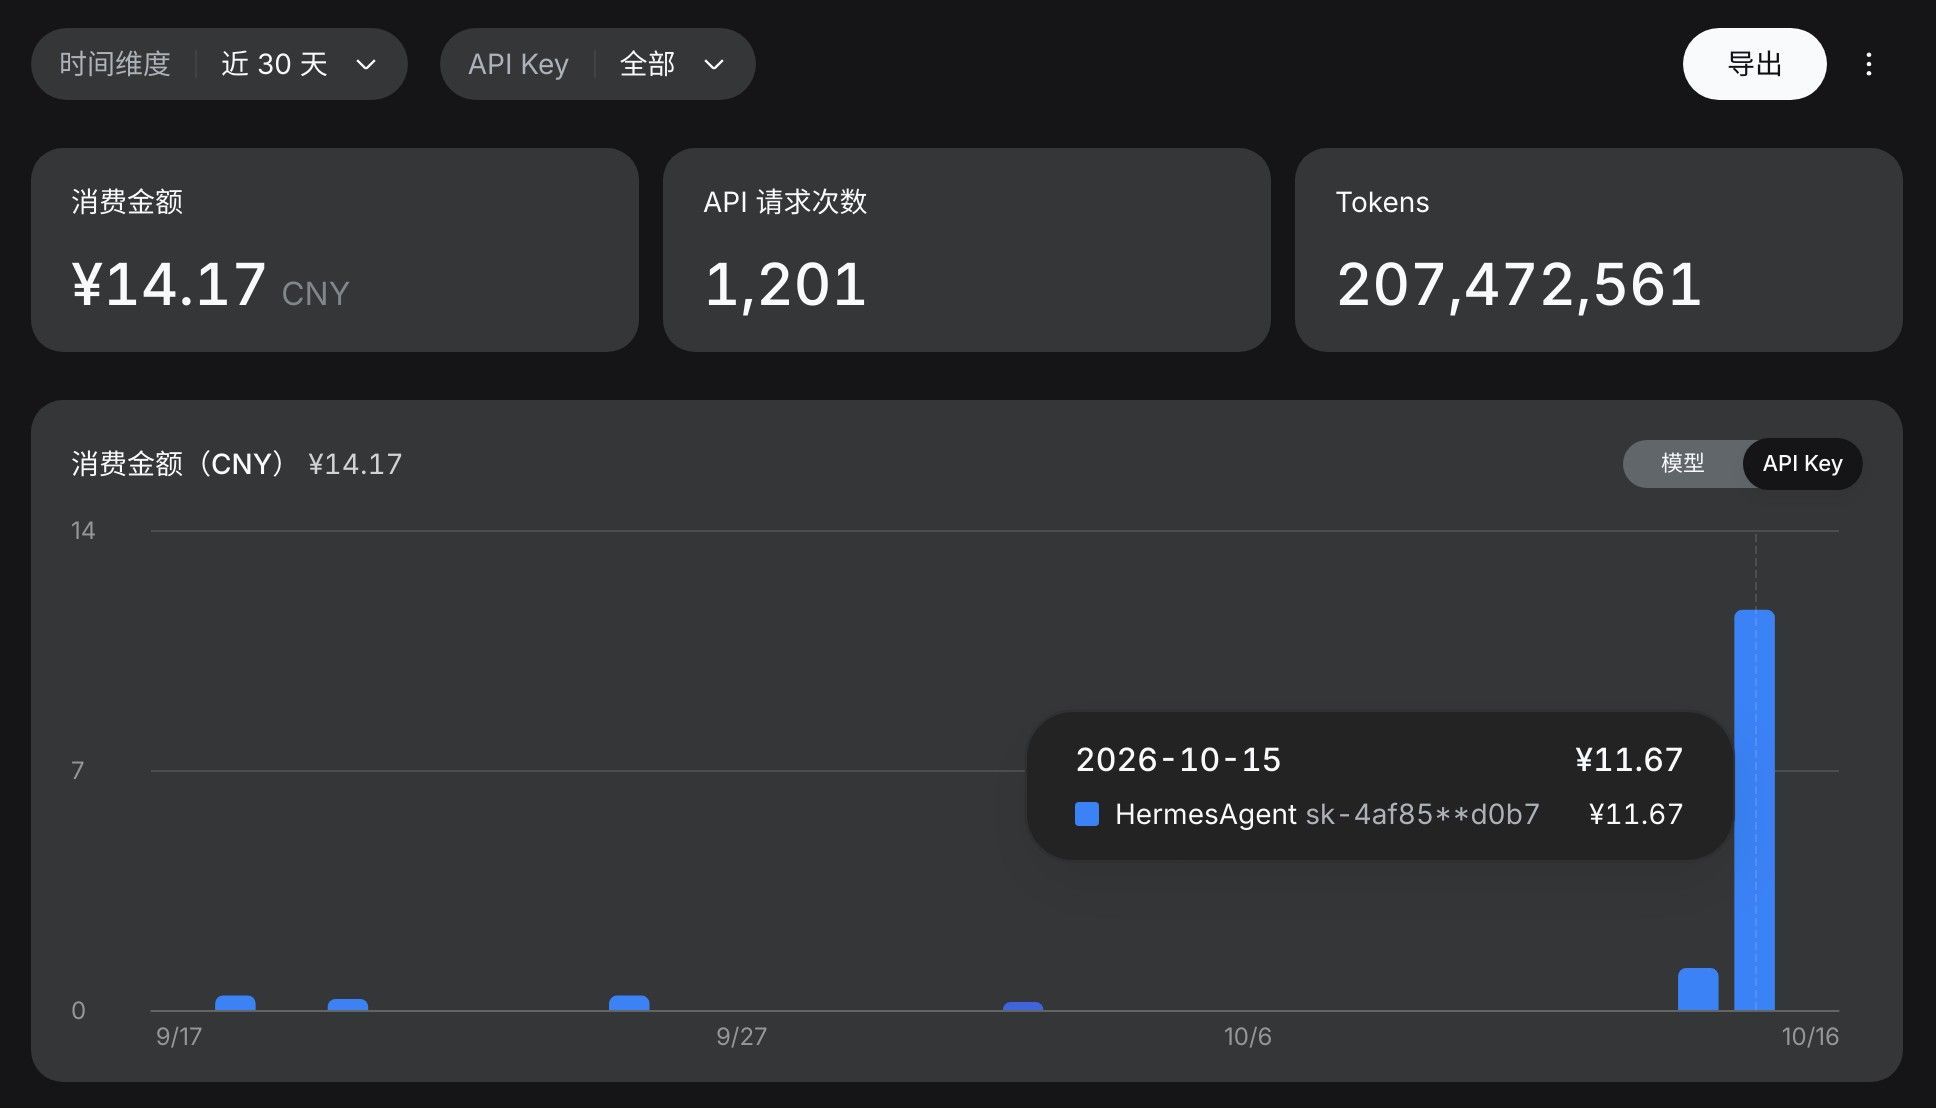
除了手动更新机器、组网,环境全由hermes配置,耗时16小时,花销如图。


 │
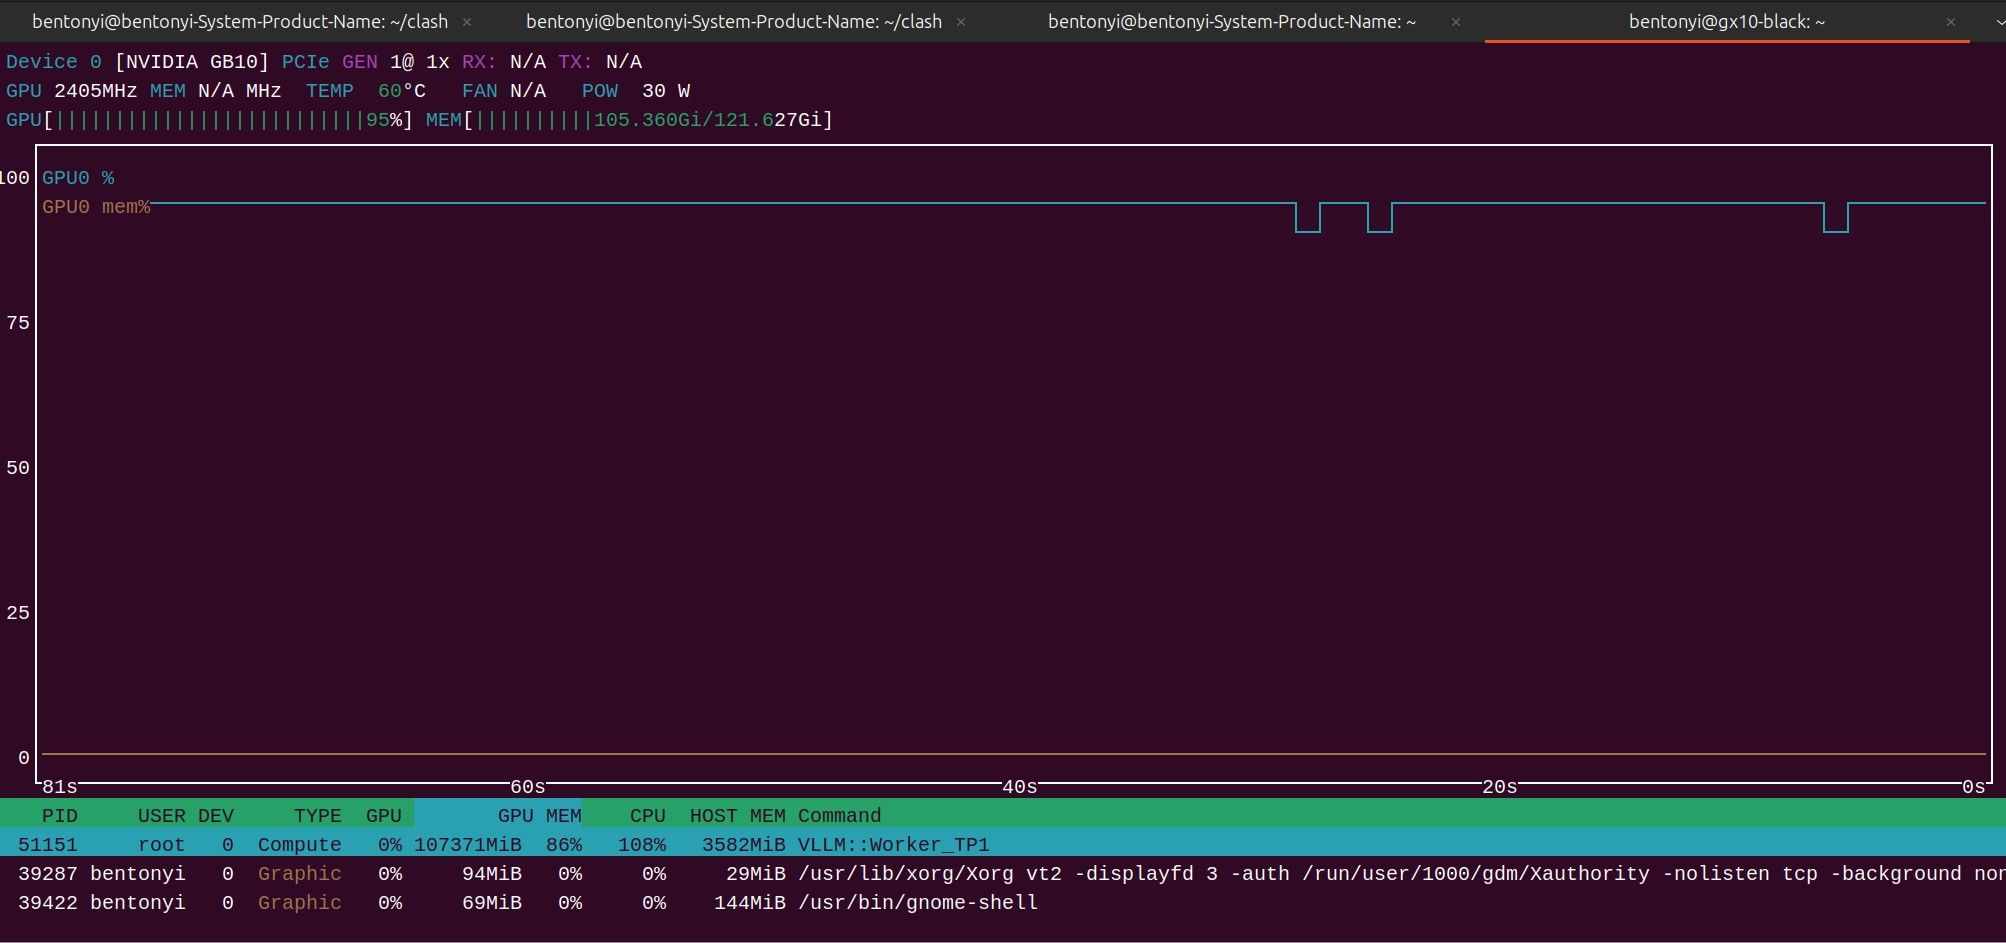
 不触发 CPU swap — KV Cache 全在 GPU,48 层 SSM 不吃 KV