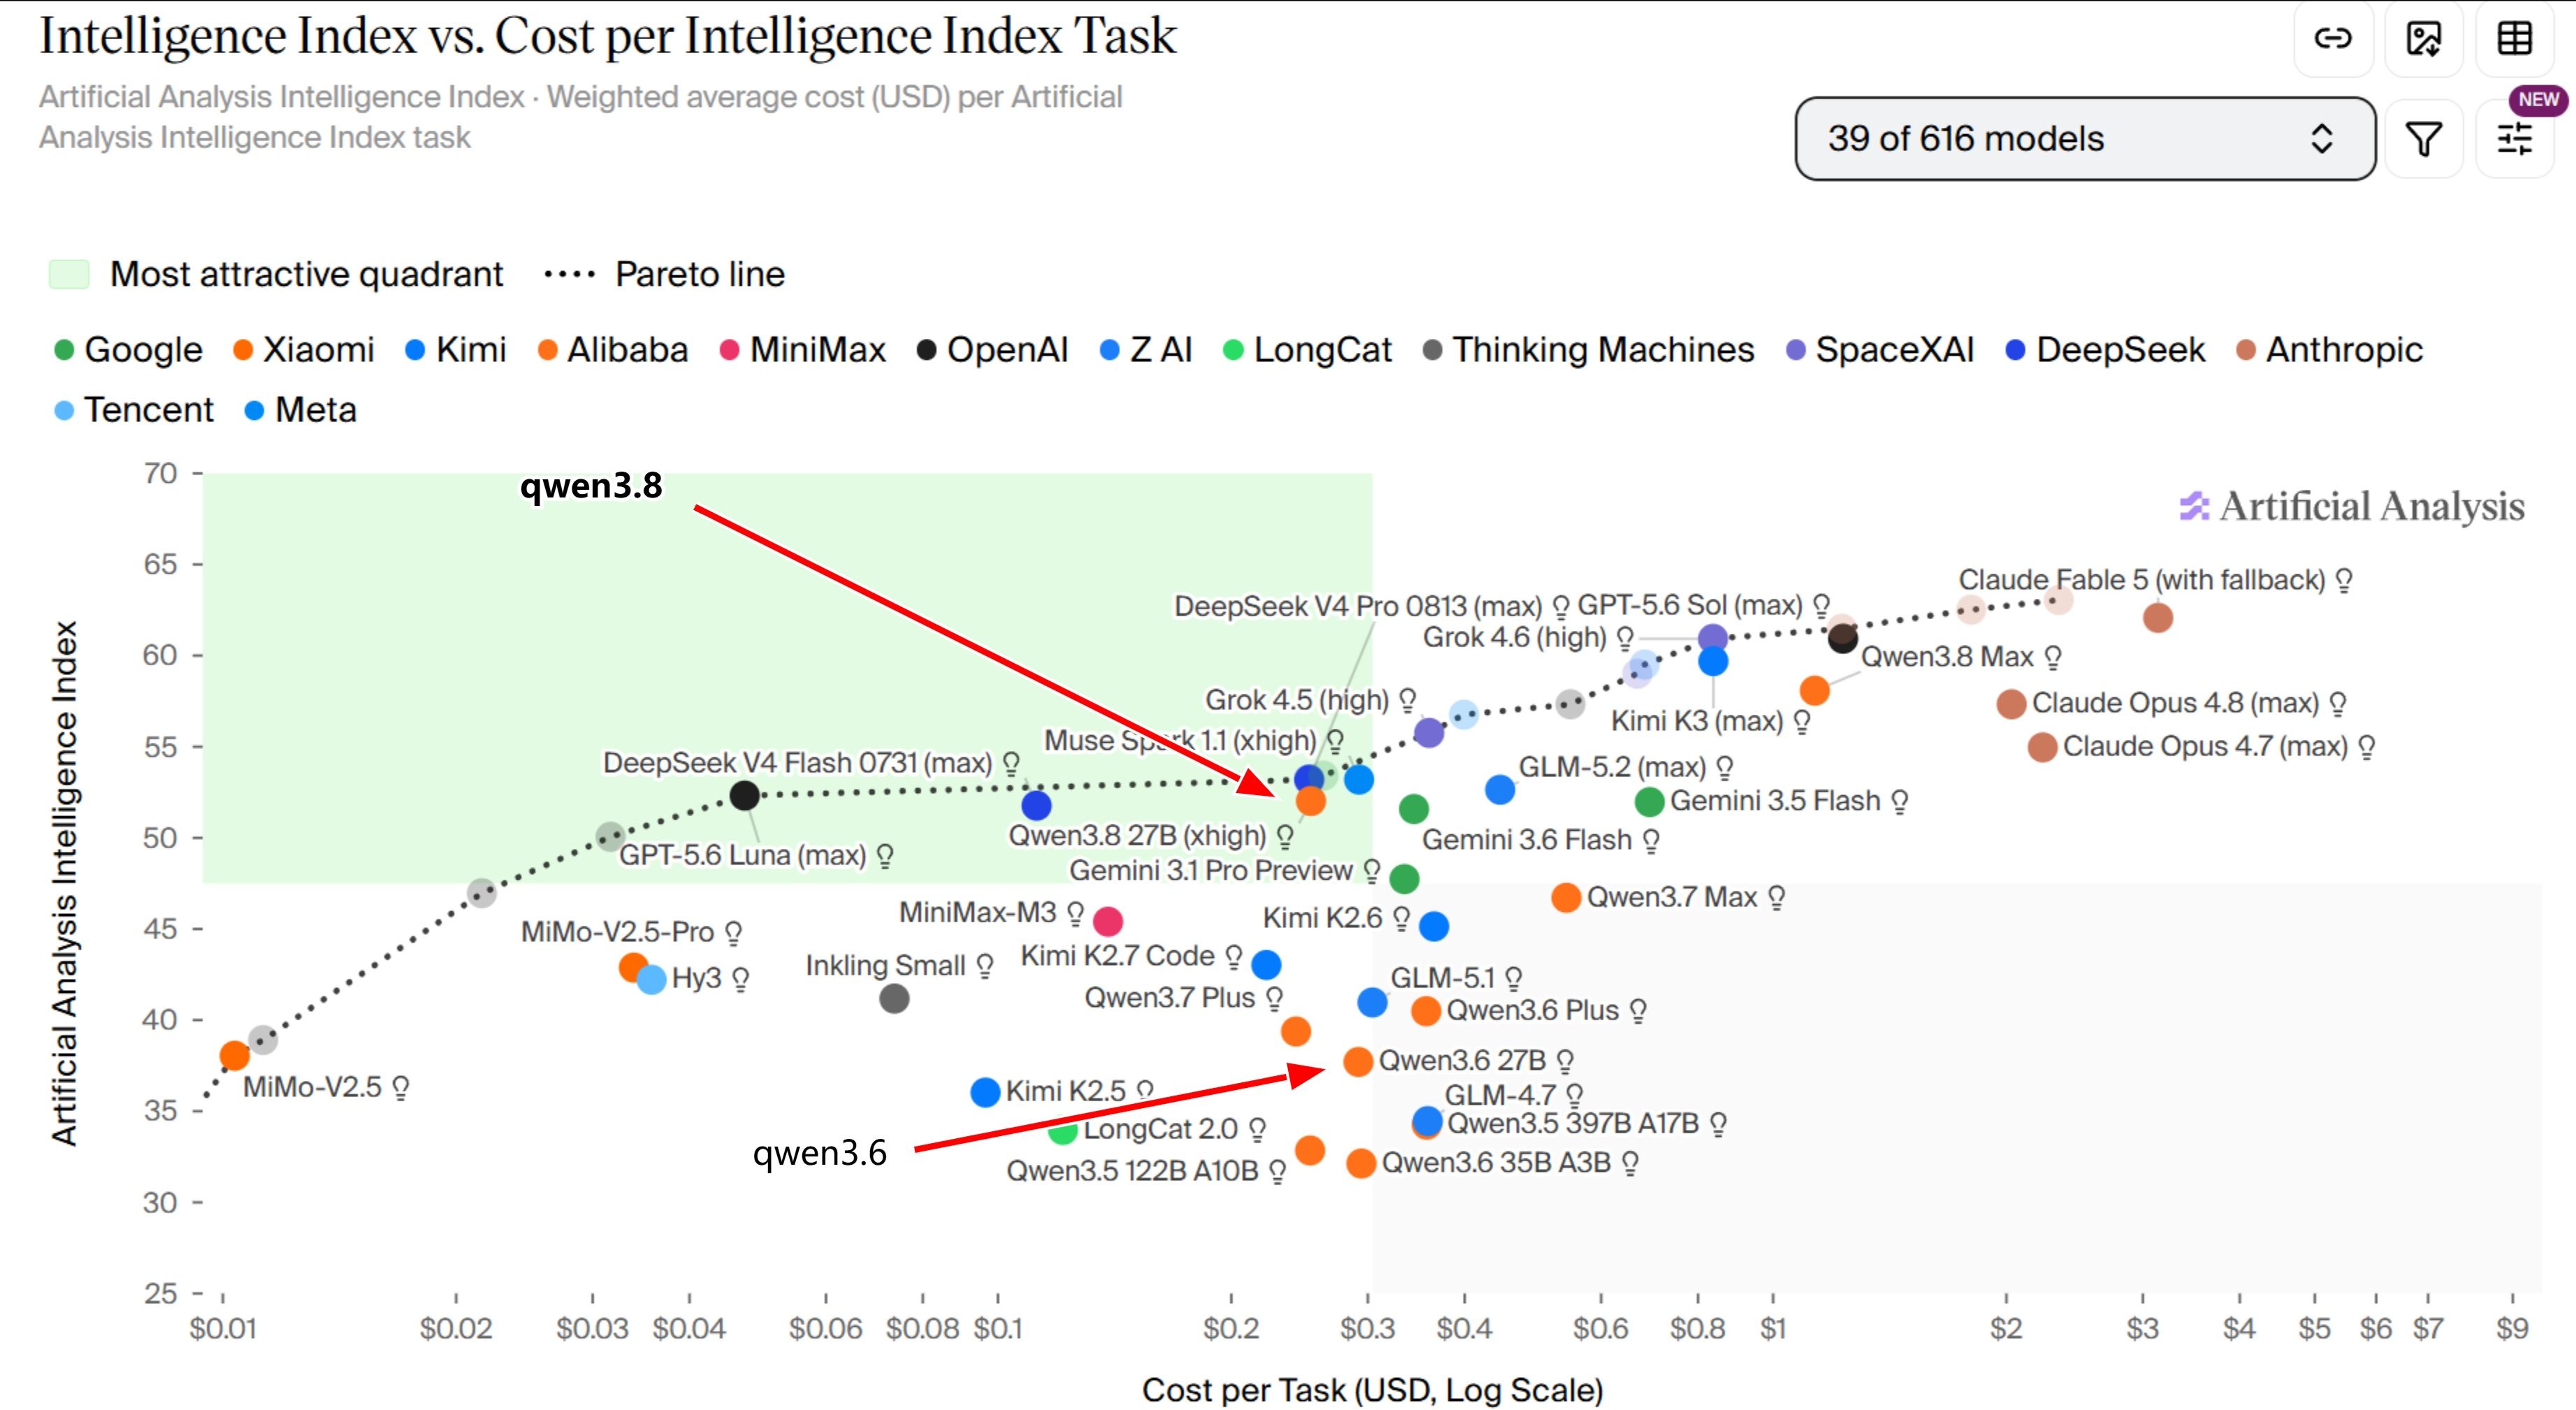
我记得上次qwen3.8说“下周”发布,实际过了7天以上。怕最迟得到11/8
-
Qwen4 下週見! -
gpu-unlock-ada 在 4080S 上的实测数据TP=2 prefill 每GPU功率从原本的260W左右升至290W左右(1.15x);峰值能突破320W上限;任务平均功耗尚未统计。
-
gpu-unlock-ada 在 4080S 上的实测数据仓库:https://github.com/JustAResearcher/gpu-unlock-ada
数据:
测试项 初始值 unlock 提升 bf16 张量核 GEMM 100.3 TF/s 175.1 TF/s 1.75× fp16 张量核 GEMM 100.4 TF/s 192.9 TF/s 1.92× TP=1 prefill 16K 1687 tok/s 2449 tok/s 1.45× TP=1 prefill 65K 1366 tok/s 1957 tok/s 1.43× TP=1 prefill 131K 1079 tok/s 1524 tok/s 1.41× TP=1 prefill 240K 796 tok/s 1118 tok/s 1.40× TP=1 decode 2K 22.60 tok/s 22.65 tok/s 持平 TP=1 decode 262K 16.43 tok/s 17.69 tok/s 1.08× TP=2 prefill 16K 2193 tok/s 2901 tok/s 1.32× TP=2 prefill 65K 1924 tok/s 2565 tok/s 1.33× TP=2 prefill 131K 1623 tok/s 2184 tok/s 1.35× TP=2 prefill 240K 1273 tok/s 1730 tok/s 1.36× TP=2 decode 2K 38.71 tok/s 38.88 tok/s 持平 TP=2 decode 262K 29.08 tok/s 31.18 tok/s 1.07× 说明:
- 配置:Ubuntu,vllm,Qwen3.8-27B-AWQ-INT4
- AI粗测,不代表实际生产值
-
【硬核实测】双 4080S 跑 125B Flash-Next 吊打 27B:单路 153 tok/s,是 27B 的 2.2 倍,Strata 三套量化 vs SGLang 全对比驱动用Duanyll那个就可以了,我试了运行平稳,4080S基本上不用改什么东西。
不过,P2P提升作用非常有限(个位数百分比;可能对推测解码稍好)
-
M5 Ultra 确实有点弱啊! 对比双卡 DGX Spark 集群:你在跑大模型时一直忽视的“致命数字”到底是什么?并发看上去很糟。这究竟是推理引擎还是metal的问题呢?
-
抄作业翻车三次:4080S 32G 上 NInfer 跑 Qwen3.8-27B,双路 256K 全部跑通,崩卡根因定位到 CUDA Graph × 批量投机看起来KVCache相当省啊。可惜在速度上NInfer对40系提升不像5090那么大
-
JEV颠覆传统AI生态,GPT Claude降本增效数百倍?DSH/GPT简单测试,AI圈子里的重金求子项目!很难赞同。炒作是一定有的,但不代表它没有价值。
就拿我之前看到的一个举例:
https://form-jev-scene-lab.op7418.chatgpt.site/毫秒级切换场景布局。恕我孤陋寡闻,我不知道在此之前应该用什么模型实现同等的效果。
它的判断力确实还相当有限;但是给很多场景加上一个几乎无感知的前置决策,我觉得是有用的。
-
有人试过jev和step5了吗?laya 零样本 似乎达不到可用水准;
openjev 似乎质量还行,但不够快。想试下这个。
step plan 官网是售罄状态。
-
各路大神求救,本人不才中标一个垃圾项目,银行私有部署看不懂。我只说说我作为外行的想法:
- 魔改显卡+二手拆机配件?
- qwen3.8-27B 当豆包用?小模型知识量少,也许是接入你们的知识库?
- 硬件都没买的情况下,你说你做好了软件。。最好别到时候发现数不清的问题。
- 20并发不需要太大显存,关键是你需要多大的上下文、响应/吐字速度、精度。
- 建议就是对他们的需求摸个底,尽量压低配置,没提到的东西统统不要上;选质量有保障的硬件,降低风险。总之就是砍上限保下限。
-
混搭 DGX Spark GB10 Prefill + Mac Studio DecodePD分离么,有点意思。但是GB10算力一般;通信带宽也许足够了,但延迟可能会很糟糕。
-
这个配置,大神帮忙建议一下,本地化部署什么大模型最合适,需要5个人同时并发?看不懂。量化权重+draft权重+视觉塔算30G吧,这还剩60G VRAM;qwen3.8 在KVCache FP8量化下,262K context约12G;5并发各262K上下文,完全是足够的,在纠结什么?
-
本地大模型部署的必要性分析,请大家投票。我入坑本地部署得到的最大教训就是不要本地部署。先建立你完整的AI工作流,跑一段时间后分析成本,再决定要不要做本地部署,否则真的就只是在“玩”。
-
下单了rtx pro 4500有必要把现在的主机换成工作站吗为什么要换呢?没钱不换;有钱直接买套新的。加/换内存即可
-
Qwen3.8-27B 在AA上的排名有点离谱吧。。 -
RTX PRO 5000(或其他48GB显存)的Qwen3.8-27B-FP8配置交流(prefill 5000+t/s,decode 60+t/s)@用户名违规 怎么会全量 prefill 呢?把三级缓存都打开试下?
export SGLANG_HICACHE_FILE_BACKEND_STORAGE_DIR="/path/to/kvcache/folder"--mamba-radix-cache-strategy extra_buffer \ --enable-hierarchical-cache \ --hicache-size 16 \ --hicache-storage-backend file \ --schedule-policy lpm \ --enable-session-radix-cache \ --enable-metrics \hicache-size根据内存大小设置,或者用hicache-ratio -
双 3090 NVLink + vLLM 半年实测:Qwen3.6-27B 解码 128 tok/s,并发 4 用户 258 tok/s -
嫌台式机显卡吵的, 给大家推荐一个神器@johnnybegood 直接上个空调机柜会不会好点?
-
请教各位大神:魔改 32GB RTX 4080 SUPER 开启 ReBAR 后,BAR1 最大仍只有 16GB,正常吗?我的也是16GB。魔改厂商不太可能帮你把BAR1开到32GB。想改内核开P2P的话,风险很大。参考:https://duanyll.com/2026/7/13/4090-48G-P2P/
-
测试了两天,发现RTX PRO 4500 Blackwell 32GB这张卡真有点坑啊!有没有哪位大神在这张显卡上能稳定高速的27B-llama方案啊?这很奇怪吧,32G 显存开不起 22G 权重?不要用
--gpu-memory-utilization,改--kv-cache-memory-bytes 4G试试,MTP 也先去掉。 -
TurboQuant 还真是比 FP8 慢了很多TurboQuant 好处是 KVCache 容量比 FP8 大了将近1倍(仅以我的设备为例;vLLM):
FP8:
GPU KV cache size: 1,006,391 tokens
TurboQuant:
GPU KV cache size: 1,900,544 tokens
官方声称 TurboQuant 吞吐量比 FP8 低很多,我还不以为意;接入 harness 实战后,降速凸显:
FP8,多并发:
Avg generation throughput: 443.6 tokens/s, Running: 12 reqs, Waiting: 0 reqs, GPU KV cache usage: 18.0%
TurboQuant,多并发:
Avg generation throughput: 264.0 tokens/s, Running: 12 reqs, Waiting: 0 reqs, GPU KV cache usage: 9.2%
FP8,单并发,约 72k 时:
Avg generation throughput: 56.0 tokens/s, Running: 1 reqs, Waiting: 0 reqs, GPU KV cache usage: 7.3%
TurboQuant,单并发,约 72k 时:
Avg generation throughput: 22.0 tokens/s, Running: 1 reqs, Waiting: 0 reqs, GPU KV cache usage: 3.8%
可见 TurboQuant 比 FP8 至少慢了 40%,而且越长越慢。真的是没有白捡的 KVCache