
另外,我的llama.cpp 启动参数加了
--jinja --chat-template-file /models/chat_template.jinja --reasoning-format deepseek --reasoning-preserve --reasoning-effort low
体感速度还会快一些。
另外,我的llama.cpp 启动参数加了
--jinja --chat-template-file /models/chat_template.jinja --reasoning-format deepseek --reasoning-preserve --reasoning-effort low
体感速度还会快一些。
搜了搜论坛,发现不少7900XTX极致优化的帖子,但一般都是魔改llama.cpp 或者双卡或者基于SGLang。我没太多精力去深究,一般倾向于用开箱即用的官方版本。
今天意外刷到 llama.cpp 的 spec : add DFlash2 support (local convolution + candidate selector)- #27342 已经在 8月底 merged。所以,llama.cpp已经官方支持DFlash2。Agent沟通一把后,马上开试:
| 项目 | 配置 |
|---|---|
| CPU | AMD 9600X |
| RAM | 32GB DDR5 |
| OS | Ubuntu 26.04 |
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DGGML_VULKAN=ON -DCMAKE_BUILD_TYPE=Release
cmake --build build --config Release -j$(nproc) --clean-first --target llama-cli  llama-server llama-bench
#主模型用之前一直采用的unsloth 的 Qwen3.8-27B-UD-IQ4_XS.gguf

# 新下载DFlash2 Draft模型
hf download z-lab/Qwen3.8-27B-DFlash2-GGUF Qwen3.8-27B-DFlash2-Q4_K_M.gguf --local-dir /models
llama-server \
  -m /models/Qwen3.8-27B-UD-IQ4_XS.gguf \
  -md /models/Qwen3.8-27B-DFlash2-Q4_K_M.gguf \
  --spec-draft-n-max 4 \
  -ngl 99 -fa on -np 1 \
  -c 163804 -ctk q8_0 -ctv q8_0 -b 2048 -ub 1024 \
  --host 0.0.0.0 --port 8080
| 题型 | 速度均值 |
|---|---|
| 数学题 | 100+ |
| 写作题 | 60+ |
| 编程 | 90+ |
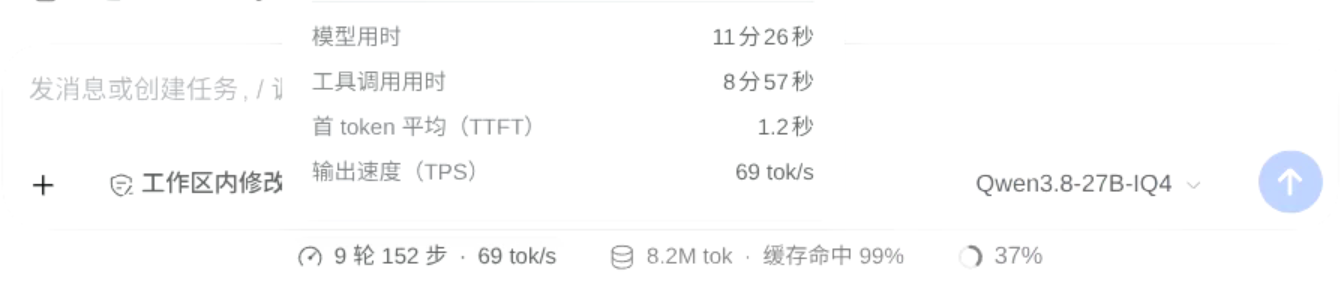
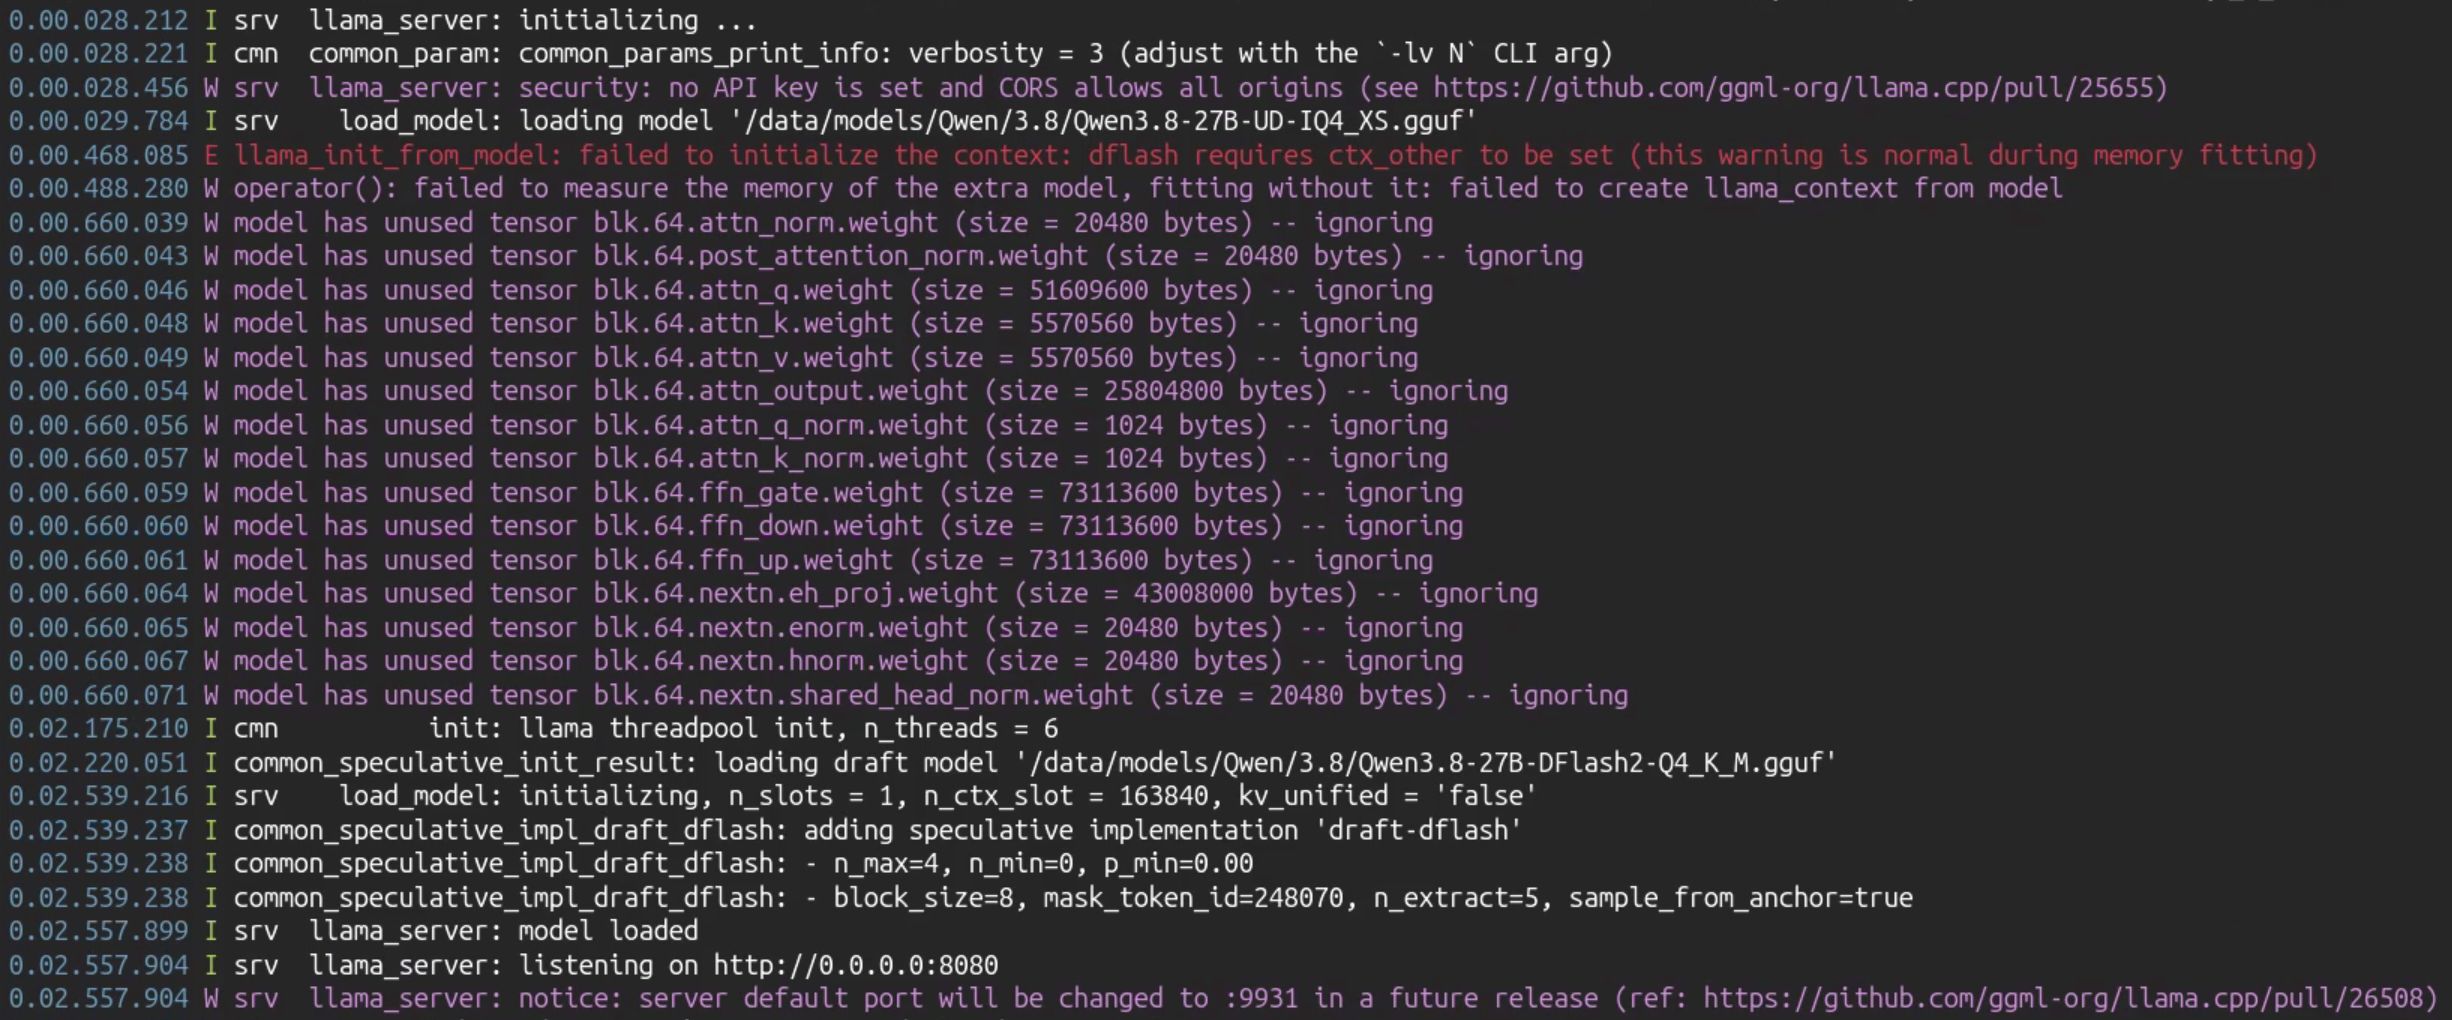
感谢各开源社区和大牛们的努力,每月每周都有惊喜!
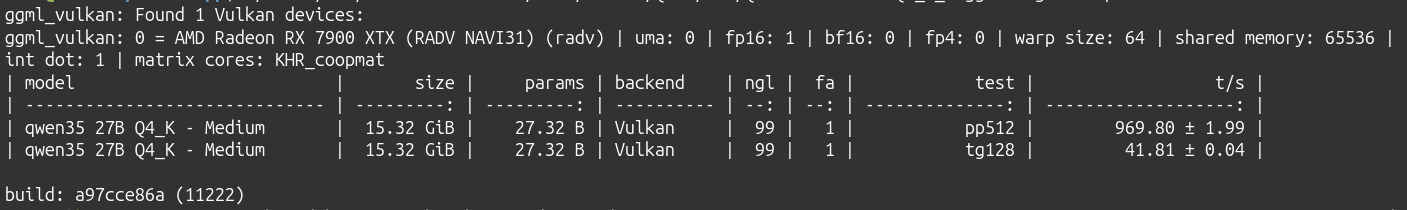
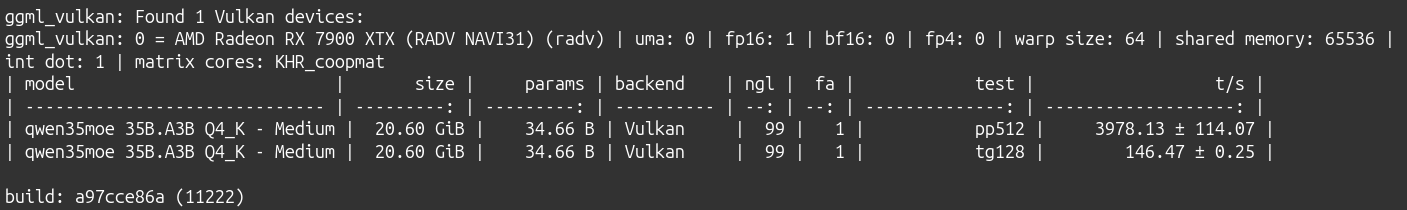
今天刷到reddit一个新帖,说 https://github.com/ggml-org/llama.cpp/commit/70c4e1582e37e4fd94104eb09301711a0f2675bc 这个 commit(70c4e15)是 llama.cpp 中一个重要的 Vulkan 后端性能优化,核心是为 AMD RDNA3 和 RDNA4 架构的 GPU 实现了 int8 量化矩阵乘法(matmul) 的硬件加速支持,能大幅提升9700XTX的prefill性能。看帖子贴出的图示,貌似针对9B的模型,prefill提升了近30%。
这个commit是9月24日提交的,刚好在v0.5.0发布的第二天。我赶紧更新到最新版实测,可惜在我本机针对Qwen3.8-27B模型,只有5%左右的提升。不过也好,蚊子肉也是肉。
Before:
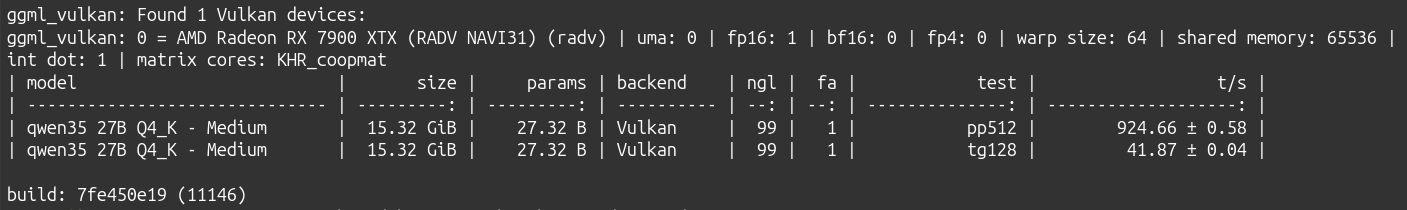
After:
Qwen3.6-35B-A3B 这种MoE型好一点,但在我本机也只有8%左右的提升。
Before:
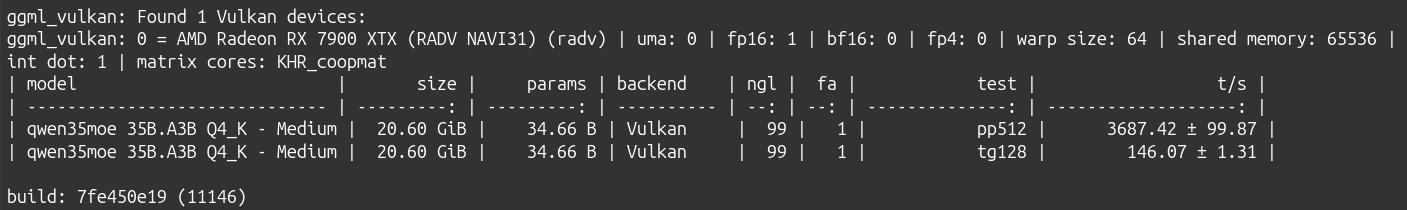
After:
我是llama.cpp + Qwen3.6-27B + hermes 重度使用者,每天至少1个小时以上。基本上智能家居+网络配置+日常电脑任务+记账 都转到AI上了。三者配合最大的问题还是prompt重算的问题,初略统计,基本上context累计到40-50K以上(尤其是频繁工具调用),就会开始出现prompt重算,之后越聊会越频繁。到最后基本就不可用了。为了缓解这个问题,频繁调试llama.cpp启动参数,都无法彻底解决。
好在一直都有人在致力于优化,我相信终会得到解决。以下是近期一些prompt重算问题的进展:
https://huggingface.co/froggeric/Qwen-Fixed-Chat-Templates 更新到了v21版本,我更新它之后,解决了hermes新版读取memory报错的一个bug(hermes自己分析是prompt/template 格式问题)。但对prompt重算改善不大。
https://github.com/ggml-org/llama.cpp/issues/22746#issuecomment-4843582985 这个issue持续有人在跟进,并提供了patch。开源的意义就在于此。
@williamlouis 谢谢 ,开拓思路了。
跟随坛友脚本,618购入了华南金牌X99-CD3主板。质量确实还可以。几个不足之处及应对:
还有一个问题暂时无解,即MOS小风扇转速太快导致噪音很大,且是2pin接口没法在BIOS里调整。自行搜索+AI,推荐的方法是使用降压线,或者干脆拔掉。论坛里其他使用该系列主板的坛友有相关经验吗?
这个问题也困扰我很久,目前用chat template 补丁,还是有不少改善:
https://lcz.me/post/5404
@CHIA-AN-YANG 与你情况相同 暂时无解,睡一觉明天再说。
@kevon 我之前显卡是5060Ti 16G,也是Qwen3.6-27B-Q4太慢,最终转向Qwen36-35B-A3B-Q4,还不错,速度能到60+t/s,接Hermes完全可用。智力是差一些,执行长链条的任务会掉链子(比如调用无头浏览器执行一系列操作),但一般性的任务还行。 奈何被这论坛洗脑,按捺不住还是换了7900XTX,27B-Q4是爽了。但是又想Q6和Q8了,本地AI就是坑啊。
Colt 说:
cmake -B server/build -S server -DCMAKE_BUILD_TYPE=Release -DDFLASH27B_GPU_BACKEND=hip -DCMAKE_HIP_ARCHITECTURES=gfx1100 -DROCM_PATH=/opt/rocm-7.2.3 -DDFLASH27B_HIP_SM80_EQUIV=ON -DCMAKE_C_STANDARD=11 -DCMAKE_CXX_STANDARD=17 -DGGML_CCACHE=OFF
还是靠Hermes,它5秒就定位问题,然后搞定了。编译的时候不能用 -DCMAKE_HIP_ARCHITECTURES=gfx1100。
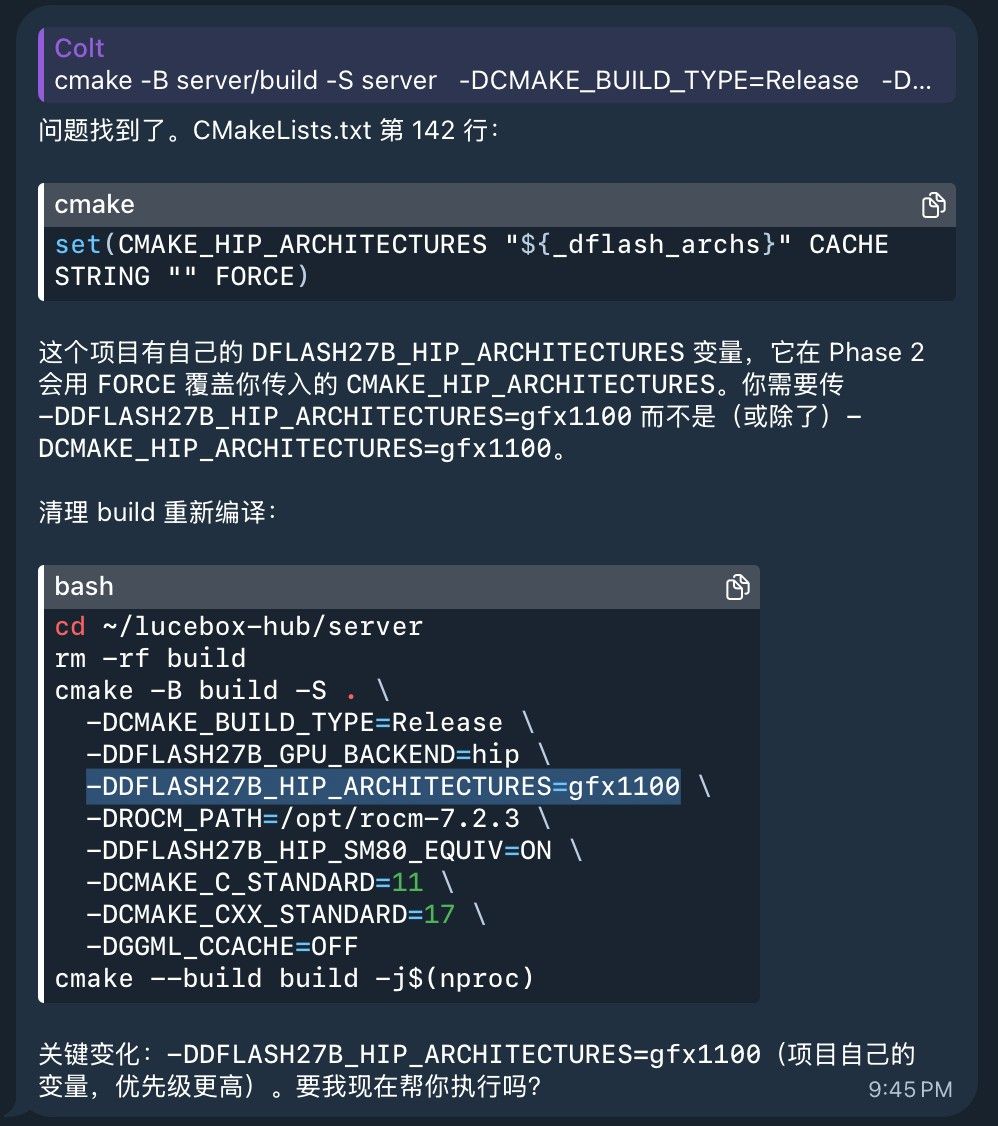
同为7900XTX,想抄作业,ubuntu26.04,之前已安装了ROCm 7.2.3,并编译llama.cpp 正常运行。这次在编译和运行test_dflash 遭遇不少挫折,最终通过如下命令编译成功:
cmake -B server/build -S server   -DCMAKE_BUILD_TYPE=Release   -DDFLASH27B_GPU_BACKEND=hip   -DCMAKE_HIP_ARCHITECTURES=gfx1100   -DROCM_PATH=/opt/rocm-7.2.3   -DDFLASH27B_HIP_SM80_EQUIV=ON   -DCMAKE_C_STANDARD=11   -DCMAKE_CXX_STANDARD=17   -DGGML_CCACHE=OFF
cmake --build server/build --target test_dflash -j$(nproc)
但是跑bench全部失败,单独运行test_dflash,错误信息如下:
LD_LIBRARY_PATH=/opt/rocm/lib:$LD_LIBRARY_PATH HSA_OVERRIDE_GFX_VERSION=11.0.0 DFLASH27B_DRAFT_SWA=2048 DFLASH27B_PREFILL_UBATCH=32 /home/user/lucebox-hub/server/build/test_dflash /data/models/Qwen/Qwen3.6-27B-Q4_K_M.gguf /data/models/Lucebox/dflash-draft-3.6-q8_0.gguf /tmp/dflash_bench/he_prompt_Qwen_Qwen3.5-27B_00.bin 128 /tmp/out_test.bin --fa-window 0 --ddtree --ddtree-budget=8
[cfg] seq_verify=0 fast_rollback=1 ddtree=1 budget=8 temp=1.00 chain_seed=1 fa_window=2048 draft_swa=2048 draft_ctx_max=4096 draft_feature_mirror=0 peer_access=0 target_gpu=0 draft_gpu=0
ggml_cuda_init: found 1 ROCm devices (Total VRAM: 24560 MiB):
  Device 0: Radeon RX 7900 XTX, gfx1100 (0x1100), VMM: no, Wave Size: 32, VRAM: 24560 MiB
[loader] eos_id=248046 eos_chat_id=-1
[target] target loaded: layers [0,64) output=1, 850 tensors on GPU 14.99 GiB, tok_embd 682 MiB CPU-only (q4_K)
[draft]  loaded
[draft]  SWA layers: 4/5 (window=2048)
[prompt] 125 tokens
[prefill] token-seg ubatch=32
Segmentation fault         (core dumped) LD_LIBRARY_PATH=/opt/rocm/lib:$LD_LIBRARY_PATH HSA_OVERRIDE_GFX_VERSION=11.0.0 DFLASH27B_DRAFT_SWA=2048 DFLASH27B_PREFILL_UBATCH=32 /home/colt/lucebox-hub/server/build/test_dflash /data/models/Qwen/Qwen3.6-27B-Q4_K_M.gguf /data/models/Lucebox/dflash-draft-3.6-q8_0.gguf he_prompt_Qwen_Qwen3.5-27B_00.bin 128 /tmp/out_test.bin --fa-window 0 --ddtree --ddtree-budget=8
dmesg 错误日志
traps: test_dflash[35252] general protection fault ip:755a83ab097f sp:7ffd64484780 error:0 in libamdhip64.so.7.2.70203[2b097f,755a83823000+481000]
问遍AI,不得其解。目前尚无头绪,不确定是否为ROCm的版本导致。我看楼主也是7.2版本,请教楼主是否曾经遇到类似问题。不到万不得已,实在不想折腾退回ROCm 6.3。
@Chan-Ivan 请问楼主,散热有没有问题啊?看图两张7900XTX之间还有多少空间?
更新下,又发现了一个基于 froggeric 的模板再优化的版本:https://huggingface.co/spiritbuun/buun-Qwen3.6-chat_template 。自己用了两天,如果是一般性的聊天,几乎不再会缓存重建。但调用browser等工具引发大量token引入的情况下,还是会发生。不过已经改善良多了,感谢作者。
下载地址: https://huggingface.co/spiritbuun/buun-Qwen3.6-chat_template/tree/main
另外,我让Hermes监控llama.cpp的输出日志,自己跑两组测试,看看还可以调整哪些参数进一步优化缓存重建的问题。 它调试分析后建议就我的硬件情况,可增加如下参数 --ctx-checkpoints 32 --checkpoint-min-step 256 --cache-ram 12288。大家也可以自己试试。