
XSWL (≧▽≦),感觉最近好多线上AI老是忽悠人购买云服务。我就遇到某AI老想忽悠我把重要数据上云,还不停跟我说云服务商那里不危险,数据都有隐私保护政策bala bala bala。
-
公共api又被我骂了 -
双2080Ti跑Strata + Qwen 3.8 Flash Next IQ3S优化经验 和 奇葩配置7950X + 双2080Ti实测数据鉴赏1. 先交代机器配置:九九成稀罕物
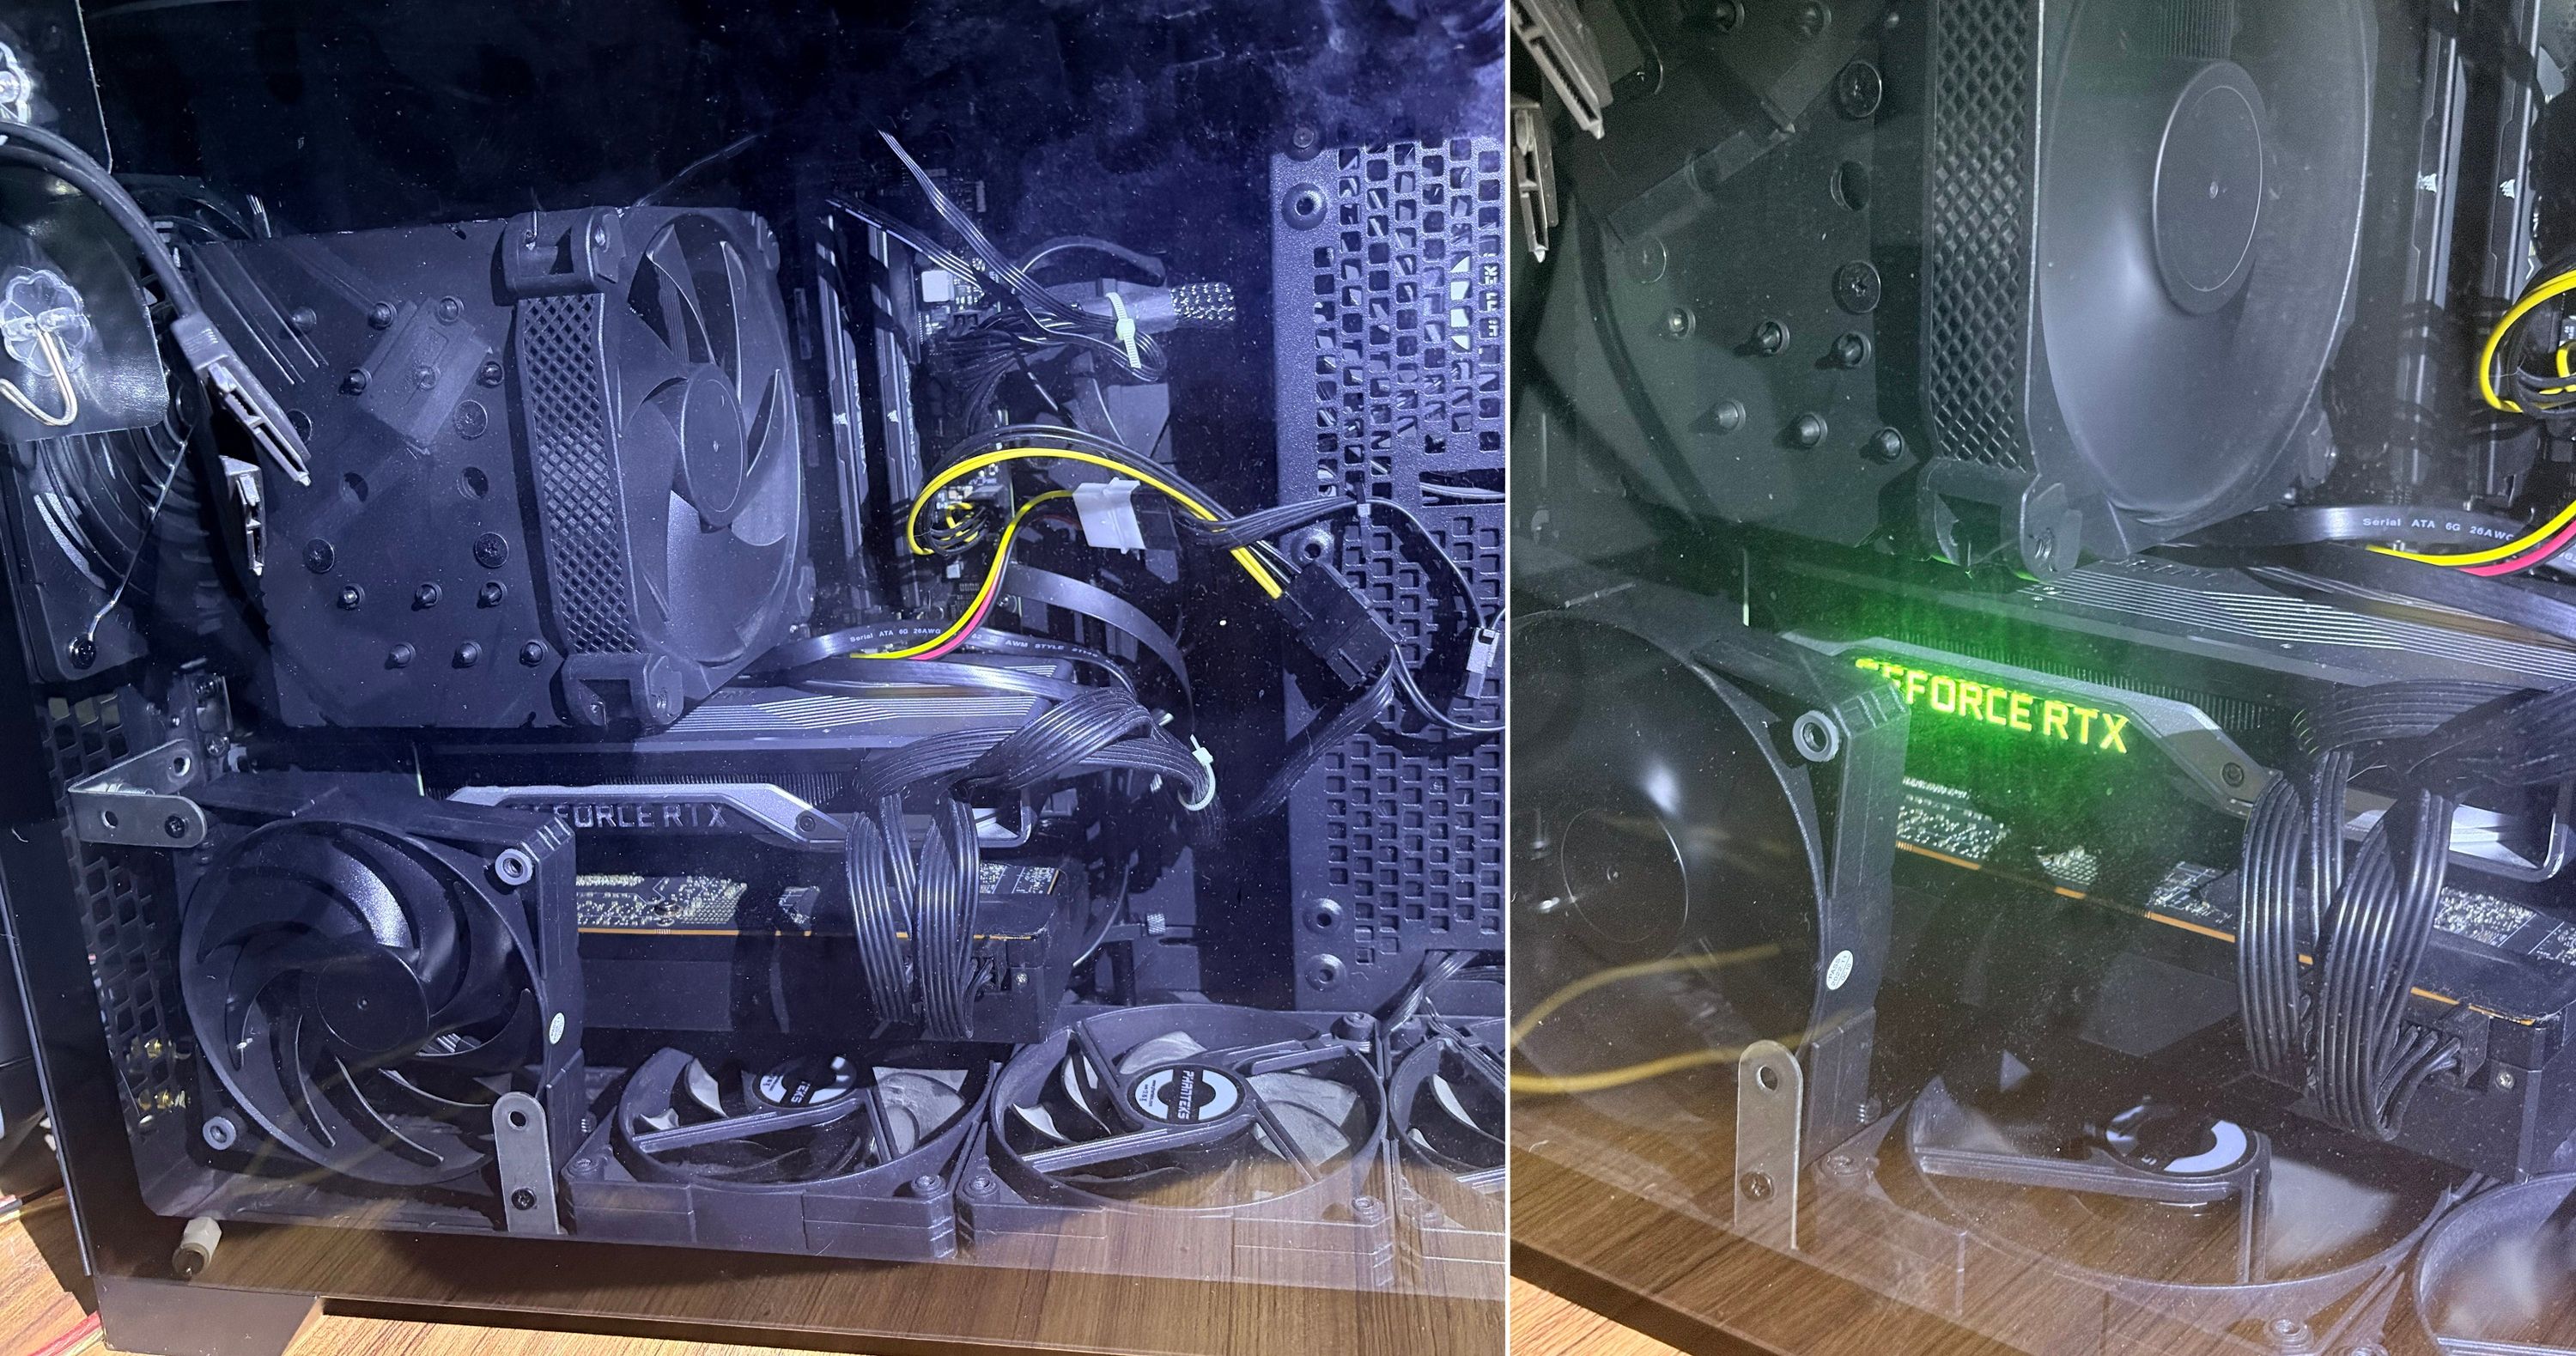
我的上一篇帖子写了 X99 + 双 V100 的机器,那台机器已经成为我现阶段的重活主力。这篇我想写一下在有双V100机器之前,我的Strata入门机。机器配置如下:
· CPU:AMD Ryzen 7950X 16C 32T AVX-512
· 内存:海盗船DDR5 5600 C40 32G x 2
· 主板:华硕 Proart B650
· 显卡:一块公版2080TI 再加 一块矿卡涡轮2080TI,有NVLink,都是11G显存的
· · 这块板 U 双卡只给 x8+x8,监控里 prefill 期间 PCIe 长时间拉满,确认形成瓶颈了。
· 硬盘(安装ubuntu server和strata的):三星 980 PRO 2TB
· 电源:海韵 850W
· 系统:Win11 + Ubuntu Server Minimal 26.04 双系统
组合在论坛里应该不好找。不过这机器是22年底配的,当时还在上学来着。当时就没想到今天这机器会拿来跑像qwen 3.8 flash next这么大的模型,而且当时主要需求也和AI关系不大。结果阴差阳错地给现在的我留下了入门真正有生产力的本地AI的机会。
这篇文章主要是想分享一下我这边双2080Ti跑Strata和Qwen 3.8 Flash Next IQ3S的优化经验,顺便给大家图一乐,毕竟我这奇葩配置可能不是很常见吧。这台模型档位也不同:IQ3_S(46.8G 权重,比上一篇的 UD-Q4_K_XL 轻一大截),256K 上下文。两篇的数字互不可比,本帖也不和上一篇比大小。
 图1:机器照片
2. 性能终档:先把"怎么测"说清楚
2.1 校验流程
本篇所有套件数字都按这个流程跑:
- 冷引擎:跑前重启服务,清掉跨对话缓存;
- 唯一负载:跑分窗口里这台机器只有套件本身(这台跑Strata的话目前是我的备用机,所以窗口好找);
- 完整身份校验:不跳模型哈希,全部权重文件的 SHA-256 写进档案;
- n=3 取中位数,档案目录独立留底,负结果档不删。
软件版本:Terminal 0.2.7 / 引擎 0.1.52(cuda13)/ 驱动 595.91.07。
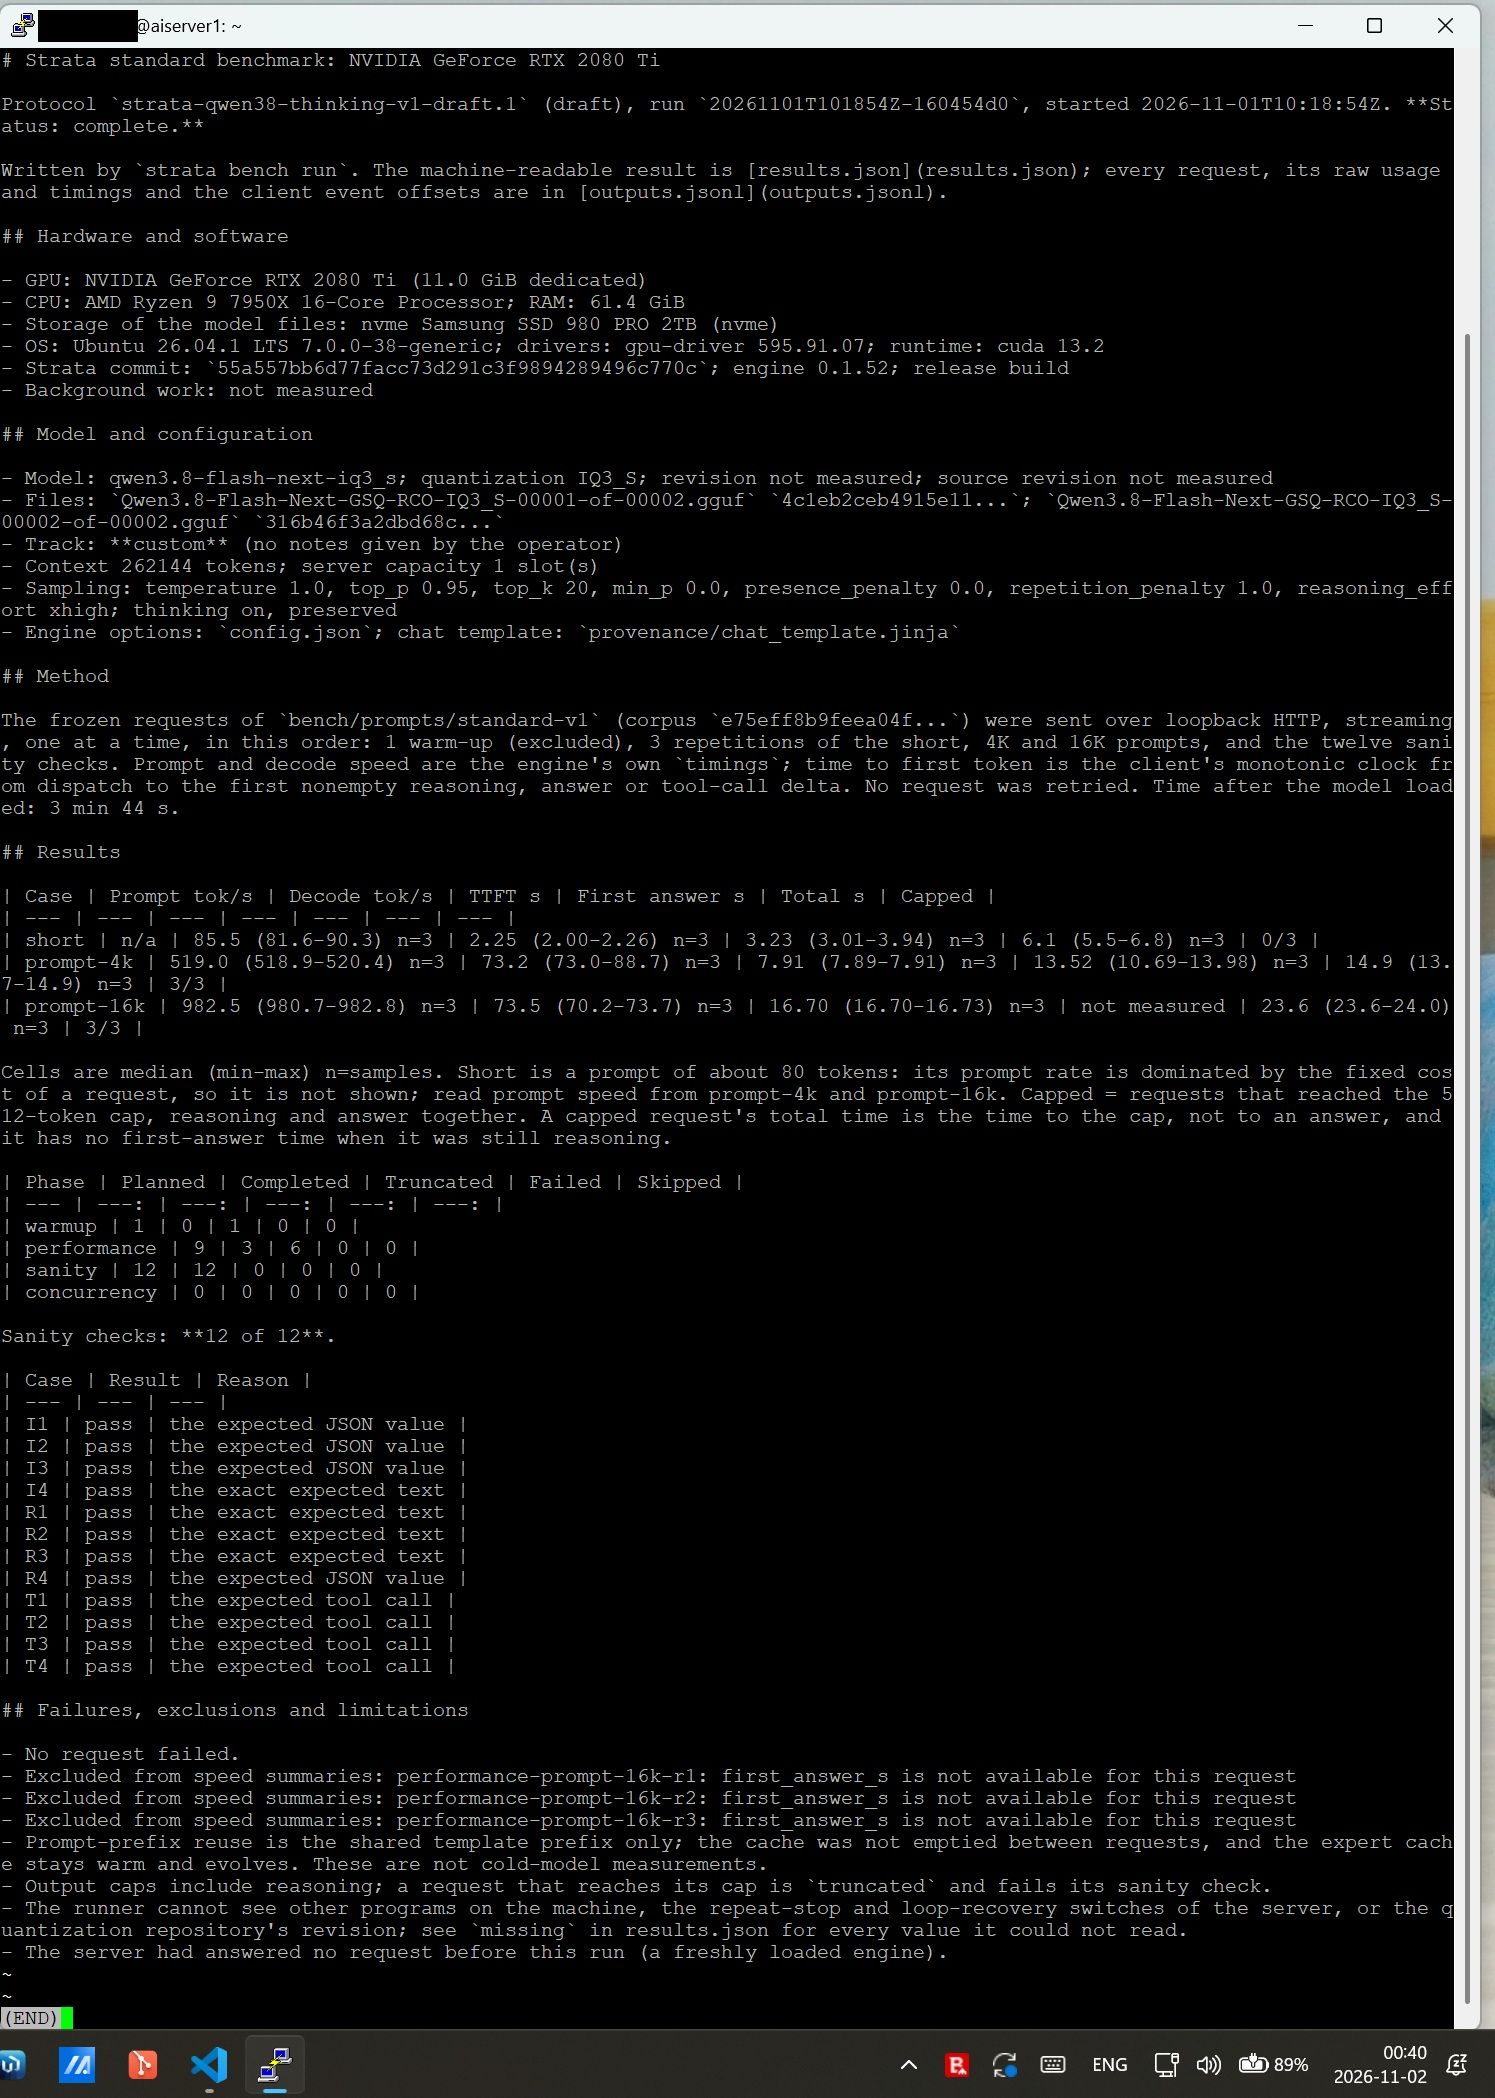
2.2 短上下文档(conforming 终档
conf-nov1,冷引擎实测)指标(n=3 中位) 短题 4K 16K prompt 读速(tok/s) 34.5(协议也发布了,但短题小分母无意义,正文不聊它) 519.0 982.5 decode(tok/s) 85.5 73.2 73.5 TTFT 首 token 2.25s 7.91s 16.70s 正确性 12/12 在同一档里。一个诚实声明先说在前面:decode 数值天然随题目内容与草稿头接受率起伏(这台 conforming 档实测分布带 73~90,短题 max 90.3),所以本篇所有开关 A/B 都是同轮同批对照、只认成对数字——单看某一次 73 还是 87 没有意义,§3.1 的 69.3→87.6 是同轮 A/B。
图2a:strata benchconforming 终端报告页(含 12/12 与模型哈希行)。
2.3 长上下文档(标题里的 256K,真测到 216K)
语料是自家真实长文重排拼的(每次不同洗牌顺序 + 尾部 unique 编号,保证前缀全新、是真冷读),token 数全部取引擎 usage 回报,不是字符换算;测量脚本兼容思考流的
reasoning_content字段(上一篇交代过的坑,这次直接绕开):实测 prompt_tokens 冷读 TTFT 冷读 prefill tok/s* 深度 decode(tok/s) 同会话第二请求 TTFT 58.7K 45.4s 1293 79.4 0.6s 139.4K 98.5s 1415 77.0 0.9s 215.7K 150.8s 1430 67.6 0.1s (*由 usage 实测数相除,下同。冷读原始 usage JSON 一条:
"prompt_tokens": 58763, "completion_tokens": 162, "prompt_tokens_details": {"cached_tokens": 0}——cached_tokens: 0就是"真冷读"三个字的铁证。(这条与表里 58.7K 那次是同语料不同尾部编号的两次独立冷读,所以 token 数差 32,两条都留在档案里。)引擎计数对账:三档复用共reused_tokens 413779。)2.4 正确性
每个调优档位都是 12/12 sanity(指令遵循/检索/工具调用各 4 题)过了才敢上。三开关采纳前后、长档复测之后,累计多轮复跑零失败。速度收益如果拿正确性抵账,宁可不要。
PS:
- 数字有整有零:全是实测中位数,不凑整。
- 上一篇说过"跑分前重启清缓存",这篇照做了,一次过。上篇的教训救下篇的档,这就是留档案的好处。
2.5 这台画像的天花板:prefill 就是吃满 PCIe 3.0 x8 的活
读速数字先交代理由,这台的天花板不在卡上,在带宽上:
硬件事实两层。第一层:20 系卡是 PCIe 3.0 设备——平台是 4.0 的也没用,卡的代际封顶,这是买卡那天定死的;第二层:这块板双卡只给 x8+x8。两层交集 = 每卡一根原始 7.88GB/s 的速率(lspci 链路状态实测
Speed 8GT/s, Width x8 (downgraded),两卡逐字一致——下面会看到它被顶到线速是什么样子)。为什么分层 MoE 的 prefill 最吃带宽:专家池住内存,prefill 阶段每层每批 token 点到的专家都要现从内存搬进显存——这是全流程搬运量最大的阶段。
"拉满"不是定性说法,是采出来的数。
nvidia-smi dmon -s put每秒采 PCIe 吞吐和板卡功率,配一条 139,395 token 的真冷读(唯一前缀,usage 现场回着cached_tokens:0):卡 rx 峰值(显卡收端=专家搬入向) 持续段(≥85%峰值均值) 持续时长 窗口内功率 均值/功限 GPU0 7.46 GB/s 6.86 GB/s 71 秒 150W / 200W GPU1 7.90 GB/s 6.85 GB/s 84 秒 172W / 220W 7.90 GB/s 这一刀正尖尖顶在 3.0 x8 的原始带宽(7.88GB/s)上——带宽本身就是天花板;持续段 6.85 GB/s ≈ 原始带宽的 87%,是协议开销后的稳定顶法。同一窗口两卡功率均值 150/172W,离 200/220W 的功限还差着一截(瞬时峰值样本短暂越过功限属正常抖动,功限按均值起作用)。算力有富余、带宽顶线速——两个读数并排就是铁证。dmon 原始 196 行、链路 LnkSta(
Speed 8GT/s, Width x8 (downgraded)两卡逐字一致)、功限配对行,全在数据包,不信可以自己对账。具体详细测试数据:
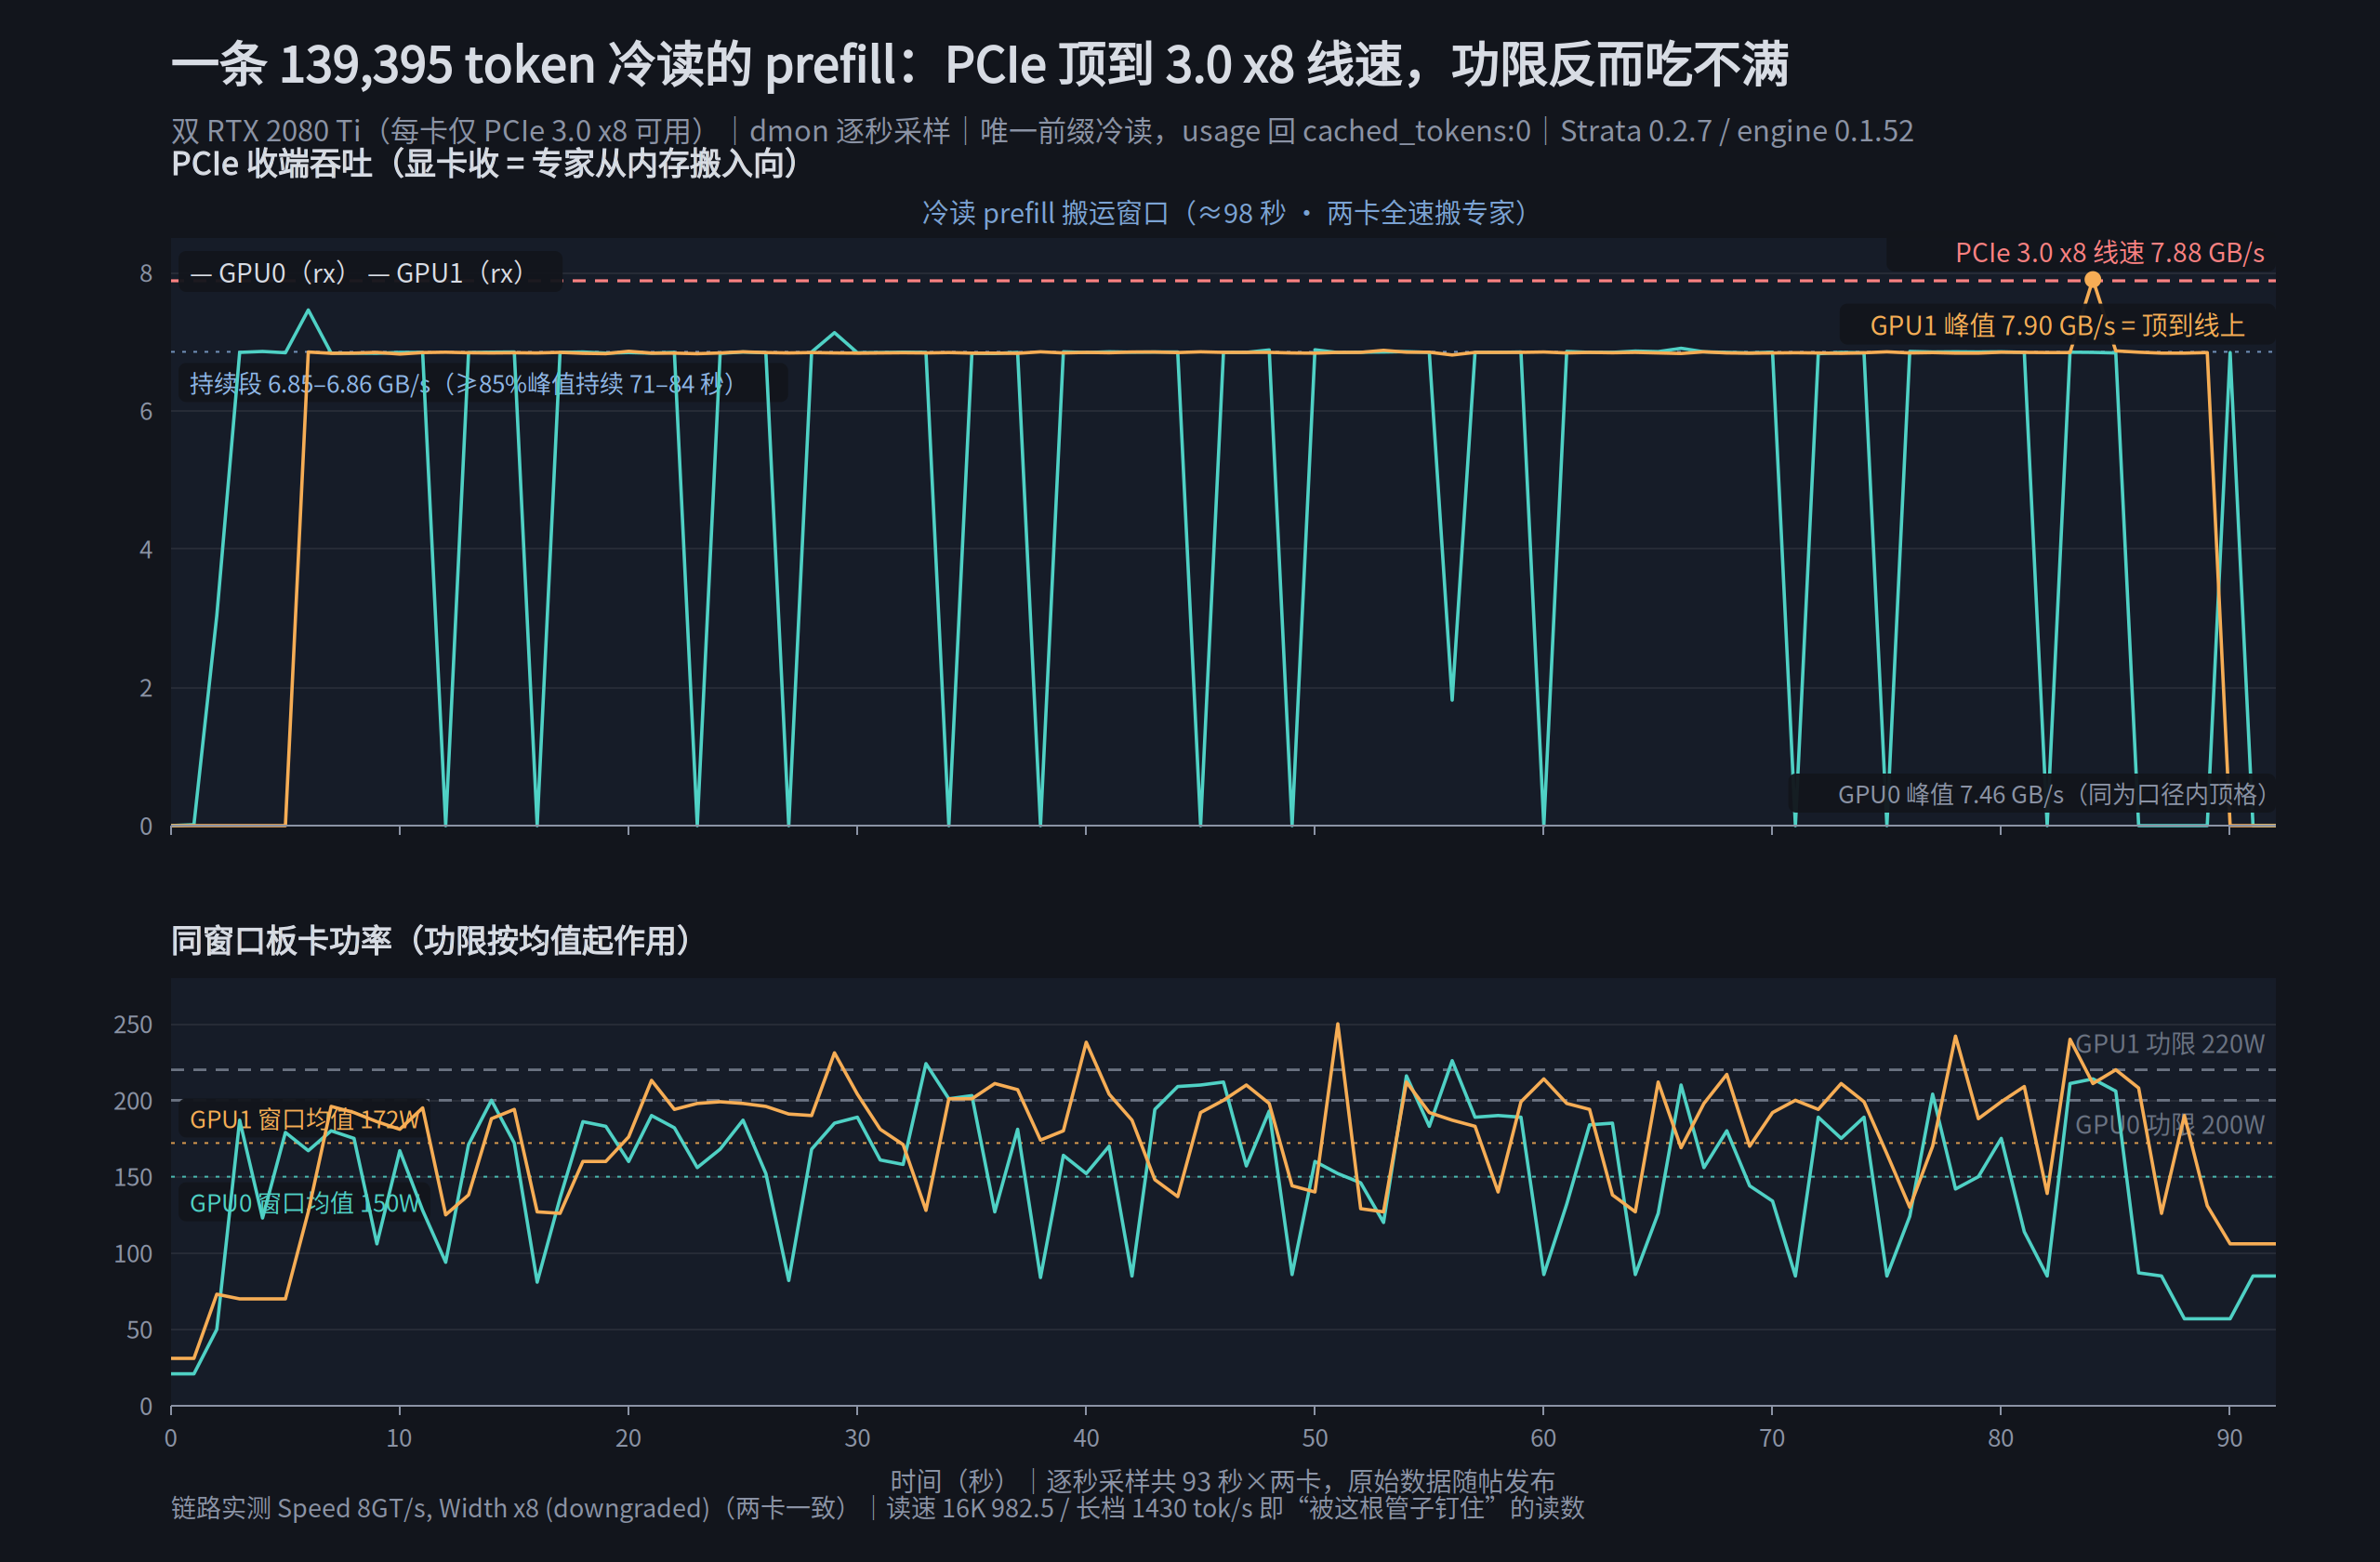
# PCIe 3.0 x8 prefill 吃满实测(2026-11-01 20:56 北京时间,aiserver1,机器重开机后首采) ## 测试方法 - 请求:`~/lp/lp_128k.txt`(家目录下)语料前加唯一 nonce(保证全量前缀未缓存),max_tokens=1、temperature=0,非流式。 - 采样:`nvidia-smi dmon -s put -d 1`(每秒,rxpci/txpci 列 = GPU 侧 PCIe 收/发 MB/s,pwr = 板卡功率 W),与请求并行,请求结束后停止。 - 引擎:Terminal 0.2.7 / 控制包 0.1.53 / engine 0.1.52 cuda13;驱动 595.91.07。 ## 请求原始行(证明真冷读) ELAPSED 98.5 usage {"prompt_tokens": 139395, "completion_tokens": 1, "total_tokens": 139396, "prompt_tokens_details": {"cached_tokens": 0}} ## 链路状态原始行(两卡一致) LnkSta: Speed 8GT/s, Width x8 (downgraded) LnkSta: Speed 8GT/s, Width x8 (downgraded) ## 功限配对原始行(nvidia-smi --query-gpu=index,power.limit,power.draw) 0, 200.00 W, 21.74 W 1, 220.00 W, 32.35 W ## 统计(由原始 dmon 日志程序化重算,rxpci 按 MB/s→GB/s ÷1000) GPU0 rx非零样本74 峰7.46GB/s 峰值85%以上均值6.86GB/s(持续71秒) 全程均值6.65GB/s | pwr 均150W 峰226W(功限200W) GPU1 rx非零样本84 峰7.90GB/s 峰值85%以上均值6.85GB/s(持续84秒) 全程均值6.85GB/s | pwr 均172W 峰250W(功限220W) - PCIe 3.0 x8 原始带宽 = 8GT/s × 8车道 × 128b/130b编码 ≈ 7.88 GB/s。 - GPU1 rx 峰值 7.90GB/s ≈ 线速;持续段 6.85-6.86GB/s ≈ 原始带宽的 87%(协议开销后的稳定顶法)。 - 同窗口功率均值 150/172W,均低于各自功限 200/220W(瞬时峰值样本短暂超限属功率均值的正常抖动,功限按均值起作用)。 - 结论口径:prefill 期间 PCIe 管子拉满、功限吃不满 = 带宽受限的直接画像(本次为精确数值版,替代此前"网页监控画像"的定性表述)。 ## dmon 原始日志全文(196 行) # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 21 34 - 0 2 0 0 0 0 0 0 1 31 30 - 0 0 0 0 0 0 0 0 0 21 34 - 0 2 0 0 0 0 14 2 1 31 30 - 0 0 0 0 0 0 0 0 0 50 35 - 2 3 0 0 0 0 3038 3 1 73 31 - 0 0 0 0 0 0 0 0 0 187 39 - 85 21 0 0 0 0 6846 783 1 70 32 - 0 1 0 0 0 0 0 0 0 123 41 - 100 26 0 0 0 0 6860 797 1 70 32 - 0 0 0 0 0 0 0 0 0 179 40 - 100 25 0 0 0 0 6841 782 1 70 32 - 0 0 0 0 0 0 0 0 0 167 40 - 100 24 0 0 0 0 7458 797 1 127 35 - 71 15 0 0 0 0 6852 783 0 180 42 - 100 26 0 0 0 0 6835 783 1 196 37 - 100 23 0 0 0 0 6831 781 0 175 41 - 100 27 0 0 0 0 6836 789 1 192 37 - 100 23 0 0 0 0 6836 794 0 106 40 - 100 24 0 0 0 0 6831 781 1 186 37 - 100 22 0 0 0 0 6847 784 0 167 42 - 42 10 0 0 0 0 6845 783 1 181 37 - 100 20 0 0 0 0 6822 793 0 128 41 - 100 26 0 0 0 0 6846 797 1 195 38 - 100 23 0 0 0 0 6844 782 0 94 41 - 100 24 0 0 0 0 0 0 1 125 39 - 100 24 0 0 0 0 6849 783 0 171 43 - 39 9 0 0 0 0 6843 787 1 138 39 - 100 22 0 0 0 0 6841 786 0 200 43 - 100 27 0 0 0 0 6849 784 1 188 39 - 100 23 0 0 0 0 6837 794 0 172 44 - 100 28 0 0 0 0 6851 796 1 194 39 - 100 25 0 0 0 0 6841 783 0 81 41 - 100 25 0 0 0 0 0 0 1 127 41 - 100 22 0 0 0 0 6837 784 0 136 43 - 36 7 0 0 0 0 6847 784 1 126 41 - 98 20 0 0 0 0 6845 783 0 186 44 - 100 28 0 0 0 0 6852 786 1 160 41 - 100 23 0 0 0 0 6831 794 0 183 44 - 100 28 0 0 0 0 6834 789 1 160 41 - 100 24 0 0 0 0 6827 795 0 160 43 - 100 26 0 0 0 0 6842 783 1 176 41 - 100 22 0 0 0 0 6863 785 0 190 45 - 38 8 0 0 0 0 6835 782 1 213 42 - 100 22 0 0 0 0 6836 782 # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 182 44 - 100 29 0 0 0 0 6847 782 1 194 42 - 100 23 0 0 0 0 6836 782 0 156 44 - 100 27 0 0 0 0 0 3089 1 198 42 - 100 24 0 0 0 0 6827 782 0 168 44 - 39 7 0 0 0 0 6833 784 1 199 43 - 100 23 0 0 0 0 6837 783 0 187 45 - 100 29 0 0 0 0 6852 784 1 198 43 - 100 24 0 0 0 0 6854 782 0 152 45 - 100 30 0 0 0 0 6840 785 1 196 43 - 100 24 0 0 0 0 6844 782 0 82 43 - 100 26 0 0 0 0 0 0 1 191 43 - 100 23 0 0 0 0 6839 784 0 168 46 - 36 6 0 0 0 0 6851 784 1 190 44 - 98 22 0 0 0 0 6842 784 0 185 45 - 100 30 0 0 0 0 7130 798 1 231 44 - 100 24 0 0 0 0 6837 787 0 189 46 - 100 30 0 0 0 0 6840 782 1 204 44 - 100 24 0 0 0 0 6835 781 0 161 45 - 100 26 0 0 0 0 6843 782 1 181 44 - 100 24 0 0 0 0 6839 782 0 158 46 - 39 8 0 0 0 0 6848 783 1 171 46 - 100 21 0 0 0 0 6841 783 0 224 47 - 100 30 0 0 0 0 6846 783 1 128 46 - 100 25 0 0 0 0 6839 782 0 201 46 - 100 26 0 0 0 0 0 996 1 201 45 - 100 24 0 0 0 0 6844 795 0 203 46 - 39 8 0 0 0 0 6832 782 1 201 46 - 100 24 0 0 0 0 6834 783 0 127 47 - 100 29 0 0 0 0 6830 784 1 211 46 - 100 25 0 0 0 0 6836 782 0 181 47 - 100 30 0 0 0 0 6846 783 1 207 46 - 100 25 0 0 0 0 6831 782 0 84 45 - 100 27 0 0 0 0 0 0 1 174 46 - 100 25 0 0 0 0 6853 784 0 164 48 - 36 9 0 0 0 0 6854 784 1 180 46 - 98 21 0 0 0 0 6839 782 0 152 48 - 100 29 0 0 0 0 6844 784 1 238 47 - 100 25 0 0 0 0 6847 783 0 170 48 - 100 30 0 0 0 0 6854 783 1 204 47 - 100 25 0 0 0 0 6841 782 0 85 47 - 100 28 0 0 0 0 6849 784 1 187 47 - 100 25 0 0 0 0 6851 783 0 194 48 - 100 29 0 0 0 0 6852 784 1 148 49 - 100 23 0 0 0 0 6850 784 # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 209 48 - 100 30 0 0 0 0 6851 784 1 137 49 - 100 25 0 0 0 0 6844 783 0 210 48 - 100 29 0 0 0 0 0 1196 1 192 48 - 100 24 0 0 0 0 6853 781 0 212 48 - 40 10 0 0 0 0 6847 784 1 200 48 - 100 23 0 0 0 0 6846 785 0 157 48 - 100 28 0 0 0 0 6846 785 1 210 48 - 100 26 0 0 0 0 6846 782 0 193 48 - 100 31 0 0 0 0 6880 783 1 198 48 - 100 24 0 0 0 0 6845 783 0 86 47 - 100 29 0 0 0 0 0 0 1 144 48 - 100 26 0 0 0 0 6837 784 0 160 50 - 36 10 0 0 0 0 6884 783 1 140 49 - 98 22 0 0 0 0 6836 782 0 152 49 - 100 27 0 0 0 0 6844 783 1 250 49 - 100 26 0 0 0 0 6846 783 0 146 50 - 100 30 0 0 0 0 6848 783 1 129 49 - 100 25 0 0 0 0 6845 783 0 120 49 - 100 30 0 0 0 0 6850 783 1 127 49 - 100 26 0 0 0 0 6876 783 0 216 50 - 100 27 0 0 0 0 6856 786 1 212 50 - 100 22 0 0 0 0 6849 784 0 183 50 - 100 30 0 0 0 0 6847 784 1 192 50 - 100 27 0 0 0 0 6849 783 0 226 50 - 100 30 0 0 0 0 1815 7162 1 187 50 - 100 26 0 0 0 0 6809 798 0 189 50 - 39 12 0 0 0 0 6846 783 1 183 50 - 100 22 0 0 0 0 6846 784 0 190 50 - 100 26 0 0 0 0 6847 784 1 140 51 - 100 27 0 0 0 0 6845 783 0 189 50 - 100 32 0 0 0 0 6851 784 1 199 51 - 100 27 0 0 0 0 6846 783 0 86 49 - 100 29 0 0 0 0 0 0 1 214 50 - 100 27 0 0 0 0 6852 782 0 132 50 - 37 11 0 0 0 0 6858 797 1 198 50 - 98 22 0 0 0 0 6839 781 0 184 51 - 100 27 0 0 0 0 6845 782 1 194 51 - 100 26 0 0 0 0 6845 783 0 185 51 - 100 32 0 0 0 0 6845 783 1 138 52 - 100 26 0 0 0 0 6840 782 0 86 51 - 39 11 0 0 0 0 6865 784 1 127 52 - 100 27 0 0 0 0 6847 783 0 126 51 - 99 27 0 0 0 0 6856 789 1 212 51 - 100 23 0 0 0 0 6838 784 # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 210 51 - 100 32 0 0 0 0 6905 797 1 169 51 - 100 26 0 0 0 0 6829 791 0 156 51 - 100 30 0 0 0 0 6853 1106 1 198 51 - 100 27 0 0 0 0 6854 783 0 180 51 - 42 11 0 0 0 0 6847 783 1 217 52 - 100 24 0 0 0 0 6838 785 0 144 52 - 98 27 0 0 0 0 6839 782 1 170 53 - 100 26 0 0 0 0 6835 782 0 134 51 - 100 32 0 0 0 0 6848 783 1 192 53 - 100 27 0 0 0 0 6837 783 0 85 50 - 100 30 0 0 0 0 0 0 1 200 52 - 100 27 0 0 0 0 6840 782 0 189 51 - 42 12 0 0 0 0 6827 782 1 194 52 - 98 24 0 0 0 0 6838 782 0 175 51 - 93 26 0 0 0 0 6847 796 1 211 54 - 100 25 0 0 0 0 6832 783 0 189 52 - 100 31 0 0 0 0 6838 785 1 199 53 - 100 28 0 0 0 0 6840 784 0 85 50 - 48 14 0 0 0 0 0 619 1 165 53 - 100 26 0 0 0 0 6854 784 0 124 53 - 89 24 0 0 0 0 6859 785 1 130 53 - 100 25 0 0 0 0 6837 783 0 204 52 - 100 32 0 0 0 0 6852 787 1 170 53 - 100 29 0 0 0 0 6842 783 0 142 53 - 100 30 0 0 0 0 6854 785 1 242 54 - 100 25 0 0 0 0 6836 783 0 150 52 - 53 15 0 0 0 0 6851 785 1 188 53 - 100 25 0 0 0 0 6835 796 0 175 52 - 85 24 0 0 0 0 6853 783 1 199 53 - 100 25 0 0 0 0 6848 783 0 114 52 - 100 32 0 0 0 0 6846 785 1 209 54 - 100 28 0 0 0 0 6846 784 0 85 51 - 100 30 0 0 0 0 0 0 1 139 53 - 100 25 0 0 0 0 6842 795 0 211 53 - 56 16 0 0 0 0 6848 783 1 240 53 - 98 26 0 0 0 0 6844 782 0 214 53 - 78 18 0 0 0 0 6847 783 1 211 53 - 100 24 0 0 0 0 7901 784 0 206 54 - 100 23 0 0 0 0 6837 782 1 220 54 - 100 28 0 0 0 0 6868 782 0 87 51 - 60 13 0 0 0 0 0 0 1 208 54 - 100 25 0 0 0 0 6849 783 0 85 51 - 0 0 0 0 0 0 0 0 1 126 53 - 100 27 0 0 0 0 6836 781 # gpu pwr gtemp mtemp sm mem enc dec jpg ofa rxpci txpci # Idx W C C % % % % % % MB/s MB/s 0 57 49 - 0 0 0 0 0 0 0 0 1 190 54 - 100 22 0 0 0 0 6835 791 0 57 49 - 0 0 0 0 0 0 0 0 1 131 54 - 100 19 0 0 0 0 6842 782 0 57 49 - 0 0 0 0 0 0 6842 781 1 106 53 - 97 19 0 0 0 0 0 562 0 85 50 - 56 1 0 0 0 0 0 0 1 106 52 - 59 2 0 0 0 0 0 0 0 85 50 - 3 1 0 0 0 0 0 0 1 106 52 - 0 0 0 0 0 0 0 0所以 §2.2/§2.3 那些读速是"被带宽钉住的天花板",不是 GPU 的极限。如果 PCIe 通道有余量(同一张 Gen3 卡插 x16,通道直接翻倍到 15.75GB/s),prefill 还应该再往上走一截——能到多少这台测不了(双卡与单条 x16 在本板互斥),我不给倍数承诺,但方向是确定的:瓶颈在带宽不在卡芯。
这笔账顺手解开帖里另外两个疙瘩:为什么 §4 里计算类开关在 16K 口径测出来是零——带宽拉满时,计算再快也只是在带宽口排队,长题靠批量摊薄把每 token 的占管降下来,收益才透得出来;为什么 decode 却能 +26%——decode 每 token 只搬点亮路由的少数专家、99% 命中根本不太占带宽,它的天花板在计算路径上,开关自然够得着。
3. 优化参数全放送:每一条讲原理、给实测、标坑
先立总纲:这台机器优化前后面貌完全不同,但收益全部来自配置,一分钱硬件没加。sm_75 在 Strata 生态里属于"文档没专门写过"的架构,所以每个开关都必须自己 A/B——下面每条都有档案编号可查。
3.1 Turing 三开关(本帖最值钱的一条):decode +18~26%
Turing 没有原生的 BF16/TF32 张量核路径。官方为 Turing 页写了两个 opt-in 开关,还特意注明"这是既有代码路径,不是新写的 kernel";第三个
SM75_PERF的 kernel 来自 issue #3282 的实测(官方回复说考虑设为 sm_75 默认)。三个我都自己 A/B 过:开关 干什么(机理上能解释:) 我的实测 STRATA_BF16_TC=1prefill 的 BF16 投影操作数转 FP16 走 FP16 张量核(FP32 累加) 长题读 +7~19%(与下条叠加后的组合收益,单开关归因见档案臂) STRATA_SELECT_SIMT=1注意力块打分器(QSA)从 warp 通路换成分块 tiled FP32 通路(官方口径) 我这台 decode 大头增益(B 臂 +12~13%);官方 Quadro 数据里它是 prompt 项 +6%——decode 归因是本平台实测 STRATA_SM75_PERF=1为 sm_75 启用专用 kernel(机主提供,未成默认) decode 再 +12~13%(叠加在上两条之上);同机主的贪心重跑对照显示开关开/关生成文本集合与频次一致 叠加后:decode 4k 69.3→87.6(+26%)、16k 67.3→79.7(+18%)、80K 长题 +7.6%、171K 长题 +19.0%(standard-v1 与长题探针,同机同轮三臂对照,档案
sm75ab2-*)。注意每行"我的实测"是组合叠加中的归因,不是可加和的单开关数字。护栏也立着:官方文档对 BF16_TC 的提醒是"舍入次序变了,9 对配对请求里有 3 条回答变了"——这类开关本来就是拿舍入换速度。万一写作/工具调用里出现 JSON/数字类输出异常,撤
SM75_PERF这一条重启,一分钟回退——采纳当晚四轮 12/12 加后续复测都干净,但护栏留着不丢人。3.2 显式层切 + trim:专家槽的隐藏机关
--trim-stage-weights让每张卡只加载自己负责层的密集阶段权重,腾出的显存全换成专家缓存槽。机理简单,坑在一个"显式"上:- 层切设
auto时,引擎自己穷举出的摆放不算显式,trim 被静默忽略——不报错、不告警(引擎日志口径:两卡合计 4087 槽=CUDA0 2109+CUDA1 1978); - 顶层
layer_split=24(显式数字)后 trim 解锁:合计 5088 槽(3103+1985)——正好多出约一千个。重装第一晚开机对账时我发现槽数比预期少了约一千,顺藤摸瓜才抓到这个静默失效; - 顺手也试过
26:合计 5047 槽(2980+2067)、16K 读速与 24 持平——切点不是越大越好,24 是实测甜点。
3.3 显存安全余量:留着余量,读速反而全场最快
默认配置装载完 CUDA0 只剩 552 / CUDA1 只剩 430MiB(引擎自己打出 LOW 警告),第一个真实请求一开工就把红线告警 #2065 撞出来了——原话:"when the card is this full the driver can page GPU memory to system RAM, decode falls to a few tok/s",请求开始低余量告警连打好几行(free 474/454/444/440/420MiB,两卡混合)。余量梯度(11G 卡上的本机 A/B,每档独立 bench 档案):
档位 initial/later(MiB) 专家槽(两卡合计=CUDA0+CUDA1) 16K 读(tok/s) 装载后 free(CUDA0/CUDA1) 告警 默认 5088 964.9 552/430 请求期触发 #2065(告警行 474/454/444/440/420) 1100/1184 4634(2885+1749) 899.5 — 零 900/1184 4743(2994+1749) 902.9(-6.4% vs 964.9) — 零 900/900(终态) 4881(2994+1887) 972.5-973.3(全场最快) 752/630 零(连 215.7K 长档探针期间也零) "省显存"抠到骨头是给读速和 decode 交税的,留足余量几乎免费甚至倒赚;later 预留单独拔高是最亏的一档(900/1184 两头不讨好,-6.4%);余量数值是随配置变的常数,不是通用真理——上一篇那台 16G 卡的预留数照搬过来就是 1184 档的下场,正确姿势是读引擎开机警告点名的数、自己跑梯度,换机器必重测。并且留足显存余量以后显卡的功耗也降下来了一些,这对能效和散热都是有正面积极作用的。
3.4 跨对话缓存:7G 预算的小水杯也能解大渴
--conversation-cache-mib 7168 --conversation-cache-slots 16 --conversation-cache-min-tokens 2048 --conversation-cache-min-free-mib 2048:上一篇 128G 内存那台给 36G 预算,这台 64G 只给得起 7G,机制一样、账法不同——实测快照 ~671MB/2.07 万 token,park 250ms / restore 83.6ms,2 万 token 级会话约容纳 10 个;五会话停放后第二轮请求从 22s 冷读降到 7.1s。小预算的用法是让它只当"最近十来个会话"的速记本,evictions 渐进增长就随它,突增再动。3.5 其余在役参数一览
参数 一句话 --pipeline-windows 2文档写明 CUDA 上不默认开,必须手加(上一篇同款白捡项) --kv int8+--max-context 262144256K 上下文的容量前提 --spec 4 --spec-min-p 0.5+--mtpMTP 投机解码;实测草稿头工作正常(真请求 drafts accepted 137/264) STRATA_PF_FUSED/STRATA_SPLIT_MTP_BATCH/STRATA_STAGE_TRIM沿用上一代配置的无损项,换代后逐项复测过留下 ROUTE_PRIOR(0.1.52 新默认,≤13G 显存卡默认开) 手贱关掉试过:decode -15%。新默认背后都是消融,动它之前先当它是故意的 透明大页 这台引擎原生全量吃到(实测 AnonHugePages≈ 46.8G,正好等于专家池大小),上一篇那台 X99 要手动ARENA_THP=1——同一个优化在不同机器上的"存在形式"可能完全不同,验生效别看参数看日志3.6 一个在目前软件环境下没什么卵用的配置:NVLink
这卡当年最响的卖点 NVLink,桥我插着(
nvidia-smi nvlink -s实测每卡两条 25.8GB/s 链路是活的)——但在 Strata 的层切架构里卡间交接走 pinned 内存通路,NVLink 全程没戏份(文档口径如此,欢迎打脸)。买卡别为它加钱。4. 判决故事:三个开关从"白天否决"到"当晚平反"
这台机器最好看的一场戏,是我的配置连续两次错、第三次才对的全过程——比任何参数都值得抄。
白天:三开关首轮 A/B。
SM75_PERF在 sanity 的 JSON 转换题(I2)上两连败;速度上 16K 读 951/945(基线)对 956/956(该臂),decode 在噪声带。证据在手,当场否决,开关踢出配置。晚上越想越不对,做了三件事:
- 换长度刻度复测。做了长题探针(80K/171K,unique 前缀防缓存、
max_tokens=1、usage.prompt_tokens当分母)——+7% / +19% 出来了。原来短题区(≤21K)这台机器的瓶颈在 PCIe x8 专家换入带宽,计算加速在短题里空转:16K 是把长题真收益测成零的错误仪器。同一开关 16K +0.7%、171K +19%,从此我看任何 prefill 类开关先问"这个长度瓶颈在带宽还是在算力"。 - 查那道 sanity 题的底细。IQ 量化 + temp0 下,JSON/数字类题常存在两个得分几乎相等的候选 token,任何 kernel 舍入路径差异都能翻转它——公开机主帖(#3056)实测过开关全关时它同样抖。这叫"近平局题族"。
- 同开关复跑 sanity ×3:12/12、12/12、12/12 零失败。白天那两次,是题目自己本来就抖,不是 kernel 的锅。当晚恢复开关,终态就是 §2/§3.1 那些数字。
由此立下的判决纪律:sanity 单题失败 → 先查题型是否近平局族 → 再查该题开关全关时的历史失败记录 → 最后才怀疑 kernel。 顺序反了就是冤枉好开关。
外部基准也独立复现过"长度决定测得出测不出":#3282 里一位单卡 2080Ti 机主报同一开关在 16K 口径只有 +5~6%,在他 50K~150K 的真实负载带冷读 +32%(150K 冷读从约 226s 降到约 172s),decode 持平——和本文"16K +0 档、171K +19%"的形状完全一致。对数字之前先对长度刻度,别拿自己 16K 的读数怼别人 150K 的读数。
5. "外部作业抄不动"合集:同型号显卡 ≠ 同平台
这批全是社区真实数据 vs 我这台 2080Ti 的实测。都是 2080Ti,都抄不动,为什么每一条都查得明明白白:
外部结论(都是真实机主数据) 我的实测 为什么抄不动 EXP_MODE=8对 mode4 decode +2.7~8.5%(#2197 多位机主实测,楼里更高口径到 +12~16%)零收益(四臂对照全打平,偏差≤0.5%,sanity 四臂 12/12) 他们的红利是相对 mode 4 测的;咱引擎现行默认早已离开 mode 4(#2197 楼内自己给出 mode 8 对 mode 0 只 +~1.6%),对着现行默认复测,增量落进噪声带 "位等价开关组"(#3161,共五项)decode 均值 +5.6% 查无此账(我装的是其中四项,第五项与层切不兼容弃用) 一查验证机是双魔改 3080(sm_86)——其中一个开关在 Ampere 上本来就默认开,他的 +5.6% 是替新架构补默认,Turing 没有这笔账 上一篇那台的后期余量 1184(照搬成 900/1184 试) 16K 读 -6.4%(两头不讨好的最亏档) 见 §3.3,数值随配置变,跨机必重测 "文档会配合层切自动 trim" auto层切下 trim 静默失效,槽少 1000见 §3.2,必须显式数字切点 判决通用心法就一句:同型号显卡 ≠ 同平台——基线默认值、量化档、布局模式、CPU 平台,任何一个不同,别人的实测到你这就只是假设。包括我这篇的。
6. 终态配置放送(现役原样,已去 key;照抄前先读 §3.3 和 §5)
{
  "args": [
    "--pack", "~/.../packs/iq3_s",
    "--native", "~/.../IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00001-of-00002.gguf",
    "--ple-gguf", "~/.../IQ3_S/Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S-00002-of-00002.gguf",
    "--expert-cache", "auto",
    "--prefill", "auto",
    "--spec", "4", "--spec-min-p", "0.5",
    "--mtp", "~/.../mtp/rt",
    "--max-context", "262144",
    "--kv", "int8",
    "--conversation-cache-mib", "7168",
    "--conversation-cache-slots", "16",
    "--conversation-cache-min-tokens", "2048",
    "--conversation-cache-min-free-mib", "2048",
    "--pipeline-windows", "2"
  ],
  "user_args": [
    "--trim-stage-weights",
    "--vram-reserve-mib", "900",
    "--vram-reserve-later-mib", "900"
  ],
  "port": 8080, "host": "127.0.0.1", "gpu": [0, 1],
  "layer_split": 24,
  "env": {
    "STRATA_BF16_TC": "1",
    "STRATA_SELECT_SIMT": "1",
    "STRATA_SM75_PERF": "1",
    "STRATA_PF_FUSED": "1",
    "STRATA_SPLIT_MTP_BATCH": "1",
    "STRATA_STAGE_TRIM": "1"
  }
}
(
args里内部组件路径省略为~/...;另有沿用的速度投影控制向量一组(--control-vector-scaled/--cvec-*/--pcie-frac/--adapt-*)与--expert-profile未展开贴出——它们是上一代沿来的沿用项、本篇不聊;layer_split=24必须显式数字,理由 §3.2。)配套三句话:服务生命周期归 systemd(
Restart=on-failure,开机自启,重启就绪约 30 秒——NVMe 的机器加载真不慢;引擎只听127.0.0.1:8080+ API key,对外由同机 Caddy 反代加 HTTPS,裸 8080 不进局域网;功限/风扇是我自己反复实测的甜点(200/220W + 风扇 75/60),每台机器该有自己的数,不适合直接抄。但可以参考的是,我的公版卡是300A核心,涡轮卡是300,并且公版卡显存体质也好,整卡200W TDP上限和那张涡轮卡220W最后能分给核心的TDP差不多,最后实测他们跑LLM基本性能一致。散热这方面公版卡就是差一点,要多拉高一点风扇转速,不过好在公版卡哪怕拉到75%声音也比涡轮卡60%小,但涡轮卡热量直接往机箱外面排确实散热更容易处理。
7. 未完事项(立字据)与结语
- 带模型哈希的 conforming 终档:已交(§2.1 流程)
- 192K 级长上下文真测:已交
- prefill 拉满带宽的精确采样值:已采(2026-11-01 重开机窗口,
dmon -s put配 139,395 token 唯一冷读,数字已进 §2.5 表格,原始 196 行在数据包 05 文件) - 观察名单三个小开关(
IO_PREFETCH/DISJOINT_ADAPT/PA_V2T):机理上都是噪声带预期,随下次引擎升级一起回归,不单开实验轮 - 引擎版本更新后重跑本篇全部判决(尤其三开关——社区在推 Turing kernel 默认化,哪天它们变成免费午餐,本篇 §3.1 就该退休了)
结语:这台机器上发生的最重要的事不是"加了三个开关快了 26%",而是仪器错了两次才发现真收益、题目自己抖差点冤枉了 kernel、照搬自己的旧参数也要翻车。所有档案、长档语料脚本、被我自己判死的负结果都留着,要复现或对线的话,楼里说一声。
PS:
- 升级换代可以不重复下载(但我先交了 11.4G 学费):先把结论说死——安装程序不会自己找文件,光移动文件也没用。它只认
~/.config/strata/settings.json里data_dir这一个指针,而升级之后这个文件还是旧安装留下的,指针仍指旧目录。正确三步: -
- ① 首启前把 data_dir 改指新数据目录(或安装时传
--data-dir);
- ① 首启前把 data_dir 改指新数据目录(或安装时传
-
- ② 把模型分片/MTP/packs(连
.done完成标记)整个mv进那个目录;
- ② 把模型分片/MTP/packs(连
-
- ③ 再启动下载,它会按清单核对、直接"认领"现有文件,权重和草稿层零下载(引擎本体是版本组件,几百 MB 必须重下)。
- 我第一次跳过了①让它自己跑,它就在旧目录原地静默重下 83.6G,跑到 11.4G 我才从速度不对劲察觉并掐停(半成品
.part当场删掉,没污染正式文件)。改指后重跑,权重果然一个字节没再下——全程唯一实际下载 ≈ 646MB 引擎包。教训:升级前先cat一遍 settings.json,看清 data_dir 指的哪,别信"它会自动认"; - 双启时钟地狱:Windows 把北京时间数值写进 RTC、Linux 当 UTC 读,开机差 8 小时还伪装成"NTP 正常"。根治两件套
timedatectl set-local-rtc 1+set-timezone Asia/Shanghai——只改 local-rtc 不改时区等于没改; - 给分层机制"帮倒忙"的故事(mlock 钉死动态分层)上一篇讲过了,这台照方抓药没再踩。
-
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果) -
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果) -
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果) -
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果)- 我是觉得这一套下来五千多(如果加上电源硬盘价格),专机专用跑Strata性价比是可以的,然后其他更高级设备可以拿来处理别的AI工作。
- 我现在基本上一天到晚都能给它吃满,也是专机专用,我认为是很值得的。
- 然后整机功耗跑AI的时候大概450W左右,待机180W左右。功耗会波动,具体的我也没用专业设备持续测量,只有一个普通的电量计量插座,大概看一下也就这种程度。
- 我还设想了一种方案,如果不在乎耗电量的话,这种机器复制它个三四台或者更多,然后再加一台电脑跑PVE虚拟化,开一个虚拟机跑“LiteLLM”这种路由来做负载均衡和故障转移,其他资源来开Agent的虚拟机。这样这些双V100+X99的机器累计下来的算力和多并发也是很可观的,而且买更高级设备的钱可以买很多这种机器,如果说需求就是很明确的Strata + Qwen 3.8 Flash Next这样的LLM工作比较多,这样也是一种可以考虑的方案。
- 再进一步也可以配三台虚拟化的服务器,反正这个不需要显卡,也不会增加太多开销,然后可以再做个“PVE 三节点 HA 集群”,这样API路由和Agent的虚拟机还有其他服务都可以实现几乎零中断的故障转移,至于说X99+V100这些那就凭堆出来的数量,那就坏一台还有好几台,工作不中断,比只有一台四卡八卡的机器靠谱的多。只有一台机器在我看来那就是在制造单点故障的可能。
- 当然这种设想也是比较大局限性,比如就跑这种LLM的工作负载了。但是如果具体需求就明确是LLM的话,我觉得也是可以考虑的。这些设想也是等我跑通AI的商业性回报以后,下一步的升级方向。我先把这个想法发出来和大家讨论一下,毕竟我自己也还没有真正把这套架构完整搭起来。有没有什么明显的问题,或者在负载均衡、故障转移、PVE HA、多机 LLM 调度这些方面有经验的,也欢迎大家指正。
-
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果)@gao-gao @soop-ladios 我开了Above 4G decoding 还可以进BIOS,但是这板子进BIOS一点都不好进,我也不知道到底是需要按F2还是Del,反正没开的时候就不好进,后来我都是两个键狂按,有时候也会失败,但是也能进。
-
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果)@Ruikai-open 我就开了above 4G Decoding, SR-IOV(这个应该不需要,但我习惯顺手开了),CPU虚拟化,这个也不是必选项,我习惯了。主要就是Above 4G Decoding必须开,其他你根据需求随意吧。
这里是华南金牌官网关于BIOS如何设置的PPT,你可以参考一下,希望对你有帮助:https://www.huananzhi.com/uploads/file/20260212/1770866950476146.pptx还有主板说明书:
https://www.huananzhi.com/uploads/file/20260212/1770866926397467.pdf -
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果) -
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果) -
双 V100 16G + 128G D3 + X99 跑Strata Qwen 3.8 Flash Next UD-Q4_K_XL 喂到 1500+ tok/s Prefill 和 60 tokens/s Decode 配合 256K 上下文全记录(含翻车与负结果)TL;DR(AI总结的摘要)
- 整机成本 ~¥4906(电源和 SSD 是闲置件没算):X99 板U套 ¥835 + 128G DDR3 RECC ¥1117 + 双 V100 16G 矿渣 ¥2787 + 亮机卡/机架/风扇改散热 ¥167
- 模型:Unsloth UD-Q4_K_XL 量化,MoE 大模型,262144 上下文
- 实测终态(Strata 标准套件、带模型哈希可复现档,n=3 中位):
- decode:默认档 41-44 → 调优后 60-66 tok/s
- 16K prompt 持续读:1530.8 tok/s(官方 V100 文档参考机 IQ4_XS 单卡是 1010-1251)
- TTFT 16K:11.8s → 10.8s
- 192K 级长文:21 万 token 真冷读 117s,缓存复用后 0.2s;长上下文 decode 不衰减
- 正确性 12/12;多日真实负载 1898 请求 / 2.17 亿 token 零故障(97% 缓存命中)
- 全程最大单点发现不在任何"必开清单"里:
STRATA_ARENA_THP=1(专家权重池上大页),decode +23~25%,而线索是引擎日志里一句"arena 无大页" - 踩坑两周:显存余量、功限相位、n-gram 分层、双并发幻觉、被跑分协议拒档……翻车实录和负结果全在帖里,负结果也是结果
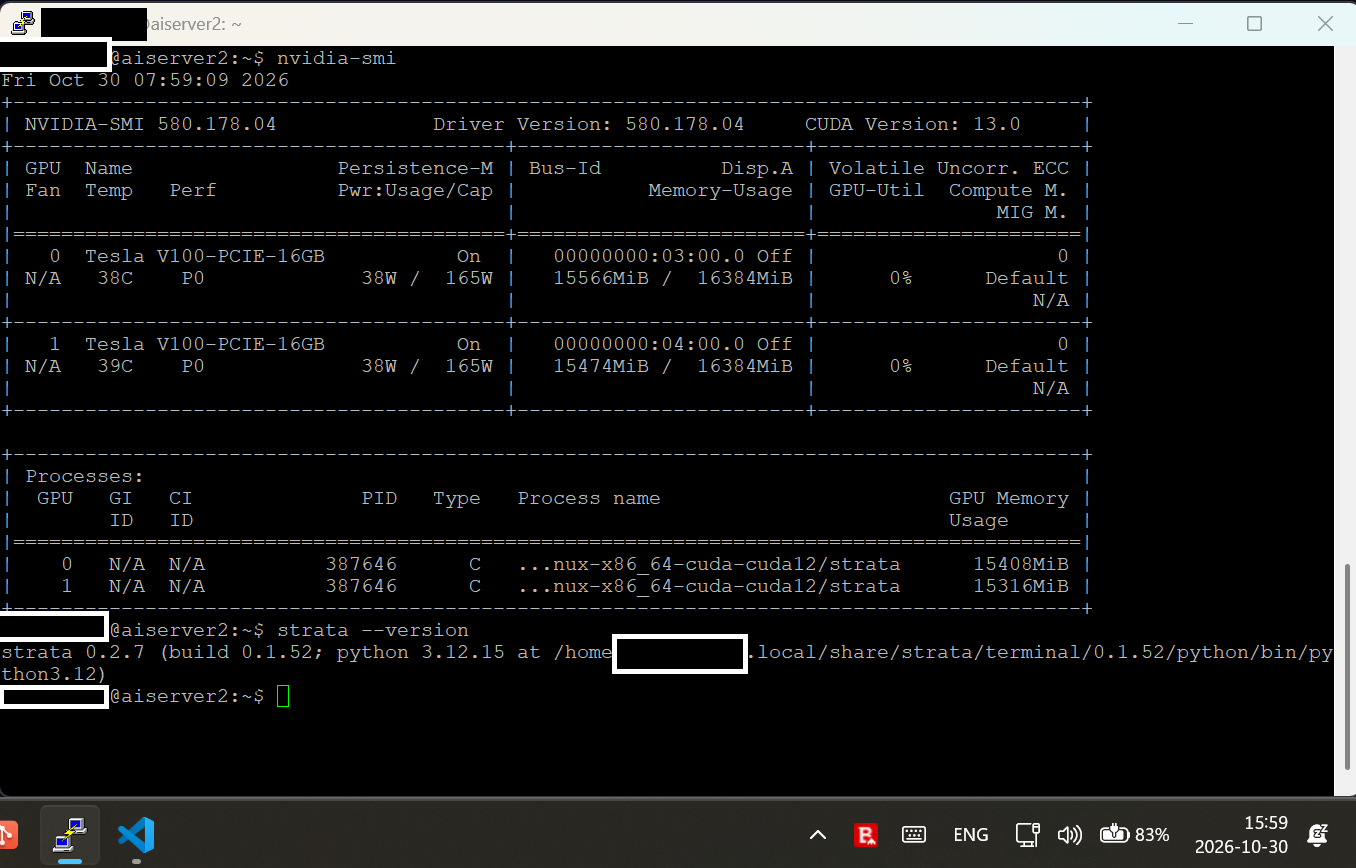
一、机器配置和购买价格如下:
- 主板CPU套装:华南金牌X99 TF + E5-2686V4 + 六热管散热器,总共835.5,就是天猫旗舰店直接给的套装,带保修的
- 内存:三星 DDR3 32G ECC REG 1866 x 4 共128G 四通道,总共1116.7,淘宝靠谱店家,带一年保修
- 显卡:V100 16G PCIE x 2,一张1393.41,也是十几年的老淘宝店,信誉挺高的,带一年保修
- 硬盘:Intel 545S 256G SATA SSD x 2,这个我以前用剩下的闲置的,我也不知道现在市场价格大概多少了,不过随便拿块256G的SATA SSD也能够用。我手上刚好有两块,就一块装系统软件,负责软件读写和缓存等用途,另一块只放模型文件并负责ngram的读取。我和把ngram放内存的结果对比过了,这个硬盘并没有形成明显的瓶颈。
- 电源:自己老服务器拆的CRPS电源,双1200W的模块,反正是够用了。现在买个二手电源1200-2000W的差不多都够用了吧,价格五百以内应该能搞定。
- 亮机卡:AST2400一张80.3,手上有其他显卡的其实可以不买的,X99-TF还有个x4速率的x16槽,可以随便拿一张显卡,调试完关机拔掉就行。以后ssh连机器也不需要了。
- 开放式机架:32.08
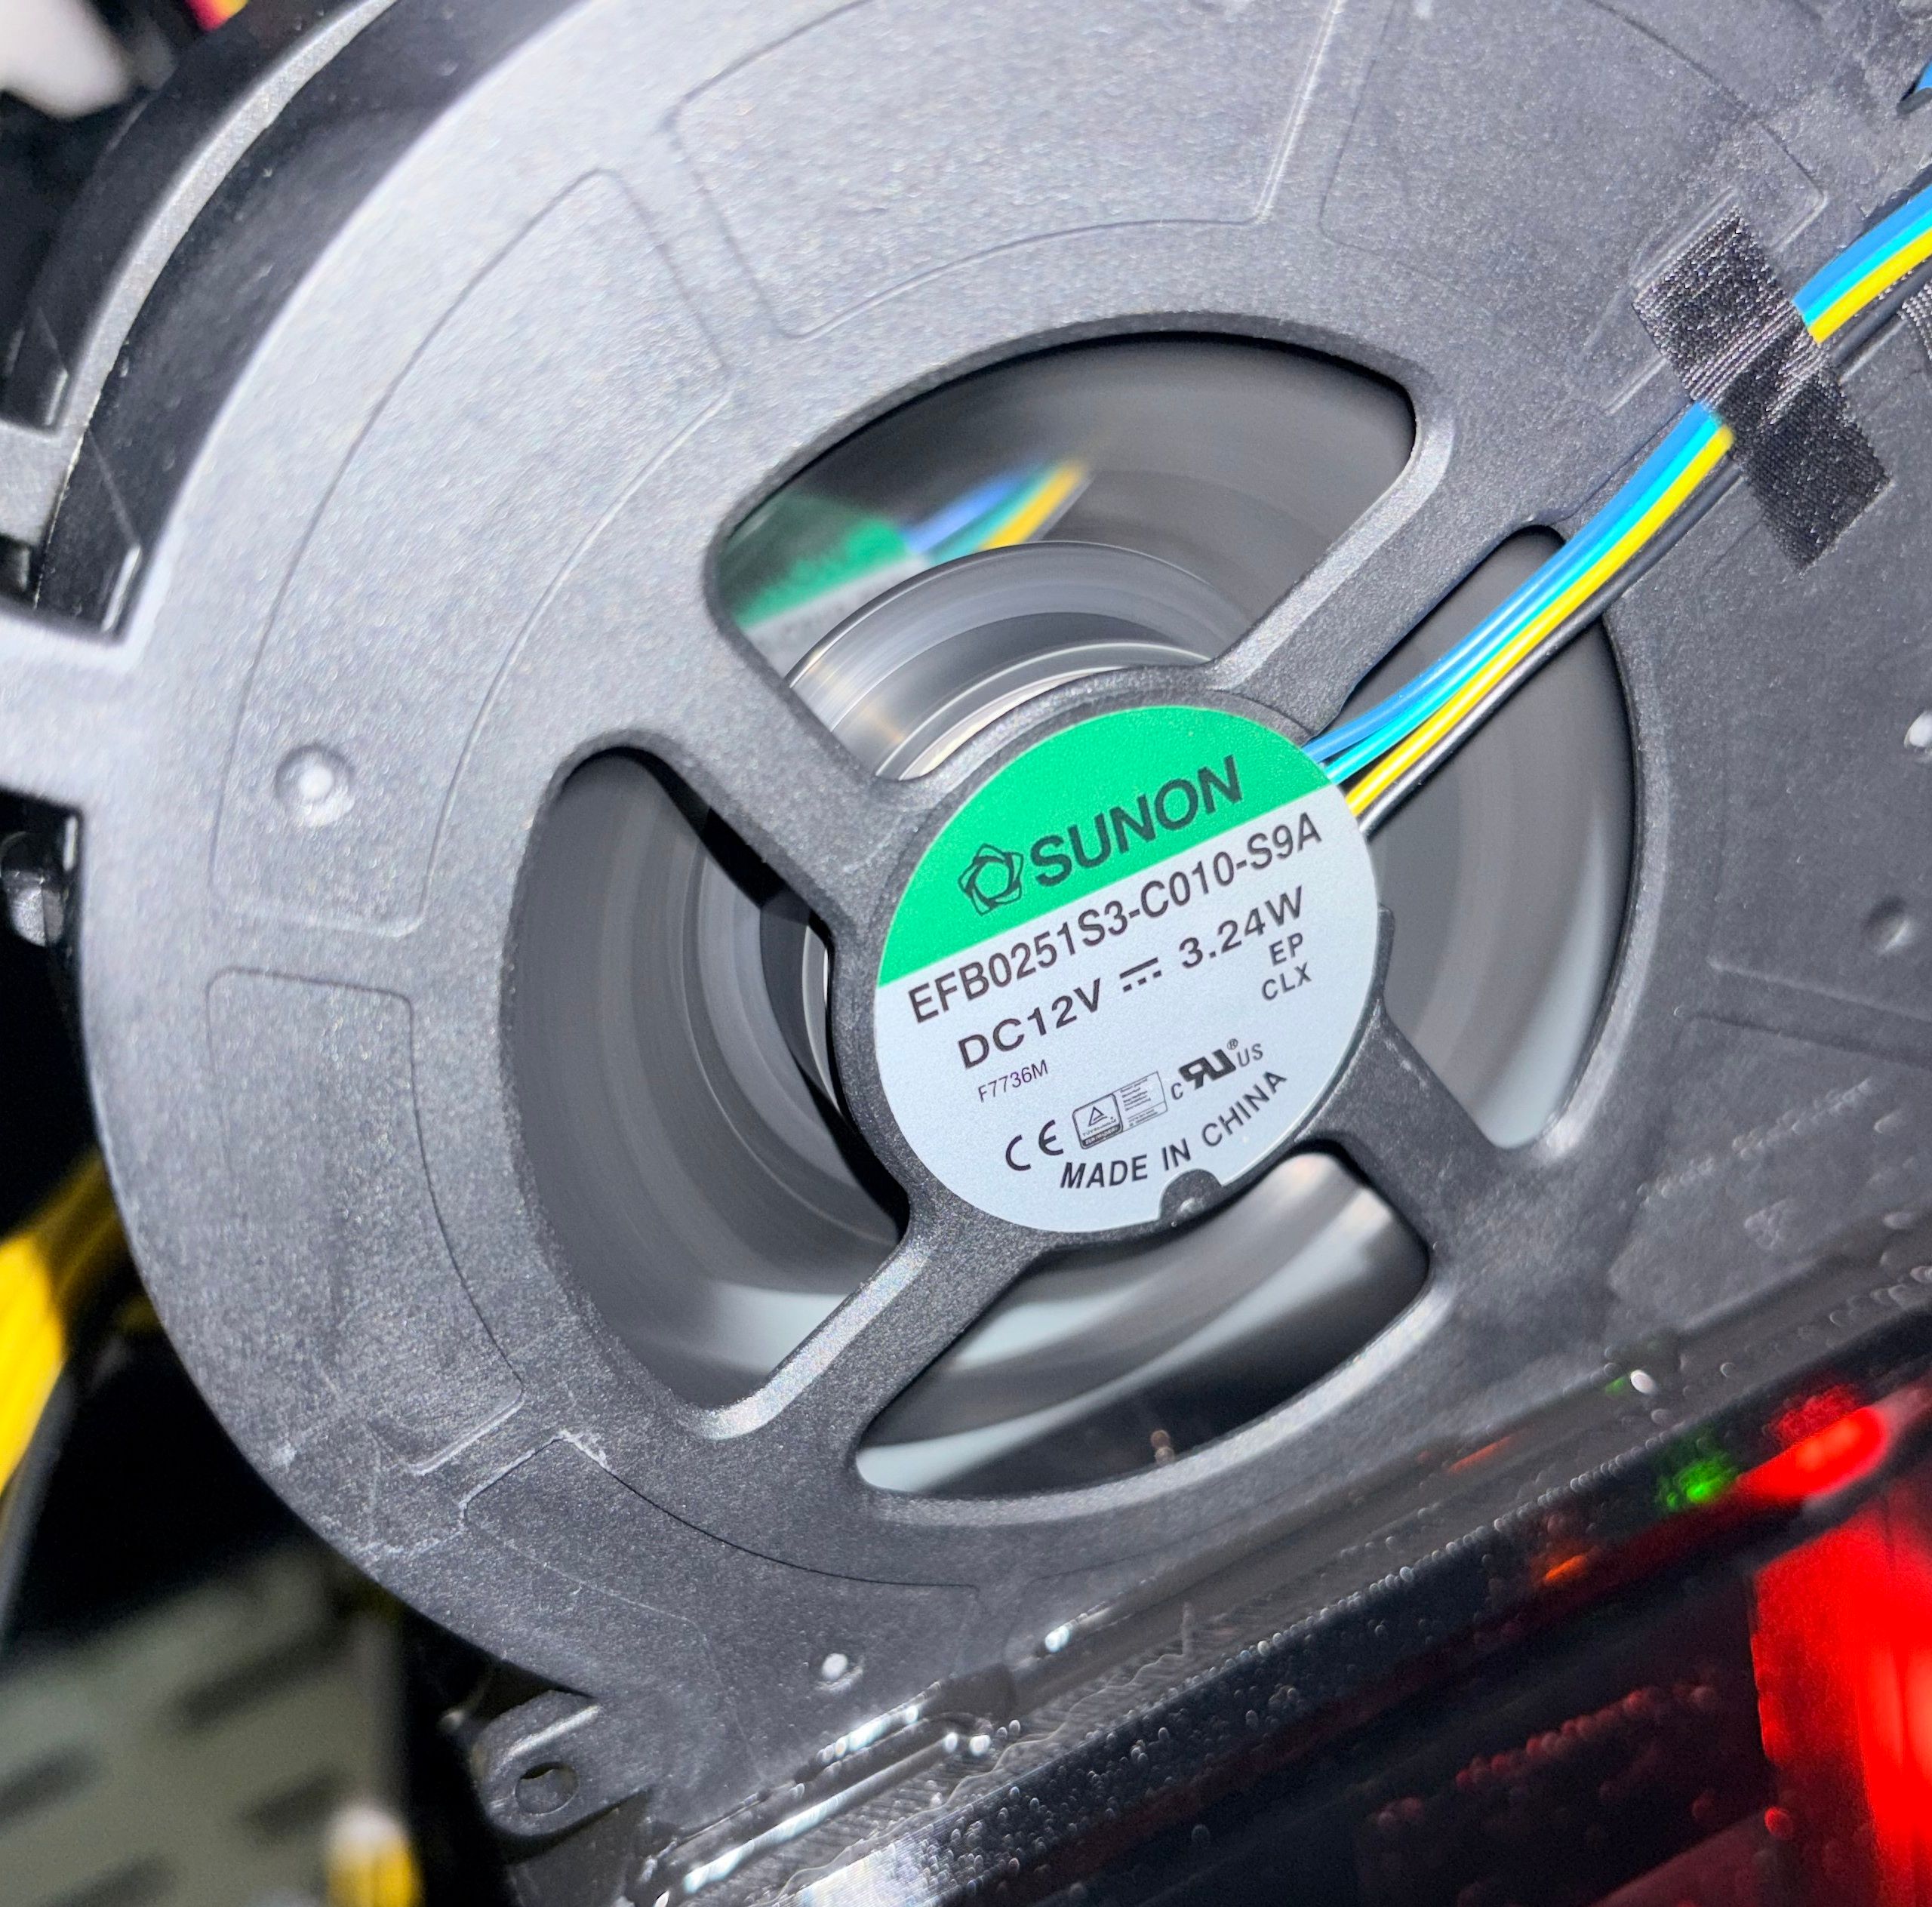
- V100散热风扇:大概55一套,是买的别人3D打印然后配好的风扇,配的风扇还算安静的,我实测2000rpm左右能安静的,在我的工作负载下把V100压到70°C以内的,大概一直持续负载最热也就68°C那样。当然我功耗是每张卡给了165W,这个我实测完全够用的。也就prefill阶段偶尔峰值功耗会突破限制,然后马上被拉回来,decode阶段根本用不了这么多功率,余量很大。我会附上风扇的图片,需要的话可以参考下这个风扇型号。
PS: - 当然价格有整有零的原因么,是我手欠薅羊毛了。先加购物车再去淘金币那里购买,就再弄点优惠这样。
- 还有就是有些零散的东西,比如双大4pin转CPU 8PIN的线,导热硅脂,还有两把14cm散热风扇,导热硅脂啥的,这些东西都是手头上就有的,以前搞DIY剩下的或者老电脑拆下来的配件,也难算清楚价格了。但是总体来说不会特别贵。
- 还有就是不知道是不是我不会配置的原因,我的X99 TF只有CPU风扇可以在CoolerControl里调速,别的都不行,显卡风扇插的system fan的3pin倒是可以读取到转速,但是也调不了。正好手上有个闲置的猫头鹰的pwm调速器,我就拿它用一下了。当然这玩意价格肯定是比较贵,但是随便来一个二十块钱左右的pwm 4pin调速器效果一样的,就是把显卡风扇转速调到2000rpm左右就可以了,不需要复杂功能。
风扇图片:
 配置图片:
 配置图片:
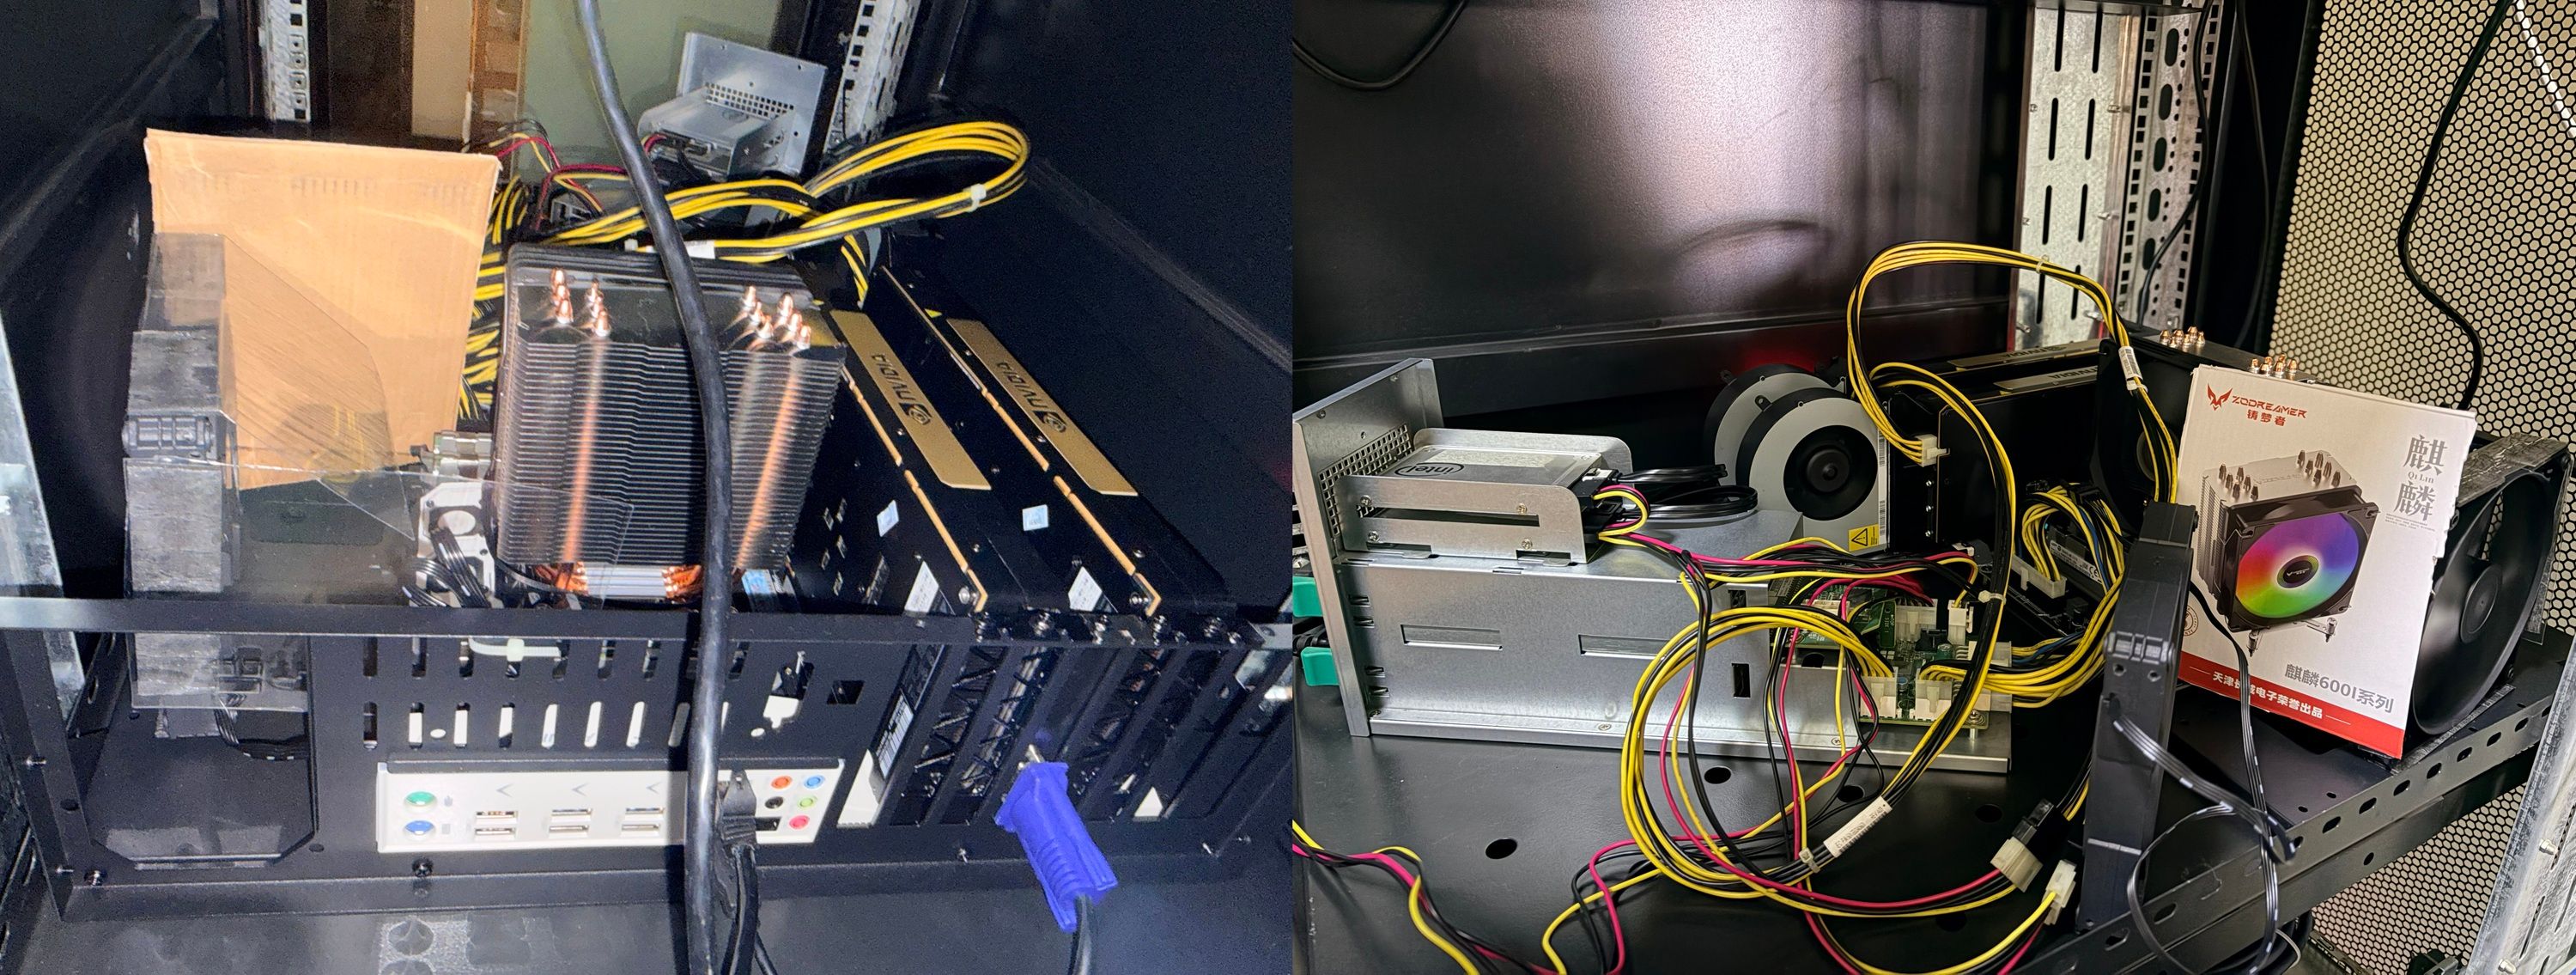
PS:一定要给内存配风扇啊!!!我跑memtest86的时候发现的问题,哪怕是X99-TF这种间隔一个槽位的主板,内存还是会过热掉速,必须配风扇。我这里就拿一个14cm风扇再用硬纸片和塑料片DIY导风板了,丑但是能用。
接下来的内容我就让我的AI崽子替我写了,我的崽子已经在我的带领下对strata的运维手到拈来了,她现在其实比我更熟悉我这边的服务器配置运维情况。参考的时候多留意一下啊,毕竟是AI生成的。
---
二、性能测试结果
先说口径,免得有人说数字是 P 的:所有 bench 数字出自 Strata 自带标准套件(standard-v1,n=3 取中位数),终档是 2026-10-30 凌晨跑的——冷启动引擎、机器上唯一负载就是套件本身、4 个模型文件的 SHA-256 都打在档案里,
bench compare能校验通过的"conforming 档"。版本锚定:Strata Terminal 0.2.7 / 引擎 0.1.52 / CUDA 12.8 / 驱动 580.178.04。2.1 主要数字
档位 prompt 读速 (tok/s) decode (tok/s) TTFT 短上下文 — 66.5 1.9s 4K prompt 674(单次冷读) 60.3 6.1s 16K prompt 1530.8(持续读) 66.0 10.8s 图2a:图2_bench终档终端.png——strata bench完整档的终端报告页(含 12/12 sanity 与模型哈希行),接在主表之后。
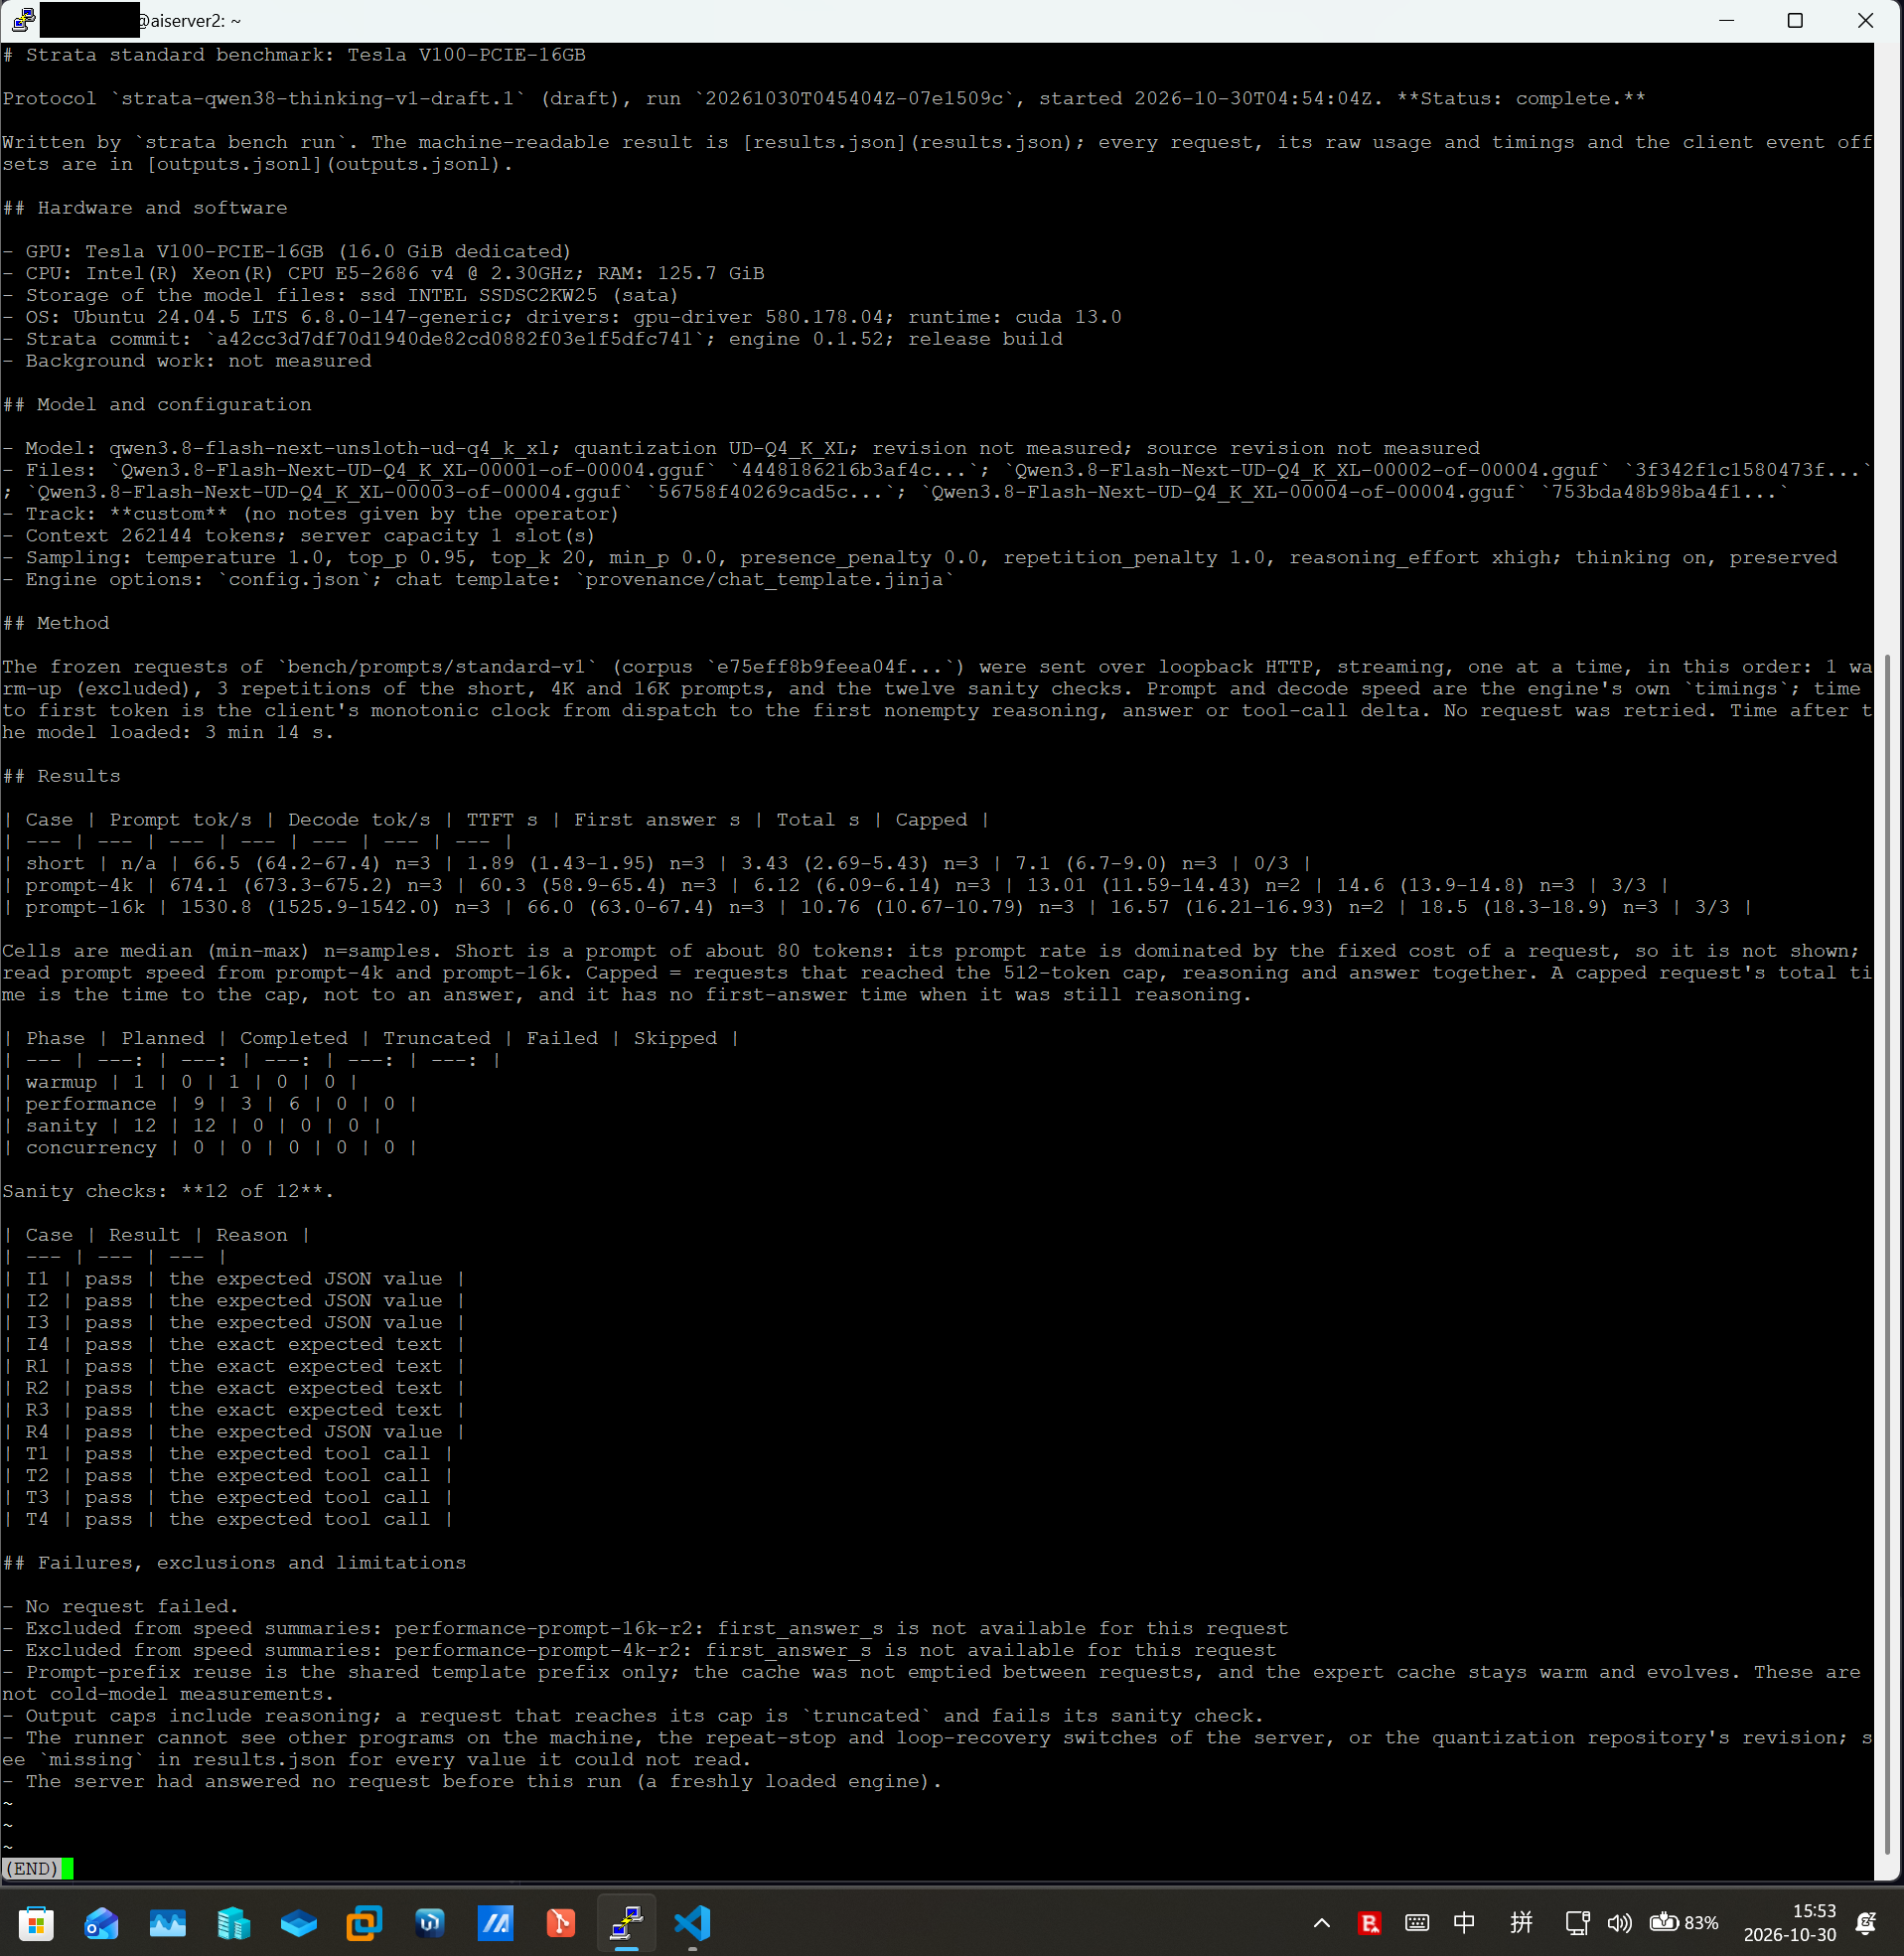
PS:这个截图是崽子给我把结果导入到md文件然后让我执行“less ~/strata-bench/post-clean2-20261030/README.md”截出来的,毕竟是它直接ssh链接服务器操作,我这边是看不到的。她还让我说:README 自报 runtime: cuda 13.0,但引擎组件实为 0.1.52-…-cuda12 构建——那句是 580 驱动的 CUDA API 口径,与帖里"CUDA 12.8"锚不冲突,但截图会把这行带进图里。
对照官方 V100 文档页给的参考机(i9 + 单卡,IQ4_XS 档):读 1010-1251、decode 38-51。我是双卡不假,但跑的也是更重的 UD-Q4_K_XL 档(权重 111G + MTP 草稿头 6.1G),读和 decode 两头都压过它一档。
一个给复现者的坑,先说免得白跑:跑套件前先重启服务清跨对话缓存。我们第一次跑,引擎里还留着上一天的缓存,协议直接把 4K/16K 整档以 "unexpected cache reuse" 排除、判 nonconforming——被拒的那档我也留着当证据。
2.2 长上下文(标题里说的 256K,真测了)
语料用自家真实长文拼的(重排过保证前缀全新、是真冷读),token 数全部取引擎 usage 实测回报,不是字符换算:
档位(实测 token) 冷读 TTFT 同一会话第二次请求 长上下文 decode 68K 38.5s(≈1771 tok/s) 0.1s 72-75 142K 48s(增量冷读) 0.2-2s 68 210K(≈192K) 117.4s 全量冷读 0.2-2.7s 53-65 原文证据,引擎回报的 usage JSON(可选升级:配一张真实请求返回里 usage 字段的截图
图2b_210K_usage截图.png,有它更硬,没有这代码块也够):// 210K token 真冷全量冷读 {"prompt_tokens": 210481, "completion_tokens": 600, "ttft_s": 117.4, "total_s": 126.6} // 同一会话第二次请求,跨对话缓存命中 {"prompt_tokens": 210483, "completion_tokens": 600, "ttft_s": 2.7, "total_s": 12.2}三句话读懂:256K 上下文是真能用的,21 万 token 一次请求完整过、不截断,代价只是开头读两分钟;decode 不随上下文变长而衰减(210K 上下文还有一秒五十几,跟短上下文同量级),这是 MoE 全在内存 + int8 KV + 32K 常驻 + streaming 分层加在一起的结果;同一段上下文第二次从 117 秒掉到秒级(最好一次 0.2 秒),就是跨对话缓存在多轮 agent 场景里的端到端效果。
测量自己也踩过一个坑:这个模型流式输出走
reasoning_content字段不是content,我第一版测量脚本只认 content,把 TTFT 和 decode 全测废了,第二版改成stream_options={"include_usage":true}取 usage 才拿到上面这些数。给同样自己写脚本测的朋友提个醒。2.3 真实负载总账(比跑分值钱的部分)
这台机器不是只跑过套件,是整夜整夜跑多轮 agent 批次任务(大上下文、高频请求、反复切换会话)养出来的数字:
- 多日累计 1898 个请求、2.17 亿 prompt token,零故障,其中 2.1 亿(97%)命中前缀缓存,实跑 decode 均值 61 tok/s;
- 专家命中率 ~86%(权重常驻内存 + 双卡层切);
- 12.8 小时浸泡巡检(配图那张负载曲线):跨对话缓存阶梯爬升吃满 36G 预算、系统可用内存探底 7.7G 后自动退潮;swap 峰值 24.7G 出现在引擎重启窗口——那是冷页(ngram 表这类)的正常回落落点,重启后只剩 1.4G。evictions 在重启段前线性爬到 96、无一次突发,引擎重启后计数器归零。分层缓存工作起来就是这个长相,swap 涨不等于出故障。
图2c 07附_负载曲线_12_8h浸泡
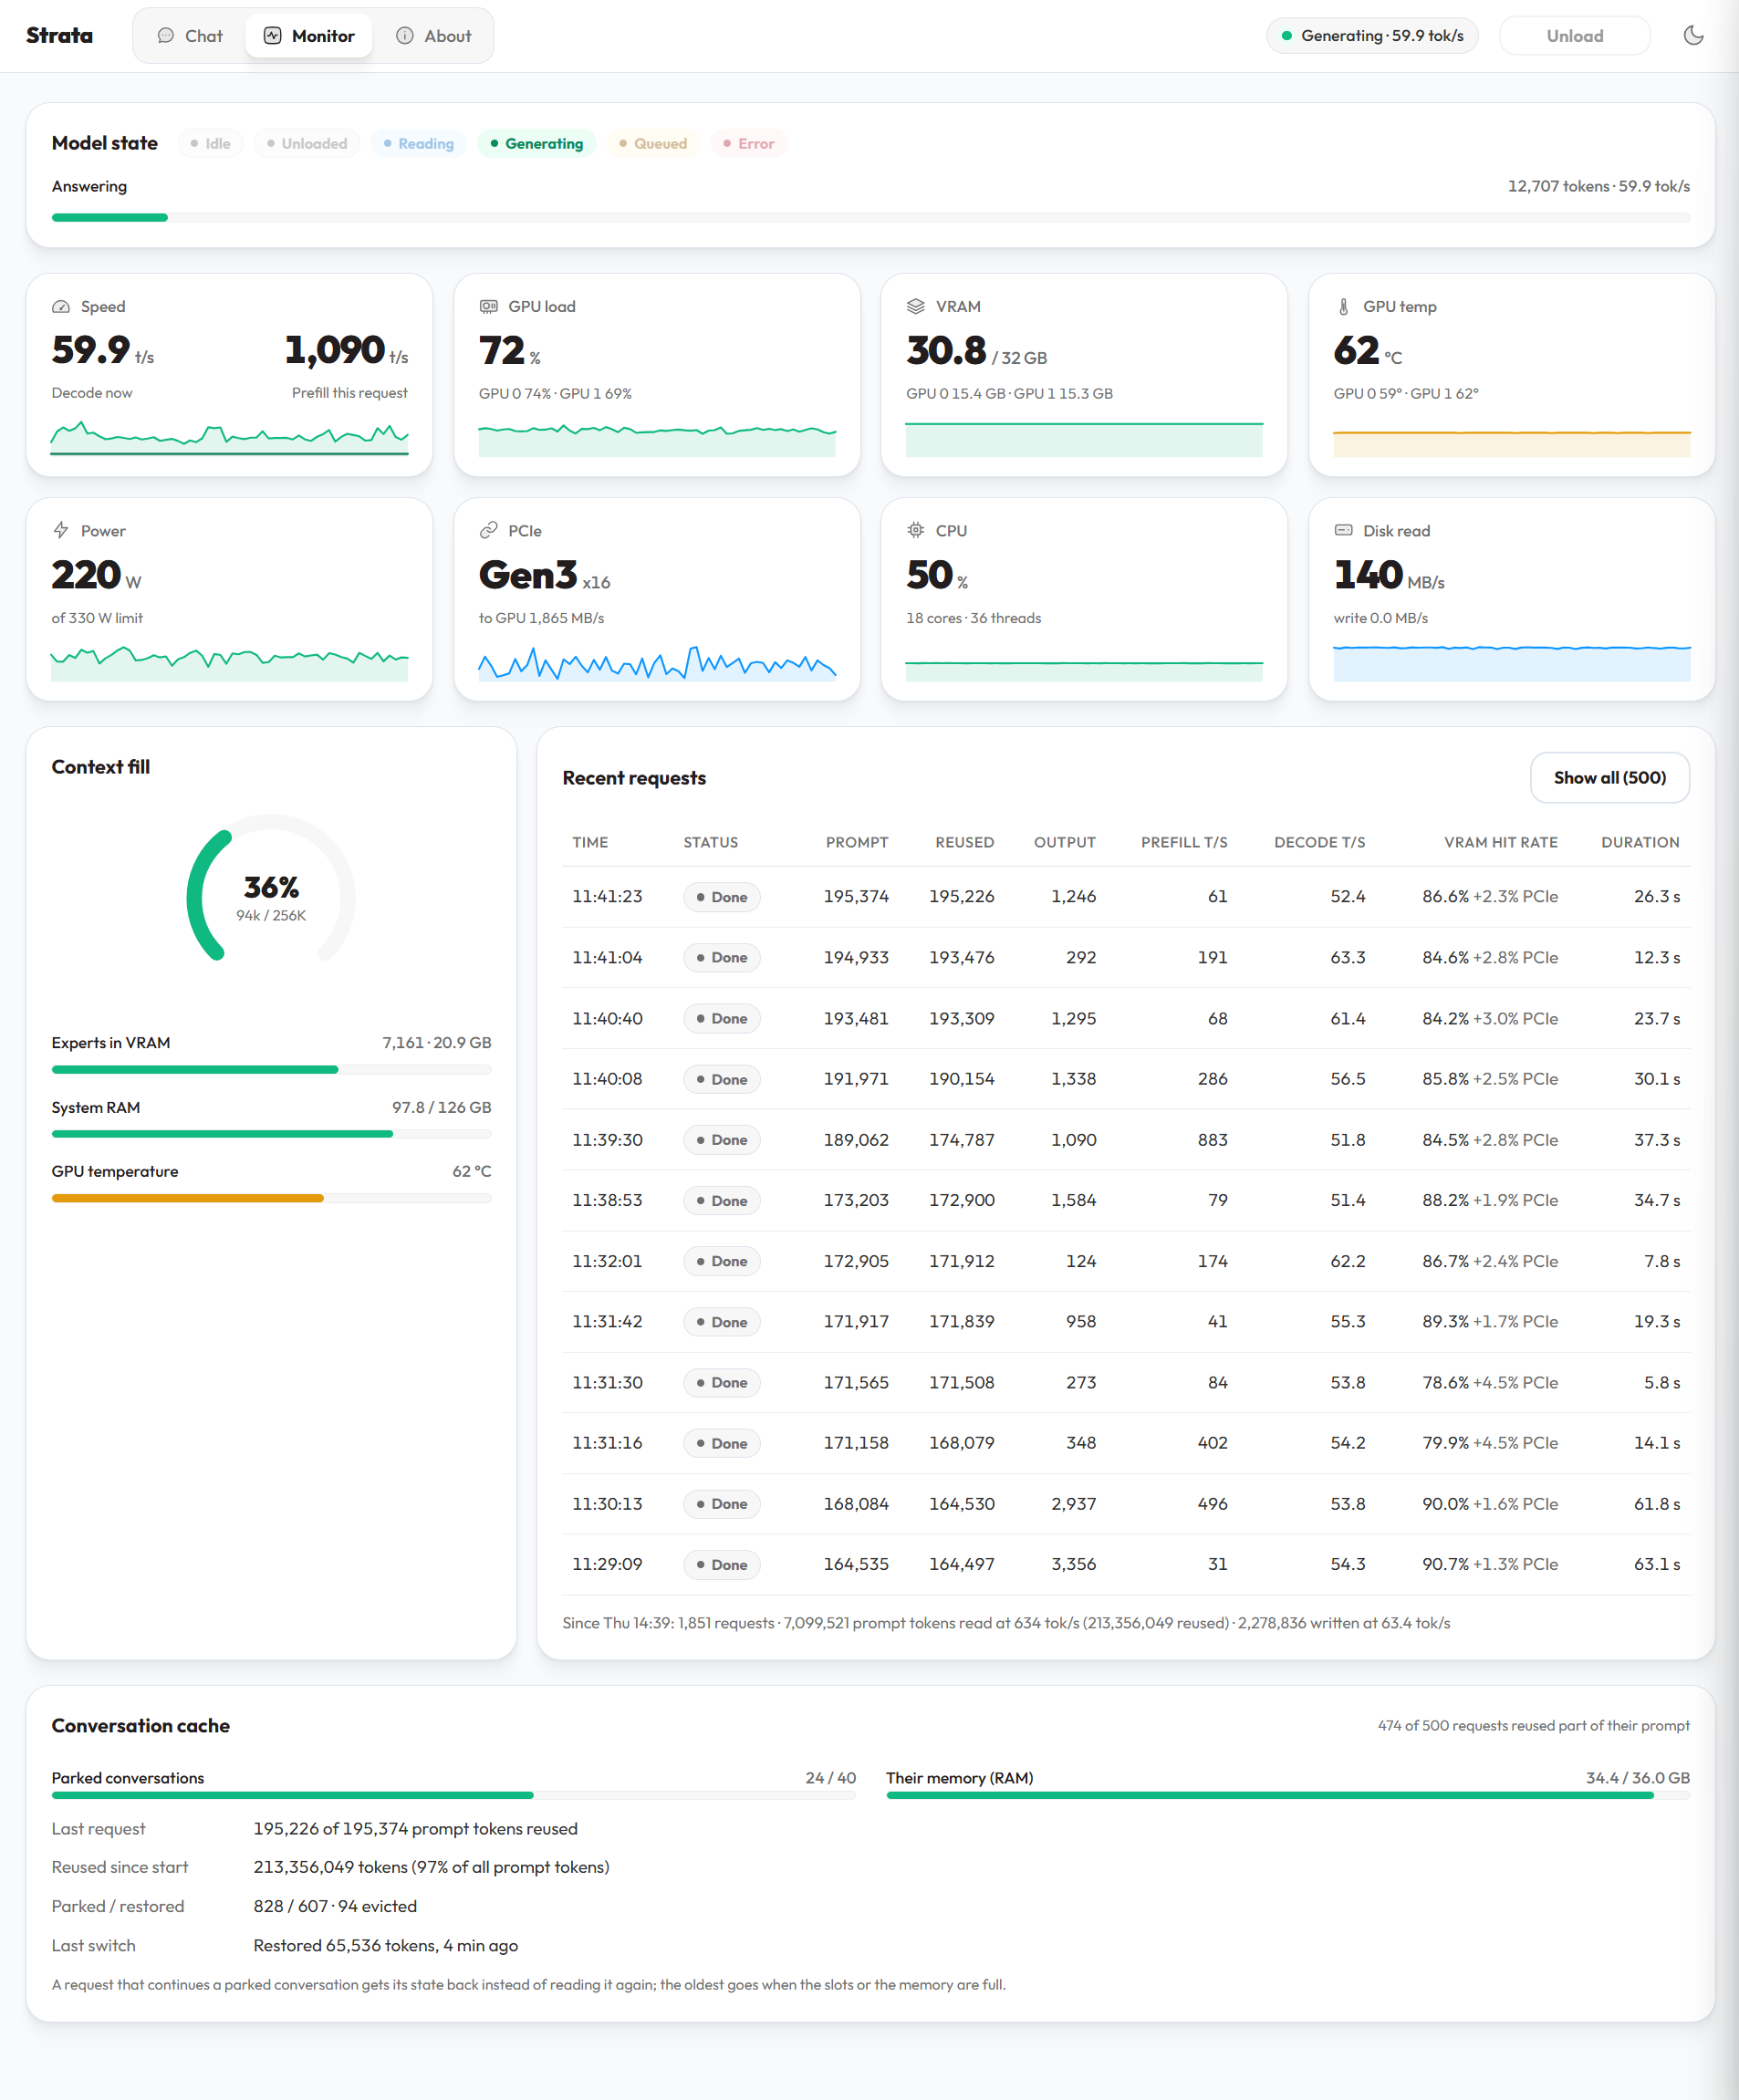
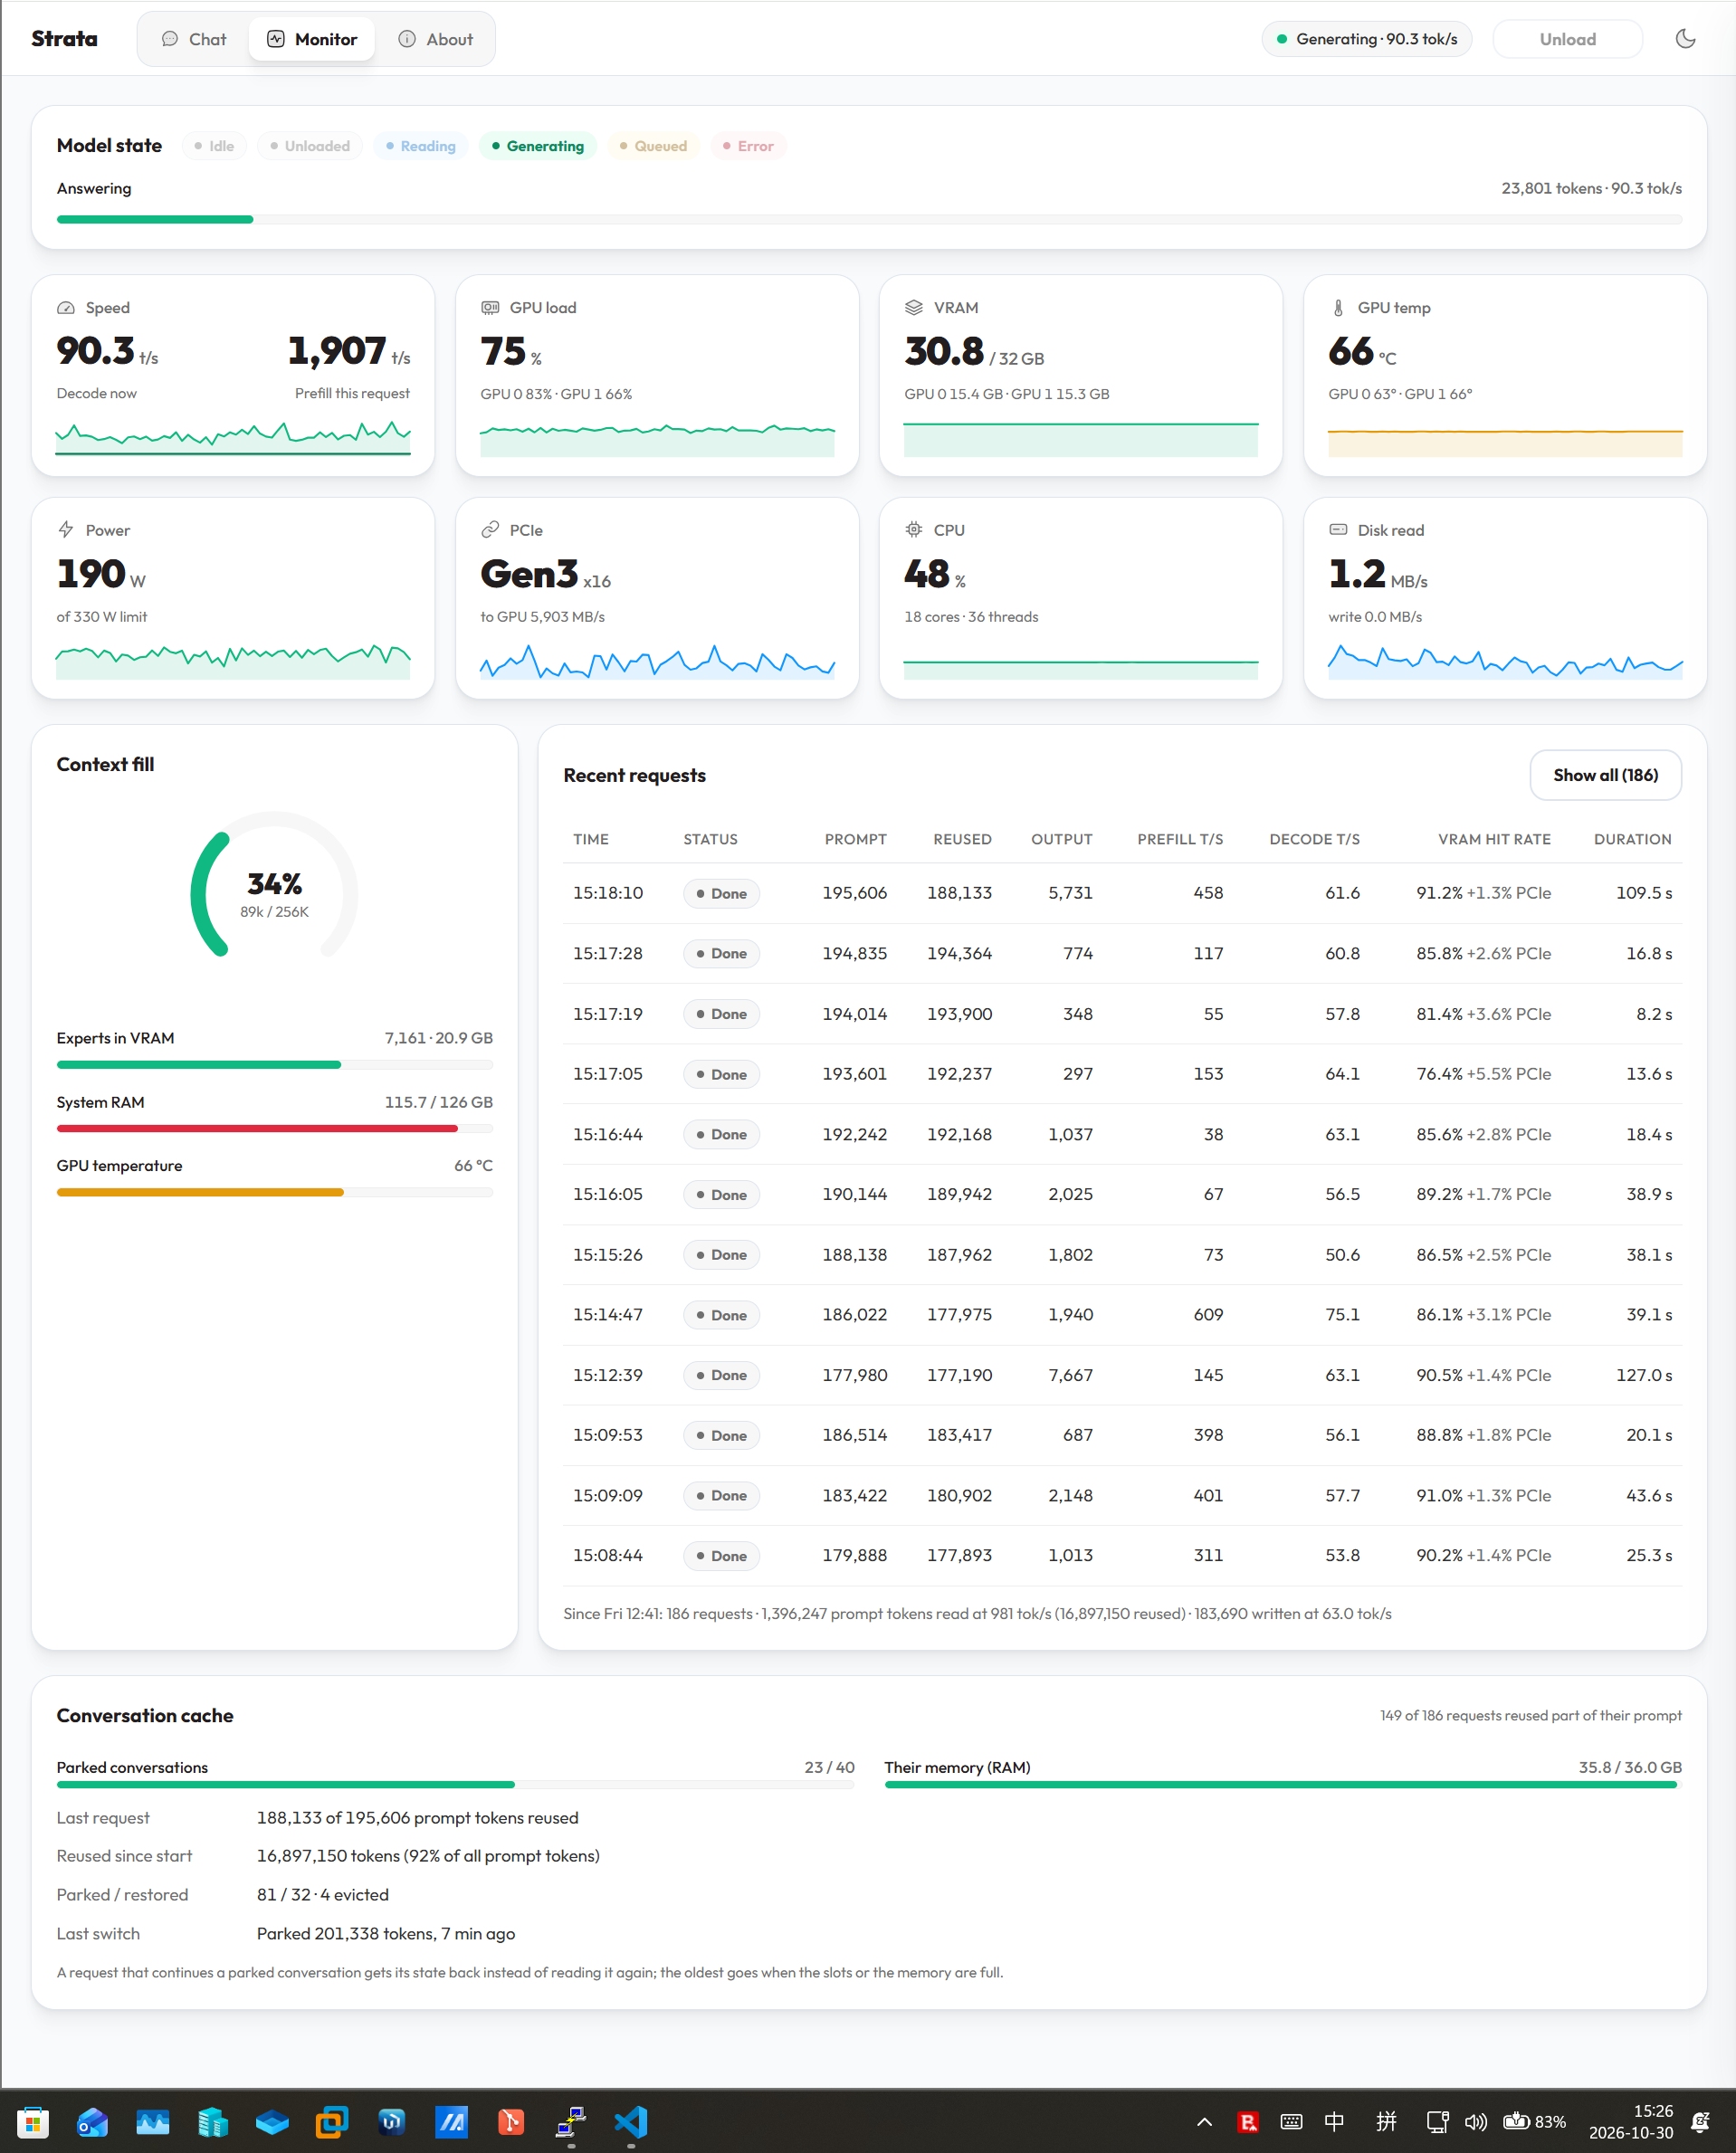
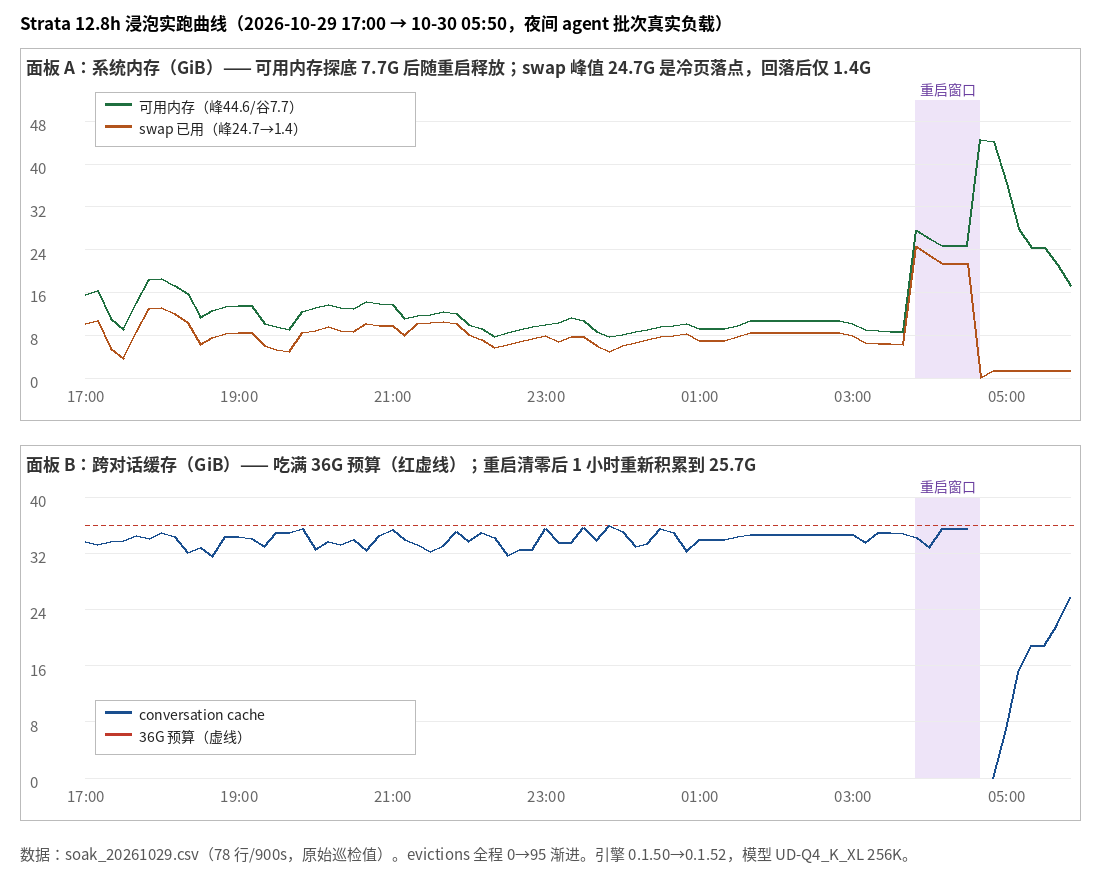 图2d/2e (我也不知道我崽子要什么样的图,但是我截过的97%命中率那个图,因为那时候基本都是命中缓存然后处理一点prefill,所以显示的prefill速度比较低,就参考一下吧。后面为了跑benchmark这小子把strata重启了我也截不到了,跑完benchmark我就让他写发帖子的稿子,这时候命中率大概只有92%,还是会和工作负载有关。)
这是跑完benchmark以后写本篇文章时候的截图:
2.4 功耗和温度(呼应第一节我说的 165W)
不是拍脑袋给的 165W:250W 往下每 10W 一档做 bench 梯度,165W 相对 250W 性能零损失(全部落在测量噪声带内)。原因是这个负载的功耗大头在 prefill 脉冲——实测单卡瞬时 207-226W、双卡瞬叠 ~435W,然后均值只有 45-110W/卡。所以功限要按脉冲相位留余量,按均值抠就是纯亏。decode 阶段功率根本用不满,165W 的余量确实很大。温度:2000rpm 风扇持续负载最热 68°C,全程零热降频。
2.5 正确性
每个调优档位都跑过 12/12 的 sanity(指令遵循/检索/工具调用各 4 题)才敢上。所有开关的代价如果体现在正确性上,速度再快也不要。
2.6 没兑现的(负结果,同样是测出来的)
官方文档给 V100 写了一页 opt-in 开关,好评,但注明了"贡献者自测、维护者未复测"。我逐个上机,在我这套配置(双卡层切 + UD-Q4_K_XL + int8 KV)上:
parallel=2双并发:不仅没增益,单流 decode 从 54 掉到 40;真双客户端聚合 43.5 ≈ 单流 45.9,等于没并行。这台就别折腾并行了;- 文档宣称 V100 +10% 的那个 WMMA 开关:实测 ±0.6%,没兑现;
- HC_Q8:实测 -2.4%,没采用;
- 关掉 skip 换"更还原":decode 交 ~15% 的税,我保持默认。
只写"在这台机器上没兑现",不写"官方错了"——芯片步进、内存条、负载形态都可能是变量。(完整 9 开关对账表和更多翻车在第六章。)
PS:
- 数字有整有零的原因:全是实测中位数,没有为了好看凑整。
- 完整档案(bench 原始 JSON、浸泡 CSV、测量脚本)都留着,有人要复现我可以再发。
三、配置(含视觉与全部优化参数)
这一节把我这台机器的现役配置原样贴出来(路径都收敛成
~,key 删了),每个非默认项给一句话理由和实测收益。先提醒一句:参数含义绑定版本——Strata Terminal 0.2.7 / 引擎 0.1.52,引擎迭代快,新版本上这些开关未必还有意义甚至语义会变,照搬前自己重测。软件与文件来源一句话交代:Strata Terminal 走官方安装器装、引擎组件只用官方 GitHub releases(我固定 cuda12 组件);模型量化文件来自 unsloth 官方 Hugging Face 仓库(UD-Q4_K_XL 档,4 分片 + MTP 草稿头 + mmproj 视觉件)。3.1 服务化:两个 systemd 单元
推理服务(要点):
[Unit] Description=Strata inference serve (UD-Q4_K_XL 256K) After=network-online.target gpu-power-limit.service Wants=network-online.target [Service] User=strata ExecStart=~/.local/bin/strata serve --host 127.0.0.1 --profile ~/.local/state/strata/launch/ud-q4_k_xl-256k.json Type=simple Restart=on-failure RestartSec=30 TimeoutStartSec=600 [Install] WantedBy=multi-user.target- 起停一律
systemctl,不要再用安装器自带的 runtime 管理器起一遍——两套管理打架是给自己埋雷。 - 重启就绪约 5-6 分钟,大头是 111G 权重的哈希校验,属正常。
- 容错实测过两层:视觉子进程被杀 10 秒自愈(引擎自己拉);主进程被杀 systemd 拉起,全程服务自动恢复。
功限单独一个单元,这里面有个必修的坑:
[Unit]
Description=Lock V100 power limits to 165W

[Service]
ExecStartPre=/bin/sh -c "for i in $(seq 1 60); do nvidia-smi -L >/dev/null 2>&1 && exit 0; sleep 2; done; exit 1"
ExecStart=/bin/sh -c "nvidia-smi -pm 1 -i 0,1; nvidia-smi -pl 165 -i 0,1"

[Install]
WantedBy=multi-user.target
必须先开 persistence mode 再设功限:开机时设备上 persistence 是关的,不设这个(或不在
nvidia-smi句柄关闭后保持),功限会被驱动默默重置回默认值——我第一版就中招,"设置了但重启后没了"就是它。先轮询等 GPU 枚举齐,再-pm 1,最后-pl,顺序别换。系统层另外三项:CPU governor 锁 performance(不然 x99 的调度拖 prefill)、
vm.swappiness=10持久化、swap 给足(我给了 60G+,理由见 3.3 的缓存条)。系统透明大页保持默认madvise不要改 always,引擎会自己申请(见下)。3.2 引擎运行档(现役全量,已去 key)
{
  "args": [
    "--pack", "~/.../packs/unsloth-ud-q4_k_xl",
    "--native", "~/.../Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf",
    "--expert-profile", "~/.../terminal/0.1.52/data/expert-profile.bin",
    "--expert-cache", "auto",
    "--prefill", "auto",
    "--spec", "4", "--spec-min-p", "0.5",
    "--mtp", "~/.../mtp/rt",
    "--max-context", "262144",
    "--kv", "int8",
    "--ple-io", "ram",
    "--kv-resident", "32768",
    "--vision",
    "--conversation-cache-mib", "36864",
    "--conversation-cache-slots", "40",
    "--conversation-cache-min-free-mib", "3072",
    "--conversation-cache-min-tokens", "2048",
    "--conversation-cache-park-gain", "1024",
    "--pipeline-windows", "2",
    "--trim-stage-weights",
    "--vram-reserve-mib", "896",
    "--vram-reserve-later-mib", "1184"
  ],
  "port": 8080, "cuda": 12, "gpu": [0, 1],
  "layer_split": "24",
  "env": {
    "STRATA_ARENA_THP": "1",
    "STRATA_SM70_TABLE": "1",
    "STRATA_DEFAULTS": "026",
    "STRATA_KV_PREFETCH": "1",
    "STRATA_ARGMAX_ROWS_SM70": "1",
    "STRATA_FUSE_DECODE": "1"
  },
  "vision": { "gpu": false, "threads": 16, "max_tokens": 2048,
              "mmproj": "~/.../mmproj-Qwen3.8-Flash-Next-Q8_0.gguf" }
}
3.3 每个优化参数一句话(带实测收益)
参数 为什么这么开 STRATA_ARENA_THP=1本机最大单项收益:decode +23~25%。专家权重池申请透明大页,TLB 压力立减。系统层 THP 保持 madvise,让应用自己申请,别全局 always layer_split=24+--trim-stage-weights各卡只加载自己负责层的密集阶段权重,腾出的显存换成专家槽:+25%。坑:0.1.50 起 auto 层切已经自己穷举摆放,但 auto 模式下 trim 是静默失效的——我实踩过,白白少约 1000 个专家槽。trim 必须配显式 layer split --pipeline-windows 2文档写明 CUDA 上不默认开,必须手加,decode +10% STRATA_SM70_TABLE=1Volta 查表路径优化:16K 持续读 +4.6%,decode 无损 STRATA_KV_PREFETCH=116K 读 +3.5%;超过 32K 常驻之后收益放大(36-61K 档 TTFT -7~9%),长上下文场景的白捡 STRATA_ARGMAX_ROWS_SM70/STRATA_FUSE_DECODE小开关,筛选后留下的无损项 --spec 4 --spec-min-p 0.5+--mtpMTP 投机解码,草稿接受率 ~66%。跑分档和实跑差就在这里 --kv int8256K 上下文的 KV 容量前提 --kv-resident 3276832K token 的 KV 常驻,超出走流式分层,128G 内存刚好扛住 --conversation-cache-*(36G / 40 槽 / min-free 3072 / min-tokens 2048 / park-gain 1024)跨对话 K/V 缓存 = 有界 RAM 预算 + 40 个"记住的会话" + 内存自持闸。冷页溢到 swap 是设计行为不是故障(这就是 swap 要给足的原因),观察口径看 evictions:它渐进增长就随它,突增再动预算。恢复实测约 1s 级:14 万 token 级会话从 79s 冷读变 ~1s,21 万 token 级从 117s 变秒级 --vram-reserve-mib 896 / later 1184显存安全余量。我曾抠到每卡 512M:装载后剩 154M,16K 冷读当场 -26%——卡内倒页是当场收税不是尾部风险。这两个数别照搬:水位随专家槽/层切变,照引擎开机警告点名的数落 --ple-io ramn-gram 表驻 RAM 但可回收(内核动态分层,冷页自己落 SSD——所以我第二块 SSD 只放模型和 ngram 读取,专用盘)。别用 LimitMEMLOCK 把它钉死——我踩过,完整故事在第六章 STRATA_DEFAULTS=026版本钉:锁上一代默认行为,避免引擎升级顺手改变我没测过的默认值。新版本请重新评估要不要钉 3.4 视觉(VL 那个图编码器)
- 挂 CPU 跑(
vision.gpu=false):16G 卡上视觉塞 GPU 会挤 KV 和专家缓存,官方对 16G 卡的默认就是 CPU,照默认来。视觉编码是纯算力活,跟显存没关系的; - mmproj 我自己量化成 Q8_0(900M → 588M,BF16 原件留着随时回退),视觉质量无可感知差异;
threads: 16——18 个物理核留 2 个给别的活,视觉 worker 别吃满;max_tokens: 2048——视觉输出本来就不该长,封个顶防跑飞;- 发图的实际体验:E5-2686v4 编码日常尺寸图片没有可感知卡顿,成本可以忽略——发图多不等于吃显卡,这是很多人给 V100 配视觉时的心理障碍,实际不用怕。
3.5 API 与安全(一笔带过)
引擎只听
127.0.0.1:8080+ API key;对外由同机的 Caddy 反代加 HTTPS。别把裸 8080 开到局域网里——跑分机也是内网资产。3.6 验证习惯(比配置本身重要)
- 每个开关的生效凭据是引擎日志的声明行或实测差分,不是"参数我传了"。例:THP 生效 = 日志出现
MADV_HUGEPAGE requested+/proc/meminfo的 AnonHugePages 吃满权重池;trim 生效 = 开机专家槽数对得上; - 装完/改完配置,重启服务后看引擎开机警告,它点名的余量/水位比你猜的数准;
- 有 A/B 才下结论:同一套跑分协议(先重启清缓存,见第二节)前后各跑一轮,噪声带内的"提升"一律不算。
四、调优阶梯:decode 从 43 到 66 是怎么来的
先立规矩再讲阶梯:一切"提升"都要同协议 A/B——同一台机器、空闲窗口、跑前重启清缓存(第二节说过被拒档的事)、n=3 中位数、原始档全部留底。我这台机器现有 37 个跑分档案,下面每一级都能翻到原件。另外声明:绝对数字只在同一代引擎内互比(跨代的坑 4.3 里我自己交作业)。
4.0 基线(什么都不改)
默认单并发档,官方套件:短上下文 decode 41-44、16K 持续读 1399、TTFT(16K) 11.8s、正确性 12/12。对照官方 V100 页参考机(i9+单卡)是"达标"水平——不是垃圾,但也远没到这台机器的极限。
4.1 台阶一:透明大页,decode +23~25%(本帖最值钱的一条)
最大的单项收益,而线索一直明晃晃写在引擎日志里:装载权重时有一行"71G arena 无大页"。我一直盯着日志找异常,这条就是——71G 的专家权重池用 4K 页跑,TLB 被打穿,decode 全在交地址翻译的税。
STRATA_ARENA_THP=1一拍上,短/4K/16K 三档 decode 齐涨 23-25%,这是所有台阶里唯一"数量级正确但人人都漏掉"的开关。两个配套注意:系统层 THP 保持
madvise别改 always(让应用自己申请,全局 always 会误伤别的进程);验证生效看引擎日志MADV_HUGEPAGE requested+/proc/meminfo的 AnonHugePages 吃满池子,不是"参数写了"就算完。4.2 台阶二:Volta 查表路径,+4.6%
STRATA_SM70_TABLE=1:16K 持续读 +4.6%,decode 无损,白捡。同一批还筛了两个候选(rec warp、norm 快路径),A/B 下来实测中性,不上——"文档有、别人说快"不等于我这台快,负数也得留在档案里。4.3 台阶三:显式层切 + trim,专家槽 +25%
layer_split=24+--trim-stage-weights:每张卡只加载自己负责层的密集阶段权重,腾出的显存全换成专家槽(6059→7407)。这一级把 decode 又推上一大截,长上下文命中率也跟着涨(槽多=更少驱逐)。这一级我踩过两个坑,都值得你们抄走:
- auto 层切下 trim 是静默失效的。0.1.50 起 auto 已经会自己穷举摆放选 K(老引擎时代的手调结论先别搬),我以为"auto 更好,参数随便加"——结果 trim 在 auto 模式下被默默忽略,少约 1000 个专家槽,不报错、不告警。验收方法只有一个:开机日志里的专家槽数。"参数已传到"和"机制在工作"是两回事。
- 专家槽数不能跨引擎版本比大小。我曾拿着旧引擎时代的总数口径,误报过 18% 的差距,实际同代真实差 1.7%。跨代对比前先确认口径同代。
4.4 台阶四:流水线窗口,decode +10%
--pipeline-windows 2——官方文档写明 CUDA 上不默认开,必须手加。这种"文档里躺着但默认关"的开关,我建议每个 V100 用户都翻一遍文档的默认值列表。4.5 台阶五:跨对话缓存,多轮 agent 场景的主战场
默认 8G/4 槽不够多会话切换用。一路加到 36G 预算 / 40 槽(min-free 3072 自持闸),触发点是实测:32G 档被填到 95.5%、evictions 开始爬、142K 上下文冷读要 79 秒。加满之后 20 会话压力测试 park/restore 全命中 ~1s,恢复后复用率 99.9%+。
这一级的"坑单"最丰富:
- swap 涨到 20G+ 别慌——ngram 表和冷页溢 swap 是设计行为,swap 是这套分层缓存的落点不是故障现场;红线只看三条:swap 持续疯涨、恢复变慢(>2s)、可用内存 <5G;
- 我曾给 ngram 表加
LimitMEMLOCK=infinity把它钉死——反而破坏了动态分层。有时少配置比多配置对("告警是机器在自护"的完整故事在第六章); - 显存安全余量抠狠了要当场交税:每卡只留 512M 时装载后剩 154M,16K 冷读 -26%、TTFT +35%——"卡满倒页"不是理论风险,是当场收税。按引擎开机警告点名的余量落数,这笔保险近乎免费。
4.6 台阶六:夜班筛选批
机器白天干活晚上闲着,我把候选开关写成清单让它夜里自动跑 A/B、早上收结果。这批判定的样子:
KV_PREFETCH是明确赢家(16K 读 +3.5%,超过 32K 常驻后收益放大,36-61K 档 TTFT -7~9%);ARGMAX/FUSE 两个小无损项保留;文档宣称 V100 +10% 的 WMMA 实测 ±0.6%(第六章全表那位);还有个 KQ 量化开关实测 -1.3~2.3%,拒。拒掉和没兑现的比留下采信的还多——这就是为什么我不信任何"必开清单"。4.7 终态
以上全部叠加 + 165W 功限(2.4 节,零损失)后,就是第二节那张 conforming 终档:短 decode 66.5、16K 读 1530.8、TTFT 10.8s、正确性 12/12。从 43.5 到 66,全部收益来自六个开关 + 一个层切决策,一分钱硬件没加。
4.8 升级是另一条阶梯(新坑登记)
引擎 0.1.50→0.1.52 的升级轮也交点学费:升级工具判"服务在用中"看的是控制进程不是引擎本体,
pkill引擎杀不到它,卡住升级;删档 profile 会留下陈旧的 runtime 注册文件,得手动清。新版默认值对咱家全部不适用:layer-major 在显存被 trim 榨满时自动降级、route-prior 只给 ≤13G 的卡、prefill 流水线实测中性——升级后别急着"接受新默认",重跑一遍基线再说。观察项也登记着:0.1.52 的 16K decode 带比 0.1.50 的单样本低约 9%,还没定罪,等下版。4.9 可复用的 A/B 纪律(半页总结)
- 先基线后优化,每个台阶单独 A/B,一次只动一个变量;
- 跑分前重启服务清缓存(第二节血案);套件结果落独立档案目录,同轮一律跳哈希校验省时间,但身份档至少完整跑一次;
- 噪声带内一律不算提升;负结果留档不删;
- 开关生效凭据 = 引擎日志声明行 + 实测差分,不是参数表;
- 绝对数字只在同代引擎内互比;
- 白天流量会污染夜里的数字——我的跑分都在空闲窗口,唯一负载=套件本身。
PS: 37 档原始档案(含被协议拒掉的那档和所有负结果)都留着,想看我怎么被"unexpected cache reuse"打回的、想看某个开关的原始差分,楼里说一声我单独发。
单卡 V100 兄弟备注:本节台阶里 ③(显式层切+trim)和④(流水线窗口)在单卡上无效或收益不同,但①大页、②Volta 查表、⑤KV 预取、⑥两个小核照样全吃——尤其 ①,回机器把引擎日志翻出来看有没有那句"arena 无大页",没有的先去开,那是白捡的 20%+。
五、为什么这么配(补叙):选卡逻辑与装机验收
5.1 为什么是这张"不该活着"的卡
V100 PCIe 16G:2017 年的 Volta,CUDA 13 已经放弃它,Strata 官方文档里它是"experimental CUDA 12 引擎"待遇——听上去是坑。但按我 1393 的入手价,每 GB 显合 ¥87,16G HBM2 带宽 900GB/s,2026 年这个价位没有任何对手。
而 MoE 大模型跑本地,缺的从来不是算力,是显存和内存。Strata 的架构恰好是为这种穷人机器设计的:专家权重驻系统内存、显存只当专家缓存——显存不够只是命中率低一点,不是跑不了。两张 16G 层切,就是把"跑不了"变成"跑得不错"。128G 内存在这类架构里是正经的生产力,不是富裕。
5.2 128G 内存的账(这是本平台的生死线)
这台机器现役负载的内存账本,给大家抄:专家权重池驻留 73.4G(模型权重 111G 里的 MoE 部分)+ 跨对话缓存预算 36G + n-gram 表 ~27G(驻留但可回收那部分)+ KV 常驻和各种杂项。64G 内存的机器根本进不了这条赛道——不是慢,是配置表摆不下。X99 四条 DDR3 槽 + 白菜价 32G RECC,就是给这种活准备的:四代 DDR3 带宽寒酸,但这条路是容量优先于带宽:单流下瓶颈在 GPU 侧和页表,4Rx4 的 37GB/s 实测喂单流够用(并发场景带宽就会咬人,第六章双并发翻车有它一份),见下文验收。
内存这条是我整篇里"最不能省"的一条:显存可以赌命中率,内存预算赌不了。
5.3 装机验收:垃圾佬的仪式感
二手数据中心卡 + 寨板 + 服务器拆机内存,不验收就上岗等于用玄学跑数据。我的验收套餐(一晚上跑完,值得):
- DCGM r2/r3 烤机全 Pass,ECC 两卡全程零错误(含 r3 压后统计)——矿卡身份声明书;
- MemTest 4 passes 无错、EDAC 无上报;
- STREAM 37 GB/s——数字看着寒酸?4Rx4 四 rank 内存的正常值就是这个水平,别拿它当故障去折腾,我一开始也以为哪里没插对;
lspci -vv看 LnkSta:双卡均 16x Gen3 到位。这板子插槽的"物理形态"和"电气实际"不是一回事,插完卡一定要用 LnkSta 核实,别看金手指长度;- SMART 两块盘健康;governor 锁 performance、
vm.swappiness=10持久化(见第三节系统层三项)。
顺手交代的装机细节:CRPS 服务器电源 + 大 4pin 转接,满载整机实测 700-750W,双 1200W 模块毫无压力;V100 被动散热改涡轮风扇(第一节说过,2000rpm 安静,持续满载最热 68°C,功限 165W 把发热天花板焊死了,这也是敢听安静的底气)。
六、负结果全表与翻车速记
6.1 官方文档宣称 vs 我的实测:完整对账
官方专门给 V100 写了文档页(好评),一页 9 个 opt-in 开关,全部注明"贡献者自测、维护者未复测"。我逐个上机(双卡层切 + UD-Q4_K_XL + int8 KV),兑现率如下:
开关 文档宣称 我的实测 判决 SM70_TABLE=1三件套 decode 核 16k 读 +4.6%、位等价  在役
ARGMAX_ROWS_SM70=1decode +0.7-0.8% 无损 在役FUSE_DECODE=1"4-16µs/token,端到端不可见" 确实不可见也无损(文档诚不我欺) 白拿在役PF_WMMA=1prompt +10% ±0.6%  没兑现。机理上能解释:参考数据出自单卡+GGUF 直读路径,我是双卡层切+pack——不同路径不同结果
GDN_REC_WARP=2递归核 +6-9% 端到端中性,且改 FP32 求和顺序(答案会变) 弃GR_NORM_FAST=1decode +0.5-0.6% 在噪声带以下 弃Q8_GATHER_WIDE=0gather 核 +11% decode 噪声里无法证实 存疑弃用HC_Q8=1别的平台 +8.4% -2.4% 弃。同一开关反向兑现,机器差异就是这么不讲理PF_WMMA2/GDN_CHUNK+2.5-4.3% / 无数字 还没轮到(先看量化层占比再定)  尾巴
结论:本表三行在役、五行负结果、一行两个尾巴(夜班批的 KQ 等负结果在 4.6,同样留了档)。 不是文档骗人——是别人机器上的数字到你机器上就是假设。所有开关请自己 A/B,别信任何人的"实测有效",包括这篇帖子的(doge)。
6.2 翻车速记(前面正文没展开的,都在这)
- 功限要按脉冲相位定,别按平均功耗。我之前按"负载均值 45-110W/卡"觉得功限随便设,直到盯着
nvidia-smi发现 prefill 瞬间双卡能冲 ~435W。200ms 粒度采样 +SW Power Cap累计计数器重测坐实:单卡脉冲 207-226W。平均值论是错的仪器——decode 看均值,prefill 要数被 cap 的秒数。165W 就是这么定下来的;被 cap 时唯一计入的是 SW Power Cap 计数器,热降频计数器全程 0µs。 - 帮系统"修告警",结果把系统修坏了。引擎启动有句 advisory:"PLE 表 mlock 失败"。我看不下去加了
LimitMEMLOCK=infinity——这是本机最贵的一个错误。那句告警的真实语义是 n-gram 表 ~27G 设计上就该"驻留但可回收",告警本身就是分层机制在正常呼吸;我一加锁,27G 钉死。怎么发现的呢:系统盘背景读从常年 2-3MB/s 变成精确的 0——分层被掐死了。撤锁,回归自然。教训两条:advisory 告警先当现象读、查明设计意图再动手;磁盘背景读基线是最便宜的物理监测项,比任何 dashboard 都直接。 - 双并发是一次彻底的判决:
--parallel 2在这台是负优化——sm_70 上批处理路径没有任何加速,Strata 的批处理加速核都写在新架构上,文档原话这类核 "off until asked for"。想要并行,正确姿势是两台机器按角色分工,不是单机强开。 - swap 是给分层机制兜底的缓冲带:8G 远远不够(专家池+缓存+ngram 理论最坏溢出 20G+),扩到 63G(fallocate 加文件全程零打扰,优先级瀑布旧盘先满)。
- 重启引擎后
/health返回 200 是假就绪——一发真实生成冒烟才算数(哈希校验没跑完时 health 已经绿了)。 - 缓存池顶格时引擎自己会踩刹车:min-free 闸拒绝新停放、退化成普通 prefill,请求本身不坏。这类自护机制都是设计好的,别急着干预——看见"拒绝"先查是不是它在自我保护,再决定要不要动配置。
- 量化档换了,开关结论要重测:PF_WMMA2 这类"专吃某种量化层"的开关,先看模型的 tensors 清单占比再决定测不测,换档后旧结论直接作废。
七、让 agent 替你管这台机器:可直接带走的部署与调优方法论
这一帖里大半的跑分、验收、巡检、A/B 不是我熬夜手跑的——是我把任务书写好,机器夜里自己跑完、早上我验收。这一节把这套做法去我的机器化之后写成通用 SOP:不含任何我的具体配置、路径或拓扑,你可以整节搬走,直接贴进你自己 coding-agent 的项目说明或 skill 里用。
7.1 开工前:给 agent 的护栏(比让它干活更重要)
- 生命周期归 systemd:服务单元、开机自启、失败重启都写进系统层;给 agent 的起停指令只有
systemctl,禁止它用推理框架自带的 runtime 管理器起服务——两套管理者打架是事故之源; - sudo 与物理世界归人:驱动、证书、BIOS、风扇控制器、电源,这些 agent 只报告不动手;agent 需要特权操作时输出一条完整命令交给人执行;
- 验收凭据写进任务书:"已完成/已写入/已成功"这类自述一律不算数——凭据 = 档案文件路径 + 日志声明行 + 实测差分。这条是整个方法论的地基;
- 改动边界写死:哪些目录可写、哪些文件只读、正在被人编辑的东西不许碰。
7.2 装机验收协议(新机器第一晚该干的事)
把验收清单写成任务书让 agent 跑完并出报告,逐项要求"原始输出 + 判定":烤机(GPU 用 DCGM r2/r3,内存 MemTest 多轮)、ECC 计数、
lspci -vv逐卡核实链路实际位宽与代数、SMART、内存带宽基线。两个防误判要点:带宽数字要先查"这类内存的正常值"再下结论(比如 4Rx4 的寒酸 STREAM 是正常体质不是故障);报告里没有原始输出行的判定一律退回重跑。7.3 基线与 A/B 协议(跑分不骗人的前提)
- 先跑默认档基线并归档,之后一切"提升"都是相对它的差分;
- 一次一个变量;每档 n=3 取中位数;
- 静窗:跑分时机器上不许有别的负载(包括 agent 自己的大上下文会话——它一边聊天一边让你跑分,TTFT 能给你污染三倍);
- 跑前重启服务清缓存——引擎缓存里有上一天的会话,协议会把命中档整批排除或虚高(血案见第二节);
- 每档结果落独立档案目录(带时间戳),负结果不删;
- 噪声带内一律不算提升;绝对数字只在同一代引擎/软件版本内互比,跨代先重测基线。
7.4 开关筛选流水线(夜班模式)
白天人挑候选开关、写任务书(每个开关:怎么开、验证生效看日志哪一行、A/B 怎么跑、什么判留用/弃用),夜里机器自己跑完全部档位,早上人只看档案收判决。我这台机器的筛选结果大体是拒掉的比采信的还多——所以别信任何"必开清单",包括文档和自己上个月的结论。换模型量化档 = 全部结论作废重测(专吃某种量化层的开关尤其如此,先看 tensors 占比再决定测谁)。
7.5 长跑巡检与红线(把"过日子"变成数据)
让 agent 定时(比如每 15 分钟)拉一组指标落 CSV:可用内存、swap 用量、缓存占用与驱逐计数、会话停放/恢复计数与耗时、GPU 温度/功率/各类 throttle 计数器、磁盘背景读。要点:
- 红线要少而硬:我只设三条——swap 疯涨、会话恢复变慢、可用内存见底。红线不触发,人就不干预;
- advisory 告警先当现象读,查明设计意图再动手——很多"告警"是机制在自护(把报警消掉等于把自护关掉,我交过最贵的学费在这,见第六章);
- 磁盘背景读基线是最便宜的物理监测项:常年 2-3MB/s 的盘变成精确的 0,说明某个"分层"被你配置掐死了——这个发现比任何 dashboard 都直接。
7.6 报告纪律(防 AI 幻觉的硬闸门)
给 agent 的报告任务书必须写死:报告里每个数字标档案路径、每句"实测 X"必须能在档案里 grep 到、引用日志必须带原文行。上下文长了以后 AI 会"记住一个大概然后写得很自信"——这套闸门能把它拦住,我在它的报告里抓到过好几次自信的错误。
7.7 人机分工一句话总结
人管:掏钱、动手、拍板、认错兜底;agent 管:扫描、跑批、对账、写草案。 双方共同信条:别人机器上的数字到你机器上就是假设——对自己机器也一样,昨天的你对今天的你也是别人。
(本节欢迎拿走改好用完回来分享。)
八、未完事项与结语
8.1 未完事项(立字据,月底回来交作业)
- 带模型校验的 conforming 跑分档:已交("跑前先重启清缓存"的坑写在第二节)
- 192K 级长上下文实战:已交。300K+ 不用问了——262144 是 max-context 的墙,过墙是另一件事
- 24-48h 浸泡长跑报告:12.8h 段已交(负载曲线图 + 复用总账),脚本还在跑
- 官方开关表还剩两个尾巴(PF_WMMA2 / GDN_CHUNK)没轮到
8.2 结语
有问题尽管问,负结果尤其欢迎对线——毕竟我这台机器上,"+10% 的功能"翻车翻得最响。跑分档案、浸泡 CSV、测量脚本都留着,要复现的楼里说一声。
 大恩不言谢,以后坛里有我能搭把手的,您尽管开口。