@HHFu517
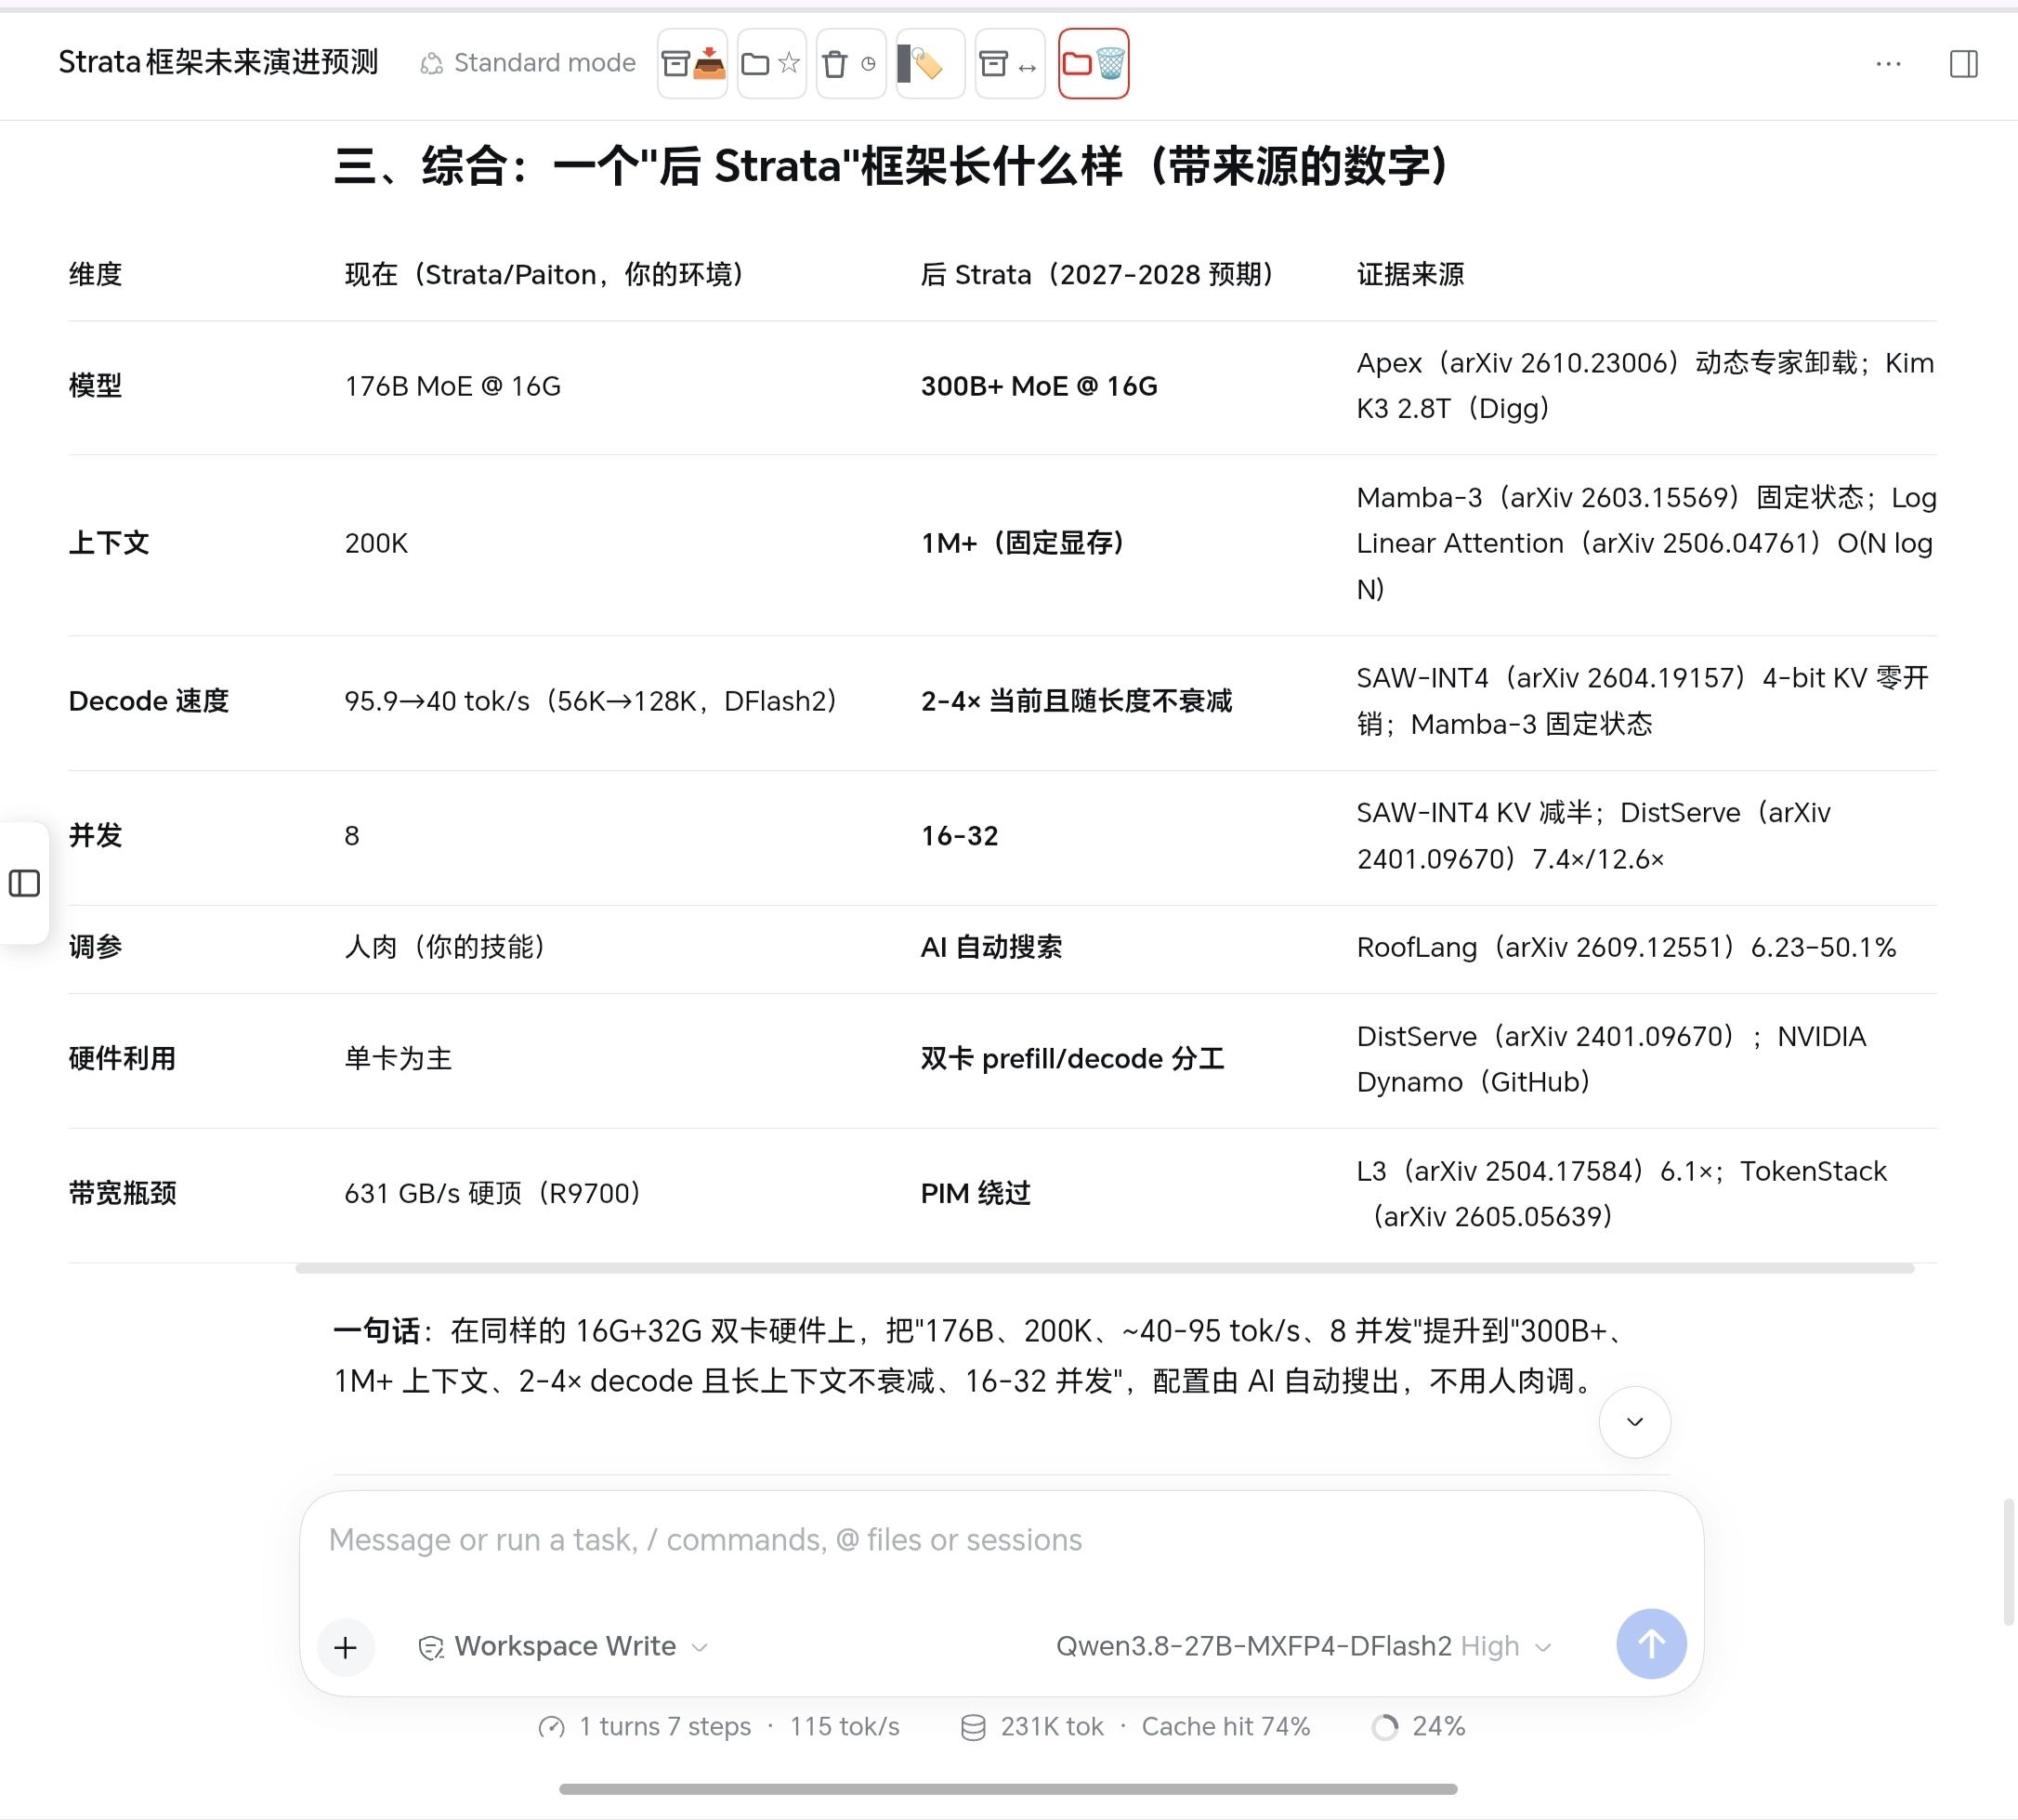
你如果目标是跑flash next的话应该是不用换电源的。因为是moe模型跑起来比较省电,另外呃也极少有就是两个显卡同时满功率加CPU满功率的状态。
-
【双 R9700 折腾记】从 Strata 到 Radiance -
【双 R9700 折腾记】从 Strata 到 Radiance -
【双 R9700 折腾记】从 Strata 到 Radiance@applejuice
哦,牛逼,牛逼,那也是双卡高带宽并行啊!比不了
-
【双 R9700 折腾记】从 Strata 到 Radiance@applejuice
5090么,pp这么快?我的5070ti只有2000左右,感觉没有命中的时候还是慢 -
【双 R9700 折腾记】从 Strata 到 Radiance@applejuice
哦,那你就往上顶吧。我用本地模型的话,感觉有时候上下文太长了,有时候等待时间太长就很烦。用deepseek flash这种在线的很快的模型就无所谓了。 -
【双 R9700 折腾记】从 Strata 到 Radiance@applejuice
不大量搞代码的话,200K绰绰有余了。我现在虽然是可以开256,但是为了方便各个模型都统一成200k了。
你可以让AI给你看一下你过往的聊天记录,看看超过某个阈值的到底有多少,这个情况频繁不频繁,如果不频繁的话,其实对于本地模型来讲设的低一点响应速度会更快一些。 -
【双 R9700 折腾记】从 Strata 到 Radiance@alan.lgv60
如果只是跑27b的话,单卡已经很顶了,能到3500的预处理,输出的话能有个100以上,就已经很丝滑了。
如果呢要想达到类似27b的速度,那就只有上双卡tp了。就看你自己的需求了,flash next呢确实好一些,但是又没好那么多。 -
DDR3内存条太便宜,上256G 512G跑本地大模型?完全没有必要,120B模型足够处理隐私和抗审查,要求高上在线AI,先赚钱! -
本地AI硬件焦虑个锤子!看看好消息吧 -
本地AI硬件焦虑个锤子!看看好消息吧@David-Chen
是啊,这种性能越来越强,硬件需求越来越低,最后agi的趋势不变的。 -
本地AI硬件焦虑个锤子!看看好消息吧 -
本地AI硬件焦虑个锤子!看看好消息吧 -
本地AI硬件焦虑个锤子!看看好消息吧@Tzung-Ru-Tsai
哦,那个我也试了一下,貌似默认的32开就挺好 -
本地AI硬件焦虑个锤子!看看好消息吧 -
本地AI硬件焦虑个锤子!看看好消息吧 -
本地AI硬件焦虑个锤子!看看好消息吧 -
本地AI硬件焦虑个锤子!看看好消息吧@zeus177169
一点不夸张,现在paiton的W3A4的27B模型已经基本接近无损了。 -
本地AI硬件焦虑个锤子!看看好消息吧 -
【双 R9700 折腾记】从 Strata 到 Radiance -
R9700 - vllm radiance 分支