@dardeaw-feng 先回答:全部是單路(一次一個請求、串行跑)。2080 / 1850 那些數字都是單請求測出來的。
看到你問,我順手補測了 4 路併發(服務 KV_SLOTS=4,4 路同時打 8K 提示詞、max_tokens=256、temp 0):
| 口徑 |
單路 |
4 路併發(每路) |
聚合 |
| prefill |
4.37 s(1830 tok/s) |
4.26 / 4.35 / 4.40 s(1877 / 1840 / 1823 tok/s) |
prefill 不掉 |
| decode |
43.2 tok/s |
4.4 / 4.9 / 21.4 / 9.3 tok/s |
4 路之和 ≈ 40 tok/s |
4 路裡有 1 路是同一條提示詞、命中了剛才單路測試留下的前綴快取(prompt_n=0),所以 prefill 只列另外 3 路;decode 四路都是真實數據。
兩個結論:
- prefill 併發幾乎不掉(每路仍 ~1830–1877 tok/s);
- decode 會塌:單路 43.2 → 每路 4–21 tok/s,四路加起來 ≈ 40 tok/s,跟單路同級。
原因寫在引擎自己的啟動日誌裡:
flash_serve: listening on 127.0.0.1:8730, 4 slots over ONE 262144-position KV pool ...
             MTP depth-2 selectable (drafter 1, speculates while alone)
speculates while alone —— 投機解碼只在「獨占」時開,有人同時生成就退回串行。所以多路併發的意義是「多個會話都要有回應」,不是提高總吞吐。
特別調了什麼
硬體 / 內核層
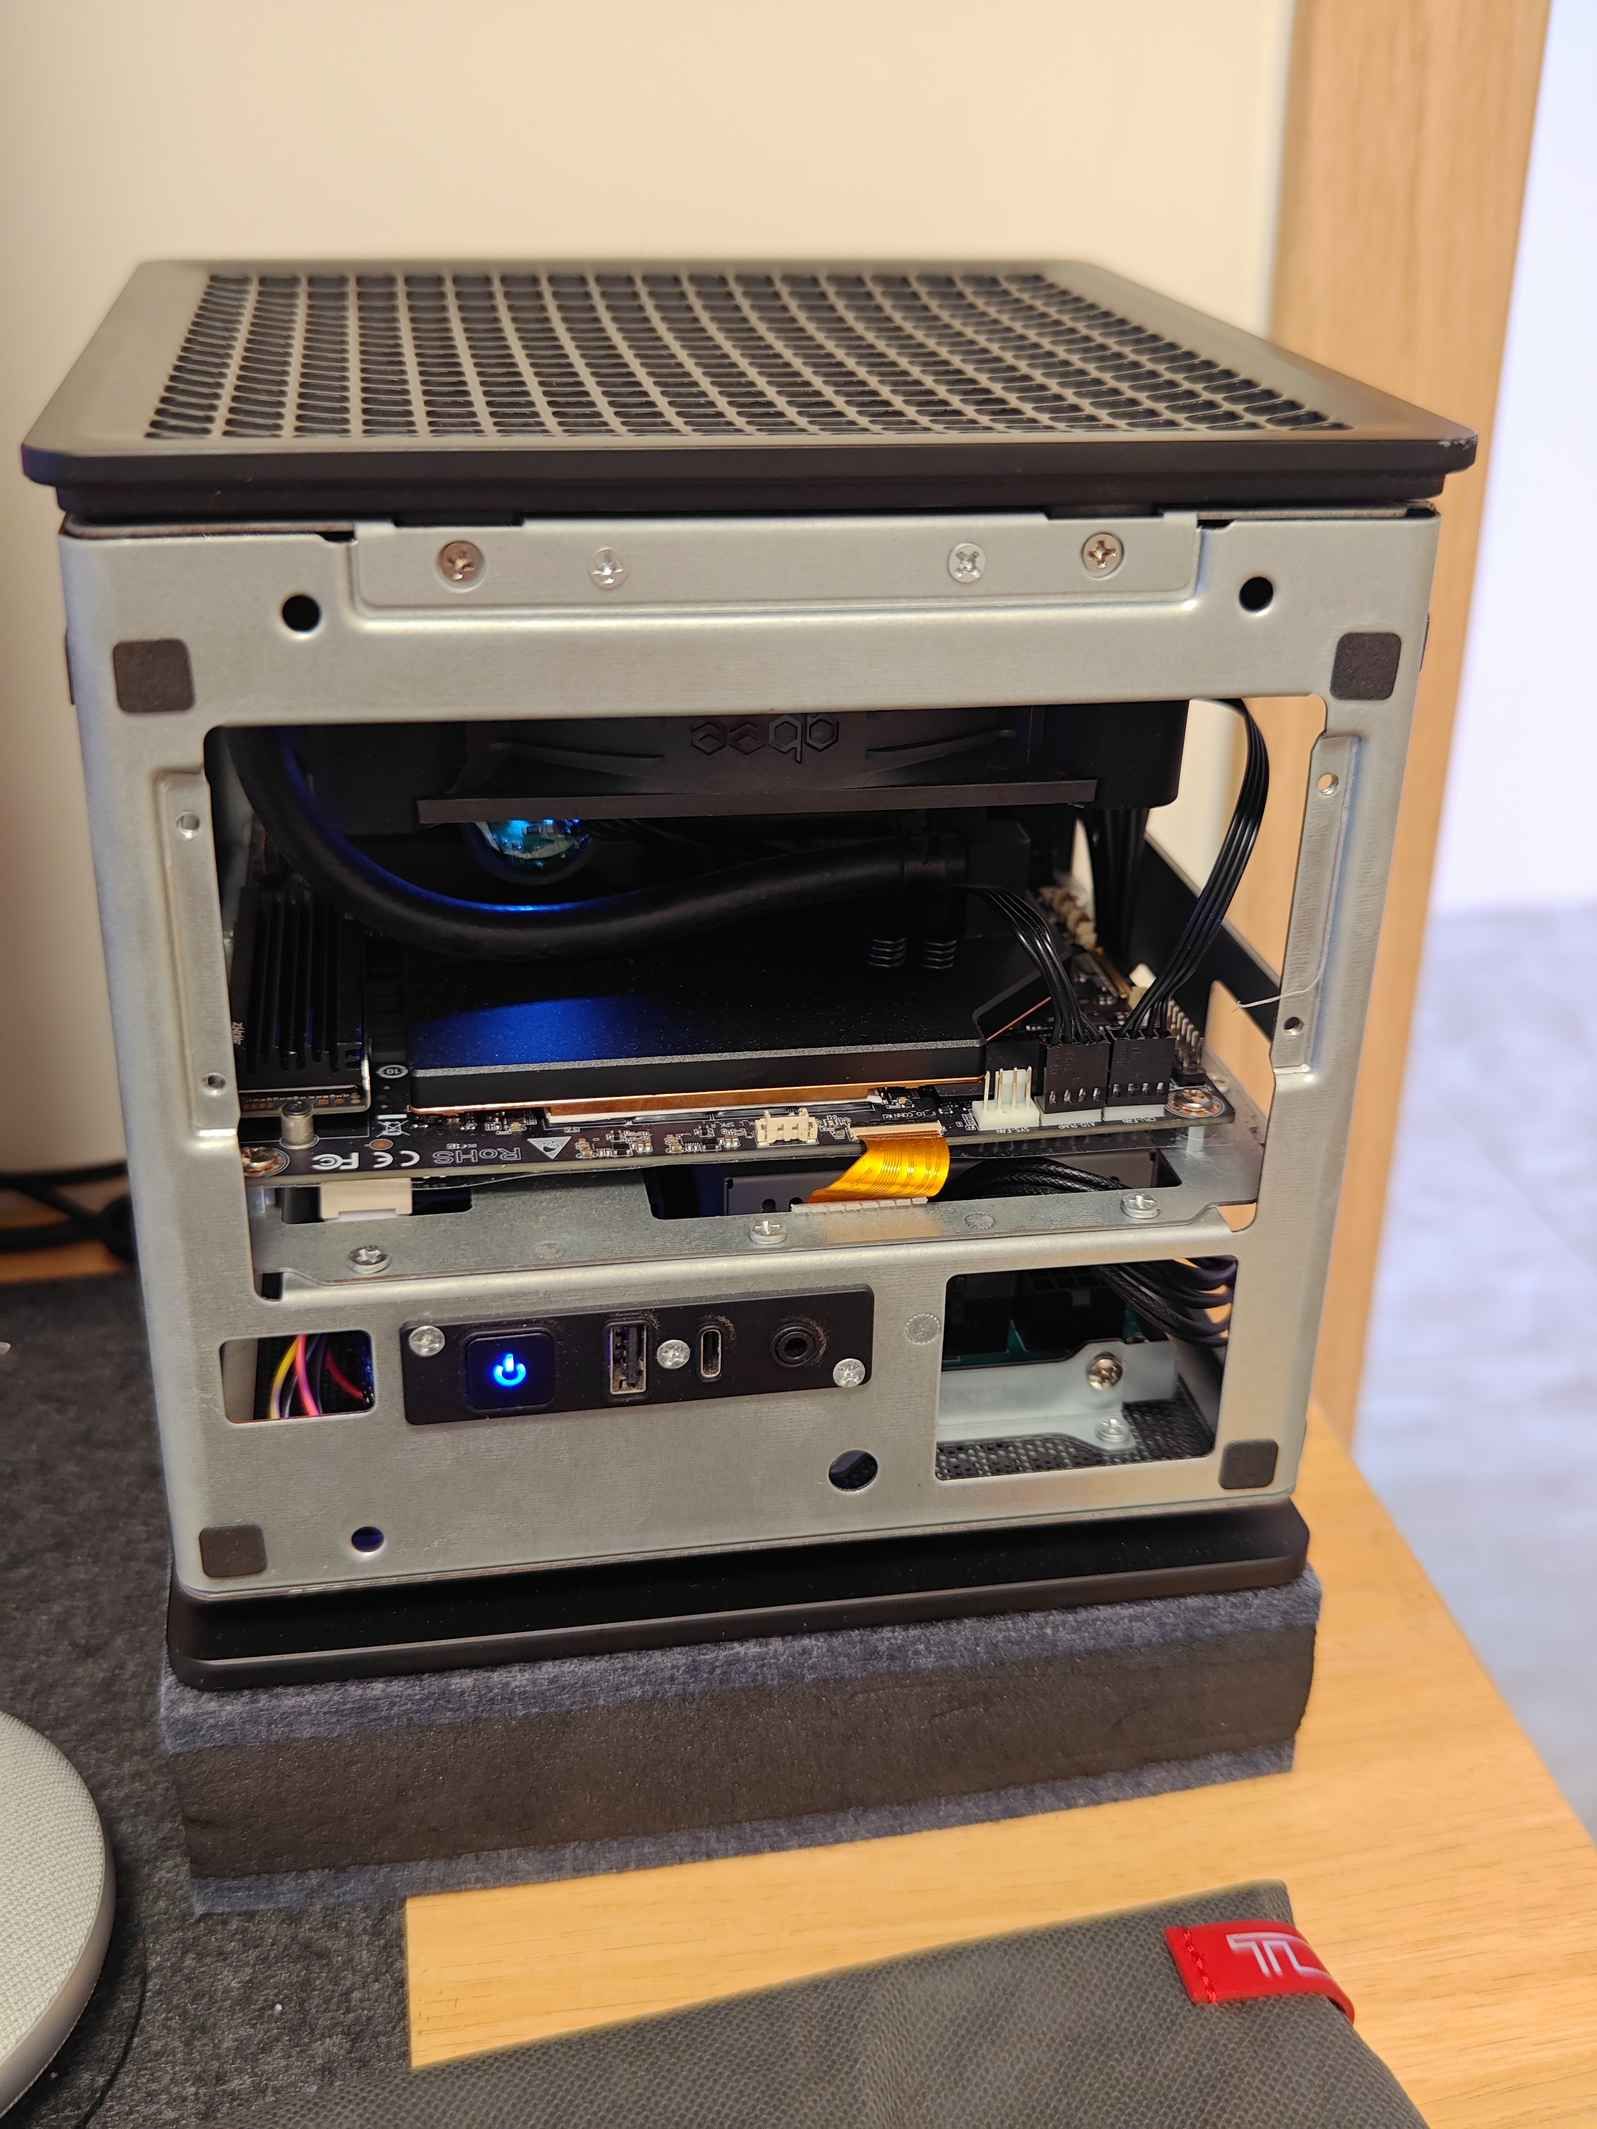
- BIOS 的 UMA frame buffer 調回最小(只 carve 1 GiB),系統可見 124.4 GiB;
- 內核參數(
GRUB_CMDLINE_LINUX_DEFAULT):
amdgpu.gttsize=126976 ttm.pages_limit=32505856 ttm.page_pool_size=32505856 amd_iommu=off
開機後 mem_info_gtt_total 出 124.0 GiB。(amd_iommu=off 是早期做過 A/B 後留下來的設定,這一輪沒有重測。)
- 功耗:PBO 開啟,滿載穩定 ~153 W(跑滿 AMD 的 PPT slow 上限);CPU governor 是
powersave。
引擎層(HALOGEN_*,跟預設不同的就這幾個)
| 參數 |
我設 |
官方預設 |
為什麼 |
HALOGEN_MAX_TOK |
16384 |
32768 |
prefill arena 減半。0.16.0 上兩者速度在噪聲內(@32K:2001 vs 1957),但 working memory 從 12.5 → 8.1 GiB |
HALOGEN_KV_POOL_POSITIONS |
262144 |
2×CTX = 524288 |
同理,省下 7.2 GiB 給頁快取 |
HALOGEN_HOST_RESERVE_GIB |
24 |
20 |
同上,留更多給頁快取 |
HALOGEN_COMPOSABLE_CONTEXT |
0 |
0 |
實測開著在 8K 提示詞上慢 16.7% |
HALOGEN_REASONING_EFFORT |
low |
模板 xhigh |
預設在 agent 長鏈上思考過久(慢約 3 倍) |
HALOGEN_PROMPT_CACHE |
2 |
2 |
resume-anywhere |
HALOGEN_CACHE_DIR |
/cache |
未設 |
快取落盤,重啟後續聊 |
HALOGEN_CACHE_BRANCHES |
3 |
2 |
父會話分叉出子代理時保住 resume point |
HALOGEN_CACHE_PRUNE_OLD |
1 |
0 |
升級時清掉舊 build 殘留子樹 |
HALOGEN_VISION_TOWER |
1 |
未設 |
開視覺 |
核心邏輯一句話:MAX_TOK 與 KV_POOL_POSITIONS 都往小調,把 RAM 讓給那張 47.7 GiB 的 n-gram 查找表(它不常駐,全靠 page cache)。
checkpoint
用 v2(qwen38-flash-next-v2.hgn 62.11 GiB + 獨立 ngram.hgn 47.68 GiB),不是舊的 w4b。常駐從 87.0 → 78.3 GiB(多出 8.7 GiB 給頁快取),同題 ppl 好 1.9%。
容器啟動參數
podman run --rm --name halogen-flash -p 8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --security-opt seccomp=unconfined --ipc=host --ulimit memlock=-1:-1 \
  -v <models>:/models:ro -v <cache>:/cache \
  -e HALOGEN_KV_POOL_POSITIONS=262144 -e HALOGEN_PROMPT_CACHE=2 \
  -e HALOGEN_HOST_RESERVE_GIB=24 -e HALOGEN_VISION_TOWER=1 \
  -e HALOGEN_COMPOSABLE_CONTEXT=0 -e HALOGEN_CACHE_DIR=/cache \
  -e HALOGEN_REASONING_EFFORT=low -e HALOGEN_MAX_TOK=16384 \
  -e HALOGEN_PREFILL_CHUNK=16384 -e HALOGEN_CACHE_PRUNE_OLD=1 \
  -e HALOGEN_CACHE_BRANCHES=3 \
  ghcr.io/peonist-ai/halogen-flash-server:0.16.0
啟動後記憶體實測行:
memory: 62.9 GiB of weights locked in RAM (0.8 of them the vision tower's),
        7.2 GiB of KV pool, 8.1 GiB of working memory, 78.3 GiB in all
單路完整數據(0.16.0 + v2,temp 0、effort low)
prefill 隨深度
| 深度 / 規模 |
prefill 速度 |
| 4K |
1960 tok/s |
| 32K |
2080 tok/s |
| 64K |
2042 tok/s |
| 128K |
1991 tok/s |
| 192K |
1850 tok/s |
| 244K |
1848 tok/s |
| 256K |
1824 tok/s |
| 260K |
1836 tok/s |
4K → 260K 只掉 6%,沒有「越長越慢」。
decode(與深度無關)
| 口徑 |
decode |
| 512 token 樣本 @32K(樣本最大) |
44.1 tok/s |
| niah 檢索(每次只生成 32 token) |
36.4 – 37.9 tok/s |
| 長上下文 API(每次 187–200 token) |
28 – 53 tok/s |
decode 速度不隨上下文深度變化 —— 48/64 層沒有 KV cache。
它主要由投機解碼命中率(生成內容的可預測性)與樣本長度決定:
同一種任務在 192K / 244K / 256K 上分別測到 52.2 / 28.1 / 53.1 tok/s,
散布這麼大是短樣本的起停開銷造成的,不是「越長越快」。
檢索完整性(引擎 niah,深度 × 位置)
| 深度 |
p05 |
p50 |
p95 |
合計 |
| 4,096 |
3/3 |
3/3 |
3/3 |
9/9(100%) |
| 32,768 |
3/3 |
3/3 |
3/3 |
9/9(100%) |
| 65,536 |
3/3 |
3/3 |
3/3 |
9/9(100%) |
| 131,072 |
3/3 |
2/3 |
3/3 |
8/9(88.9%) |
| 總計 |
|
|
|
35/36(97.2%) |
prompt cache
| 口徑 |
冷 |
暖 |
| 128K 前綴第二輪 |
58.5 s |
0.0 s(prompt_n=0,端到端 2.9 s) |
| 259K 前綴命中 |
— |
端到端 3.7 s |
上限
prompt + max_tokens ≤ 262,144,用同一條 259,474 token 的提示詞卡過邊界:
max_tokens |
合計 |
結果 |
| 2,670 |
262,144 |
 200 |
| 2,671 |
262,145 |
 400( leaving room for 2670) |