现在这是用7900xtx的少了吗,竟然是一楼,这个真得试试
-
7900 XTX 的可能性探索|单卡篇(五):与时俱进!hipfire DFlash 实测 Qwen3.8-27B MQ4-XTS:8K Decode 169.4 tok/s,Prefill 2682 tok/s -
【直播】4卡R9700从采购到调试@Name-Error 您这几张卡买的现在看很划算了。现在有了针对R9700的优化矿池和矿工软件,有几个大单可能把未来交付的订单都给扫了挖PRL,明年上半年都会缺货。
-
Intel 新卡 D270 -
【直播】4卡R9700从采购到调试@applejuice 多卡用快插,但也是出厂之前注好液的。但是一张显卡要用2对快插,好的快插就比冷板要贵了。很多国内的快插漏的见多了,这个钱不能省。
-
【直播】4卡R9700从采购到调试@Name-Error 说实话,背面那 8 颗显存的温度不用太在意,一块普通铝背板就足够散热。RDNA4 这代卡显存温度本身偏高,9070XT 用三星显存跑 90 度也很常见。
R9700 真正难搞的其实是扣合压力。这卡双面各贴 8 颗显存,layout 离核心又太近,不像9070XT那样可以用核心支架提高压力;因为核心高度是有公差的,没有支架扣合压力就会偏低,一些公差大的热点温度会更难控制一些——这是个大坑。
我有三张R9700,其中有一张结温就比另外两张高了10几度,在小黄鱼买了个9070XT的核心支架,想办法加高后换了长螺丝解决的。 -
【直播】4卡R9700从采购到调试@applejuice 生产力的配置不建议任何 DIY 液冷:单机成本高,漏液风险太大。
NV 桌面的 DGX Station 说穿了也是 AIO。多卡和 IDC 的液冷方案,都是出厂注好液、用快插接头对接安装,快插必须选史陶比尔、CPC 这类,最差也得丹佛斯。另外不会用螺纹拧头,水管都是不锈钢波纹管直接焊接。
出厂前要多轮 2kg 以上加压测漏,要求高的还做氦检。注液前先用超声波排泡,水路抽真空 30 秒以上再瞬间注液,之后是超过 72 小时的高温老化——这些都是 DIY 做不到的。以前娱乐 PC 玩 DIY,出问题学费也不高;现在成本高出太多,而且还得定期维护,还不如风冷用着算了。
-
【直播】4卡R9700从采购到调试@applejuice 不一定。之前人家只做to B是看不上个人用户这点量,热度起来了、需求明确了,谁跟钱过不去。
R9700 各家 PCB 堆叠都是照 AMD 官方文档做的,只有长短板之分——短板是涡轮版,为两侧进风优化的。所以基本上这冷板可以通吃,to C机会实际上挺大的。 -
現在買硬體的選擇实际上现在我不太认为现阶段值得去投入太多的钱。软件的护城河基本上也跟一张纸似得,不见得非得nv的卡,从目前来看明年会有非常多的超大显存方案的推理加速卡出来
-
【直播】4卡R9700从采购到调试@Name-Error alphacool也是 DIY 方案。要高可靠,可以参考 4U/2U 液冷,或者 NV、AMD 原厂推的液冷——都是反复验证过的。
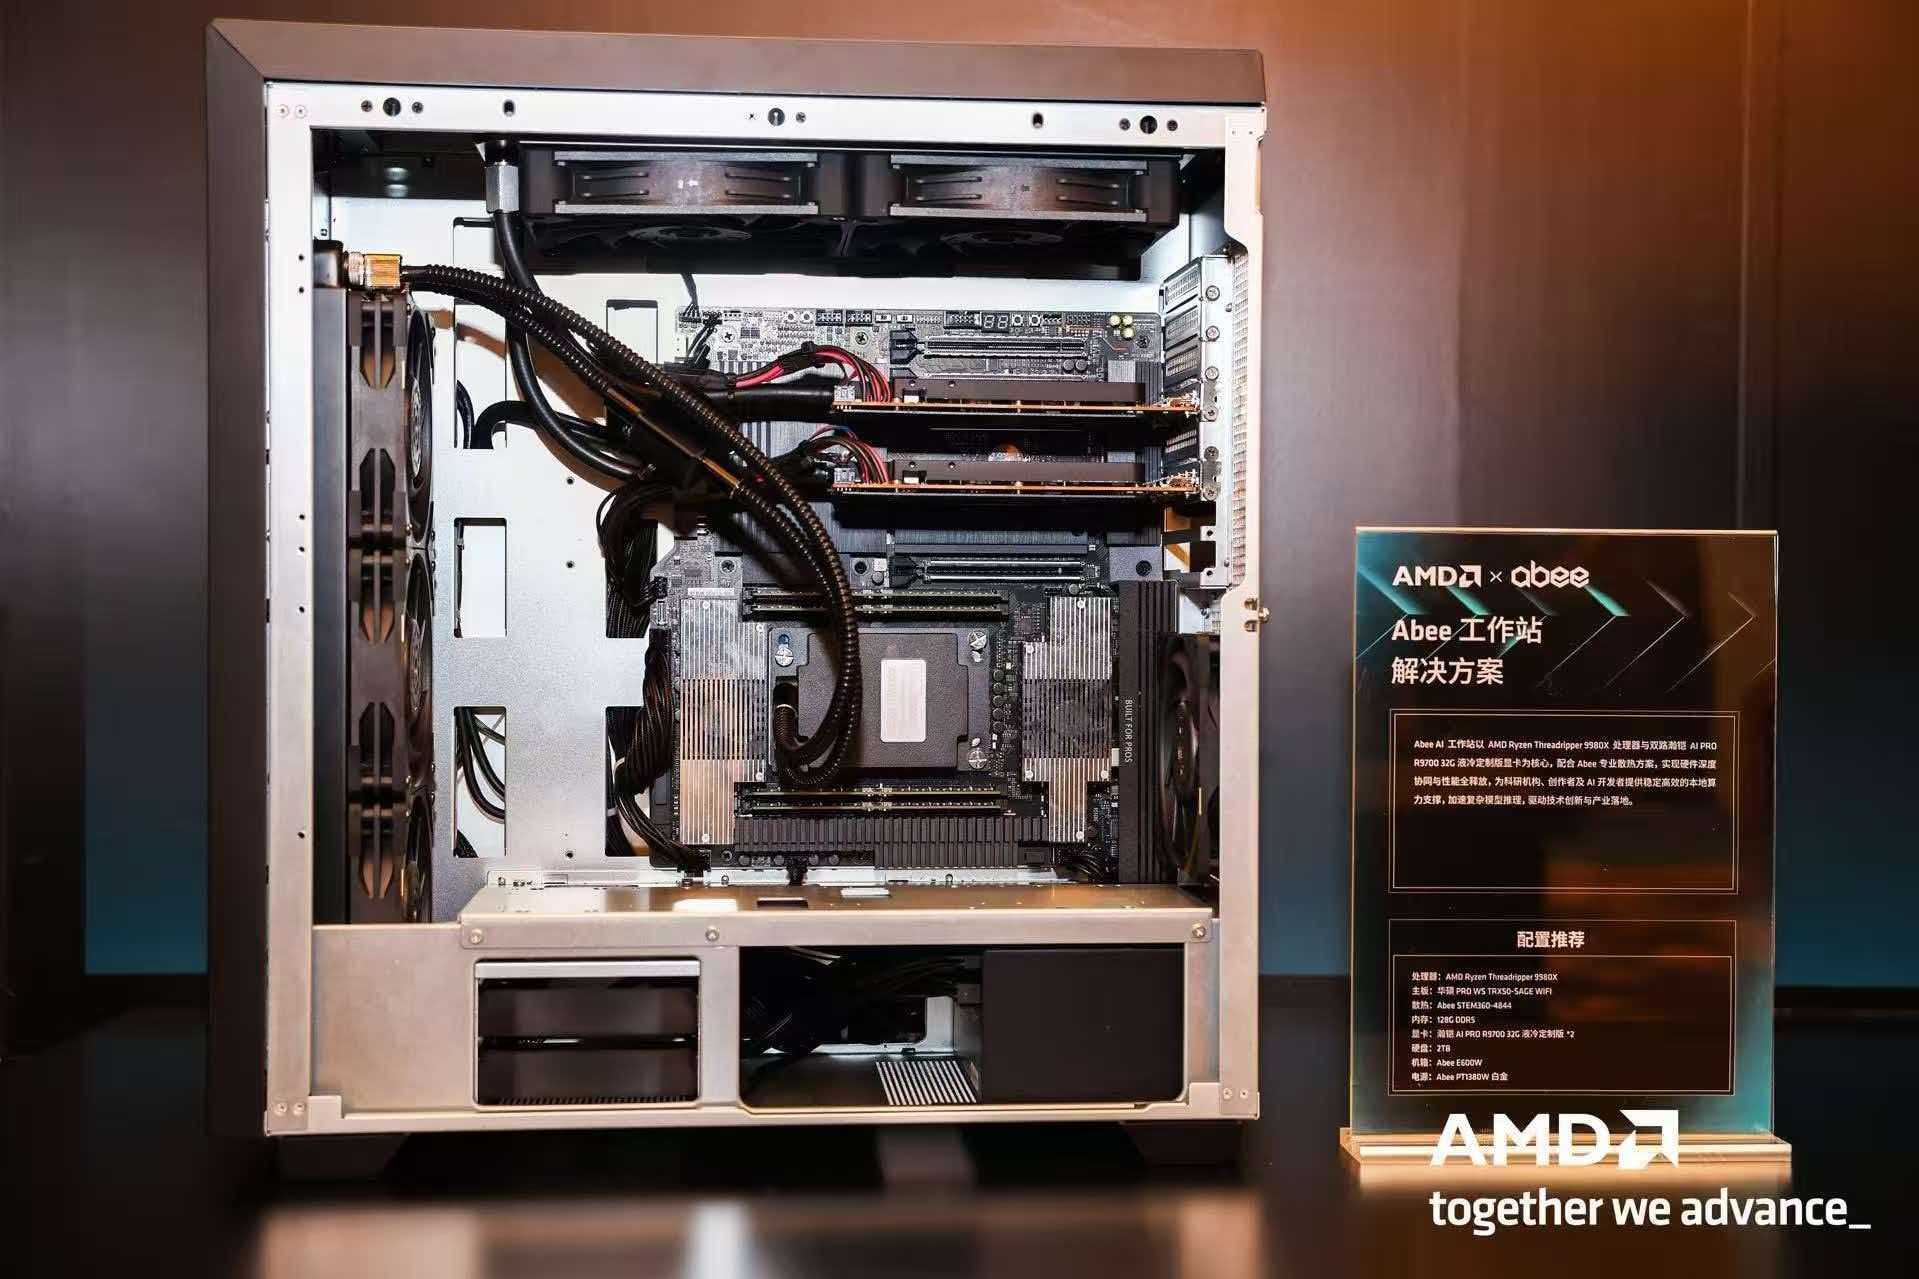
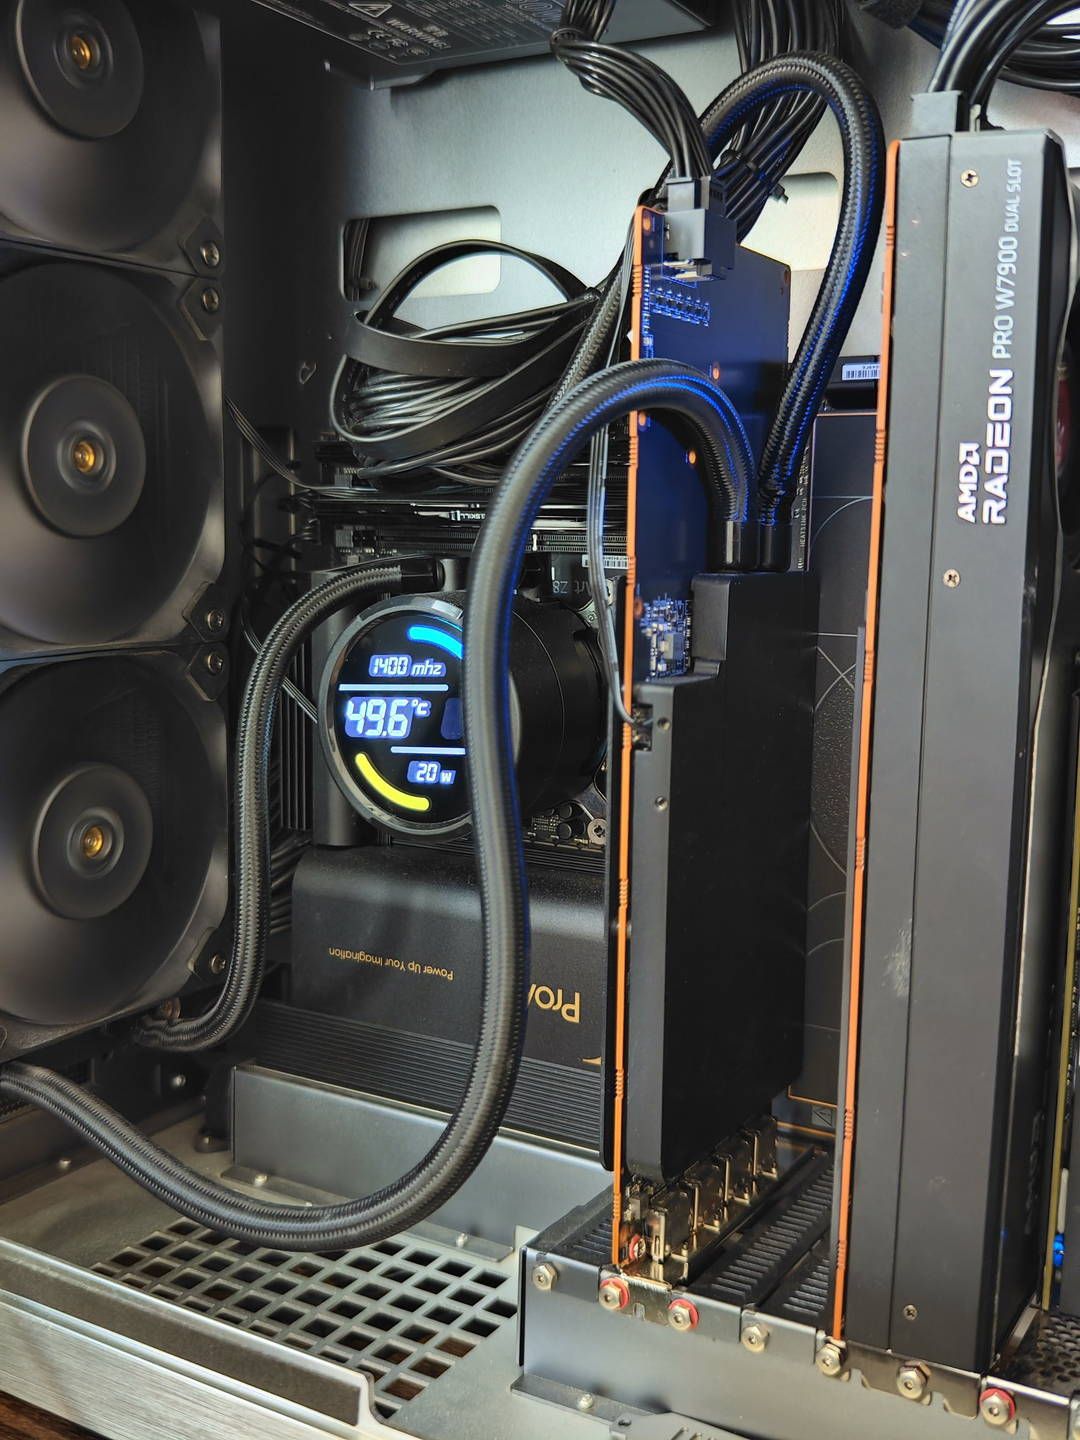
拿 R9700 举例:这是 AMD 在创作者大会上官方推的唯一一台 R9700 液冷,我看到后想办法搞到了这块冷板。但这类方案都是 to B 的,对 C 端很不友好,非得液冷工厂才组装。
图一是 AMD 活动现场的官方图
 ,水路全铜全焊接方案。
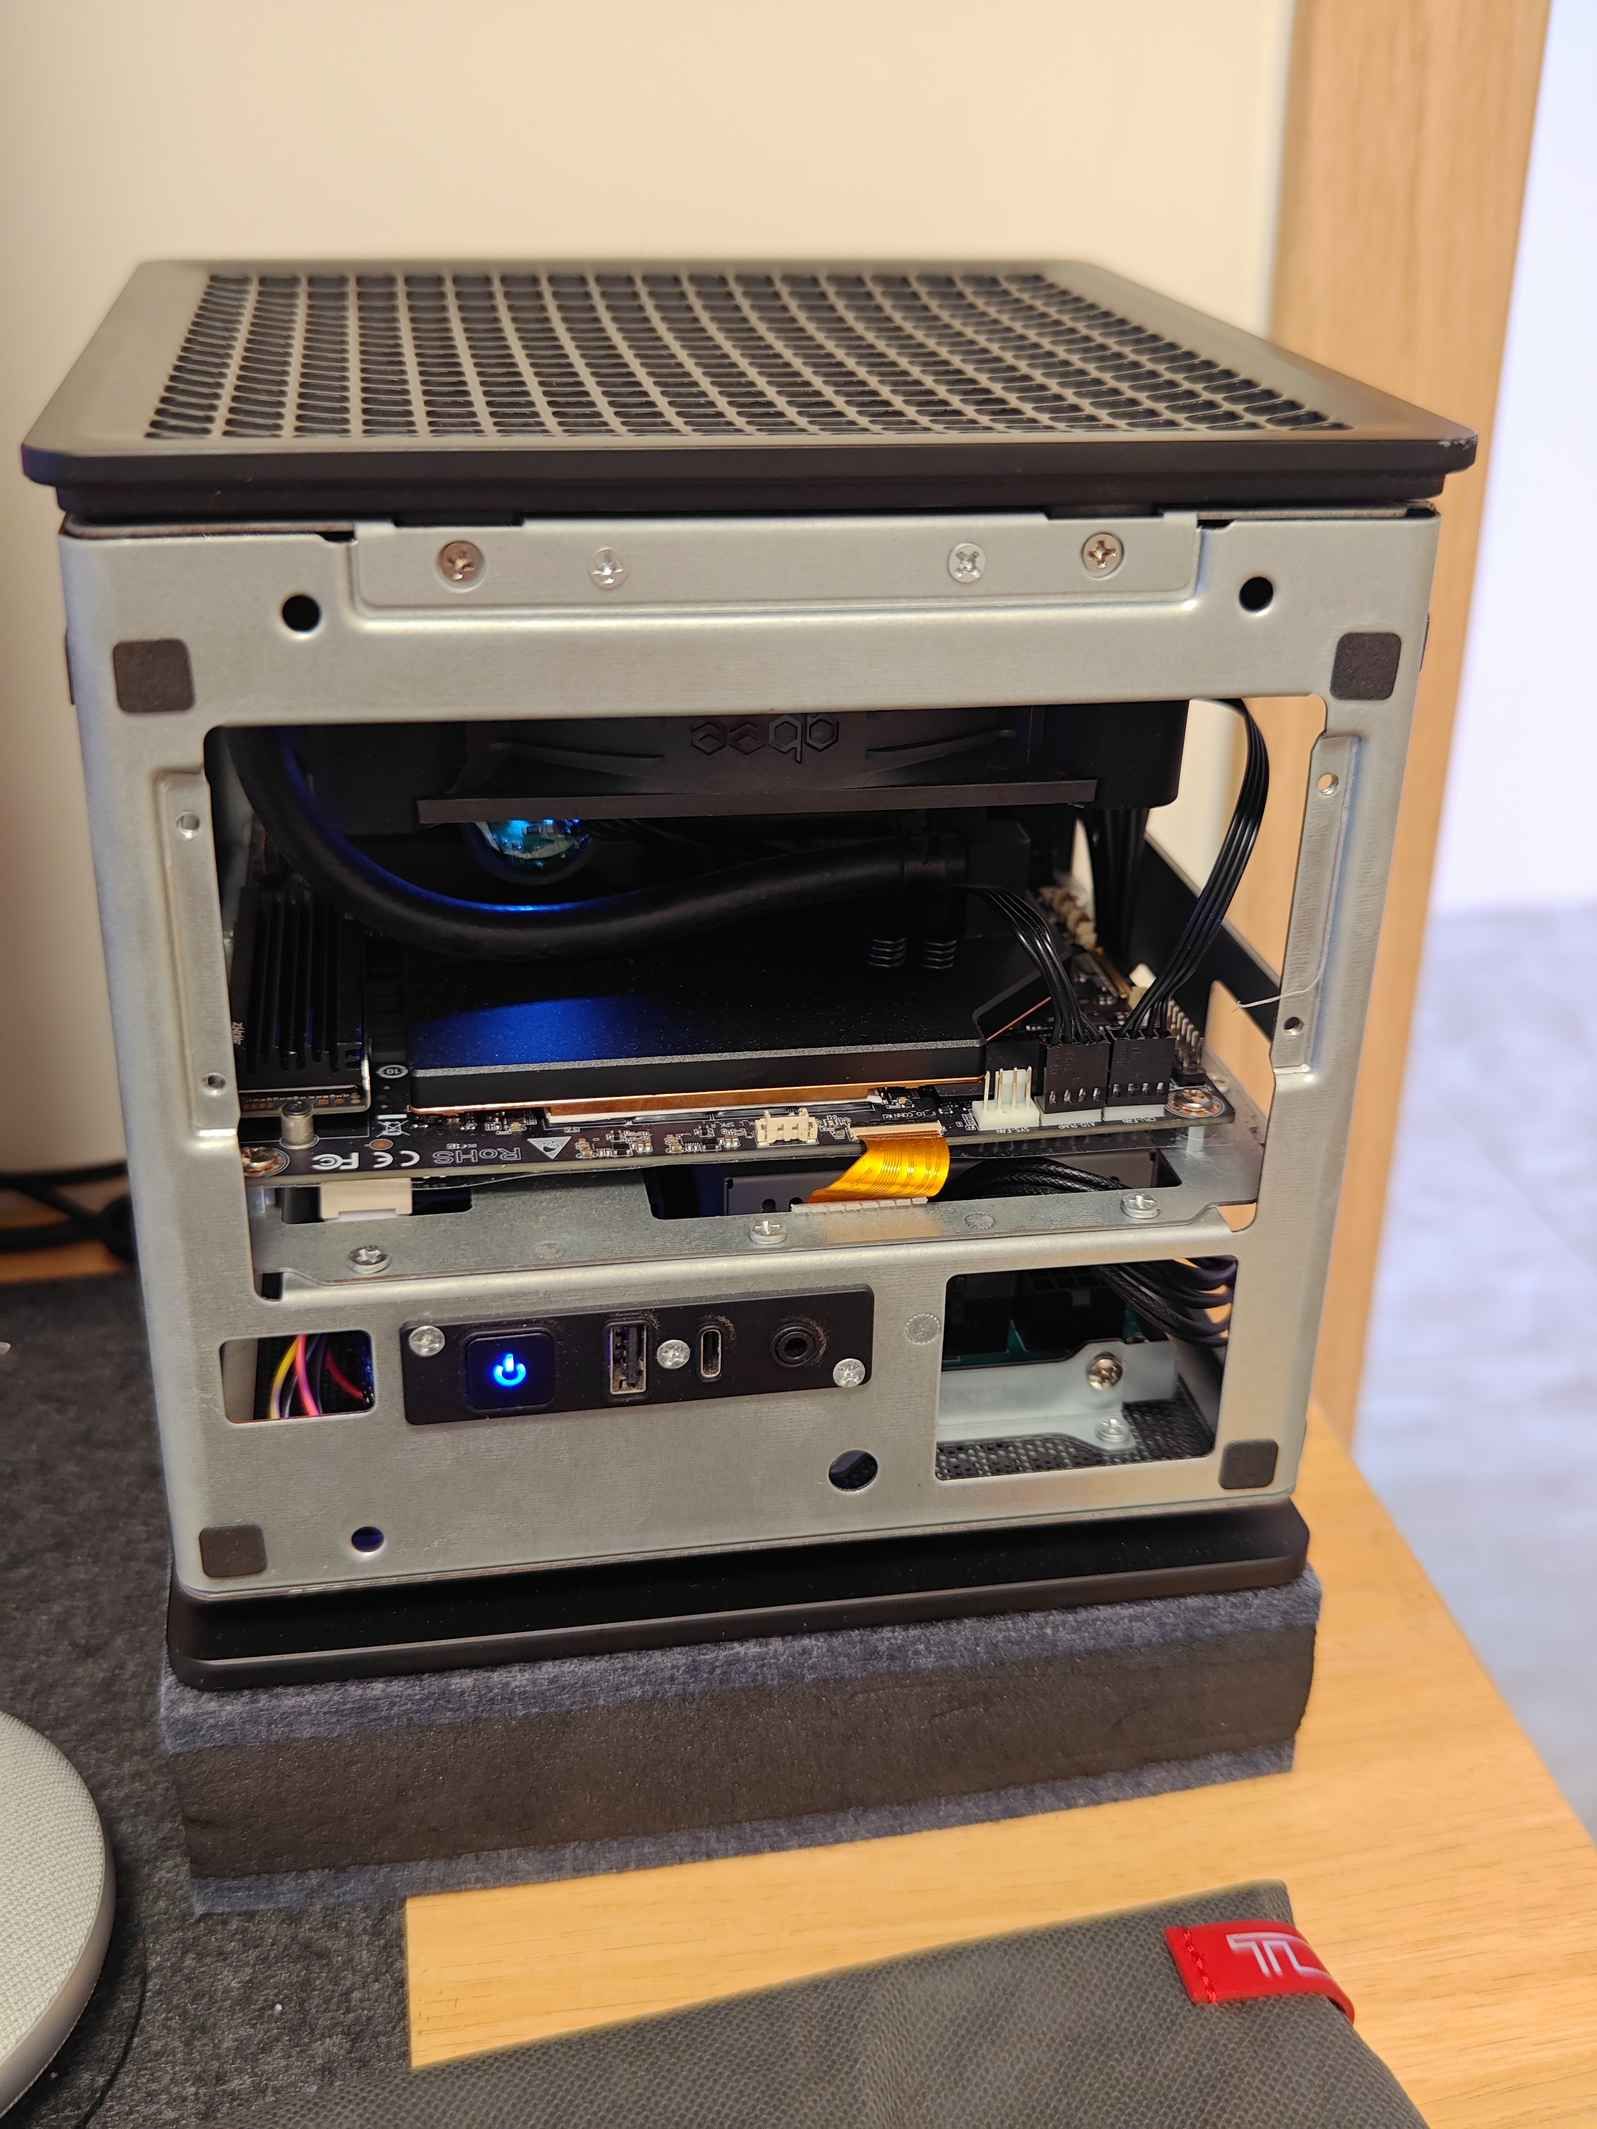
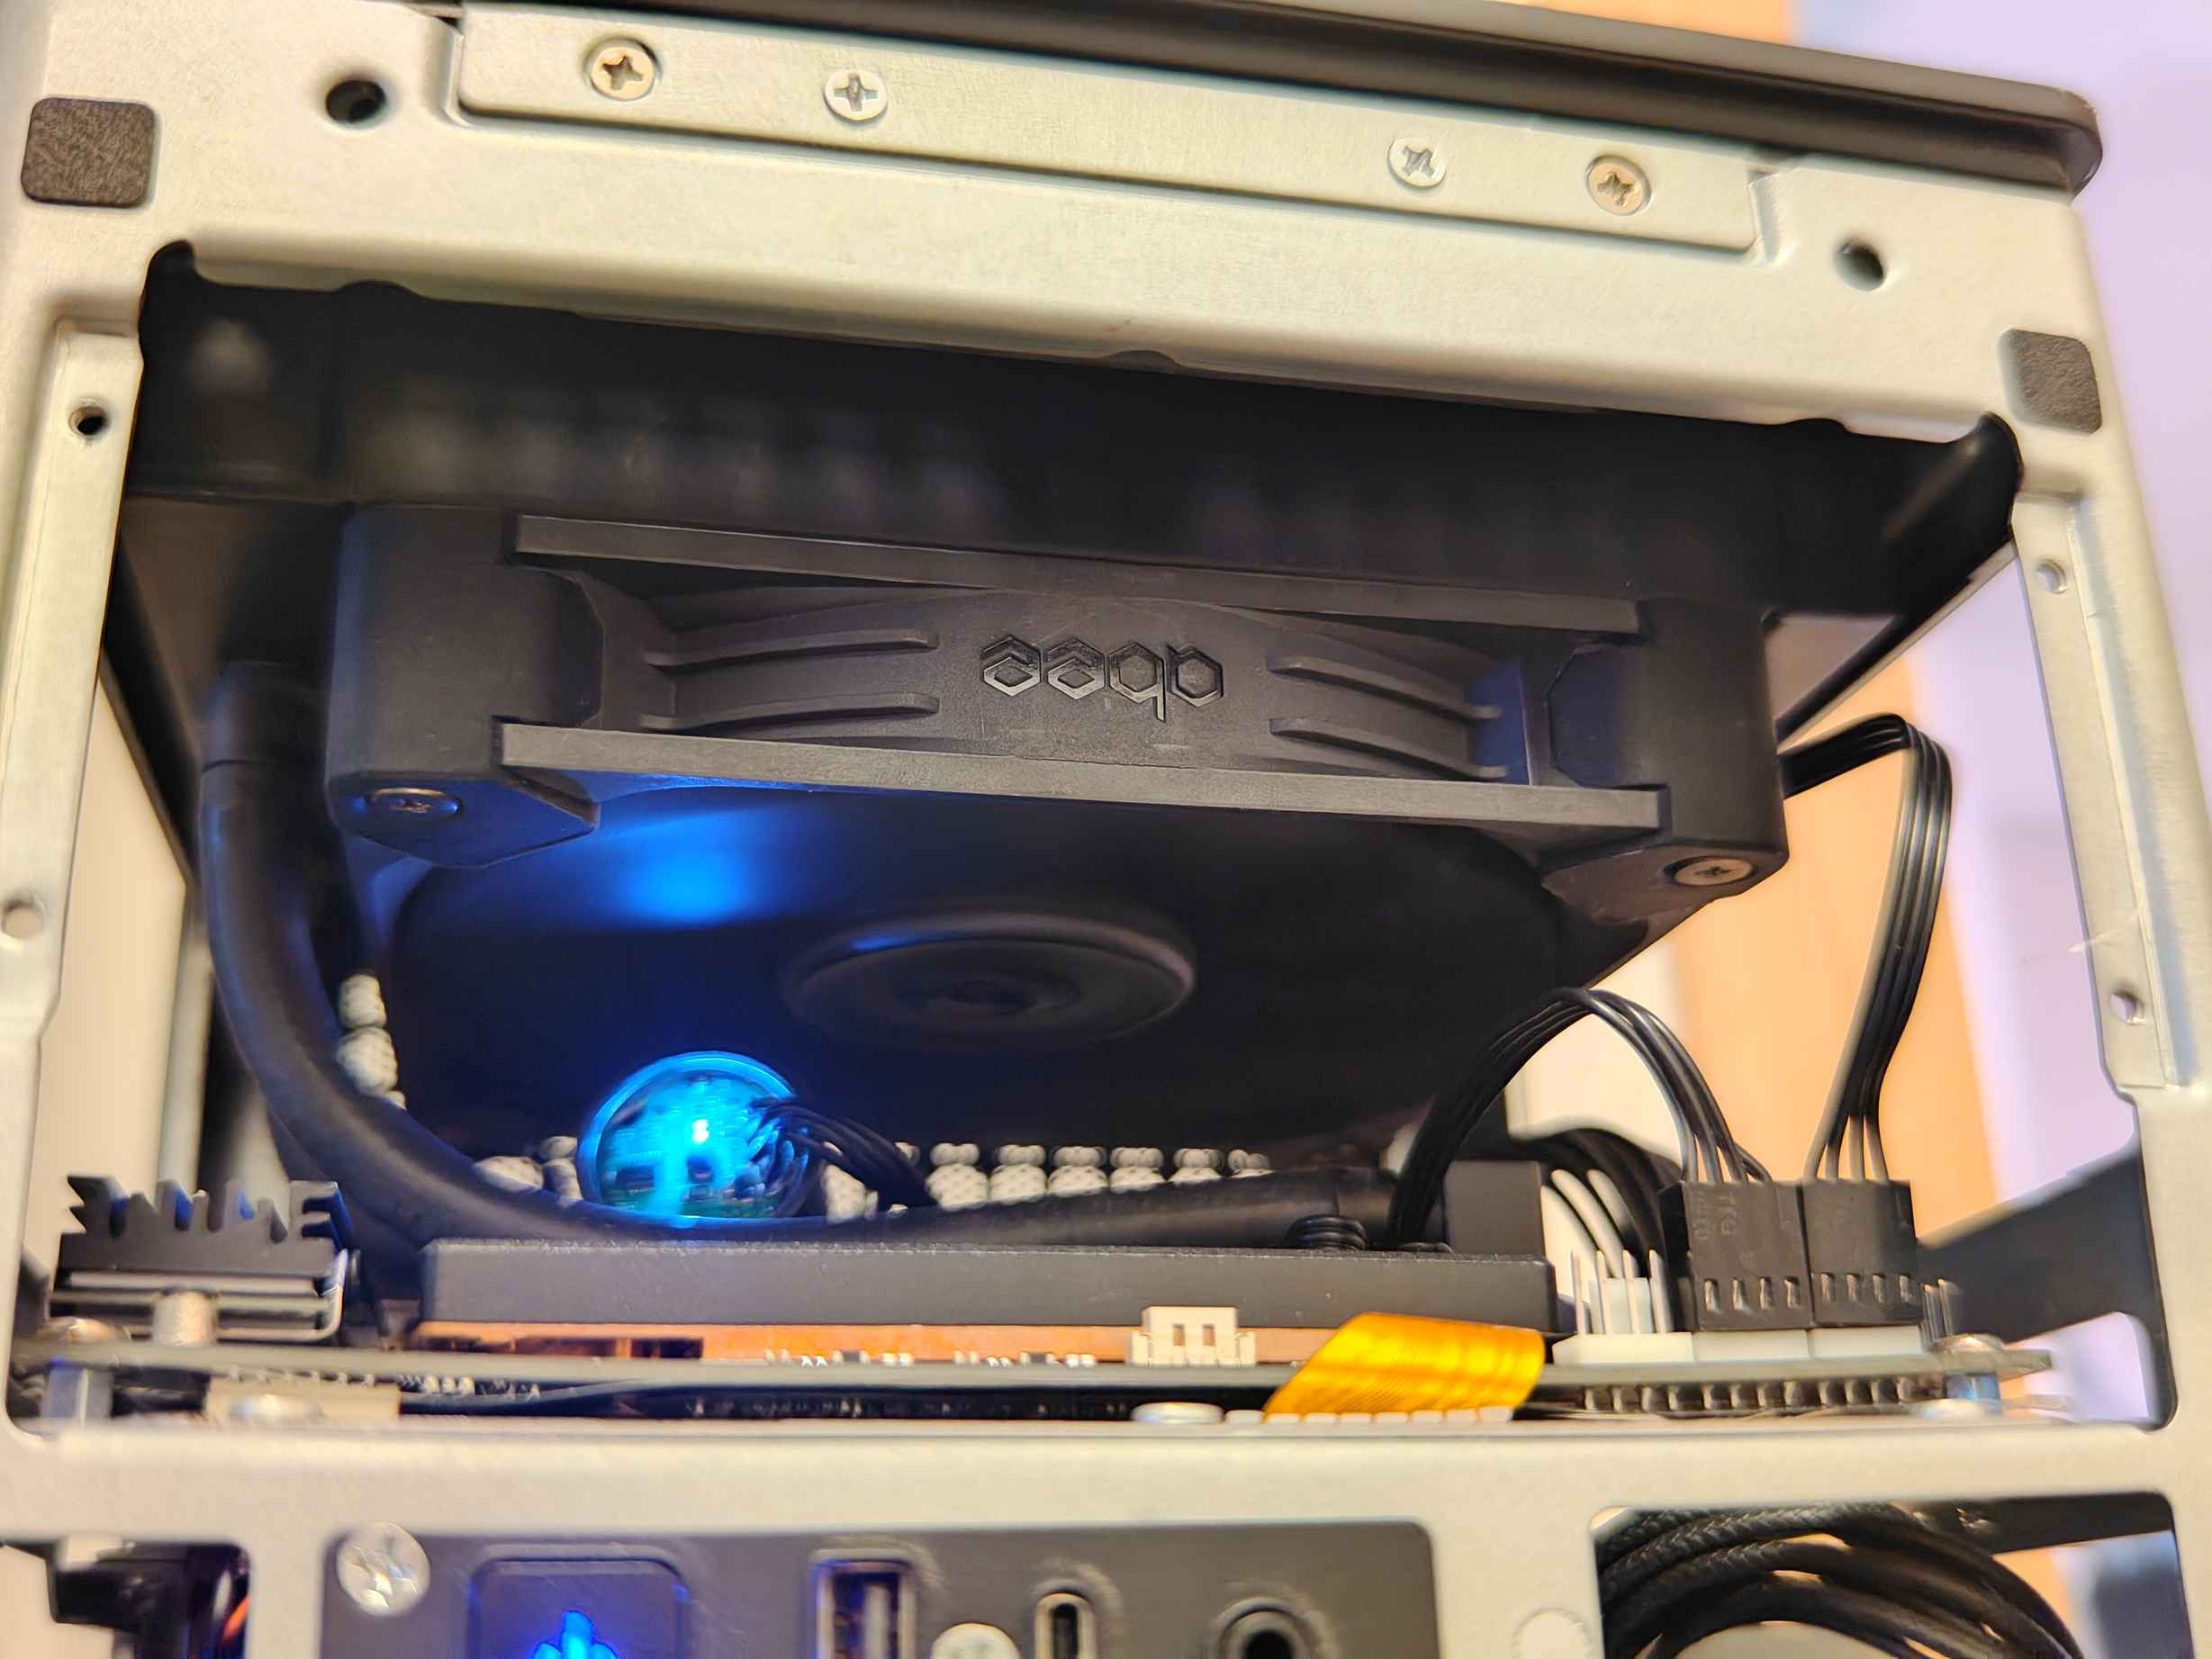
图二是我放老家的机器:拆了一个银昕 360,只留冷头和内置水泵,再请朋友在厂里加上 R9700 冷板重新组装。因为使用频率低,我妥协了不少地方,问题其实还不少——水管用的橡胶管,按理该上 FEP 甚至不锈钢管;冷排是铝的,应该用铜钎焊的;再有银昕这个冷头是锁固结构,也是个问题点。
-
【直播】4卡R9700从采购到调试 -
【直播】4卡R9700从采购到调试@Name-Error 这些都是DIY液冷的方案,风险比较高。
有几个坑:
1,不论是CPU还是GPU冷板(水路的部分)要用全铜和全焊接。不要用密封圈锁固,多一倒密封圈多一道风险;另外绝对不能用亚克力,疲劳开裂很常见。
2,不要自己diy液冷,多一个拧头多一个风险点。
3,别用by,不是针对by,是见过太多问题了。。。 -
【直播】4卡R9700从采购到调试@Name-Error 谁说r9700的液冷没有,我就用着啊
-
请教:双 7900 XTX 有必要出掉一张,换成 32GB 的 R9700 吗?要买就下吧,新的成本16k了
-
gufo對決Halogen 實測Qwen3.8-Flash-Next (AMD AI Max+395) -
gufo對決Halogen 實測Qwen3.8-Flash-Next (AMD AI Max+395)@dardeaw-feng 我就不发图了,怕被判定成广告
 。可以去搜搜液冷的395,要140液冷的那个,还有双8cm的就不太强了。
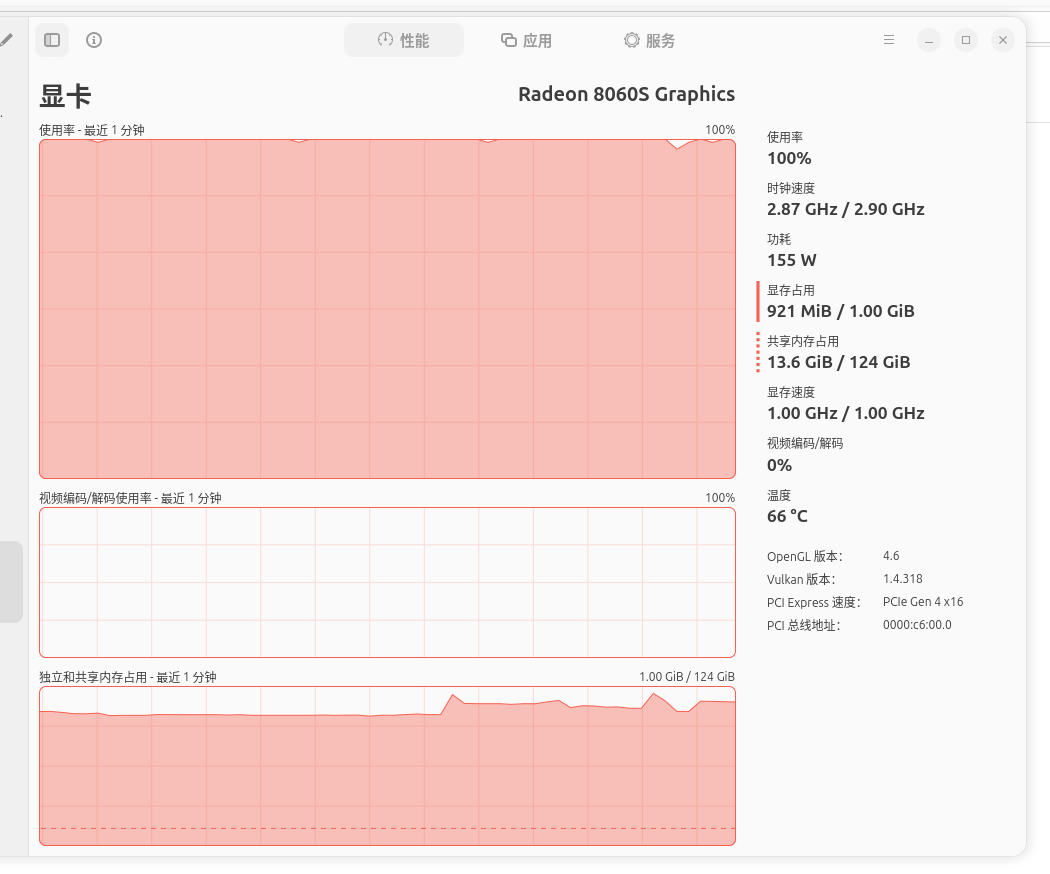
你设置160,但是要看功率是否往下掉,到目前为止风冷的395好像没有能顶住长时间120w的。
395这东西的TDP AMD已经限制死了。我没记错的话,60s的173w fast ppt,然后600s的154w slow ppt。跑模型只要散热够153w是可以常驻的,如果温度压不住,撞了温度墙就开始掉频率(不断降功耗)。
液冷的优势就太大了,单140mm风扇,风扇转速12xx声音基本听不到,温度也就不到70度,跑满slow ppt不要太轻松。双8cm的冷排散热面积小风扇转速高,就会差不少。
-
gufo對決Halogen 實測Qwen3.8-Flash-Next (AMD AI Max+395)@dardeaw-feng 我跑满153w没有任何掉功耗,用的一套液冷,性能释放很充分
更新了0.16.2,解码速度又有了一点提升。
我现在挺满意这台机器,放家里做个服务器用,不占地方也不吵,功耗比较低。
其他机器我基本上就是各种折腾,这台基本是稳定使用 -
追忆青葱岁月 - 那个玩水冷的年代这套配置用DIY液冷OK,以后上高价值的生产力配置建议别用DIY方案,特别是冷板不要用亚克力锁固的(密封圈锁螺丝紧固),特别是现在配置越来越高,价格也越来越贵,高功率长时间负载安全性太低了。改用全铜焊接的,最好能选FETP或者不锈钢管,不要用拧头(每个拧头都是密封圈紧固)
-
各位大佬7900xtx 双卡方案目前哪个好?strata还是sglang?啸叫是玄学,电感高频振动的噪声,跟用电环境关系的可能性更大。换线材都有可能有变化,做接地换更好的电源,或者在AC短加个滤波可能都有作用,另外pcie供电上串电容也可能有效果,以上都有关系可能会好也可能不好,所以是玄学
-
我的显卡温度是不是太高了AMD的卡看结温110度撞墙,跑满载没什么问题。但是你这显存温度有点太高了,显存应该是105开始撞墙,而且确实没太见到显存温度那么高的。机箱风道优化一下吧
-
gufo對決Halogen 實測Qwen3.8-Flash-Next (AMD AI Max+395)@dardeaw-feng 先回答:全部是單路(一次一個請求、串行跑)。2080 / 1850 那些數字都是單請求測出來的。
看到你問,我順手補測了 4 路併發(服務
KV_SLOTS=4,4 路同時打 8K 提示詞、max_tokens=256、temp 0):口徑 單路 4 路併發(每路) 聚合 prefill 4.37 s(1830 tok/s) 4.26 / 4.35 / 4.40 s(1877 / 1840 / 1823 tok/s) prefill 不掉 decode 43.2 tok/s 4.4 / 4.9 / 21.4 / 9.3 tok/s 4 路之和 ≈ 40 tok/s 4 路裡有 1 路是同一條提示詞、命中了剛才單路測試留下的前綴快取(
prompt_n=0),所以 prefill 只列另外 3 路;decode 四路都是真實數據。兩個結論:
- prefill 併發幾乎不掉(每路仍 ~1830–1877 tok/s);
- decode 會塌:單路 43.2 → 每路 4–21 tok/s,四路加起來 ≈ 40 tok/s,跟單路同級。
原因寫在引擎自己的啟動日誌裡:
flash_serve: listening on 127.0.0.1:8730, 4 slots over ONE 262144-position KV pool ...
             MTP depth-2 selectable (drafter 1, speculates while alone)
speculates while alone—— 投機解碼只在「獨占」時開,有人同時生成就退回串行。所以多路併發的意義是「多個會話都要有回應」,不是提高總吞吐。
特別調了什麼
硬體 / 內核層
- BIOS 的 UMA frame buffer 調回最小(只 carve 1 GiB),系統可見 124.4 GiB;
- 內核參數(
GRUB_CMDLINE_LINUX_DEFAULT):
amdgpu.gttsize=126976 ttm.pages_limit=32505856 ttm.page_pool_size=32505856 amd_iommu=off開機後
mem_info_gtt_total出 124.0 GiB。(amd_iommu=off是早期做過 A/B 後留下來的設定,這一輪沒有重測。)- 功耗:PBO 開啟,滿載穩定 ~153 W(跑滿 AMD 的 PPT slow 上限);CPU governor 是
powersave。
引擎層(
HALOGEN_*,跟預設不同的就這幾個)參數 我設 官方預設 為什麼 HALOGEN_MAX_TOK16384 32768 prefill arena 減半。0.16.0 上兩者速度在噪聲內(@32K:2001 vs 1957),但 working memory 從 12.5 → 8.1 GiB HALOGEN_KV_POOL_POSITIONS262144 2×CTX = 524288 同理,省下 7.2 GiB 給頁快取 HALOGEN_HOST_RESERVE_GIB24 20 同上,留更多給頁快取 HALOGEN_COMPOSABLE_CONTEXT0 0 實測開著在 8K 提示詞上慢 16.7% HALOGEN_REASONING_EFFORTlow 模板 xhigh 預設在 agent 長鏈上思考過久(慢約 3 倍) HALOGEN_PROMPT_CACHE2 2 resume-anywhere HALOGEN_CACHE_DIR/cache未設 快取落盤,重啟後續聊 HALOGEN_CACHE_BRANCHES3 2 父會話分叉出子代理時保住 resume point HALOGEN_CACHE_PRUNE_OLD1 0 升級時清掉舊 build 殘留子樹 HALOGEN_VISION_TOWER1 未設 開視覺 核心邏輯一句話:
MAX_TOK與KV_POOL_POSITIONS都往小調,把 RAM 讓給那張 47.7 GiB 的 n-gram 查找表(它不常駐,全靠 page cache)。checkpoint
用 v2(
qwen38-flash-next-v2.hgn62.11 GiB + 獨立ngram.hgn47.68 GiB),不是舊的 w4b。常駐從 87.0 → 78.3 GiB(多出 8.7 GiB 給頁快取),同題 ppl 好 1.9%。容器啟動參數
podman run --rm --name halogen-flash -p 8731:8731 \
  --device /dev/kfd --device /dev/dri --group-add keep-groups \
  --security-opt seccomp=unconfined --ipc=host --ulimit memlock=-1:-1 \
  -v <models>:/models:ro -v <cache>:/cache \
  -e HALOGEN_KV_POOL_POSITIONS=262144 -e HALOGEN_PROMPT_CACHE=2 \
  -e HALOGEN_HOST_RESERVE_GIB=24 -e HALOGEN_VISION_TOWER=1 \
  -e HALOGEN_COMPOSABLE_CONTEXT=0 -e HALOGEN_CACHE_DIR=/cache \
  -e HALOGEN_REASONING_EFFORT=low -e HALOGEN_MAX_TOK=16384 \
  -e HALOGEN_PREFILL_CHUNK=16384 -e HALOGEN_CACHE_PRUNE_OLD=1 \
  -e HALOGEN_CACHE_BRANCHES=3 \
  ghcr.io/peonist-ai/halogen-flash-server:0.16.0
啟動後記憶體實測行:
memory: 62.9 GiB of weights locked in RAM (0.8 of them the vision tower's),
        7.2 GiB of KV pool, 8.1 GiB of working memory, 78.3 GiB in all
單路完整數據(0.16.0 + v2,temp 0、effort low)
prefill 隨深度
深度 / 規模 prefill 速度 4K 1960 tok/s 32K 2080 tok/s 64K 2042 tok/s 128K 1991 tok/s 192K 1850 tok/s 244K 1848 tok/s 256K 1824 tok/s 260K 1836 tok/s 4K → 260K 只掉 6%,沒有「越長越慢」。
decode(與深度無關)
口徑 decode 512 token 樣本 @32K(樣本最大) 44.1 tok/s niah 檢索(每次只生成 32 token) 36.4 – 37.9 tok/s 長上下文 API(每次 187–200 token) 28 – 53 tok/s decode 速度不隨上下文深度變化 —— 48/64 層沒有 KV cache。
它主要由投機解碼命中率(生成內容的可預測性)與樣本長度決定:
同一種任務在 192K / 244K / 256K 上分別測到 52.2 / 28.1 / 53.1 tok/s,
散布這麼大是短樣本的起停開銷造成的,不是「越長越快」。檢索完整性(引擎
niah,深度 × 位置)深度 p05 p50 p95 合計 4,096 3/3 3/3 3/3 9/9(100%) 32,768 3/3 3/3 3/3 9/9(100%) 65,536 3/3 3/3 3/3 9/9(100%) 131,072 3/3 2/3 3/3 8/9(88.9%) 總計 35/36(97.2%) prompt cache
口徑 冷 暖 128K 前綴第二輪 58.5 s 0.0 s( prompt_n=0,端到端 2.9 s)259K 前綴命中 — 端到端 3.7 s 上限
prompt + max_tokens ≤ 262,144,用同一條 259,474 token 的提示詞卡過邊界:max_tokens合計 結果 2,670 262,144  200
2,671 262,145  400(
leaving room for 2670)