@Terry 确实拉,后面剑心的剑还穿模了 
-
[H3剑心比赛] Mac Studio M5 Max 40 GPU 64 GB 统一内存|MiniMax H3 3D / 2D |Draw Things 单卡一次跑完 294 帧 -
[H3剑心比赛] Mac Studio M5 Max 40 GPU 64 GB 统一内存|MiniMax H3 3D / 2D |Draw Things 单卡一次跑完 294 帧前言
重在参与。用的Drawthings, 没有调教,没有任何优化。
这次参赛没有分段、没有 LoRA、没有 turbo 加速,也没有 ffmpeg 拼接。两条 12 秒成片都是同一台 Mac Studio 上、同一个 Draw Things 项目里,一次生成 294 帧(1344×768)出来的。下面所有参数、耗时都来自 Draw Things 项目数据库里的计时 log(每条生成记录的
duration/timings),不是估算。- 3D CGI 成片:https://youtu.be/7X3QUBg-3LQ
- 传统 2D 动画成片:https://youtu.be/noVovfnEz7s
硬件 / 软件环境
- 机器:Mac Studio
- 芯片:Apple M5 Max,18 核(6 超级核 + 12 性能核)
- 内存:64 GB 统一内存
- OS:macOS 27.0.1
- 推理栈:Draw Things 26.1020.0(CoreML / Metal,纯苹果栈,没有 ComfyUI、没有 ROCm、没有 CUDA)
- 输出格式:Draw Things 原生视频 + 同步音频 → ProRes 4444(1344×768, 24 fps)+ PCM 32 kHz 立体声
M 卡跑 H3 的难点不是"跑不通",而是"跑得慢":294 帧整段生成,采样阶段占了 98% 以上的时间,单步 4 分钟上下。能一次跑完 294 帧靠的是下面几个设定。
模型档案
minimax_h3_ref2va_i8x.ckpt— 34.4 GB(Ref2VA 基座,i8x 量化)qwen_3_vl_32b_50_i8x.ckpt— 26.5 GB(Qwen3-VL-32B 文字编码器,i8x)minimax_h3_vae_f16.ckpt— 5.51 GB(视频 / 音频 VAE,FP16)- 合计约 66.4 GB 权重,全部在 64 GB 统一内存里跑
- LoRA:无(
loras: [])|upscaler:无|face restoration:无|hiresFix:关闭 - 参考图走 canvas / moodboard 喂入(比赛主帖指定的那组剑心、志志雄参考图)
关键参数(两条片子除 Style 与 seed 之外完全一致)
项 3D 版 2D 版 模型 minimax_h3_ref2va_i8x.ckpt同 分辨率 1344 × 768 1344 × 768 帧数 294 294 步数 50 50 采样器 DDIM Trailing( sampler: 16)同 Shift / Audio Shift 12 / 3 12 / 3 Text guidance 1 1 Seed 2254839087 1694873285 Seed mode ScaleAlike( seedMode: 2)同 分块解码 开启,tile 256×256,overlap 64 同 分块扩散 关闭 关闭 teaCache 关闭 关闭 maskBlur / maskBlurOutset 1.5 / 0 1.5 / 0 sharpness 0 0 batchCount 1 1 strength 1 1 这些数值就是官方 Ref2VA 的推荐起点(768 短边、50 步 DDIM Trailing、Text Guidance 1、Shift 12、Audio Shift 3),没有改动。
为什么 64 GB 能一次跑完 294 帧
- i8x 量化基座 + i8x 文字编码器:34.4 GB + 26.5 GB,这是 Draw Things 官方给 H3 的量化版本,也是 64 GB 机器唯一可行的组合。
tiledDecoding: true(tile 256×256 / overlap 64):VAE 解码按块进行,294 帧不是一次性解码,解码阶段只用了 122.6 s / 117.0 s。tiledDiffusion: false:扩散本身整块跑 —— 说明 294 帧的 latent 在 64 GB 里放得下,不需要分段。- 没有 turbo LoRA:官方 Ref2VA 基座没有 4-step turbo 分支,所以只能 50 步硬跑,这是耗时的根源。
实测耗时(取自项目 sqlite 里的
duration/timings)版本 总耗时 text_encoded controls_generated sampling image_decoded 3D 12,542.3 s(3 h 29 m 02 s) 43.8 s 22.4 s 12,353.2 s(98.5%) 122.6 s 2D 13,619.0 s(3 h 46 m 59 s) 65.8 s 5.9 s 13,430.1 s(98.6%) 117.0 s 采样阶段逐步耗时:
- 3D:首条 log 22.6 s(首块预热),其余 50 步平均 246.6 s/步,区间 238.3 – 254.4 s
- 2D:首条 log 14.7 s,其余 50 步平均 268.3 s/步,区间 259.9 – 279.4 s
2D 版比 3D 版慢 1,076.7 s(约 18 分钟),每步慢约 22 s。
成片校验
项 3D 2D 分辨率 1344 × 768 1344 × 768 帧率 / 帧数 24 fps / 294 帧 24 fps / 294 帧 时长 12.25 s 12.25 s 视频编码 ProRes 4444(ap4h) ProRes 4444(ap4h) 音频 PCM 32 kHz 立体声,非静音 PCM 32 kHz 立体声,非静音 文件大小 326 MB 305 MB 直接在 1344×768 采样,无缩放、无补帧、无裁切。
Prompt(统一英文,只切 Style)
3D 版:
Style: 3D CGI animation  Masterpiece, high quality, cinematic lighting.
Subject: A fierce battle sequence featuring two characters based on the reference images—a red-clad swordsman (Jianxin) and a purple-robed warrior (Zhizhixiong).
Action: The camera begins with a dynamic low-angle tracking shot. The swordsman in red dashes forward with a long sword, leaving a glowing trail, while the warrior in purple stands firm and executes a sweeping counter-attack with a flaming effect. They clash in the center of the frame, creating a shockwave of energy and sparks. The camera rapidly orbits around them as the fiery battle intensifies, concluding with the red-clad swordsman landing gracefully while the purple warrior points his weapon forward, both facing the camera.
Environment: Dramatic background with embers floating in the air, high contrast lighting.
2D 版:开头换成
2D traditional anime,其余一字不差。画面对照
两版都完成了 prompt 要求的:红衣剑客突进、火焰横扫反击、中央交锋、镜头斜向/低角度环绕、结尾双方持刃相对。
- 3D 版:材质光滑、光影立体,人物接近手办/三维渲染质感;火星与火焰柱构成包围式构图,轮廓光明显。
- 2D 版:线条清晰、色块分明、阴影戏剧化,典型赛璐璐手绘动画调性;剑刃交错与橙黄光带形成对角线构图,红发紫眼剑客与缠脸紫袍对手的对决更"动画化"。
复现说明
附件
3D.json/2D.json就是这两条成片对应的 Draw Things 生成参数导出,逐字段可核对。同环境(M5 Max 64 GB + Draw Things 26.1020.0 + 上述三个权重)用同一 prompt、同一 seed 重跑即可复现:3D seed 2254839087,2D seed 1694873285。需要留意的两点:
- 64 GB 是这条链路的下限体验,294 帧整段扩散靠 i8x 量化才放得下;换 i6x 或加 hiresFix 会撑爆。
- 没有 4-step turbo LoRA 可用(Ref2VA 基座不支持),所以 50 步是硬成本,一条 12 秒成片约 3.5 小时。
-
【实测】Mac Studio M5 Max 64GB 跑 Strata + Qwen3.8-Flash-Next Q2_0:安装、配置与 256K 上下文阶梯实测 -
【实测】Mac Studio M5 Max 64GB 跑 Strata + Qwen3.8-Flash-Next Q2_0:安装、配置与 256K 上下文阶梯实测 -
【实测】Mac Studio M5 Max 64GB 跑 Strata + Qwen3.8-Flash-Next Q2_0:安装、配置与 256K 上下文阶梯实测结论先说:64GB 的 M5 Max 能跑 125B 的 Qwen3.8-Flash-Next(Q2_0 量化),262K 上下文完整跑通,512K 卡在时间预算而不是模型本身。
实测 prefill 吞吐约 1,870–2,077 tok/s,生成吞吐约 79–89 tok/s;512K 请求引擎侧实际跑了 310.5 s 才被客户端中止。
一、测试机器
项目 配置 机型 Mac Studio(Mac17,14,型号 MHQJ4LL/A) 芯片 Apple M5 Max CPU 18 核(6 超级核 + 12 性能核) 统一内存 64 GB GPU 内置,40 核,Metal 4 系统 macOS 27.0.1(Build 26A434),arm64 引擎自报的 CPU 配置(启动日志):
CPU pool: 16 workers by default (18 physical cores, 18 logical processors;
bounded by physical cores, one kept free)
host thread on core 0 (draining too)
this CPU has no AVX-512: the expert kernels run on ggml-cpu vec_dot
二、软件与模型
项目 内容 推理框架 Strata(开源,MIT)—— 版本 0.2.1,Metal 引擎 0.1.46.2(日志显示 engine 0.1.46-metal)模型 Qwen3.8-Flash-Next,125B 参数 MoE(48 层,每层 512 专家) 量化版本 ISTA-DASLab 的 GSQ-RCO Q2_0(分 2 个 shard) 模型体积 shard1 37.6 GB + shard2(PLE n-gram 表) 28.8 GB = 66.4 GB 视觉编码器 mmproj-Qwen3.8-Flash-Next-BF16.gguf,0.91 GBMTP 草稿层 mtp-q2_0.gguf,0.89 GB(draft 词表 106,299 tokens)本地 pack packs/q2_0/dense.bin,1.49 GB(1,079 个张量)磁盘总占用 Strata-data/约 70 GB服务地址 OpenAI 兼容 API: http://127.0.0.1:8080/v1;聊天页:http://127.0.0.1:8080//v1/health返回:{"status":"ok","max_context":524288,"model":"qwen3.8-flash-next-q2_0", "images":true,"api_key":false,"loaded":true,"service":"strata"}
三、安装过程(Mac 源码路线)
Strata 在 Mac 上有两条路:
.dmg应用 / Terminal 版(预编译引擎),或源码./setup.sh(自己编译 Metal 引擎)。本机走的是源码路线。git clone https://github.com/Niko1221/Strata && cd Strata ./setup.sh # 问模型尺寸;--yes 走推荐答案setup.sh依次做 7 件事(已完成的步骤会自动跳过):- Python:需要 3.10+,macOS 自带 3.9 时会下载一个 25 MB 的独立 Python 3.12(SHA-256 校验),不需要 sudo/Homebrew。本机已有 Homebrew Python 3.14,直接建
.venv。 - 体检:芯片、内存、macOS 版本、Command Line Tools、磁盘空间。
- Python 依赖装进
.venv,CMake 与 Ninja 也来自 pip。 - 编译引擎
build-metal/strata(Apple metal-cpp 头文件 + llama.cpp 的 ggml,本机 AppleClang 21)。 - 下载模型(断点续传;已有 GGUF 可用
--gguf-dir)。 - 准备模型:生成 pack(几秒)+ MTP 草稿层(约 5 GB 原始 checkpoint)。
- 写
strata-<model>.json与run-<model>.sh,然后启动服务。
本机实际时间线(2026-10-20)
时间 事件 14:02 创建 .venv(Python 3.14.7)14:03 Metal 引擎编译完成( build-metal/strata,4.7 MB)14:17 模型 shard 1 下载完成(37.6 GB) 14:27 模型 shard 2 下载完成(28.8 GB) 14:28 视觉编码器 + pack( dense.bin1.49 GB)就绪;strata-vision编译完成14:31 MTP 草稿层(0.89 GB)生成;写入 run-q2_0.sh14:31:43 引擎首次启动, --max-context 3276815:24 / 15:32 / 16:52 上下文依次调到 131072 → 262144 → 262144 20:19 / 20:56 上下文调到 524288,跑阶梯实测
四、配置信息
strata-q2_0.json(由run-q2_0.sh调用):{ "exe": ".../build-metal/strata", "args": [ "--pack", ".../Strata-data/packs/q2_0", "--native", ".../Qwen3.8-Flash-Next-GSQ-RCO-Q2_0-00001-of-00002.gguf", "--ple-gguf", ".../Qwen3.8-Flash-Next-GSQ-RCO-Q2_0-00002-of-00002.gguf", "--expert-profile", ".../Strata/data/expert-profile.bin", "--expert-cache", "64", "--prefill", "auto", "--spec", "2", "--mtp", ".../Strata-data/mtp/rt", "--max-context", "524288", "--mmap-experts", "--vision" ], "tokenizer": ".../packs/q2_0/tokenizer", "model_name": "qwen3.8-flash-next-q2_0", "port": 8080, "backend": "metal", "env": { "STRATA_METAL_STREAM": "0" }, "vision": { "exe": ".../build-vision/bin/strata-vision", "mmproj": ".../mmproj-Qwen3.8-Flash-Next-BF16.gguf", "gpu": true, "max_tokens": 1024 } }参数含义(按本机实测理解):
参数 作用 --native37.6 GB 主文件被 Metal 直接映射进统一内存("wrapped"),专家权重不复制 --ple-gguf28.8 GB 的 n-gram PLE 表,从 SSD 逐行读,不计入显存 --expert-cache 64常驻 GPU 的专家槽位 64 个,仅 0.08 GiB;按路由频率排序,不淘汰 --expert-profile24,576 个专家配对的排序表,决定哪些专家常驻 --spec 2MTP 投机解码窗口 2(Mac 默认值) --mtp草稿层,实测 drafts accepted 7 of 8--max-context上下文窗口,本机从 32768 逐步调到 524288 --vision图片输入开启(默认开)  ️ 524K 上下文时引擎的警告:
serve: 0 MiB of VRAM free with everything loaded - LOW: requests may stall;
  add --vram-reserve-mib 1212 to the config's args (or lower --max-context)
另外
memory guard: the available RAM cannot be read; parking and session save/restore are refused—— 所以 Strata 侧没有 oMLX 那样的/admin/api/stats,测试脚本无法采集内存峰值(报告里peak GiB为-)。
五、测试工具
自写脚本
scripts/local-test/context_capacity_probe.py:- 扫描本机 OpenAI 兼容端口(8000 / 8080),列出在线模型供选择;
- 先做 校准(测 chat 模板开销与 tokens/字符比例,本次模板开销 72 tokens,filler 47 tokens/行);
- 然后按 16K → 32K → 64K → 128K → 256K → 512K 阶梯上升;
- 每步
max_tokens=16,记录真实prompt_tokens / completion_tokens / prefill_ms / total_time / 墙钟时间; - 任一步失败(OOM、memory guard、超时、上下文超限、服务端截断)立即停止,不再试更高阶梯;
- 每次运行独立目录,不覆盖旧结果。
本次运行参数:
--mode ladder,--gen-tokens 16,--time-budget 480,--max-requests 20,--request-timeout 360。
六、实测结果(run-20261020-201926-074430ec)
- 目标模型:
qwen3.8-flash-next-q2_0@http://127.0.0.1:8080/v1 - 状态:
ladder_stopped_timeout,总耗时 479.61 s,请求 10 条(9 成功 / 1 失败)
阶梯上下文 目标 prompt 实际 prompt prompt 字符 gen tokens prefill(ms) prefill tok/s total(s) 状态 16,384 16,304 16,286 60,408 16 7,840.0 2,077 8.14 OK 32,768 32,688 32,689 121,483 16 16,048.3 2,037 16.26 OK 65,536 65,456 65,448 243,458 16 32,262.5 2,029 32.49 OK 131,072 130,992 131,013 487,583 16 66,416.4 1,973 66.69 OK 262,144 262,064 262,049 975,483 16 140,141.4 1,870 140.48 OK 524,288 524,208 — 1,951,633 — — — 210.54 timeout 关键指标:
指标 值 最高完成阶梯 262,144 tokens 实测最大 prompt tokens ≥ 262,049 上下文可信区间 [262,049, 524,208]prefill 吞吐中位数 / P95 2,029 / 2,077 tok/s 生成吞吐中位数 78.7 tok/s 最大单请求耗时 210.54 s 请求体总字节 3,853,524 B 缓存命中 token 0(每阶梯都是新会话) 引擎侧对应日志(同一请求):
prompt 262049 tokens = 0 reused + 262049 read in 140141 ms (1869.9 tok/s),
  16 generated in 203 ms (78.7 tok/s), drafts accepted 7 of 8, 6 checkpoints
prompt 524215 tokens = 0 reused + 524210 of 524215 read in 310525 ms (1688.1 tok/s),
  0 generated in 2 ms (0.0 tok/s) (cancelled)
七、结果解读
1. 262K 是真跑通的,不是"声明支持"。
服务端/health声明max_context: 524288,但声明不等于可用。实测 262K 完整 prefill + 生成 16 token,没有任何截断或报错。2. 512K 失败是"时间预算"问题,不是模型拒绝。
失败类型是Timeout: TimeoutError,HTTP 状态-1(客户端侧),而不是服务端返回 400/500。整轮运行耗时 479.61 s,正好撞上--time-budget 480的全局预算,所以这条请求在 210.5 s 处被客户端看门狗中止;引擎日志显示该请求的 prefill 推进到 524,210 / 524,215 tokens,累计 310.5 s(1,688 tok/s) 后才被标记为cancelled。
→ 把--time-budget提到 900 s、--request-timeout提到 600 s,512K 大概率能跑通。3. prefill 吞吐随上下文下降约 10%。
2,077 → 2,037 → 2,029 → 1,973 → 1,870 tok/s。16K 到 262K 只降 10%,说明长上下文没有明显的平方级恶化(MoE + PLE 的读取走 SSD,专家命中走 GPU)。4. 真正的瓶颈是显存余量。
32K 上下文时10273 MiB of VRAM free;524K 时0 MiB of VRAM free,引擎直接提示"requests may stall"。64 GB 统一内存跑 Q2_0(官方建议 64 GB 起)在 512K 上是刚好卡在边界。5. KV 缓存复用效果非常明显。
同一会话重复请求时,日志出现:prompt 262132 tokens = 262127 reused + 5 read in 25 ms (197.0 tok/s)262K 上下文从 140 s 降到 25 ms。阶梯测试每步都是新会话,所以
cached_tokens = 0;日常多轮对话的实际体验远好于阶梯数字。6. 生成速度稳定。
带 MTP(--spec 2)实测 79–89 tok/s,草稿接受率约 7/8。
八、复现命令
# 1) 启动服务
cd /Users/snow/local-ai/Strata/Strata
./run-q2_0.sh

# 2) 健康检查
curl http://127.0.0.1:8080/v1/health

# 3) 阶梯实测
cd /Users/snow/Documents/workspace
python3 scripts/local-test/context_capacity_probe.py --list
python3 scripts/local-test/context_capacity_probe.py --select 2

# 4) 想跑满 512K,把预算放宽
python3 scripts/local-test/context_capacity_probe.py \
  --select 2 --time-budget 900 --request-timeout 600 --max-requests 12
九、给同样配置的人的建议
场景 建议 64 GB M5 Max,日常使用 --max-context 262144,稳;实测 262K 无压力想试 512K 保留 --vram-reserve-mib 1212,并把客户端超时/预算放宽到 600–900 s磁盘 至少预留 80 GB。本机模型放在内置 SSD(剩余 618 GB),外接 4 TB SSD 存放 oMLX 的模型 多轮长对话 开启缓存复用,实际首 token 延迟远低于阶梯测试值 想要更高质量 官方文档:64 GB 内存 Q2_0 / IQ2_XS / IQ3_XXS 都能装,但 IQ3_XXS 需要关闭浏览器并把上下文控制在 128K 以内;IQ3_S 建议 96 GB 起
附:数据来源
- 硬件:
system_profiler SPHardwareDataType/sysctl/diskutil - 服务元数据:
/v1/health、/v1/models、strata-q2_0.json、build-metal/BUILD.json - 引擎日志:
Strata/strata-q2_0.log - 测试报告:
scripts/local-test/results/run-20261020-201926-074430ec/summary.md(另有result.json/probes.csv/probes.jsonl/meta.json) - 复现性:20:27 的第二轮(
run-20261020-202748-1342eaf6)得到同样的结论——256K 成功、更高阶梯超时。
- Python:需要 3.10+,macOS 自带 3.9 时会下载一个 25 MB 的独立 Python 3.12(SHA-256 校验),不需要 sudo/Homebrew。本机已有 Homebrew Python 3.14,直接建
-
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G -
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G -
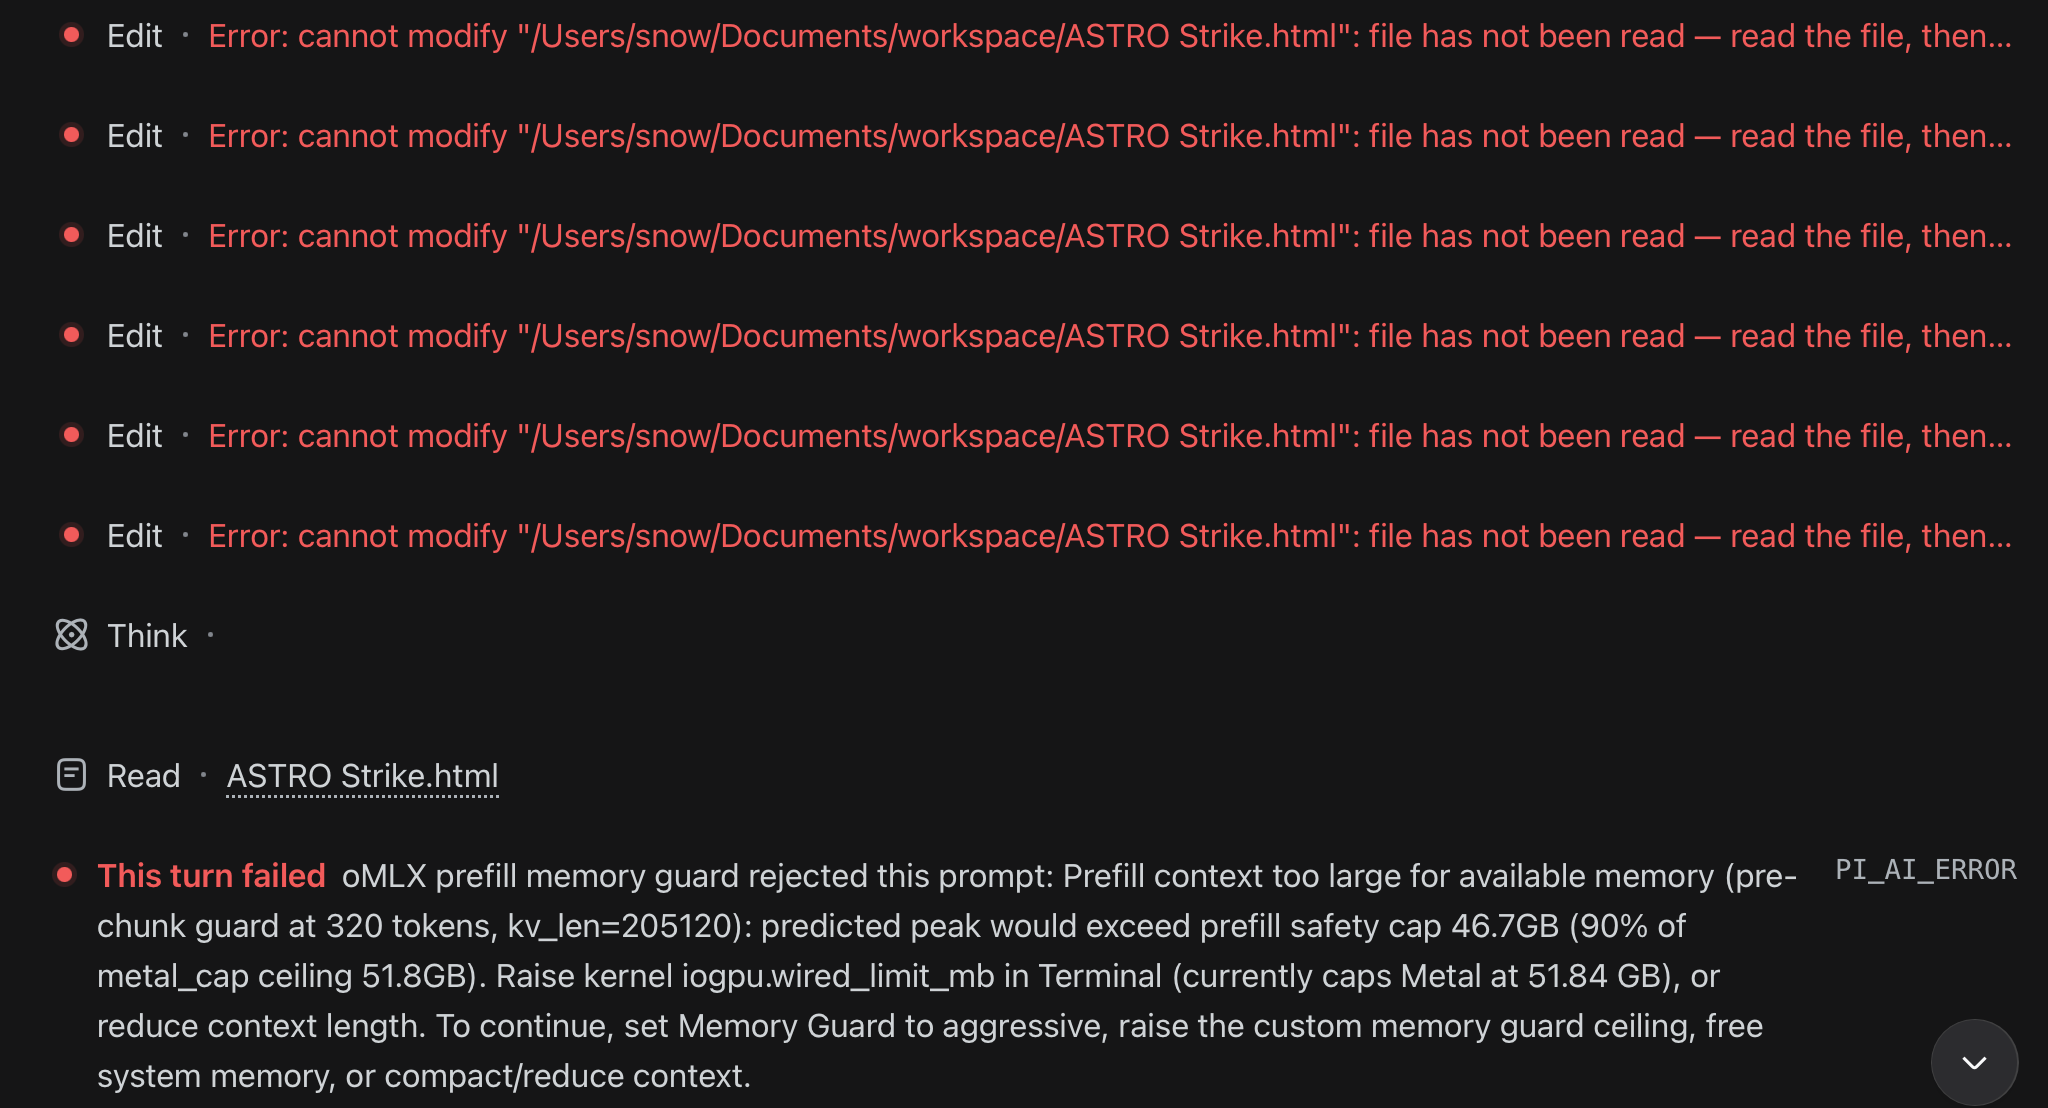
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G半实战测试,让Qwen3.8-27B 写了个射击小游戏;反复修一些小bug;调整关卡难度,物品掉落折腾了半天。期间大部分由hermes调配完成。不知道是不是DSH对非自家模型适配的调配机制问题。给了他几个请求发一起,他一通思考然后就爆上下文罢工了。期间还报错在自己workspace内的文件他自己无法修改,最后爆掉了。
还请DSH大神指导。
然后我让Hermes去查,就是可以修改的,没问题。是DSH打开文件,又开了个复件自己修改自己被拒。。。我也是没想明白DSH怎么把自己绕进去的。
然后就让Hermes持续开发完善了小半天。长上下文持续工作下,输出就降到了33 Tok/s。
今天让35B-A3B开发了第四关,很顺利的一把完成。没遇上什么问题。因为上下文压力也比较小,输出在62 Tok/s
也算模拟小规模实际开发时,2个模型大概的能力展示。27B稠密模型这个速度也还算是可以接受,就是心理预期知道,实际能力很难维持50 Tok/s左右的。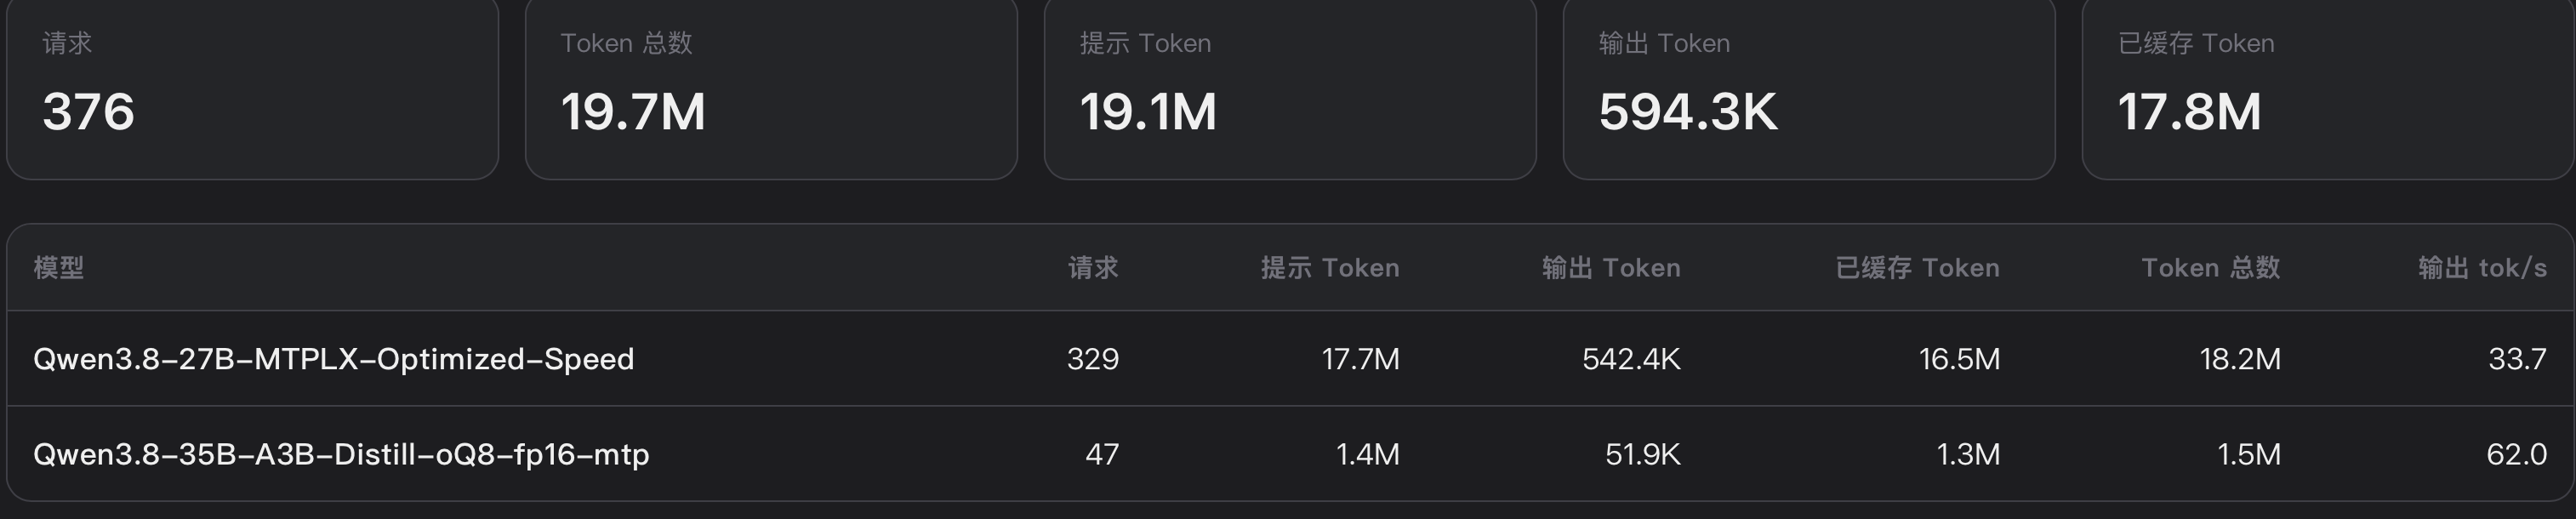
-
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G -
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G接着测试 oMLX with Qwen3.8-35B-A3B-Distill-oQ8-fp16-mtp(38.6G)

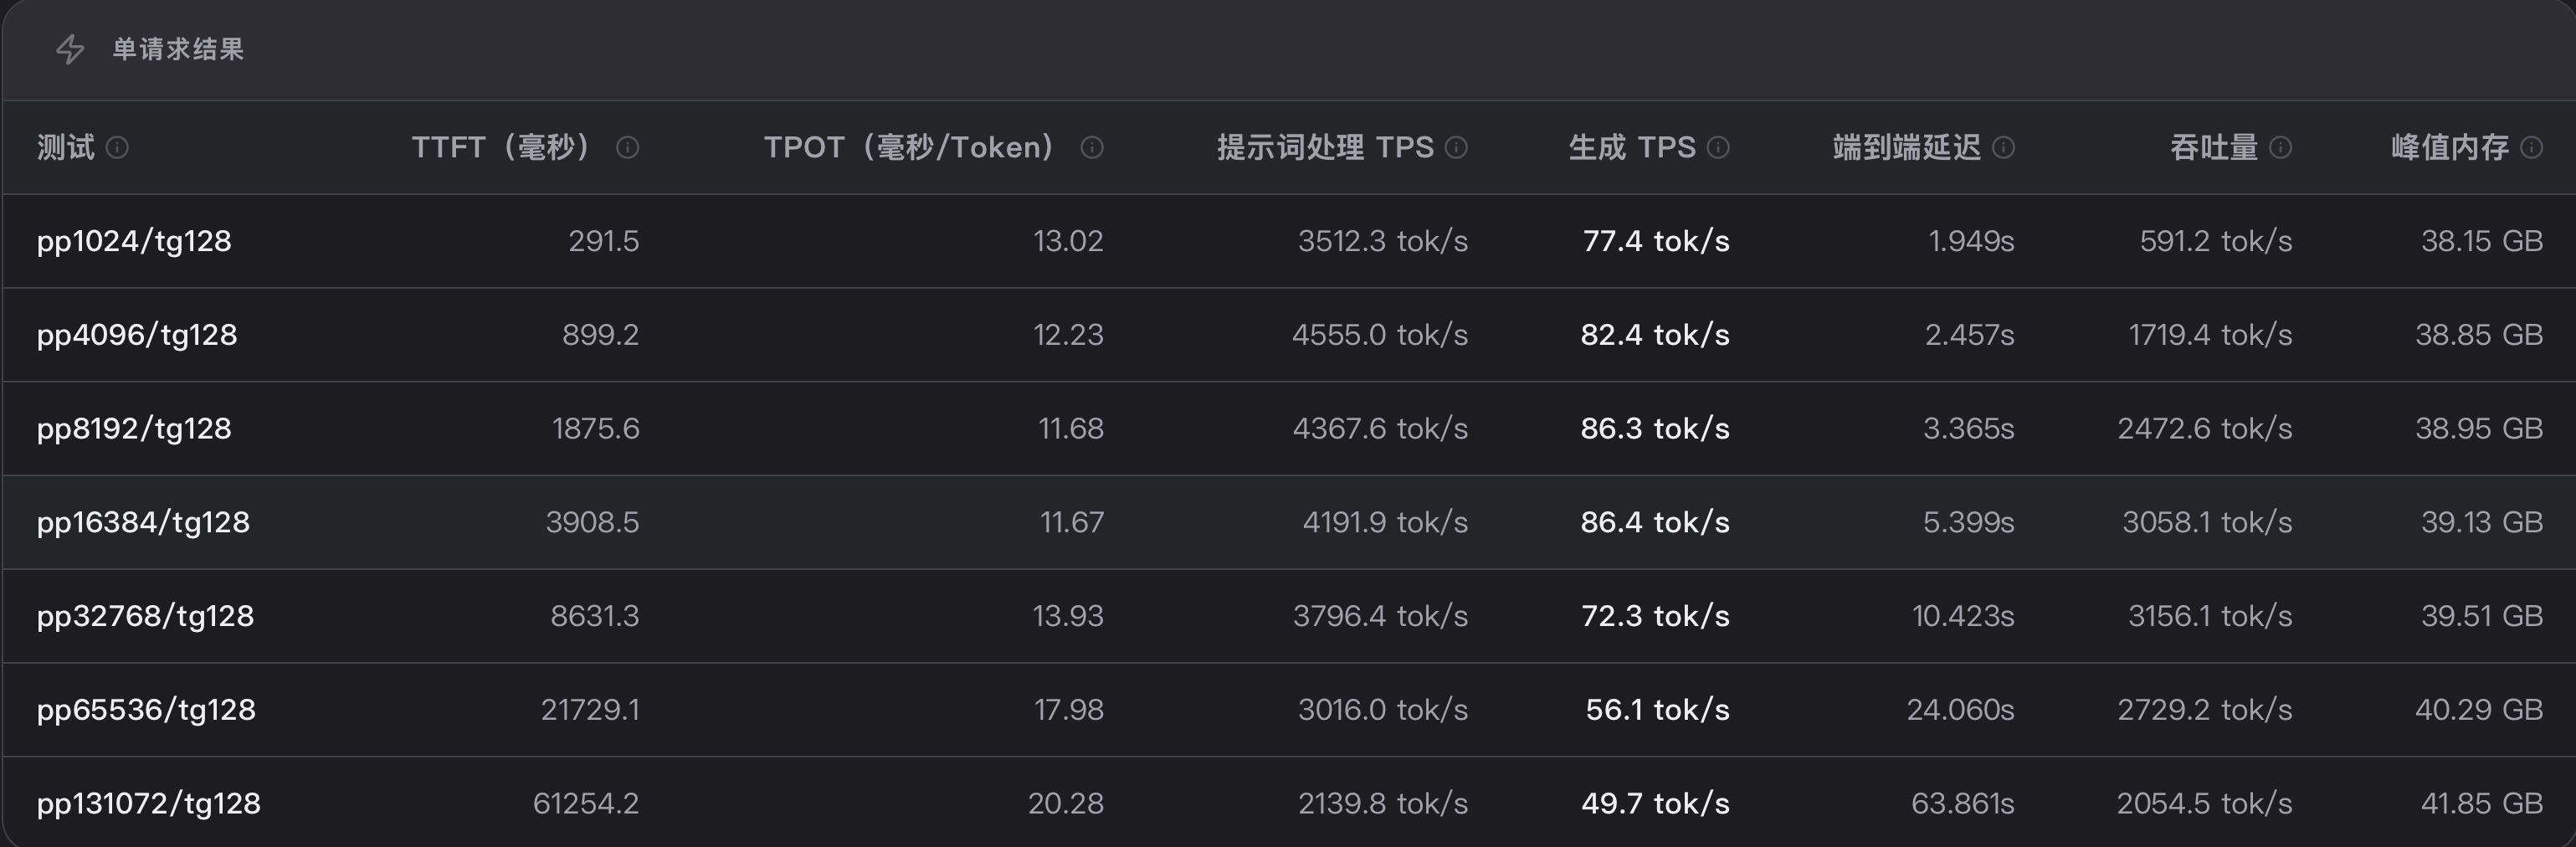
A3B模型性能更好了,缺点是因为Q8占内存更高,上下文128K以上就压力太大了。智力测试与27B(Q4)对比:
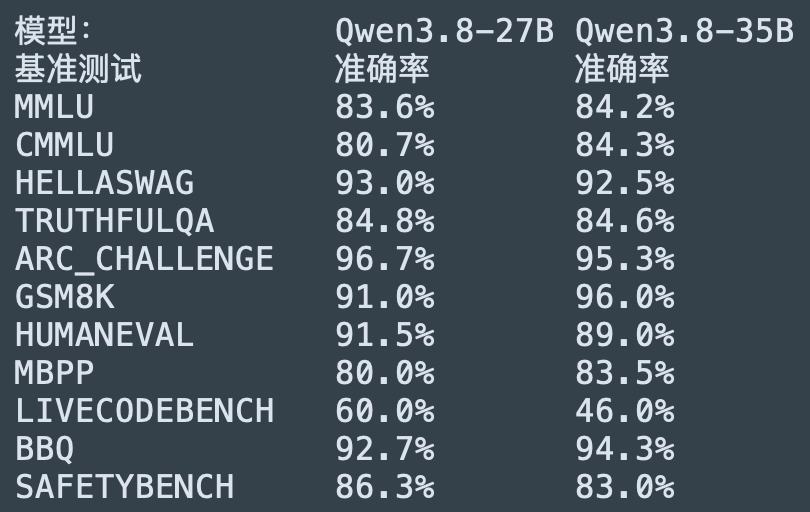
除了LIVECODEBENCH 低了不少,其余测试似乎和4Bit 27B不相上下
-
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G备注:
本人是纯菜鸟。不是UP主,不是从业者
自己在虚心关注,学习,练习中。
希望能拽住时代大浪潮的尾巴,不被甩开太远。望各大佬不令指导指正。
-
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G用oMLX加载MTPLX优化的模型,关闭思考,启用Lightning MTP
Model用的是Qwen3.8-27B-MTPLX-Optimized-Speed (19.5G)
执行简单回话,任务,写个贪吃蛇小游戏
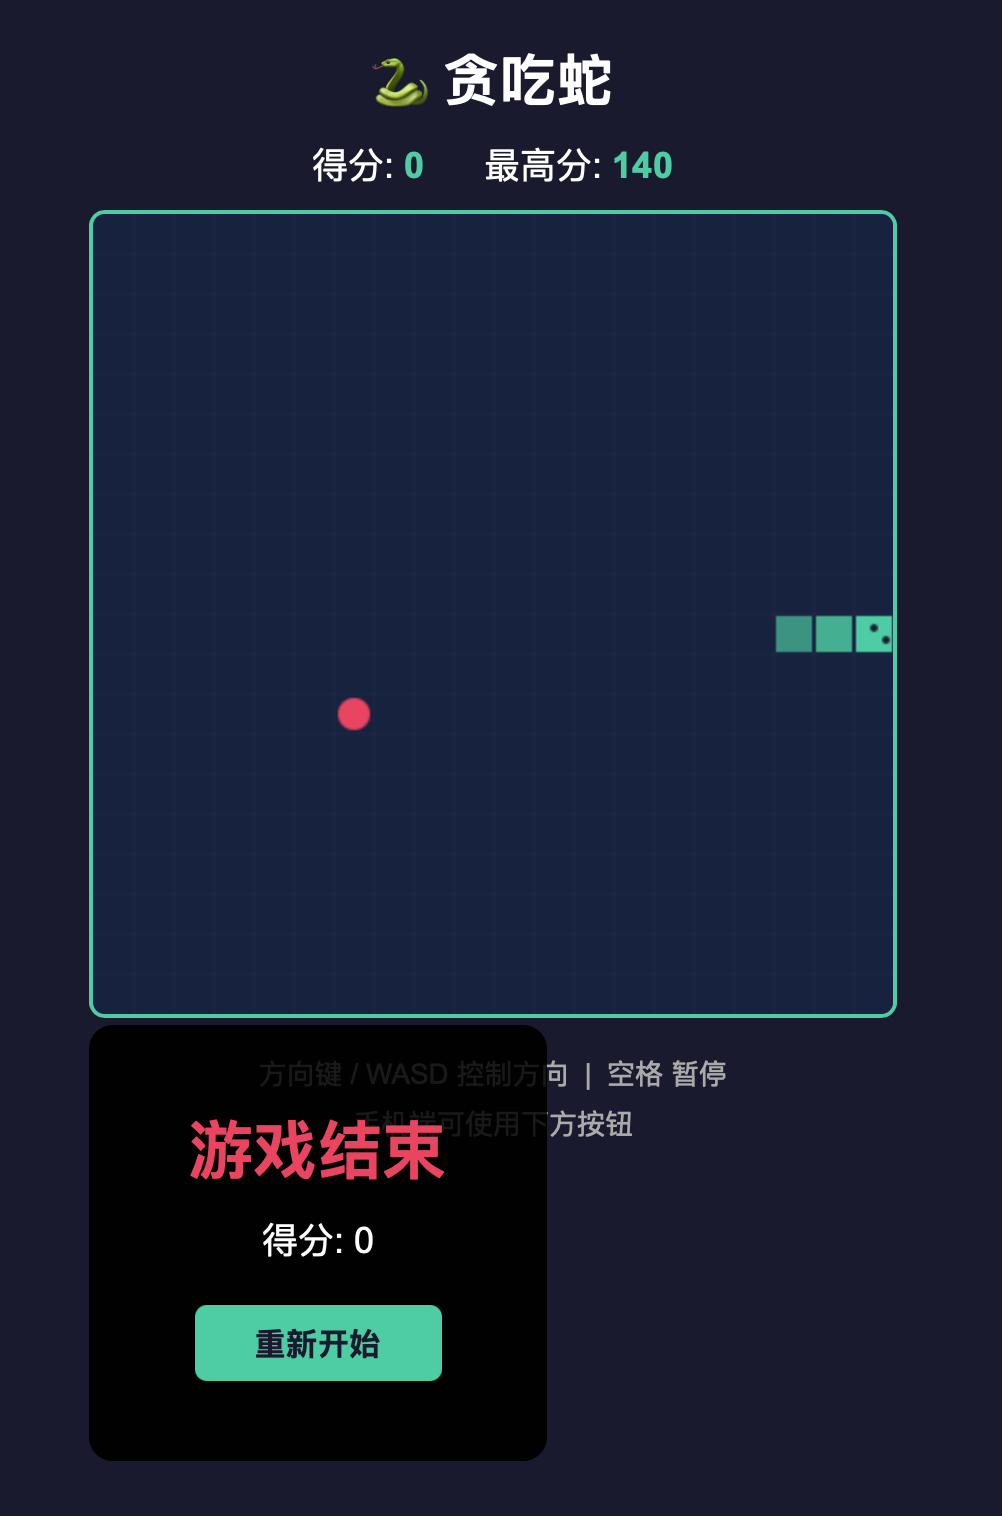
一次成功,图形画面也不错
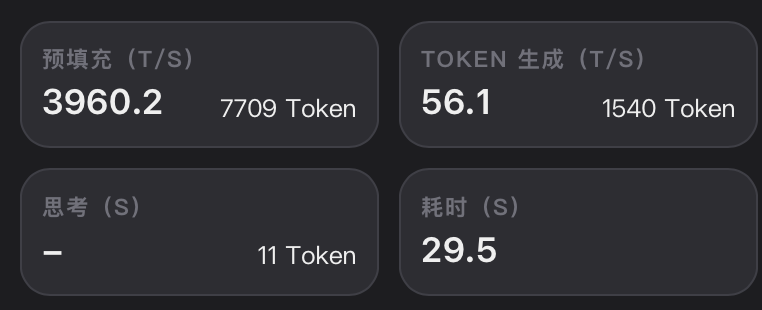
数据还挺漂亮。
性能测试结果: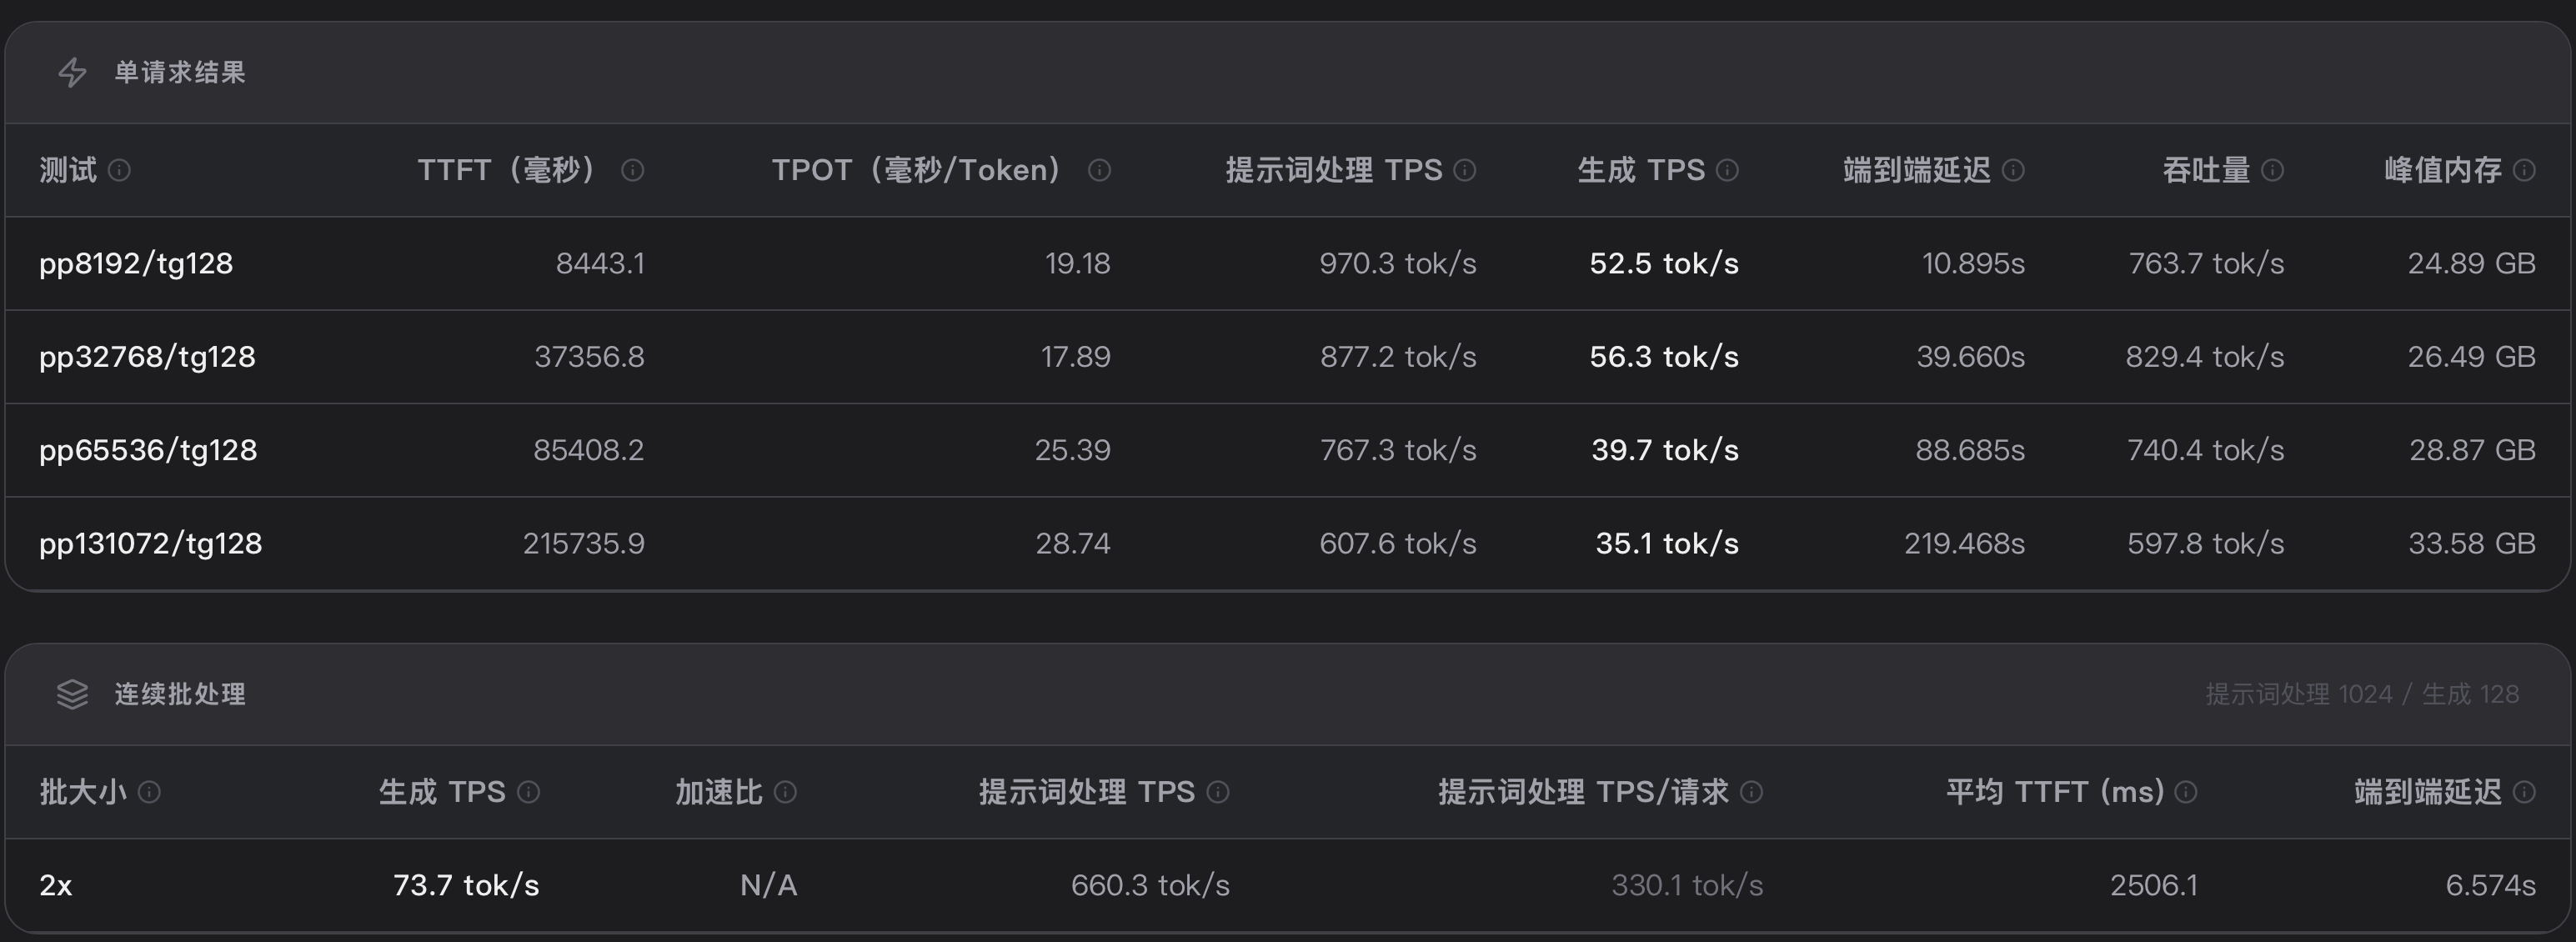
智力测试结果:
智能基准对比模式 抽样 Qwen3.8-27B-MTPLX-Optimized-Speed
MMLU 抽样 1000/14042 83.6%
CMMLU 抽样 300/11582 80.7%
HELLASWAG 抽样 200/10042 93.0%
TRUTHFULQA 全量 817 84.8%
ARC_CHALLENGE 抽样 300/1172 96.7%
WINOGRANDE 抽样 300/1267 79.0%
GSM8K 抽样 100/1319 91.0%
HUMANEVAL 全量 164 91.5%
MBPP 抽样 200/500 80.0%
LIVECODEBENCH 抽样 100/1055 60.0%
BBQ 抽样 300/10864 92.7%
SAFETYBENCH 抽样 300/11435 86.3%--- 详情 ---
模型:Qwen3.8-27B-MTPLX-Optimized-Speed
基准测试 准确率 正确 总数 Time(s) 思考MMLU 83.6% 836 1000 856 否
CMMLU 80.7% 242 300 93.5 否
HELLASWAG 93.0% 186 200 82.9 否
TRUTHFULQA 84.8% 693 817 245.3 否
ARC_CHALLENGE 96.7% 290 300 106.8 否
WINOGRANDE 79.0% 237 300 79.7 否
GSM8K 91.0% 91 100 515 否
HUMANEVAL 91.5% 150 164 375.9 否
MBPP 80.0% 160 200 535.2 否
LIVECODEBENCH 60.0% 60 100 2561 否
BBQ 92.7% 278 300 86.2 否
SAFETYBENCH 86.3% 259 300 91 否可能是关闭思考的关系,LiveCodeBench测试只拿到了60%
别的基本都还挺高 -
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G另外补充我很喜欢的一点:
GPU 满载时 GPU功耗也就100W
仔细听可以听到风扇声音,但也非常轻。环境音下,不特别关注几乎完全注意不到。
这样就可以很放心的放在家里任何地方,无论是工作室,机房,甚至是卧室。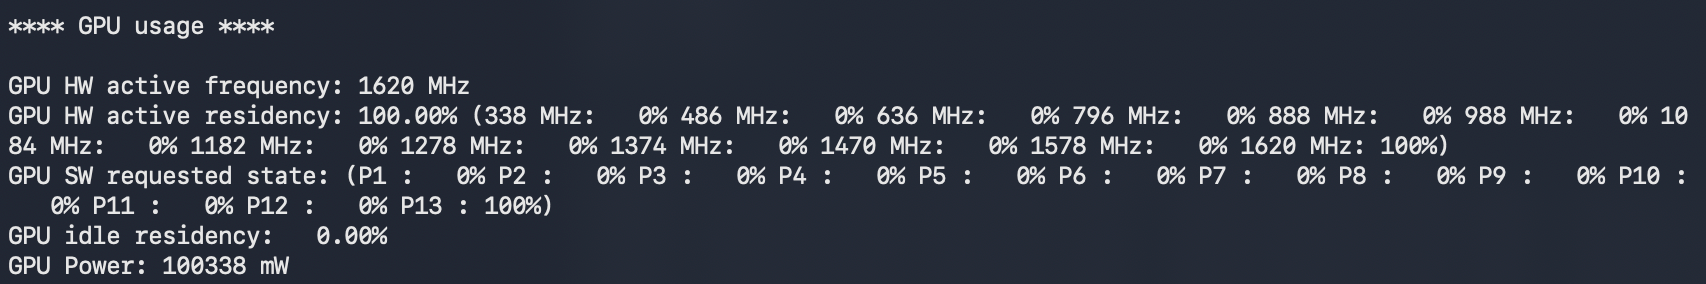
-
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G第一手测试资料:
先说基准测试 - MLX:
Qwen3.8-27B-MLX-6bit (模型 22.8G)
目前四档实测
Context Prefill Decode Peak Memory 512 tokens总时间
8K 921.3 tok/s 23.17 tok/s 25.26 GB 30.9 s
32K 845.4 tok/s 21.62 tok/s 26.87 GB 62.5 s
128K 596.8 tok/s 16.69 tok/s 33.69 GB 248.8 s
256K 436.7 tok/s 13.05 tok/s 42.74 GB 643.7 sQwen3.8-27B-MLX-4bit (模型 16.1G)
Context Prefill Decode Peak Memory 512 tokens总时间
8K 985.1 tok/s 31.92 tok/s 18.53 GB 24.3 s
128K 626.1 tok/s 21.10 tok/s 26.96 GB 231.6 s
256K 447.2 tok/s 15.49 tok/s 36.01 GB 613.8 s基准和网上MacBook M5 Max的测试数据差不多;长上下文内存占用不多,256K 6Bit差不多42G,4Bit36G,还是跑的动,且有冗余20来G分配给系统和Agent等。长上下文是主要耗时还是在Prefill,将近10分钟。
-
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G我选Mac Studio M5 Max的理由:
等M5 Max Studio的原因:
- MacBook 14 散热太差其实跑不动M5 Max
- MacBook 16 依然很难发挥Max全部能力,同时便携性很差;除非贪他的优秀大屏。
- 个人没有很大的移动办公需求;现在出门可以用Telegram远程下指令调配任务,固定的工作站式24*7的服务器模式更合适。已经在用M4的Mac Mini作为小型家庭服务器,体验极佳。
- 相比MacBook,相同配置Studio价格更实惠
-MacBook 16 Max-40GPU,64G,2T-最低标配 - $5,399; 直逼低配Ultra了 ($5,499) - 为什么选这个配置 (40GPU, 64G内存)?
- 32GPU只有400多G内存带宽;40GPU才有614G (Ultra 统一都是1.2T)
- 128G内存价格也直逼Ultra低配版了(1T硬盘,$5,399),(96G内存 $5,499; 有这个预算的话,个人建议直接上最低配的Ultra
- 个人暂时没有音视频工作流的打算,如果有大多也不会选Mac吧;多开还是Ultra高带宽高内存更好;当然有钱啥都不是事儿;综合考量着现在这个价位能跑本地Qwen3.8-27B游刃有余,可坚固日常办公Agent任务需求;是很好的中间位
- 缺货问题。现在我这边Max 128G是期货,待机1个月+

; Ultra 低配待机已经超过2个月

;
-
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G -
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G被扣了声望,原贴想要修改编辑也不能了。
补上一些吧:
刚看到的Mac MinMaxH3 优化后MacBook 高配生视频介绍。
Mac Studio上线后有两个屌丝位:
M5Max 40GPU 614G带宽 64G内存 $3799 (1T硬盘)
M5Ultra 64GPU 1.2T带宽 96G内存 $5499 (1T硬盘)目标如果是架设本地AI Qwen3.8-27B(35B)
偶尔有少许文生图,或少量视频生成需求,是不是会成为这个巨大的硬件甜点位? -
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G只是分享一个刚看到的信息而已,本人不是原作者,也不是什么推广。
一直比较关注Mac生态罢了;受不了PC。分享给大家品品靠不靠谱而已;毕竟新的Mac Studio上来了一大波硬件
-
Mac生态跑文生图视频以有可能了吗?M5 Max 40GPU 64G视频搬运工:
Youtube Video