@Botio-Kuo 用本地大模型上下文是超级稀缺的资源。
 G
George Suen
@George Suen
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】 -
【一个Agent两个大语言模型,一个学徒工,一个老师傅】我信你说的话。
但是咱俩用Agent的场景完全不同。我做的东西全凭自己的兴趣,都带有探索性。我做的上一个项目,一开始也是用AI计划,最后发现那条路完全走不通,一直改一直改。好在最后结果我很满意。而且我也不太在乎AI犯错,反正都是我在尝试的事情。
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】@Botio-Kuo 我想的是把信息分给多个agent维护,再有一个agent维护信息的目录。工作agent只维护当前问题的上下文。需要了解历史问题的时候去问他们。
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】@neo 甚合我意
-
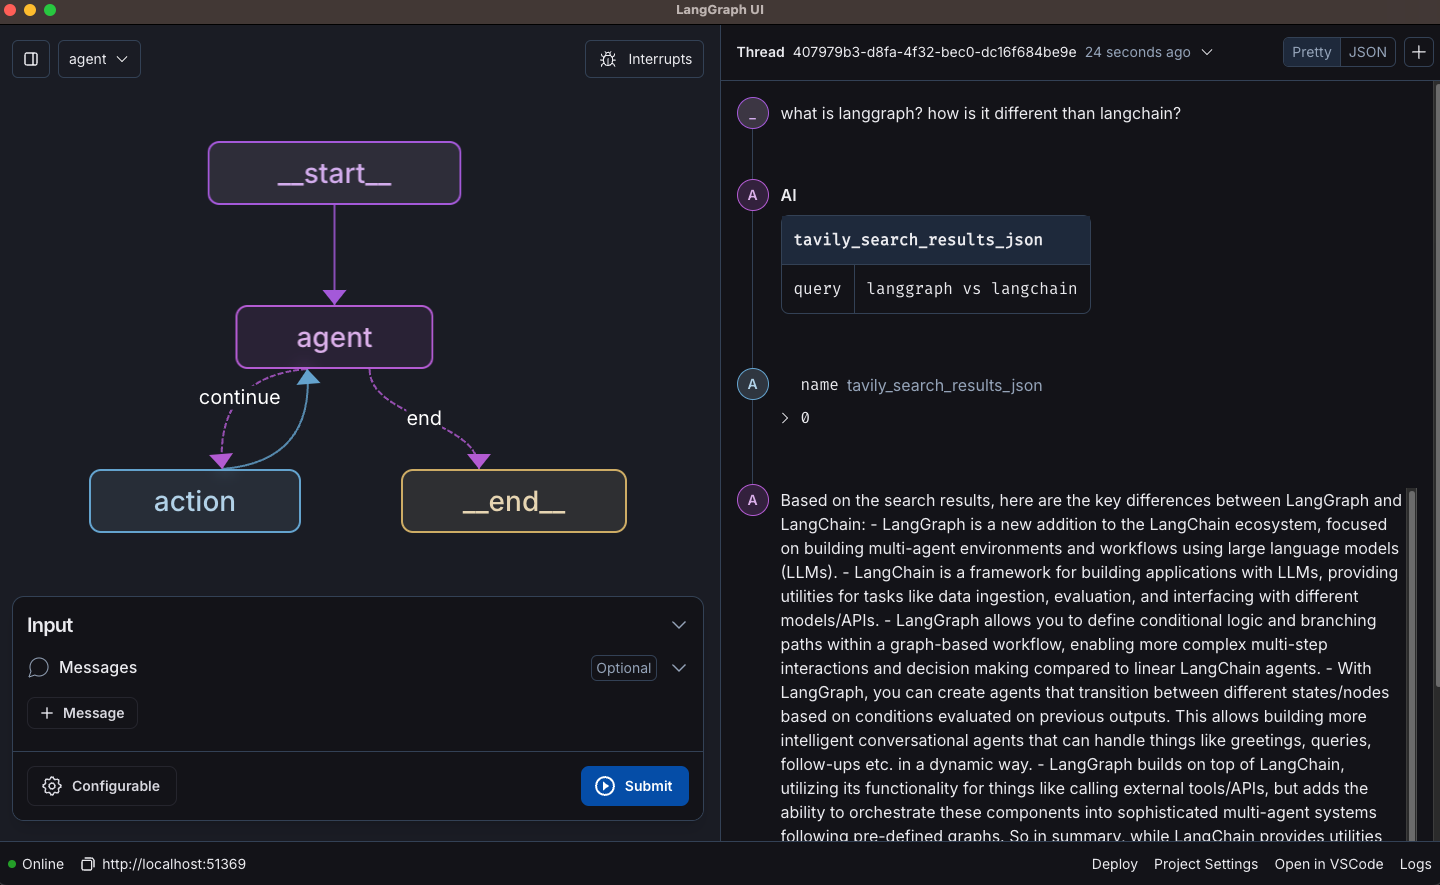
【一个Agent两个大语言模型,一个学徒工,一个老师傅】@許托比 我说的是 这种东西,它本来就在工作流图里。https://reference.langchain.com/python/langgraph/graph/state/StateGraph/add_conditional_edges
你举得资安的例子,我完全没概念,从未接触过。 -
【一个Agent两个大语言模型,一个学徒工,一个老师傅】@許托比 那个就是在必要的时候问大模型,“你认为.....请简单的回答 是 或者 不是”。
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】@許托比 你说的机械式闸门 是langgraph里那种 是非回答么? 哪个其实跟动作前提醒挺像的。
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】我遇到跟你相同的问题。agent用几次就忘了。我得手动提醒,他才会用起来,一会儿又忘。
所以agent最好要专业化。去掉与它的分工无关的skill和tools。而且可以在每次他动作前提醒他。用本地大模型的时候可以事后把这些提醒从上下文里删除,反正没有跨api调用的kv cache。
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】您是有钱人,我思考的都是,怎么用多个128K上下文的agent加上RAG什么的,实现1M甚至更多上下文的效果。
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】 -
【一个Agent两个大语言模型,一个学徒工,一个老师傅】@kop-wang 你这个思路不是三年前就有了,ChatGPT刚刚推出的时候,就有人用它辅助编程。开始是每次把代码和错误复制粘贴进网页,然后再把GPT写的代码粘贴进项目。后来有人写了个Python脚本代替了复制粘贴过程。再后来有人把这个脚本做成项目当时叫AutoGPT。这就是所有Agent的原型。但是当时AI下性能太差,这东西火了一阵就不行了。
我说的东西跟这个完全不一样,本地Agent使用人类的自然语言问技术问题,而不是像Agent那样有严格的格式。回答也是自然语言。根本无法直接接入Agent。网页模型有搜索功能,相当于web search工具,而且直接返回当前关心的内容。对比Agent自己search可以节约大量上下文。
不要说网页上模型比绝大多数本地模型都强太多,即便是智力水平差不多。所谓三个臭皮匠顶个诸葛亮。只要能很好的组织这些模型,能够做到比其中任何一个都聪明的效果。在这方面做的最好的是前一阵日本人做的哪个实验。可以自己去搜。
当然你们可能觉得会用个hermes就可以了。哪种交互式的agent只适合对需求或工作流尚不清楚或者频繁变动的场景。实际上工业场景用LangGraph,pydantic-ai定制agent群工作,使用多个大模型协同,根本就是标准操作。
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】@terry 首先我用deepseek v4配合网页上的大模型。亲测有效,可以减少deepseek无效尝试。
你说没有生产力,你认为问题出在那里?
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】@kop-wang 必须有本地模型的,完全不一样。
-
【一个Agent两个大语言模型,一个学徒工,一个老师傅】诸位,用Agent都是只用一个大语言模型么?
我一直用pi coding agent 配合Deepseek V4。但是Deepseek还是挺弱的。我就给他写了个Skill让他有任何困惑就通过OpenCLI去问ChatGPT或者Gemini。两个大语言模型一聊天,很多技术难点就突破了。
现在Deepseek又涨价了。我更趋向于用pydantic-ai写一组新的Agent。本地的弱模型配合网页上的顾问大模型。除了电费,网费一分钱都不花。
但是本地模型上下文太短了。一直想不明白怎么搞。
我先端上一碟醋,大会儿帮我包盘饺子吧!
-
网站的 Content Security Policy好了,图全出来了。
-
网站的 Content Security Policy -
网站的 Content Security Policy我这就是网页里很多图片显示不出来,但是复制图片链接用新的Tab确能打开,我有点好奇是怎么回事,才调试你们的网站的。这事跟我也没关系,我也是多管闲事。
-
网站的 Content Security Policy@Xiaote 我知道了,是因为我常常清理浏览器cache导致 cache总是不命中。你如果不清cache你那儿就没问题。你试试清掉cache storage应该就能看到我看到的问题了。
-
网站的 Content Security Policy命中缓存就返回,没命中就放行 所谓放行就是fetch
-
网站的 Content Security Policy@Xiaote 我问了一下Chatgpt。我明白了因为页面第一次加载时用的img src 这个你在CSP里写了https 所以没问题。但是在 service worker里这个使用的是fetch下载 而connrct-src没有哪些图片的网址,所以报错图片不显示。