
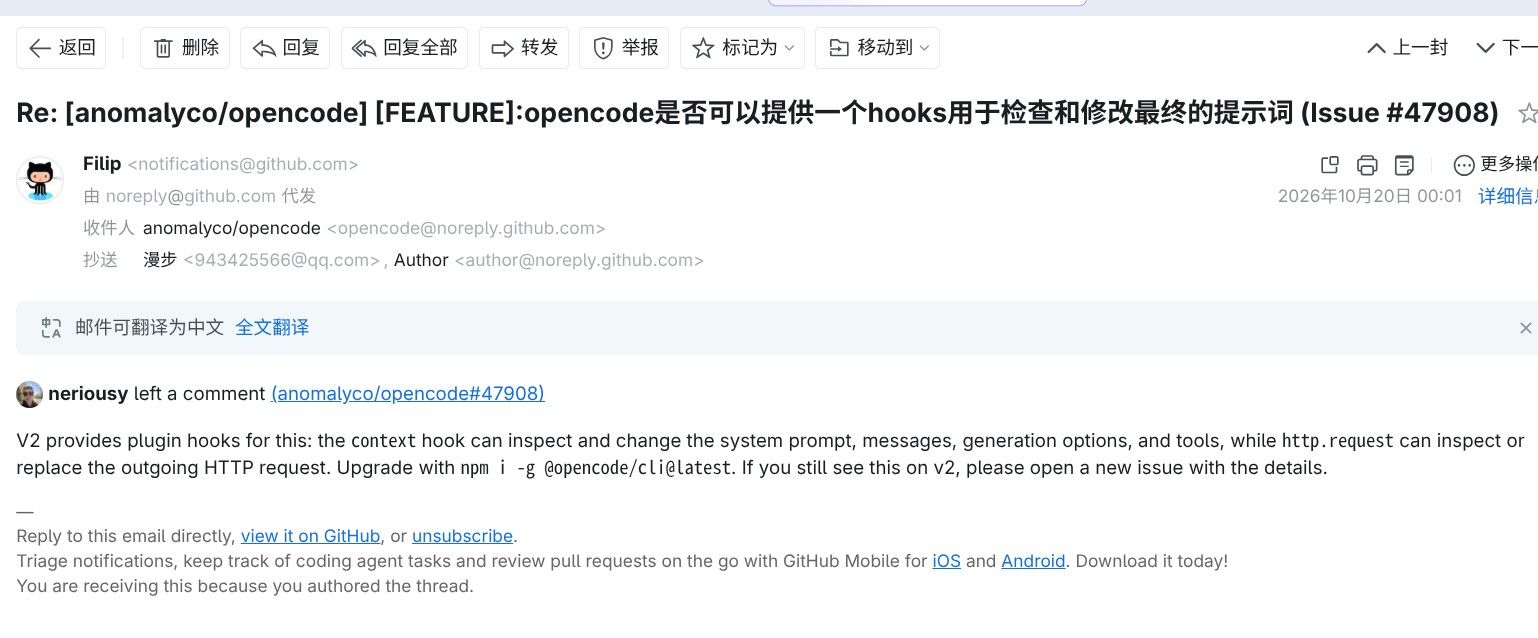
上个月提交一个需求,这个月在opencode v2上实现了,这下可以精简提示词,使用本地模型更方便了
 H
heheimback
@heheimback
-
opencode可以修改最终请求的提示词了,官方还是挺给力的 -
決策模型:Jev vs Laya 魔術方塊大對決laya-mlx是laya的一个分支吗
-
我普通人的算力需求 病态@applejuice 本地ai也不错的,我现在就是用本地AI做大本文处理,然后我后面还会部署laya,用于批处理文本,打上标签,算力上来后,能做的事情挺多的,要是laya后面支持多模态就更好了,我图表的分析就更方便了
-
我普通人的算力需求 病态@applejuice 说实话,这个ai就像游戏一样,很容易沉迷,我八月份天天2点左右睡,早上起来上班,现在已经过了这个劲了
-
我普通人的算力需求 病态@applejuice 你自己怎么写的RAG,我用的是linux系统,就让llm用grep查询就可以了,claude code就是这么做的,我就是设计了一下怎么组织知识
-
我普通人的算力需求 病态@johnnybegood 我用的是obsidian,qwen27b q4只能做一些简单的工作,稍微深度的一些的分析需求需要上q5,不然输出不完整,我现在都是用q5的,日常办公和处理一些大文本够用了
-
我普通人的算力需求 病态@applejuice 你有真实需求才行,别没有需求制造焦虑,我是每天夜里都跑RAG,才部署的本地模型
-
我普通人的算力需求 病态没有必要上r7900,qwen3.827b够日常用了,ai发展的很快,说不定明年就出现远超现在的推理硬件了,现在不适合投入太多进去
-
提问:文本提取使用那个模型@williamlouis 越小越好,前提是跨段落合并提取和多事实合并没有幻觉,我现在用的是27B的5bit量化,速度有点慢,平均是50tps,如果能提升个50%左右的效率就好了
-
提问:文本提取使用那个模型如题:那个本地小模型提取文本事实又快又好,最重要的是提取没有幻觉,主要是跨段落合并提取和多事实合并的场景
-
deepseek4.1幻觉严重@Anthony 我都快疯了,写的都是乱七八糟的,我本来以为我可以轻松点,结果稍微复杂一些的功能,我都需要深入的去检查,不然就是瞎写,我怀疑ai有人格了,而且是偷懒人格,就是那种汇报工作做的好,里子做的差的一批的
-
deepseek4.1幻觉严重我最近在做量化交易,已经被ai忽悠麻了,还是得老老实实看书去,ai给了我一个看似正确的路线,我也不懂,然后一边看书一边对照ai的实现,发现ai真的就是在一本正经的胡说八道啊,给我的方案都是打折扣的,华而不实
-
deepseek4.1幻觉严重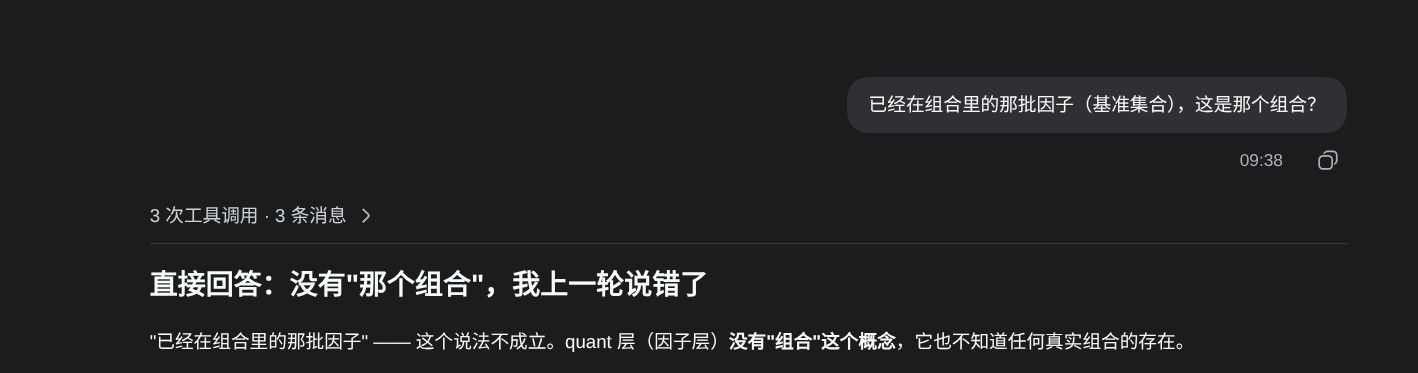
DeepSeek已经胡说八道了,大家用的时候还是小心点,我这两天一直在重构代码,写的一堆垃圾,给我气死了,我发现个有意思的问题,就是当deepseek说的话,你已经看不明白的时候,大概率就是你的项目中毒严重了,不要再继续开发了 -
DSH 做了一个系统监控小插件不错,不过我用linux,有桌面插件,用不到这个
-
Codex/Hermes/DSH使用心得分享,DeepSeek V4.1 Flash + Harness是当下生产力性价比答案,Qwen 27B 搭配DSH也能干活!我中午开发了一个重要的功能,连续跑了快两个小时,交付的质量目前来看是可以的,才用了6块钱,唯一的问题就是需要一个计划模式,不然容易直接执行
-
增加开源项目板块建议论坛还是挺活跃的,是否可以增加开源项目板块,让大家把自己的vibe coding的github项目放上来,增加曝光,让更多的人参与进来优化,就比如一些opencode插件、实用的工具等等
-
AMD R9700 實測:ROCm 10,Qwen38-27B-UD-Q6_K、128K context 和 MTP我感觉R9700有点尴尬,我之前也想买这个的,但是除了高一点的量化模型也没有太多的提升,效果也都差不多,token速度还有点慢
-
單張 RX 7900 XTX 24GB Qwen3.8-27B 優化紀錄 —— Vulkan 路線實測報告大佬,有没有长上下文速度tps降的太多的优化方案呢
-
單張 RX 7900 XTX 24GB Qwen3.8-27B 優化紀錄 —— Vulkan 路線實測報告非常好的帖子,我去试下