先定性,本帖只给想尝试自己搭建大模型,还没有升级、购买设备的朋友做个参考,顺便补充一下论坛硬件数据库的资料。
8G显存显卡,两个月前不具备生产力,搭配Hermes蠢得要死,勉强能作为玩具,尝尝鲜,感受一下自动化Agent是啥,但是编程,复杂任务很难完成,多轮后,容易陷入一直调用工具的循环,Hermes超时没了反应。
但是现在,搭配Deepseek Harness,竟然能够干一些简单的活了,编写个小游戏,写个文章啥的,已经有模有样。至少是真的可以干活了。
harness真牛逼,他的任务约束能力,至少让这个傻缺模型智能上了两个档次,从学前班成长为初中生的级别。
因为不是玩AI主力配置,就大概展示一下数据,作为一个参考。
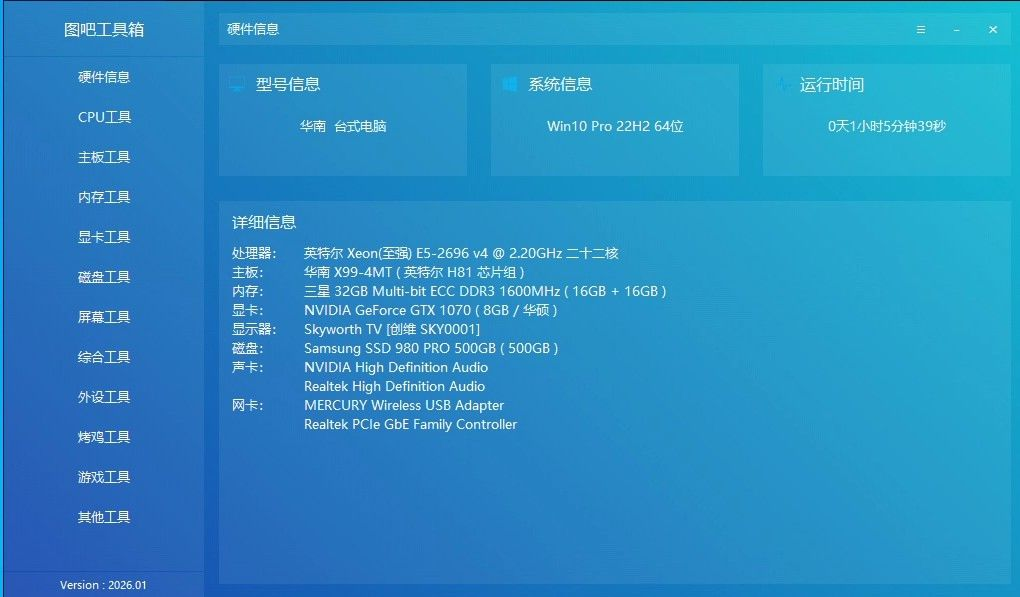
硬件
软件
llama-b9310-bin-win-cuda-12.4-x64
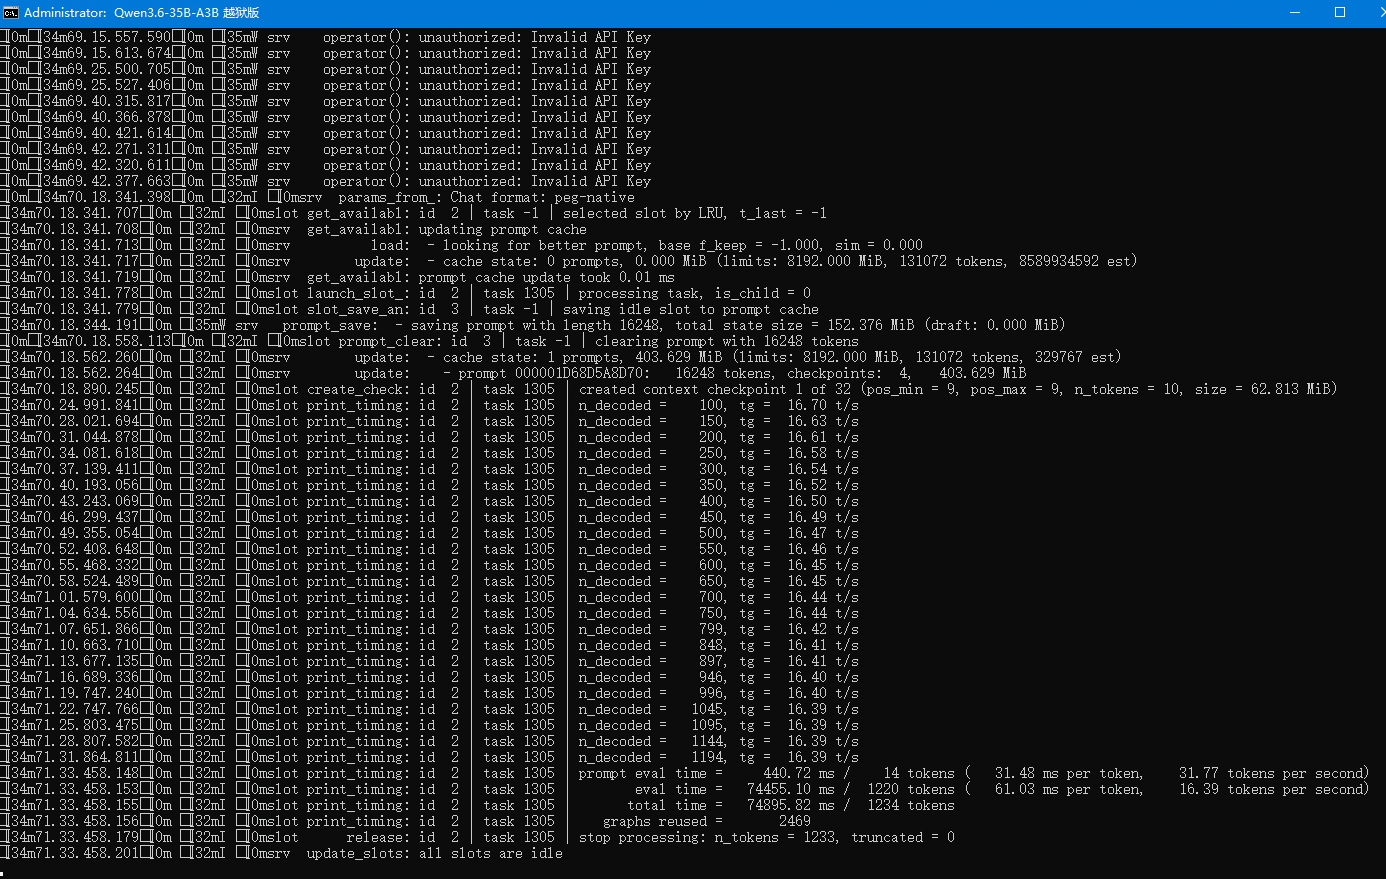
我懒,具体看图
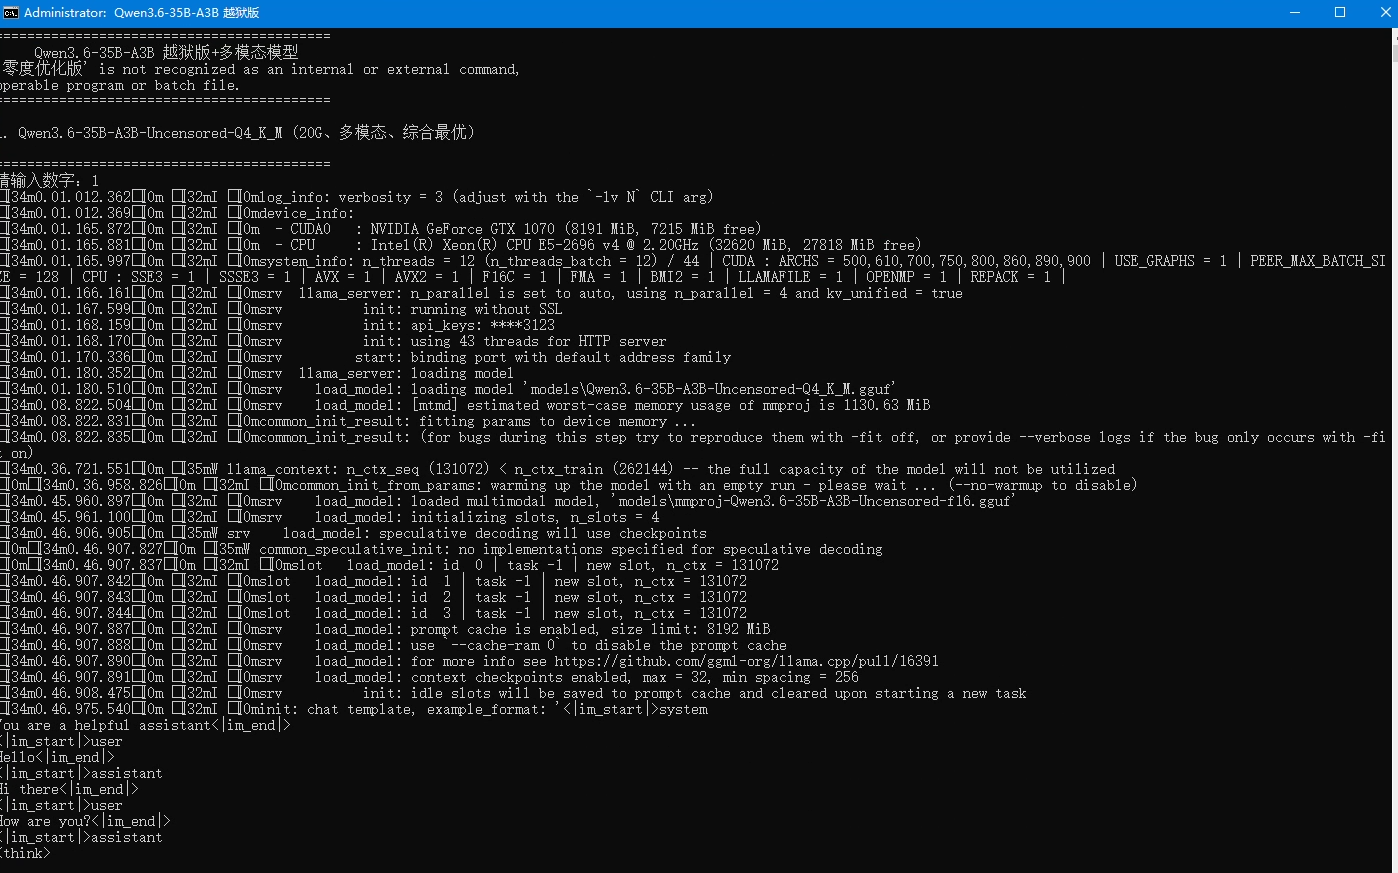
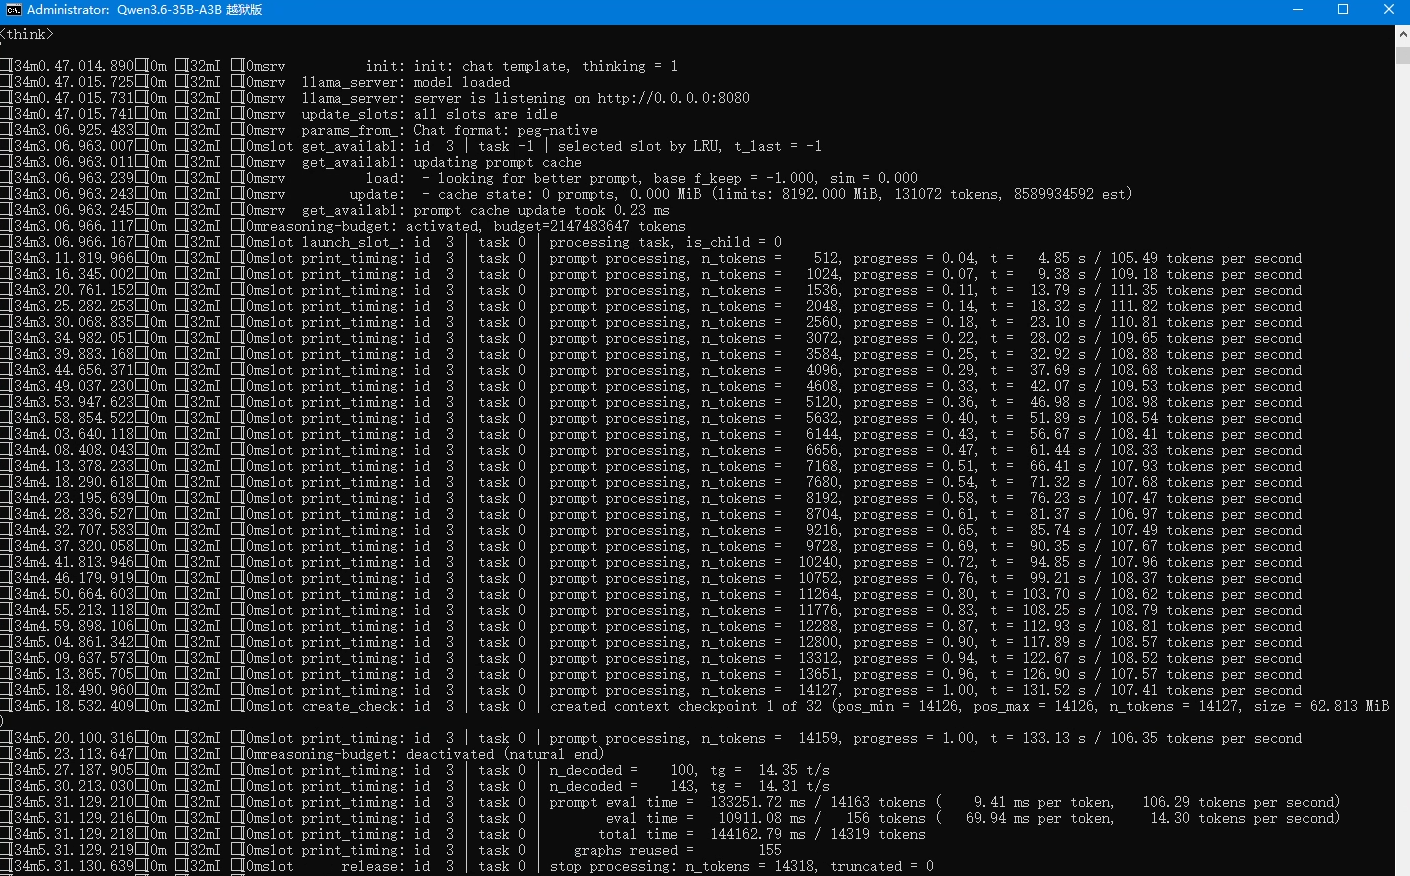
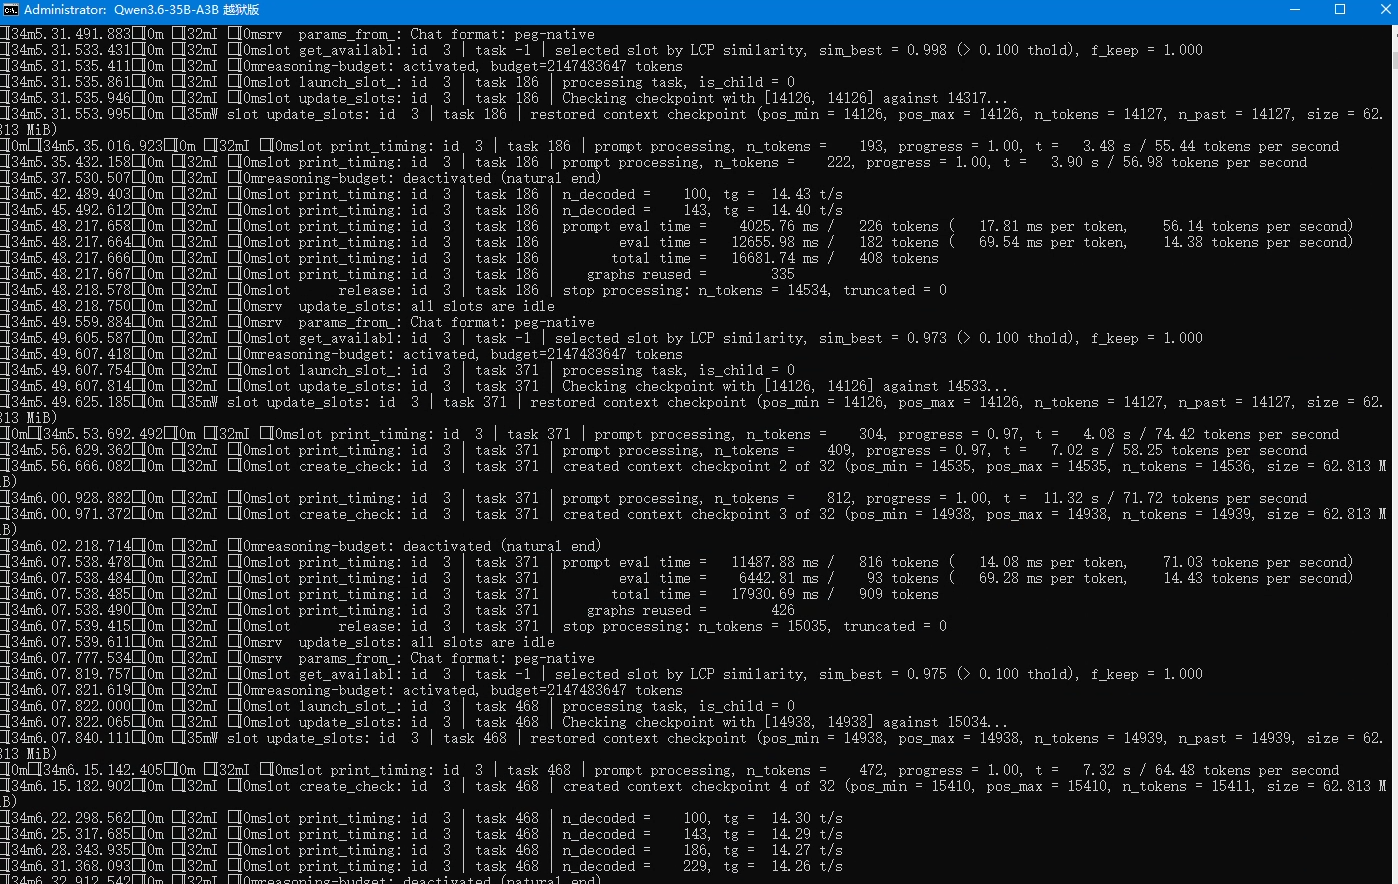
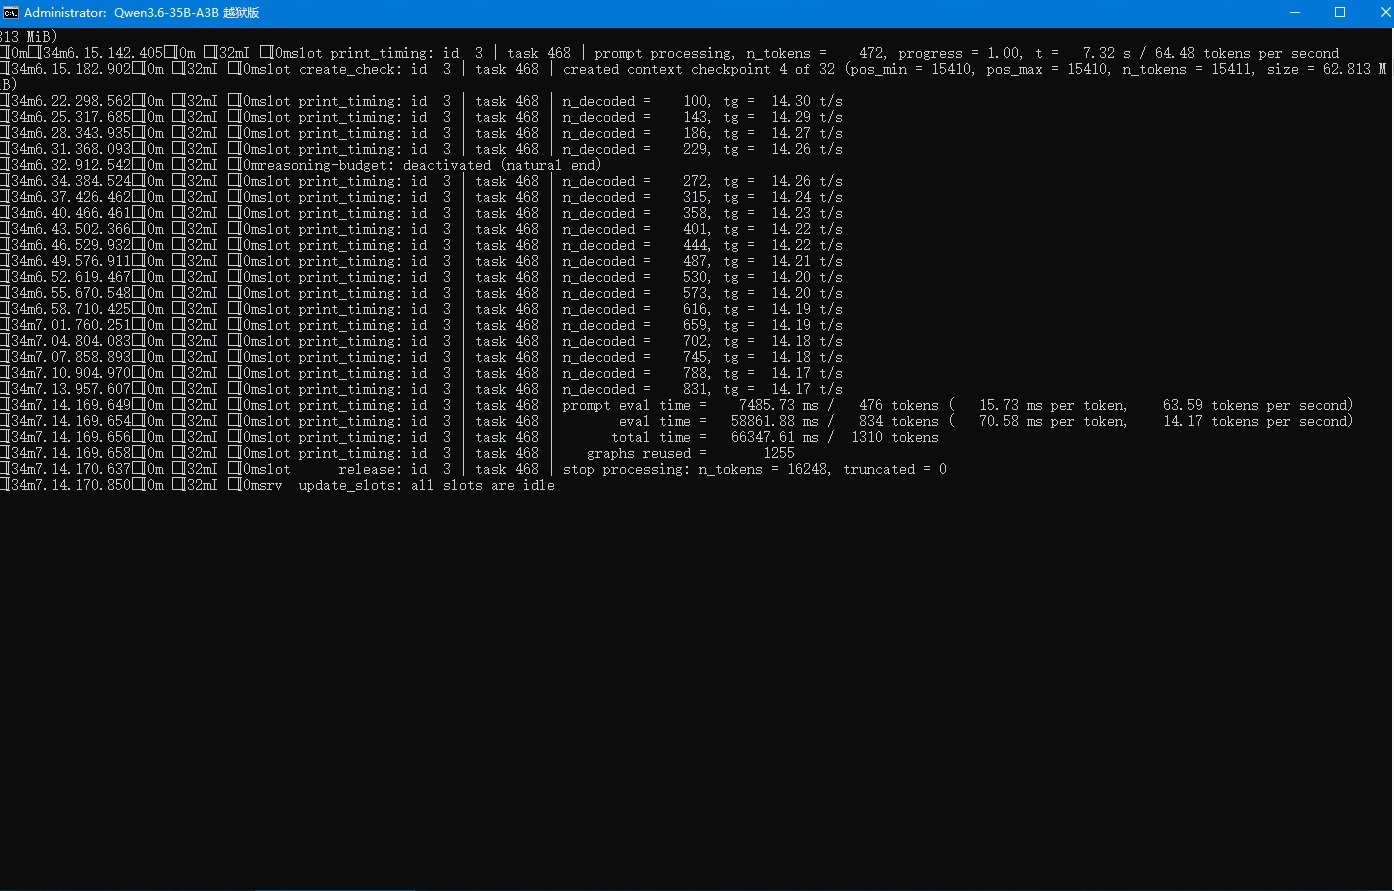
上面是运行了一下 Deepseek harness 的日志。下面是直接用网页版,直接访问llama.cpp 模型的截图。
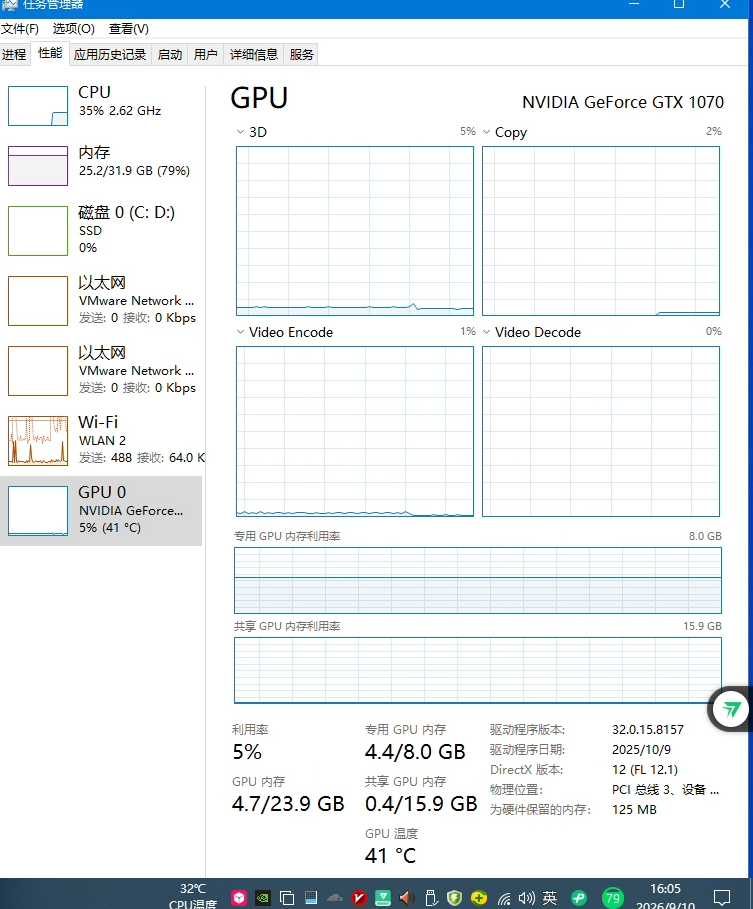
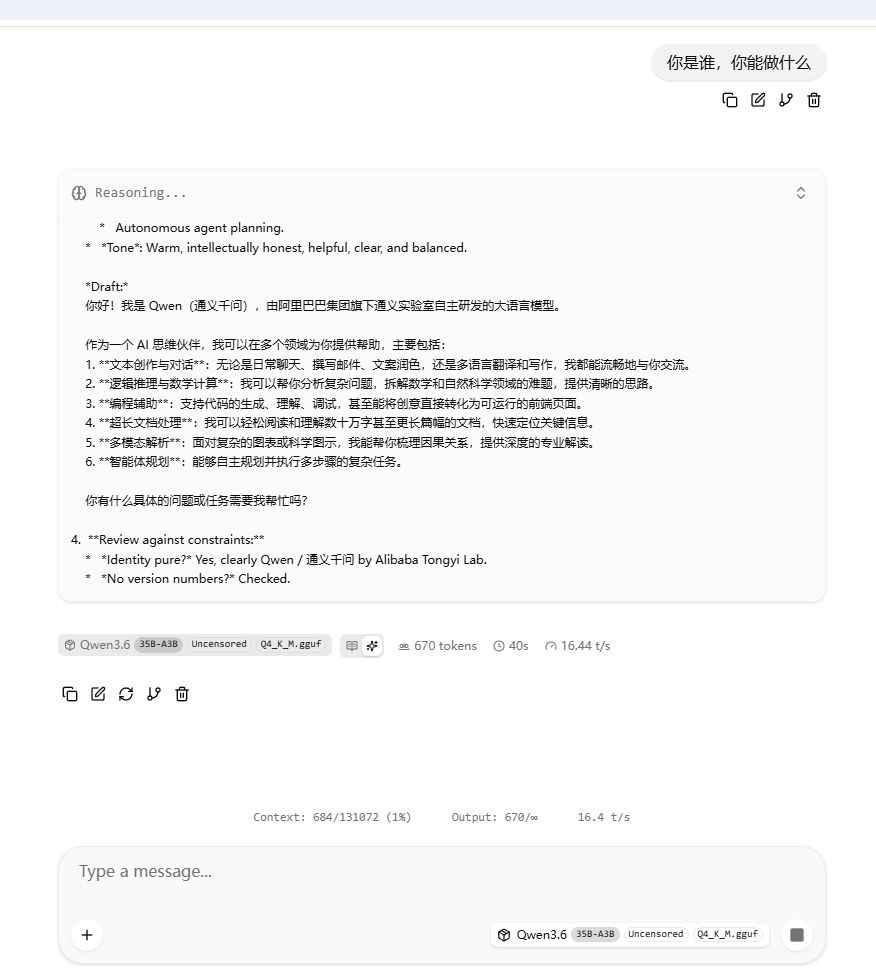
启动设置:
@echo off
chcp 65001 >nul
title Qwen3.6-35B-A3B 越狱版

cd /d "%~dp0"

:menu
cls
echo ==========================================
echo      Qwen3.6-35B-A3B 越狱版+多模态模型
echo
echo ==========================================
echo.
echo 1. Qwen3.6-35B-A3B-Uncensored-Q4_K_M (20G、多模态、综合最优)
echo.
echo ==========================================

set /p choice=请输入数字:

if "%choice%"=="1" (
    llama-server.exe ^
    -m "models\Qwen3.6-35B-A3B-Uncensored-Q4_K_M.gguf" ^
    --mmproj "models\mmproj-Qwen3.6-35B-A3B-Uncensored-f16.gguf" ^
    -ngl 999 ^
    --n-cpu-moe 99 ^
    --flash-attn on ^
    --jinja ^
    --api-key 123123 ^
    -c 131072 ^
    -n 8192 ^
    -t 12 ^
    -b 512 ^
    --cache-type-k q4_0 ^
    --cache-type-v q4_0 ^
    --mlock ^
    --no-mmap ^
    --image-min-tokens 1024 ^
    --host 0.0.0.0 ^
    --port 8080
)

pause
我需要比较长的上下文,开了131072上下文。如果调小一点,速度还会提高。我最大调262144,也能跑的动,速度有所下降。调小了能提高,但是最高也就到19 token/s,再也上不去了。我感觉15 token/s 勉强能接受,写个东西阅读能跟的上,可以调用Hermes,做一些小任务,编程不行。编程还得用DSH调用,勉强能做一些东西,智力还是稍微差一点。另外就是上下文用了超过60%,速度会慢,有时候不给他任务,他后台大模型还会自己调用工具循环,不知道什么原因,我现在强制他不循环调用工具,会好一点,很少像死机一样没反应了。
本文就是就是给没来得及上车的游戏党玩家做个参考,利用手中的工具,看看大概能跑个什么数值。这显卡做生产力还是差的有点多。
另外就是不用去试其他大模型了,9B及以下的模型,速度可能比较快一点,但真的智力更堪忧,千问Qwen3.6-35B-A3B,应该是综合性价比最高的,其他厂家的模型,各种量化版本也都试过几十个,输出token速度大多是个位数,8G显存档基本上可以不用试了。这个基本就是8G档的最优模型。