跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
jason anJ

jason an

@jason an
取消关注 关注
关于
帖子
9
主题
1
分享
0
群组
0
粉丝
0
关注
1

帖子

最新 最佳 有争议的

  • 写了个模型档无损压缩管理器,有需要的可以试试看
    jason anJ jason an
    LLM讨论区 本地模型 量化

    鼓励探索开发,加油!


  • 双卡RTX3090 + 256G内存 用Strata 跑orcarouter的QFN IQ4_XS 100t/s 256k 10月8日 冲150T/S
    jason anJ jason an
    LLM讨论区 rtx3090 strata qwen-flash

    期待楼主出对比QWEN 3.8 27B 和strata + qwen 3.8 flash 的使用感受


  • 混搭 DGX Spark GB10 Prefill + Mac Studio Decode
    jason anJ jason an
    AI硬件 dgxspark gb10 mac

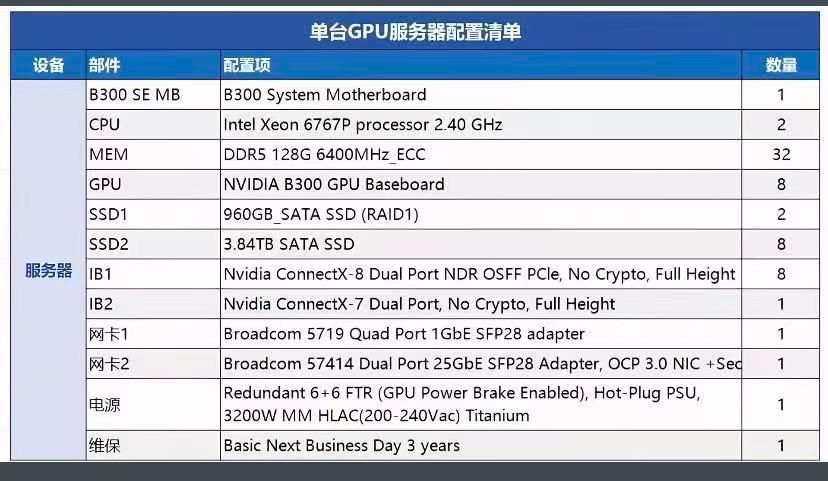
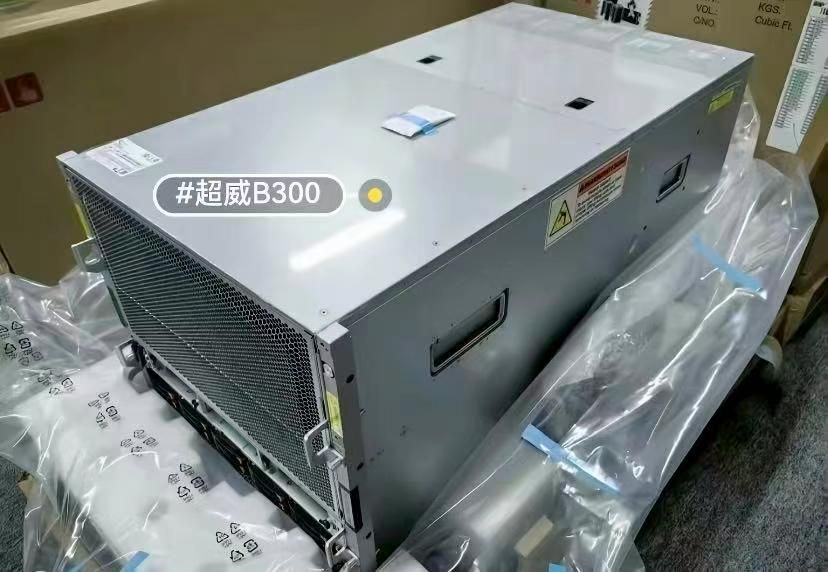
    我孤陋寡闻了。我发的那组B300,我以为价值可能会三四百万,今天贸贸然问了代理的人,没想到炒到过千万一台了。真离谱!


  • 混搭 DGX Spark GB10 Prefill + Mac Studio Decode
    jason anJ jason an
    AI硬件 dgxspark gb10 mac

    @kos-or 说:

    很有趣的組合, 不知道效果如何?

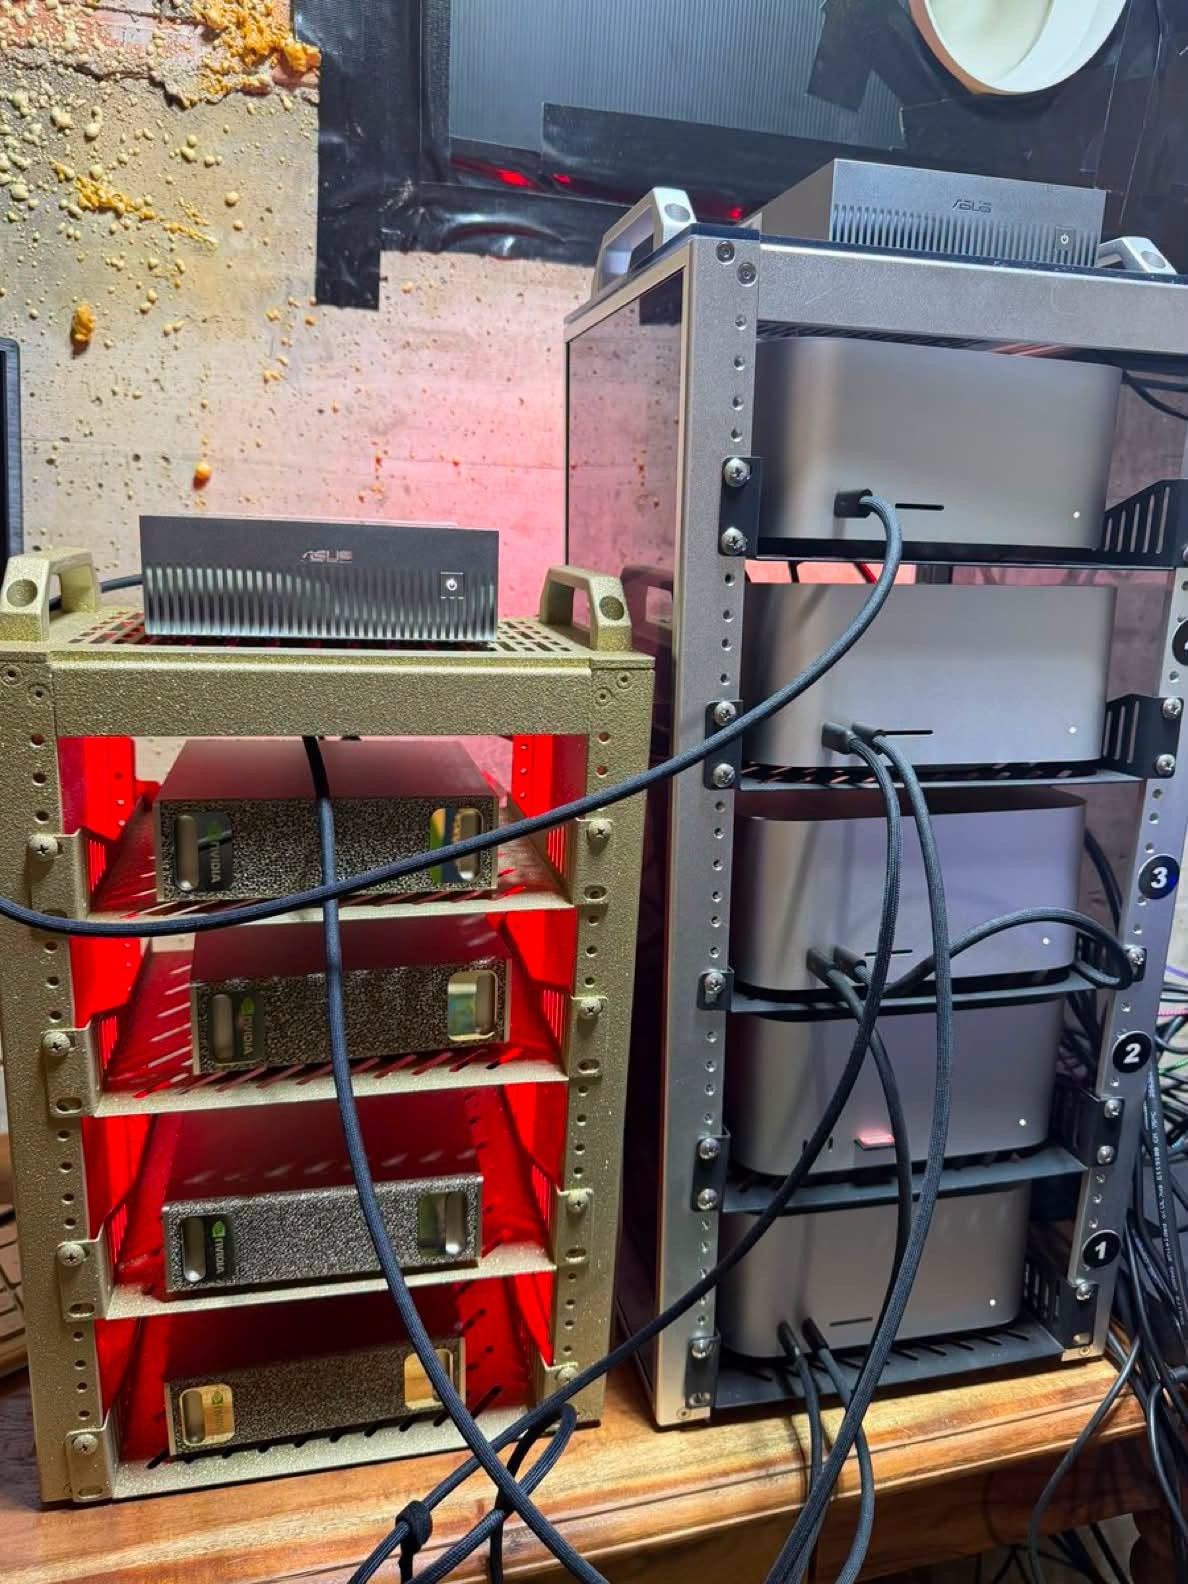
    分享一下網路上AI熱愛者的經典作品 :混搭 GB10 Prefill + Mac Studio Decode

    擁有 2.4 TB 統一記憶體的傳奇之作

    • 7 塊 DGX Spark :896 GB
    • 5 塊 M3 Mac Studio :1.5 TB
    • NVIDIA 負責處理昂貴的Prefill。
    • Apple Silicon 晶片負責模型運行和高效率Decode。
    • 快取跨越普通 10Gb 乙太網路。

    26cd00b1-53f5-4891-b11e-1b1a3377be0c-image.jpeg

    这是个天才玩家啊,显存超过这配置的一半了,价格,可是离这家伙的一半远不少
    63fa4012-7009-49fd-a837-845128fa8953-7fcfe30c76af4fb5ce1a49d122e364bc.jpg
    2f675086-0ca2-40d6-bf50-808492f35948-9c997d08fae8bfb34da33b118ee76f67.jpg
    fe96e983-44f9-49d4-b054-a3839fce89bd-ef5fa81bbe84d5a554d752e5219f864d.jpg


  • 【GTX 1070 8G】NVIDIA GeForce GTX 1070 (8G 华硕) 跑Qwen3.6-35B-A3B ,14~19 token/s ,【补论坛显卡数据库,需要生产力的不用看】
    jason anJ jason an
    AI硬件 nvidia qwen dsharness

    @kos-or 说:

    聽說這個小模型很強 MiniCpm5-2B
    有機會可試試看

    好滴,周末下载个玩玩看。不知道能干活不。我以前下过2B级别的小模型,除了吐字快,其他的似乎没啥用,都不行。驱动Agent有点傻,写文章很生硬,甚至英文插在仙侠文中蹦出来,还有给你凑字数,不停的复制粘贴相同段落,总之挺傻缺的。


  • 【GTX 1070 8G】NVIDIA GeForce GTX 1070 (8G 华硕) 跑Qwen3.6-35B-A3B ,14~19 token/s ,【补论坛显卡数据库,需要生产力的不用看】
    jason anJ jason an
    AI硬件 nvidia qwen dsharness

    @dardeaw-feng 说:

    Ornith 1.5 35B可以試試看,同樣是Qwen 3.5用新的COT模式訓練上來的,體驗上可靠度比四個月前的Qwen 3.6 35B好一點

    好滴,你这个建议我试试。非常感谢!


  • 【GTX 1070 8G】NVIDIA GeForce GTX 1070 (8G 华硕) 跑Qwen3.6-35B-A3B ,14~19 token/s ,【补论坛显卡数据库,需要生产力的不用看】
    jason anJ jason an
    AI硬件 nvidia qwen dsharness

    忘了说了,这个是大力飞砖,配置卸载的层数不对,是按照3060 12G,64G内存写的,在这个机器上也能跑,只是都放内存里让cpu跑了。3060 12G那个机器能跑37 token/s .


  • 【GTX 1070 8G】NVIDIA GeForce GTX 1070 (8G 华硕) 跑Qwen3.6-35B-A3B ,14~19 token/s ,【补论坛显卡数据库,需要生产力的不用看】
    jason anJ jason an
    AI硬件 nvidia qwen dsharness

    先定性,本帖只给想尝试自己搭建大模型,还没有升级、购买设备的朋友做个参考,顺便补充一下论坛硬件数据库的资料。

    8G显存显卡,两个月前不具备生产力,搭配Hermes蠢得要死,勉强能作为玩具,尝尝鲜,感受一下自动化Agent是啥,但是编程,复杂任务很难完成,多轮后,容易陷入一直调用工具的循环,Hermes超时没了反应。

    但是现在,搭配Deepseek Harness,竟然能够干一些简单的活了,编写个小游戏,写个文章啥的,已经有模有样。至少是真的可以干活了。

    harness真牛逼,他的任务约束能力,至少让这个傻缺模型智能上了两个档次,从学前班成长为初中生的级别。

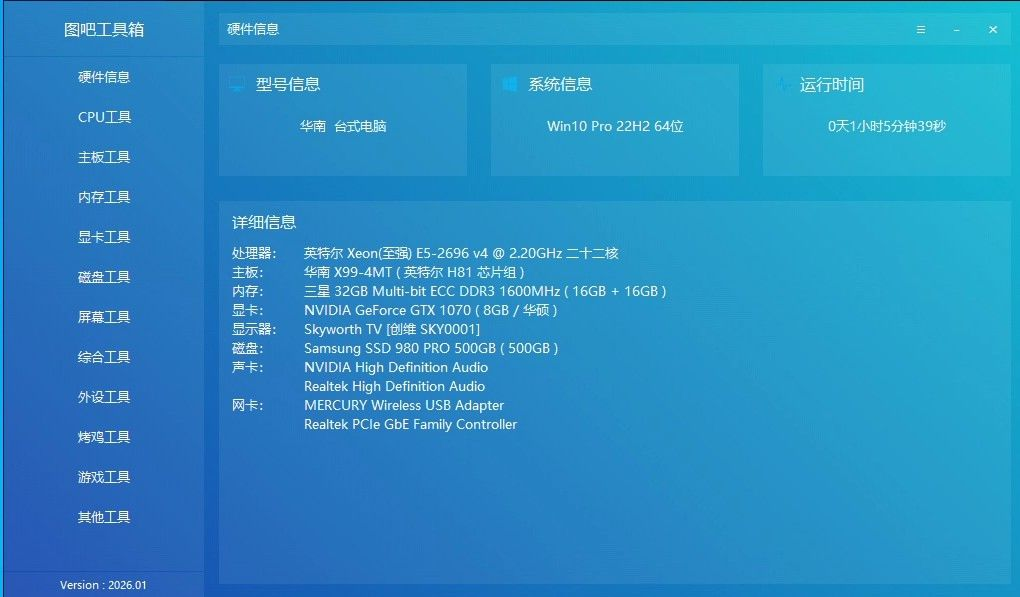
    因为不是玩AI主力配置,就大概展示一下数据,作为一个参考。

    硬件
    01.png

    软件

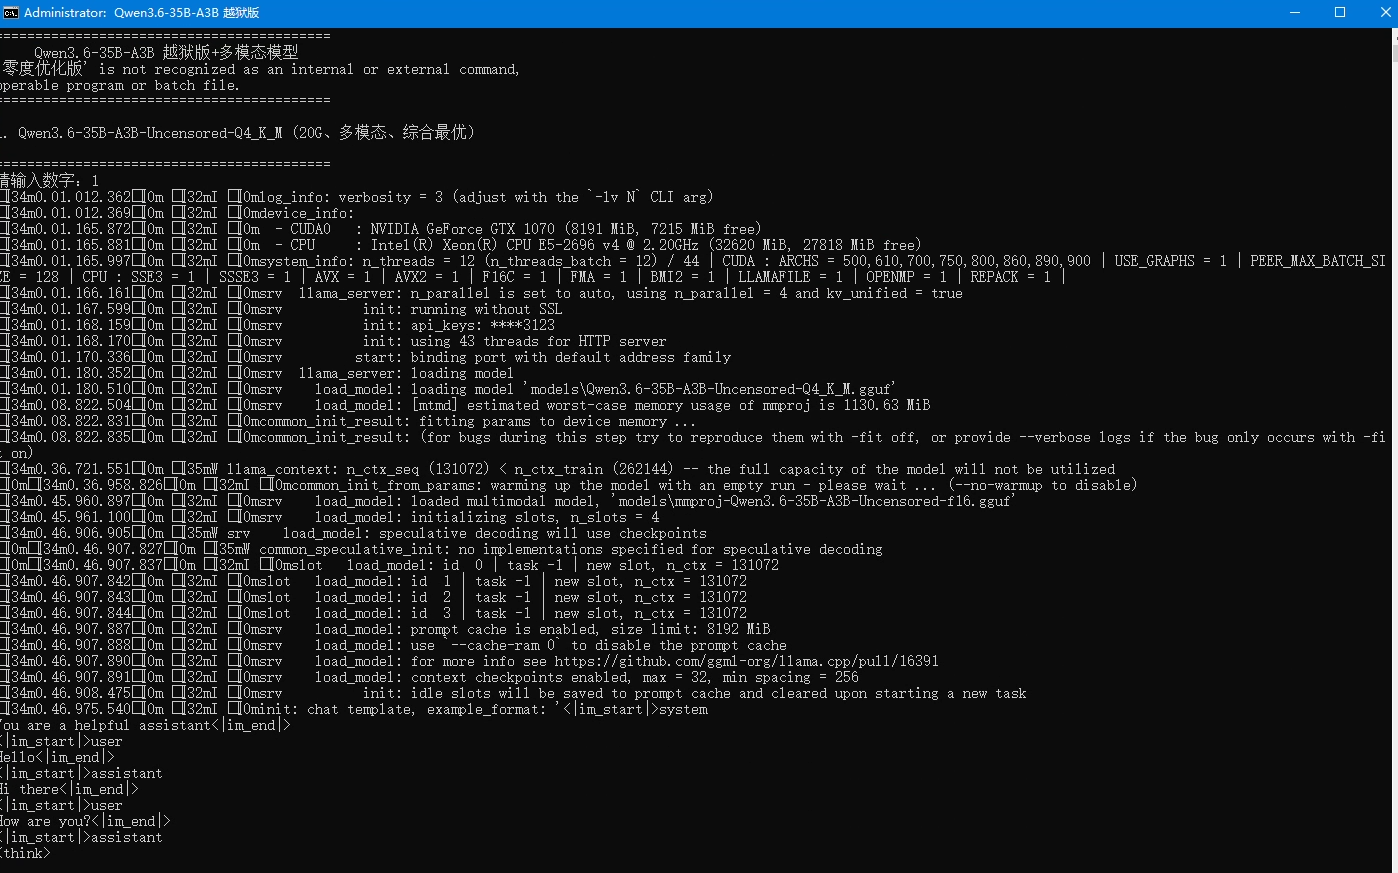
    llama-b9310-bin-win-cuda-12.4-x64

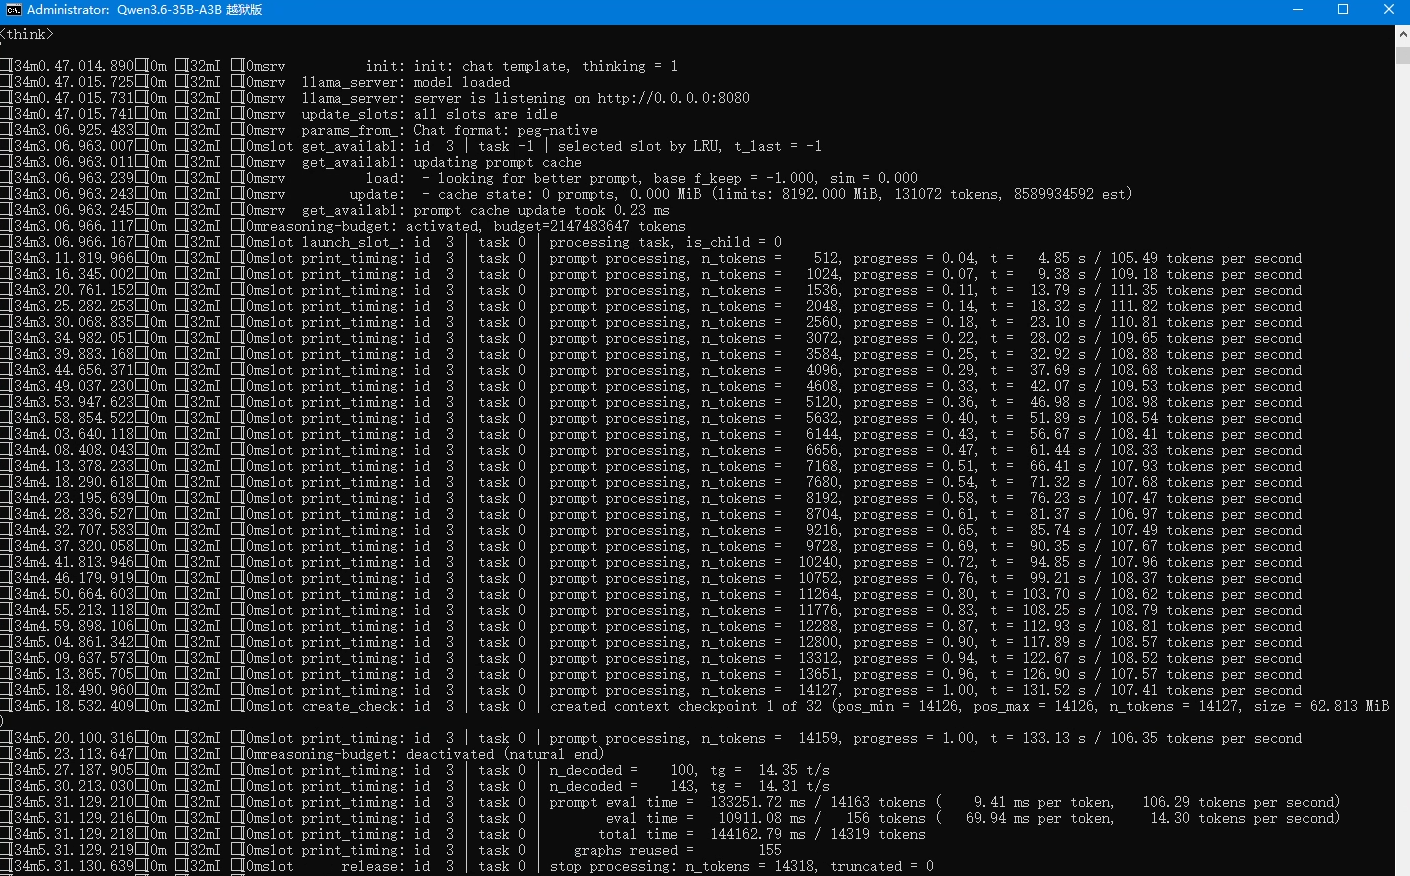
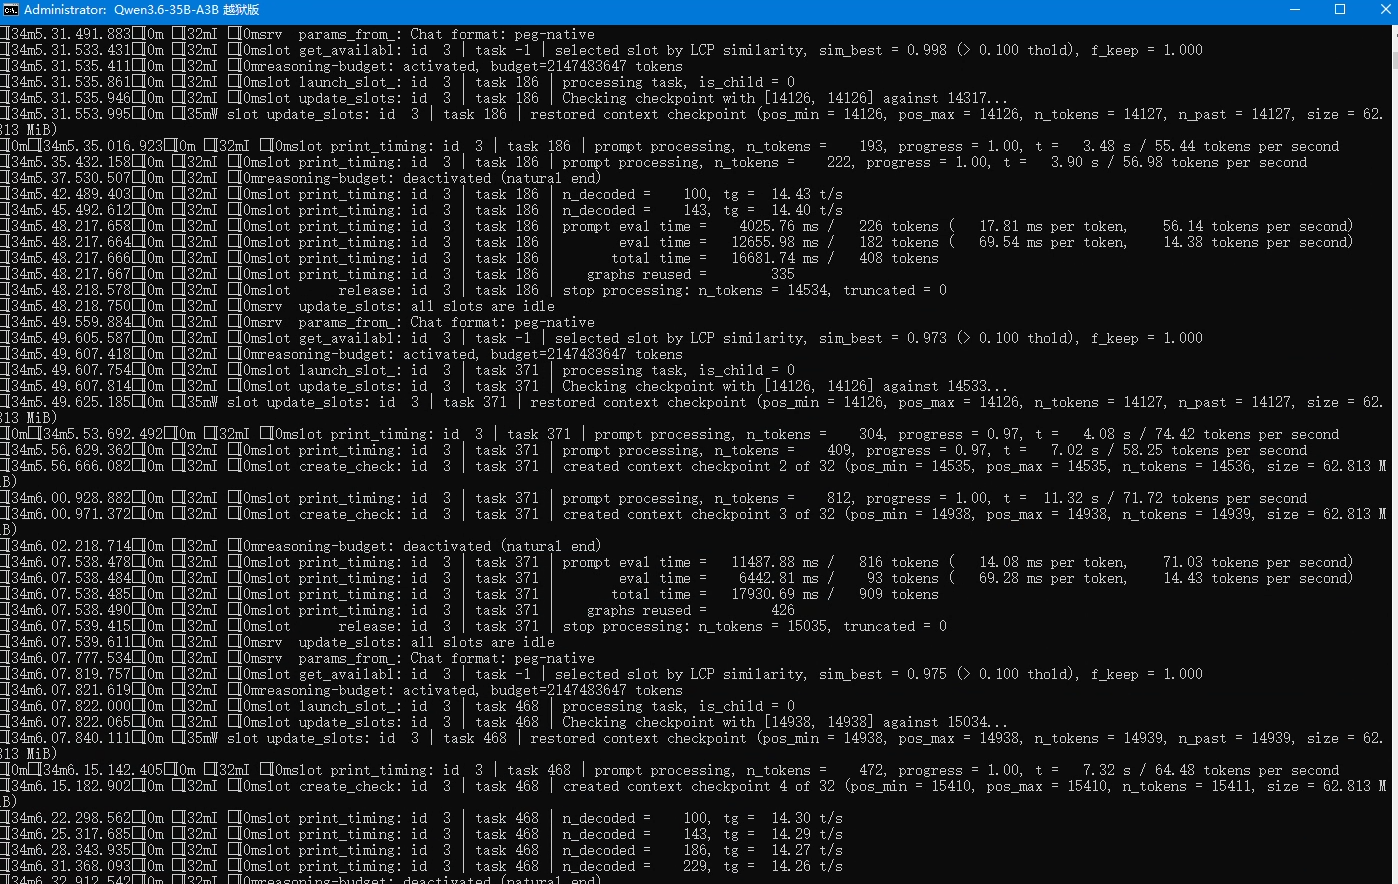
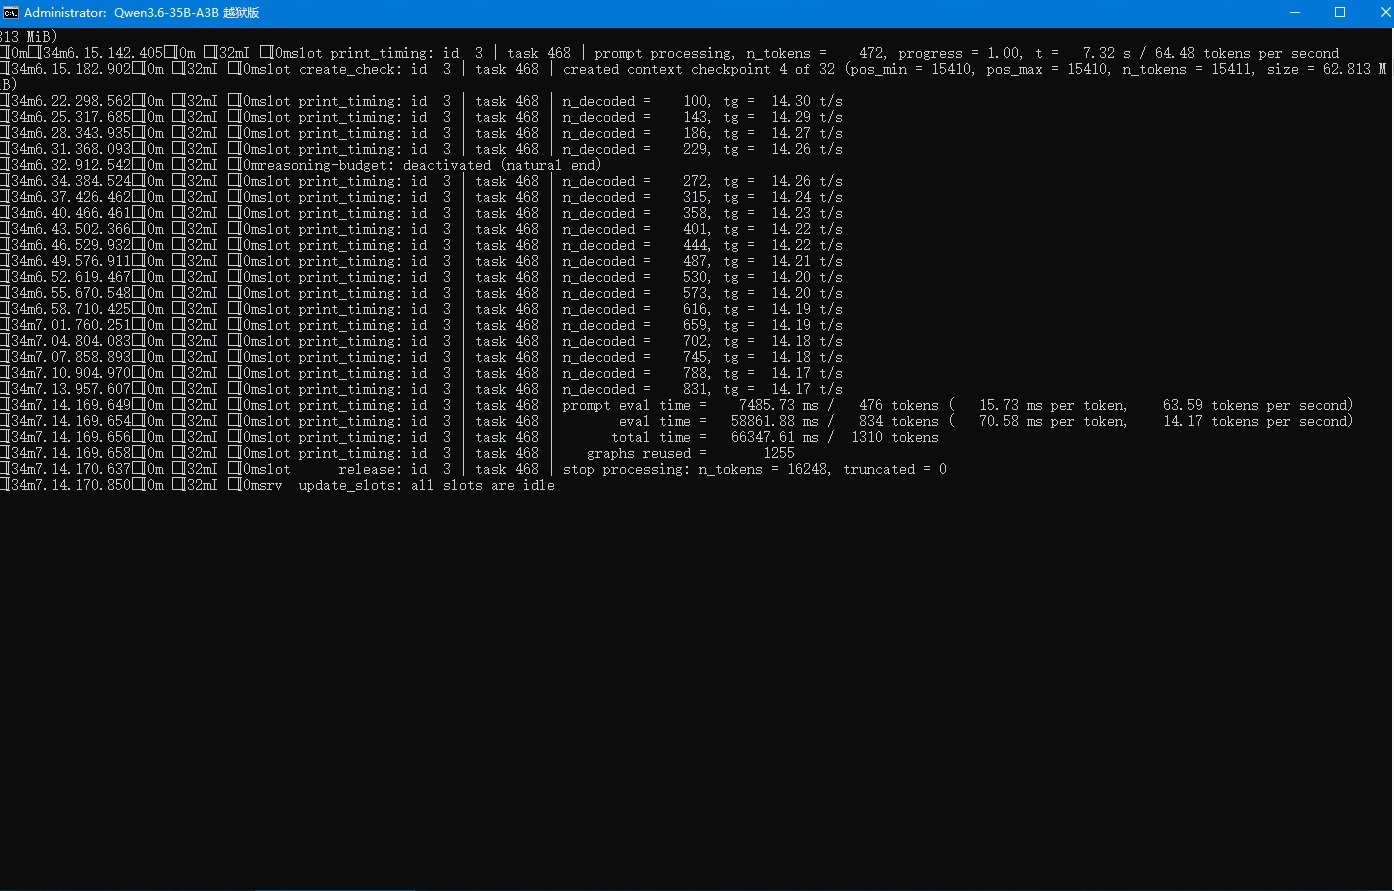
    我懒,具体看图
    02.png

    03.png

    04.png

    05.png

    06.png

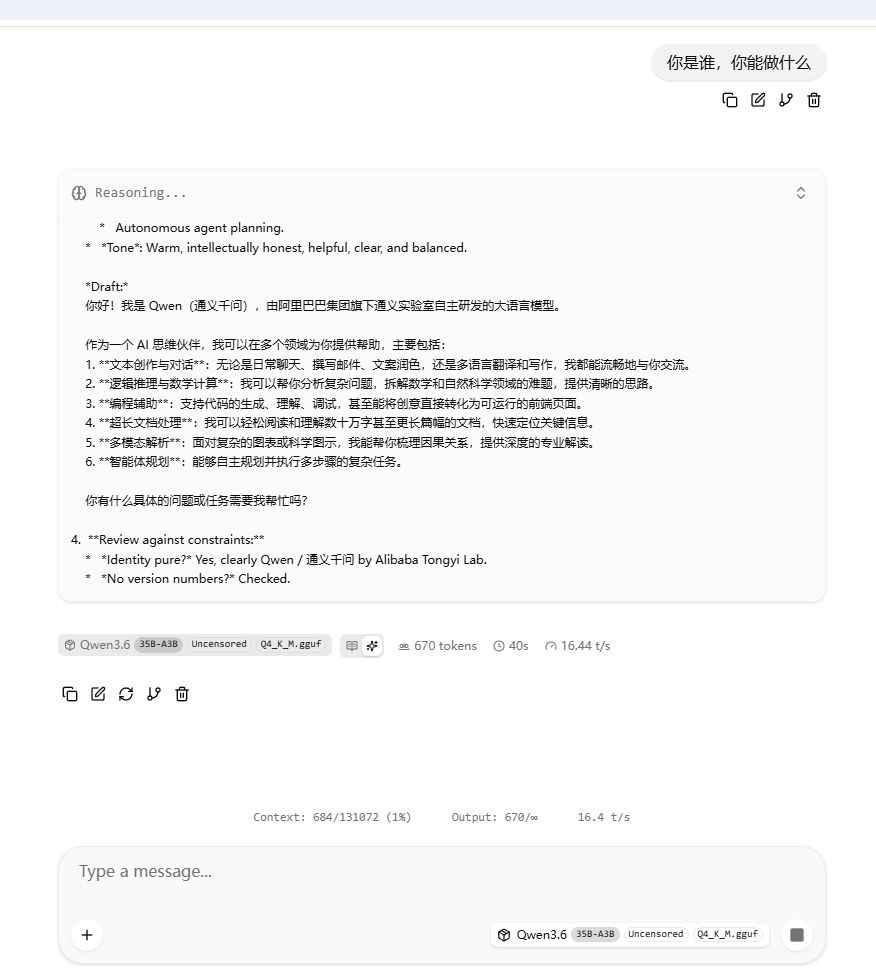
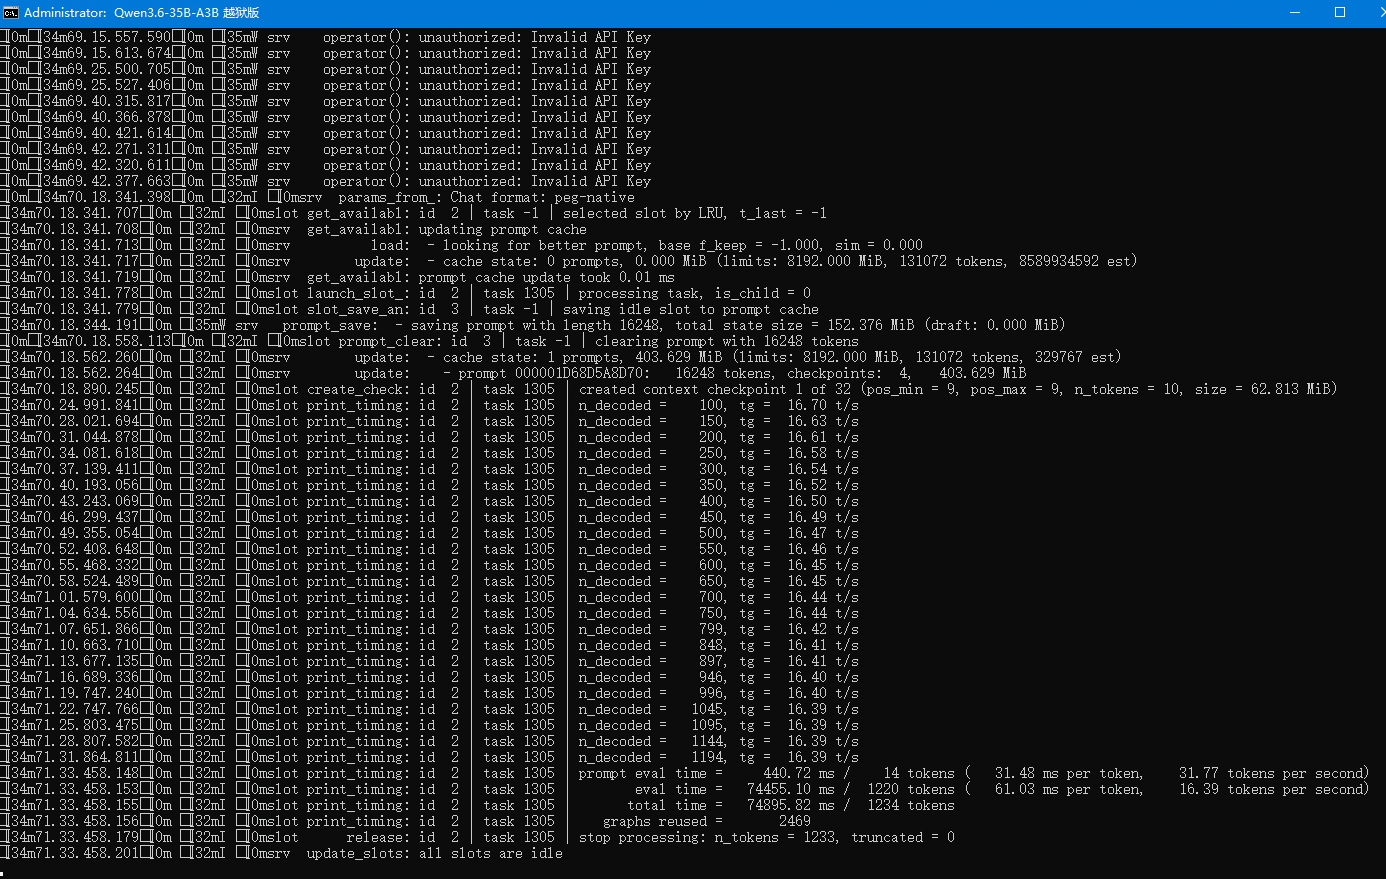
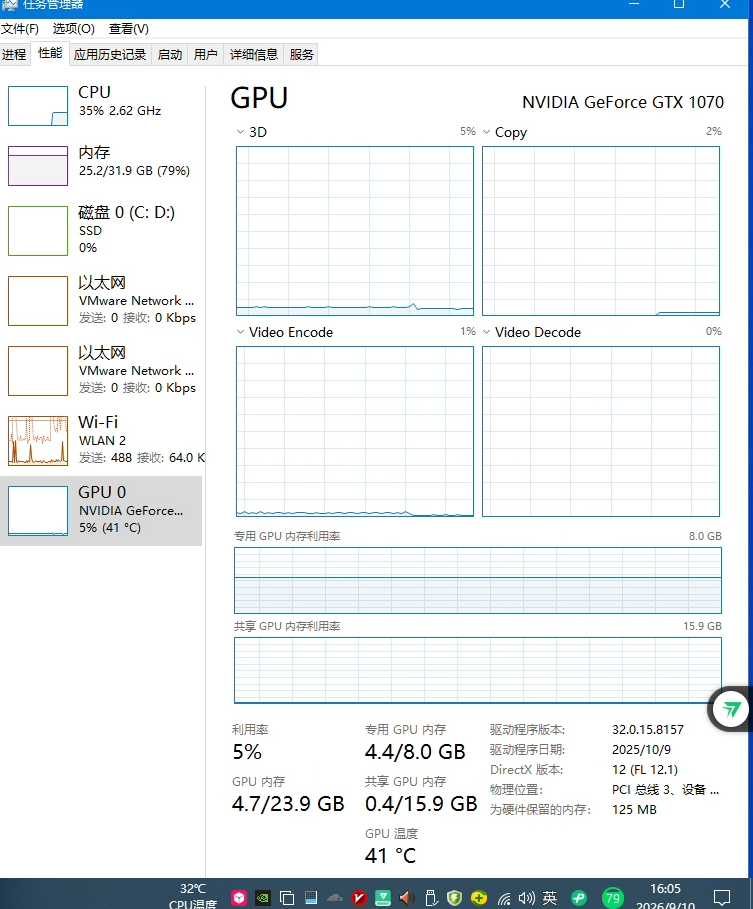
    上面是运行了一下 Deepseek harness 的日志。下面是直接用网页版,直接访问llama.cpp 模型的截图。
    07.png

    08.png

    09.png

    启动设置:

    @echo off
    chcp 65001 >nul
    title Qwen3.6-35B-A3B 越狱版
    
    cd /d "%~dp0"
    
    :menu
    cls
    echo ==========================================
    echo      Qwen3.6-35B-A3B 越狱版+多模态模型
    echo              
    echo ==========================================
    echo.
    echo 1. Qwen3.6-35B-A3B-Uncensored-Q4_K_M (20G、多模态、综合最优)
    echo.
    echo ==========================================
    
    set /p choice=请输入数字:
    
    if "%choice%"=="1" (
        llama-server.exe ^
        -m "models\Qwen3.6-35B-A3B-Uncensored-Q4_K_M.gguf" ^
        --mmproj "models\mmproj-Qwen3.6-35B-A3B-Uncensored-f16.gguf" ^
        -ngl 999 ^
        --n-cpu-moe 99 ^
        --flash-attn on ^
        --jinja ^
        --api-key 123123 ^
        -c 131072 ^
        -n 8192 ^
        -t 12 ^
        -b 512 ^
        --cache-type-k q4_0 ^
        --cache-type-v q4_0 ^
        --mlock ^
        --no-mmap ^
        --image-min-tokens 1024 ^
        --host 0.0.0.0 ^
        --port 8080
    )
    
    pause
    

    我需要比较长的上下文,开了131072上下文。如果调小一点,速度还会提高。我最大调262144,也能跑的动,速度有所下降。调小了能提高,但是最高也就到19 token/s,再也上不去了。我感觉15 token/s 勉强能接受,写个东西阅读能跟的上,可以调用Hermes,做一些小任务,编程不行。编程还得用DSH调用,勉强能做一些东西,智力还是稍微差一点。另外就是上下文用了超过60%,速度会慢,有时候不给他任务,他后台大模型还会自己调用工具循环,不知道什么原因,我现在强制他不循环调用工具,会好一点,很少像死机一样没反应了。

    本文就是就是给没来得及上车的游戏党玩家做个参考,利用手中的工具,看看大概能跑个什么数值。这显卡做生产力还是差的有点多。

    另外就是不用去试其他大模型了,9B及以下的模型,速度可能比较快一点,但真的智力更堪忧,千问Qwen3.6-35B-A3B,应该是综合性价比最高的,其他厂家的模型,各种量化版本也都试过几十个,输出token速度大多是个位数,8G显存档基本上可以不用试了。这个基本就是8G档的最优模型。


  • 京东自营上架二手3090,标价8699,近期有自建本地AI算力的玩家可以给东哥走个面,单卡或者双卡TP都很有CP值,比7900XTX新卡更好!
    jason anJ jason an
    AI硬件 rtx3090 多卡部署

    凌晨看的时候,狗东都没有货了,剩下的小店,3090都是一万二起步了。

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组