跳转至内容
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组
皮肤
  • 浅色
  • Brite
  • Cerulean
  • Cosmo
  • Flatly
  • Journal
  • Litera
  • Lumen
  • Lux
  • Materia
  • Minty
  • Morph
  • Pulse
  • Sandstone
  • Simplex
  • Sketchy
  • Spacelab
  • United
  • Yeti
  • Zephyr
  • 深色
  • Cyborg
  • Darkly
  • Quartz
  • Slate
  • Solar
  • Superhero
  • Vapor

  • 默认(LCZ-Blue)
  • 不使用皮肤
  • LCZ-Green
  • LCZ-Blue
  • LCZ-Black
折叠
品牌标识

抡锤者

首页 版块 标签
硬件
装备秀
AI 广场 App
JumpEggKillerJ

JumpEggKiller

@JumpEggKiller
体面乡绅 硕果累累
取消关注 关注
关于
帖子
50
主题
9
分享
0
群组
2
粉丝
0
关注
0

帖子

最新 最佳 有争议的

  • 没想到我的猫笼机箱+矿架居然上电视了!有钱大神太多,4 X 3090低调路过...
    JumpEggKillerJ JumpEggKiller
    装备秀 rtx3090 多卡部署

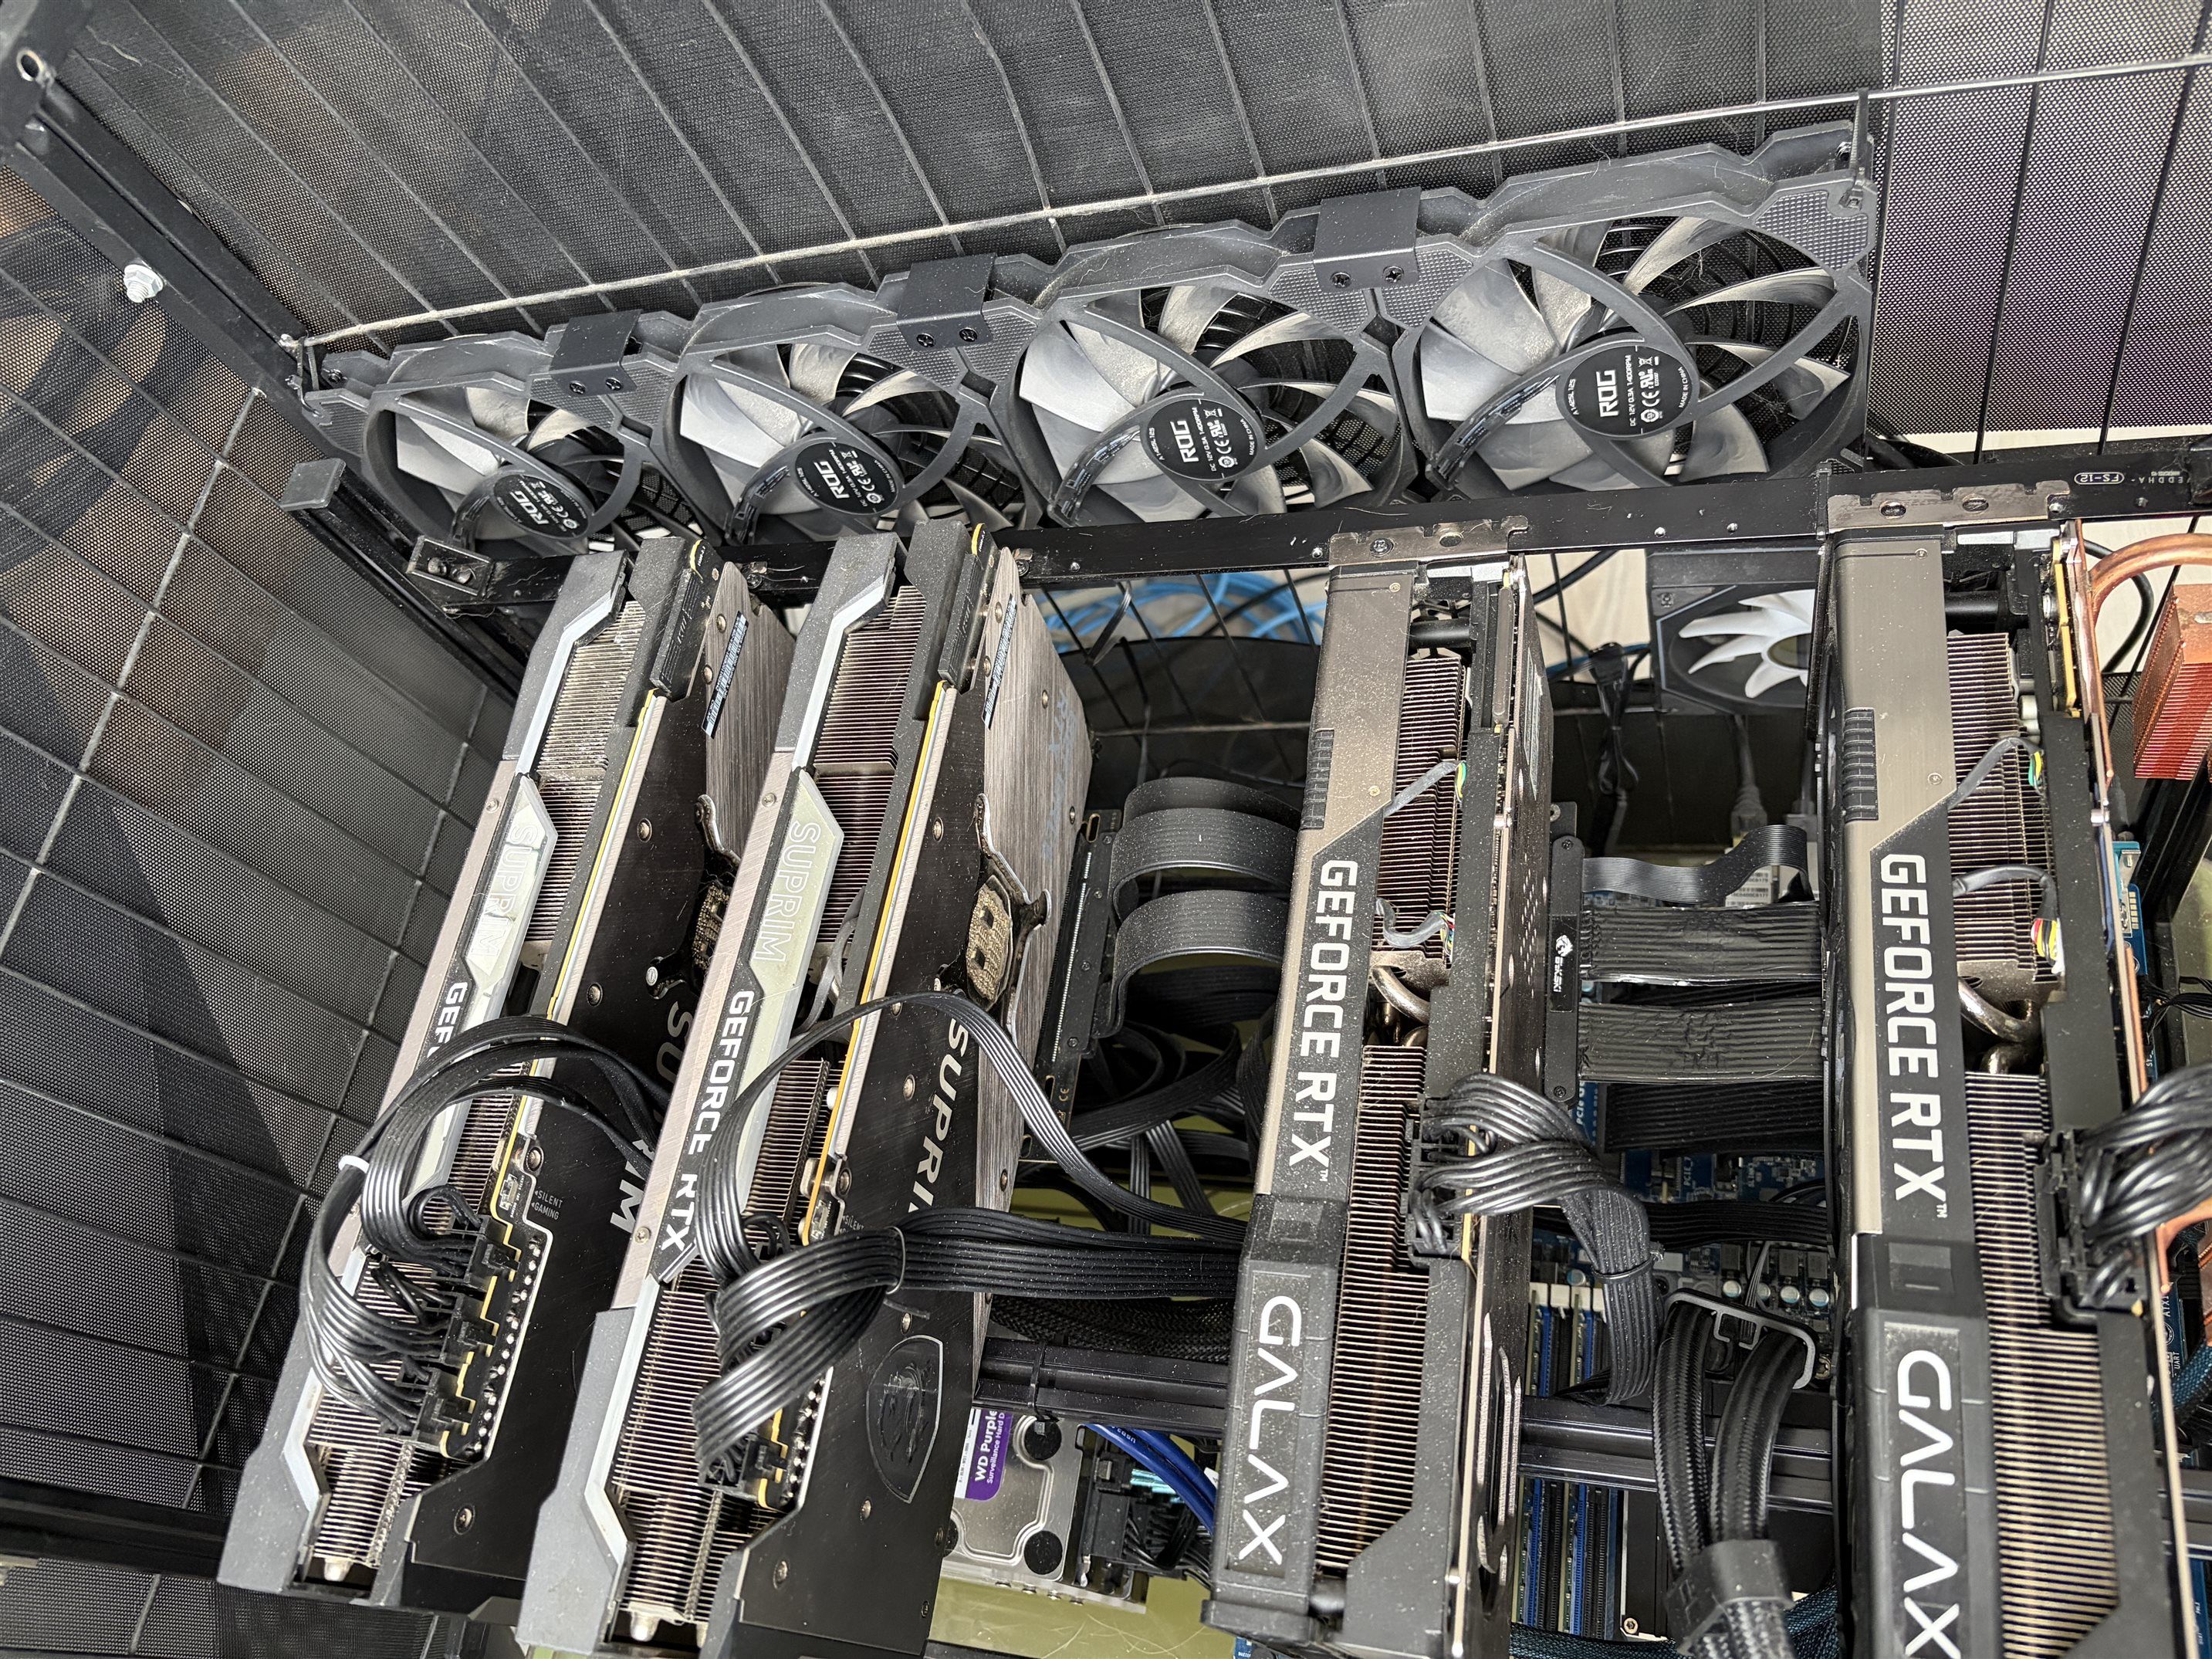
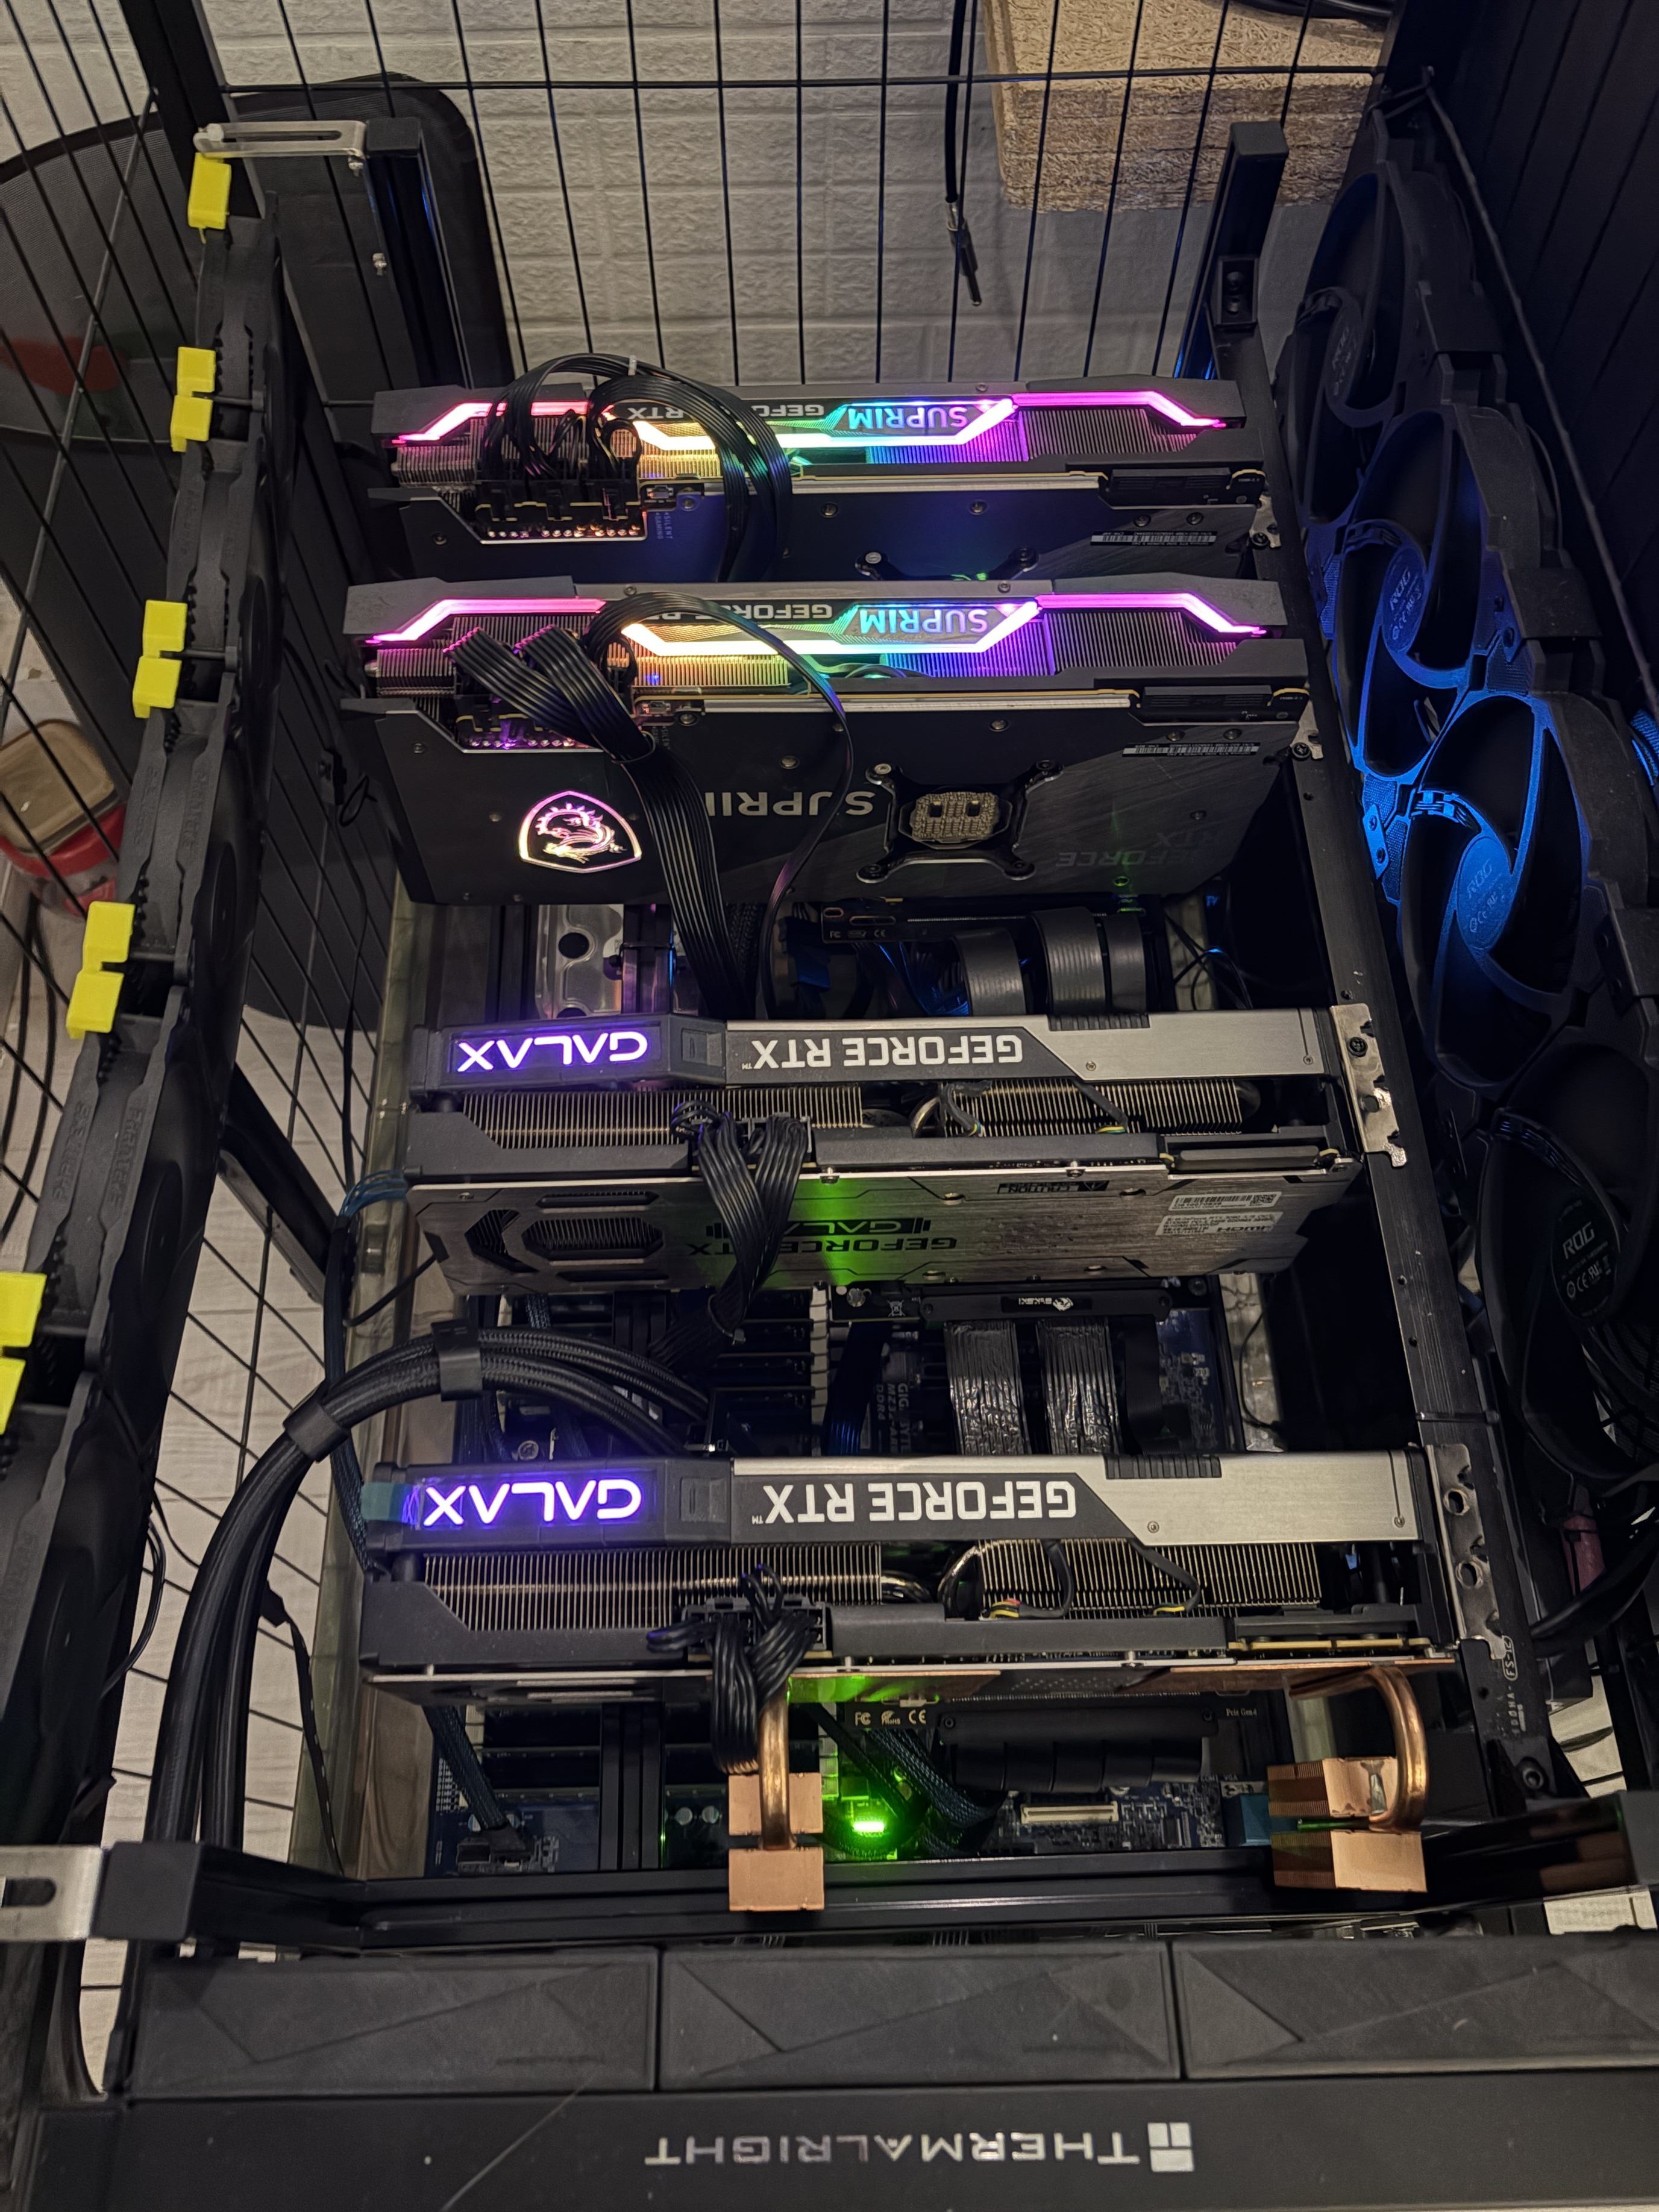
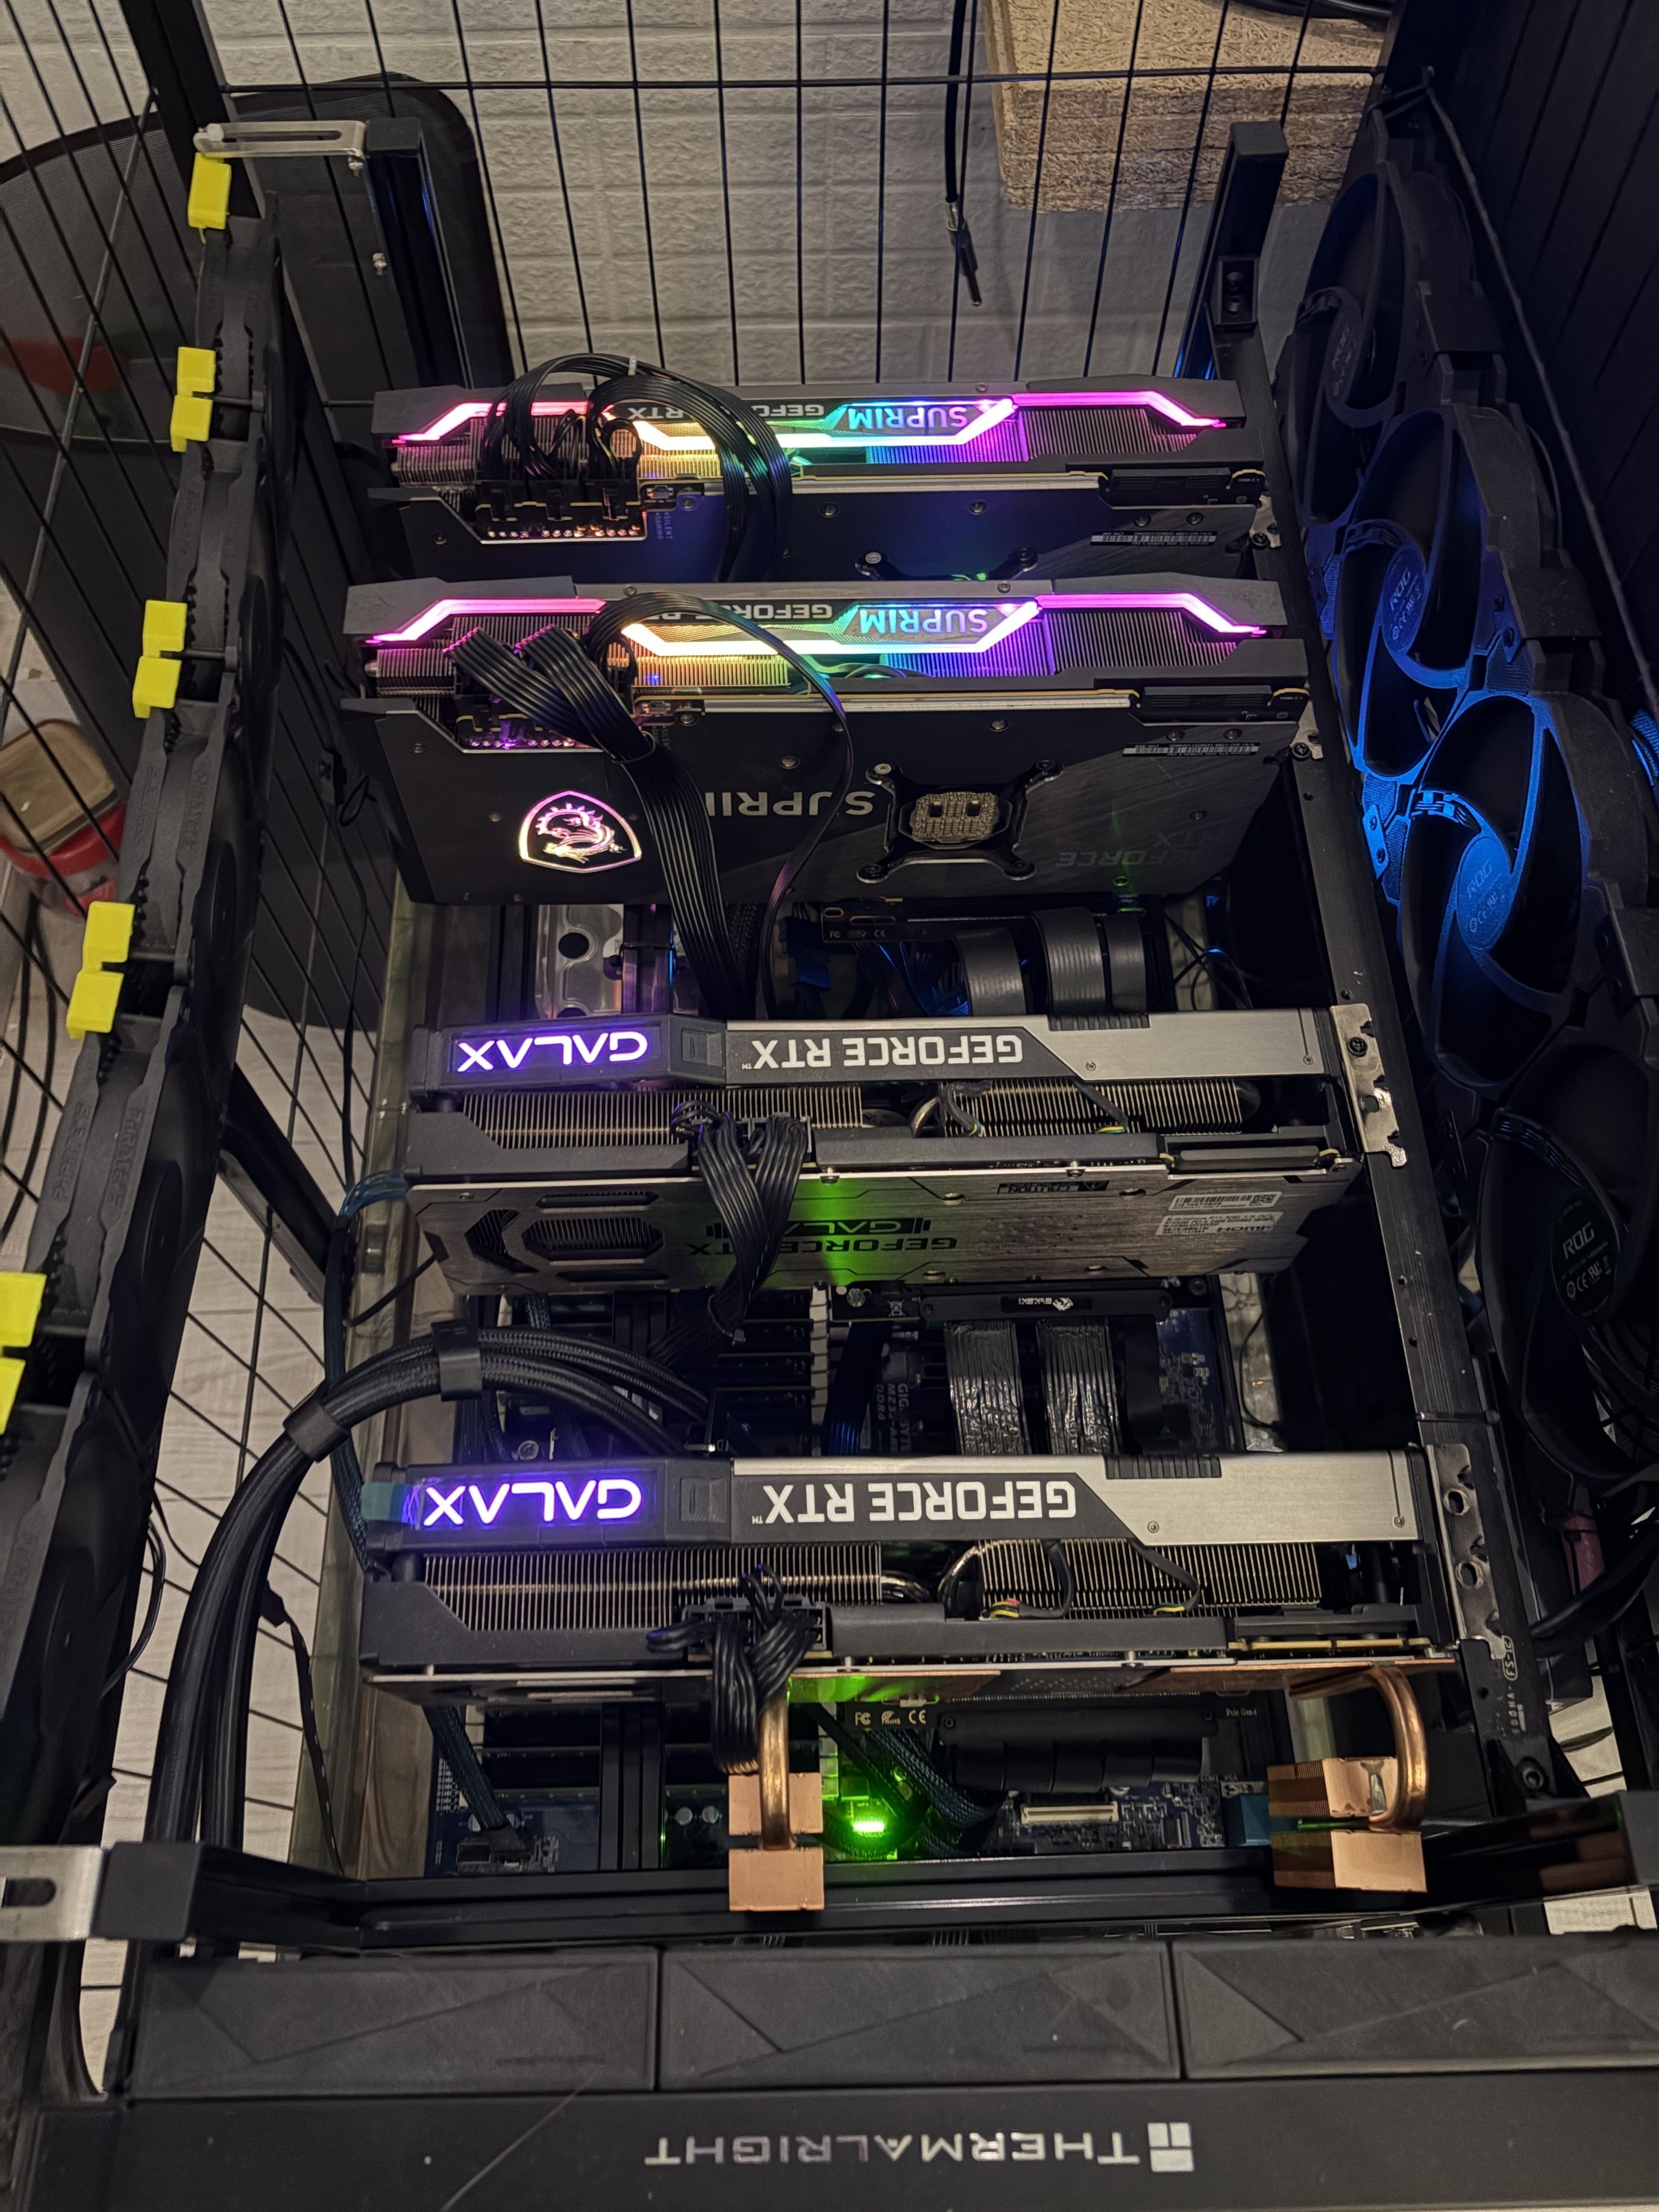
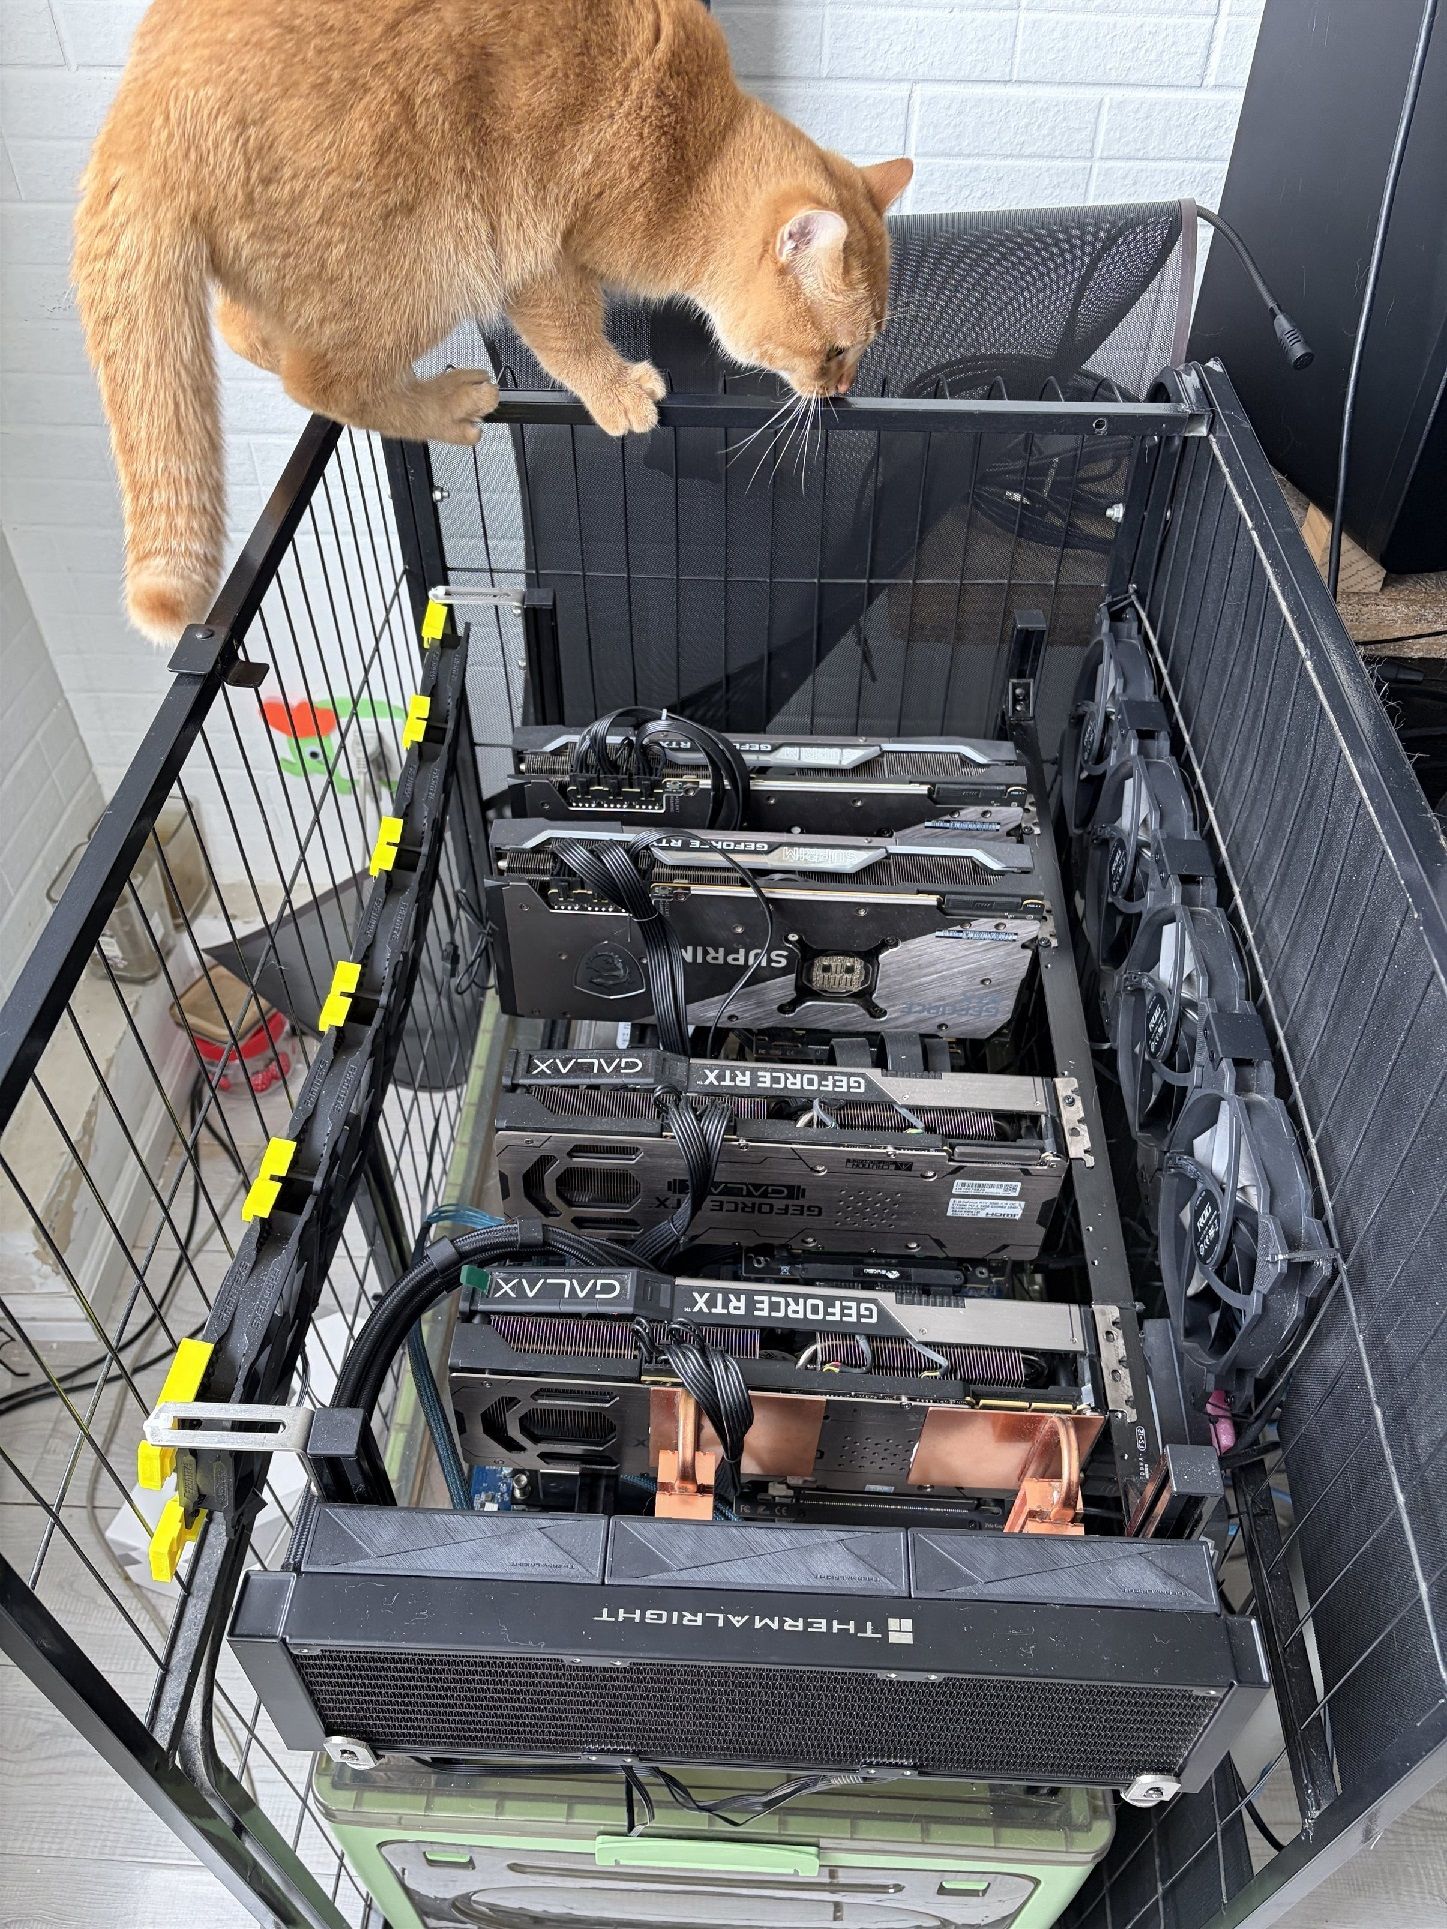
    🤪这是我的4x3090🐈猫笼机箱+矿架:
    7b78a67259792b98d2ec3390ac360df2.jpg

    出现在了博主最近的视频中🤣,给博主审美点赞!🤘

    😹我就是爱折腾!

    先说一下折腾历程。😎
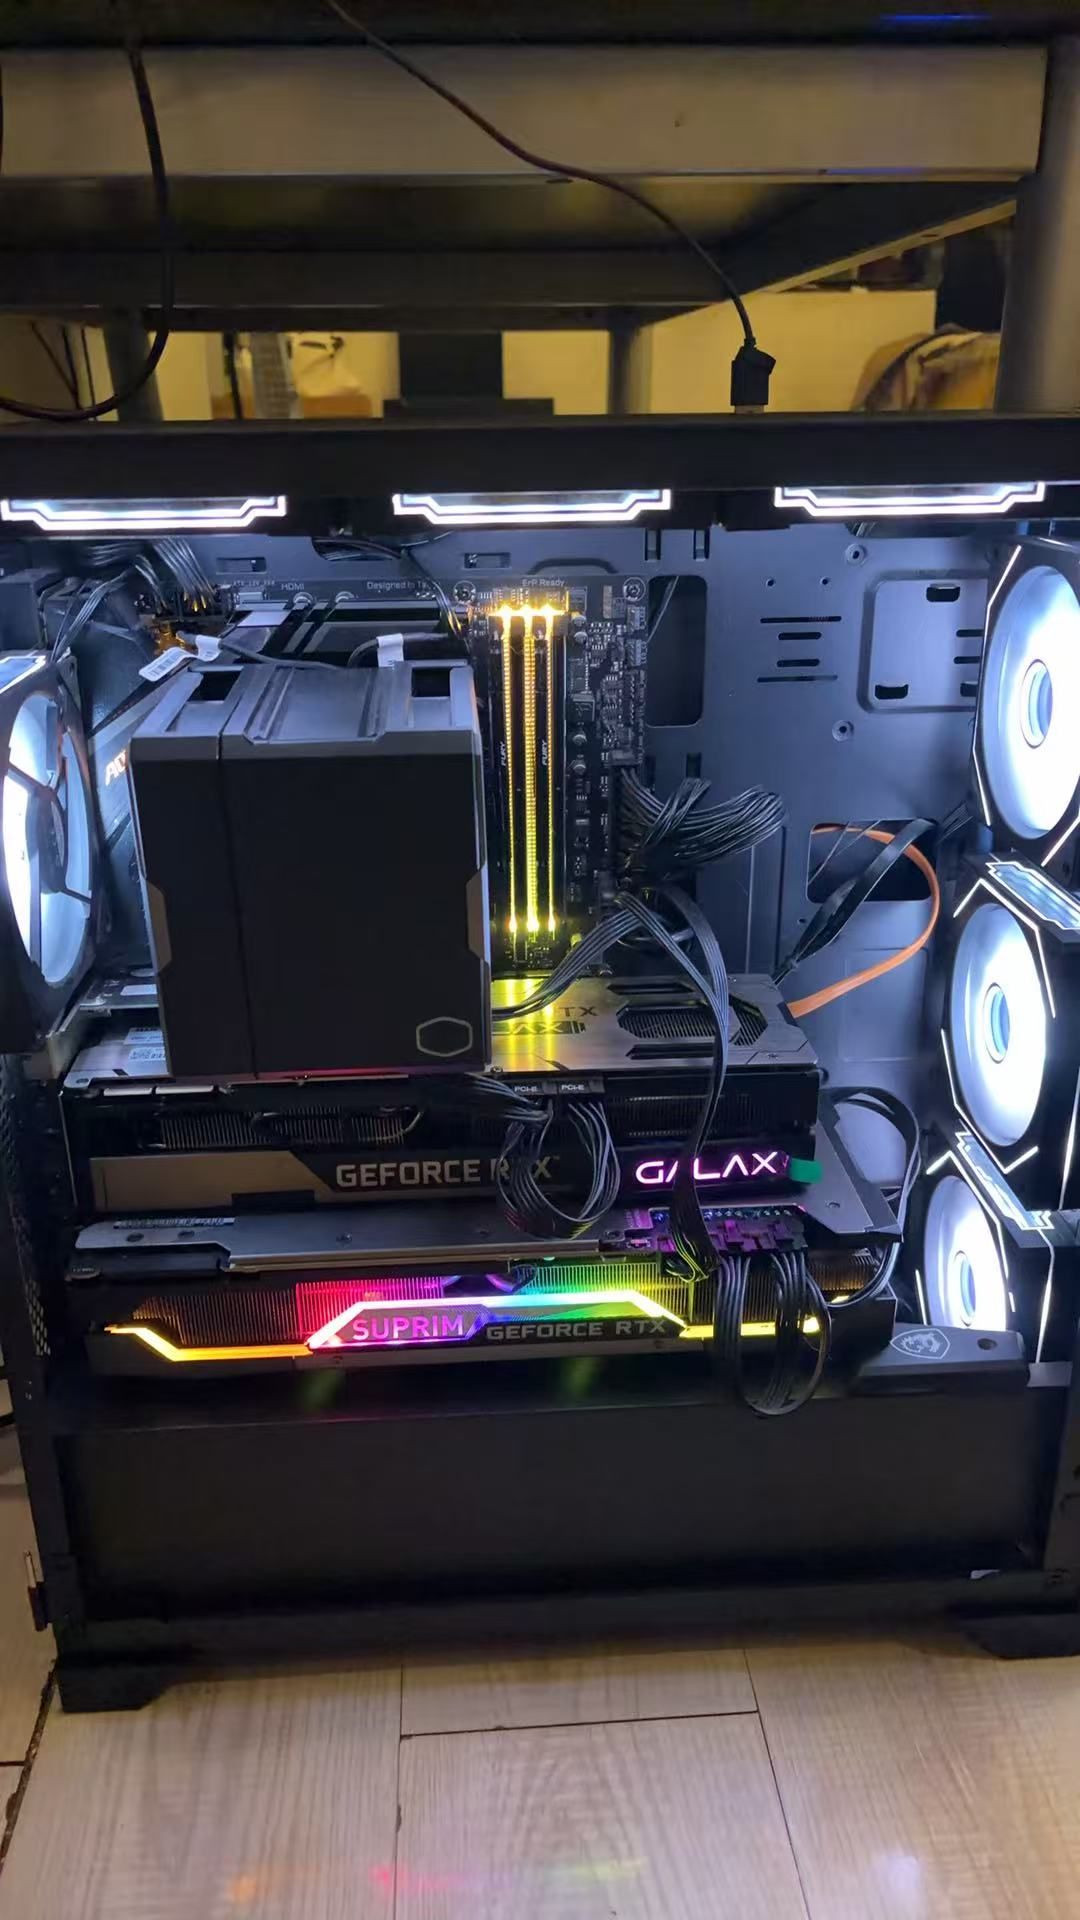
    年初在老游戏主机上了双卡3090:🤦‍♂️
    b5b3c453ab035dae8b35c28ef448371a.jpg

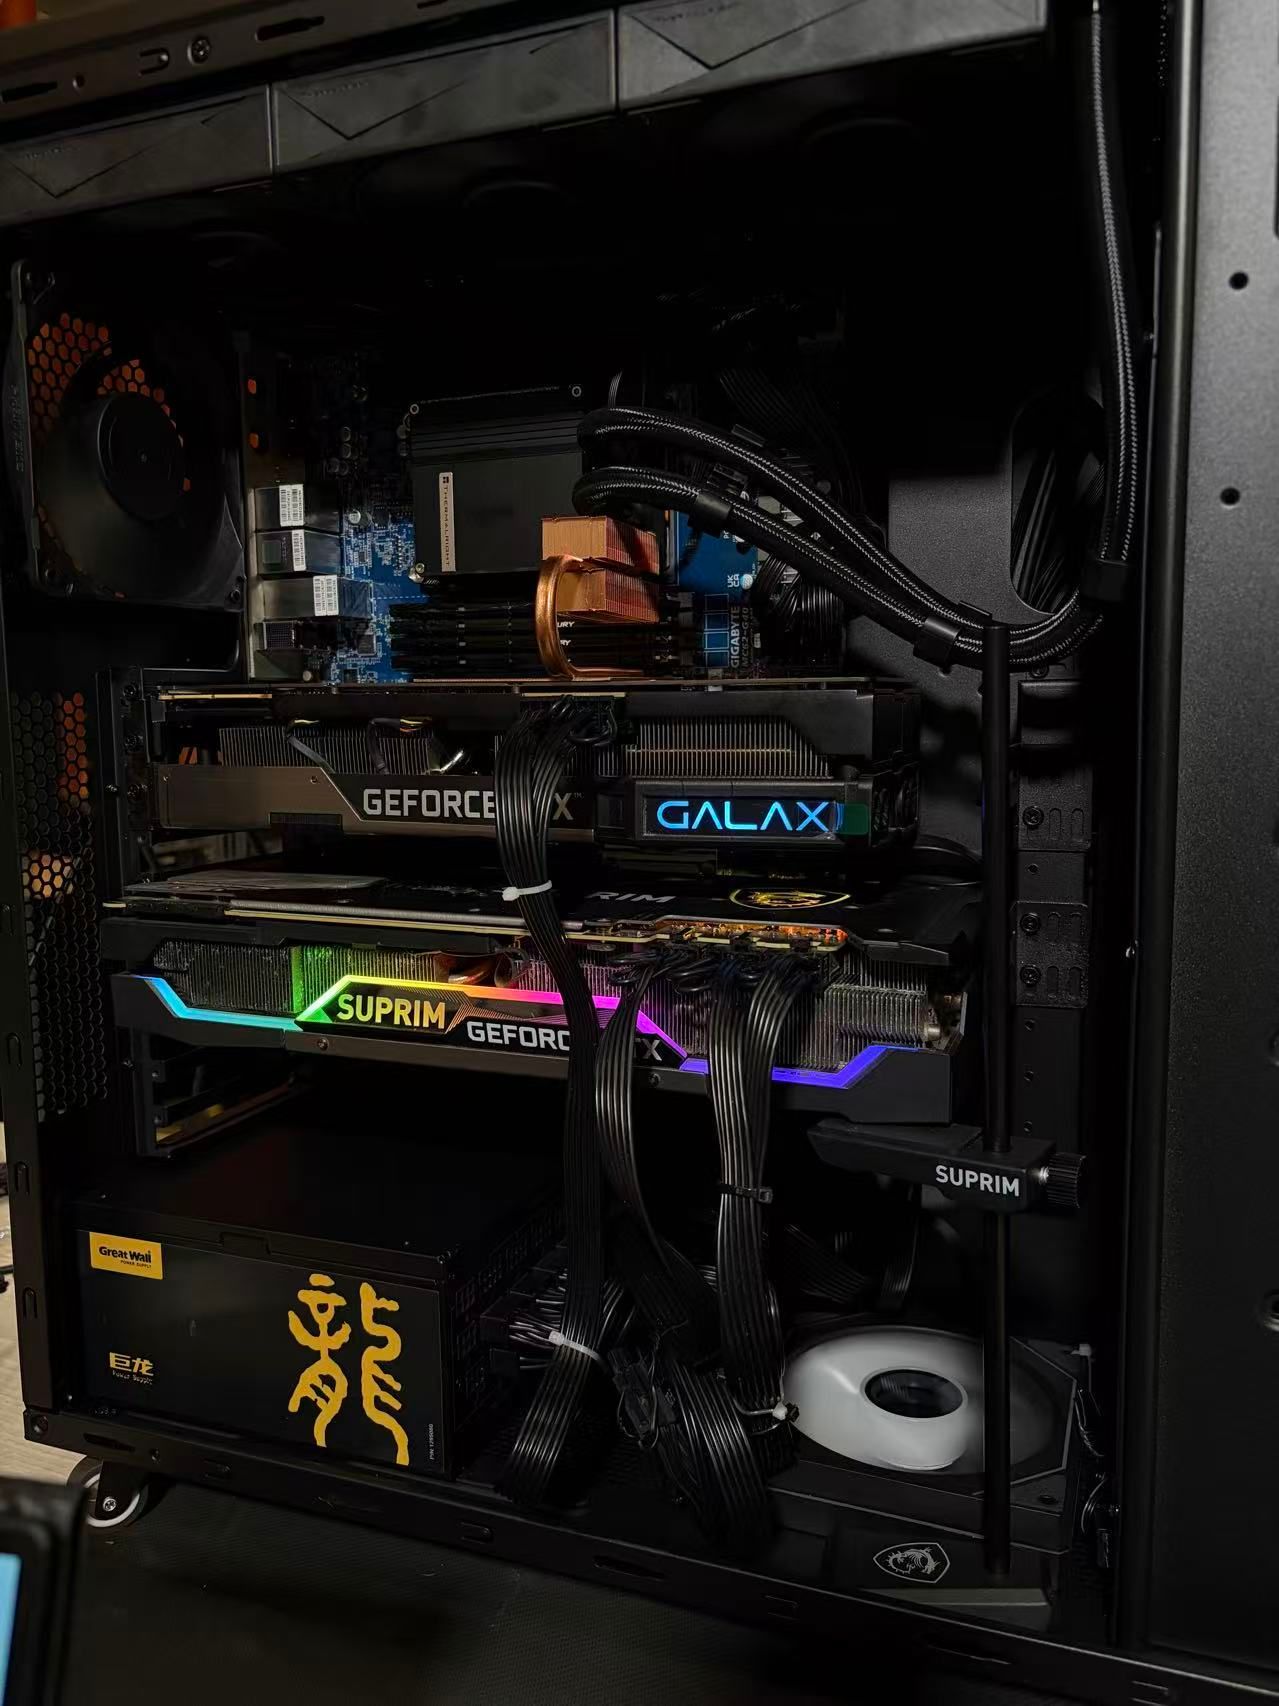
    电源是在本体淘的长城巨龙2000W(500元未拆封全新),显卡都在本地收上门收的,运气比较好成色都不错,一手,都有原盒。😍
    那时候价格还不错,影驰大将5000元收的,微星超龙5200元收的。😋

    👉老主机配置:
    🐱主板:Z390 AORUS PRO
    🐱CPU:9900KF Coffee Lake 8核16线程 5.0Ghz
    🐱内存:金士顿32G X 2 64G total
    🐱硬盘:1T M.2,机械盘6T
    🐱显卡:3090 X 2
    🐱电源:长城巨龙2000W

    🕹️那个时候,在本地能玩的模型还不是太多,能力也很惨,驱动个agent可能都搞不定。
    玩了
    Qwen:3-30B-A3B,32B,Coder-30B-A3B,VL-30B-A3B,2.5-72B Instruct
    Gemma 3 27B
    Mistral Small 3.1/3.2 24B
    GPT-OSS-20B
    Llama 3.3 70B

    😹我就是爱折腾!

    后来玩的不爽,觉得应该搞个PCIE4.0多插槽的主板,
    加上老主机被我拿去做了音频服务器🖥️(我主业是个调音师/音频工程师)🔊🎸🥁🎹🎛️🎤🎙️🎧🎼🎶。
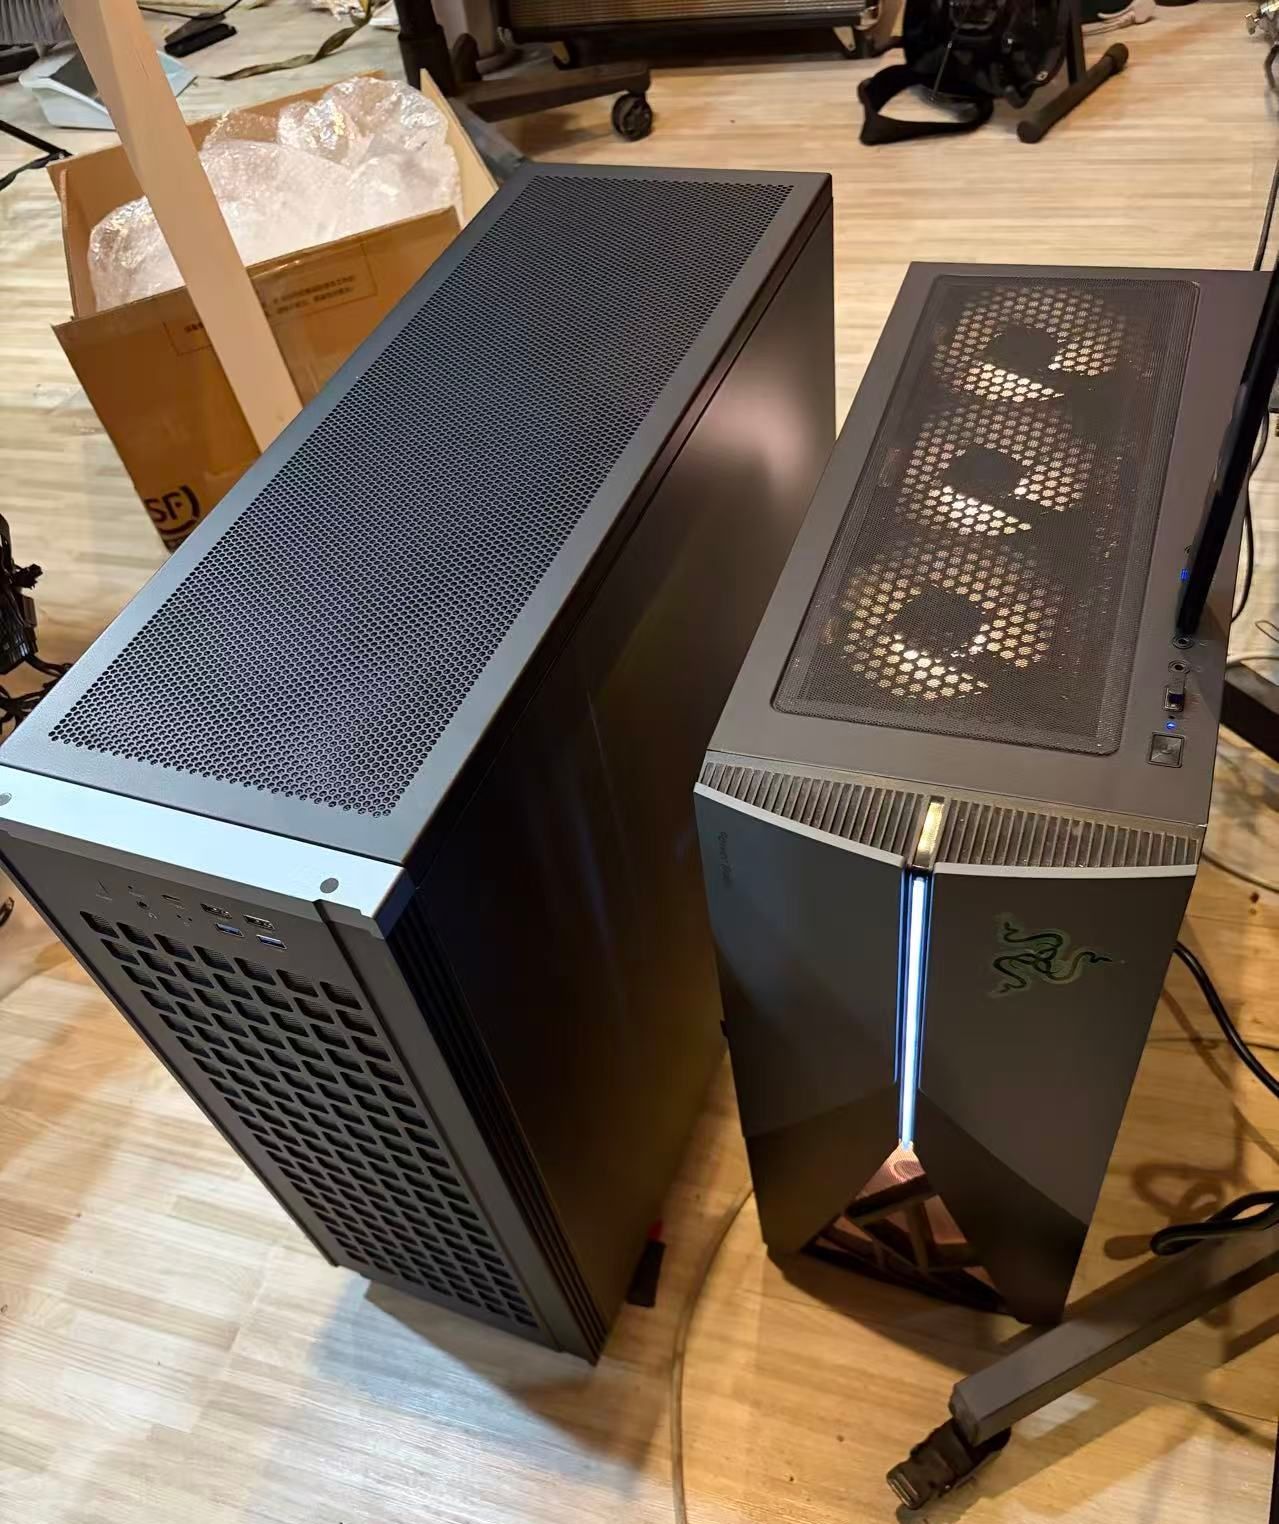
    新机箱买了全新的金河田9125b,确实大,和老机箱对比:
    dc6b114e0a463a1c711293a739768c18.jpg

    所以主板就上了技嘉MC62-G40(全新):
    8e9055ac73596eb277cacbe2c66419f4.jpg

    因为考虑到兼容音频处理的功能,CPU上了AMD 5965WX(全新),因为主频能到4.5Ghz。💫
    把2张3090显卡和电源都搬过来了!👌
    又闲鱼淘了一张影驰大将,这时候涨到了6000多接近7000!
    然后把内存直接换成了镁光DDR4 1RX4 3200MHZ 32G X 8 256G total🍻

    👉换服务器平台配置:
    🐱主板:MC62-G40
    🐱CPU:AMD 5965WX 24核48线程 4.5Ghz
    🐱内存:镁光DDR4 1RX4 3200MHZ 32G X 8 256G total
    🐱硬盘:1T X 2 M.2,机械盘8T
    🐱显卡:3090 X 3
    🐱电源:长城巨龙2000W
    🐱机箱:金河田9125b
    🕹️这个阶段可玩的模型就多起来了,能力也飞升,干了好多活。
    Qwen:3.6-27B,3.6-35B
    Gemma:4 26B-A4B,31b,12b
    DeepSeek V4 / V4-Flash:Q2(CPU跑)
    ACE 1.5
    Wan 2.1 / Wan 2.2
    LTX-2 / LTX-2.3

    💥不得不说这便宜没好货啊(但是我买的全新啊),也可能是我运气不好🥺,这主板用了2个月不到挂了,返厂维修之后,CPU和主板都卖了😣。

    😹我就是爱折腾!

    然后就又折腾了现在的配置:
    内存,显卡,电源,硬盘都搬过来

    👉服务器平台二配置:
    🐱主板:MZ32-AR0 Rev3.0
    🐱CPU:AMD EPYC 7R13 48核96线程 3.6Ghz
    🐱内存:镁光DDR4 1RX4 3200MHZ 32G X 8 256G total
    🐱硬盘:1T X 2 M.2,机械盘10T
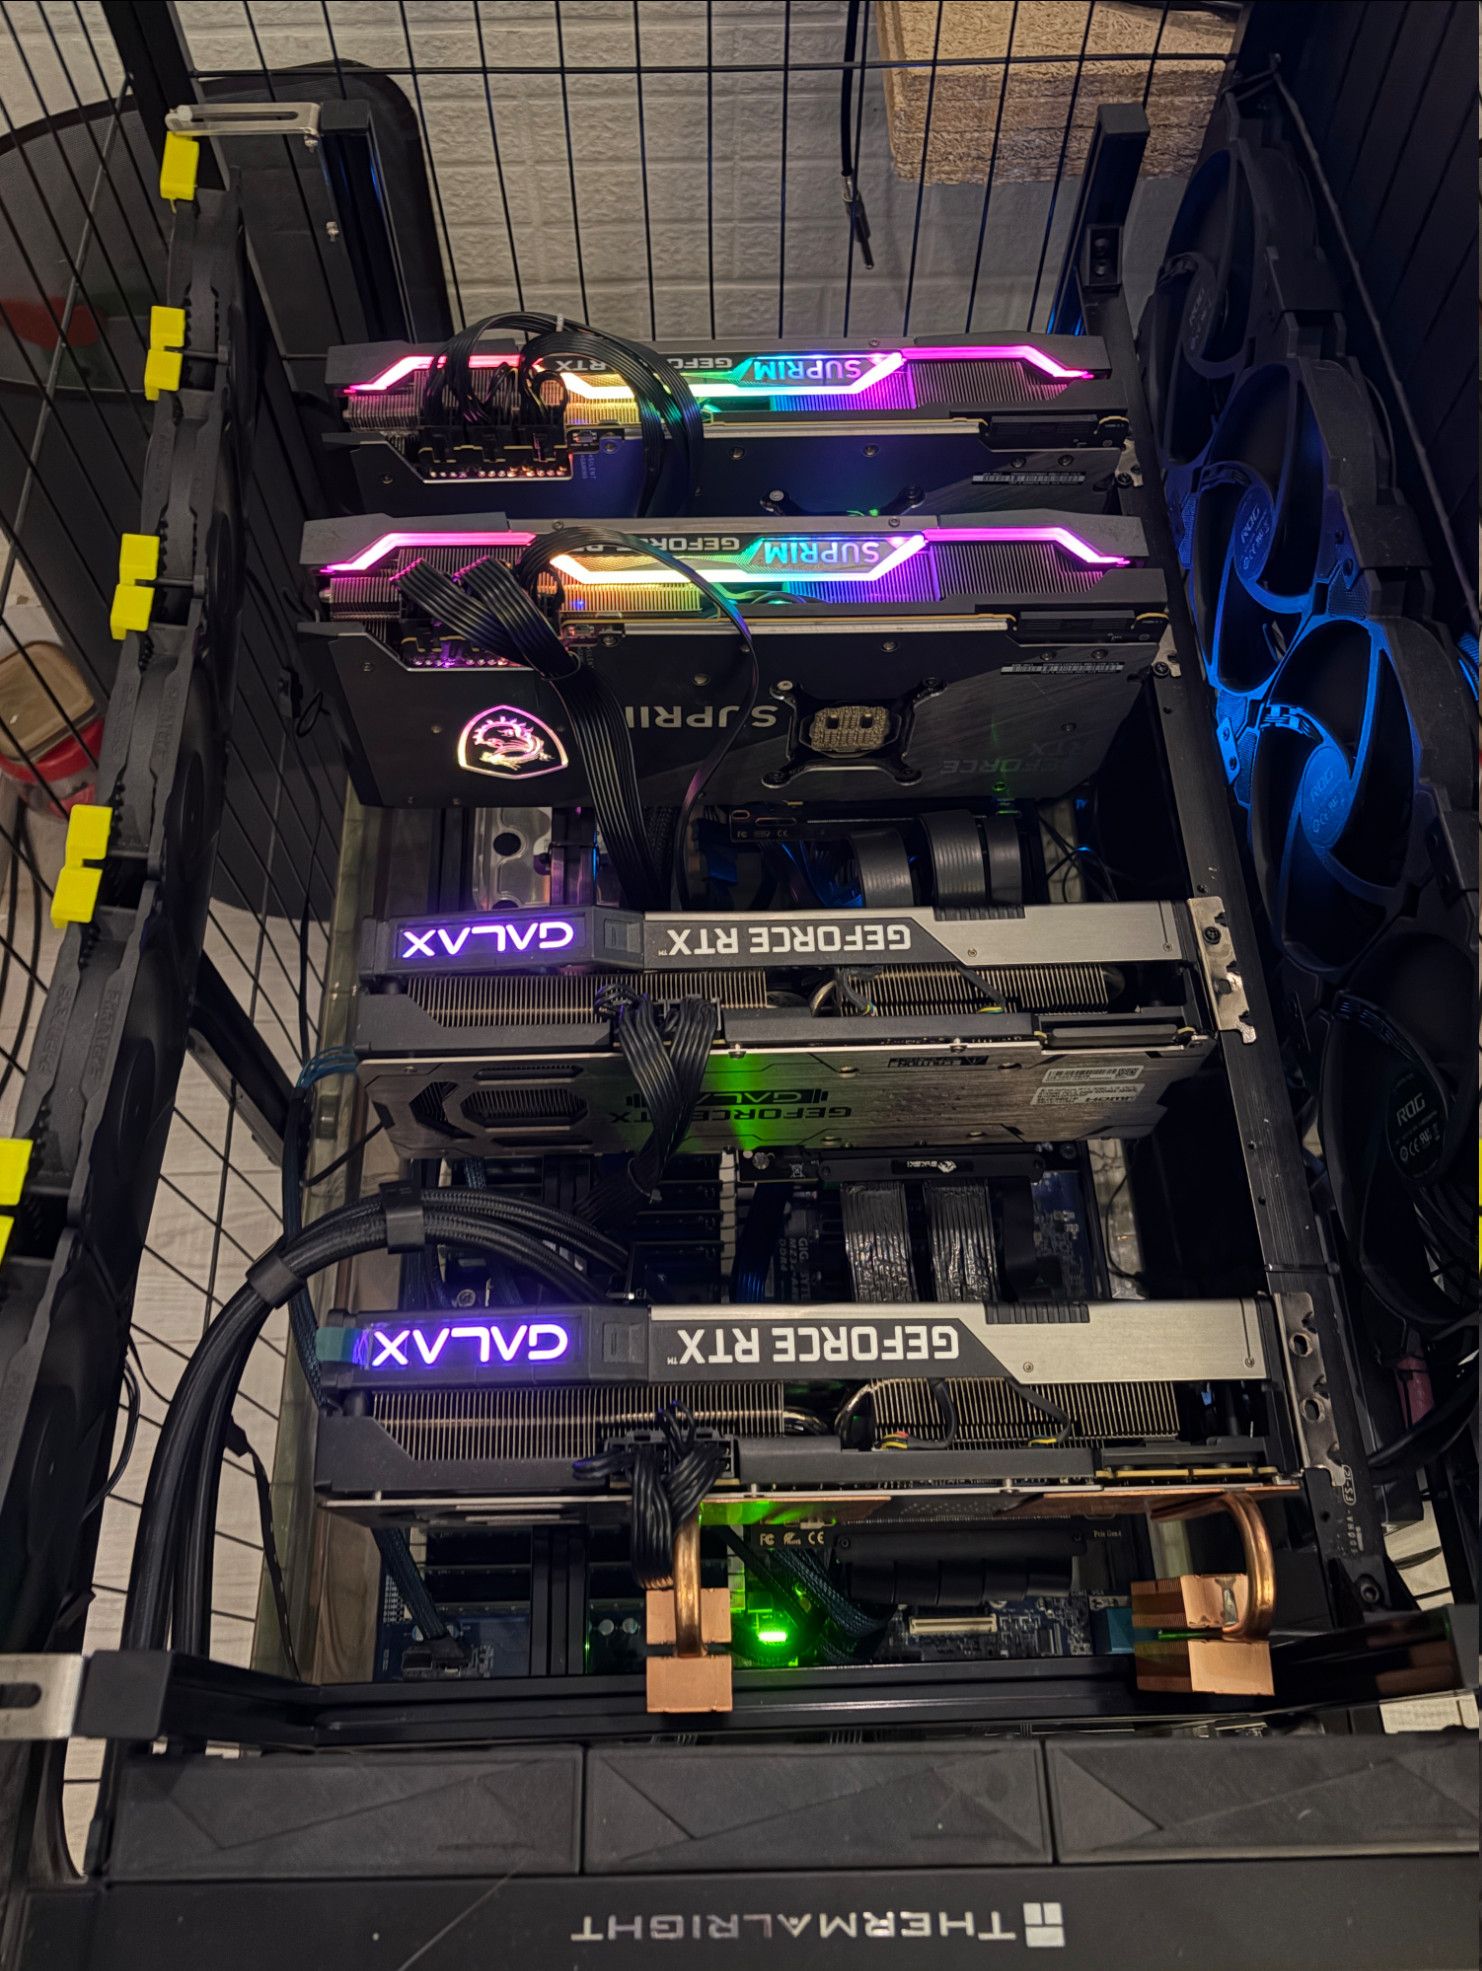
    🐱显卡:3090 X 4
    🐱电源:长城巨龙2000W(依然稳)
    7b78a67259792b98d2ec3390ac360df2.jpg

    🤷这AMD EPYC 7R13是亚马逊啊各种头部大厂淘汰下来的U,一般没人想得到,
    但是有一天我和Hermes(用的美团LongCat 2.0模型)探讨的时候,🎰
    这模型居然帮我对比出来了这颗U,性价比极高!😱
    到手48核96线程 3.6Ghz,Cinebench R23多核跑分13766(单核不用看了才3.6Ghz),多核性能居然超过了M3 Ultra!💨
    为了玩的更爽,语言模型,生图生视频,音乐生成都可以同时跑,🤞
    我又闲鱼买了最后1张显卡微星超龙,这时候价格来到了8000上下,最终7800成交的。状态不错,原盒原码。🤠

    于是新的问题来了!😲机箱金河田9125b,之前以为能容得下多卡,🤓
    可是3卡就已经几乎没空间散热了,显卡贴着显卡,并且PCIE4.0插槽和显卡完全对不上!😭
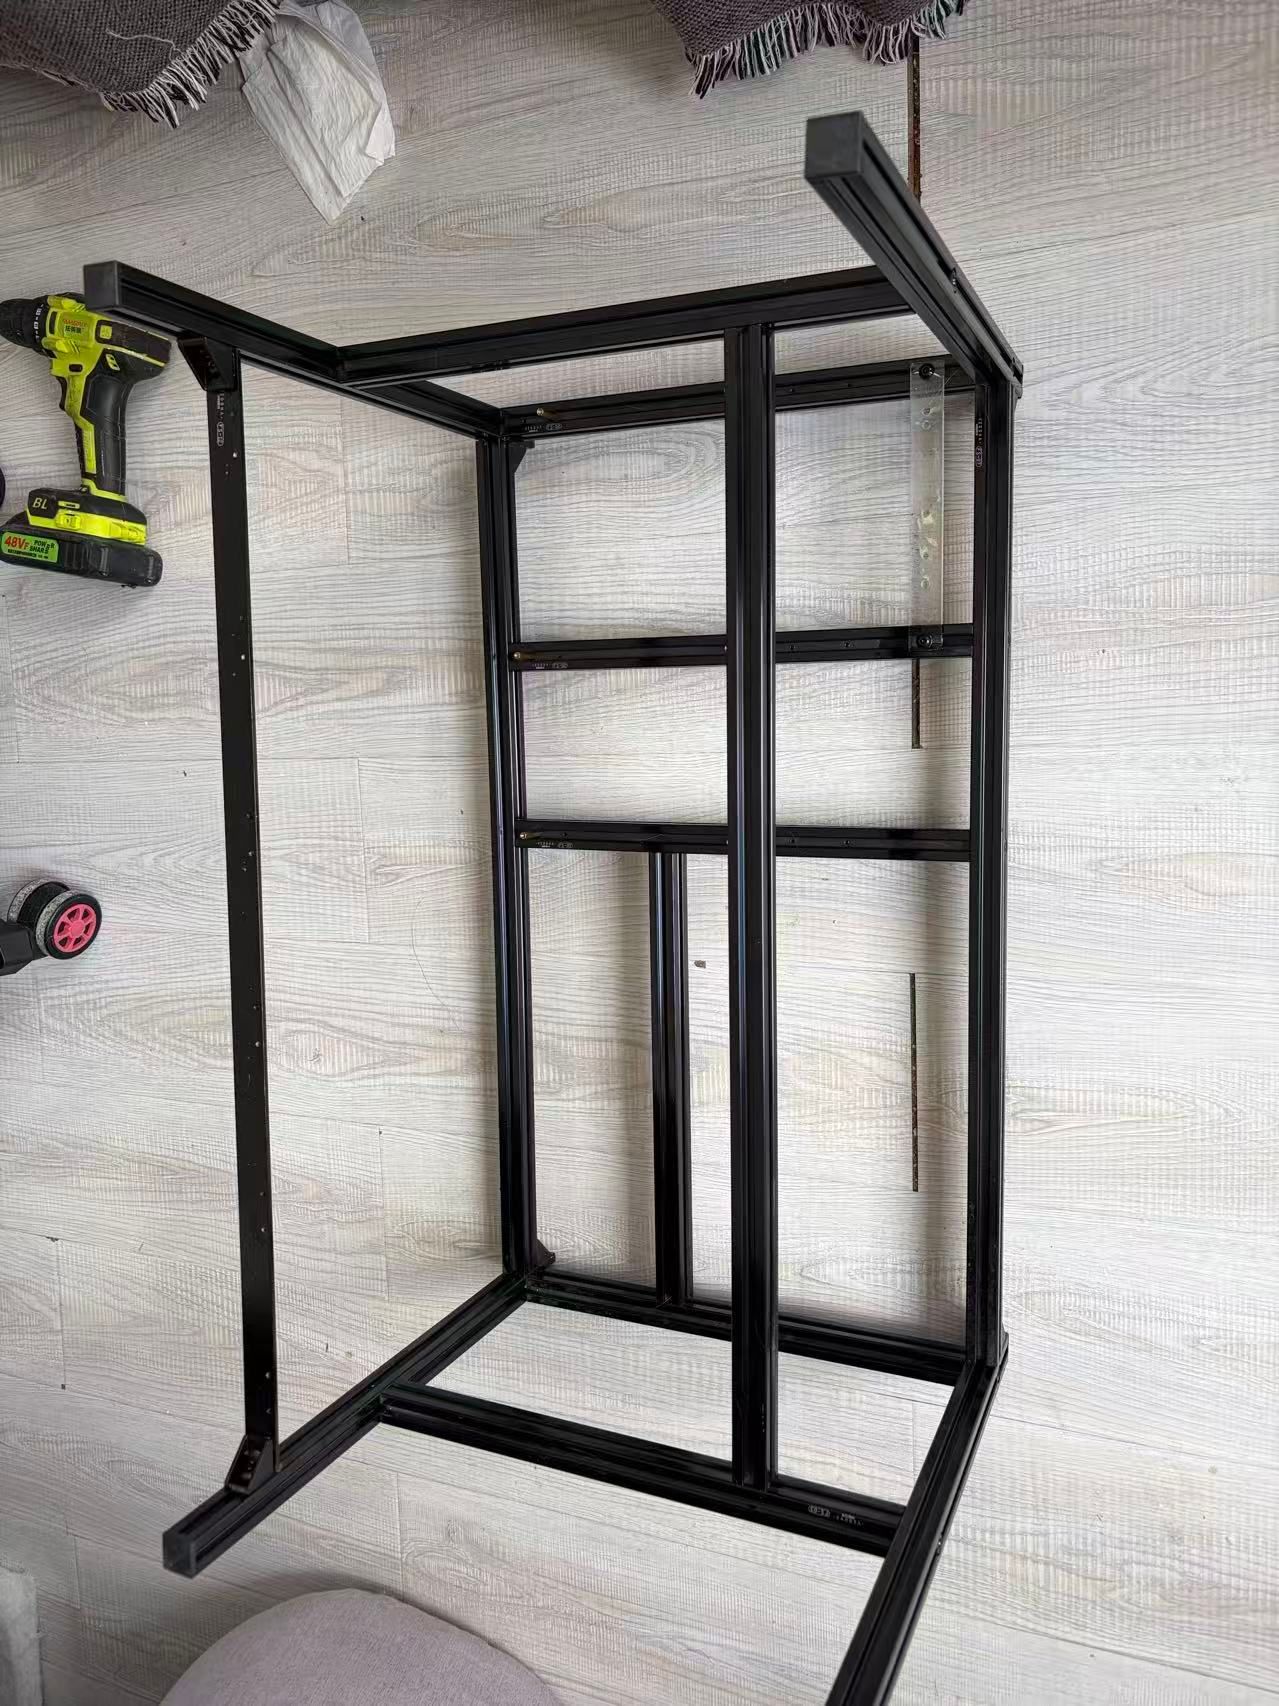
    最终总结出了:多卡的尽头是矿架!的思想感情......🕳️

    😹我就是爱折腾!

    还好动手能力这方面,轻松拿捏!🫰
    24cf12fe75fc381522cf031b48b3c10c.jpg

    150块钱在本地找一个以前挖矿的老哥淘的veddha矿架。🎲
    这老哥还问我:现在又能挖矿了?🤦‍♂️

    16f418e0b467c177f71106d17a8cfd22.jpg

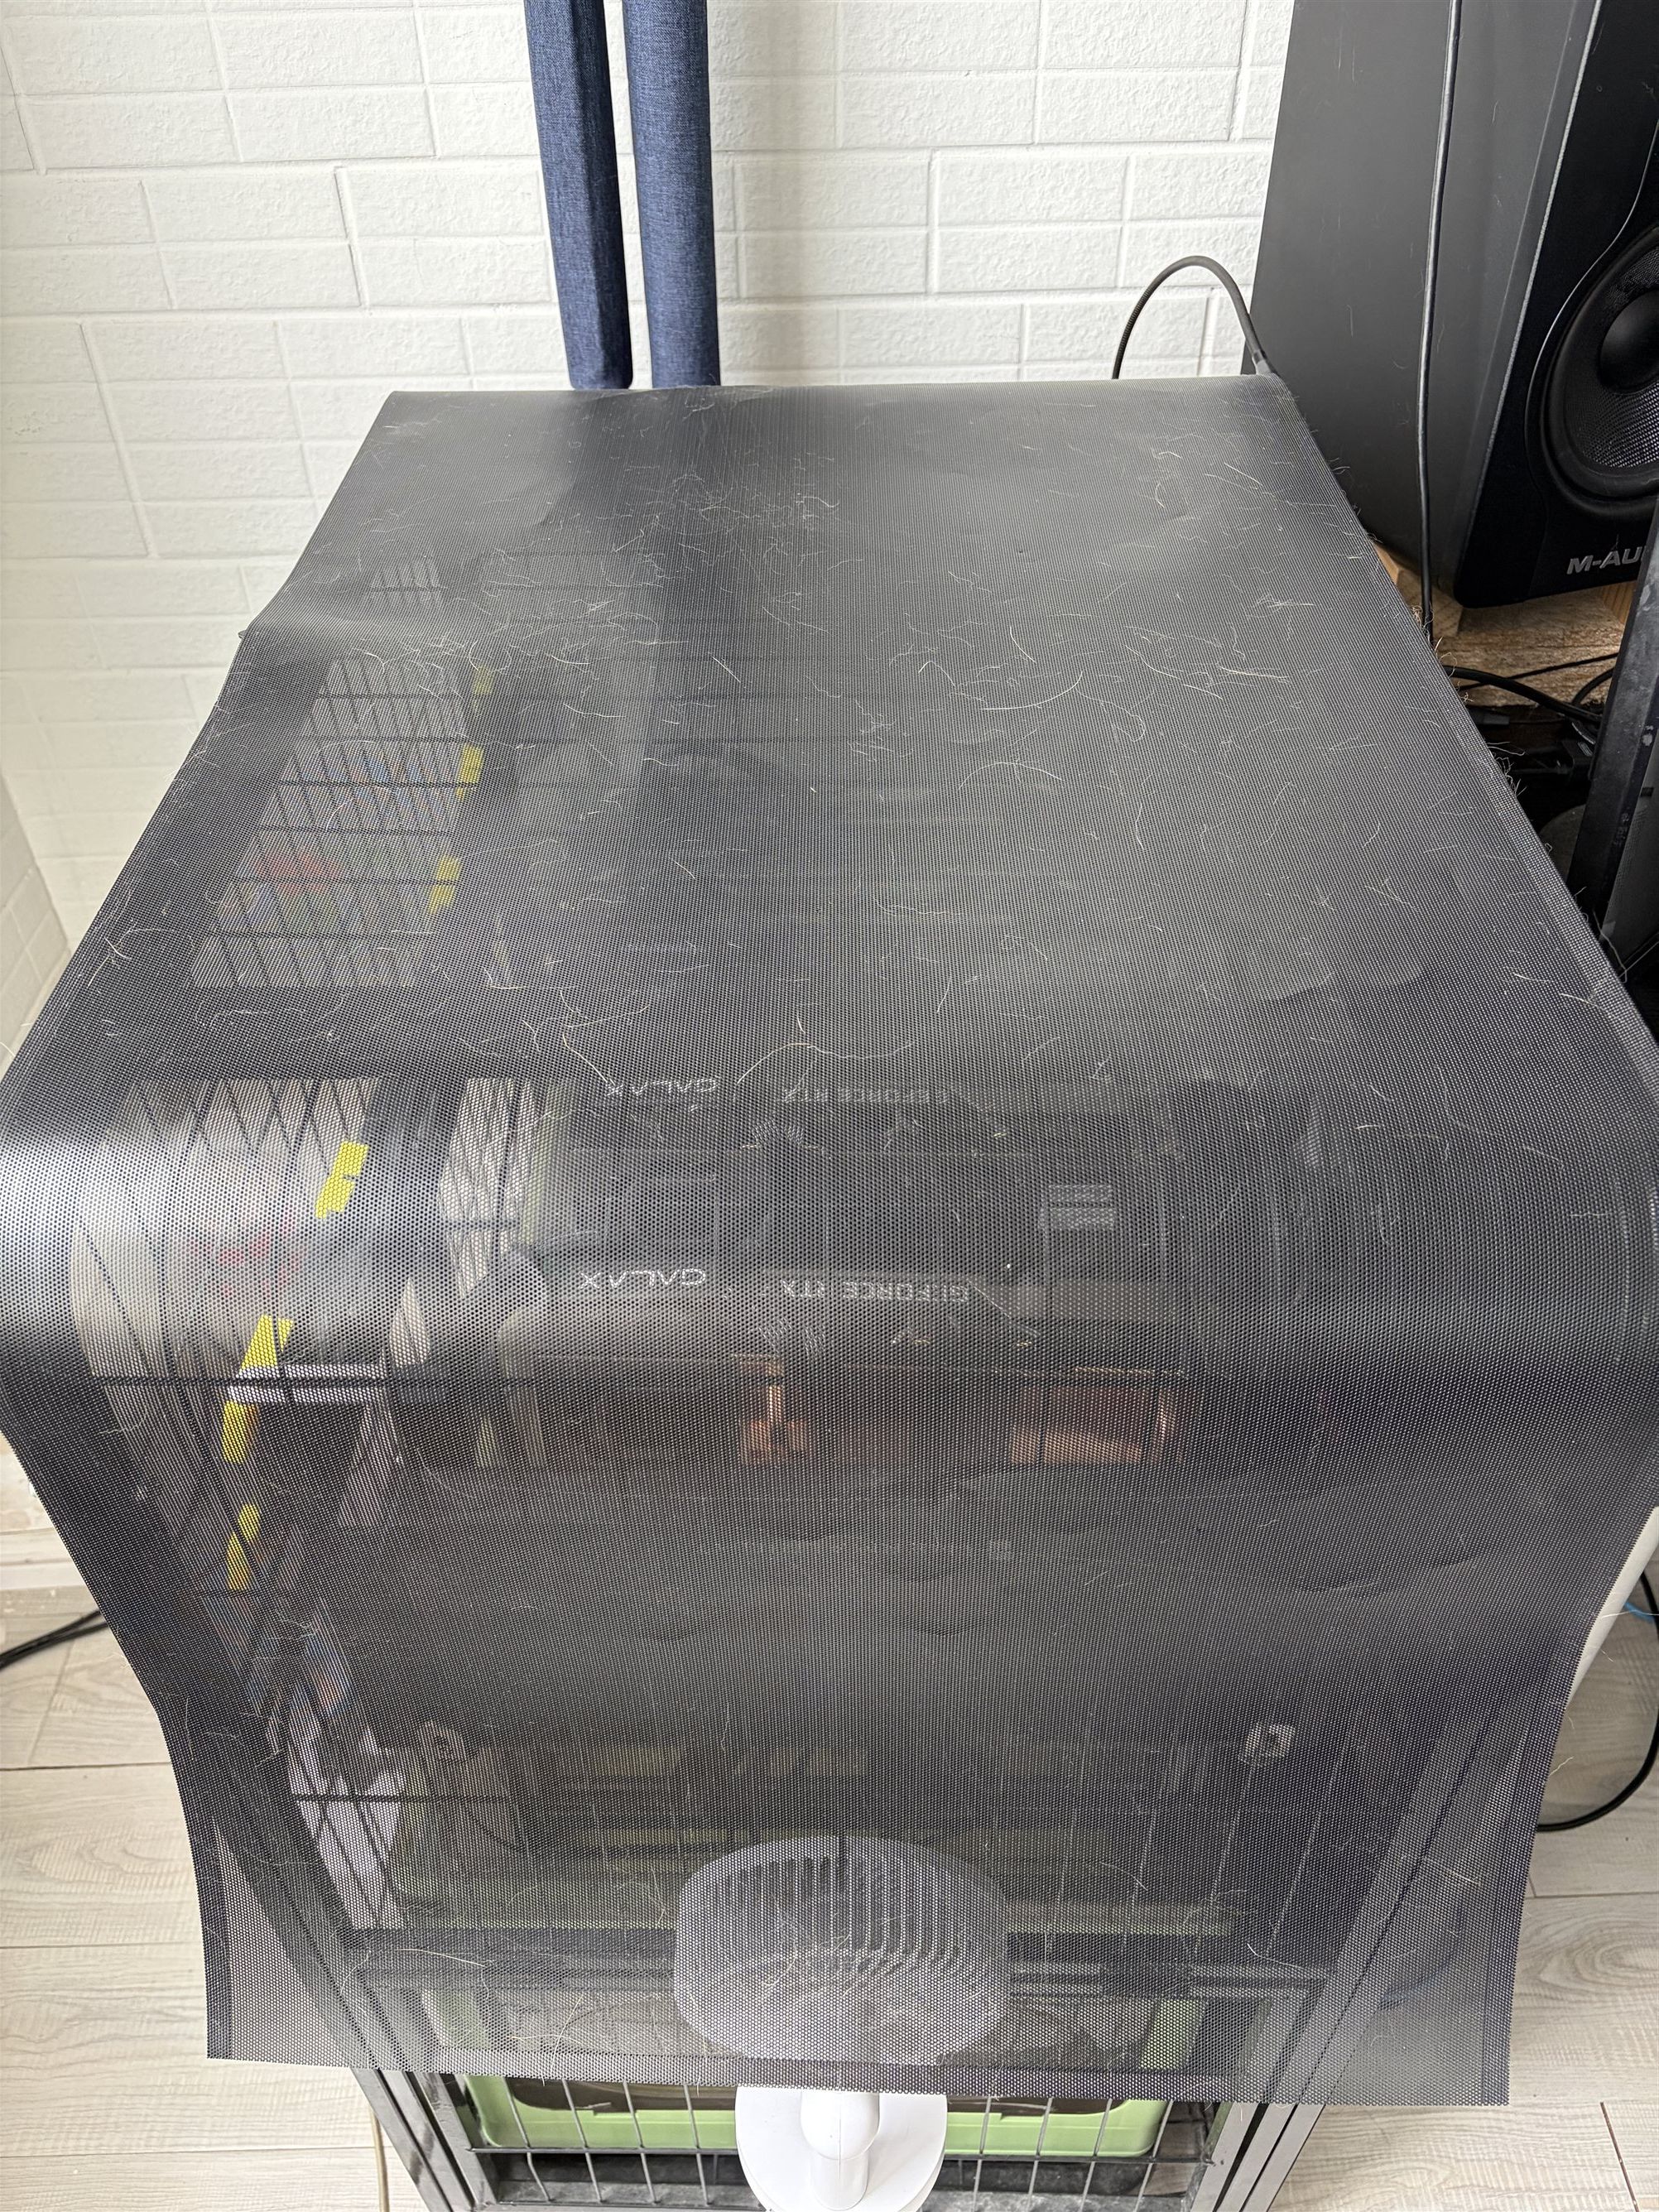
    因为家里面猫多,😼😼😼猫和猫毛满天飞,所以如果开放式矿架=自毁。💩
    你看这毛量,如果不是又根据猫笼尺寸淘宝定制了防尘网,那么又得折腾了!🤷‍♂️

    4b2cccfd4a0239869a0f4ed550763400.jpg

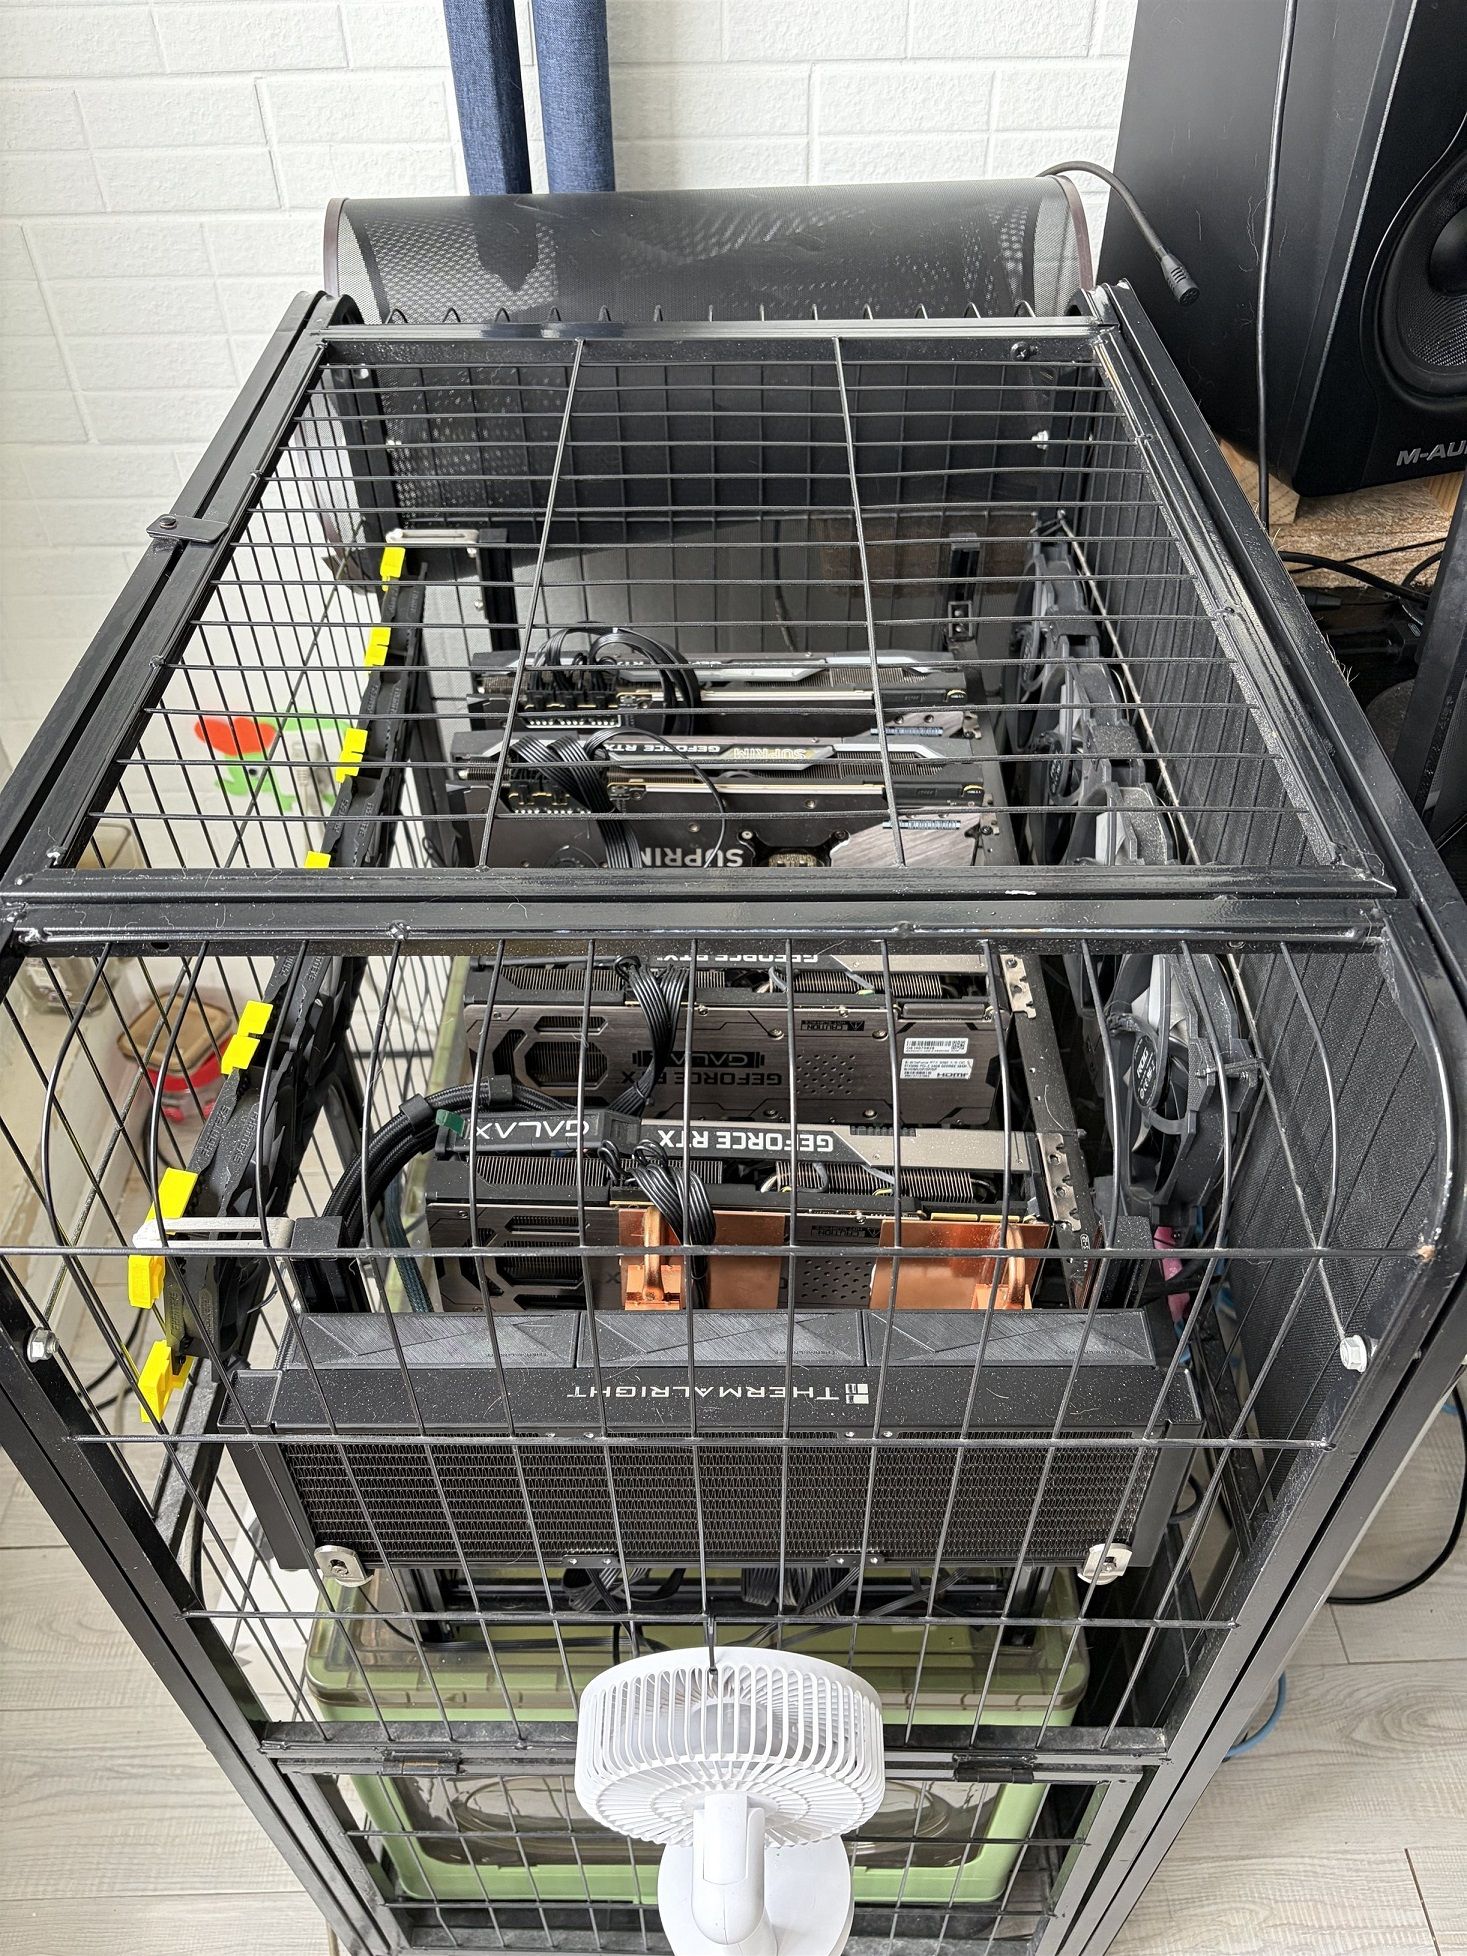
    而且本来家里就闲置一个大号猫笼,所以就把整个机器放进猫笼里了。♻️

    a65150ebe6d18f3ae444918dd38bb11a.jpg

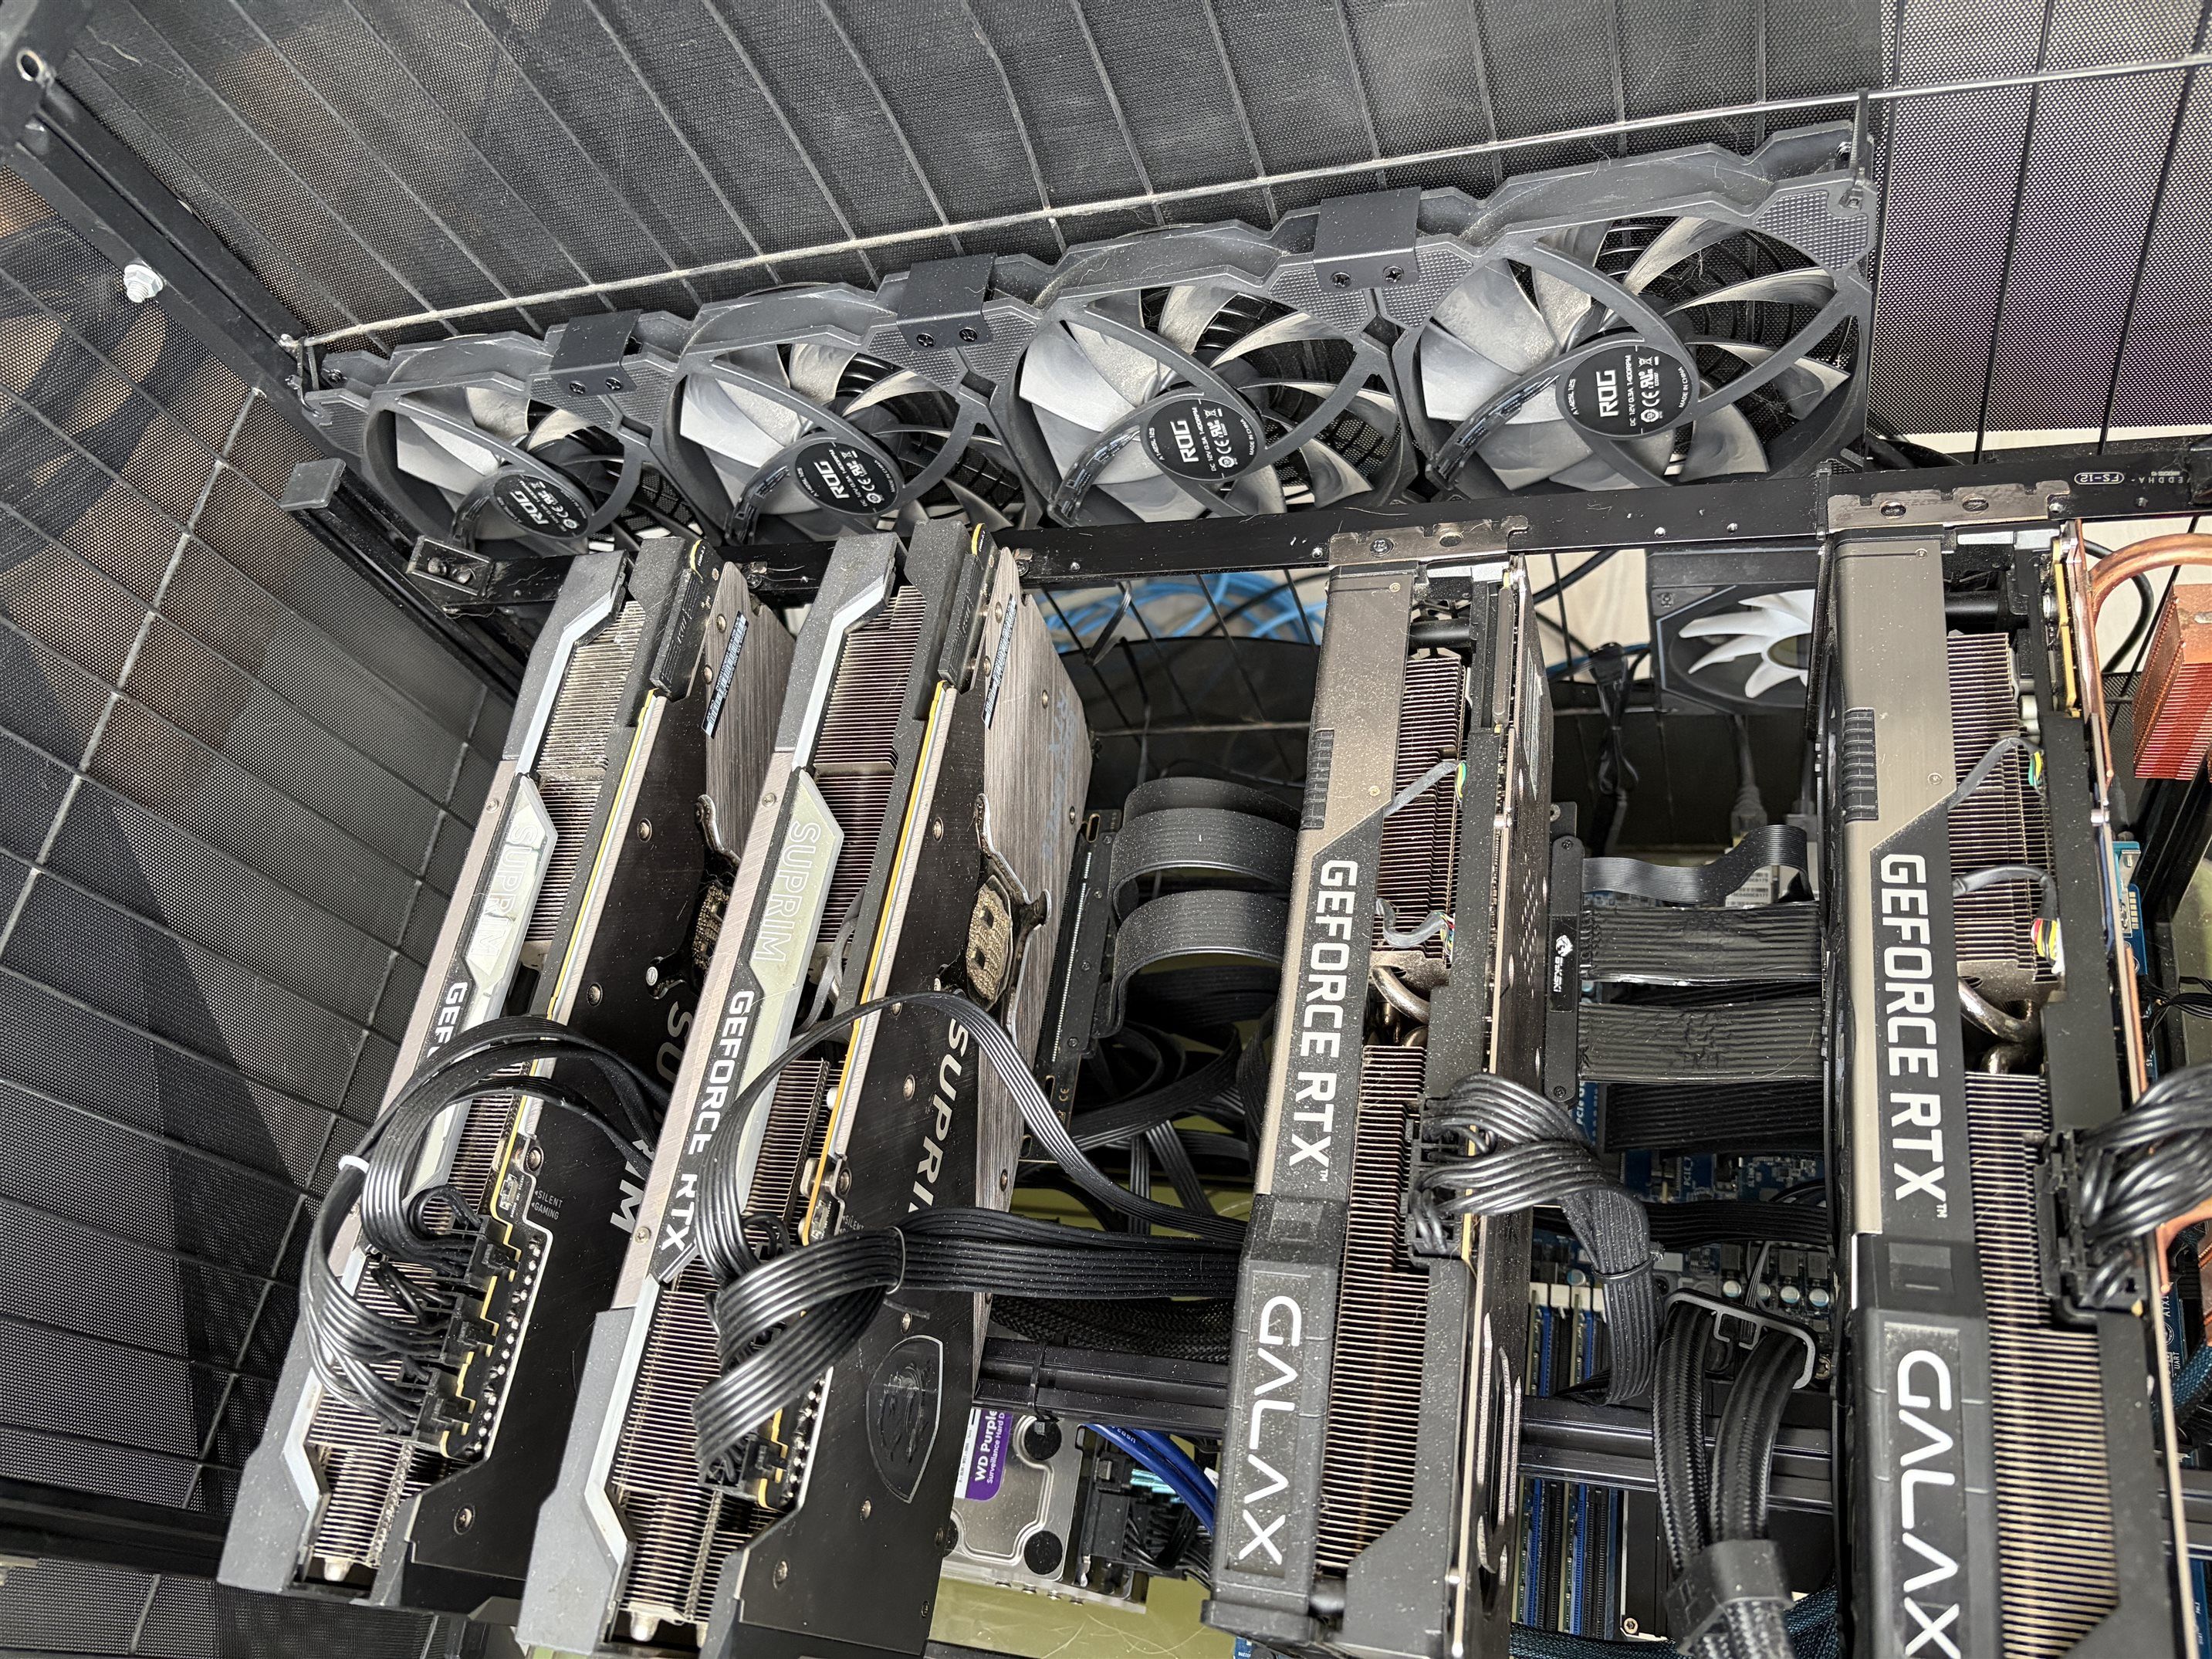
    散热风道设计是从右到左,右边4个本地淘的便宜二手14cm PWM风扇(15一个买的),用金属连接件组装到了一起,进风⬅︎
    左边是veddha矿架自带的5个12cm PWM风扇,用塑料连接件组装到了一起,出风⬅︎

    a7fff4db2085a86515e9e2153414411e.jpg

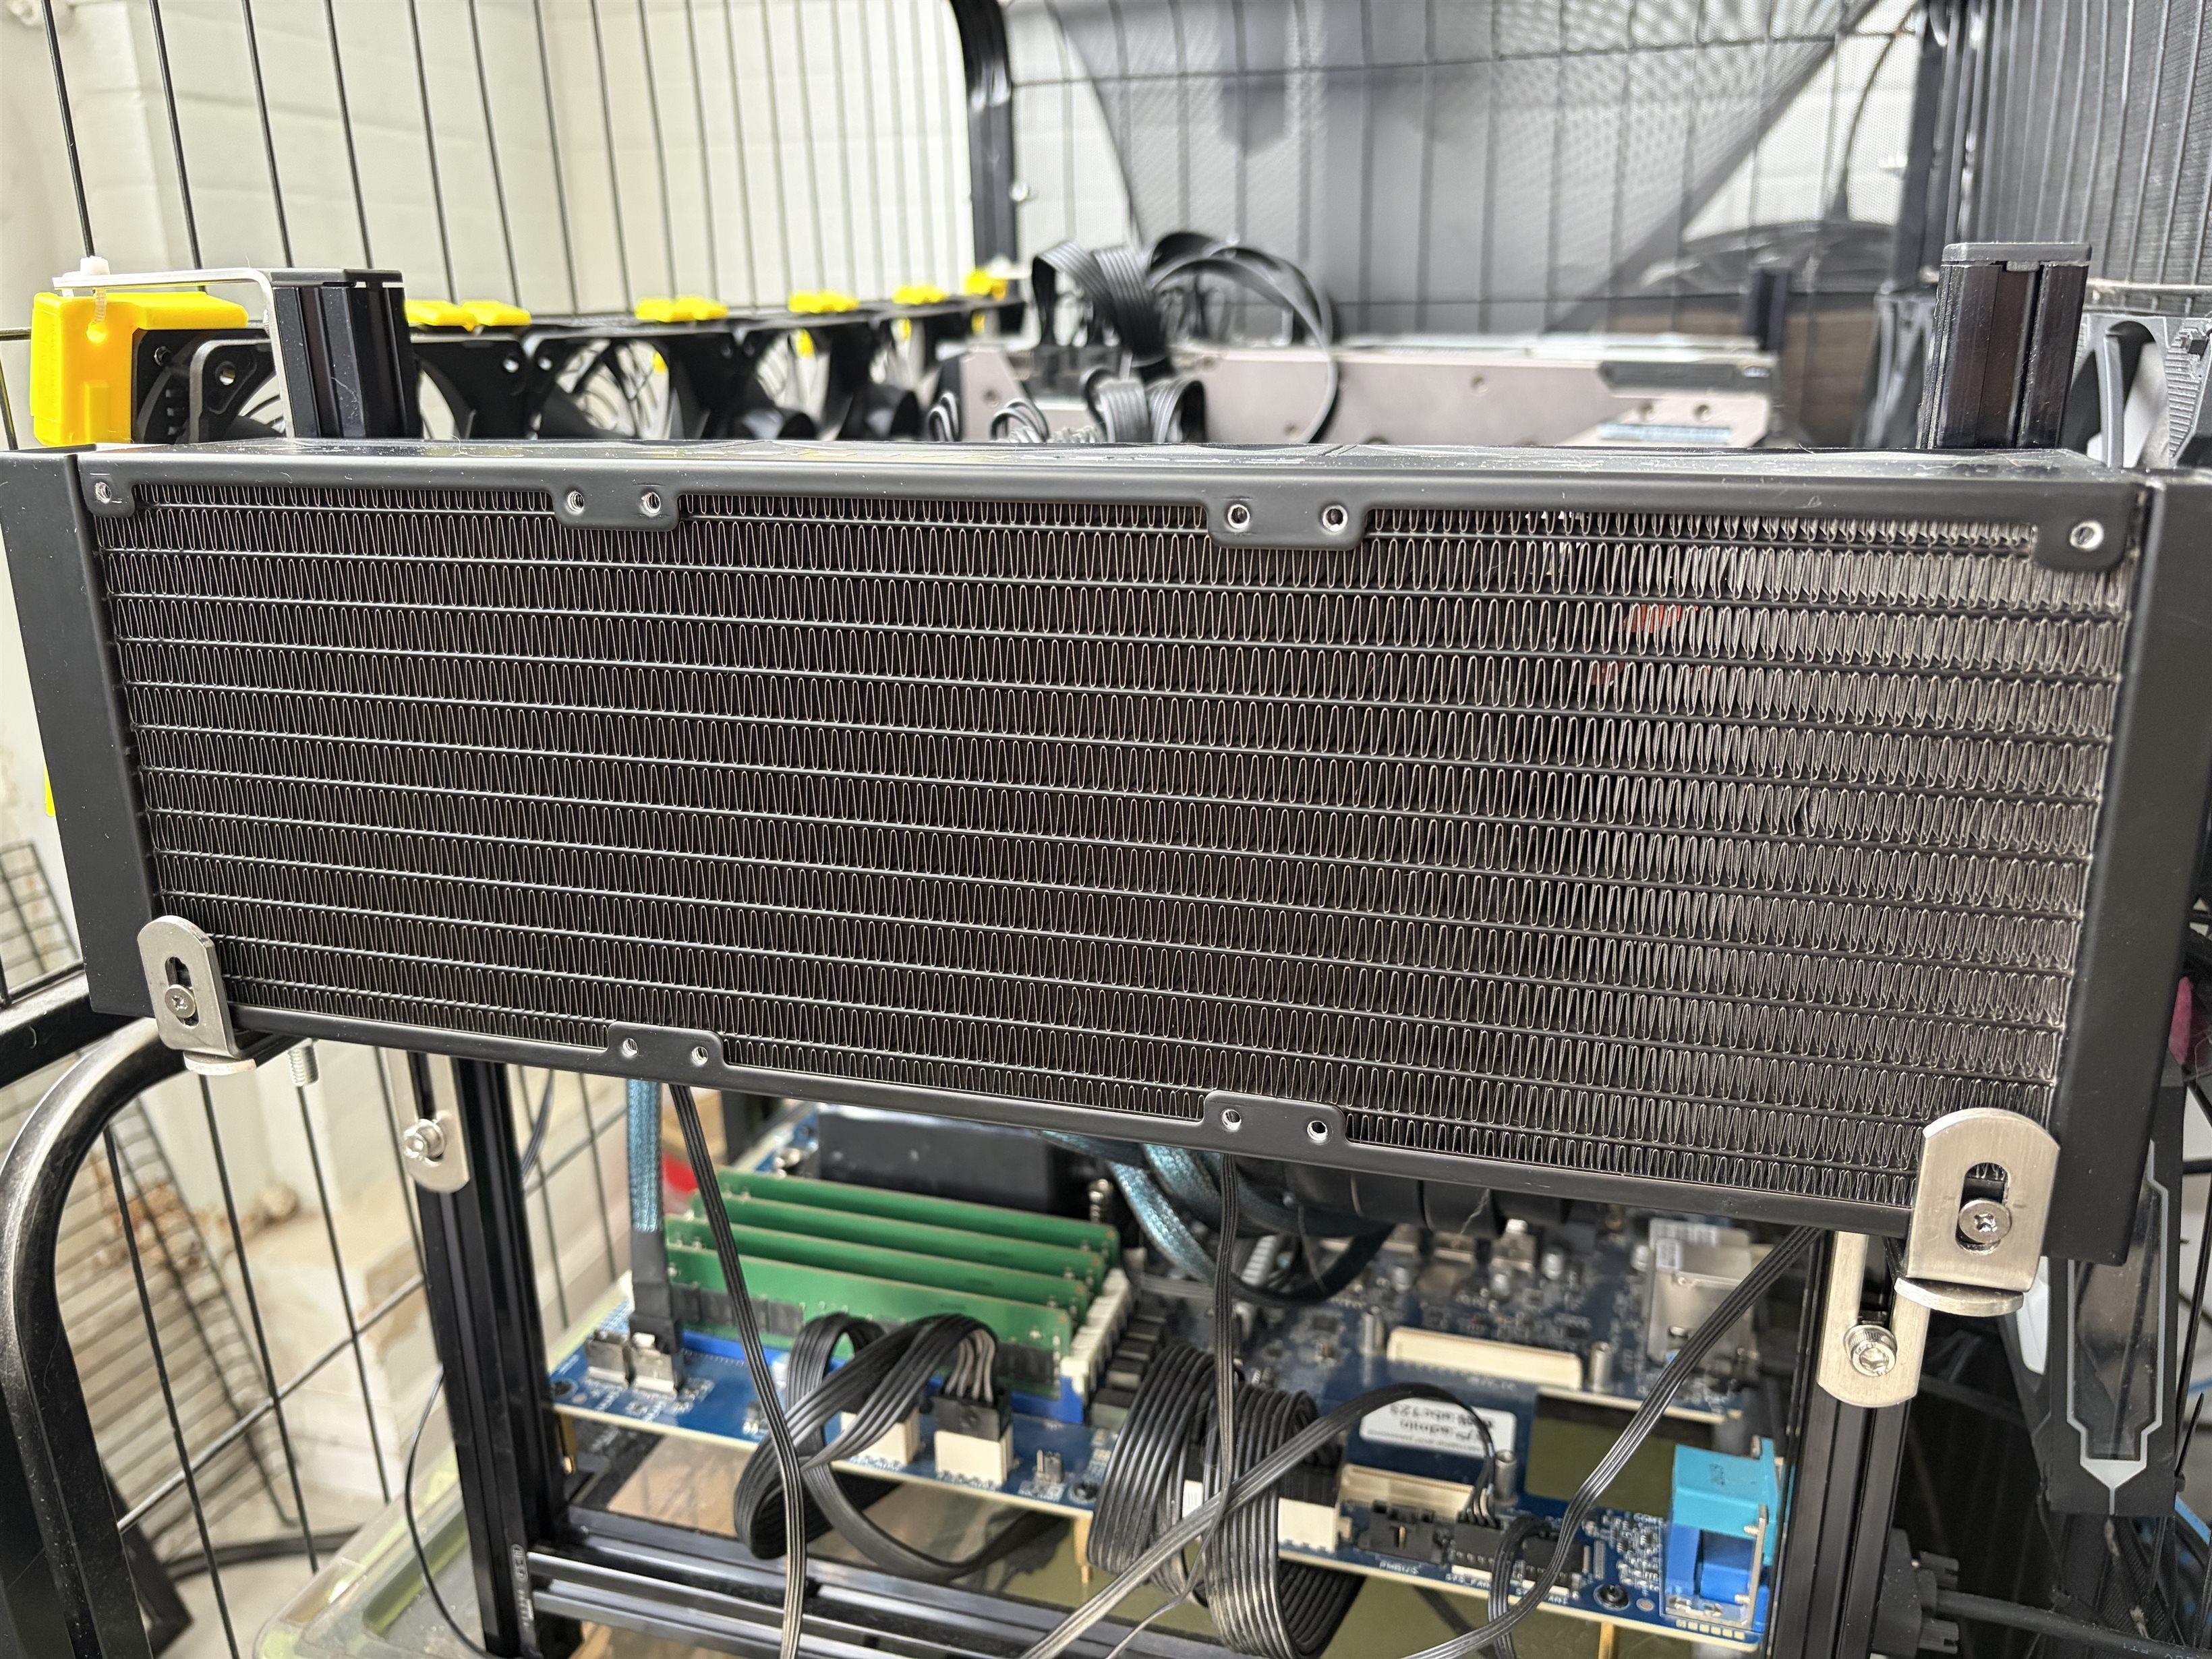
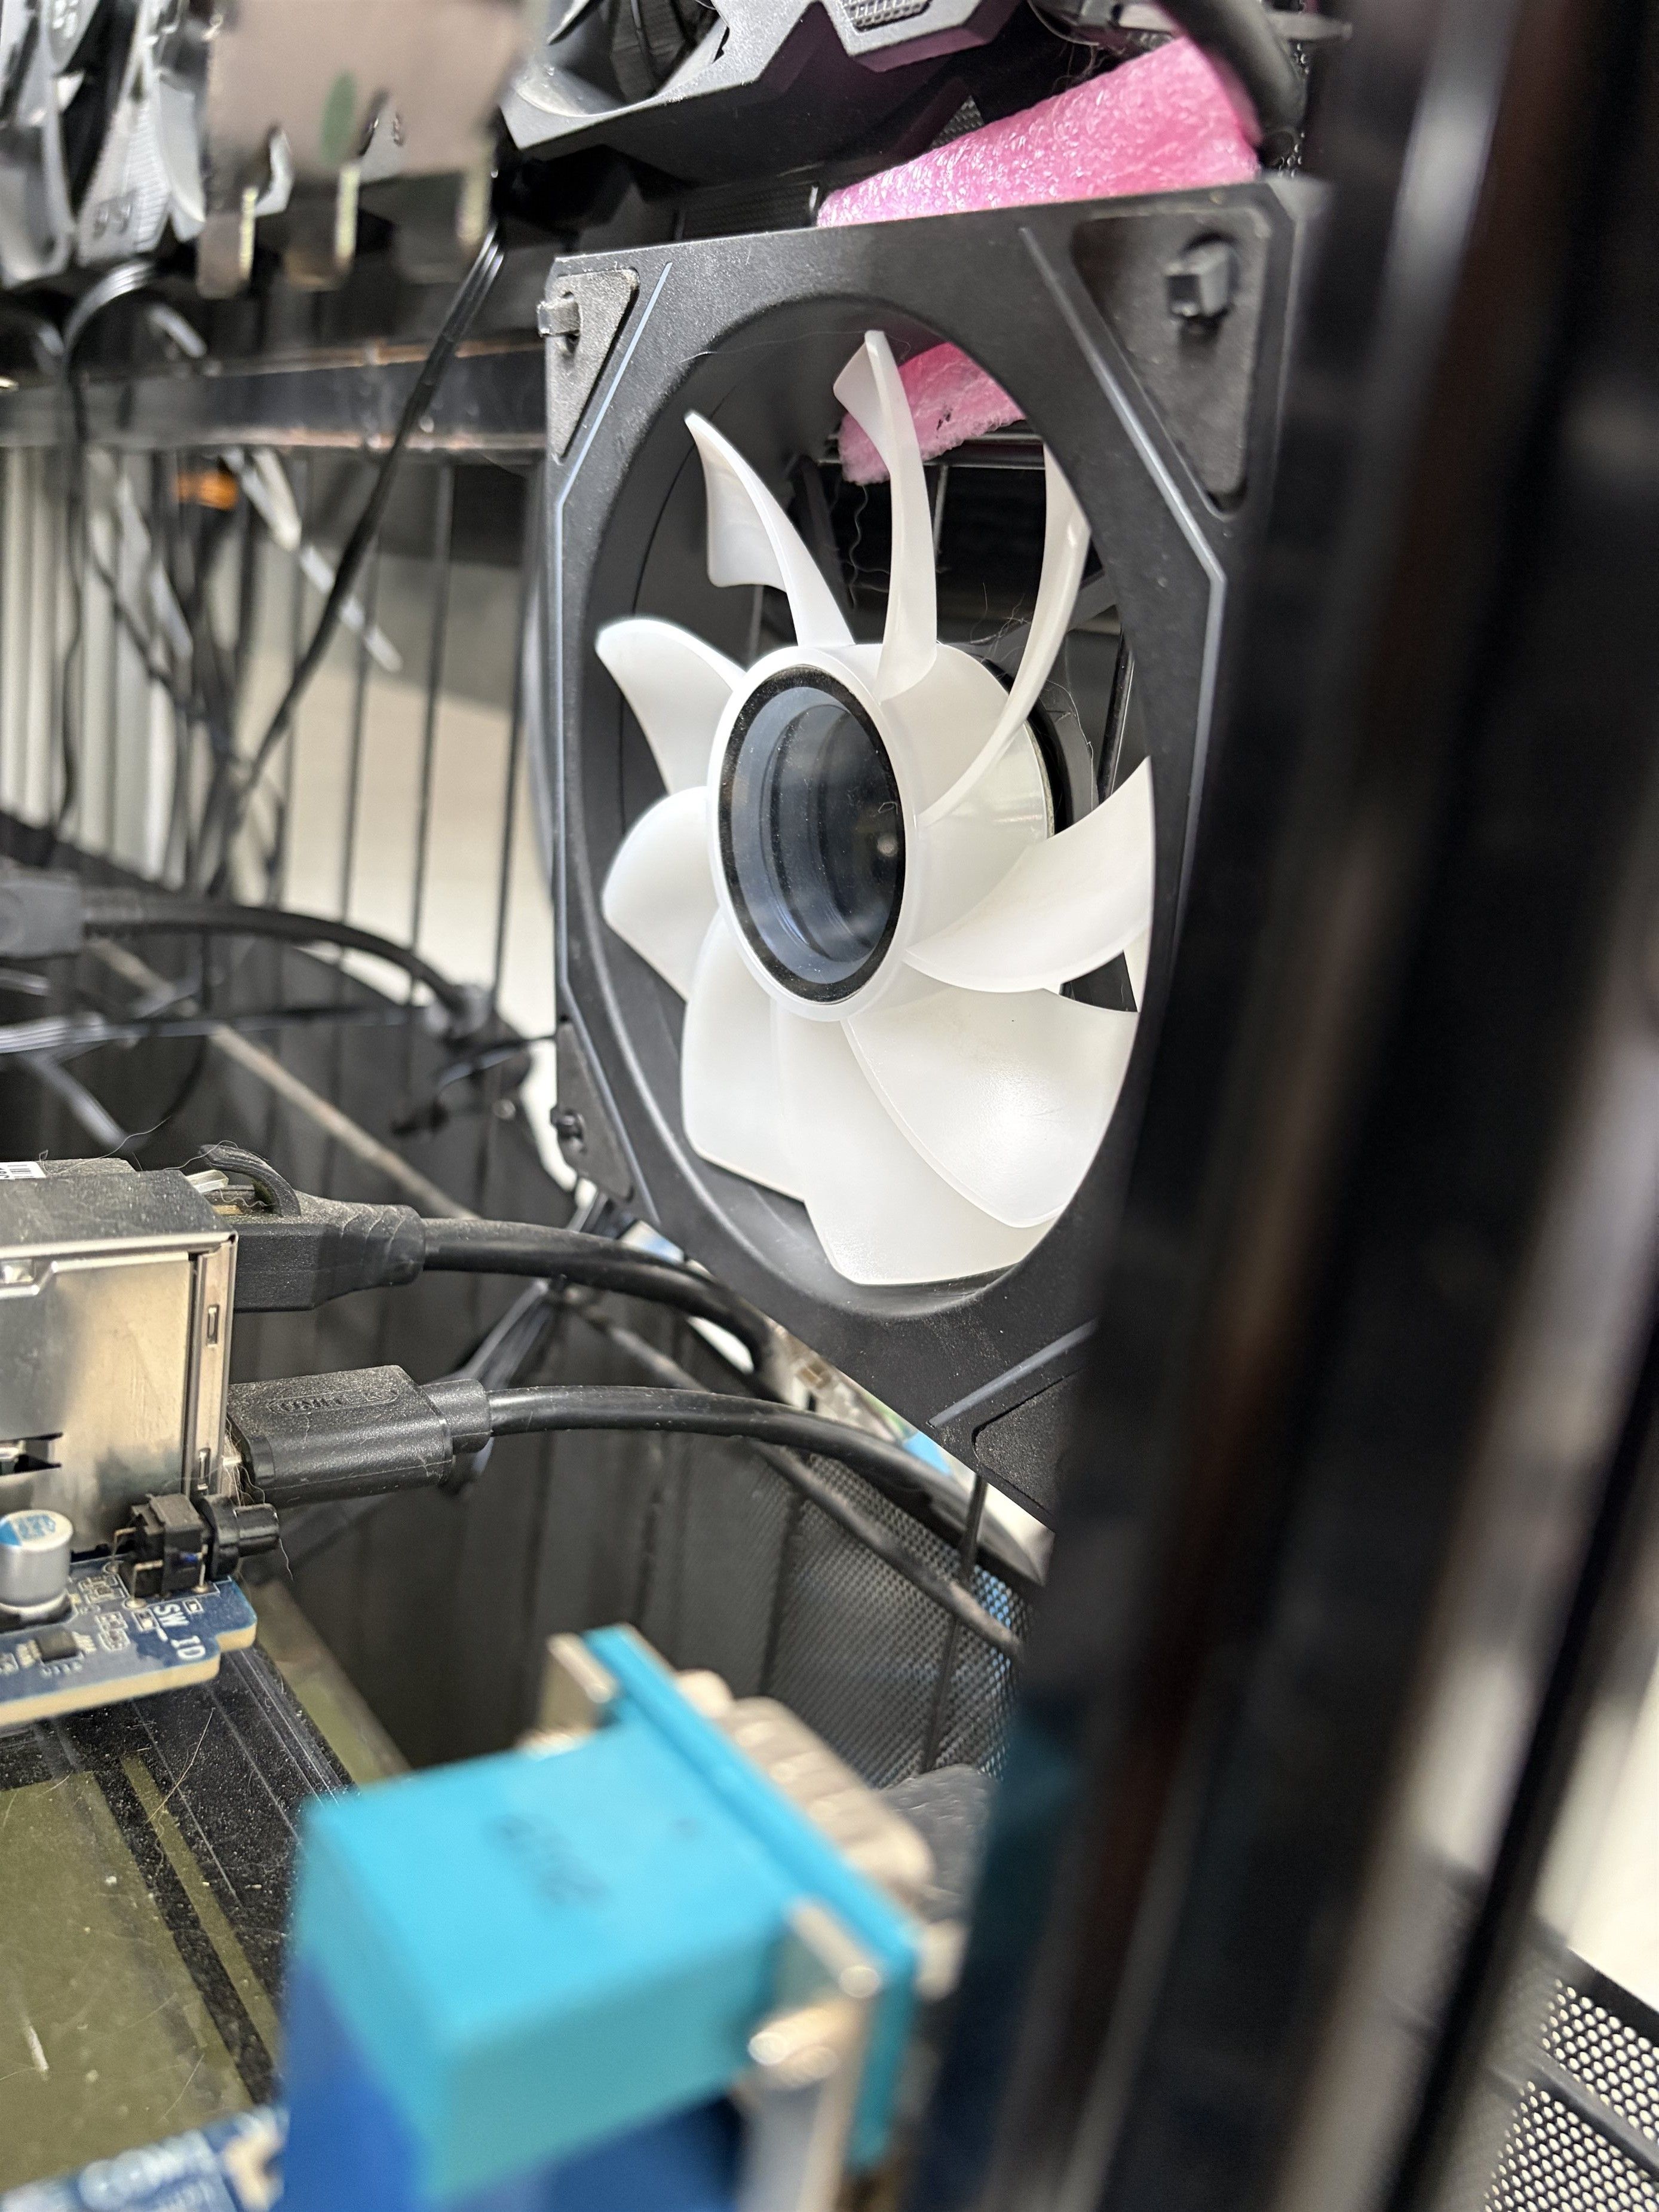
    CPU的冷排风向往正前方出⬇︎

    因为这块主板的CPU供电散热部分特别容易高温,如果没有专门的风向对着它吹,有的时候温度可以高达90°以上!🕳️又是个坑!

    eb49d2e21c8033c594275414564be017.jpg

    专门一个12cm风扇对着它吹,现在不超过50°😂

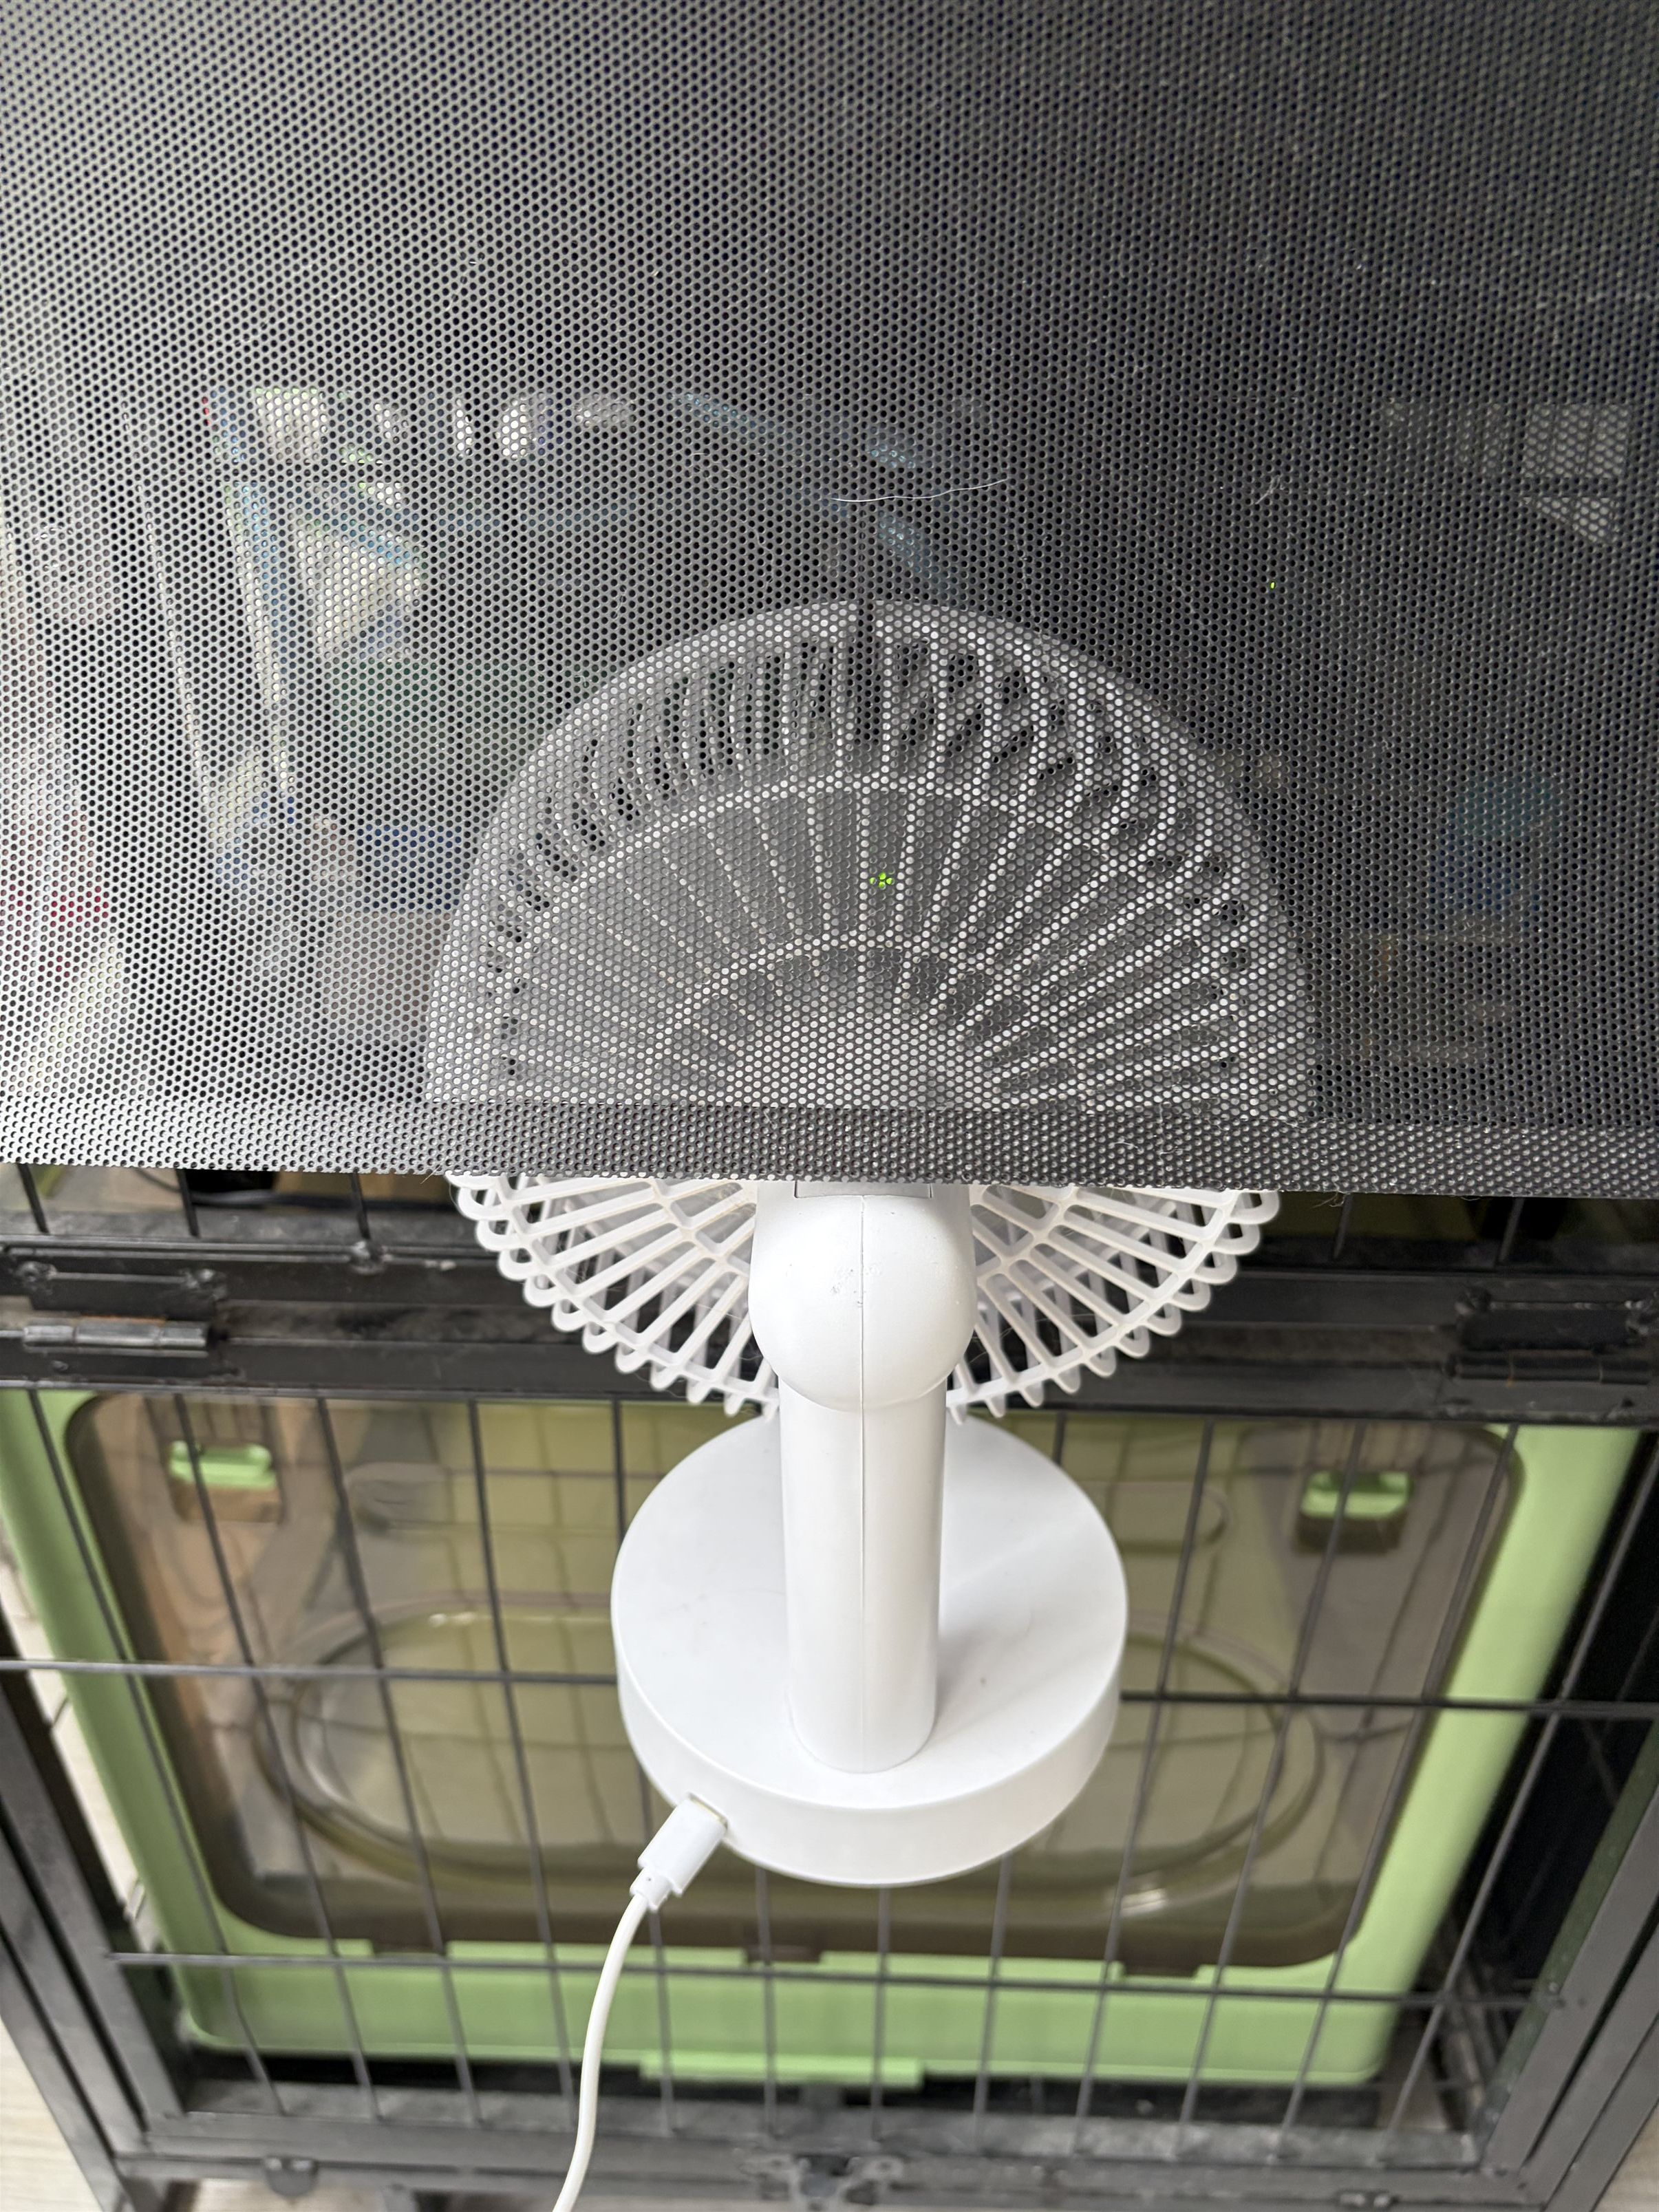
    然后在CPU冷排下方增加了一个闲置的小风扇,就和博主说的一样,别小看这些小风扇,放在对的位置有奇效!👍

    5fa852c51922d4d8a4e69f4df9addb87.jpg

    专门对着主板的侧面灌风,哦,对了,忘了说,主板和底层的高度我通过长螺丝加高到了3cm,
    放在了一块定做的透明亚克力板上,所以主板背面的空间非常宽裕!💨

    但是由于我家猫主子特别闹的原因(三天不打上房揭瓦,但是又舍不得打),我不得不每隔几天就要打开猫笼清理!😭

    344cc1a54207b8cb6fb4ec86fafda097.jpg

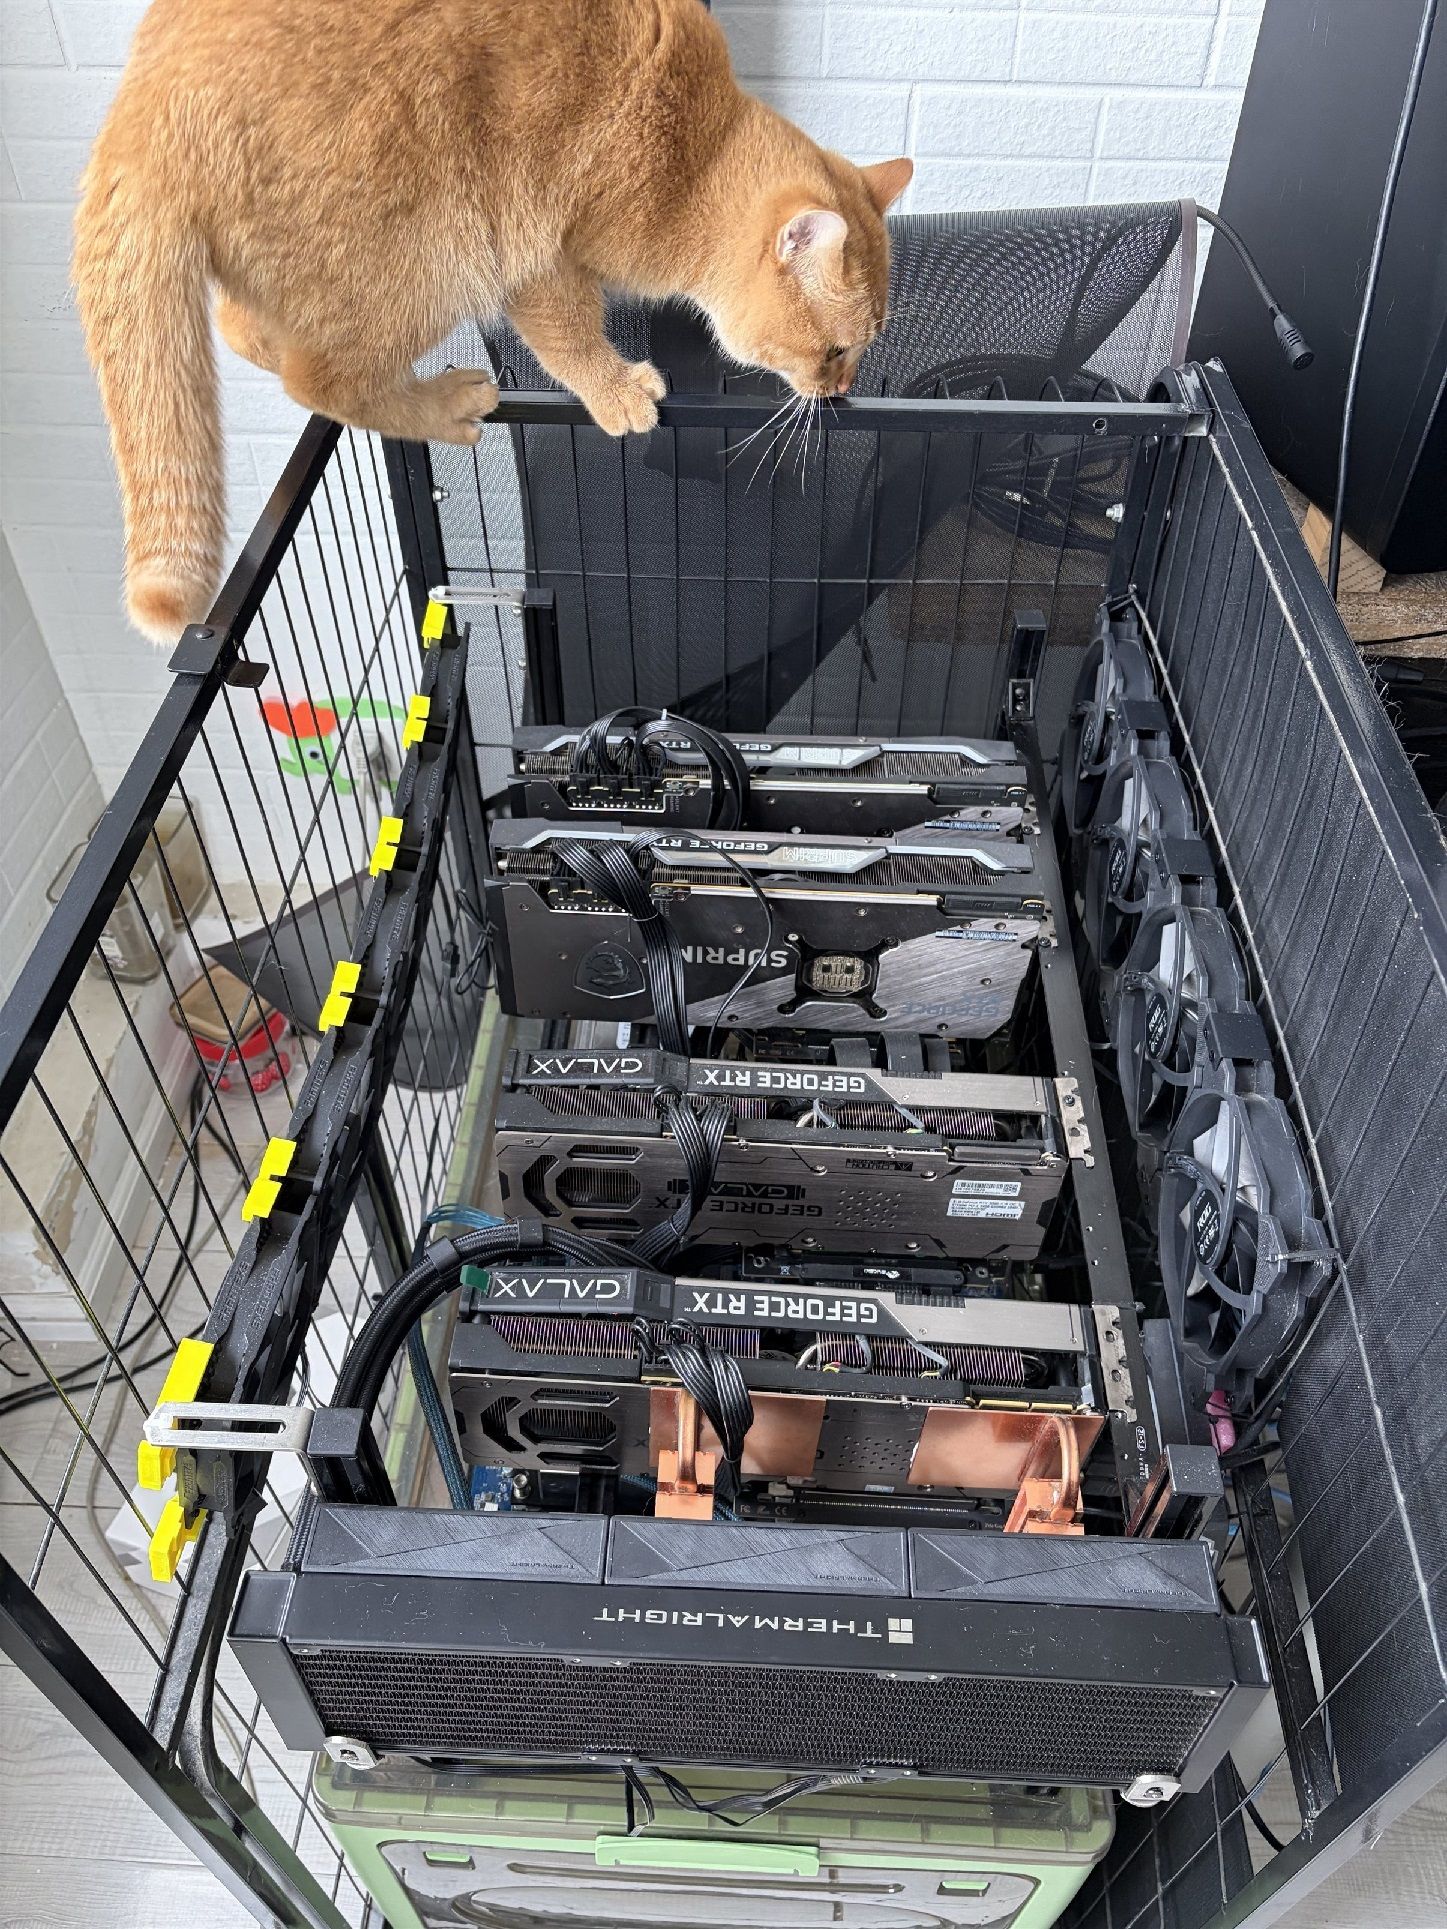
    装备分享完毕,最后来一张我家小主子的照片。😽

    8db2dbeefa6f54b8ac184204bf42c308.jpg

    祝大家生意兴隆!


  • 我的4×3090终于不再“绑在一起”:双卡200K MoE + 单卡Vision Sidecar,本地Agent开始Token自由
    JumpEggKillerJ JumpEggKiller
    LLM讨论区 rtx3090 strata 多卡部署

    Qwen3.8 Flash Next 后续:双3090 + IQ4_XS + 200K Context,150K长会话稳定105–110 tok/s,8小时长任务无幻觉无循环,再加了一张3090做Vision Sidecar!

    主要是我的一些探索思路
    344cc1a54207b8cb6fb4ec86fafda097.jpg
    分享,大家看看如果手里有3张显卡的情况下是否值得试试。
    a65150ebe6d18f3ae444918dd38bb11a.jpg

    前一阶段我已经分享过 Qwen3.8 Flash Next 从多卡低效一路优化到单卡 100+ tok/s 的过程:
    https://lcz.me/topic/2116

    这次不再重复前面的 benchmark。
    最近这一轮,我更关心的是另外三个问题:

    1. 能不能从 IQ3 升到质量更高的 IQ4_XS,同时维持高速?
    2. 能不能真正把 Context 拉到 200K,并在超长实际会话里持续工作?
    3. Vision 能不能不拖累主模型,而是独立拆出去?
      目前这三个问题基本都有答案了。

    现在我的主力配置已经变成:
    Niko1221/Strata v0.1.39:https://github.com/Niko1221/Strata/releases/tag/v0.1.39
    Qwen3.8 Flash Next IQ4_XS
    RTX 3090 ×2
    Max Context:200K
    文本模型不承担 Vision
    而真实使用中,一个已经增长到约 150K Context 的持续会话,Decode 长期保持在:
    105~110 tok/s
    同时我还完成了一次约 8 小时的连续实际任务。
    在这次长任务中:
    没有观察到明显幻觉恶化
    没有出现重复循环
    没有发生 Context 越长、输出越不稳定的现象
    这对我来说,比单次 benchmark 跑出一个很高的峰值更重要。

    一、从“单卡100+”转向“质量优先的双卡 IQ4_XS”
    上一阶段,我已经通过 Strata Custom Fork 把 Flash Next 做到了单3090、100+ tok/s。
    但那时候我真正担心的不是速度。
    而是:
    如果我要让这个模型长期承担 Agent、代码、文件分析、长任务甚至几个小时连续工作的主模型,低量化是不是还值得继续?
    所以后面我把目标改了。
    不再追求:
    “最低显存占用下的最高 tok/s”
    而是追求:
    “质量、上下文、速度、稳定性四项同时成立”。
    最终我切到了:
    Qwen3.8 Flash Next IQ4_XS
    Runtime:
    Niko1221/Strata v0.1.39
    GPU:
    RTX3090 ×2
    这一步最大的意义不是“又多用了一张3090”。
    而是我终于可以在自己愿意长期使用的量化质量下,同时保留:
    200K Context
    以及 100 tok/s 级别的真实生成性能。

    二、现在最让我满意的不是峰值,而是150K真实会话性能
    目前我实际使用中的一个会话已经累计到大约:
    150K Context
    而不是测试里临时塞进去一个 150K Prompt。
    也就是说,它是一个真正不断增长的工作 Session。
    当前这种情况下:
    平均 Decode ≈ 105~110 tok/s
    这个数据和单次 Cold benchmark 的意义完全不同。
    因为我真正想知道的是:
    模型聊了很久以后还快不快?
    Agent 做了大量工具调用以后还稳不稳?
    Context 已经十几万 token 后,Decode 会不会明显崩掉?
    目前答案都比我预期要好。
    在大约 150K Context 时,仍然能够长期维持三位数 tok/s。
    对我来说,这已经从“本地模型 benchmark”进入了“可以直接拿来干活”的阶段。

    三、200K Context 对我来说终于不再只是一个启动参数
    目前主模型的 Context 上限设为:
    200K
    这里我现在越来越在意一个区别:
    “能启动 200K”
    和
    “能在 200K Profile 下长期正常工作”
    完全不是一回事。
    很多长上下文配置可以成功启动,也可以完成一次 retrieval benchmark。
    但真正进入长期 Agent workload 后,可能出现:
    速度明显衰减
    重复
    循环
    逻辑稳定性下降
    长期任务后输出退化
    所以这次我没有只测短 benchmark。
    而是直接拿它跑真实任务。

    四、8小时连续实际任务:这是我现在最看重的一项测试
    目前已经完成过一次:
    约 8 小时连续实际任务
    不是简单地让模型无限生成文本。
    而是我平时真正会运行的长期工作流。
    结果是:
    整个过程中没有观察到明显幻觉
    没有 repetition loop
    没有出现输出逐渐陷入模板化循环
    没有因为 Context 持续增长而明显失控
    模型在长时间运行后的行为,和任务刚开始时基本保持一致。
    这里我不想说:
    “IQ4_XS 永远不会幻觉”。
    这显然不可能。
    更准确的结论是:
    在我这次约 8 小时的真实 workload 中,没有观察到因为长 Context 或长时间运行导致的异常幻觉、重复或循环问题。
    对我来说,这比单独一张:
    “峰值 120 tok/s”
    的截图有价值多了。

    五、为什么最后没有让 Flash Next 同时负责 Vision
    然后我又遇到另一个问题。
    我的实际工作并不只有文本。
    Hermes Local 和 DSH Local 平时还需要处理:
    截图
    图片
    界面
    文档中的视觉内容
    图片分析
    一些多模态 Agent 任务
    如果一定要求文本主模型自己支持 Vision,就会立刻多出一堆约束:
    模型选择受限
    Runtime 受限
    显存压力变大
    Context 管理更复杂
    文本性能可能受到影响
    更重要的是:
    为了偶尔看一张图片,让整个主模型长期背着 Vision 能力,并不一定合理。
    所以我后来换了一个思路:
    不要找一个什么都做的模型。
    直接拆。

    六、现在增加了一套独立 Vision Sidecar
    目前额外拿出一张 RTX3090。
    专门运行:
    vLLM
    Qwen3-VL-4B-Instruct
    BF16
    这张卡完全独立于 Flash Next 文本主模型。
    现在整个结构变成:
    文本:
    Qwen3.8 Flash Next IQ4_XS
    Strata v0.1.39
    RTX3090 ×2
    200K Context
    视觉:
    Qwen3-VL-4B-Instruct BF16
    vLLM
    RTX3090 ×1
    这样 Hermes Local 和 DSH Local 可以按照任务类型直接路由。
    普通文本、代码、Agent、长上下文:
    → Flash Next
    需要看图:
    → Vision Sidecar
    图片处理结束后:
    → 结果再交回文本主模型继续推理
    我现在反而觉得,这比强行追求一个“全能大模型”合理得多。

    七、为什么4B Vision反而非常适合做Sidecar
    这里我并不需要 Vision 模型承担复杂的主推理。
    主推理已经有 Flash Next。
    Vision Sidecar 更重要的是:
    看清楚
    识别正确
    输出结构化视觉信息
    速度够快
    占用显存合理
    所以 Qwen3-VL-4B-Instruct BF16 对这个位置其实很合适。
    而且我直接跑 BF16。
    不需要为了省显存再牺牲视觉模型质量。
    因为它有自己独占的一张 24GB 3090。
    这也是 Sidecar 架构一个很大的好处:
    每个模型都可以选自己最舒服的精度和 Runtime。
    文本模型不需要为了 Vision 妥协。
    Vision 模型也不用为了和大 MoE 抢显存而量化到很低。

    八、现在我的三张3090实际上形成了这种分工
    RTX3090 #1:
    Qwen3.8 Flash Next IQ4_XS
    RTX3090 #2:
    Qwen3.8 Flash Next IQ4_XS
    RTX3090 #3:
    Qwen3-VL-4B-Instruct BF16 / vLLM
    剩下的 GPU 资源还可以继续用于:
    实验
    生图
    其他 Sidecar
    备用 Runtime
    新的模型测试
    这和我之前“四张GPU一定要全部参与同一个模型”的思路已经完全不同。
    现在我更倾向于:
    把 GPU 当成一个本地 AI 资源池。
    而不是把所有 GPU 强行绑成一个超大推理实例。

    九、现在Hermes Local / DSH Local的使用体验
    这次升级对我来说最大的改变,其实不是 benchmark。
    而是日常工作方式。
    现在 Hermes Local 和 DSH Local 里:
    普通聊天
    代码
    Agent
    文件分析
    长文处理
    超长上下文
    图片理解
    截图分析
    视觉任务
    基本都可以在本机完成。
    文本走 Flash Next。
    图片走 VL Sidecar。
    上层 Agent 不需要关心底层到底调用了哪张 GPU。
    这才是我真正想要的体验。

    十、所谓“Token自由”是什么意思
    这里我说的 Token 自由,并不是模型计算不需要 token。
    而是:
    常规任务已经不再受外部 API 的 token 计费和额度约束。
    以前我跑一个几个小时的 Agent 任务,会自然考虑:
    用了多少百万 token?
    要花多少钱?
    上下文还能不能继续?
    是否需要为了 API 成本压缩历史记录?
    现在对于常规任务,这些顾虑基本消失了。
    如果一个任务需要跑:
    1小时
    3小时
    8小时
    或者持续积累十几万 Context
    主要成本已经变成:
    我自己的 GPU
    电费
    以及时间。
    而不是:
    每生成一个 token 都在增加 API 账单。
    这就是我这里所谓的:
    “常规任务 Token 自由”。

    十一、当前这套系统最关键的数据
    文本主模型:
    Qwen3.8 Flash Next IQ4_XS
    Runtime:
    Niko1221/Strata v0.1.39
    GPU:
    RTX3090 ×2
    最大 Context:
    200K
    Vision:
    关闭 / 独立 Sidecar
    实际长期会话:
    约 150K Context
    Decode:
    平均约 105~110 tok/s
    长期任务测试:
    约 8 小时
    结果:
    未观察到明显幻觉恶化
    未观察到 repetition loop
    未观察到长时间运行后的输出崩坏
    Vision Sidecar:
    Qwen3-VL-4B-Instruct
    BF16
    vLLM
    RTX3090 ×1
    上层:
    Hermes Local
    DSH Local

    十二、和我上一阶段最大的区别
    上一阶段我解决的是:
    “Qwen3.8 Flash Next 到底能不能在消费级3090上跑得很快?”
    答案已经是:
    可以。
    这一次解决的是:
    “跑得快以后,它能不能真正成为长期使用的主模型?”
    目前我的答案也开始变成:
    可以。
    而且我现在越来越觉得:
    本地 Agent 的最终形态可能根本不是一个“万能模型”。
    而是:
    一个强文本主脑

    多个专门的 Sidecar
    比如:
    Vision
    Embedding
    OCR
    Speech
    TTS
    Image Generation
    甚至 Router
    主模型只负责自己最擅长的推理和长 Context。
    其他能力按需调用。
    这样反而比试图把所有能力全部塞进一个模型,资源利用率更高,也更容易升级。

    最终架构
    现在我的实际结构可以简单写成:
    Hermes Local / DSH Local
    ↓
    任务路由
    ↓
    文本任务
    → Qwen3.8 Flash Next IQ4_XS
    → Strata v0.1.39
    → RTX3090 ×2
    → 200K Context
    → 150K Session ≈105~110 tok/s
    图片任务
    → Qwen3-VL-4B-Instruct BF16
    → vLLM
    → RTX3090 ×1
    ↓
    结果重新汇入 Agent 工作流

    现在这套东西对我而言已经不再只是:
    “4张3090可以跑什么大模型?”
    而开始变成:
    “4张3090如何组成一套真正长期可用的本地 AI 基础设施?”

    这是我觉得这一阶段最值得分享的变化。


  • cmp 170hx今天拼多多售价24999?
    JumpEggKillerJ JumpEggKiller
    AI硬件 170hx

    淘宝没有,京东没有,闲鱼满大街(完全没保障)。
    感觉就是矿卡脱手热销潮。
    这个价格,还是老老实实4090 48G更稳。
    挣钱不易,理性为重!哈哈哈


  • RTX3090 4卡 + DDR4 服务器内存256G,在纠结到底要不要上NV link?
    JumpEggKillerJ JumpEggKiller
    AI硬件 rtx3090 多卡部署

    9fac33e4-c6b7-4889-8d78-af4df26e4dd6-image.jpeg

    NV link好贵,目前最低的价格都在1800左右一个,想知道有没有已经link了的朋友,在各种启动方式(SGLANG/vLLM/llama.cpp)上进步有多大?到底值不值得上?

    PS:3090购买经历
    我目前是2张影驰大将3090+2张微星超龙3090。其中1影驰大将3090+1微星超龙3090是本地当面收的二手,经过验证,温度,性能都正常,另外1影驰大将3090+1微星超龙3090来自闲鱼,可能是运气比较好,经过验证,温度,性能也都正常就正常签收了。


  • 請益 Strata 雙卡配置:雙 RTX 3090,還是 RTX 5080 + RTX 3090?
    JumpEggKillerJ JumpEggKiller
    AI硬件 rtx3090 rtx5080 多卡部署

    都上了5080为什么不上个好点的PCIE5.0主板?


  • RTX3090 4卡 + DDR4 服务器内存256G,在纠结到底要不要上NV link?
    JumpEggKillerJ JumpEggKiller
    AI硬件 rtx3090 多卡部署

    @許傑 价格有点离谱啊最低都要1800人民币


  • 3090用户进!Windows开机自动解锁,叫你Agent抄作业即可!
    JumpEggKillerJ JumpEggKiller
    AI硬件 rtx3090 多卡部署

    a_high_quality_stylized_tech_poster_infographic_s.png

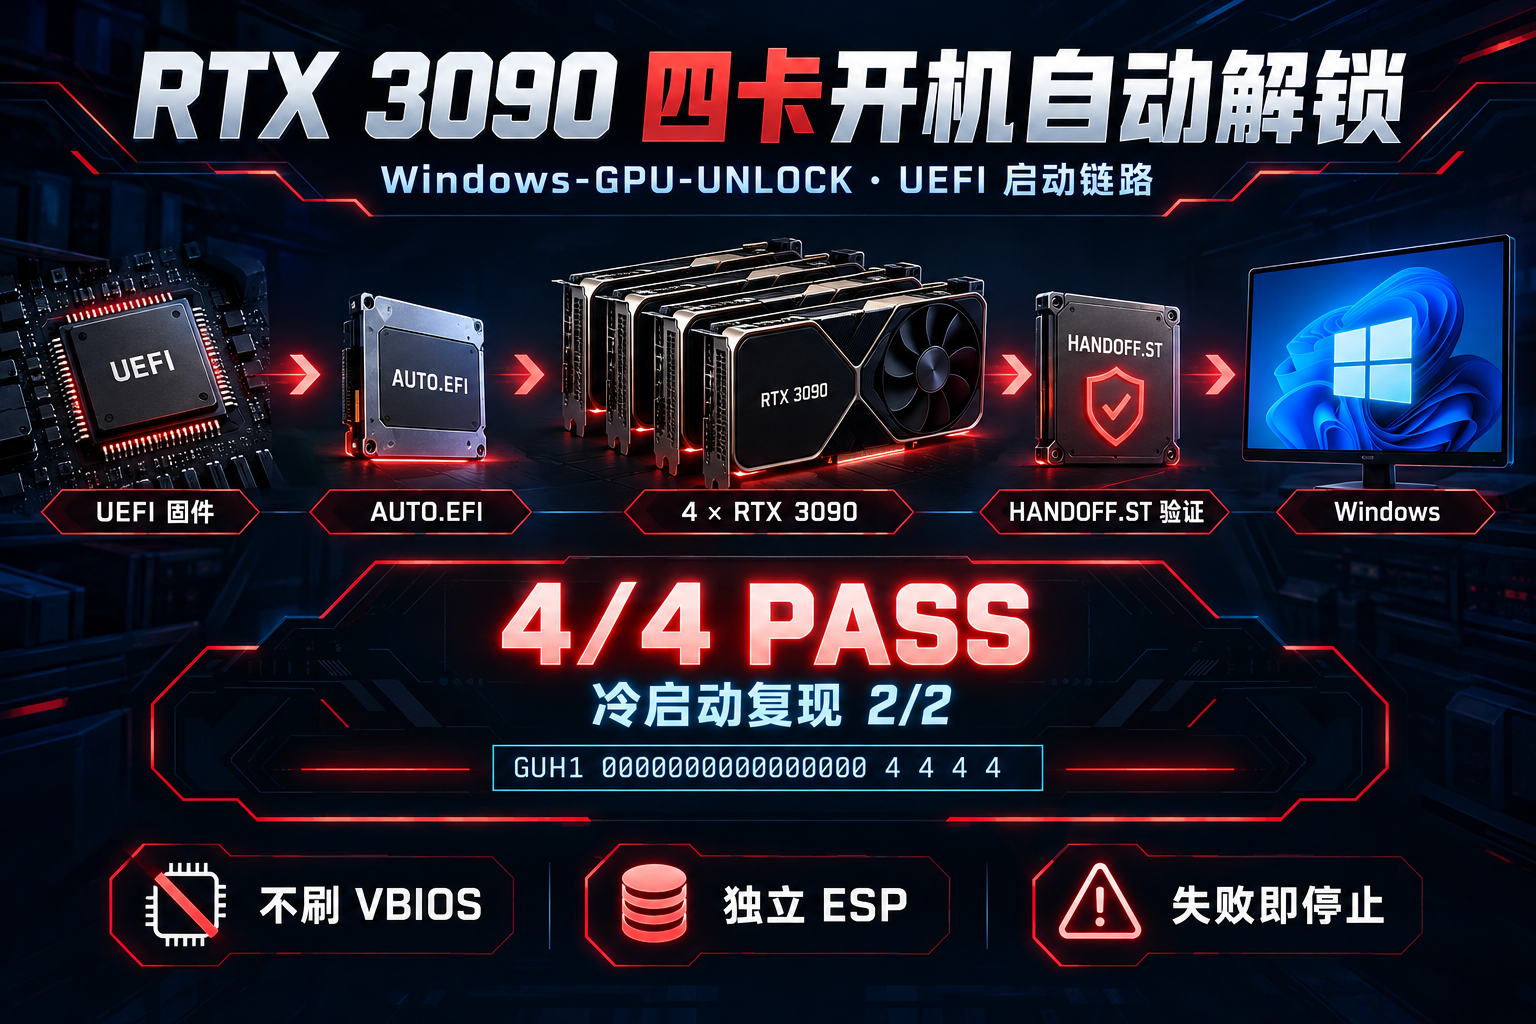
    我的情况是RTX 3090 四卡,但是我做成了无论你是几卡都能用。(如果有问题大哥/大姐尽管回来吐槽,我赶紧跪着改!)

    RTX 3090 Windows 开机自动解锁,连续多次冷启动验证通过!

    今天在折腾 RTX 3090 的算力解锁。

    之前已经成功验证了单卡以及多卡的 FP16/BF16 计算性能提升,但有一个问题始终没有解决:

    难道每次电脑关机重新启动,都要手动进入 UEFI 环境,再解锁一次显卡吗?

    对于长期运行 AI 大模型的四卡服务器来说,这显然不够实用。

    经过多轮调试,我终于把它做成了一套 Windows 开机自动解锁方案,并将成果整理到了 GitHub。

    wide_cinematic_tech_poster_thumbnail_scene_of_a.jpg

    项目地址:

    https://github.com/JumpEggKiller/Windows-GPU-UNLOCK

    这是基于 impacifist/Windows-GPU-UNLOCK 继续开发的 Fork,保留上游研究成果,重点完善了多卡、无人值守冷启动、Windows 启动交接与部署流程。

    1. 我的测试平台

    • GPU:RTX 3090 × 4,合计 96GB 显存
    • 内存:256GB ECC DDR4
    • 系统:Windows 10

    【注意】我把我插着显示器的那张3090也解锁了,所以如果你要解锁带显示器的卡还涉及显示输出,你最好加一个亮机卡或者显示器插主板上,不然解锁过程出岔子你就无从得知。

    2. 现在实现了什么?

    最重要的是:

    开机 → 自动检测 → 四卡解锁 → 验证状态 → 直接进入 Windows。

    整个过程发生在操作系统启动之前。

    不需要登录 Windows 后再运行解锁脚本,不需要每次手动操作 U 盘,也不需要刷写显卡 VBIOS。

    我们使用独立 EFI 系统分区保存启动程序,通过 UEFI 固件启动顺序执行解锁,成功后直接交接给 Windows Boot Manager。

    解锁状态不会永久写入显卡,每次冷启动都会重新建立。

    3. 实际验收结果

    目前在我的四卡服务器上:

    • 四卡解锁:4/4 PASS
    • 无人值守冷启动:ALL PASS
    • 解锁状态保留:4/4 PASS
    • Windows 启动交接:PASS
    • 无额外复位:PASS

    最关键的成功记录:

    GUH1 0000000000000000 4 4 4 4

    意味着四张目标卡全部完成解锁、保留状态并通过最终检查。

    即使承担显示任务的 GPU0,也在保留独立显示通路的前提下通过了所有权释放与状态检查。

    4. 性能提升有多大?

    在此前的一轮单卡 Tensor GEMM 基准测试中:

    指标 解锁前 解锁后 提升
    FP16 79.41 TFLOPS 121.14 TFLOPS +52.5%
    BF16 81.26 TFLOPS 125.64 TFLOPS +54.6%

    测试针对 FP16/BF16 Tensor 计算路径,并不代表所有 AI 模型、游戏或其他负载都会提升 50%。

    本次 Fork 的重点也不是重新创造这些解锁能力,而是解决它们在 Windows 多卡/单卡服务器上的启动自动化与可复现性,减少你重复操作的麻烦。

    5. 换一台机器能用吗?

    这次也增加了面向新机器的部署向导 Adopt.ps1。

    它会自动盘点显卡身份、生成配置、构建启动镜像并引导部署过程,支持分步骤执行以及恢复 Windows 优先启动。

    【但必须说明】目前实机完整验证的是我的四卡 RTX 3090 平台,不能保证所有主板、VBIOS 和 NVIDIA 显卡都兼容。你可以让你的Agent抄作业照着改!

    尤其需要注意:

    • 必须具备安全的备用显示通路。!
    • 当前方案使用未签名 UEFI 程序,需要关闭 Secure Boot。
    • 需要独立 FAT32 EFI 分区,不能直接改写 Windows EFI 分区。
    • 需要满足项目文档中的 BitLocker、固件版本及硬件校验要求。
    • 解锁异常时采用失败即停止策略,避免带着不完整状态进入 Windows。

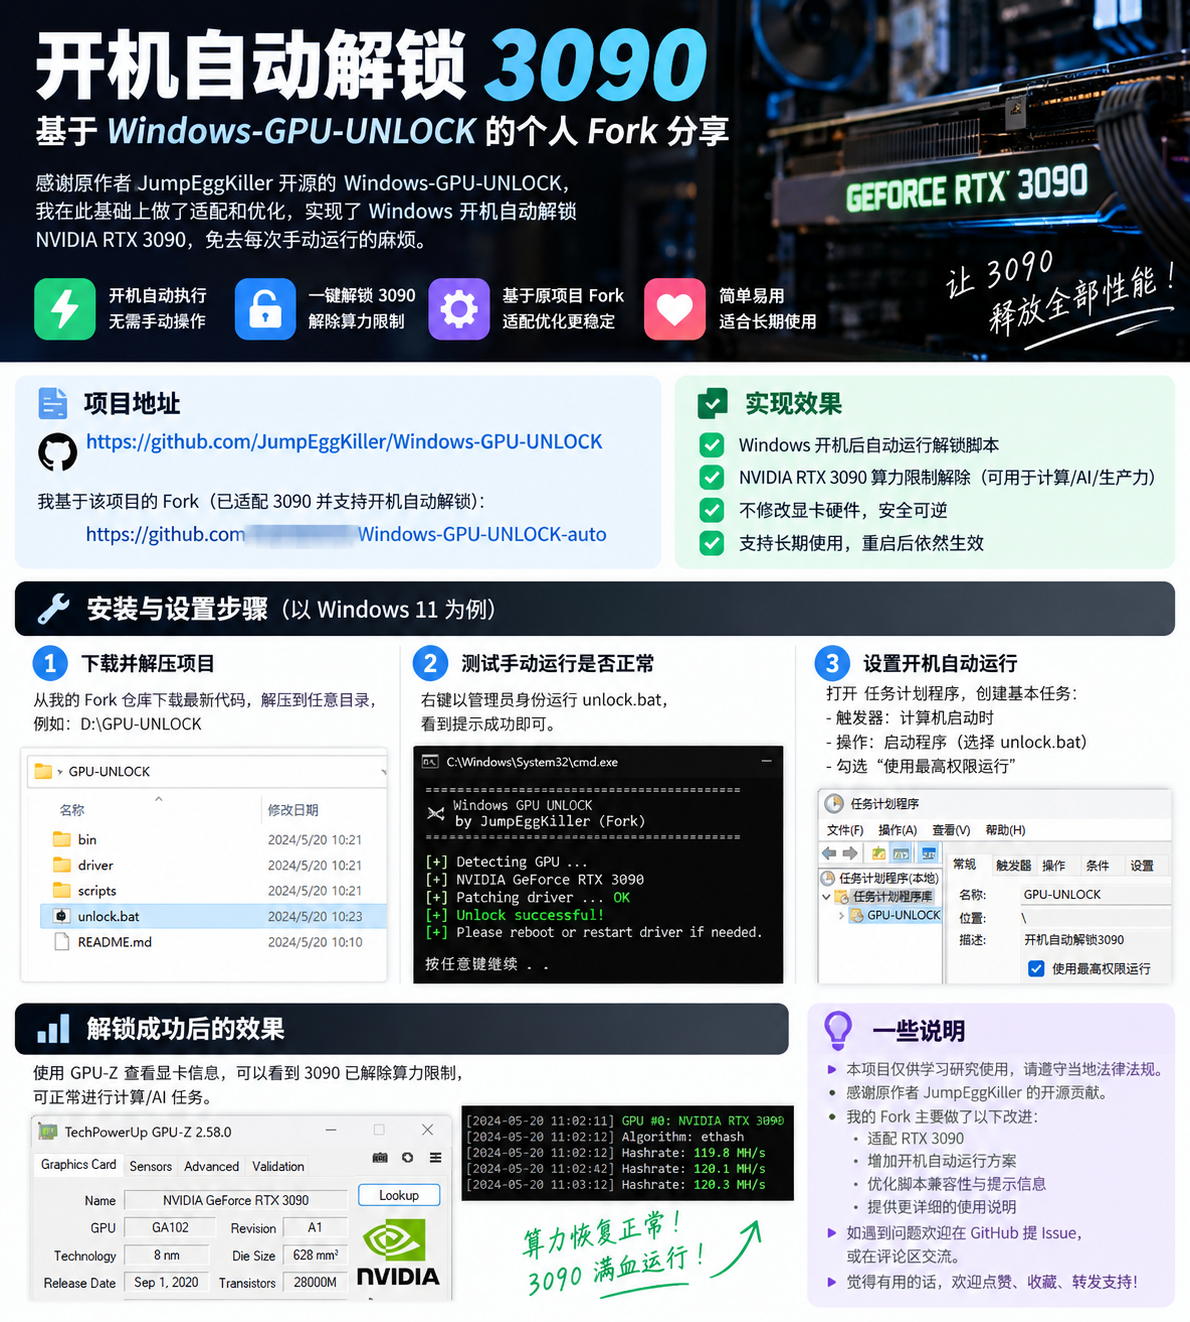
    强烈建议先阅读仓库的 ADOPT.md,而不是直接把其他人的 EFI 文件复制到自己的电脑上运行。

    Windows 开机自动解锁 3090 技巧指南.png

    6. 项目开源

    我的 Fork:

    https://github.com/JumpEggKiller/Windows-GPU-UNLOCK

    上游项目:

    https://github.com/impacifist/Windows-GPU-UNLOCK

    底层研究来源:

    https://github.com/Zagitta/gpu-unlock

    感谢原项目作者及后续移植者的研究与开源贡献。

    如果你也在使用 RTX 3090 运行本地 AI,欢迎交流不同主板、VBIOS、单卡和多卡的实际兼容性。

    让后面来抄作业的大哥/大姐更加快速的部署解锁!阿弥陀佛!善哉!

    尤其希望看到更多独立机器的复现实测,而不只是软件模拟测试。

    这次最大的收获,不仅是让 3090 跑得更快,而是让解锁后的算力能够真正融入一台可长期使用的 Windows AI 服务器。

    我是跳蛋杀手。下次我弄出点什么方便的东西来我再继续分享。


  • Blackwell用户新福利!NVIDIA Flare推理框架!
    JumpEggKillerJ JumpEggKiller
    LLM讨论区 nvidia 本地模型

    图片.jpeg

    https://github.com/NVIDIA/spark-local-inference

    五项核心技术优势

    ① 预编译 CUDA Graph,减少推理运行时开销

    PyTorch 负责提前编译、自动调优和 CUDA Graph Capture,Rust 运行时 Helios 直接执行预先生成的 GPU 程序,无须在每次推理时经过 Python 模型执行流程。

    主要价值是减少 CPU 调度与 GPU 提交间隙,提高执行稳定性,特别适合低并发推理。
    GitHub+1

    ② 完整上下文状态缓存,而不只是 KV Cache

    Flare 的设计把 KV Cache、GDN/KDA 循环状态、部分页面以及推测解码状态纳入统一管理。

    这意味着长对话恢复、共享前缀、Agent 分支及重复工具调用能够复用更多计算状态。Selene 进一步探索 GPU、RAM 和磁盘的分层缓存,但部分 Offload 路径仍需单独验证。
    GitHub+1

    ③ GPU 内完成 MTP / DSpark 推测解码

    支持 Qwen、GLM 的 MTP 和 DeepSeek 的 DSpark。候选生成、验证和状态提交可以组合在预编译 GPU 执行流程中,减少 CPU-GPU 往返。

    在候选 Token 接受率较高时,有机会显著改善 Decode 速度;实际增益仍受模型、精度及批量影响。
    GitHub

    ④ 针对 MoE 模型优化显存与访存

    使用 Blackwell 原生 NVFP4/MXFP8、FlashInfer/b12x 融合算子和压缩 Scale,并支持把 PLE、Engram 等大型查找表放在主机内存或磁盘中,按需向 GPU 传递所需行。

    对 DeepSeek V4.1、Qwen3.8 Flash 等模型尤其有价值,有望减少 GPU 侧存储和数据搬运,但缓存未命中时仍会产生额外延迟。
    GitHub+1

    ⑤ 专用模型优化与多 GPU 执行

    Flare 为特定模型建立独立 Recipe,针对注意力、MoE、循环状态、推测解码进行联合优化,同时支持受支持配置下的单机 TP 和跨主机 TP。

    优点是可以为特定模型深度优化,而不是强求一个通用执行路径兼容所有模型。


  • 【最新】Strata专为Deepseek V4.1 Flash 1017 + GLM 5.3做的新分支-Project-Maya
    JumpEggKillerJ JumpEggKiller
    LLM讨论区 strata deepseek glm

    图片.jpeg
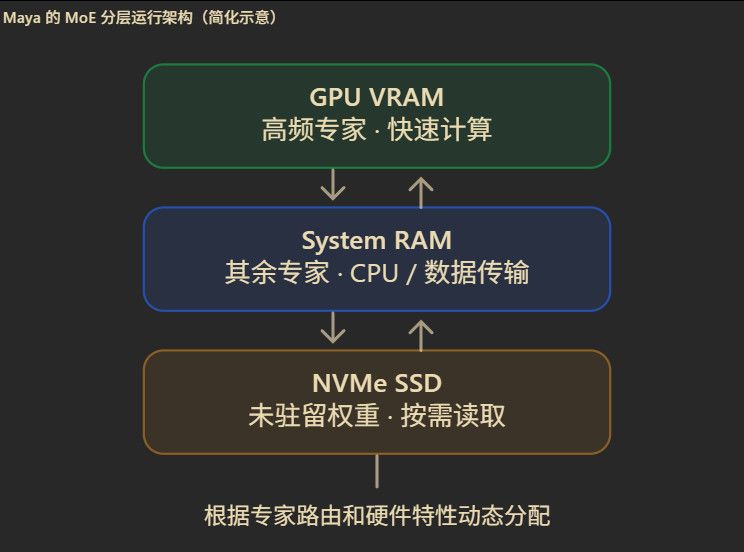
    这里最重要的不是能够加载一个几百 B 的模型,而是三个工程能力:

    1. Expert Placement / Expert Cache
      将高频激活的专家尽可能保留在显存,剩余专家由 CPU 和内存处理,并在需要时从 NVMe 加载。这可以减少显存不足带来的性能损失。
    2. 适配超大上下文
      GLM 路线使用 KV Streaming,将部分 KV Cache 放到系统内存;DeepSeek 路线则使用模型自身的压缩注意力缓存格式。它们不是同一套实现。
    3. 推测解码和请求服务
      GLM 支持原生 MTP 或 DFlash2 推测解码,最多 8 路并发请求;DeepSeek 支持自己的 DSpark drafter,但不能直接假定拥有与 GLM 相同的并发性能。
      此外,Maya 提供 OpenAI 兼容 API、Anthropic 兼容 API、Tool Calling、网页聊天和硬件监控。

  • 用Hermes+本地NInfer Qwen3.8 27b+单卡3090写的一个多GPU实时监控小程序,大家随意下载玩玩~
    JumpEggKillerJ JumpEggKiller
    AI Agent hermes ninfer rtx3090

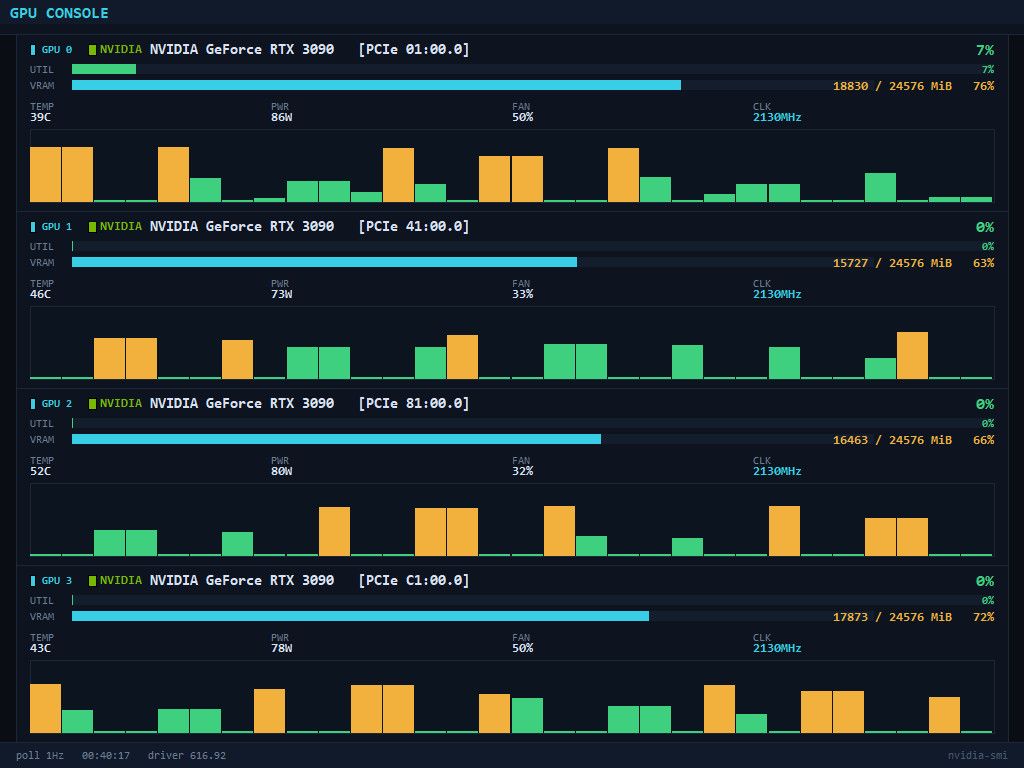
    用Hermes写了一个小工具开源给大家玩玩:
    GPU Console 桌面 GPU 监控小窗,多显卡逐卡显示(品牌色标+型号+温度/功耗/风扇/频率),还有 30 秒利用率历史小图无边框可拖拽,F11 全屏,无黑窗闪烁免费开源(MIT),
    一键安装包下载:
    github.com/JumpEggKiller/gpu-console/releases 有独立显卡的自取 🖥️

    8246baea-3289-48bd-9145-013bf07af3e9-image.jpeg

    NInfer Qwen3.8 27b是真的很快啊,在单卡3090上(目前NIfer只能单卡)70+t/s,唯一不足就是上下文太短(单卡上显存不够了)。


  • 【最新】Strata专为Deepseek V4.1 Flash 1017 + GLM 5.3做的新分支-Project-Maya
    JumpEggKillerJ JumpEggKiller
    LLM讨论区 strata deepseek glm

    针对Deepseek V4.1 Flash 1017 + GLM 5.3做的运行框架。

    https://github.com/mw00/project-maya

    刚刚看到,我也正在安装准备测试!

    希望看到论坛各位大神的实测表现!


  • 没想到我的猫笼机箱+矿架居然上电视了!有钱大神太多,4 X 3090低调路过...
    JumpEggKillerJ JumpEggKiller
    装备秀 rtx3090 多卡部署

    @Tony-Wang 他爸应该是金渐层,妈是狸花


  • 【改造成本2.9元】养猫之家塔式机箱散热的解决方案小巧思
    JumpEggKillerJ JumpEggKiller
    装备秀

    你可以和我一样弄个猫笼来当机箱啊。散热更好,还没有噪音。https://lcz.me/topic/2115/8


  • 没想到我的猫笼机箱+矿架居然上电视了!有钱大神太多,4 X 3090低调路过...
    JumpEggKillerJ JumpEggKiller
    装备秀 rtx3090 多卡部署

    @Tony-Wang 好看

  • 登录

  • 登录或注册以进行搜索。
  • 第一个帖子
    最后一个帖子
0
  • 版块
  • 最新
  • 标签
  • 热门
  • 用户
  • 群组