
@applejuice 试试
-
strata跑QFN模型的速度越来越快了,要及时更新 -
皮衣黄的AI 还是没算到这一步?那么成功的男人才出轨1个婆娘,已经够faithful了。换做别人已经自建萝莉岛了。
-
strata跑QFN模型的速度越来越快了,要及时更新@applejuice 怎么做到的
-
strata跑QFN模型的速度越来越快了,要及时更新我的2*3090 prefill干到3500,decode 140,4卡prefill4700,但是decode掉到20
-
[實測VII] 新引擎 Basalt 跑3卡 Qwen 3.8 flash 406 tok/s、pp 175,050 讀 22 秒(7956.8 tok/s) —— 32K–256K 全檔位實測 + 安裝與調優这引擎只有Blackwell sm_120能用吧。散了散了
-
Blackwell用户新福利!NVIDIA Flare推理框架!
https://github.com/NVIDIA/spark-local-inference
五项核心技术优势
① 预编译 CUDA Graph,减少推理运行时开销
PyTorch 负责提前编译、自动调优和 CUDA Graph Capture,Rust 运行时 Helios 直接执行预先生成的 GPU 程序,无须在每次推理时经过 Python 模型执行流程。
主要价值是减少 CPU 调度与 GPU 提交间隙,提高执行稳定性,特别适合低并发推理。
GitHub+1② 完整上下文状态缓存,而不只是 KV Cache
Flare 的设计把 KV Cache、GDN/KDA 循环状态、部分页面以及推测解码状态纳入统一管理。
这意味着长对话恢复、共享前缀、Agent 分支及重复工具调用能够复用更多计算状态。Selene 进一步探索 GPU、RAM 和磁盘的分层缓存,但部分 Offload 路径仍需单独验证。
GitHub+1③ GPU 内完成 MTP / DSpark 推测解码
支持 Qwen、GLM 的 MTP 和 DeepSeek 的 DSpark。候选生成、验证和状态提交可以组合在预编译 GPU 执行流程中,减少 CPU-GPU 往返。
在候选 Token 接受率较高时,有机会显著改善 Decode 速度;实际增益仍受模型、精度及批量影响。
GitHub④ 针对 MoE 模型优化显存与访存
使用 Blackwell 原生 NVFP4/MXFP8、FlashInfer/b12x 融合算子和压缩 Scale,并支持把 PLE、Engram 等大型查找表放在主机内存或磁盘中,按需向 GPU 传递所需行。
对 DeepSeek V4.1、Qwen3.8 Flash 等模型尤其有价值,有望减少 GPU 侧存储和数据搬运,但缓存未命中时仍会产生额外延迟。
GitHub+1⑤ 专用模型优化与多 GPU 执行
Flare 为特定模型建立独立 Recipe,针对注意力、MoE、循环状态、推测解码进行联合优化,同时支持受支持配置下的单机 TP 和跨主机 TP。
优点是可以为特定模型深度优化,而不是强求一个通用执行路径兼容所有模型。
-
双 2080 Ti(22G)跑 MiniMax-H3 张量并行 TP2 方案分享2080TI魔改卡去年便宜的时候买过,才2天就花屏,退了以后就没有再敢碰
-
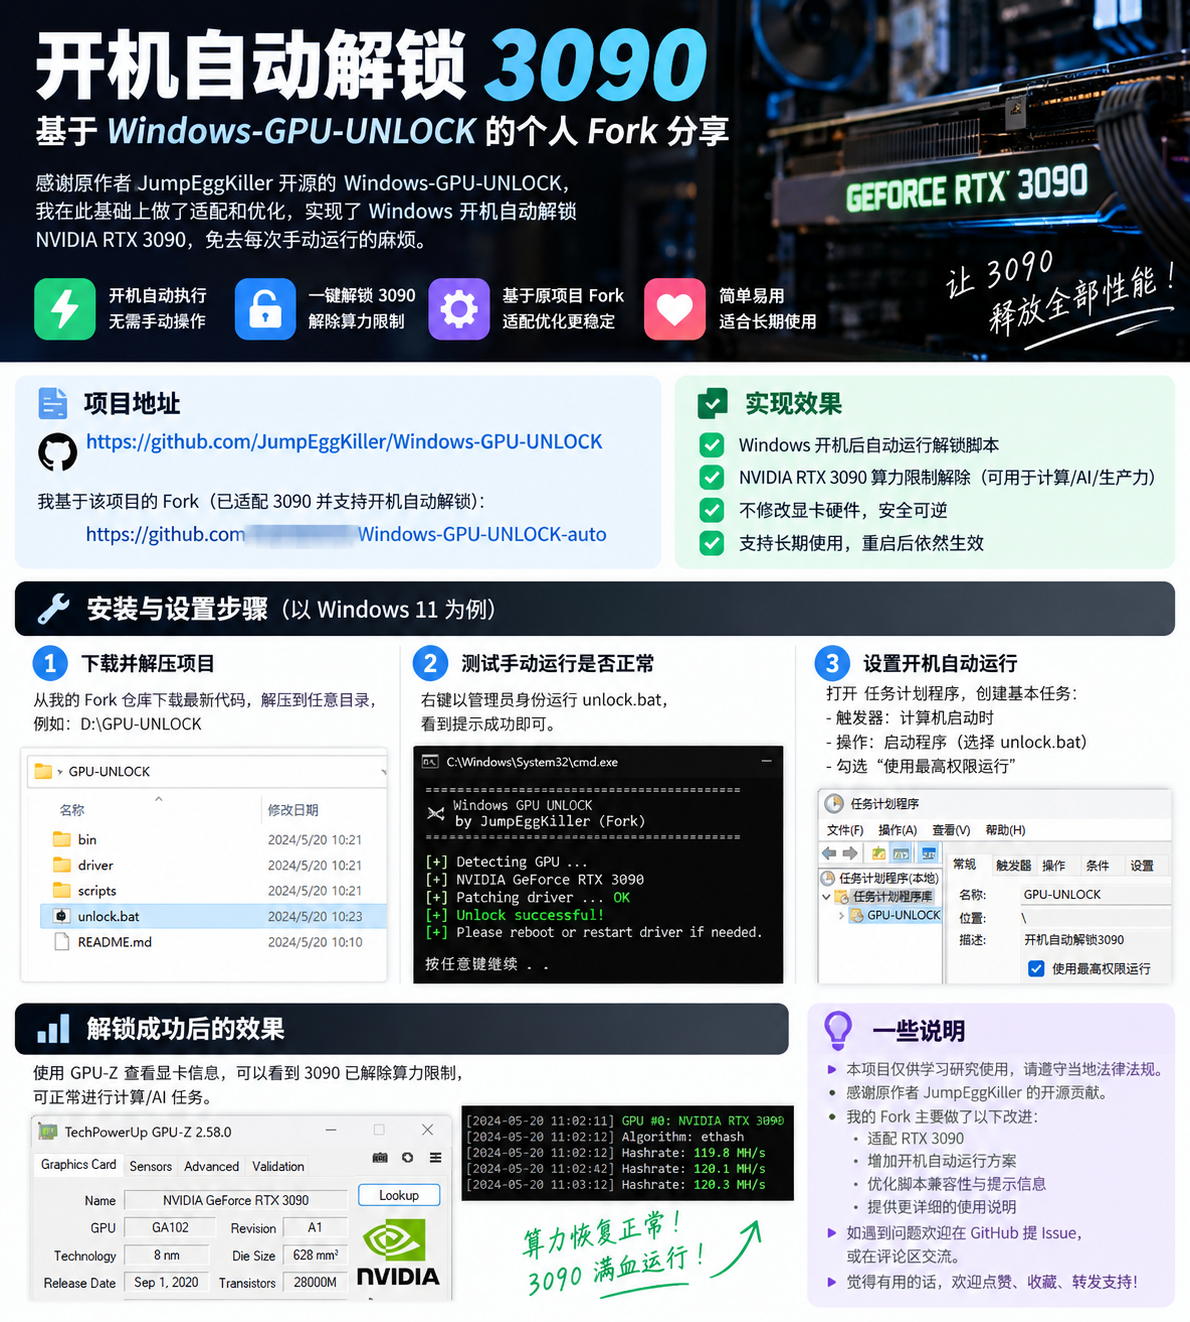
3090用户进!Windows开机自动解锁,叫你Agent抄作业即可!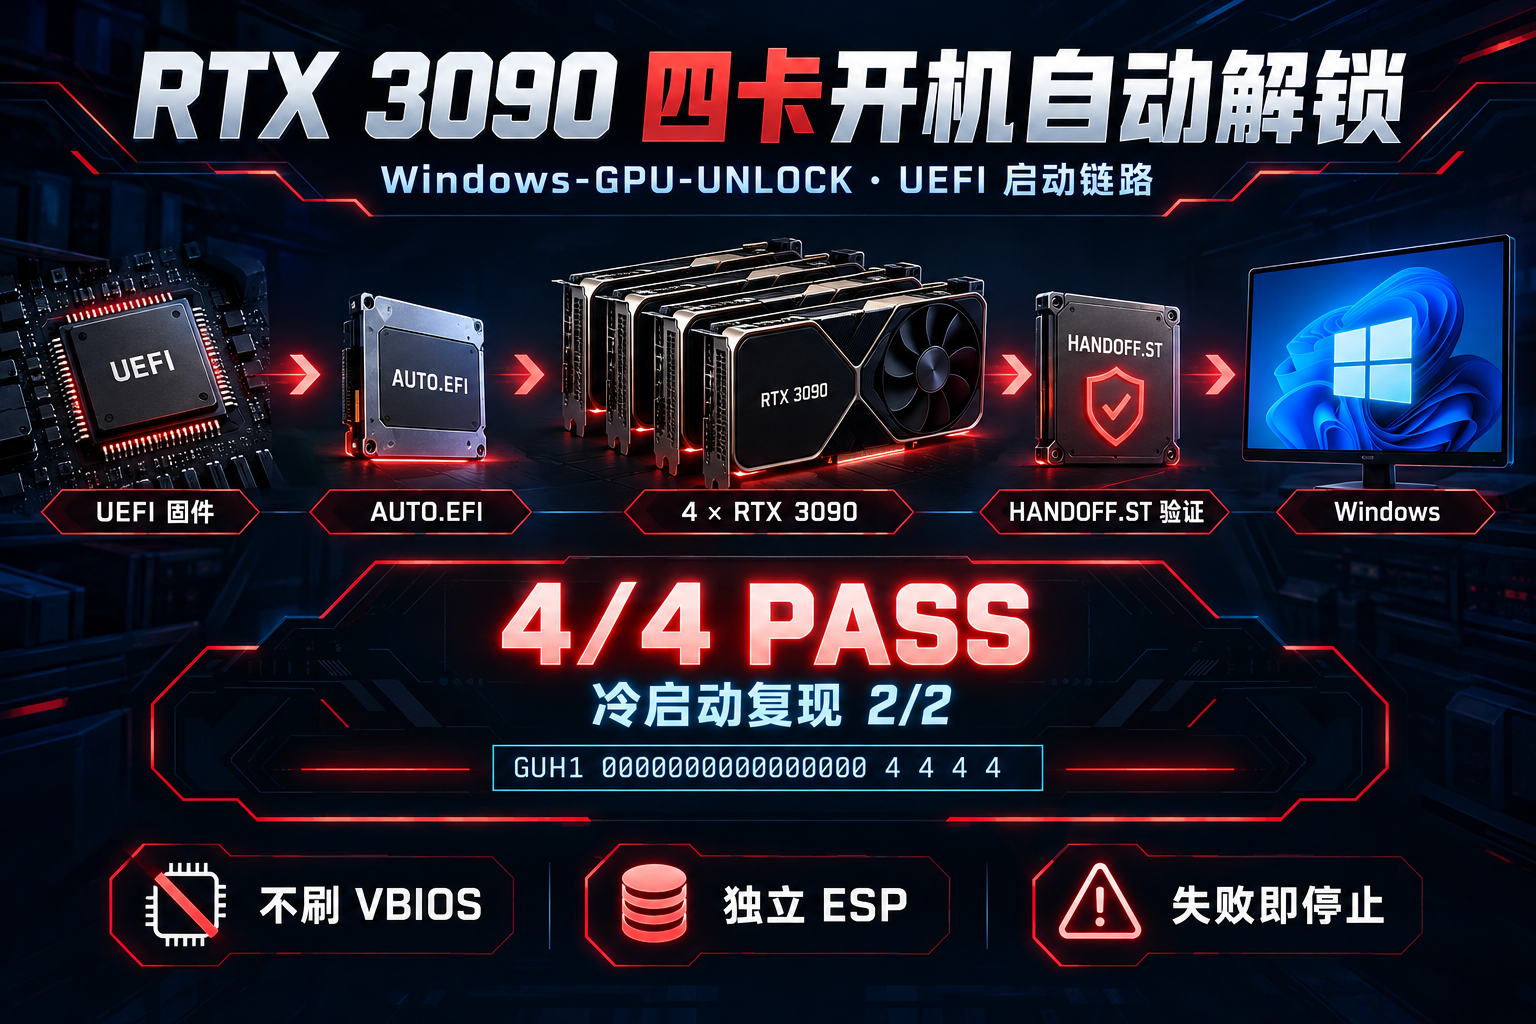
我的情况是RTX 3090 四卡,但是我做成了无论你是几卡都能用。(如果有问题大哥/大姐尽管回来吐槽,我赶紧跪着改!)
RTX 3090 Windows 开机自动解锁,连续多次冷启动验证通过!
今天在折腾 RTX 3090 的算力解锁。
之前已经成功验证了单卡以及多卡的 FP16/BF16 计算性能提升,但有一个问题始终没有解决:
难道每次电脑关机重新启动,都要手动进入 UEFI 环境,再解锁一次显卡吗?
对于长期运行 AI 大模型的四卡服务器来说,这显然不够实用。
经过多轮调试,我终于把它做成了一套 Windows 开机自动解锁方案,并将成果整理到了 GitHub。
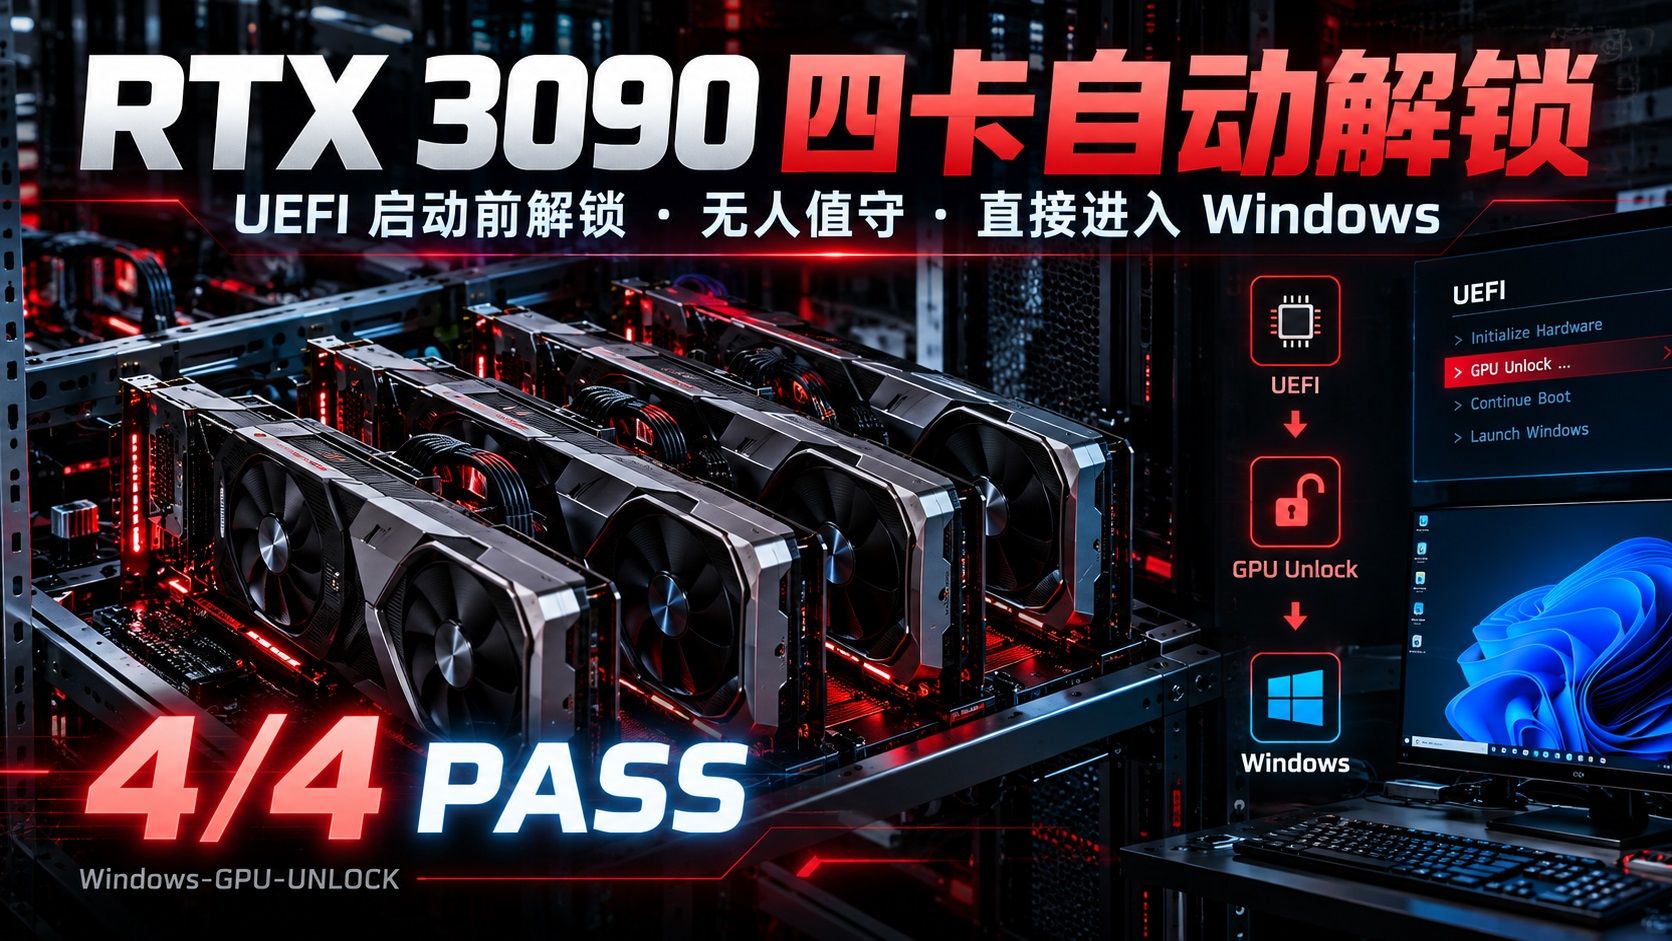
项目地址:
https://github.com/JumpEggKiller/Windows-GPU-UNLOCK
这是基于 impacifist/Windows-GPU-UNLOCK 继续开发的 Fork,保留上游研究成果,重点完善了多卡、无人值守冷启动、Windows 启动交接与部署流程。
1. 我的测试平台
- GPU:RTX 3090 × 4,合计 96GB 显存
- 内存:256GB ECC DDR4
- 系统:Windows 10
【注意】我把我插着显示器的那张3090也解锁了,所以如果你要解锁带显示器的卡还涉及显示输出,你最好加一个亮机卡或者显示器插主板上,不然解锁过程出岔子你就无从得知。
2. 现在实现了什么?
最重要的是:
开机 → 自动检测 → 四卡解锁 → 验证状态 → 直接进入 Windows。
整个过程发生在操作系统启动之前。
不需要登录 Windows 后再运行解锁脚本,不需要每次手动操作 U 盘,也不需要刷写显卡 VBIOS。
我们使用独立 EFI 系统分区保存启动程序,通过 UEFI 固件启动顺序执行解锁,成功后直接交接给 Windows Boot Manager。
解锁状态不会永久写入显卡,每次冷启动都会重新建立。
3. 实际验收结果
目前在我的四卡服务器上:
- 四卡解锁:4/4 PASS
- 无人值守冷启动:ALL PASS
- 解锁状态保留:4/4 PASS
- Windows 启动交接:PASS
- 无额外复位:PASS
最关键的成功记录:
GUH1 0000000000000000 4 4 4 4意味着四张目标卡全部完成解锁、保留状态并通过最终检查。
即使承担显示任务的 GPU0,也在保留独立显示通路的前提下通过了所有权释放与状态检查。
4. 性能提升有多大?
在此前的一轮单卡 Tensor GEMM 基准测试中:
指标 解锁前 解锁后 提升 FP16 79.41 TFLOPS 121.14 TFLOPS +52.5% BF16 81.26 TFLOPS 125.64 TFLOPS +54.6% 测试针对 FP16/BF16 Tensor 计算路径,并不代表所有 AI 模型、游戏或其他负载都会提升 50%。
本次 Fork 的重点也不是重新创造这些解锁能力,而是解决它们在 Windows 多卡/单卡服务器上的启动自动化与可复现性,减少你重复操作的麻烦。
5. 换一台机器能用吗?
这次也增加了面向新机器的部署向导
Adopt.ps1。它会自动盘点显卡身份、生成配置、构建启动镜像并引导部署过程,支持分步骤执行以及恢复 Windows 优先启动。
【但必须说明】目前实机完整验证的是我的四卡 RTX 3090 平台,不能保证所有主板、VBIOS 和 NVIDIA 显卡都兼容。你可以让你的Agent抄作业照着改!
尤其需要注意:
- 必须具备安全的备用显示通路。!
- 当前方案使用未签名 UEFI 程序,需要关闭 Secure Boot。
- 需要独立 FAT32 EFI 分区,不能直接改写 Windows EFI 分区。
- 需要满足项目文档中的 BitLocker、固件版本及硬件校验要求。
- 解锁异常时采用失败即停止策略,避免带着不完整状态进入 Windows。
强烈建议先阅读仓库的 ADOPT.md,而不是直接把其他人的 EFI 文件复制到自己的电脑上运行。
6. 项目开源
我的 Fork:
https://github.com/JumpEggKiller/Windows-GPU-UNLOCK
上游项目:
https://github.com/impacifist/Windows-GPU-UNLOCK
底层研究来源:
https://github.com/Zagitta/gpu-unlock
感谢原项目作者及后续移植者的研究与开源贡献。
如果你也在使用 RTX 3090 运行本地 AI,欢迎交流不同主板、VBIOS、单卡和多卡的实际兼容性。
让后面来抄作业的大哥/大姐更加快速的部署解锁!阿弥陀佛!善哉!
尤其希望看到更多独立机器的复现实测,而不只是软件模拟测试。
这次最大的收获,不仅是让 3090 跑得更快,而是让解锁后的算力能够真正融入一台可长期使用的 Windows AI 服务器。
我是跳蛋杀手。下次我弄出点什么方便的东西来我再继续分享。
-
贫穷的3060玩家弄来了8个DGX你侮辱了贫穷两个字
-
cmp 170hx今天拼多多售价24999?@terry 不敢碰了,寿命也差不多了
-
4090 (4070TI) 解锁F16(FP32)算力 加快PREFILL咱们这三瓜两枣的,老黄怕是看不上,哈哈哈,供应Vera Rubin都还供不上。
-
cmp 170hx今天拼多多售价24999?现在随便一问都是一万七八,没意思了
-
cmp 170hx今天拼多多售价24999?是啊,单卡玩还行,多卡就遭罪了,pcie2.0,而且有的还在x4不是x16,我看国外还有人把它改pcie3.0x16的
-
cmp 170hx今天拼多多售价24999?淘宝没有,京东没有,闲鱼满大街(完全没保障)。
感觉就是矿卡脱手热销潮。
这个价格,还是老老实实4090 48G更稳。
挣钱不易,理性为重!哈哈哈 -
【最新】Strata专为Deepseek V4.1 Flash 1017 + GLM 5.3做的新分支-Project-Maya@applejuice 谁能跟Strata Qwen3.8 flash next比,我现在看到100decode以下都无感,哈哈哈哈哈
-
【最新】Strata专为Deepseek V4.1 Flash 1017 + GLM 5.3做的新分支-Project-Maya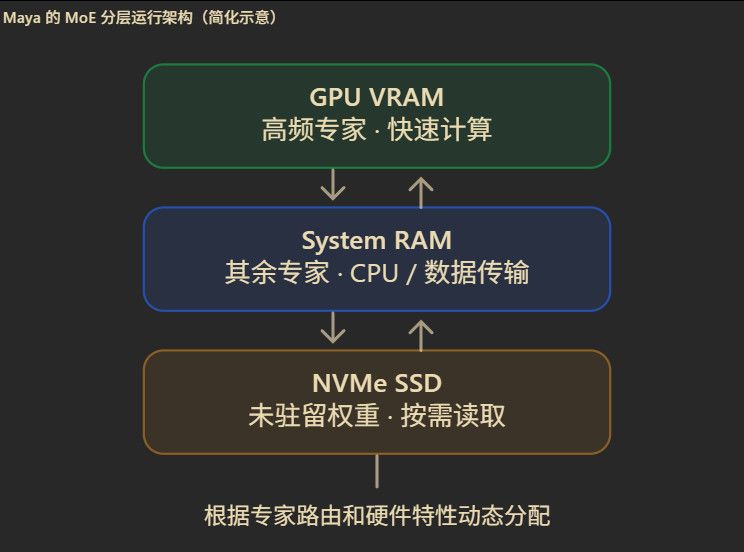
这里最重要的不是能够加载一个几百 B 的模型,而是三个工程能力:- Expert Placement / Expert Cache
将高频激活的专家尽可能保留在显存,剩余专家由 CPU 和内存处理,并在需要时从 NVMe 加载。这可以减少显存不足带来的性能损失。 - 适配超大上下文
GLM 路线使用 KV Streaming,将部分 KV Cache 放到系统内存;DeepSeek 路线则使用模型自身的压缩注意力缓存格式。它们不是同一套实现。 - 推测解码和请求服务
GLM 支持原生 MTP 或 DFlash2 推测解码,最多 8 路并发请求;DeepSeek 支持自己的 DSpark drafter,但不能直接假定拥有与 GLM 相同的并发性能。
此外,Maya 提供 OpenAI 兼容 API、Anthropic 兼容 API、Tool Calling、网页聊天和硬件监控。
- Expert Placement / Expert Cache
-
【最新】Strata专为Deepseek V4.1 Flash 1017 + GLM 5.3做的新分支-Project-Maya针对Deepseek V4.1 Flash 1017 + GLM 5.3做的运行框架。
https://github.com/mw00/project-maya
刚刚看到,我也正在安装准备测试!
希望看到论坛各位大神的实测表现!
-
【改造成本2.9元】养猫之家塔式机箱散热的解决方案小巧思@xiongjie-gao 动起手来,弄着弄着就不残了
-
【改造成本2.9元】养猫之家塔式机箱散热的解决方案小巧思你可以和我一样弄个猫笼来当机箱啊。散热更好,还没有噪音。https://lcz.me/topic/2115/8
-
【實測】4× RTX PRO 6000:DeepSeek V4.1 Flash 原版 vs 1017,單人生成提升約 51%太壕了!!!!!!