* AMD R9700(RDNA4 / gfx1201)單卡:llama.cpp Vulkan MTP 去審查實測
參考 BEN LIN 前輩《雙 R9700 單宿主 SGLang + llama.cpp MTP 同機實測》 的方法學整理。
本機:單張 AMD R9700 32GB(RDNA4 / gfx1201)跑「去審查(abliterated)」Qwen3.8-27B + llama.cpp Vulkan MTP。
4090 留給 ComfyUI,全程不參與推理。
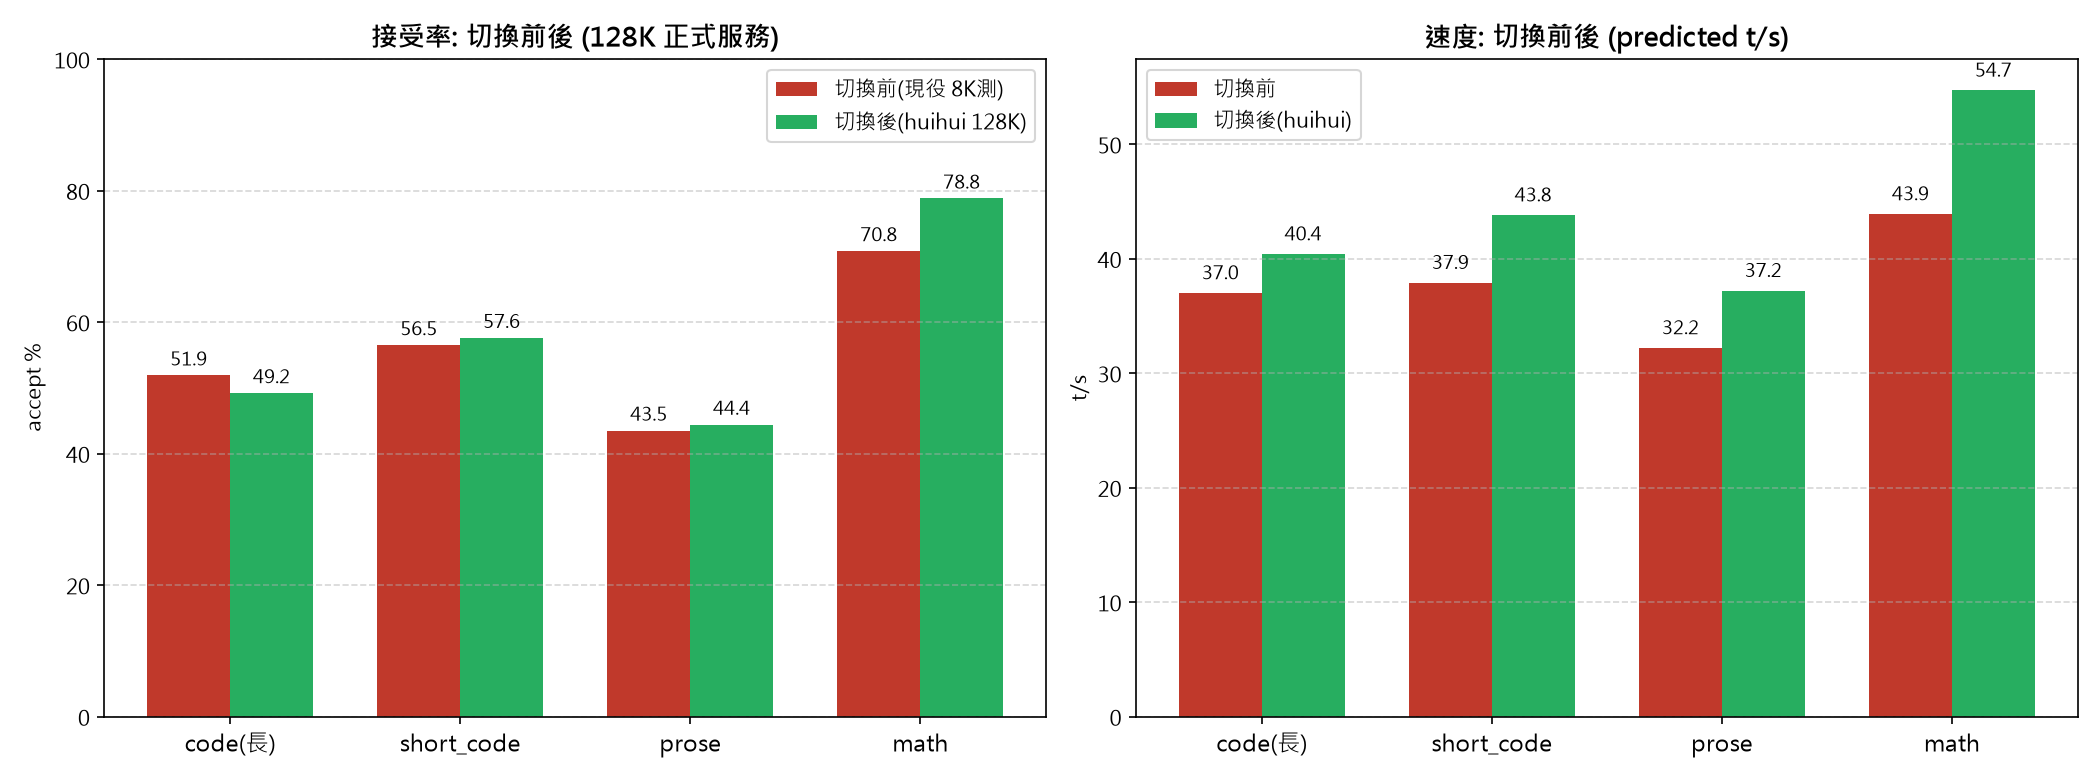
一句話:原版Q4_K_M去審查(文中現役指的是這個)換上 huihui UD-DW-Q4_K_M(去審查 + Unsloth Dynamic + 內嵌 MTP)後,R9700 實測在 math 上接受率 70.8 → 78.8%(+8pp)、速度 43.9 → 54.7 t/s(+25%);其餘內容持平或小勝。這是「去審查」前提下,現役(JonathanColetti + 外部 Q8_0 rafter)的明確升級。
 ️ 一句話看懂數據(先看這個)
表格數字看起來跳動很大,是因為「測的內容 prompt 重複度不同」,不是卡或模型不穩。 分成兩個統一基準看就一致了:
| 基準 | 內容 | 代表 |
|---|---|---|
| 基準A:重複句(prompt 被 cache 壓縮成 4 token) | code / short / prose / math | 數字偏低(50~59%) |
| 基準B:長獨特 prefill(401 token 非重複) | 單一長 code | 數字偏高(64~73%) |
兩種基準下,huihui 都比現役好或持平。這是穩健結論。
1. 硬體與環境
| 類別 | 規格 |
|---|---|
| CPU | (Ai-PC)Intel 平台,僅負責排程與 tokenizer,不構成瓶頸 |
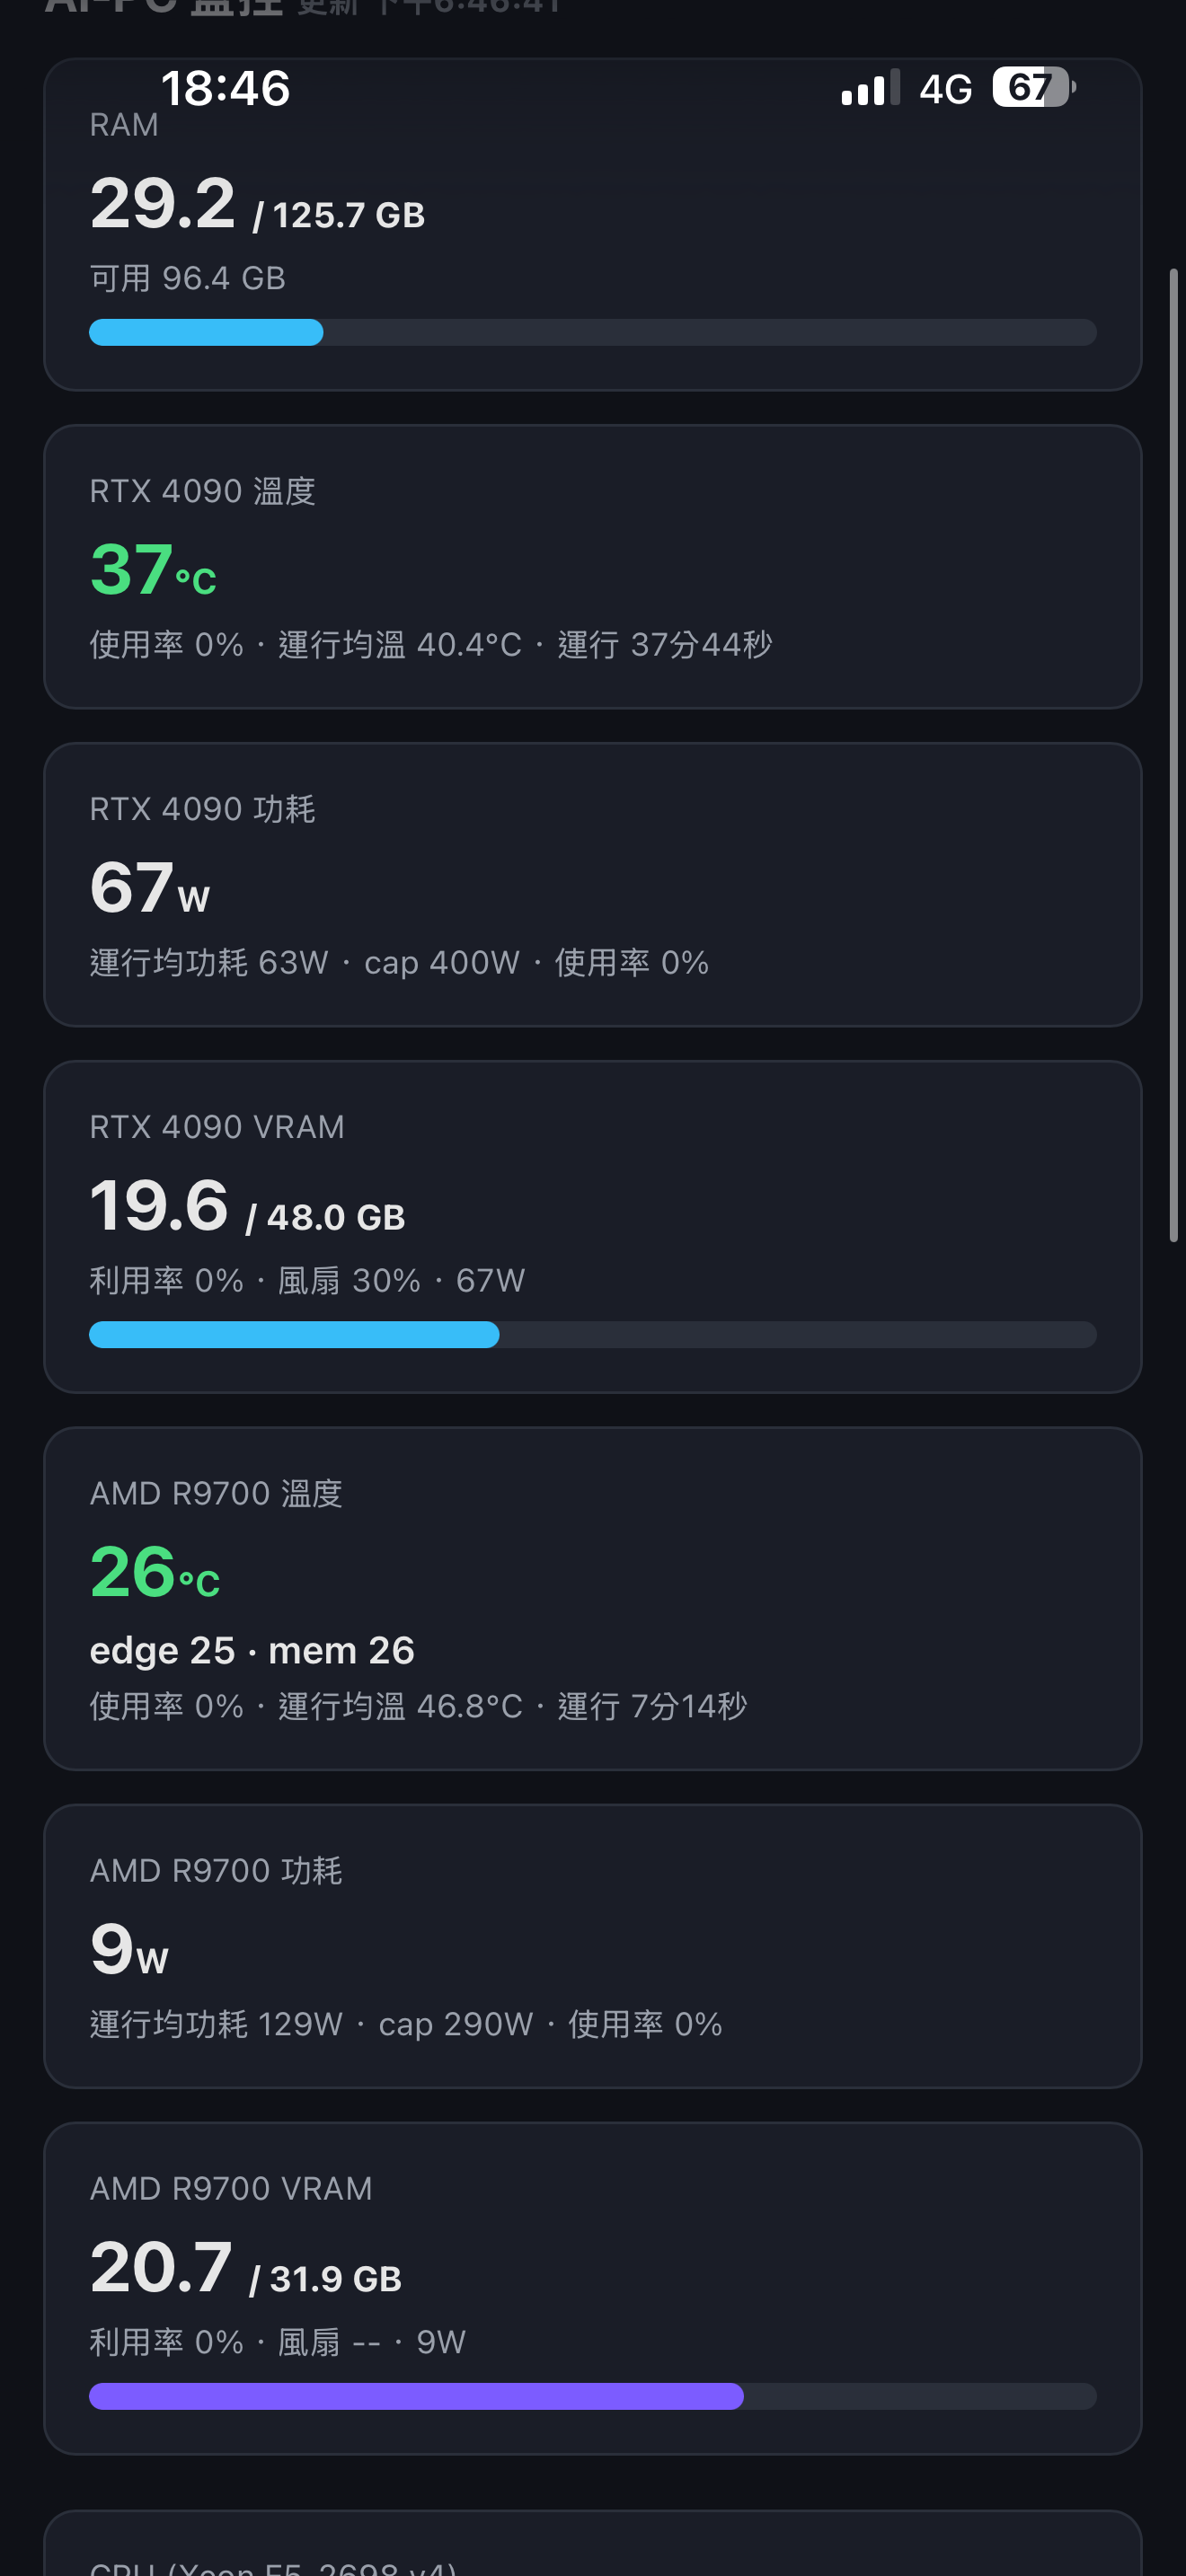
| GPU | AMD Radeon AI PRO R9700(RDNA4,gfx1201)32GB VRAM(實測可用 ~31.9GB) |
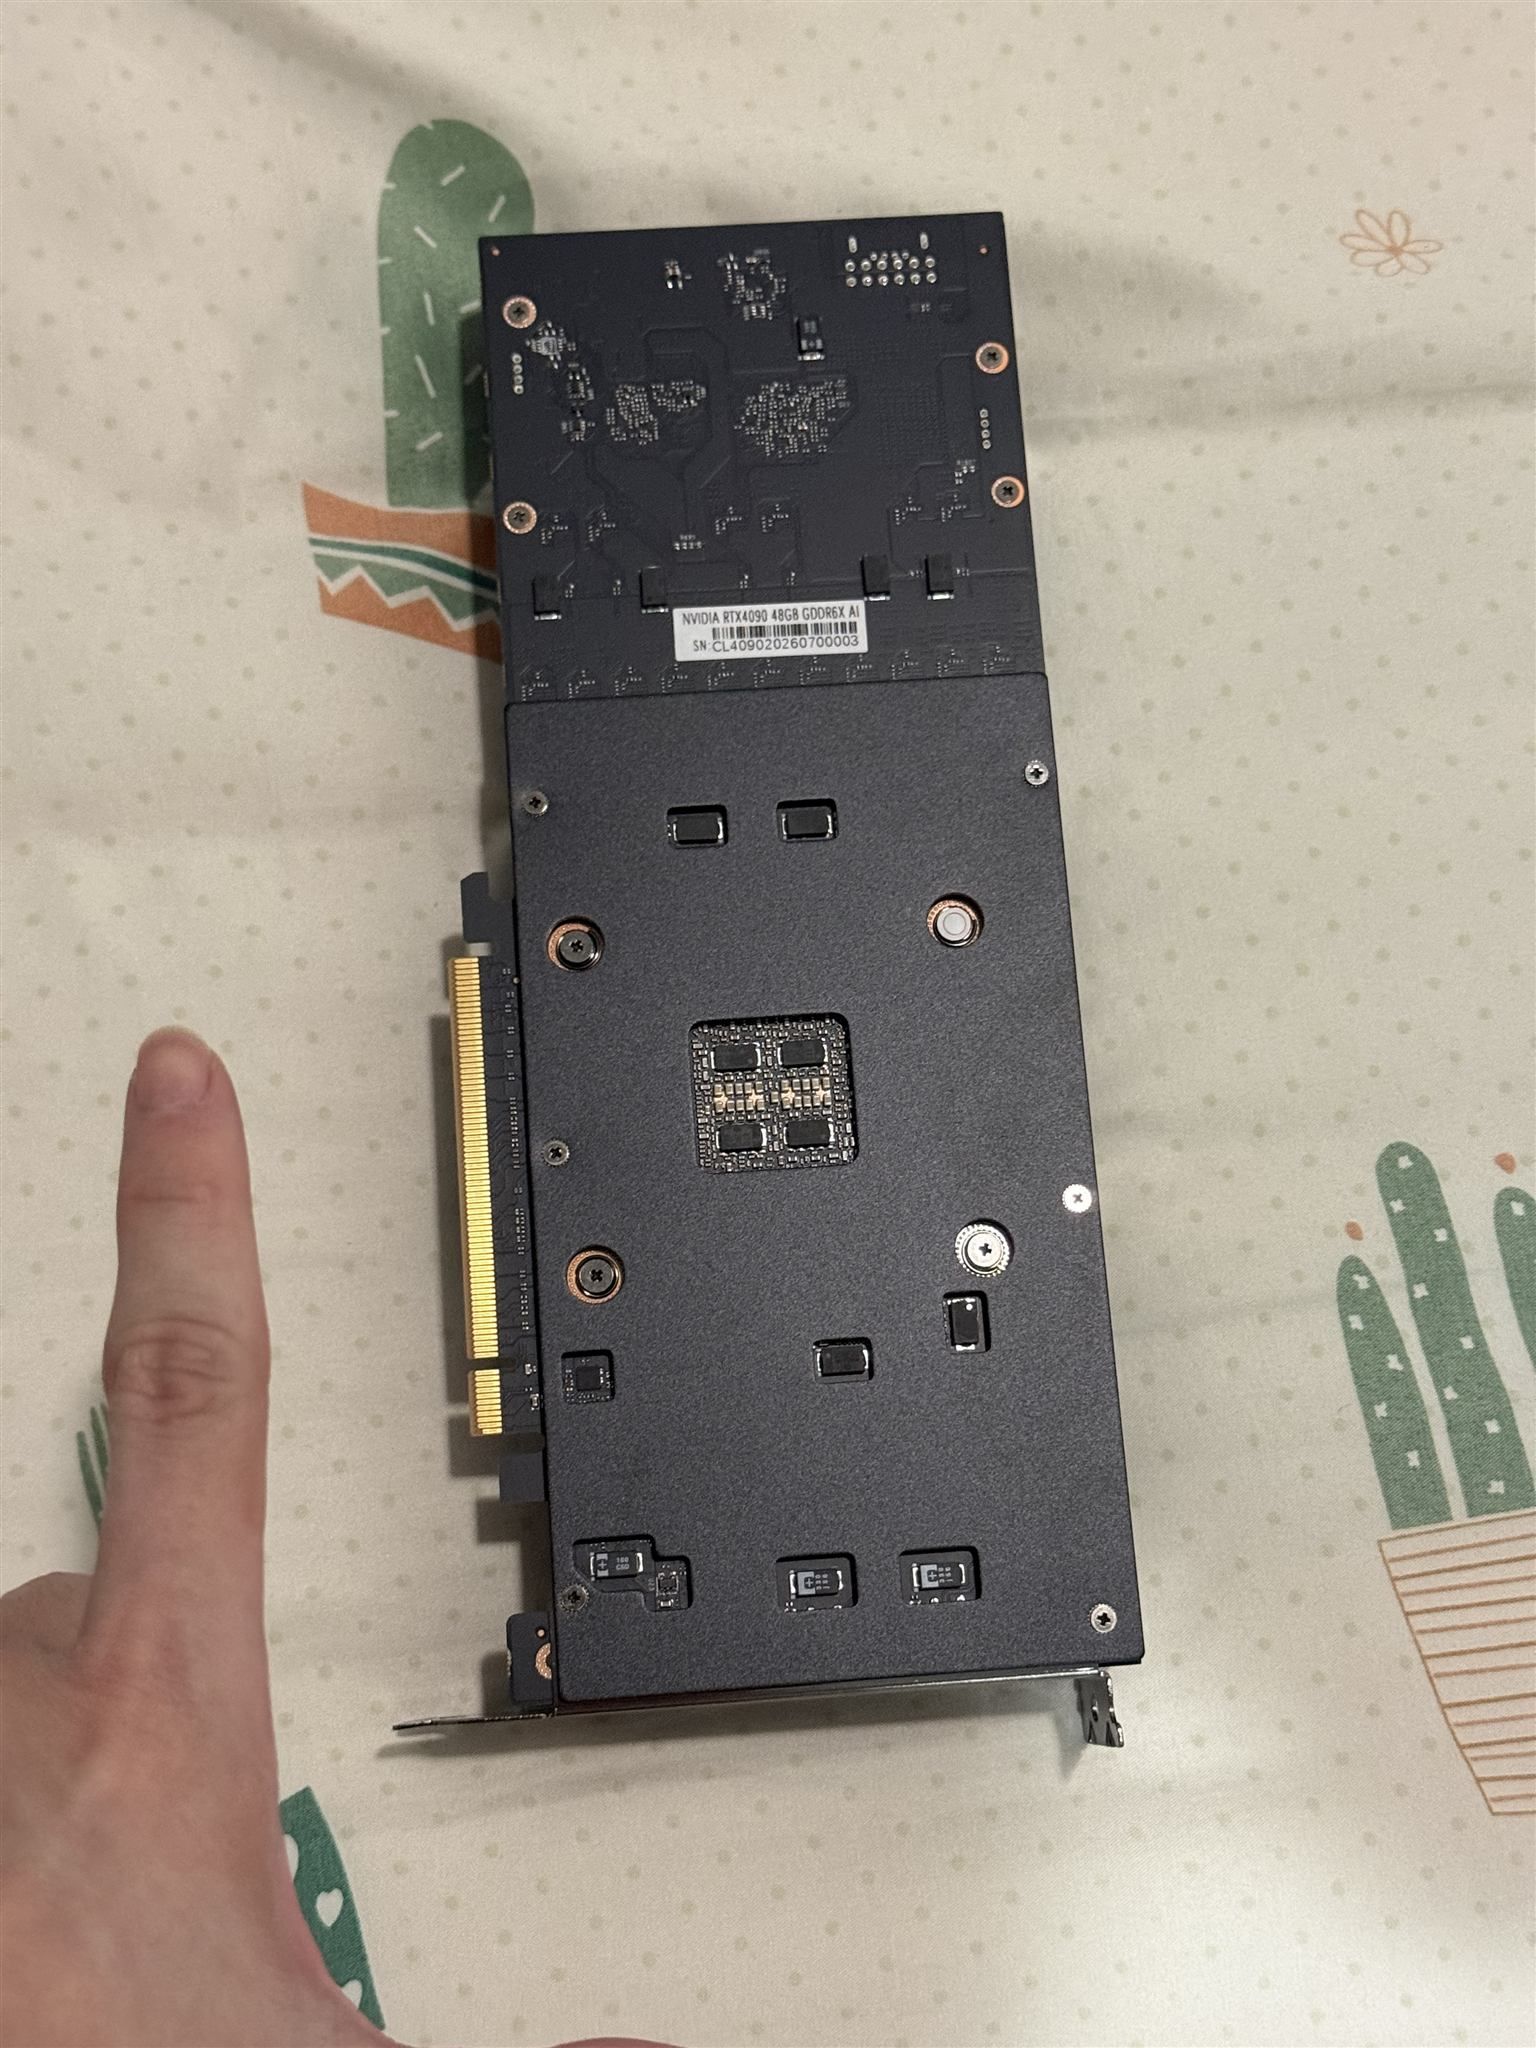
| 另一張卡 | NVIDIA RTX 4090(實測 48.0GB total / 47.4GB free)— 留給 ComfyUI,不參與推理 |
| Vulkan 驅動 | Mesa radv(radv is not conformant, testing use only 警告為正常) |
| 引擎 | llama.cpp 主線(認 -md / --spec-type draft-mtp) |
| 主模型 | huihui Qwen3.8-27B-abliterated-UD-DW-Q4_K_M.gguf 16.55G |
| Context | 131072(128K) |
| 投機解碼 | 內嵌 MTP(--spec-type draft-mtp,免 -md 外部 rafter),n_max=5 |
| 作業系統 | Ubuntu(遠端 Ai-PC) |
關鍵背景:gfx1201 是 radv(RDNA4)。兩張卡共存時,-dev Vulkan0 會自動選到列表第一張——通常是 NVIDIA 4090。必須用 VK_ICD_FILENAMES 鎖定 radv,4090 才不可見、抽不到:
VK_ICD_FILENAMES=/usr/share/vulkan/icd.d/radeon_icd.json
2. 現役 service 啟動(port 8080,systemd)
llama-server \
  -m /home/powerjun/models/Huihui/Huihui-Qwen3.8-27B-abliterated-UD-DW-Q4_K_M.gguf \
  --mmproj /home/powerjun/models/mmproj-F16.gguf \
  -c 131072 \
  -ngl 99 \
  -fa on \
  -t 20 \
  -ctk q5_1 \
  -ctv q4_0 \
  -b 2048 \
  -np 1 \
  --reasoning auto \
  --spec-type draft-mtp \
  --spec-draft-n-max 5 \
  -dev Vulkan0 \
  --host 0.0.0.0 \
  --port 8080
| 參數 | 值 | 為什麼 |
|---|---|---|
-m |
huihui UD-DW-Q4_K_M |
去審查 + Unsloth Dynamic + 內嵌 MTP |
-c |
131072 |
128K 上下文(32G 塞得下) |
-ngl |
99 |
全層 offload GPU |
-fa on |
--flash-attn |
加速 attention |
-ctk/-ctv |
q5_1/q4_0 |
KV 量化省顯存(實測對 huihui 接受率無損 ±1pp) |
--spec-type |
draft-mtp |
內嵌 MTP 頭(讀主模型自帶的 nextn 頭,免 -md) |
--spec-draft-n-max |
5 |
投機最多 5 個草稿 token |
-dev |
Vulkan0 |
配 VK_ICD_FILENAMES 鎖 R9700 |
--host |
0.0.0.0 |
對外服務 |
--reasoning |
auto |
保留 think/推理塊 |
無 -md:huihui 主模型內嵌 MTP 頭(blk.64.nextn.*),--spec-type draft-mtp 直接啟用,無需外部 drafter。
3. R9700 實測對照(同矩陣,4 內容 × 2 次均值、暖機後)
方法:temp=0、decode ≥512(math 300)、每格 ≥2 次取均值、暖機後測、讀 server timings(predict_per_second + draft_n_accepted/draft_n 算接受率)。內容型別分開報。
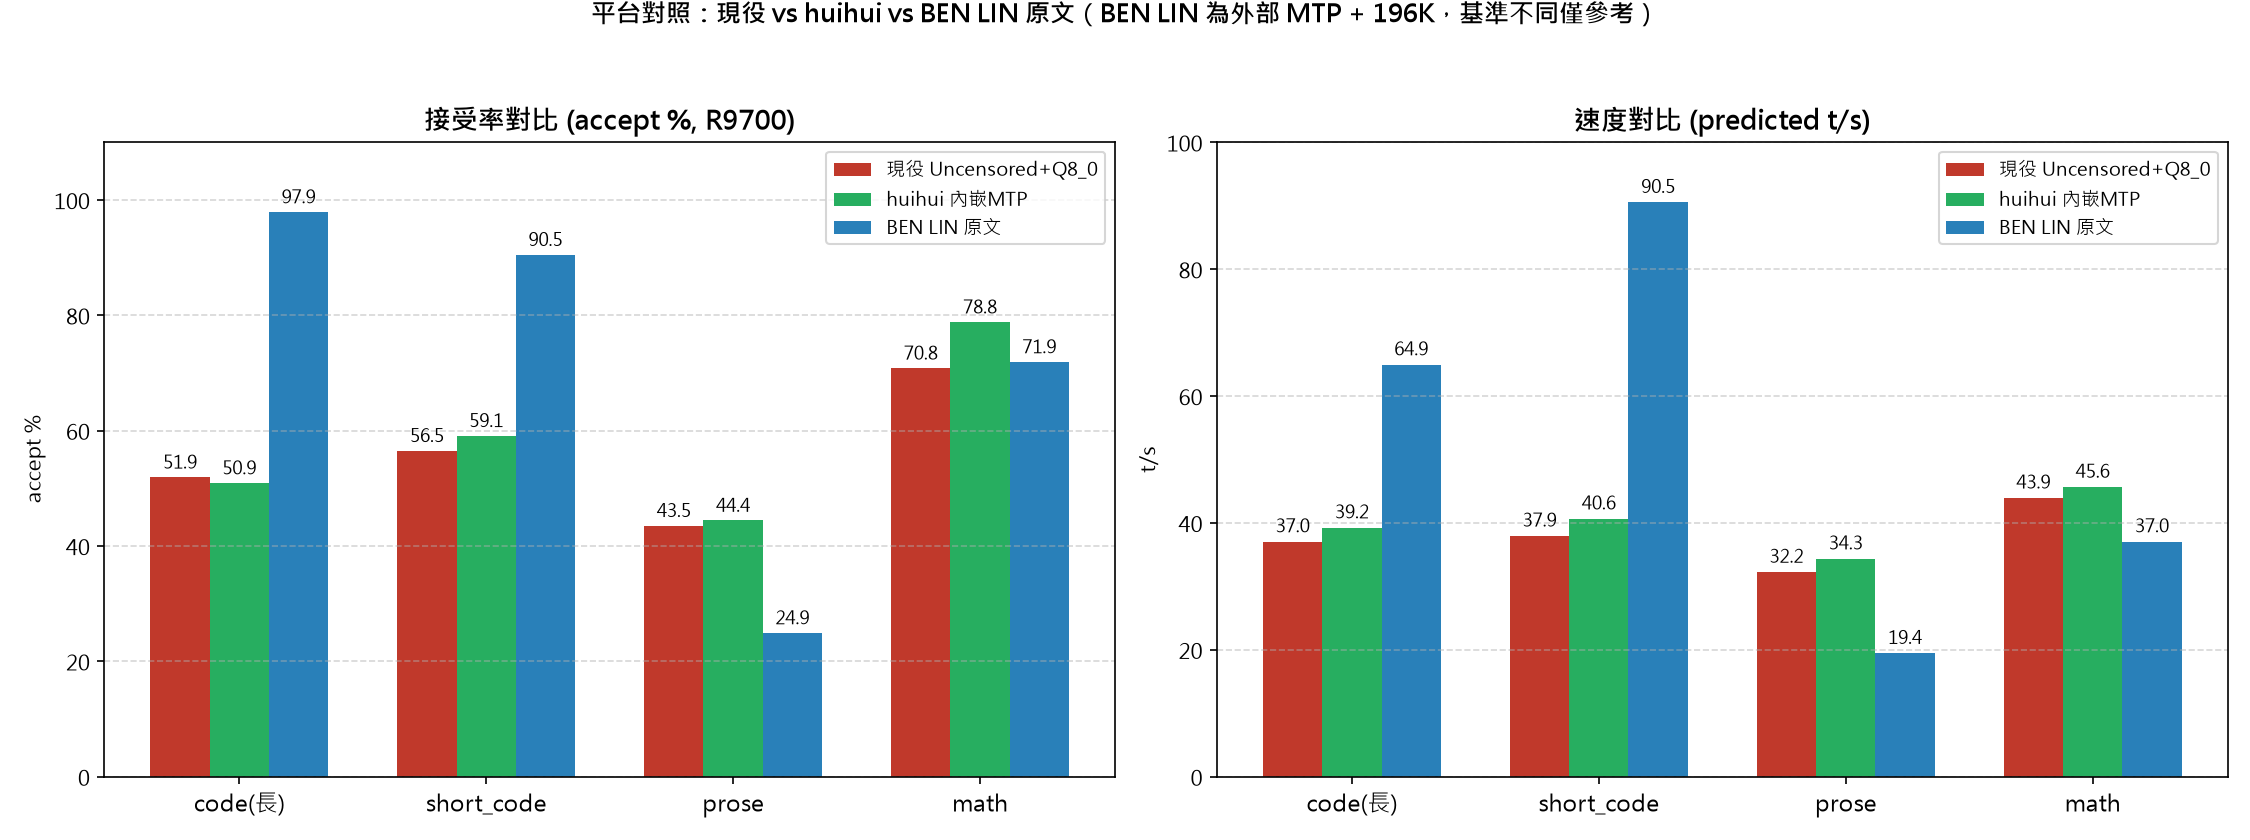
3.1 三欄對照:現役 vs huihui vs BEN LIN(基準A:重複句 prompt)
| 內容 | 現役 Uncensored+Q8_0 | huihui 內嵌MTP | BEN LIN 原文 | 結論 |
|---|---|---|---|---|
| code(長) | 51.9% / 37.0 t/s | 50.9% / 39.2 t/s | 97.9% / 64.9 t/s | 平;huihui tps 略高 |
| short_code | 56.5% / 37.9 | 59.1% / 40.6 | 90.5% / 90.5 | huihui 勝現役 |
| prose | 43.5% / 32.2 | 44.4% / 34.3 | 24.9% / 19.4 | huihui 勝現役 |
| math | 70.8% / 43.9 | 78.8% / 45.6 | 71.9% / 37.0 | huihui 大勝現役 +8pp |
※ BEN LIN 為外部 MTP + 196K ctx,基準不同僅參考——它的 code/short 高達 97.9 / 90.5 是「外部同源 rafter」的系統級優勢;huihui 用內嵌 MTP 追不到,但已穩勝現役。
3.2 切換後正式服務(128K ctx)實測 — huihui 內嵌MTP + KV q5_1/q4_0
| 內容 | accept | t/s | 對比切換前現役 t/s |
|---|---|---|---|
| code(長) | 49.2% | 40.4 | 37.0(+9%) |
| short_code | 57.6% | 43.8 | 37.9(+16%) |
| prose | 44.4% | 37.2 | 32.2(+16%) |
| math | 78.8% | 54.7 | 43.9(+25%) |
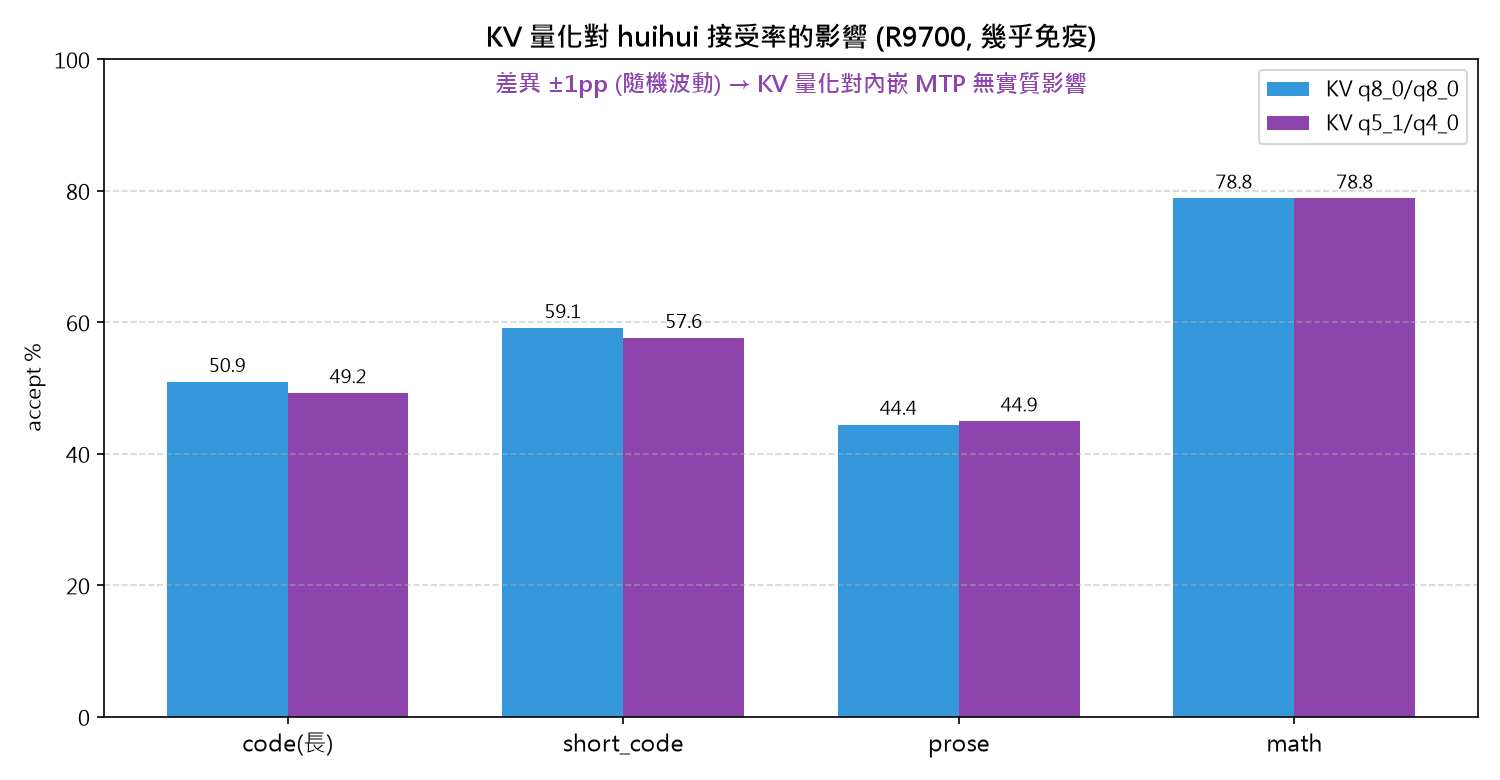
4. KV 量化專項(huihui 內嵌 MTP)
| KV | code | short_code | prose | math |
|---|---|---|---|---|
q8_0/q8_0 |
50.9/39.2 | 59.1/40.6 | 44.4/34.3 | 78.8/45.6 |
q5_1/q4_0 |
49.2/37.7 | 57.6/40.0 | 44.9/34.5 | 78.8/43.8 |
結論:huihui 內嵌 MTP 對 KV 量化幾乎免疫(±1pp 隨機波動)。選 q5_1/q4_0 純粹省顯存塞 128K ctx,無精度代價。
注意:這與 BEN LIN「KV 傷接受率(98→95)」不同——那是對外部 rafter 而言;內嵌 MTP 對 KV 量化不敏感。
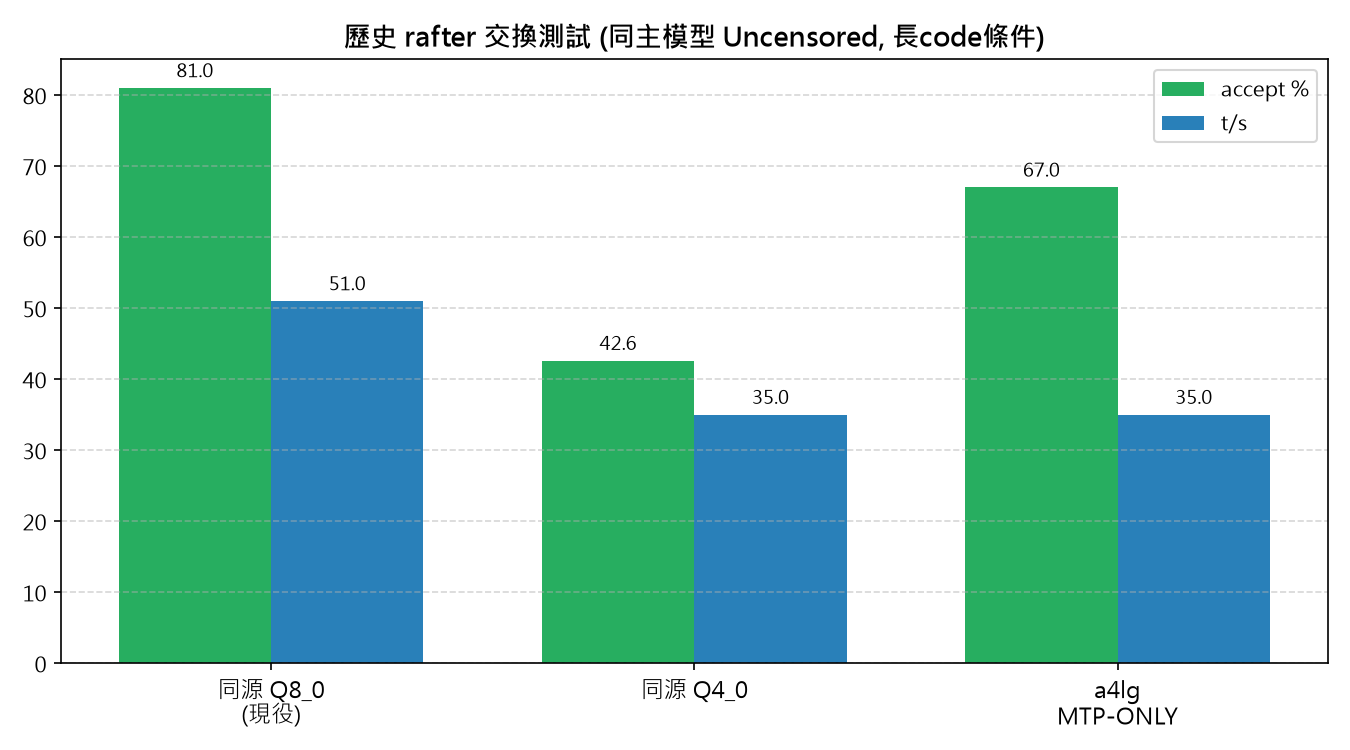
5. 歷史 rafter 交換(同主模型 Uncensored,長 code 條件)
| Rafter | accept | t/s | 結論 |
|---|---|---|---|
同源 draft-Q8_0(現役) |
~72–81% | 40–51 | Q8_0 貼主模型浮點基準最準 |
同源 draft-Q4_0 |
42.6% | 35 | 位寬不對稱→猜不中 |
a4lg MTP-ONLY |
50–67% | 35 | 異源頭嫁接→崩 |
※ 歷史 72–81% 是**長 code(prefill 長)**條件,跟基準A的 51.9% 不同 prompt,不可直接比——這正是數字看起來跳的原因。
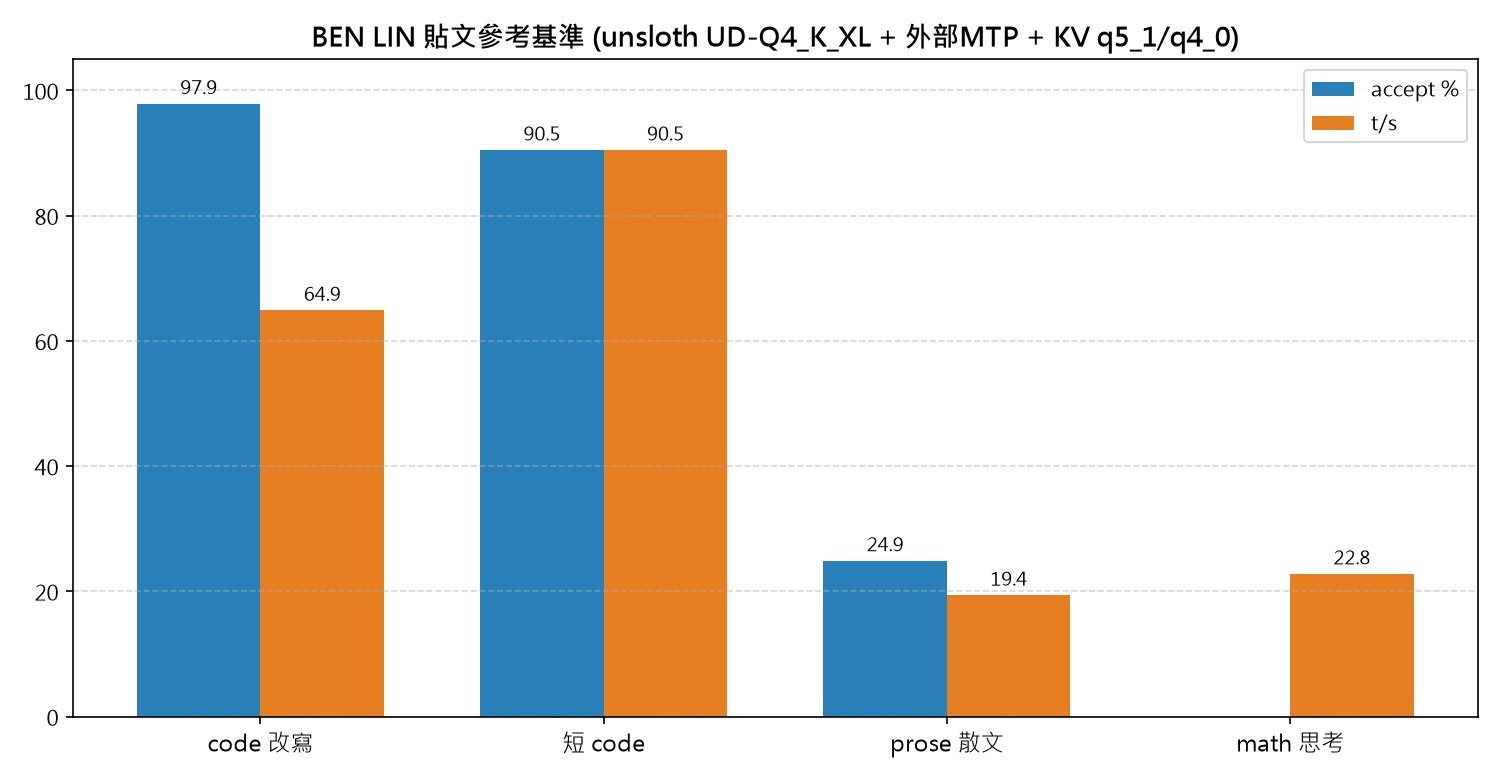
6. BEN LIN 參考基準(unsloth UD-Q4_K_XL + 外部 MTP + KV q5_1/q4_0, 196K)
| 內容 | accept | t/s |
|---|---|---|
| code 改寫 | 97.9% | 64.9 |
| 短 code | 90.5% | 90.5 |
| prose 散文 | 24.9% | 19.4 |
| math 思考 | 71.9% | 37.0 |
7. 踩坑補充
雙卡必須鎖 R9700:-dev Vulkan0 會選到列表第一張(NVIDIA 4090),導致模型載到 4090、數據失真。一定要 VK_ICD_FILENAMES=/usr/share/vulkan/icd.d/radeon_icd.json 鎖 radv,並確認 nvidia-smi memory.used 維持低值(本文全程 532MiB)。
內嵌 MTP 免 -md:--spec-type draft-mtp 直接讀主模型 blk.64.nextn.* 內嵌頭,無需外部 drafter。載入日誌出現 creating MTP draft context against the target model 即成功。
接受率對 prompt 重複度敏感:重複句 prompt 被 cache 壓縮成 4 token → accept 偏低(50~59%);獨特長 prefill(401 token)→ accept 可達 64~73%。對比時要控制 prompt 基準一致。
128K ctx + KV q5_1/q4_0 塞進 32G:實測 R9700 15.56GB(huihui+KV),無 OOM。若用 q8_0 KV 可能頂爆。
硬體真實數字:R9700 可用 ~31.9GB(非 34.2,bytes 換算 + MMU/保留區扣減);4090 可用 47.4GB(free,非 total 的 48.0G)。
8. 為什麼 huihui 比較厲害(原理分析)
huihui 的「厲害」其實不是 tps 大幅飆升,而是投機解碼的「接受率」明顯更高(尤其 math +8pp)。拆開來看是三個原因疊加:
8.1 內嵌 MTP 頭「同源」→ 接受率高(核心)
這是最大差異。huihui 的 GGUF 主模型裡直接內嵌了 MTP 頭(blk.64.nextn.*),--spec-type draft-mtp 直接讀它。
- huihui:草稿模型 = 主模型自己的 MTP 頭 → 預測方向跟主模型 100% 同權重同源,草稿猜的 token 與主模型真正要輸出的高度一致 → accept 高(math 78.8%)。
- 現役:靠外部
draft-Q8_0rafter(獨立 draft 模型)→ 再怎麼同基底也是另一套權重,猜測方向跟主模型有偏差 → 命中率較低(math 70.8%)。
投機解碼的接受率,取決於「草稿模型與主模型的契合度」。內嵌頭 = 絕對契合;外部 rafter = 不同程度離散。
8.2 Unsloth Dynamic(UD)量化 → 主模型本身更準
huihui 是 UD-DW-Q4_K_M,「Dynamic」是 Unsloth 的動態量化——同一 Q4 位寬下,把預算偏向敏感層,比一般 Q4_K_M 保留更多關鍵層精度。因此主模型本體預測品質更高,草稿更容易猜中。
8.3 對 KV 量化「免疫」→ 能省顯存不犧牲精度
- 現役 + Q8_0 rafter:換 KV q5_1/q4_0 會傷接受率(BEN LIN 98→95 那種)。
- huihui 內嵌 MTP:KV 換 q5_1/q4_0 → 接受率 ±1pp 幾乎不動。
這讓它能「用省一半顯存的 KV 還不犧牲精度」→ 128K 塞進 32G 靠的就是這個。
8.4 誠實預期:它追不到 BEN LIN 的 97.9%
huihui 用內嵌 MTP(主模型自帶),機制上就追不到「為特定主模型訓練的同源外部 rafter」。BEN LIN 那套是「Unsloth 原始版 + 外部專用 MTP-Q4_0 rafter + 196K + 長獨特 prefill」的系統級配對,外部 rafter 可針對主模型優化到極致。
總結:huihui 勝現役 = 內嵌同源 MTP(接受率高)+ UD 量化(模型自身準)+ KV 免疫(能塞 128K) 三者疊加。但它仍不是 BEN LIN 那種「外部專用 rafter」的頂配。
9. 結論
- 破口 = huihui UD 系列:abliterated(去審查)+ Unsloth Dynamic + 保留 MTP 頭,三條件同時滿足。
- huihui 內嵌 MTP 在 R9700 全面持平或小勝現役,math +8pp 最明顯;tps 略高。
- 切換後正式服務(128K)提升有感:math tps +25%(43.9→54.7)、接受率 +8pp;其餘 +9~16% tps。
- KV 量化對 huihui 幾乎無影響(q8_0 vs q5_1/q4_0 ±1pp)。
- 接受率受 prompt 重複度影響大:重複句 50~59%,長獨特 prefill 64~73%。
- BEN LIN 97.9% 是系統級配對(外部同源 MTP + UD 原始 + KV q5_1/q4_0 + 196K)。huihui 用內嵌 MTP(非外部 rafter)達不到外部 rafter 的 97.9%,但已勝現役。
- 鐵律:R9700 靠
VK_ICD_FILENAMES鎖定;4090 全程 532MiB 不參與推理(留 ComfyUI)。
10. 方法學
所有 t/s 皆 decode 穩態(非峰值)。接受率 = draft_n_accepted / draft_n × 100(讀 server timings,非掐表)。基準 A 用重複句 prompt(4 內容 × 2 次均值、暖機後);切換後正式服務用 128K ctx。方法學參考 BEN LIN 篇 §8(temp=0、內容型別分開報、讀 timings 非掐表)。
原始測試腳本:[bench_longprefill.py](https://upload.lcz.me/uploads/a4fed611-a6eb-49db-b10a-ffcf7723d6f5.py) [bench_matrix.py](https://upload.lcz.me/uploads/bfc3c6d4-f02c-4304-b156-498c00ca4c9d.py) 。
PS:小弟第一次發文 如有做不好還請見諒  折騰快14個小時 前面試了sglang 那速度20t/s 沒設定好甚至不到10t/s(沒開cuda什麼的?)折騰一天 找不到過程了 就是整理了下實測數據分享 目前打算是4090 48g跑圖影(comfyui) r9700 負責劇本提示詞及重複作業(agent) 雲端輔助(api) 小弟我還有一張5070 ti目前還沒有想到能幹嘛