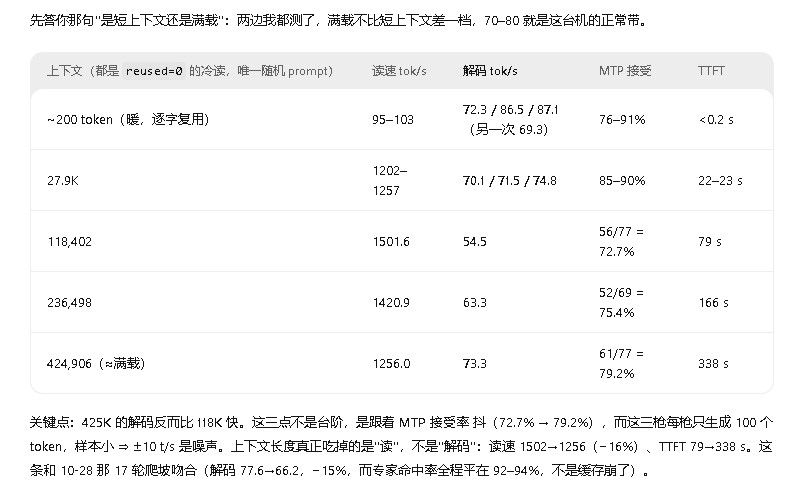
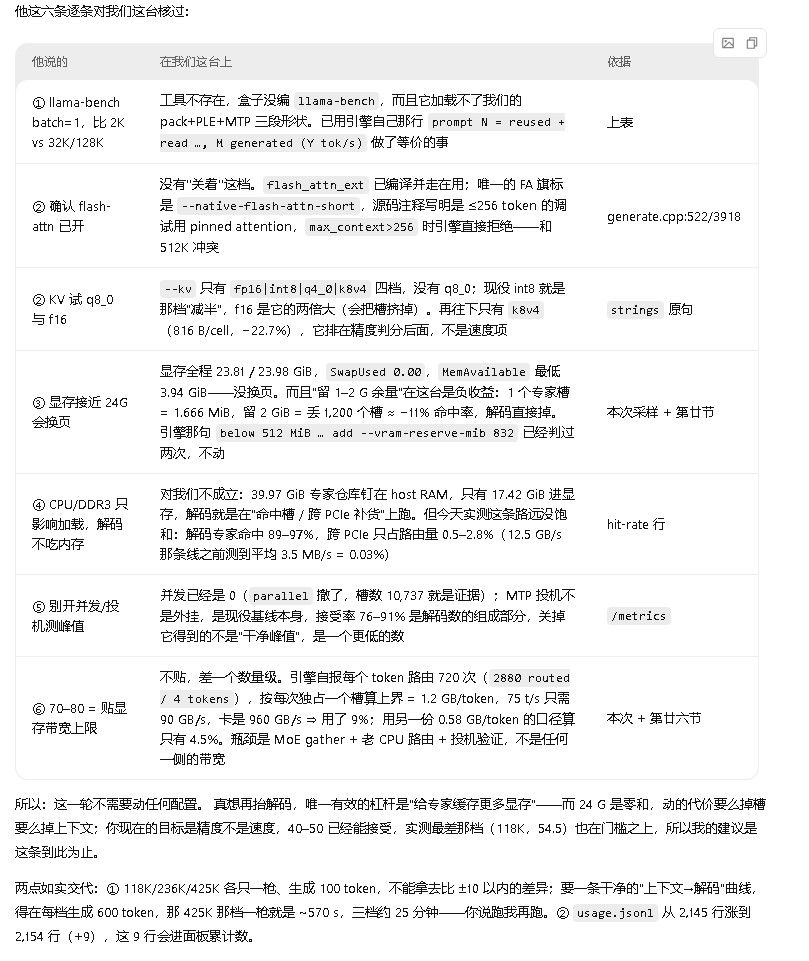
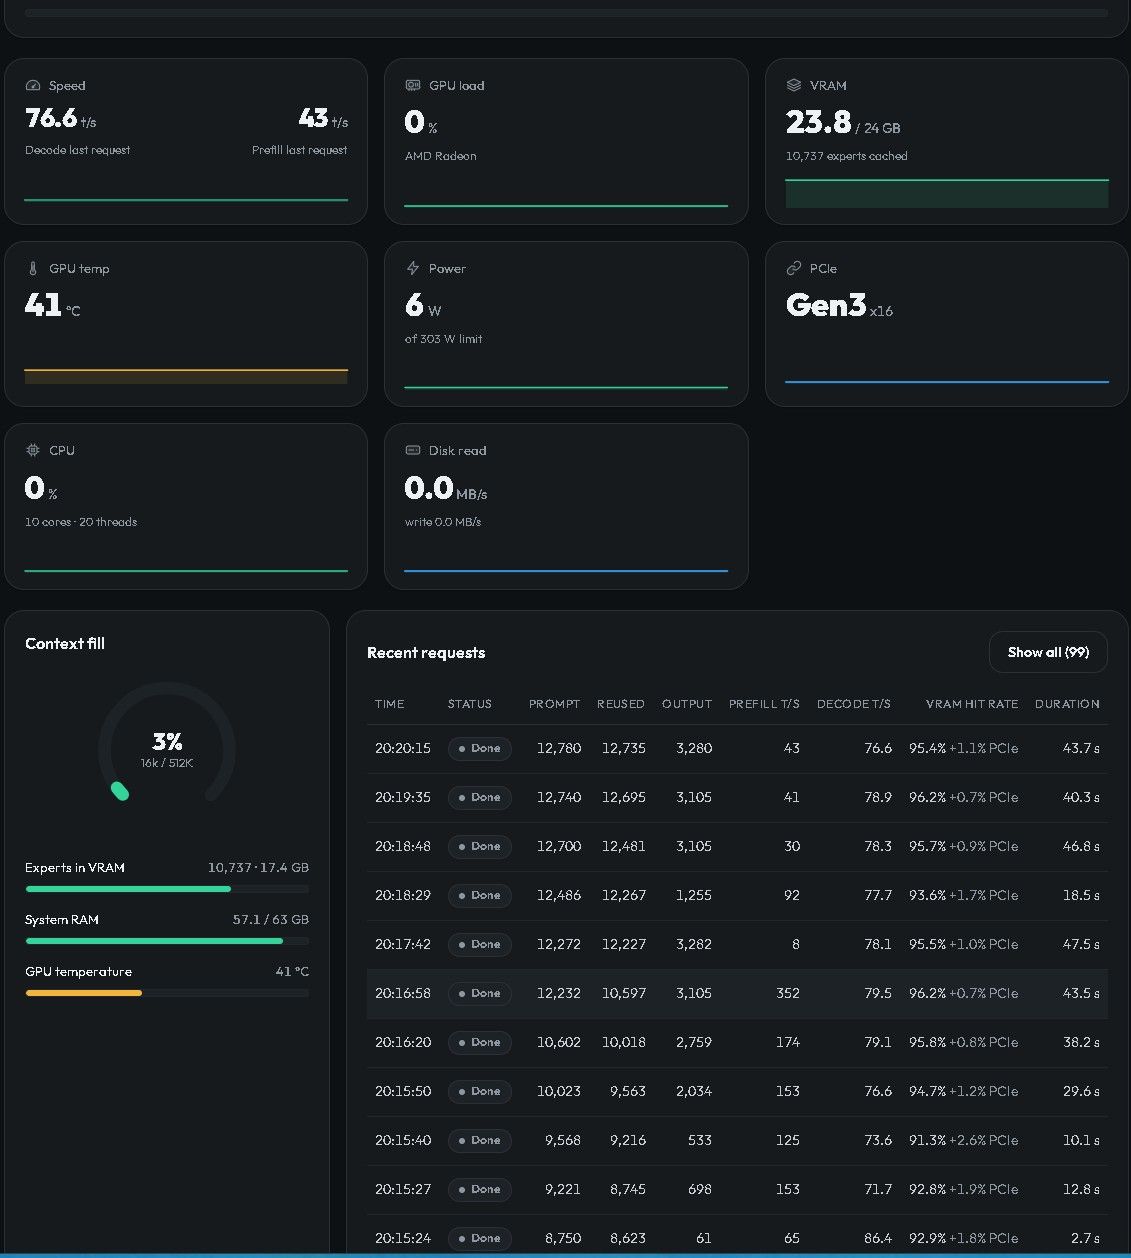
@rongda-weng 抄作业就好了,基本7900xtx大家都用 nicejunjie的rdna3 folk。刚测了一下,decode比最新的strata快15%的样子
让ai试过了,结果都是更差,都是负收益
 M
== 硬件 ==
CPU : Intel Xeon E5-2686 v4 @ 2.30GHz(Broadwell,18核36线程,有 AVX2+FMA,无 AVX-512)
主板 : X99 / C612
内存 : 4×16GB DDR3 ECC REG,四通道 1DPC,BIOS 锁 1866(有效带宽实测约 10.9 GB/s)
显卡 : AMD Radeon RX 7900 XTX,gfx1100 / RDNA3,24GB VRAM(rocm-smi: Total 25.75GB / Used 25.61GB)
存储 : NVMe(nvme0n1,实测读约 2.5 GB/s)
系统 : CachyOS(Arch 系),内核 7.2.7-1-cachyos
== 软件 ==
推理引擎 : Strata(serve v0.2.10;引擎 0.1.56,本机源码 AVX2 自编译,
ROCm : 无系统级 ROCm,走 pip bundled SDK(_rocm_sdk_devel + _rocm_sdk_libraries_gfx110X_dgpu,7.10.0),GEMM 经 hipBLASLt
模型 : Unsloth Qwen3.8-Flash-Next UD-IQ4_XS(MoE,3-shard GGUF;专家总量 55.4 GiB,Dynamic IQ4_XS 量化)
== 启动参数 ==
--pack /home/phuai/Strata-data/packs/iq4_xs_abl
--native .../unsloth-UD-IQ4_XS/Qwen3.8-Flash-Next-UD-IQ4_XS-00001-of-00003.gguf
--expert-profile .../data/expert-profile.bin
--expert-cache 12000
--prefill auto:16384
--spec 4 --spec-min-p 0.7
--mtp .../SC117/strata/rt
--max-context 393216
--kv int8 --kv-resident 20480
--vision
--expert-profile-save .../data/expert-profile.live.bin --expert-profile-save-every 15
--adapt-every 1 --adapt-swaps 160 --adapt-decay 0.99
--resident-budget-gib 46
--conversation-cache-mib 4096
--rope-scaling yarn --rope-scale 1.5 --yarn-orig-ctx 262144
--tail-role-token 8678
== 环境变量(9 键)==
STRATA_HIPBLASLT_TUNING=.../tools/hip/gfx1100-hipblaslt-100200.txt
STRATA_HC_Q8=1
STRATA_KVA=1
STRATA_ATTN_LANECELL=1
STRATA_GDN_HEAD=1
STRATA_GDN_PP=2
STRATA_GDN_CONVL2=1
STRATA_GDN_NOY=1
STRATA_CVEC_FUSE=1
== 当前实测指纹 ==
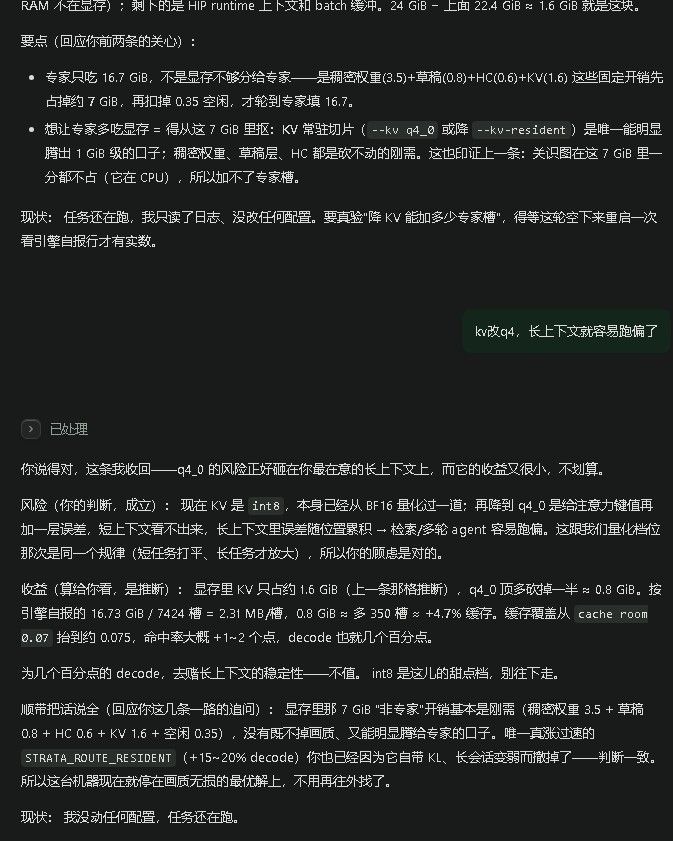
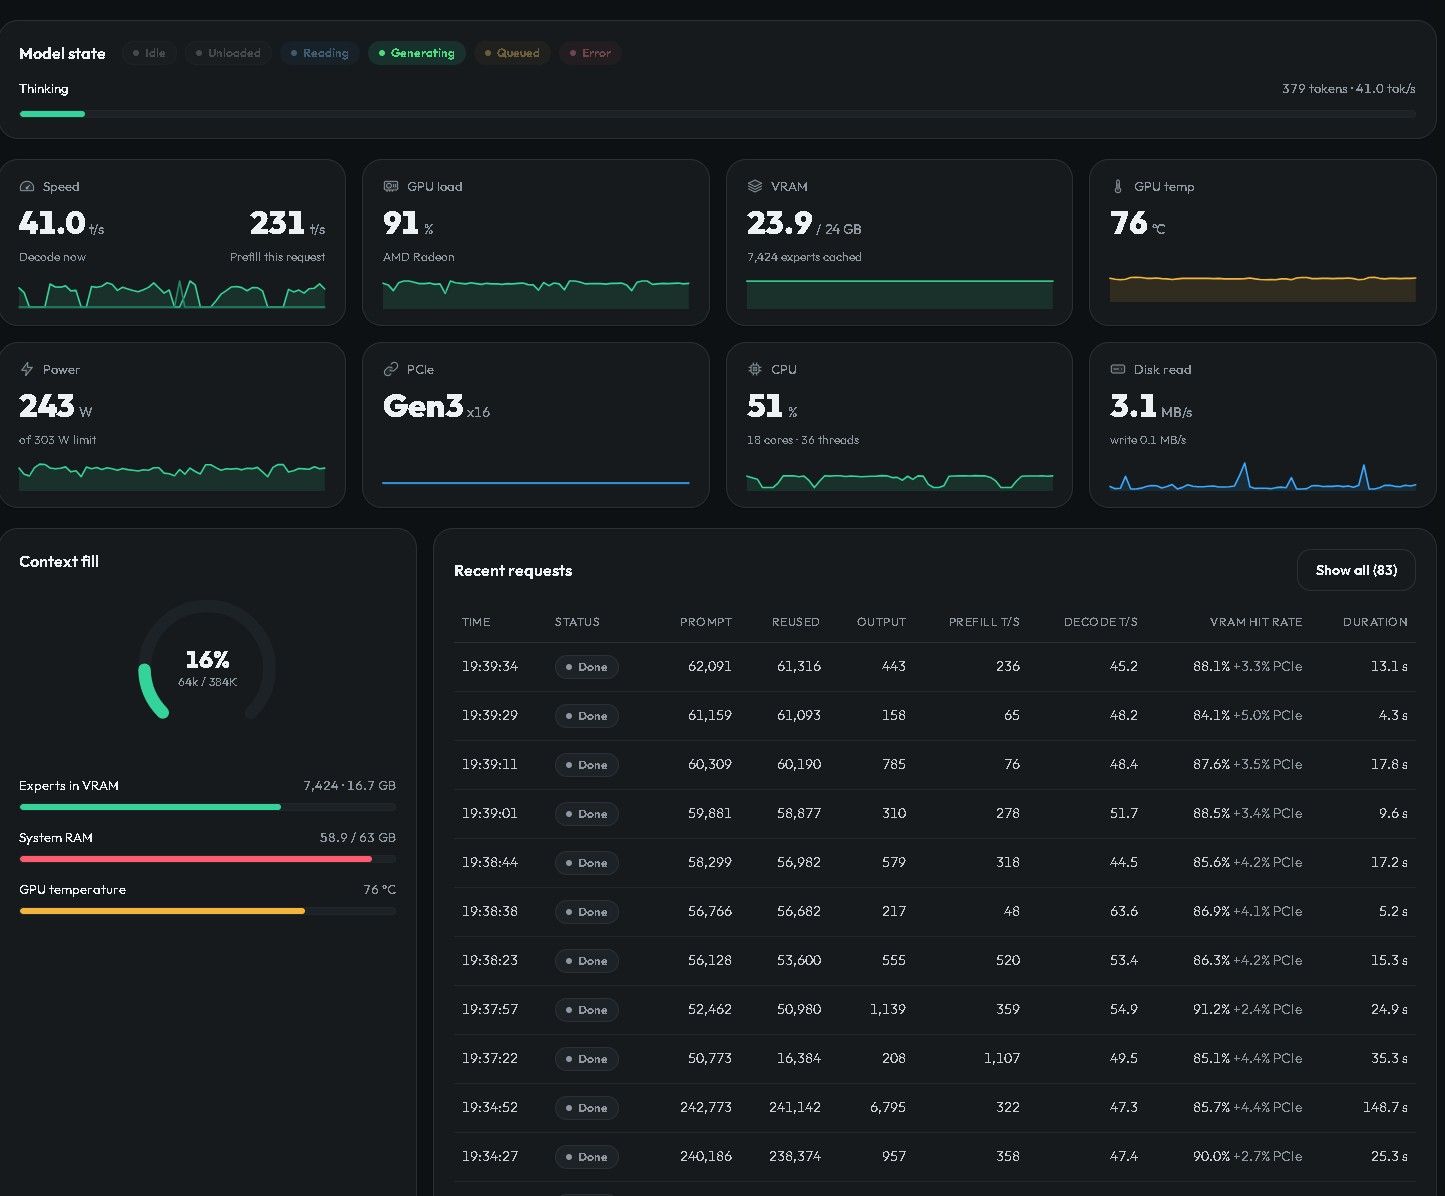
GPU 专家缓存 7424 槽 / 16.73 GiB;显存空闲 356 MiB
RAM 常驻专家 45.50 GiB(page-locked),0 次文件读
decode 命中 86–88%,decode 约 47–56 tok/s,冷 prefill 约 1150 tok/s
瓶颈:只有约 7% 专家进得了显存缓存(cache room 0.07),其余走 RAM VRAM 换入
抄 Wang Wei(lcz.me #2804)两套配置实测 vs 基线
臂改动引擎账本 decode 中位草稿接受率结果基线现役 0.1.56 配置53.1(52.4–54.6)~80%参照B(全抄)+expert-cache auto / prefill auto:32768 / kv-resident 32768 / vram-reserve 3072~42.2(41.6–43.3)63–69%−21%A(只抄可移植)+pool-workers 30 / spec-min-p 0.5 / adapt-decay 0.97 / PF_SWITCH_MIN_T 4096 / IO_THREADS 3250.7(49.1–54.7)62–69%−4.5%仪器:probe_speed.py 1024 6,六轮 out=1024 全干净,取引擎账本 decode 列。为什么输
B:expert-cache auto + vram-reserve 3072 把 GPU 专家缓存从 7498 槽压到 ~6204,非专家显存预留又挤掉缓存 → 命中下降;spec-min-p 0.5 同时把接受率打掉。两个负面叠加 = −21%。他那台是双 7900XTX 用 GPU0、峰值 RAM 104 GB,显存/内存预算比我们宽得多,auto 对他安全、对我们是降级。
A:唯一实质伤害是 --spec-min-p 0.5(我们 0.7)——接受率 80%→65% 直接把 decode 拖到 50.7。pool-workers 30/PF_SWITCH_MIN_T/IO_THREADS 在本机短提示测不出红利(他的收益在 prefill 侧、且依赖 hipBLASLt 表命中)。
决定:两臂都没跑赢,已全部回退,配置字节级等于备份基线(226d2892)。按规矩不写上游档。