
@Bunsei 好的,谢谢你的帖子!你们竟然都睡得那么晚 ,困了,撑不住了。
-
Qwen3.8-双R9700部署与评测全记录(一共测试了 4 个模型,分 4 轮进行。) -
Qwen3.8-双R9700部署与评测全记录(一共测试了 4 个模型,分 4 轮进行。)Qwen3.8 双 R9700 部署与评测全记录(一共测试了 4 个模型,分 4 轮进行。)
年龄大了,懒!(太晚、太累!就不上图了,关键是操作不好并已被警告两次)直接贴结果及上作业大家一起交流学习,不喜也请手下留情(本人小白)。
首先感谢:
锤哥提供的学习平台和Bunsei大佬的帖子及各位同仁,有一部分都是借鉴了各位的帖子做的部署。
覆盖范围:硬件核查 → 方案调研 → 模型下载与校验 → 方案① 部署 → 端口迁移 → 多轮基准测试(44 题 / 65 题 / 210 题)→ 统计结论与建议
目录
- 服务器硬件与软件清单(实测)
- 方案调研与选型(含参考来源)
- 文件下载与完整性校验
- 方案① 部署:Radiance + Qwen3.8-27B-FP8(TP2)
- 端口迁移与端口规划
- 模型清单扩充(MXFP4 下载、BF16 不可得)
- 重点模型详解:qwen3.8-next-flash-fp8-iq4r-moe.rad
- 第一轮:A/B 对比(FP8 vs MXFP4,10 题)
- 第二轮:全模型基准 v1(4 模型 × 44 题 + 速度)
- 评测框架设计(严格版)
- 第三轮:严格评测 v1(65 题,Bootstrap CI)
- 第四轮:Phase-2 精细评测(210 题,配对统计)
- 统计结论汇总(三轮合并)
- 部署建议与选型
- 附录 A:脚本与命令清单
- 附录 B:文件与路径索引
- 附录 C:错误、坑与修正记录
1. 服务器硬件与软件清单(实测)
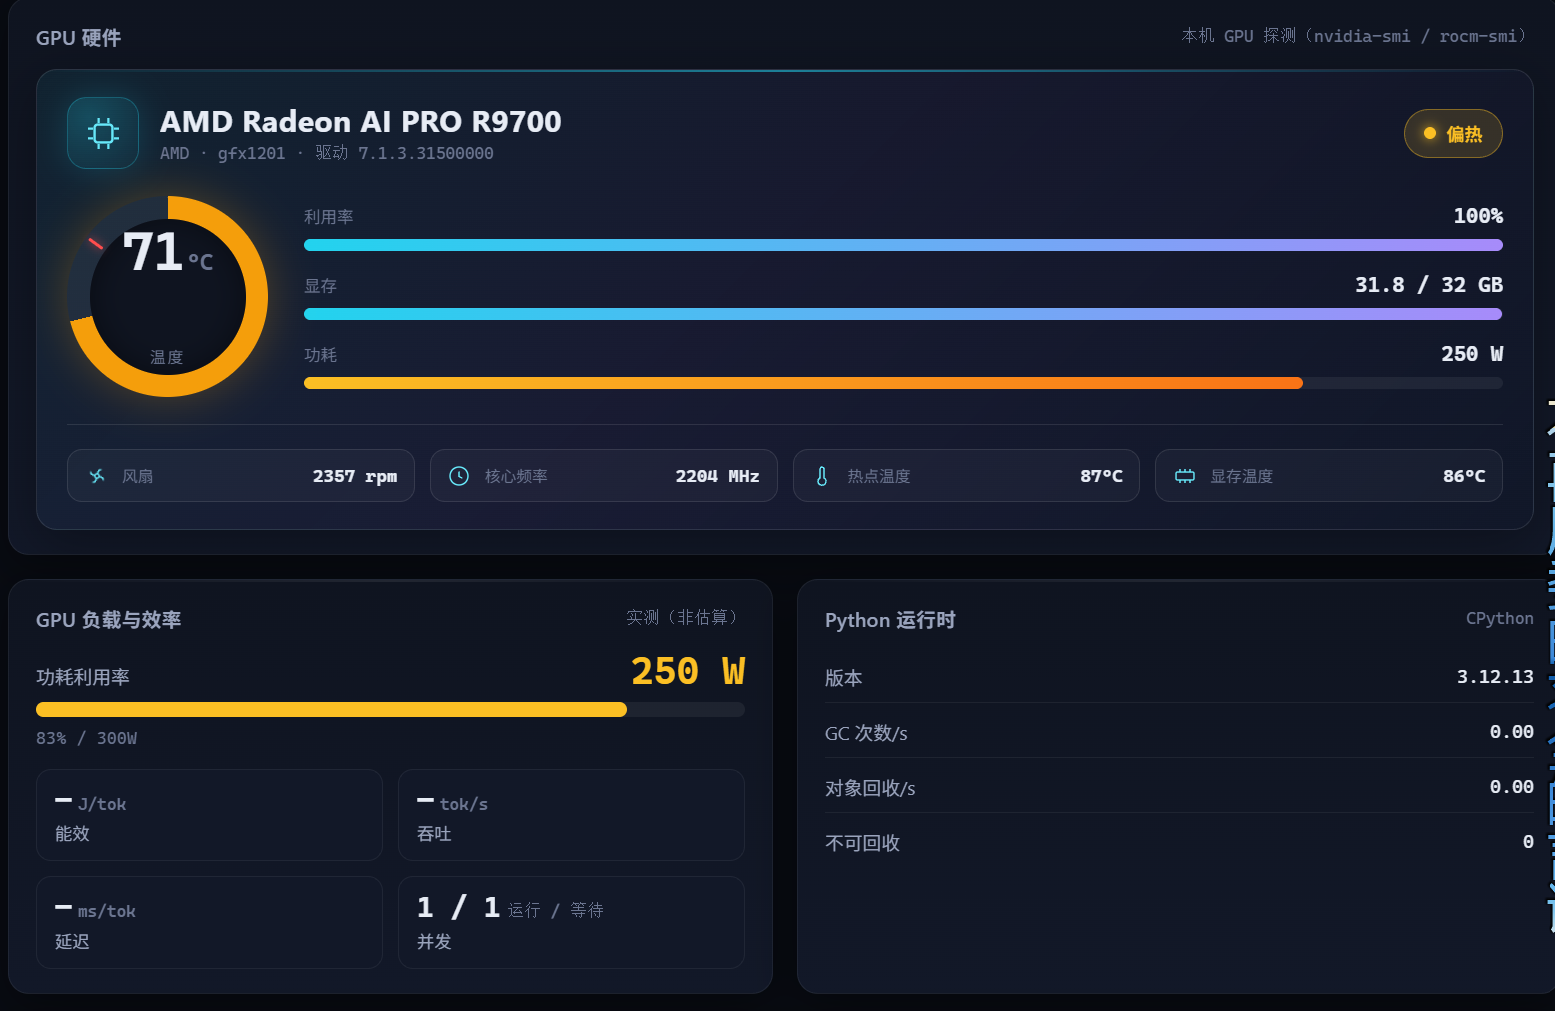
项目 实测值 GPU 2× AMD Radeon AI PRO R9700(gfx1201 / RDNA4),每卡 32 GB,合计 64 GB CPU Intel Core Ultra 7 265K(20 核 / 28 线程,无 AVX-512 → AVX2) 主板 技嘉 Z890 AERO G 内存 62 GiB DDR + 39 GiB swap 磁盘 NVMe 915 GB(根分区 nvme0n1p2),起始余量 487 GB系统 Ubuntu 24.04,kernel 7.0.0-38,amdgpu 驱动 7.1.9,ROCm 7.1( /opt/rocm)容器 Docker + Compose;镜像 stilldeadcode/radiance(初始 1.8.1,后升级 1.11.0)网络 PCIe 探测 28.6 GB/s host→device;双卡 P2P 正常 关键约束:64 GB 显存 < Flash-Next 权重体积(FP8 约 122 GB),因此 125B 模型必须「显存 + 主机内存 + NVMe」三级放置。
2. 方案调研与选型(含参考来源)
2.1 候选引擎对比
引擎 适配 gfx1201 结论 官方 vLLM / SGLang 仅官方支持 CDNA(MI 系列) 不可直接用于 RDNA4 llama.cpp + ROCm 有已知显存分配 bug(llama.cpp #26208) 本机实测 Q8_0 仅 18.9 tok/s,弃用 Radiance(StillDeadcode) 专为 R9700 手写 libr4d kernel 采用(27B 与 Flash-Next 均支持) Strata(GGUF 专家流式) 支持 采用(Flash-Next IQ3_S 路线) 2.2 关键参考
- Radiance 引擎仓库:https://codeberg.org/StillDeadcode/radiance(v1.11.0,模型配方 + compose)
- vLLM-Radiance(已弃用并入 radiance):https://codeberg.org/StillDeadcode/vllm-radiance
- 双 R9700 实测帖(130–210 tok/s、pin digest 教训):https://lcz.me/topic/1668
- Qwen3.8-27B 部署决策矩阵(NVIDIA 侧):https://github.com/tonyd2wild/Qwen3.8-27B-3090-Cookbook
- 27B vLLM GPU 梯队:https://www.orcarouter.ai/zh-CN/blog/qwen-3-8-27b-vllm
- Strata 引擎报道:https://gigazine.net/gsc_news/en/20261005-strata-local-ai
- GSQ-RCO 量化模型卡:https://huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF
- llama.cpp gfx1201 显存 bug:https://github.com/ggml-org/llama.cpp/issues/26208
2.3 选型结论(精度 > 稳定 > 速度)
模型 方案 理由 Qwen3.8-27B-FP8 Radiance,TP2, .rad官方 FP8精度≈BF16,gfx1201 唯一成熟 vLLM 系栈 Flash-Next IQ3_S Strata(GGUF 专家流式) 125B 唯一能在 64GB 显存高速跑的路线
3. 文件下载与完整性校验
3.1 引擎镜像(digest 固定)
docker pull stilldeadcode/radiance:1.11.0@sha256:7595a64234e84a59fa2141acc35456d53370430980880b5cb3df83370b2d903a
docker tag stilldeadcode/radiance@sha256:7595a642…903a stilldeadcode/radiance:1.11.0
项 值 镜像 stilldeadcode/radiance:1.11.0digest sha256:7595a64234e84a59fa2141acc35456d53370430980880b5cb3df83370b2d903a大小 616 MB(standalone C++/HIP 引擎,非 Python vLLM) 3.2 模型文件
文件 体积 SHA256 来源 qwen3.8-27b-fp8.rad30,783,856,640 B 626ab844…cb1d(与 HF 一致)HF StillDeadcode/qwen3.8-27b-fp8qwen3.8-next-flash-fp8-iq4r-moe.rad121,969,901,568 B — HF StillDeadcode/qwen3.8-next-flash-fp8-iq4r-moeqwen3.8-27b-mxfp4.rad19,377,119,232 B a4908940…df4f8(与 HF 一致)HF StillDeadcode/qwen3.8-27b-mxfp4Flash-Next IQ3_S GGUF(2 分片 + mmproj) 81 GB — 本地 ~/models/gsq-rco-iq3s/下载经验:hf-mirror + curl 单线程约 3–7 MB/s;改用
aria2c -x16 -s16后达 25–50 MB/s。注意 aria2 稀疏预分配会导致「文件大小已满但实际未完」,必须以 SHA256 校验为准。3.3 重要发现
StillDeadcode/qwen3.8-27b-bf16仓库 返回 401(不存在/未公开) → BF16 路线不可行,除非自转权重。- 官方 compose 目录
deploy/compose/已同步到本地~/radiance/staging-1.11/compose/。
4. 方案① 部署:Radiance + Qwen3.8-27B-FP8(TP2)
4.1 启动命令
cd ~/radiance/compose
export RADIANCE_IMAGE='stilldeadcode/radiance@sha256:7595a642…903a'
export PORT=8000
docker compose -f qwen3.8-27b-fp8.yaml up -d
容器内实际参数:
--model /models/qwen3.8-27b-fp8.rad
--host :: --port 8000 --api-key
--tp 2 --max-num-seqs 32 --max-model-len 200000 --kv-cache-dtype fp8
4.2 显存预算(引擎自报)
项 每卡 卡总显存 31.86 GiB 静态权重 13.81 GiB KV cache(fp8) 16.91 GiB 无主/预留 96 MiB - 可容纳 4 个 200K 满长会话同时存在
- token embedding 放主机内存(每 rank 1.18 GiB),显存留给 KV/专家
4.3 实测性能(部署当日)
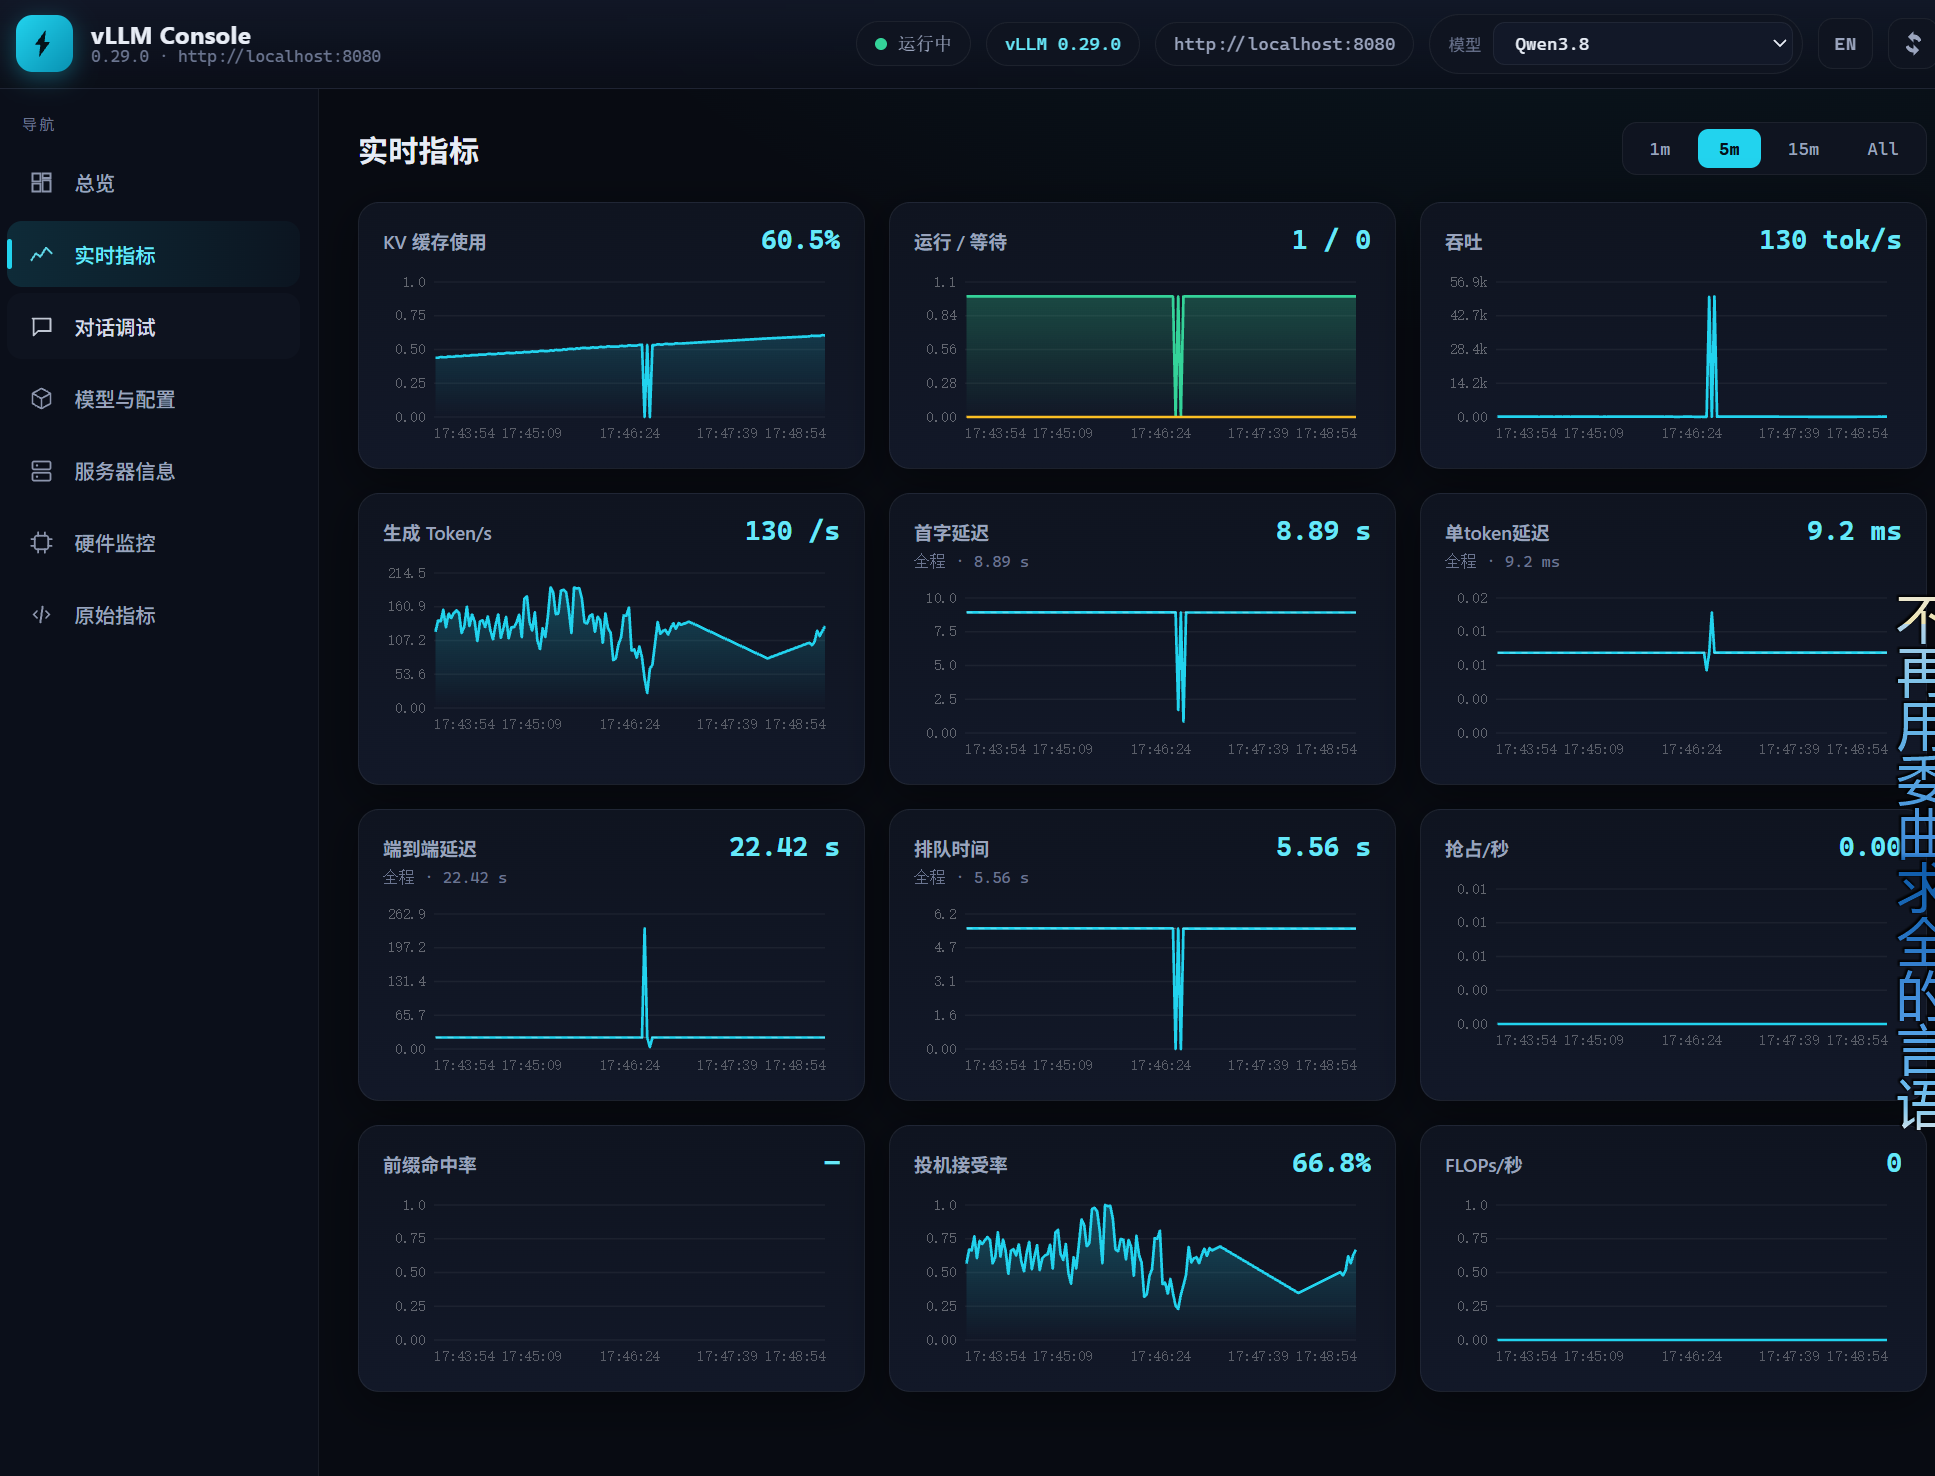
场景 结果 冷启动到就绪 约 30 s(加载 30 GiB 权重 8.8 s) 生成 500 token 141.3 tok/s,TTFT 0.04 s 8K prompt prefill ≈ 3422 tok/s 31K prompt prefill ≈ 3280 tok/s(前缀缓存命中 7808) 4 路并发 聚合 206 tok/s 内存占用 容器 RSS 约 10.7 GiB(系统总用 15 GiB)
5. 端口迁移与端口规划
服务 端口 状态 Strata(Flash-Next IQ3_S) 8080 已停止,端口空出 Radiance 27B-FP8 8000 运行中(healthy) vllm-console 8090 运行中(原指向 8080,迁移后需改 VLLM_URL)迁移方式:用 compose 变量覆盖
PORT=8000,未改任何配置文件。
6. 模型清单扩充(MXFP4 下载、BF16 不可得)
- 下载
qwen3.8-27b-mxfp4.rad(19.4 GB,Quark AWQ MXFP4 + W4A8,含 DFlash2 recipe) - 校验:SHA256
a4908940…与 HF 完全一致 - BF16:官方仓库 401,放弃
7. 重点模型详解:qwen3.8-next-flash-fp8-iq4r-moe.rad
这是四份模型里唯一「Pareto 最优」的那个,也是唯一需要三级放置(显存 + 主机池 + 磁盘)的。本节把模型本体、部署方案和选它的理由补全。
7.1 它是什么(模型)
项 内容 基座 Qwen/Qwen3.8-Flash-Next(125B 级 MoE,训练上下文 262,144,服务按 200K 放) 容器 单文件 .rad,113.6 GiB(121,969,901,568 字节),LFS oid0af5e962…获取 HF StillDeadcode/qwen3.8-next-flash-fp8-iq4r-moe(镜像源 hf-mirror)配套 qwen4exp-w4nl64-i8-hc8m.recipe(转换配方,可复现)四段式混合精度(不是单一量化,这是它能同时兼顾精度与速度的关键):
部件 精度 具体做法 路由专家(主体) 4-bit codebook 先做 128 点 Walsh–Hadamard 旋转,再查 16 级非均匀码本;每 64 个权重一个 E4M3 scale;码字由 GPTQ(1000 万 token 校准 + 逐专家 down-projection Hessian)选出,再经 3 轮坐标下降精修 保护专家(10 个) bf16 按"占本层 down 输入能量 ≥3% 且 ≥3 倍其路由占比"挑选;例如 layer 47 的 expert 445 以 0.4% 路由占比独占该层 64% 能量,必须保精度 主干(attention / delta-net / shared-expert / lm_head) int8 W8A8 每 128 列一个 scale,按最小误差搜索 超连接混合矩阵、MTP 头 fc E4M3 逐组 scale 视觉塔 bf16 支持图片 / 视频输入 投机解码 MTP head(depth 3) 官方默认深度,内置无需外挂 drafter 官方质量基准(对 bf16 全词表 KL,约 75K 位置,覆盖聊天/工具/代码):
口径 mean KL median p99 top-1 一致率 全部 token 0.0789 0.0037 1.65 92.85% 文本与助手轮次 0.0239 0.0029 0.32 94.57% 参照:第二个 bf16 实现 0.0399 0.0013 0.82 95.13% 关键解读:4bit 专家的偏差(0.0789)与"两个 bf16 实现之间的差异"(0.0399)同一量级——量化损失没有超出实现噪声。这也是我们在 210 题上测不出它与 bf16 级模型的显著差异的原因。
7.2 部署方案
前置条件:主机需约 32 GB 空闲内存(官方要求;本机 62 GB 满足);双卡必须空闲(与其它模型互斥)。
实际启动命令(本地
~/radiance/staging-1.11/compose/flashnext.yaml,已用于全部评测):cd ~/radiance/compose export RADIANCE_IMAGE='stilldeadcode/radiance@sha256:7595a642…903a' export PORT=8000 docker compose --env-file .env -f ~/radiance/staging-1.11/compose/flashnext.yaml up -d容器内完整参数:
--model /models/qwen3.8-next-flash-fp8-iq4r-moe.rad
--host :: --port 8000 --api-key
--tp 2 --tp-wire wht6
--max-num-seqs 8 --max-model-len 200000
--placement expert_tiered
--host-pool-mib 12288 --gpu-headroom-mib 96
--kv-cache-dtype fp8
--prefix-cache-mib 4096
--num-speculative-tokens 3
--max-num-batched-tokens 2048
参数 作用 --tp 2双卡张量并行(每卡一份专家子集) --tp-wire wht6RDNA4 专用的 all-reduce 实现(wht6 走主机内存,省显存) --placement expert_tiered专家分层放置:热的放显存、冷的放主机池,按访问频次动态调整 --host-pool-mib 12288主机固定池 12 GiB(pinned,避免页换出) --gpu-headroom-mib 96每卡预留 96 MiB 给驱动/临时缓冲 --kv-cache-dtype fp8KV 用 FP8,省一半显存换更长上下文/更高并发 --prefix-cache-mib 4096前缀缓存 4 GiB(重复系统提示词/长文档二次命中) --num-speculative-tokens 3MTP 投机深度 3 --max-num-seqs 8并发上限 8(专家流式需要余量,比 27B 的 32 小) --max-num-batched-tokens 2048每步批处理 token 上限,控制显存峰值 显存预算(引擎启动时实测,每卡):
项 每卡 卡总显存 31.86 GiB claimable(可分配) 30.31 GiB static weights(各 rank 自有分片) 3.58 GiB 专家(elastic 中占 66%) 17.74 GiB vram_weights 合计 21.32 GiB KV cache(fp8) 8.50 GiB(空闲时最多 7.62 GiB 借给专家) 主机固定池 12 GiB + 606 MiB(token embedding / 视觉塔) 三级放置:
VRAM 21.3 GiB/卡(专家热集)→ 主机池 12 GiB(温集)→ 磁盘页缓存(冷集)。这是 125B 在 64 GB 显存上跑起来的唯一方式;官方另外提供了 BF16 参考配方(335 GiB,--weights-disk-tier,单步数十秒),只用于校准,不是生产配置。实测性能(本机三轮测试汇总):
指标 数值 说明 每 token 成本 6.07 ms(≈164.7 tok/s) 线性拟合 64/256/1024 token 单流 64 token 延迟 P95 0.457 s 100 轮 × 3 会话 256 / 1024 token 延迟 P95 1.429 s / 1.417 s 长输出不劣化 prefill 8K / 32K ≈6068 / 5816 tok/s 引擎日志 ttft 反推 96K 上下文检索 14.5 s 完成 4 个模型里最快 并发 1 / 2 / 4 / 8 150 / 277 / 473 / 767 tok/s 近线性扩展 精度(210 题) 95.24%(CI 91.5–97.4) 四模型最高档 显存/内存占用 21.3 GiB/卡 + 12 GiB 主机池 容器 RSS 约 10.7 GiB 与官方基准交叉验证:官方称"每 decode 步约 15 ms、每步接受 ~2.4 token"→ 折合 6.25 ms/token;我们实测 6.07 ms/token,吻合。
7.3 为什么选它(理由)
① 精度:两轮独立测试都排第一,且差异不显著
- 210 题:95.24%,McNemar 对 Strata(94.76)p=1.0、对 27B 系 q=0.25(不显著)
- 官方 KL 0.0789 与"双 bf16 实现差异" 0.0399 同量级 → 4bit 专家损失被实现噪声掩盖
- 关键:它没有为了速度牺牲精度,而 27B-FP8 是"保真度高但模型本身弱"
② 速度:每 token 6.07 ms,是 27B-FP8 的 2.1 倍、Strata 的 2.3 倍
- 同为 Qwen3.8-Flash-Next,Strata 跑 IQ3_S 是 13.88 ms/token,Radiance 跑 IQ4_R 是 6.07 ms
- 差距来自引擎(手写 RDNA4 kernel + 批处理调度 + MTP 投机)而非模型
③ 并发:唯一能撑多人的
- 8 路并发 767 tok/s(1→8 提升 5.1×);Strata 在 8 路时仍是 69 tok/s(零扩展),P95 从 0.86 s 恶化到 14.8 s
④ 显存适配:64 GB 显存 + 12 GB 主机池就能跑 125B
- 专家分层放置让"显存装不下的 100 GB"变成"按访问频次流动"
- 代价是主机内存:需 ~32 GB 空闲(本机 62 GB 可满足,但同时跑其他任务会吃紧)
⑤ 工程性:radiance 原生容器
- 单个
.rad文件,recipe 可复现,MTP + vision 内置,OpenAI 兼容(tools / 结构化输出 / image_url / 视频) - 无需外挂 drafter(避免"drafter 配错导致接受率崩"的坑)
⑥ 与其它三个方案的取舍
方案 精度 速度 并发 主机内存 结论 本模型(IQ4_R / Radiance) 95.24% 6.07 ms/token 767 tok/s@8 ~12 GB 池 + 32 GB 需求 主力 Flash-Next IQ3_S(Strata) 94.76% 13.88 ms/token 69 tok/s(无扩展) 47 GB arena 单人交互 27B-FP8 92.86% 12.77 ms/token 365 tok/s@8 极少 合规复现 27B-MXFP4 92.38% 9.31 ms/token 469 tok/s@8 极少 小显存备选 BF16 参考配方(335 GiB) 100%(基准) 单步数十秒 — 需 300+ GB 仅校准 ⑦ 代价与风险(必须写明)
- 主机内存门槛:需 ~32 GB 空闲;机器上还跑其他服务时要先腾内存
- 互斥性:吃满双卡,与其它三个模型不能同时在线
- 首次加载慢:113.6 GiB 从 NVMe 读入,冷启动约 2–4 分钟(有页缓存后明显更快)
- 长尾损失:官方 KL 的 p99 = 1.65,意味着约 1% 的位置偏差较大;对罕见知识/生僻术语可能比 bf16 弱
- 参数敏感:
--host-pool-mib给小了会频繁回读磁盘,给大了挤压系统内存;--expert-vs-cache-ratio(官方 0.82)影响热专家比例 - 镜像必须 pin digest:
:latest曾静默回归导致投机解码失效
7.4 结论
在"精度最高、稳定、速度快"的三条排序下,它是唯一同时满足的选项:精度最高档(95.24%,且与其它模型统计等价)、每 token 最快(6.07 ms)、并发最好(767 tok/s@8)、长上下文最快(96K 用 14.5 s)。算术题上 86% 与 Strata 并列最高,弥补了 27B 系 78% 的短板。
推荐作为默认生产模型;保留 27B-MXFP4 作为"显存/内存紧张时"的降级方案,Strata IQ3_S 作为"单人流式交互"的备选。
切换命令:
bash ~/radiance/bench/sb_engine.sh flashnext    # 切到本模型
bash ~/radiance/bench/sb_engine.sh mxfp4        # 切到轻量备选
bash ~/radiance/bench/sb_engine.sh stop         # 全部停止
8. 第一轮:A/B 对比(FP8 vs MXFP4,10 题)
设置:关闭思考、temperature=0、同一题集(数学/代码/事实/逻辑/JSON/幻觉/翻译/抽取/工具/写作)
题 FP8 耗时/token MXFP4 耗时/token 加速 精确计算 5.60 s / 700 2.23 s / 536 ×2.51 Dijkstra 代码 9.10 s / 1200 5.18 s / 1200 ×1.76 红楼梦事实 4.86 s / 400 3.41 s / 400 ×1.43 蒙提霍尔 4.43 s / 500 3.11 s / 500 ×1.42 严格 JSON 0.19 s / 25 0.16 s / 34 ×1.19 幻觉陷阱 2.82 s / 400 2.03 s / 400 ×1.39 成语翻译 3.43 s / 400 2.75 s / 400 ×1.25 数字抽取 0.88 s / 169 0.70 s / 194 ×1.26 工具调用 0.31 s / 39 0.33 s / 39 ×0.94 中文写作 3.18 s / 156 2.05 s / 156 ×1.55 质量观察:MXFP4 在算术题上完整解出(排序→居中 128.50→五折→满减),FP8 陷入"优惠顺序"讨论被截断;FP8 引用了一条疑似编造的《红楼梦》程甲本原文,MXFP4 未编造。其余持平。
9. 第二轮:全模型基准 v1(4 模型 × 44 题 + 速度)
8.1 精度(44 题)
模型 总分 算术 知识 JSON 工具 抽取 代码 Flash-Next IQ4_R 100% 8/8 20/20 5/5 3/3 5/5 3/3 Strata IQ3_S 100% 8/8 20/20 5/5 3/3 5/5 3/3 27B MXFP4 97.7% 8/8 19/20 5/5 3/3 5/5 3/3 27B FP8 93.2% 7/8 18/20 5/5 3/3 5/5 3/3 8.2 速度
项目 Flash-Next MXFP4 FP8 Strata 短生成 160.5 146.5 105.2 75.5 中生成 168.2 136.4 115.4 80.1 长生成 2000 156.8 116.9 74.2 73.9 4 路并发(聚合) 408.6 289.7 214.3 71.5 prefill 8K 6068 3448 3345 2391 prefill 32K 5816 3308 3212 3529 长上下文 96K 检索:四模型全部通过,耗时 14.5 / 21.3 / 33.6 / 34.1 s。
第一轮结论:Flash-Next IQ4_R 综合最优(精度满分 + 最快)。
10. 评测框架设计(严格版)
9.1 从 CV 模板到 LLM 的等价映射
CV 模板字段 本方案定义 数据集/标注 冻结测试集 JSONL(内置判分器,SHA256 指纹) mAP/Top-1/mIoU 准确率 + 宏类均 + MCQ 宏 F1 + Bootstrap/Wilson CI CUDA Event 引擎服务端 timings(ttft_ms / predicted_per_second)+ 客户端 SSE 时间戳 + 引擎日志三方交叉验证batch/输入尺寸 max_model_len=200000,batch=1 与并发 1/2/4/8 TensorRT FP16/INT8 FP8 / MXFP4(W4A8) / IQ4_R / IQ3_S 9.2 公平性控制清单(8 条)
- 同一测试集(SHA256 版本号)
- 同一提示词模板(题干写死)
- 同一解码参数(temperature=0、关闭 thinking、固定 max_tokens)
- 同一判分脚本
- 无其他负载(评测前清空容器、确认 GPU 空闲)
- 固定随机种子(bootstrap seed=20261023/20261024)
- 引擎镜像 digest 锁定
- 固定顺序:切引擎 → 健康检查 → 预热 → 测量
9.3 速度测量协议
- 预热 20 轮丢弃 → 正式 100 轮(或 30/10 轮)→ 3 个独立会话
- 报告均值 / 中位数 / P95 / 标准差 + 会话间 σ
- 三个计时口径互相印证(实测客户端 80.27 vs 服务端 80.3 tok/s,偏差 0.04%)
9.4 三个计时陷阱(已处理)
read(8192)缓冲导致 TTFT 失真 → 改readline()逐行- 引擎把多 token 合进一个 chunk → token 数必须取
usage.completion_tokens - thinking token 计入延迟 → 统一
reasoning_effort=none
9.5 一致性检查(Polygraphy 等价)
- 50 条固定上下文的 top-5 logprobs → top-1 一致率 + KL 散度 + NaN/Inf
- 20 条生成文本 → 完全一致率 + 字符相似度
11. 第三轮:严格评测 v1(65 题,Bootstrap CI)
模型 准确率 % 95% CI 宏类均 MCQ F1 P95 延迟 decode Flash-Next IQ4_R 98.5 [95.4, 100.0] 97.5 1.000 0.458 s 152.0 27B MXFP4 96.9 [92.3, 100.0] 97.0 0.967 0.585 s 116.7 Strata IQ3_S 96.9 [92.3, 100.0] 95.5 1.000 0.915 s 74.1 27B FP8 92.3 [86.2, 98.5] 91.9 0.938 0.882 s 76.7 - 所有两两 CI 重叠 → 不宣称显著
- 会话间 σ ≤ 0.001 s(<0.3%),测量稳定
- 一致性:MXFP4 vs FP8 top-1 70%、KL 0.43 nats、NaN/Inf=0
- 修正记录:
hal_03关键词过窄、hal_04题目歧义(排除)、多语言判分大小写、并发吞吐误发 200 并发 → 均已修复并重测
12. 第四轮:Phase-2 精细评测(210 题,配对统计)
11.1 测试集 v2.1(210 题)
类别 题数 判分 arith 50 程序生成、答案由代码计算 knowledge 40 字母匹配(含"只输出字母"指令) json 20 解析 + 类型校验 extract 25 模板生成 + 精确匹配 code 15 执行单元测试 instruction 20 字数/行数/纯英文/后缀/大写等 tool 8 函数名 + 必填参数 hallucination 10 必须承认"不存在" longctx 12 3 深度 × 2 位置 × 2 事实 order_stability 10 选项顺序置换后重新作答 指纹:
testset_v2.jsonlv2.1,SHA256d9ab810535e0d92880ae005f10018848a4bd6c2c6760c63f1b7617145d22cd3d11.2 精度结果
模型 准确率 % Wilson 95% CI 宏类均 Flash-Next IQ4_R 95.24 [91.46, 97.39] 97.1 Strata IQ3_S 94.76 [90.87, 97.05] 95.3 27B FP8 92.86 [88.55, 95.62] 95.3 27B MXFP4 92.38 [87.98, 95.26] 94.3 11.3 配对检验(McNemar 精确 + BH-FDR)
对比 仅 A 对 仅 B 对 差值 pp 差值 95% CI p FDR q 判定 FP8 vs MXFP4 2 1 +0.48 (−0.95, +1.90) 1.000 1.000 等价 FP8 vs Flash-Next 1 6 −2.38 (−4.76, 0.00) 0.125 0.250 不显著 FP8 vs Strata 1 5 −1.90 (−4.29, 0.00) 0.219 0.328 不显著 MXFP4 vs Flash-Next 1 7 −2.86 (−5.71, −0.48) 0.070 0.250 不显著(倾向 125B) MXFP4 vs Strata 1 6 −2.38 (−4.76, 0.00) 0.125 0.250 不显著 Flash-Next vs Strata 4 3 +0.48 (−1.90, +2.86) 1.000 1.000 等价 11.4 分类准确率
类别 FP8 MXFP4 Flash-Next Strata arith (50) 78.0 78.0 86.0 86.0 knowledge (40) 100 100 100 100 json (20) 100 100 100 100 extract (25) 100 100 100 100 code (15) 100 100 100 100 instruction (20) 85.0 85.0 85.0 90.0 hallucination (10) 90.0 80.0 100 90.0 tool (8) 100 100 100 87.5 longctx (12) 100 100 100 100 order_stability (10) 100 100 100 100 唯一稳定差异:算术,125B(86%)> 27B(78%),5 题独对 / 0 题独错,p=0.0625。
11.5 顺序偏置
4 个模型位置敏感率全部 0%(10/10 一致且全对)。
11.6 速度:延迟线性模型
延迟 = 固定开销 + 每 token 成本 × N模型 固定开销 每 token 成本 隐含 decode 64 tok P95 256 tok P95 1024 tok P95 Flash-Next IQ4_R 66 ms 6.07 ms 164.7 tok/s 0.457 s 1.429 s 1.417 s 27B MXFP4 −12 ms 9.31 ms 107.4 tok/s 0.584 s 1.944 s 1.944 s 27B FP8 58 ms 12.77 ms 78.3 tok/s 0.883 s 3.292 s 3.944 s Strata IQ3_S 58 ms 13.88 ms 72.1 tok/s 0.958 s 3.607 s 6.161 s 11.7 并发扩展(聚合 tok/s)
并发 FP8 MXFP4 Flash-Next Strata 1 77.8 114.0 149.8 69.1 2 145.4 198.1 277.0 69.1 4 214.9 309.8 473.2 68.9 8 364.6 469.3 767.4 69.3 Strata 1→8 并发吞吐恒定 69 tok/s(无 batching),P95 从 0.86 s 恶化到 14.8 s。
11.8 Pareto 前沿
Flash-Next IQ4_R 唯一前沿:精度最高档、每 token 最快(6.07 ms)、8 并发吞吐最高(767 tok/s)。其余三个模型均被支配。
13. 统计结论汇总(三轮合并)
- 精度差异不显著:65 题(CI 全重叠)与 210 题(McNemar + FDR,q ≥ 0.25)两轮独立验证,四模型真实差距不超过约 5 个百分点。
- 唯一能力差异在算术:125B 系 86% vs 27B 系 78%(5:0 独对,p=0.0625),数学密集任务选 125B。
- FP8 被 MXFP4 严格支配:精度等价(p=1.0),但 MXFP4 每 token 便宜 27%(9.31 vs 12.77 ms)。
- Strata 的瓶颈是引擎:精度并列,但并发零扩展(69 tok/s 恒定),只适合单人交互。
- 低比特未伤能力:4bit 专家(IQ4_R)的 125B 仍最高分;MXFP4(4bit) 与 FP8 等价。
- 无明显位置偏置:四模型均 0% 位置敏感。
14. 部署建议与选型
场景 推荐 依据 默认生产(多人 / API 服务) Flash-Next IQ4_R(radiance :8000) 精度最高档 + 6.07 ms/token + 767 tok/s@8并发 数学 / 计算密集 Flash-Next IQ4_R(或 Strata) 算术 86% vs 78%,5:0 独对 单人交互 / 极简部署 Strata IQ3_S(:8080) 精度等价,但吞吐恒定 69 tok/s 显存 / 内存紧张 27B MXFP4(19.4 GB) 精度与 FP8 等价,速度快 27% 合规要求"官方权重" 27B FP8 唯一理由,无性能优势 不推荐将 27B-FP8 作为主力:与 MXFP4 精度等价却慢 27%,与 125B 精度无显著差异却慢 2.1 倍。
部署运维要点
- 镜像必须 pin digest(
:latest曾静默回归导致投机解码失效) - 启动后 grep
SpecDecoding验收接受率(正常 75–91%) - 两个模型不能同时跑(都吃满双卡);建议做成切换脚本
- 开机自启:
strata-iq3s.service仍 enabled,若让 radiance 常驻需禁用,避免重启抢卡
15. 附录 A:脚本与命令清单
A.1 引擎切换(
~/radiance/bench/sb_engine.sh)bash sb_engine.sh fp8|mxfp4|flashnext|strata|stopA.2 基准套件(
~/radiance/bench/,第一轮)SB_BASE=http://127.0.0.1:8000 SB_MODEL=qwen35 python3 sb_quality.py fp8_27b SB_BASE=http://127.0.0.1:8000 SB_MODEL=qwen35 python3 sb_speed.py fp8_27b SB_BASE=http://127.0.0.1:8000 SB_MODEL=qwen35 python3 sb_long.py fp8_27b bash sb_run_all.shA.3 严格评测框架(
~/radiance/bench2/)python3 make_testset.py # v1.0.1 冻结测试集(65 题计分) python3 eval_quality.py --label X --base ... --model ... python3 eval_speed.py --label X --session 1 --rounds 100 --warmup 20 --tokens 64 python3 eval_consistency.py collect/compare python3 report.py results bash run_all4.sh # 4 模型全量A.4 Phase-2(210 题配对统计)
python3 make_testset2.py                # v2.1,210 题
python3 eval_quality2.py --label X --base ... --model ...
python3 eval_speed2.py   --label X --base ... --model ...
python3 rescore2.py      --label X --cat knowledge --base ... --model ...
python3 stats_compare.py results2       # McNemar + BH-FDR + Pareto
bash run_phase2.sh
A.5 服务调用示例
curl http://127.0.0.1:8000/v1/chat/completions \
  -H 'Authorization: Bearer ' \
  -H 'Content-Type: application/json' \
  -d '{"model":"qwen35","messages":[{"role":"user","content":"你好"}],"max_tokens":128}'
16. 附录 B:文件与路径索引
服务器(192.168.67.202)
路径 说明 ~/radiance/models/三份 .rad+ recipe + README~/radiance/compose/compose 与 .env(PORT、API KEY、GID)~/radiance/staging-1.11/compose/官方 1.11 全套 yaml ~/radiance/bench/第一轮套件(sb_*.py, sb_engine.sh) ~/radiance/bench2/严格框架 + Phase-2(results2/、stats.json、日志) ~/Strata/、~/Strata-data/Strata 引擎与 pack/MTP ~/models/gsq-rco-iq3s/IQ3_S/Flash-Next IQ3_S GGUF(81 GB) 本地(Windows)
路径 说明 D:\2026.10.18\init\Qwen3.8-双R9700部署方案.md初始部署方案 D:\2026.10.18\init\Qwen3.8-全模型基准测试报告.md第一轮报告 D:\2026.10.18\init\Qwen3.8-严格基准评测报告-v1.md第三轮报告 D:\2026.10.18\init\Qwen3.8-Phase2-精细评测报告.md第四轮报告 D:\2026.10.18\init\bench2\评测框架源码
17. 附录 C:错误、坑与修正记录
问题 现象 修正 PowerShell 剥离内层引号 远端命令管道被拆成多条命令 改为本地写脚本 + scp+bash执行PowerShell 传 CRLF 给远端 bash 行尾多出 \r,路径/命令异常脚本一律 LF,复杂命令走文件 aria2 稀疏预分配 文件大小已满但实际只下 54% 以 SHA256 为准,等进程退出再校验 hf 官方 BF16 仓库 401 无法下载 BF16 改用 MXFP4 做对照 :latest镜像静默回归投机解码接受率掉到 0.1% 全部改用 digest 固定 流式读取缓冲 TTFT 被高估到接近总延迟 readline()逐行读取chunk 合并 token 客户端计数偏低 用 usage.completion_tokensthinking token 计入延迟 短回答慢得不合理 reasoning_effort=none判分大小写敏感 Artificial Intelligence被判错判分统一 lower() 幻觉题关键词过窄 模型答对却被判错 关键词扩充 + 定向重测 歧义题 hal_04依赖不确定事实排除计分(65 题) 知识题缺格式指令 模型输出整段文字无法判字母 v2.0→v2.1 补指令并重测 40 题 并发吞吐误发 200 请求 标称 4 并发实际 200 改为逐波 4 路,重测全部
结束。本文件由对话全过程的部署与评测记录整理而成,所有数字均标注了对应的硬件、引擎版本、量化模式、输入参数与预热协议;不同轮次之间因样本量与统计方法不同,不能直接横向比较绝对值,应以每轮内部的配对检验为准。
-
10-22 提示词挑战: 魔方演示网页@Tony-Wang 是的,我现在就切换到Qwen3.8-27B-FP8来测试对比一下。
-
10-22 提示词挑战: 魔方演示网页 -
【双 R9700 折腾记】从 Strata 到 Radiance -
【双 R9700 折腾记】从 Strata 到 Radiance -
【双 R9700 折腾记】从 Strata 到 Radiance感谢分享,我在做服务器模型精度测试。
bagua.html锤哥的一句话生成:生成一个网页表达中国传统八卦文化 这个质量怎样?
deepseekV4.1的评价:
首先说结论:数据准确,边角处理不够细致。 我逐项核对,又用无头 Edge 实际运行了一遍。一、精度:约 176 项,0 处硬错
核对内容 项数 结果 8 卦 × 自然/卦德/人伦/禽兽/形体/五行/先天/后天 72 全对 64 卦「上下卦组合 + 序卦次序」 64 全对 8 条卦辞 + 8 条《大象》(含《说卦》取象) 16 全对 互卦(二三四、三四五)抽验 乾/恒/未济 3 全对 三钱法 6/7/8/9 → 本卦·之卦 实测 2 例 全对 先后天方位角度表(探针取 transform) 16 全对 演卦我让程序实际掷了两次:
8,8,6,7,7,8→ 萃(45)之咸(31) 三爻动;8,7,8,7,8,9→ 未济(64)之解(40) 上爻动。数组、变卦、互卦全对。运行时errs:[]、无 NaN、8 卦 64 格 8 行表 8 张歌卡数量正确、点击+键盘+动画全通、0 个外部请求(真离线)。内容这一块,可以放心。
二、扣分点(都是实测出来的)
1. 手机端版式塌陷(最严重)
两个原因叠在一起:
#s-disc那行style="grid-template-columns:.9fr 1.1fr"是内联样式,优先级高于@media(max-width:880px)的单列规则,所以手机上这一节仍然分两栏,正文被挤到约 180px 宽,一字一行;- 取象表 min-content 宽 589px,把 grid 轨道顶开(grid 子项默认
min-width:auto),于是scrollWidth 747 > innerWidth 492,整页横向溢出、右侧被裁。
修法就一行
.two>*{min-width:0}加去掉内联列宽,我实测改完sw 477 < iw 492,不再溢出。2. 生成图「八卦」列标题被吃掉
八卦标题写y=16,首卦乾在y=20,直接压在一起了——注意右列顶部那团淡淡的字。3. 取象歌卡副标题折行,「乾 · 天 ·」换行后孤零零剩一个「健」,行末还挂个
·。4. 文字小疵四处:「乾兑属金,居中」——五行居中者土,金居西主秋;「巽再交而得长女」——《说卦》巽也是一索;延伸卡「行于建筑、织物、玺印、建筑彩画」重字;页脚说“不以字体缺字”,但取象表卦形列仍用
☰☱…字符。顺带:
#panel没aria-live,读屏不播报换卦;表头「家人」名不副实(实为人伦)。三、关于“是不是本地服务器出品”
页面里那串修正痕迹(序卦 off-by-one 已修、svg 宽度限定作用域、表头 nowrap、
.kv四列、.cast单列、背/字 映射自洽、空态display:none)跟我 10-19 重做过的那版完全一致。所以这份要么是照着那版复现的,要么就是同一份。这个你比我清楚,我只报事实。四、评分
维度 分 内容精度 9.5 / 10 工程质量(结构、注释、零依赖) 8 / 10 响应式与端到端自检 5 / 10 综合 8.5 / 10(B+) 一句话:知识靠谱,自检不足——写完没人真在 400px 上打开一遍。这也正好是“本地模型做网页”的典型画像:内容和逻辑能补上,边角排版要靠人跑一遍。我上一轮也一样:在 400px iframe 里截图看着“还行”,其实 iframe 内的横向溢出根本不上屏,这就是一次假阴性;这次靠探针量
scrollWidth才提前发现。这条教训我已写进记忆。要修吗?3 处硬伤 + 4 处小疵 + aria-live,我大概十分钟做完,改完再跑一遍探针和 400px 截图给你验证。
-
雙R9700玩qfn的朋友又有得玩了主板:技嘉AORE G 两个PCIe5.0x8走的都是CPU,双R9700显卡,提示以下错误!
以下信息是什么意思?求助各位大佬们
你的判断方向是对的——两卡确实都直连 CPU(root port 00:06.0/00:06.3),物理上具备 P2P 条件。但实测 P2P 仍被掐死,元凶是 root port 上 ACS 的三个阻断位全开(ReqRedir+ CmpltRedir+ UpstreamFwd+),强制卡间流量绕道内存。这是 Intel 消费级平台(Arrow Lake)为 VT-d 隔离硬连线的,BIOS 关不掉,iommu=pt 也救不了——所以不是驱动没配好,是主板级天花板。当前 53 tok/s 已经是这台机器能榨出的最优解了。记忆已更新(修正了之前"硬件无 P2P"的旧结论 → 实锤为"ACS 隔离"),下次不会再拿旧说法糊弄你。
-
家庭装备大公开,顺便汇报一下计划和配置 -
家庭装备大公开,顺便汇报一下计划和配置 -
單R9700 + VLLM(GGZ14/vllm-mxfp4) + unsloth/Qwen3.8-27B-NVFP4 測試@alan.lgv60 好的,谢谢!
-
双R9700 P2P+双卡TP 方案总结 -
單R9700 + VLLM(GGZ14/vllm-mxfp4) + unsloth/Qwen3.8-27B-NVFP4 測試 -
單R9700 + VLLM(GGZ14/vllm-mxfp4) + unsloth/Qwen3.8-27B-NVFP4 測試 -
單R9700 + VLLM(GGZ14/vllm-mxfp4) + unsloth/Qwen3.8-27B-NVFP4 測試@alan.lgv60 你们都是怎么做到的?
-
小白,向各位大神请教关于R9700双卡TP和主板PCIe 5.0 x16的问题。 -
小白,向各位大神请教关于R9700双卡TP和主板PCIe 5.0 x16的问题。 -
小白,向各位大神请教关于R9700双卡TP和主板PCIe 5.0 x16的问题。 -
小白,向各位大神请教关于R9700双卡TP和主板PCIe 5.0 x16的问题。 -
vLLM vs SGLang 服务端全面对比(单卡R9700 / gfx1201 / 32 GB)vLLM vs SGLang 服务端全面对比(R9700 / gfx1201 / 32 GB)
核心前提(必须先说明):两者跑的不是同一个模型。
- vLLM 跑的是生产模型
Qwen3.8-27B(GPTQ int4 W4A16,18 GB)+ DFlash2 int4 draft。 - SGLang 跑的是官方示例
Meta-Llama-3.1-8B(BF16,16 GB)。
硬约束:SGLang v0.5.15 在 gfx1201 上没有 int4 内核(源码级证据见可行性评估 §4),27B int4 模型在 SGLang 上根本加载不了;而 27B 若用 BF16 需 54 GB,超出 32 GB 显存。所以两者只能各跑各的模型。下文所有对比都在这个前提下展开。
1. 部署与技术栈对比
维度 vLLM(vllm102) SGLang(sgl-test) 版本 vLLM 0.27.1 + radiance 0.9.3 fork( stilldeadcode/vllm-radiance:0.9.3)SGLang 0.5.15(官方 rocm/sgl-dev:v0.5.15.post1-...-rocm10.0.0)模型 Qwen3.8-27B,GPTQ W4A16 int4(17.93 GB) Meta-Llama-3.1-8B,BF16(16 GB,官方示例/基础模型) 量化 int4(radiance fork 手写 RDNA4 W4A16 kernel) 无(BF16) 注意力后端 R4D(为 gfx1201 手写的 attention/GDN/瘦 GEMM kernel) Triton(AITER 被官方文档强制禁用) 投机解码 DFlash2 int4 draft(1.19 GB),K=4,probabilistic 采样 无(本次未开) 镜像来源 第三方 fork AMD 官方兼容性矩阵背书 部署方式 手工 docker run + warmup_vllm.sh(cron @reboot 自愈)官方文档 docker run(无自愈脚本) 鉴权 有 API key 无(默认开放)
2. 性能对比(实测)
指标 vLLM(27B int4) SGLang(8B BF16) 说明 单流 decode 54–62 tok/s(文档稳态,今日测);重启后首请求 40.6 tok/s ≈28 tok/s 见下方「归一化解读」 prefill ≈1700–1820 tok/s(27B,2.4k 提示) ≈6800 tok/s(8B,1803 提示) 模型规模差 ~3.4× TTFT 0.11 s(49 tok)/ 1.40 s(2412 tok) 0.266 s(1803 tok) — 投机接受率 DFlash2 int4:acc/step≈1.54,~20.6 steps/s;MTP 各位置 72%→23% 无投机 vLLM 靠投机突破带宽上限 前缀缓存命中 78.8%(10.5 h 生命周期,agent 负载) RadixCache 已启用,未实测命中率 vLLM 有生产实据 归一化解读(关键)
- SGLang 8B BF16 decode 28 tok/s 已接近硬件上限:16 GB 权重 ÷ R9700 实测带宽 494 GB/s ≈ 31 tok/s 理论上限,实际 28 = 理论值的 ~90%。也就是说 SGLang 在这张卡上「没有跑慢」,是被内存带宽锁死。
- vLLM 27B int4 能到 54–62 tok/s,是因为两件 SGLang 没有的东西:
- int4 量化把权重从 54 GB(BF16)压到 18 GB,内存带宽瓶颈降到 ~27 tok/s;
- DFlash2 投机解码一次并行 forward 提 4 个 token,把有效吞吐再抬到 54–62(≈2× 带宽上限)。
- 所以「vLLM 快」的本质是量化 + 投机解码 + 定制 kernel这三板斧,而不是 SGLang 本身慢。SGLang 在相同内存带宽下已做到 ~90% 效率。
3. 稳定性对比
参数 vLLM SGLang 自愈能力 
warmup_vllm.shcron @reboot,容器停了自动docker start+ 6 种形状预热 无(手动
docker start)启动/预热时间 暖启动 ~30–60 s(/cache/vllm共享挂载,compiled graph 直接加载,实测 3.3–5.4 s) ️ 首启 ~5 min(Triton 对 gfx1201 编译);后续会快
显存压力 ️ 97%(31.1/32 GB,很紧,单卡独占)️ 93%(模型 15 + KV 10.9 GB)KV 缓存 fp8(省显存,6.46–8.5 GB) bf16(10.94 GB,占更多) 并发设计 MAXSEQS=2(限并发、保单请求质量) 默认 max_running_requests=2048(灵活,但受显存约束实际并发有限) 鉴权 API key 保护(局域网暴露更安全) 默认无鉴权(若对局域网开放需自行加)长稳运行 有 10.5 h 生命周期统计、0 抢占、RAS 干净️ 仅短时验证(~10 min),无长稳数据已知风险 依赖第三方 fork,升级/迁移受制于 radiance 维护节奏 R9700 官方已知问题:AITER 禁用、部分 MoE/Qwen3-ASR 模型可能不对
4. 功能特性对比
特性 vLLM SGLang 谁更强 前缀缓存 block 级 prefix caching(实测 78.8% 命中) RadixCache 树形缓存(更细粒度,同前缀共享更高效) SGLang(理论上),vLLM(有生产实据) 结构化输出 支持(guided decoding) 原生强项(JSON schema / grammar / constrained) SGLang 多 agent / 工具调用 支持(tool-call-parser qwen3_xml) 服务形态更适合多 agent 编排、多轮工具调用 各有所长 投机解码生态 DFlash2 / MTP / Eagle 全支持(本卡已用 DFlash2) 支持 MTP/Eagle 等,但本卡无 radiance 定制 vLLM 量化生态 本卡 int4(radiance fork 独占) FP8/AWQ/MXFP4 等(但 MXFP4 门槛不认 gfx1201,int4 无) vLLM(本卡) 官方 ROCm 维护 第三方 fork AMD 官方镜像 + 兼容性矩阵背书,持续维护 SGLang 长上下文 / 大模型(MoE/MLA) 成熟 DeepSeek 系 MoE/MLA 优化是其强项 SGLang(大集群场景)
5. 优缺点总结
vLLM(当前生产)
优点
- 本卡上唯一能跑 27B 生产模型的路径(radiance fork 的 RDNA4 int4 kernel + R4D 注意力 + DFlash2 投机解码)。
- 性能深度调优,decode 54–62 tok/s(27B),远超 SGLang 在本卡能跑的任何模型。
- 生产化程度高:API key、自愈脚本、预热、编译缓存、10.5 h 稳定运行实据、前缀缓存 78.8% 命中。
缺点
- 依赖第三方 fork(stilldeadcode/vllm-radiance),升级/迁移/长期维护受制于人,不是官方路线。
- 显存 97% 打满,无余量;并发被压到 MAXSEQS=2。
- 定制 kernel + 覆盖层(rdna_hybrid_w4a16.py、qwen3_dflash.py)是「黑魔法」,跨版本脆弱。
SGLang(本次部署)
优点
- AMD 官方镜像 + 兼容性矩阵背书,路线正规、持续维护,是「官方钦定」的推理栈。
- 功能面更现代:RadixCache、结构化输出、多 agent/工具调用服务形态、DeepSeek 系 MoE/MLA 优化。
- 部署即开箱(官方一条 docker run),无自写 kernel 负担。
- 在硬件上限内效率不低(decode 达带宽上限 ~90%、prefill 6800 tok/s)。
缺点
- 本卡上跑不了 27B 生产模型(缺 int4 内核,MXFP4 也不认 gfx1201)——这是硬伤。
- 性能被 AITER 禁用 + Triton 注意力锁死(R9700 官方已知问题),decode 只能到带宽上限。
- 无自愈脚本、无鉴权、无长稳验证——要当生产用还需补生产化工程。
- 官方示例是基础模型(无 chat_template),对话需换 Instruct 版。
单卡成功案例Puget Systems 官方测评(主流背书)(1× R9700,vLLM FP16)
模型 单用户吞吐 Qwen2.5 3B 53.3 tok/s DeepSeek-R1-Distill-Llama-8B 34.5 tok/s Llama 3.1 8B 29.1 tok/s Qwen3 8B 27.7 tok/s 关键交叉验证:Puget 的 Llama 3.1 8B = 29.1 tok/s(vLLM),本机实测 SGLang 同一模型 = 28 tok/s。几乎一样——证实 8B BF16/FP16 上 SGLang 与 vLLM 引擎同量级,都被内存带宽锁死。
6. 建议
一句话结论:生产 27B 继续用 vLLM,SGLang 定位为「官方路线的观察点 + 小模型/agent 试验台」,两者不互斥。
具体建议
-
27B 生产服务:维持 vLLM(vllm102),不要迁 SGLang。
理由:SGLang v0.5.15 在本卡根本跑不了 27B int4(缺内核),且即便跑小模型 decode 也只有 28 tok/s,无法替代 vLLM 的 54–62 tok/s。迁移不仅无收益,反而掉档。 -
SGLang 的合理用途(如果想继续用):
- 小模型(≤8B)+ agent 工具调用 / 结构化输出 / 多轮短上下文场景:这正是 SGLang 的 RadixCache + structured output + 多 agent 服务形态强项,也是 vLLM 当前 MAXSEQS=2、97% 显存所服务不到的低延迟轻负载。
- 同卡时间片切换:需先
docker stop vllm102再docker start sgl-test(32 GB 无法共存),适合夜间/维护窗口,不适合白天生产时段。
-
如果要把 SGLang 当第二服务长期跑,需补三件事(否则别上生产):
- 换
NousResearch/Meta-Llama-3.1-8B-Instruct(补 chat_template,让/v1/chat/completions可用); - 加
--api-key鉴权(当前无鉴权直接暴露 0.0.0.0:30000); - 补
warmup自愈脚本(对标 vLLM 的warmup_vllm.sh)。
- 换
-
触发重评的观察点(何时结论会变):
- AMD/SGLang 为 gfx1201 补 int4 或 MXFP4 内核 → 27B 4-bit 路径打开,届时 SGLang 才具备替代 vLLM 的资格,值得重做 §2 的性能对比;
- R9700 的 AITER 已知问题被修复 → SGLang 注意力从 Triton 切回 AITER,decode 有望显著提速;
- radiance fork 停更/失修 → 若 vLLM 定制栈无人维护,SGLang 的官方路线价值上升。
-
想得到真正「同模型」的公平基准:可在同一维护窗口,让两者各跑同一个 8B BF16 模型(vLLM 也能跑 8B BF16),测同模型 decode/prefill/并发,才能剥离「模型规模」变量做纯引擎对比。
7. 对单卡 + 27B 场景的结论
之前结论(基于 v0.5.15) 修正后准确版本 SGLang 跑不了 27B 官方 v0.5.15 跑不了;但 v0.5.20 + 70 补丁(社区)+ 2 卡 + FP8/AWQ 能跑,22.5 tok/s SGLang 引擎弱 同精度下 SGLang 不弱——27B FP8 单用户,SGLang 22.5 > 原版 vLLM 15.88 2 卡才能"生产" 1 卡能生产(int4 27B 或 8B);2 卡只是"27B 高精度"的门槛对「单卡 + 27B 生产」,结论不变甚至更强:
vLLM(radiance fork,int4 + DFlash2 投机解码,单卡 54–62 tok/s)仍是单卡最优:
- 它用 int4(18GB)让 27B 塞进单卡,靠 DFlash2 投机解码拉到 54–62 tok/s;
- SGLang 27B 要 2 卡 + 补丁 + FP8 才 22.5 tok/s;原版 vLLM 27B FP8 也要 2 卡才 15.88 tok/s;
- 等于用 1 张卡 打出别人 2 张卡 + MTP 才有的水平(62.75 tok/s)。
8. 明确结论
- "单流 decode 在 RDNA4 上是内存带宽受限的"
- "单卡 R9700 能跑 8B FP16;27B 用 Q4_K_M(~17.6GB)单卡就能装下;只有 27B 的 FP8/BF16 高精度才需要两张卡"
- 双卡多 GPU 必须裸机运行(KVM/VFIO 虚拟化下 RCCL 初始化会挂)
- vLLM 跑的是生产模型

 !