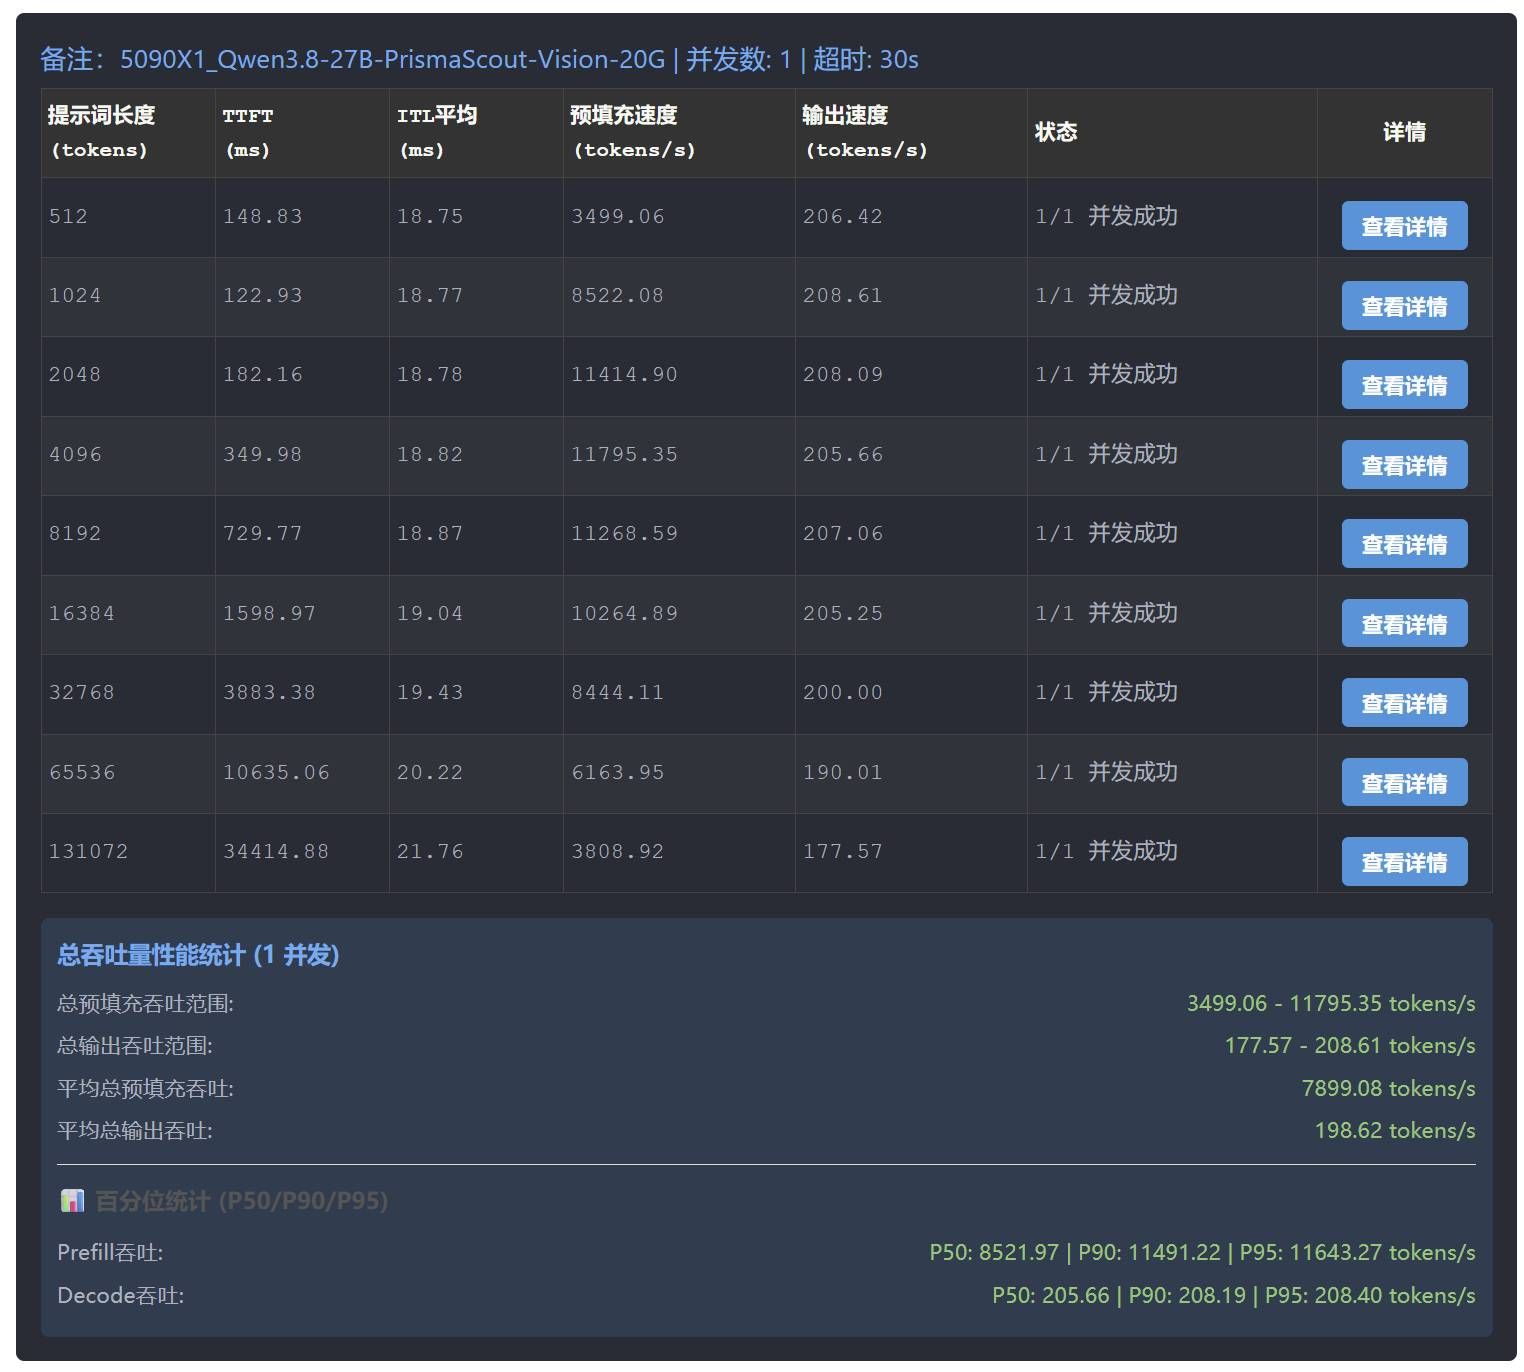
@stormaround 这卡 prefill太低了 说白了就是性能不行 做智能体几乎不能用
 M
Mediali Li
@Mediali Li
-
魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec -
3090单卡跑qwen3.8 27b q4km 上下文2456K达成,但是感觉生产力还是不太行。@Xiaote 想的少 效果就差 这是无解的
-
3090单卡跑qwen3.8 27b q4km 上下文2456K达成,但是感觉生产力还是不太行。这模型想有点效果 首先必须 vllm 或者sglang,单卡24g是很难跑起来的,所以必须 32g-40g显存才有生产力,所以普通卡就必须双卡了,双卡的n卡哪个便宜就选哪个就是了,速度妥妥的提升 能干活,例如双卡 5070ti 32g ,那么nvfp4版本可以开 256k上下文 速度 大概 prefill 3000-5000 输出 130+,长上下文不掉速多少
-
单台DGX 装qwen 3.8 next flash 500K token 长度,能用@Kk-Hh 问题这台主机不是3000 也不是1w, 是3-4w, 这价格能用小主机来衡量吗? 这价格目的买的是工作平台来使用吧,不是用来等用来玩的。这价位这速度,超级不值。
-
魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec还好 我可以经常回国,在美国也没啥好买的,不过之前特价倒是入了3张5090 现在派用场了
-
魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec -
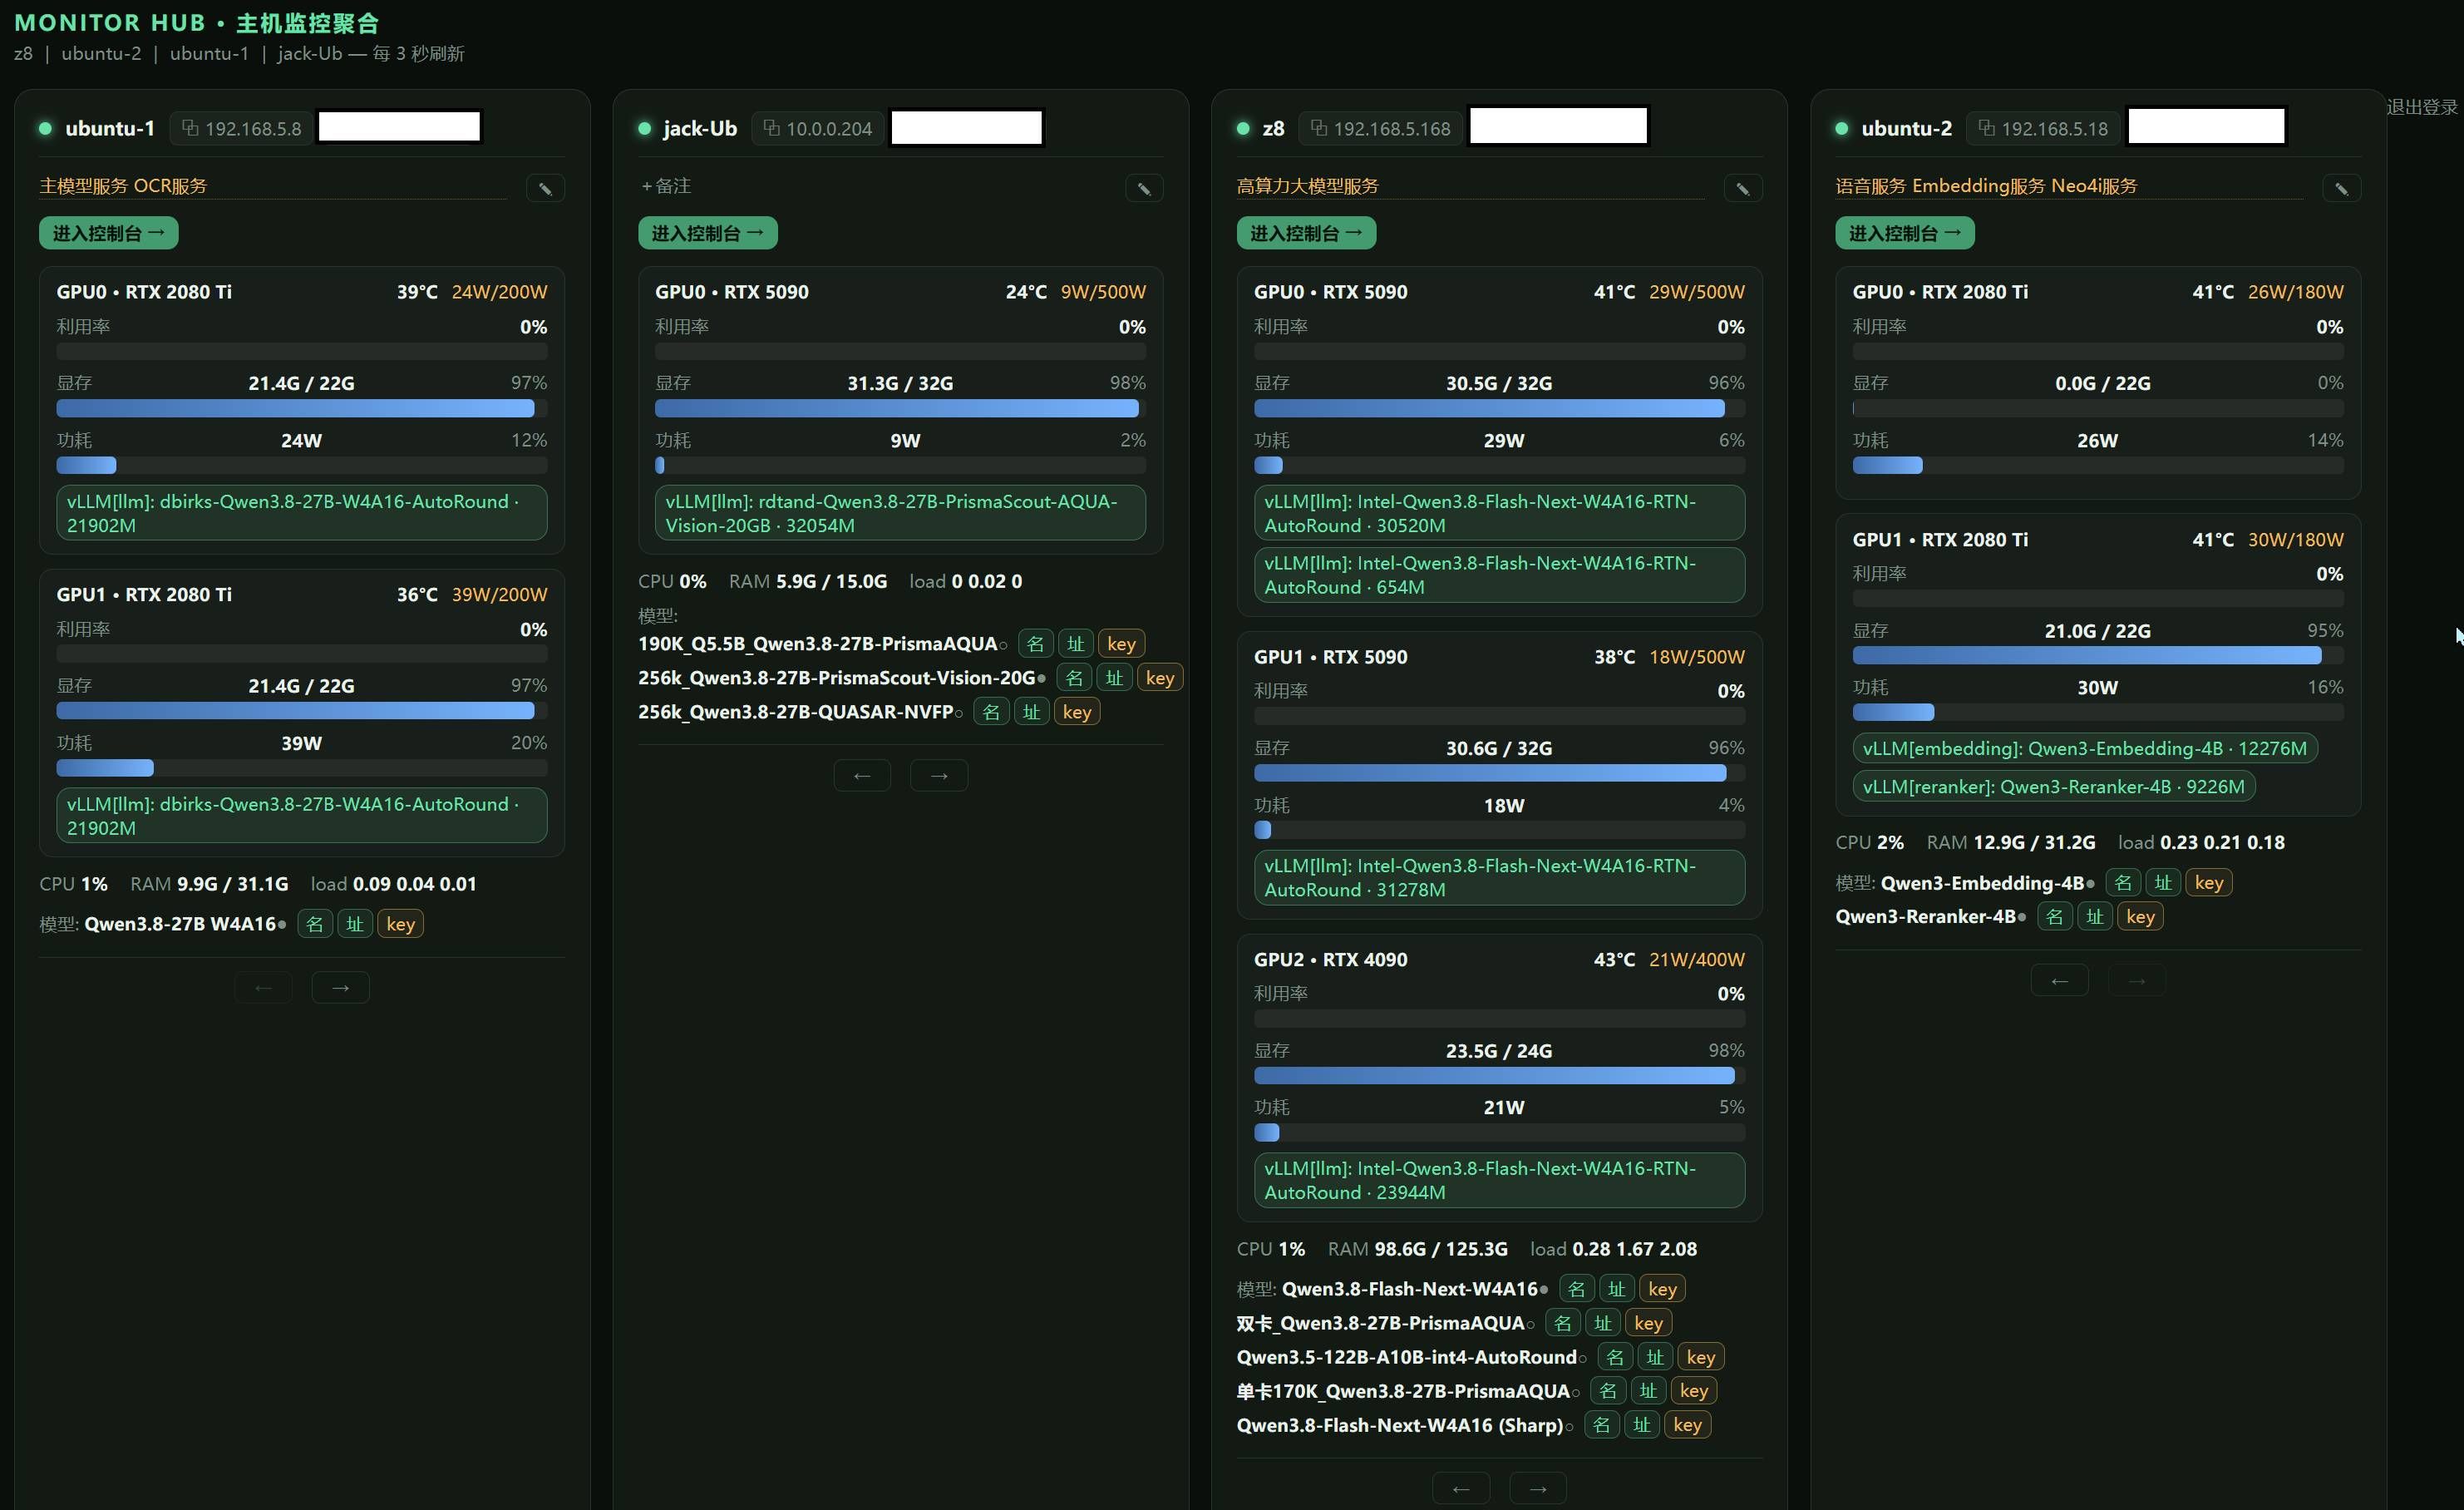
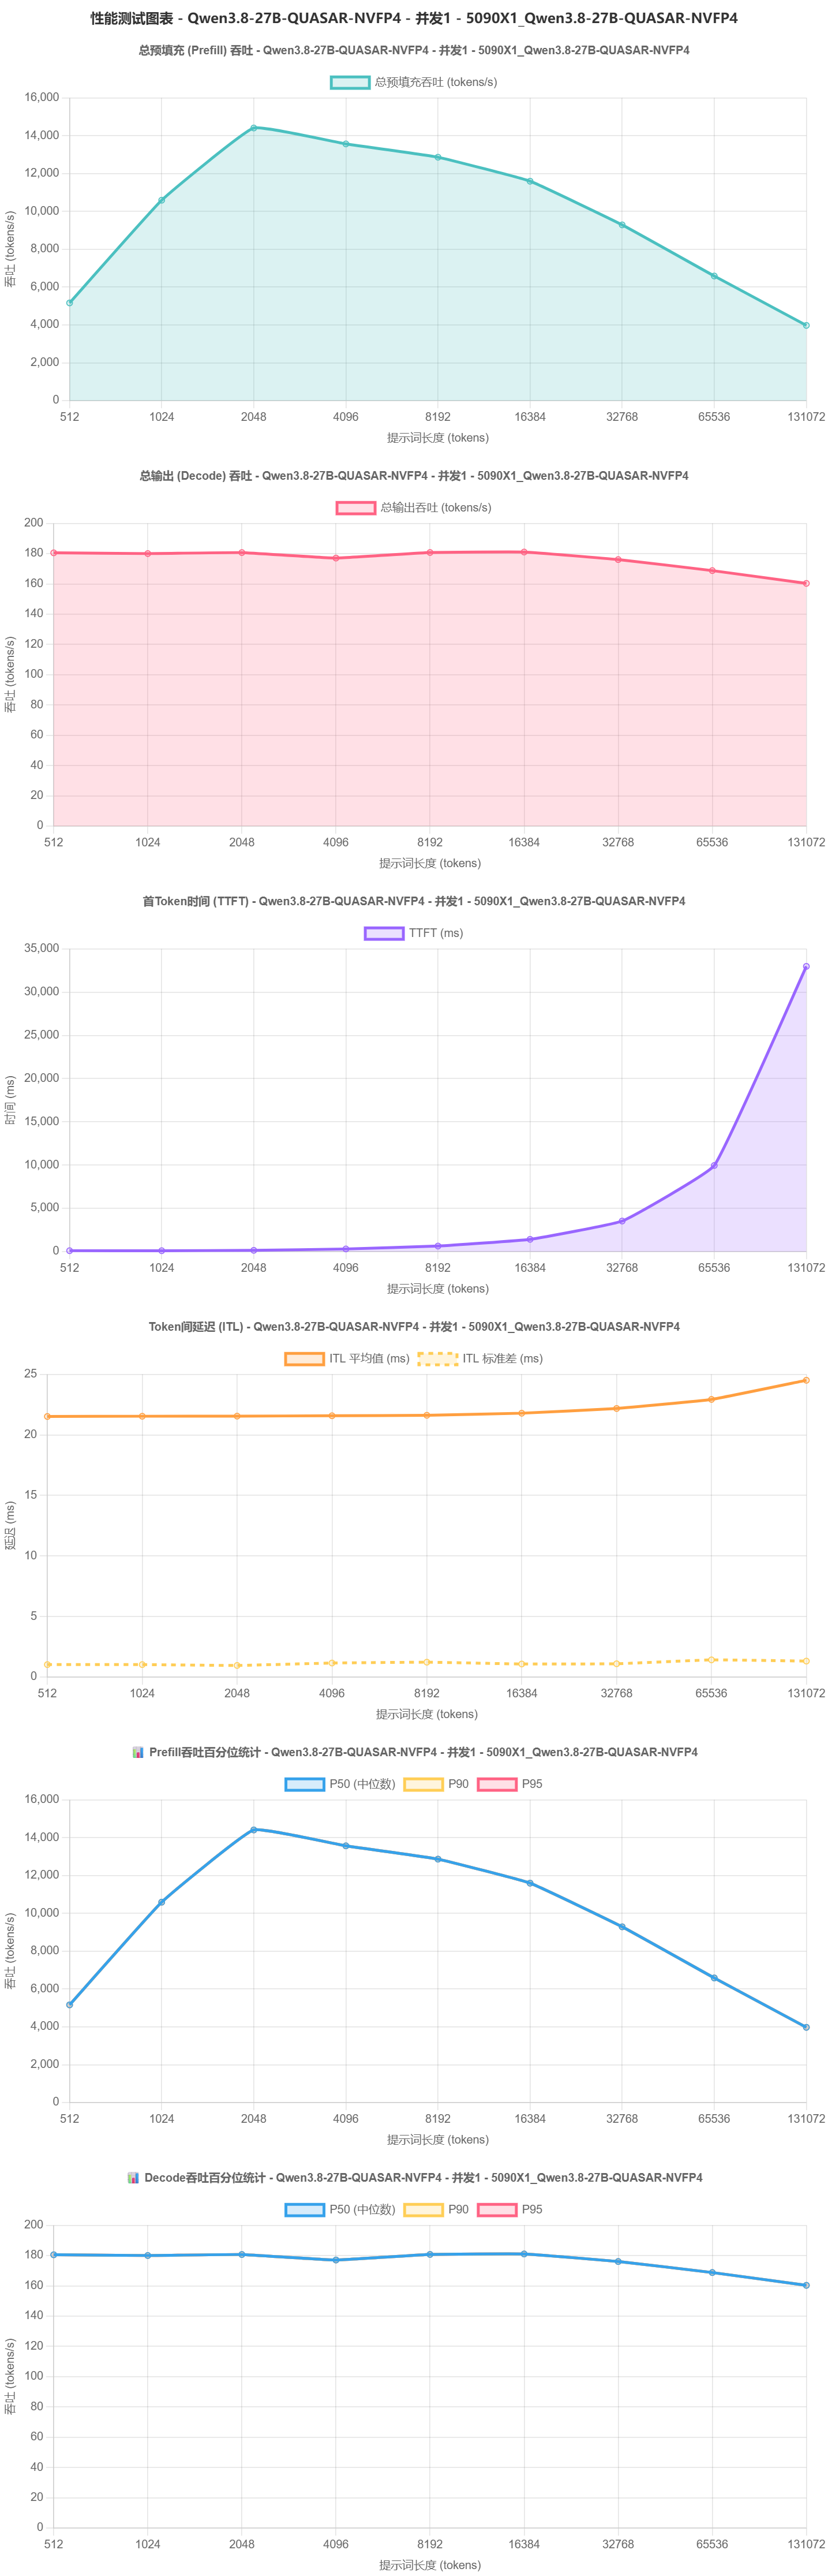
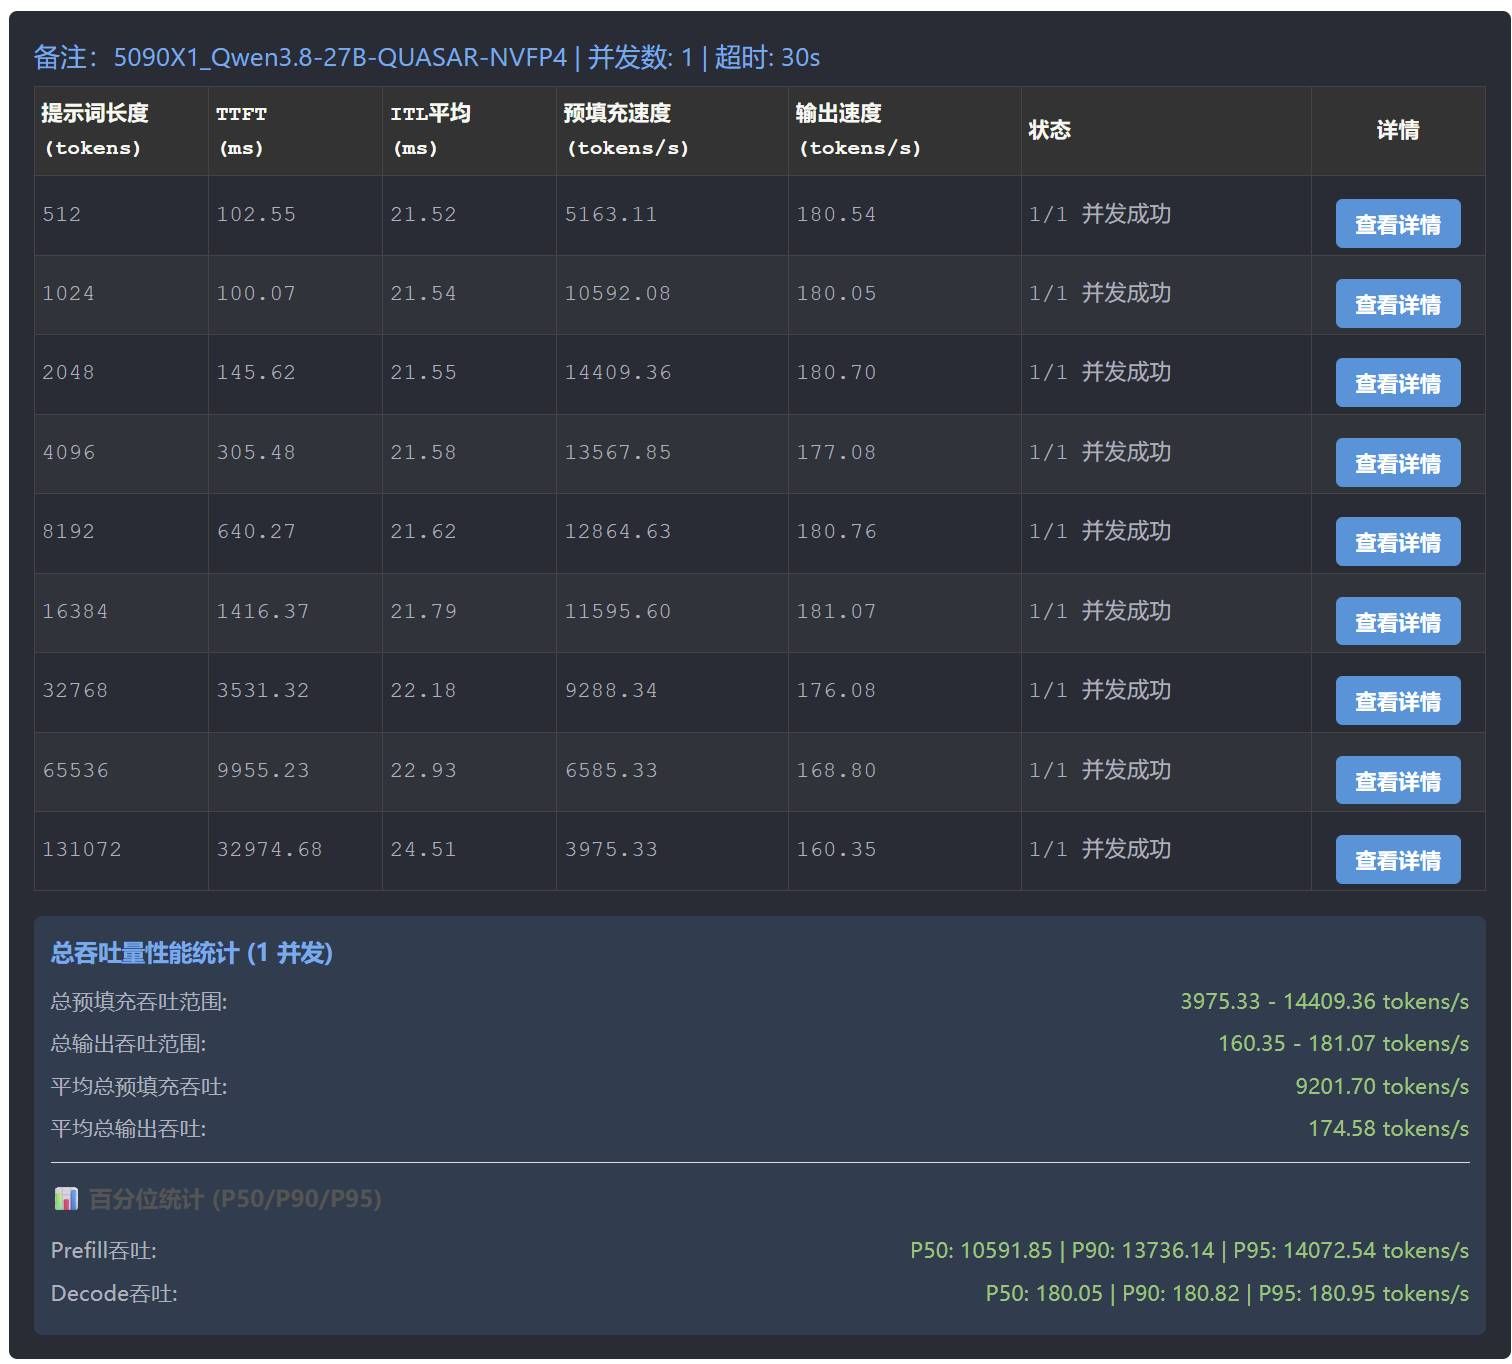
魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec@applejuice 这点速度还快? 27b w4a16 我双卡5090 去到 8000 prefill,nvfp4得 1.5w+ 2080ti我就挂机做个翻译而已!
-
魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/sec@applejuice 4-bit 量化模型(AWQ、GPTQ 或 AutoRound)的输出速度为 110 token/s,而 FP8 量化可达到约 1500–1600 token/s,从而实现 75 token/s 的输出速度。
-
魔改SGLANG支持7900XTX 双卡TP TTFT <1s 平均TG 80-100! 4并发TG200/secPrefill 才500多 速度这么低 能用吗?
随便一张n卡 都翻倍了吧,双卡价格都上万了才这点速度 ,性价比很差啊,我是不能理解这么低的prefill 做智能体究竟有什么意义,我随便组的 2080ti双卡 27b prefill都有1800+,我都觉得慢,正常好用至少4000+
-
真心求教Hermes agent运行本地oMLX的Qwen3.8-27B-MLX-4bit如何提速?现在才醒觉,会不会太晚了呢?当时用DS 4 flash的时候就没想过它会涨价吗?你觉得它那么便宜是合理的吗?能一直持续下去吗?现在能用得爽的卡 已经很贵很贵了,都买不起了
-
Qwen3.8 27B + DeepSeek Harness实测:7900XTX本地跑Agent效率不错,忘掉SGLang?llama.cpp咸鱼翻身!2080ti*2 不好吗? 同样5000
-
双显卡叠加 VRAM 玩本地模型的迷思,两年过来人血泪谈,最终直上32gb 单卡fcme 用延长线就是的
-
昨天看到一个博主的配置(5060ti 16G X4 )+华南H12D-8D 这能成吗?再发一个对比

-
昨天看到一个博主的配置(5060ti 16G X4 )+华南H12D-8D 这能成吗?@applejuice 2080ti四卡 27b fp8 优化后也有 2200 prefill 输出大概是80tks-100tks
-
昨天看到一个博主的配置(5060ti 16G X4 )+华南H12D-8D 这能成吗? -
昨天看到一个博主的配置(5060ti 16G X4 )+华南H12D-8D 这能成吗?昨天他的测试成绩并不理想 27b fp8 prefill 2300 decode mtp3 100tks
-
双显卡叠加 VRAM 玩本地模型的迷思,两年过来人血泪谈,最终直上32gb 单卡5090 2w 块钱的时候不醒觉 现在才来醒觉,我都第三张5090了