
DS太大气了,只恨自己这个星期都在蹬Opencode go的DS,DS官方API用的太少了,才拿到15块钱增金。
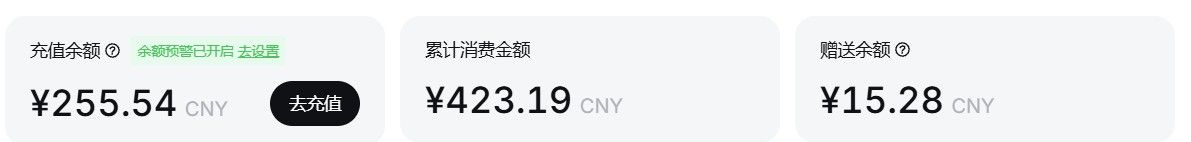
DS太大气了,只恨自己这个星期都在蹬Opencode go的DS,DS官方API用的太少了,才拿到15块钱增金。
很棒啊,这个多卡方案!
哇,非常nice! 我学做AI短剧下一个小目标就是做自己的BGM了XD
赞一个,去审查非常有必要XD
A100真的挺强大的...
我就在3090和A6000上试过好些加速工作流,4 step lora, Larry 8 step, Taomate, FastH3. 目前用的FastH3 v2还不错,下面这个博主做了加速版/二采超分版/人脸精修版三个工作流。我用着觉得挺好,加速版验证prompt和分镜,latent超分做清晰,有人物就再加face refinement.
Youtube Video
Minimax M3.1 Flash Preview真的不错,我吃灰的Minimax 订阅Plan又可以拿出来用了XD。
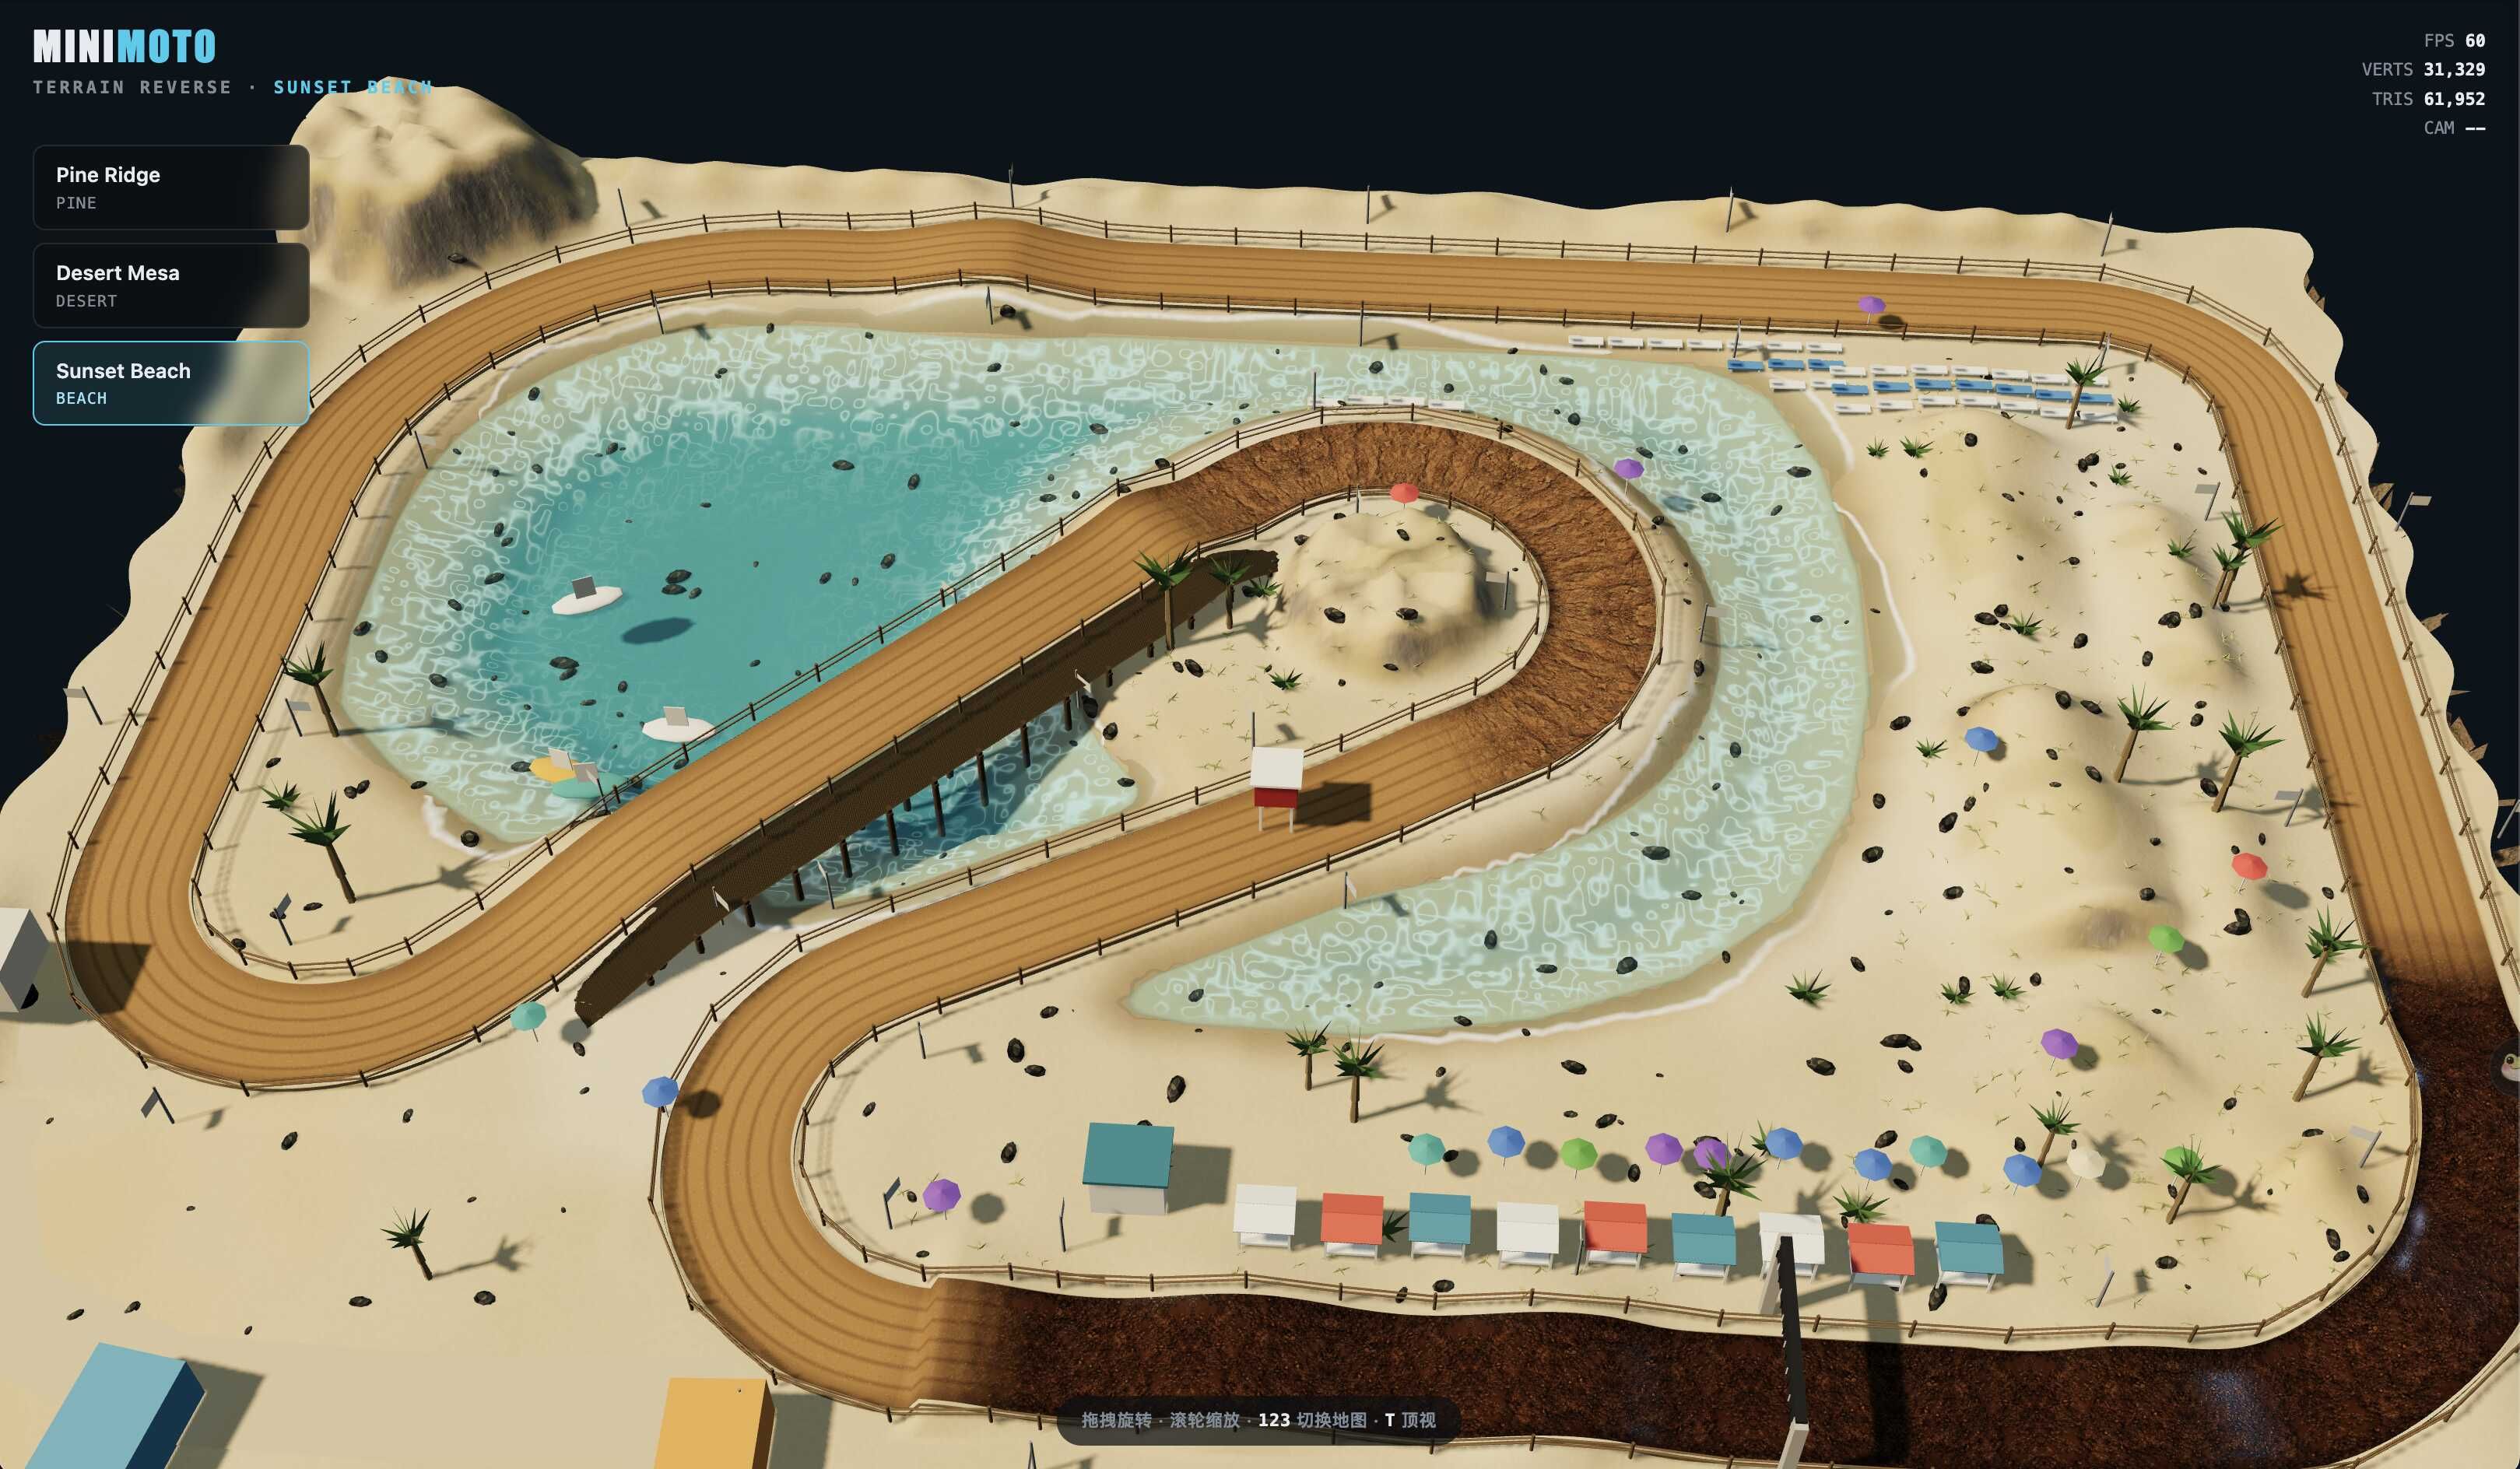
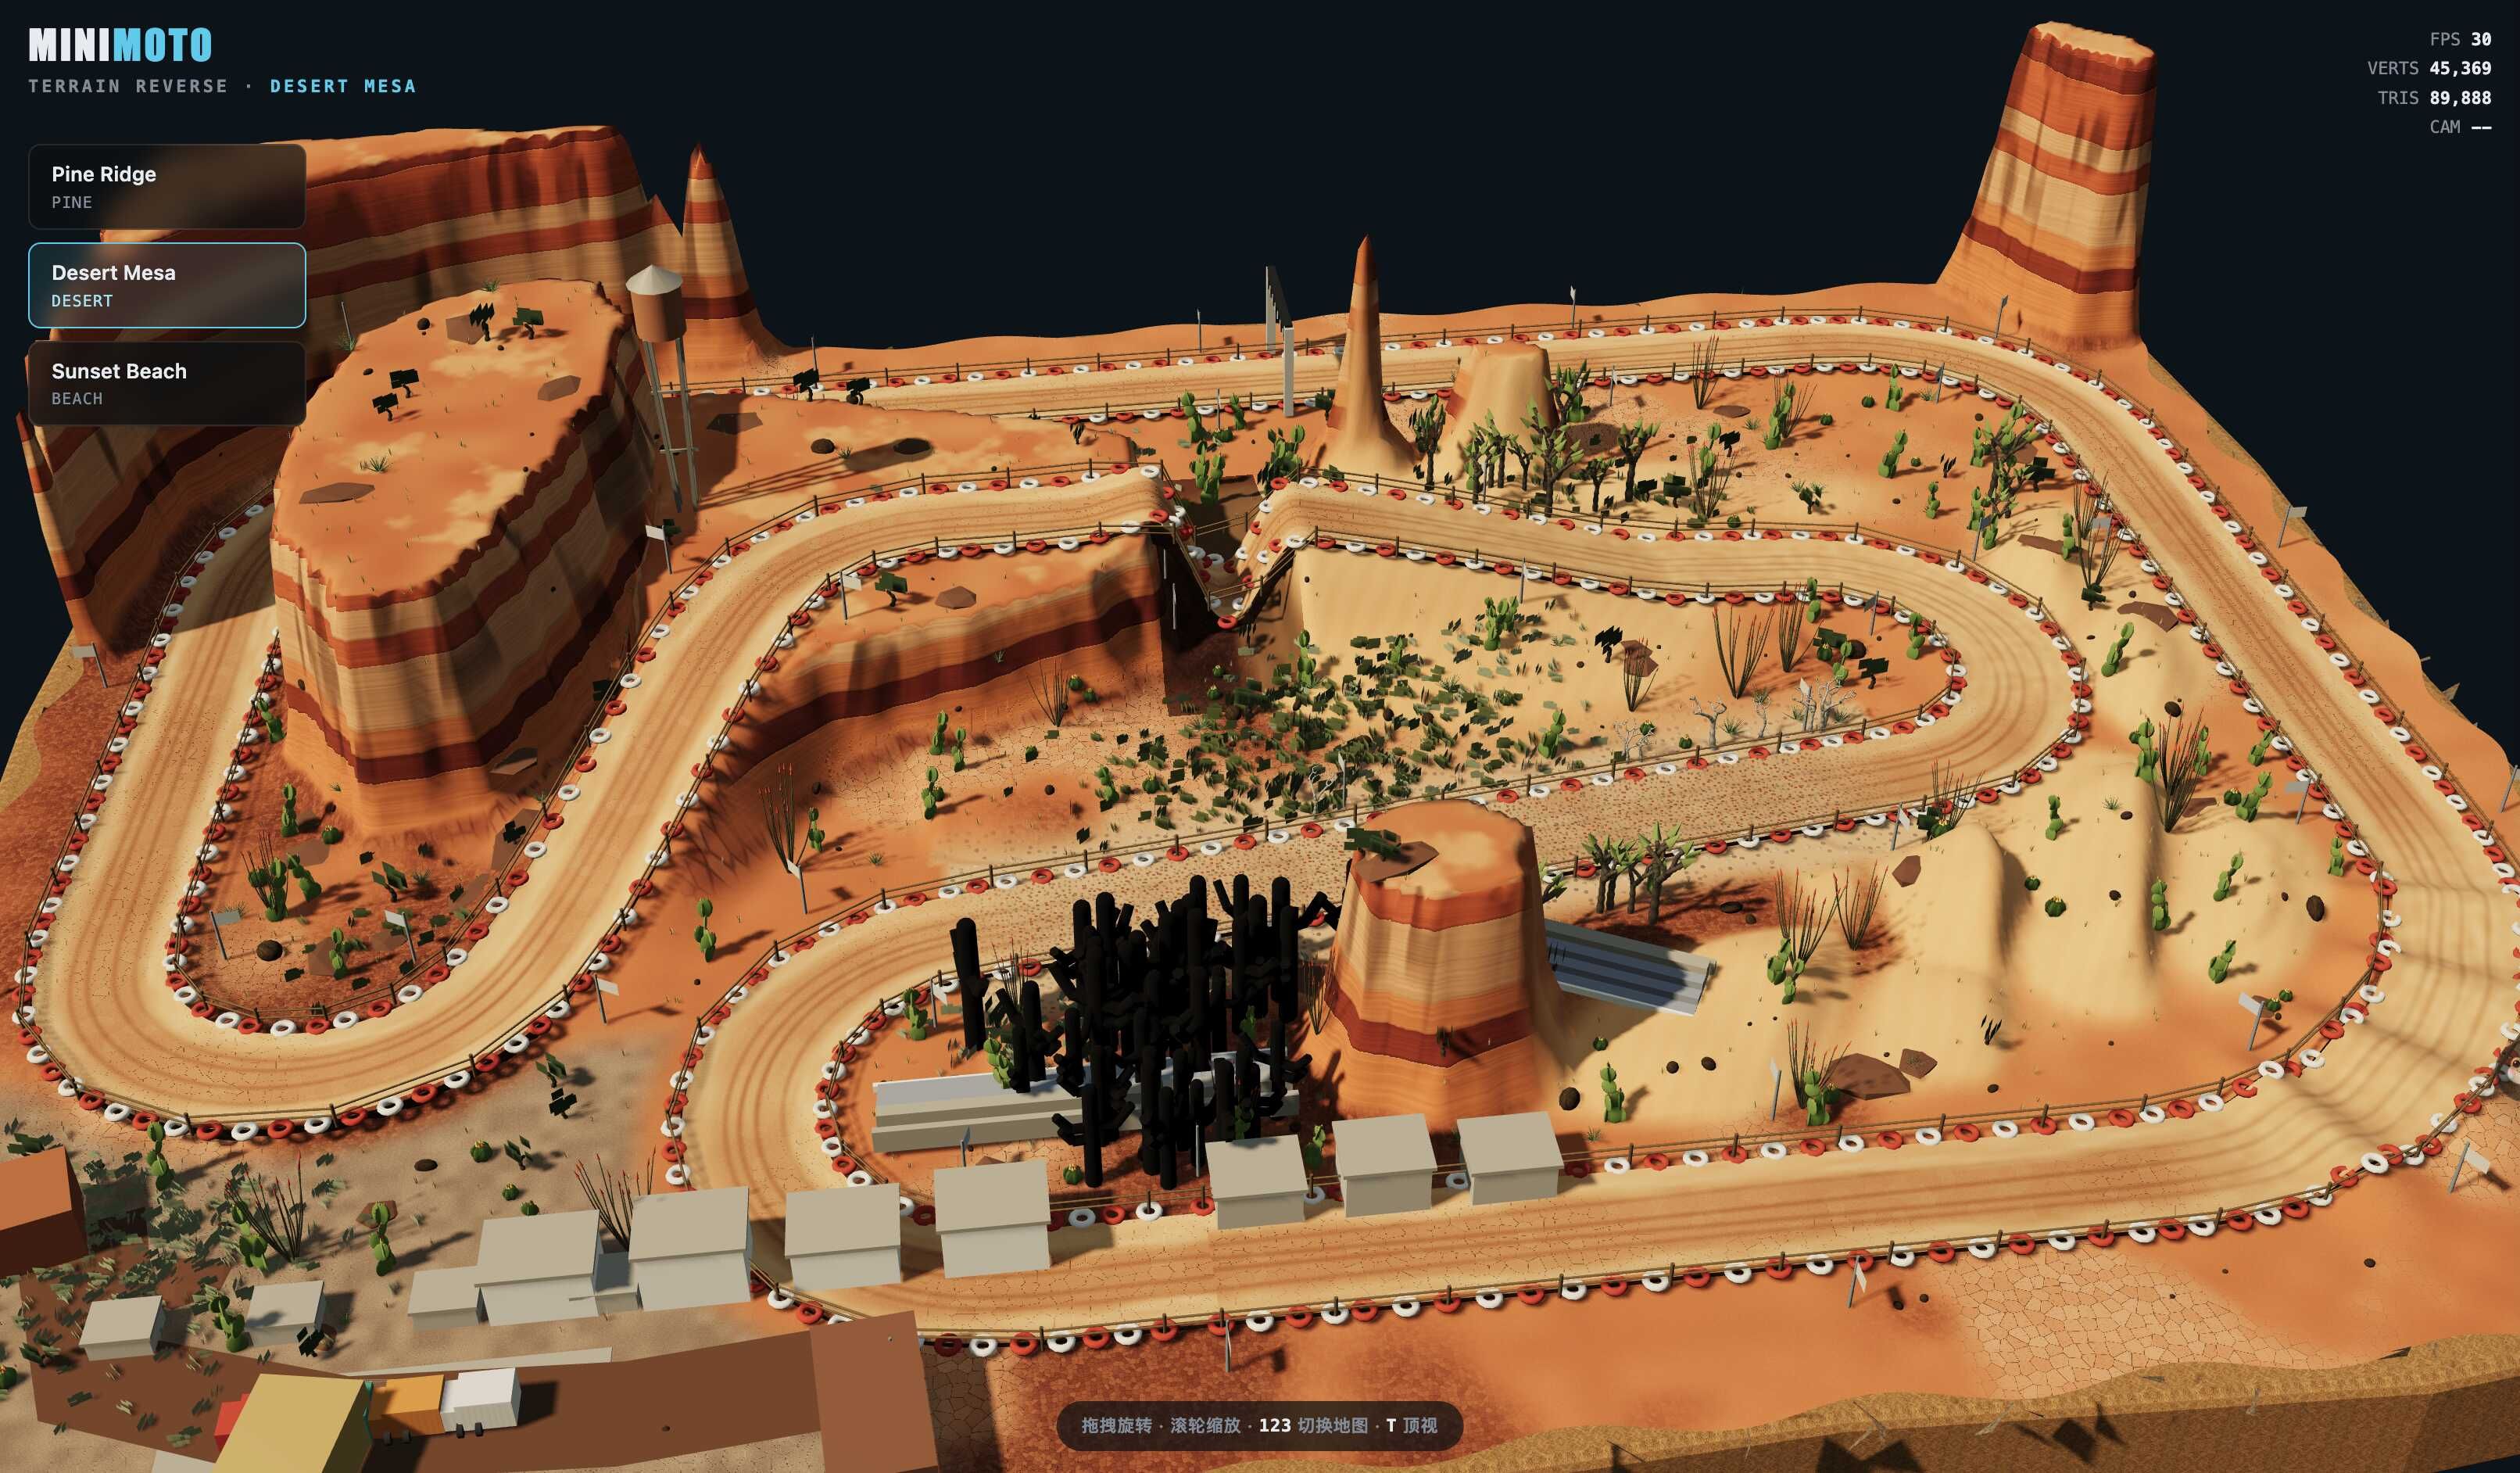
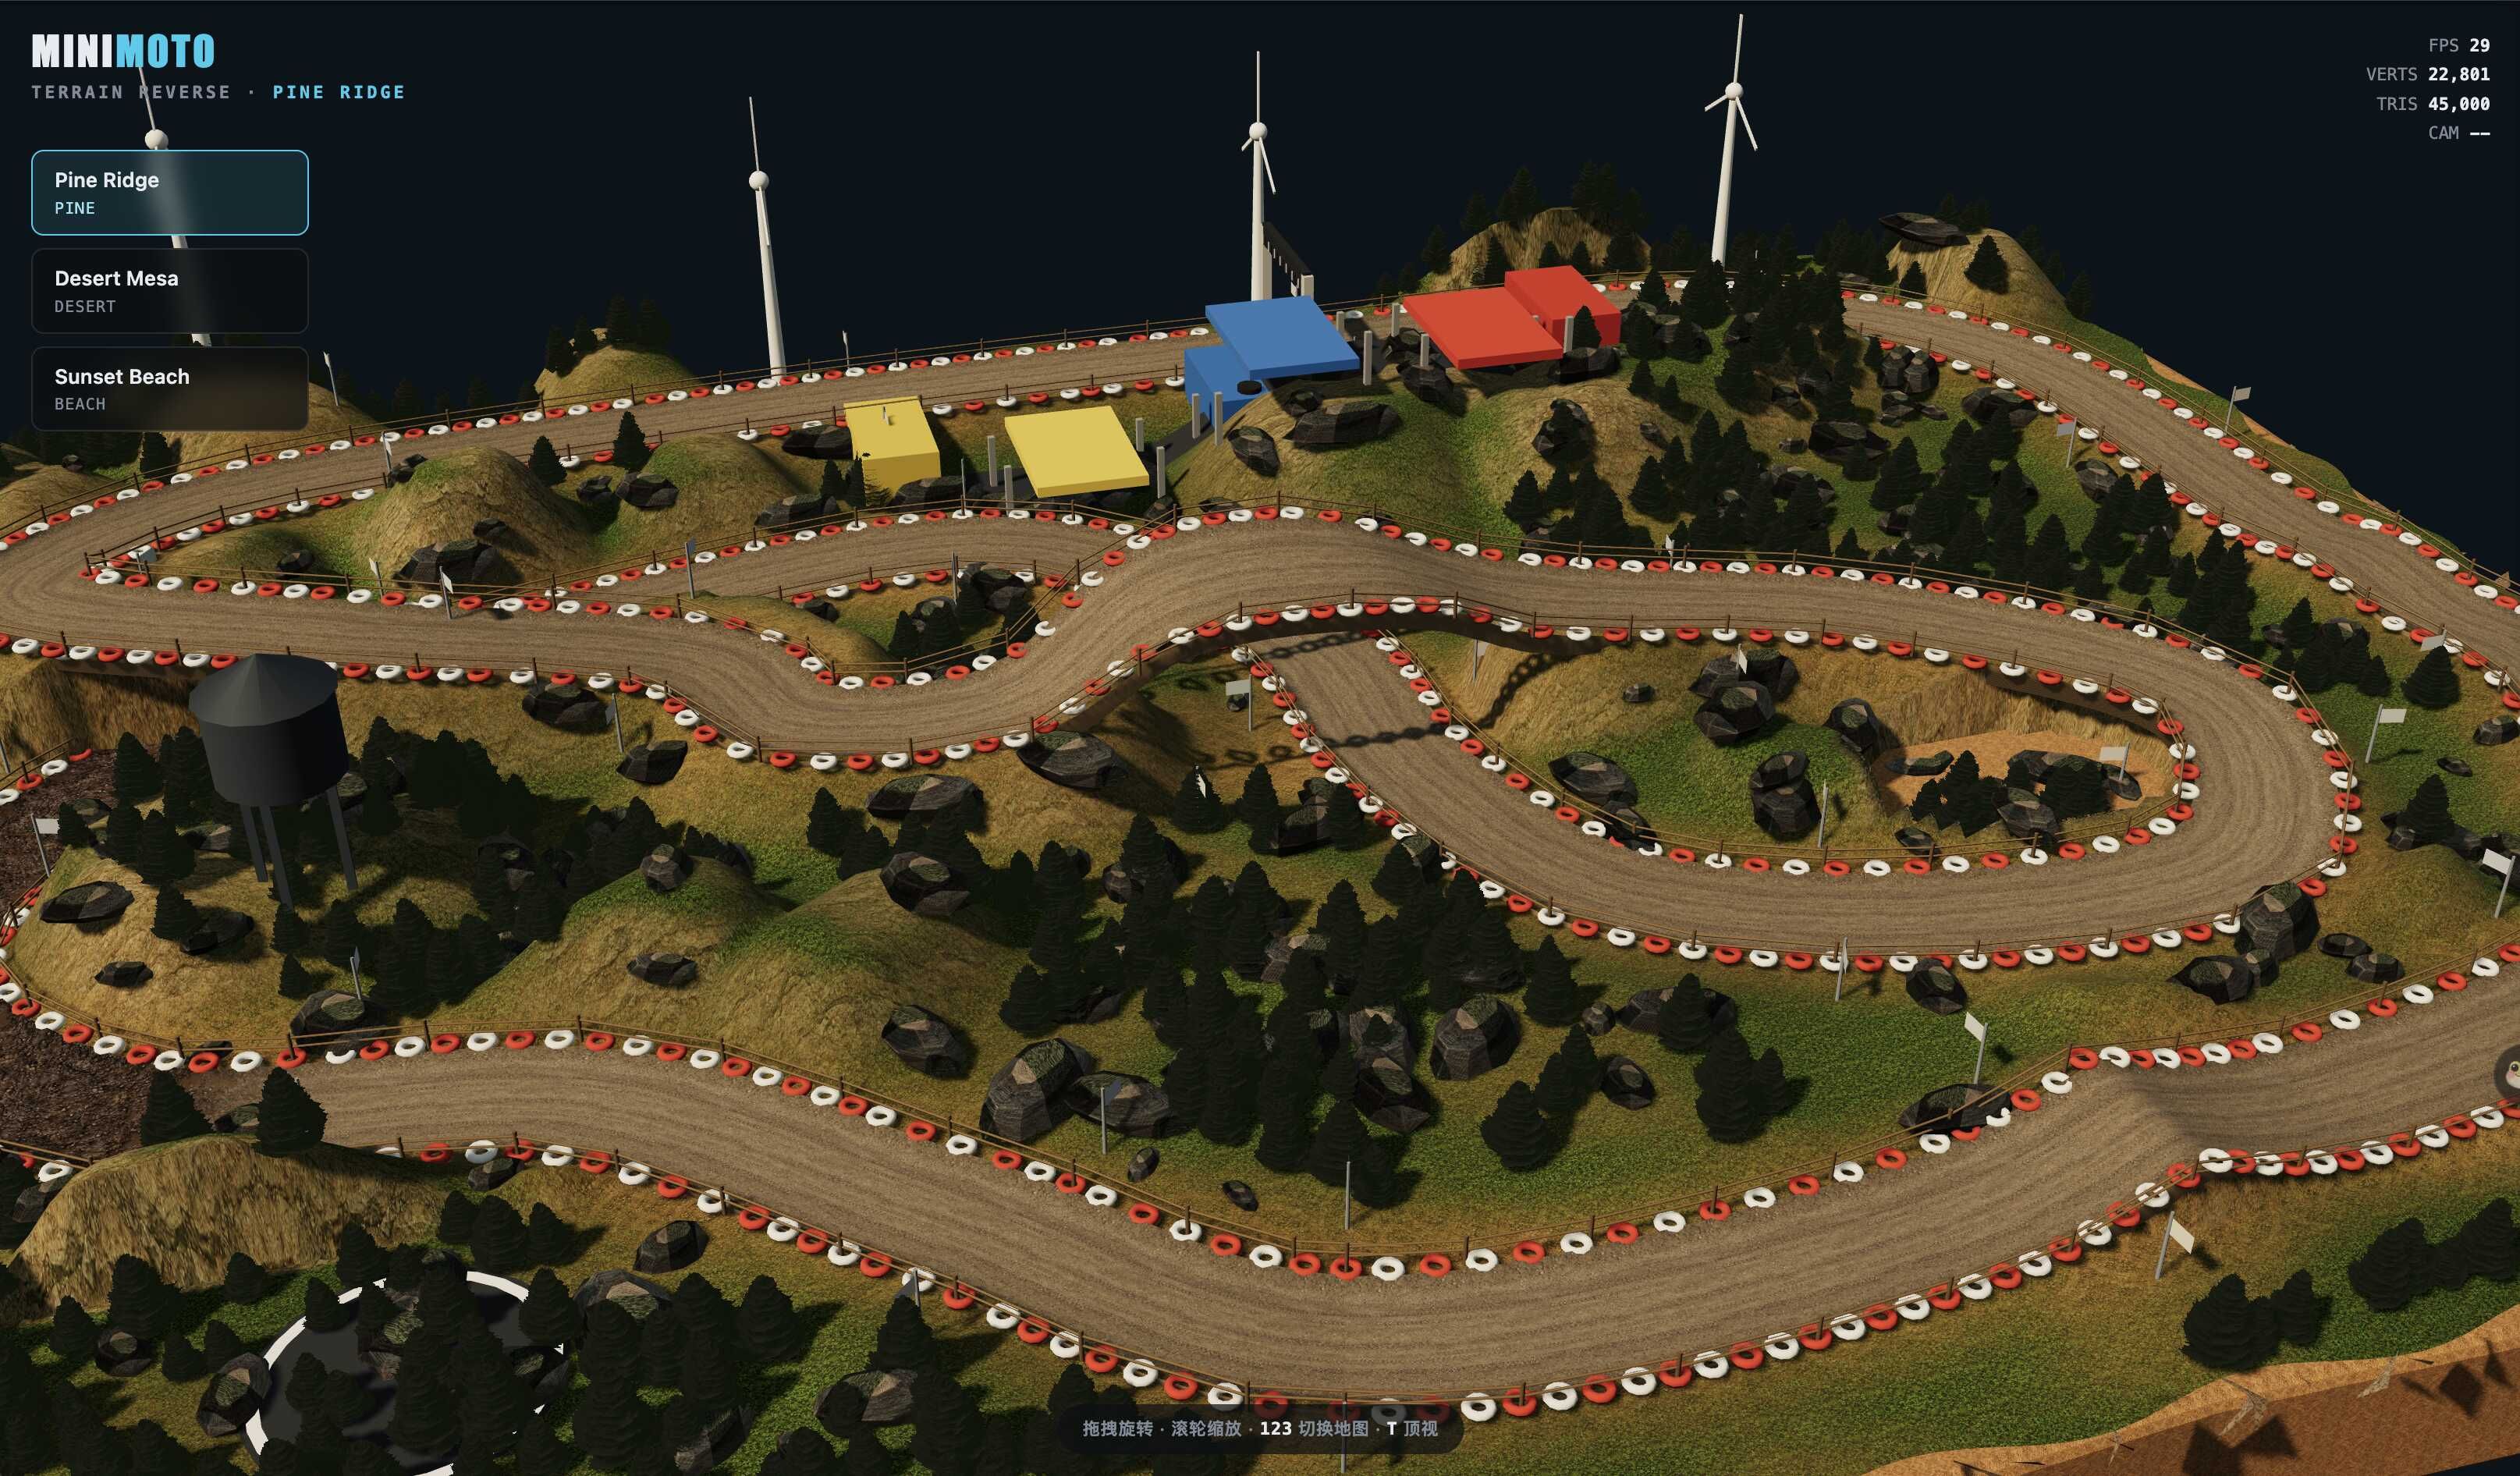
下图是我拿Minimax M3.1 Flash Preview 复刻的一个博主的3d js游戏的场景,思考强度调的最高,改了好些次,现在能有原游戏的8分像了。
原游戏地址: https://mini-moto-park.chipchaunceytheonlyone.chatgpt.site/
它准确率不是100%
应用到财务流程中?
也不算严格用在财务流程里吧,我想做的其实就是一个自动化创建、提交报销单的应用,输入出差时长,或者报销类目的简单自然语言的描述,以及发票,水单之类的文件,然后这个应用自动化分析,审核,最终提交报销单,达到减少员工的报销工时的目的。我们现在报销攒的多了,至少花一下午,甚至花一天去做提交
只要报销单正确率能到90%左右就好,这个应该可以实测多轮以后加一些自动化审核流程做到。最终提交的报销单有些小错误也不要紧,有外包的人员来审核报销单的错误,打回来再由人来改就好了。
感谢!楼主这个插件挺好的,我加了一个小按钮触发监控卡片折叠展开,现在用DSH-Pocket在手机上监控远端服务器的GPU也很方便了XD
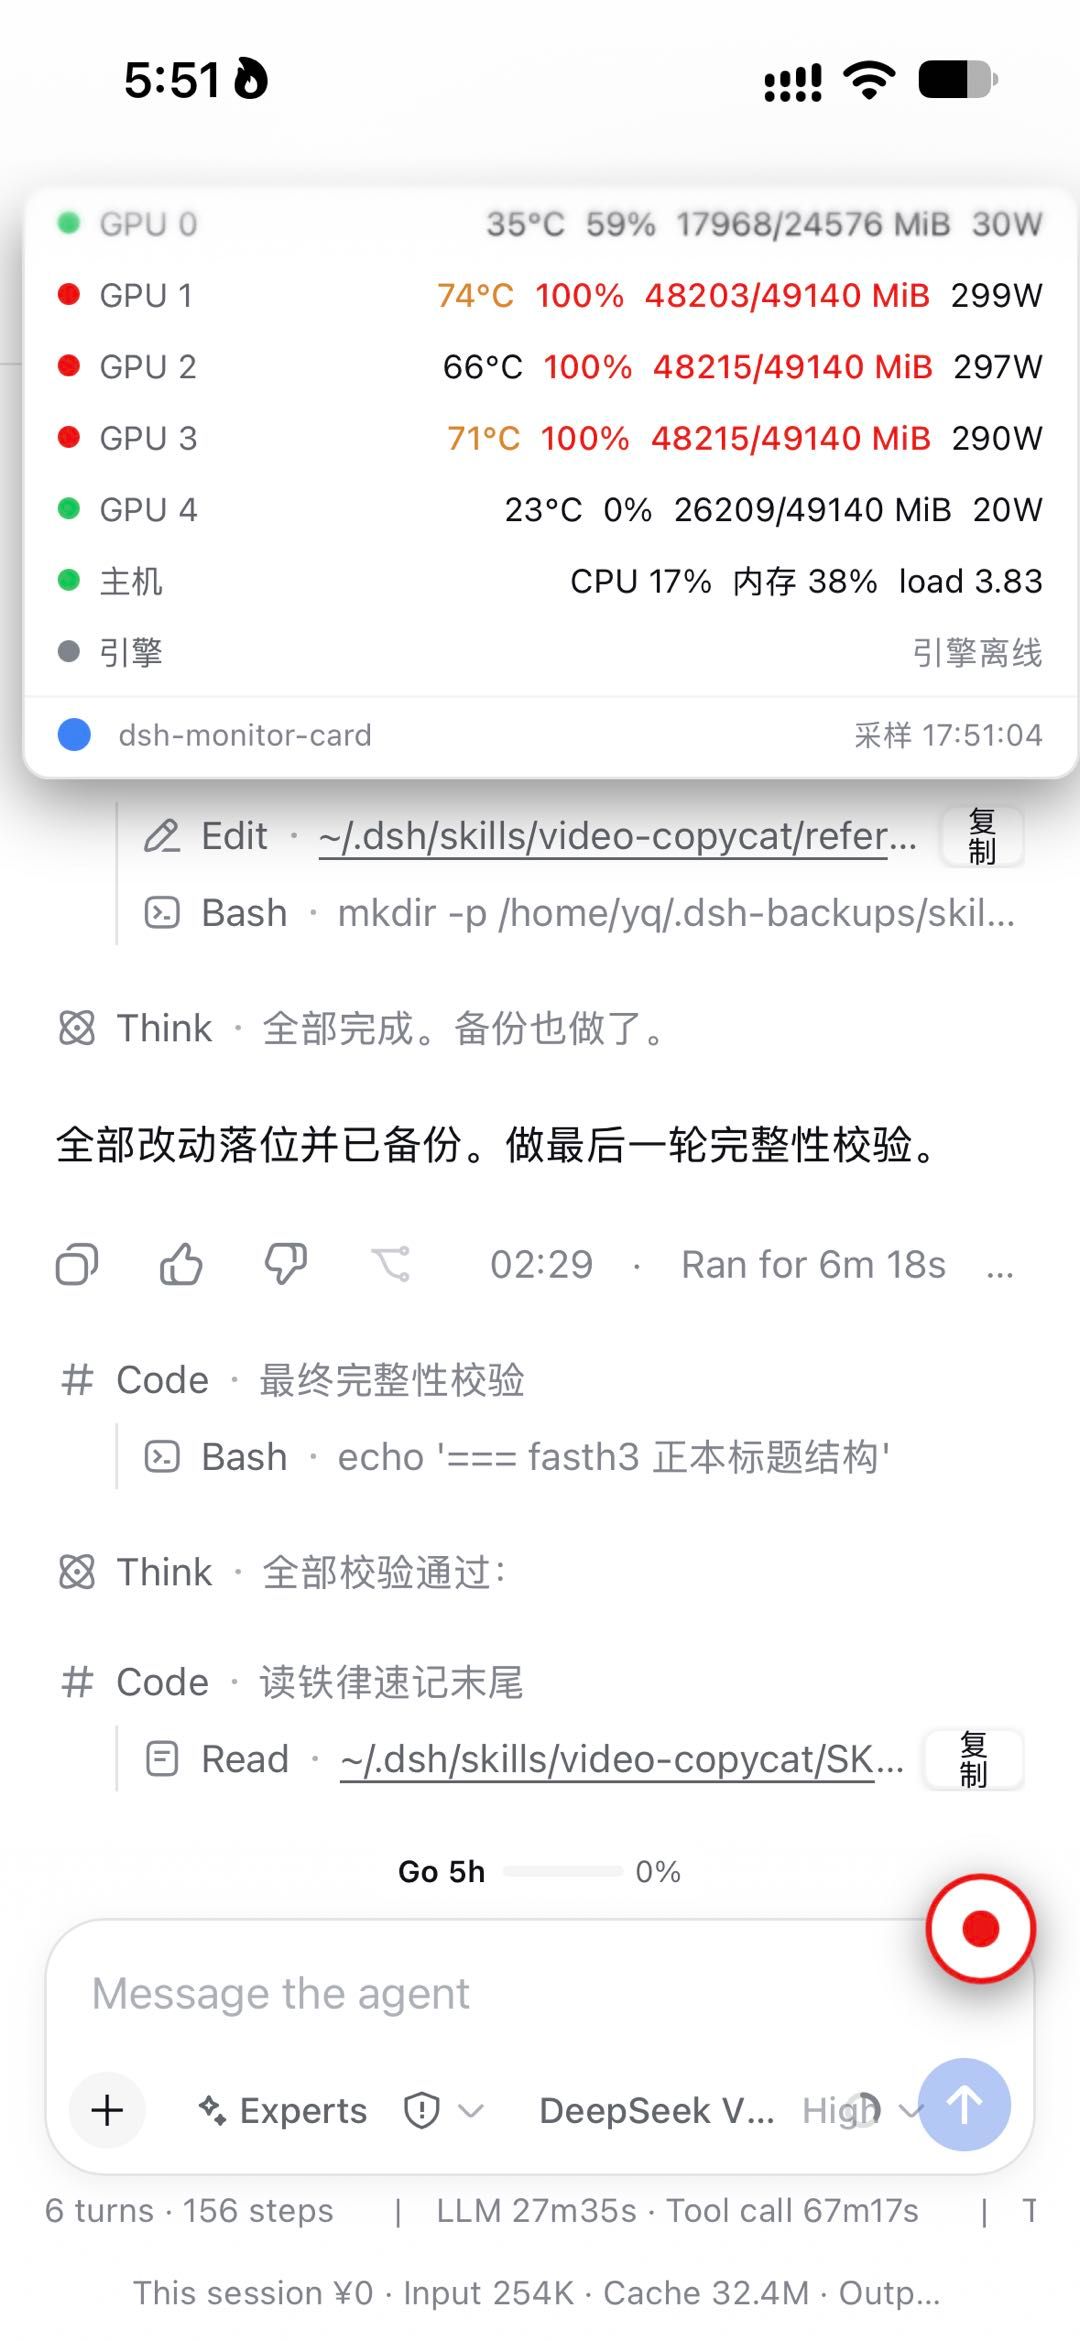
好帖,值得好好学习。最近我正在研究怎么优化公司的四块 A6000 跑 comfyUI H3生视频任务呢,raylight 四卡加速和拆分四卡做独立任务我都试过,各有优劣,还没还没琢磨出一个最优方案出来。我目前还是所有模型都跑在一张卡上,毕竟 A6000 显存有 48G. Diffusion model 选的 INT8 的.搞不懂为什么 A6000 单卡跑视频的速度还不如同任务同工作流和参数设置的 3090。
发帖缘起:JEV 发布那天刷屏了,最抓人的说法是「7 秒查完一趟机票、每步不到 3 分钱」。我看完第一条反应不是转发,是想确认这东西能不能用到我这台 Linux 机器上。我平时让 agent 操作桌面用的是 computer-use 插件,速度一直是它的短板,我在前帖里形容过是「老年手速」。当晚就去申请了 JEV 的 Waitlist,第二天通过,然后花了两个晚上把链路拆开重接了一遍。这篇是完整记录。
前帖:《把 DSH 装进口袋:IM + Pocket + Computer Use 三个插件实测记录》→ lcz.me/topic/1678/9
适合谁看:已经在用 computer-use、嫌它慢的;高负荷computer-use 应用需要省token的人
先把我实测用到的东西放这儿:
结论:同一个任务、同一台机器,操作时间从 271.4 秒降到 27.41 秒,差 9.9 倍,指针全程在屏幕上真的动。
▲ 全程 1 倍速,没有剪辑。鼠标是真的在屏幕上移动、滚动、点击。
任务是这样一句话:
打开 NBA 官网首页,逐屏往下翻,找到库里的新闻,点开,从头翻到尾。
| 改之前 | 改之后 | |
|---|---|---|
| 总耗时 | 271.4s | 27.41s |
| 交互轮次 | 13 次工具调用 | 8 步 |
| 平均每步 | 19.4s | 3.08s |
| 怎么读屏 | 全屏截图送进多模态模型 | 读结构化 DOM,46ms |
| 怎么决策 | 模型看图后输出一段话 | TypeSafe 一次 Choice,约 1s |
271.4 秒那次我事后数了一遍:13 次调用,每次 19.4 秒。这 19.4 秒里浏览器真正干的事,滚一屏或者点一个链接,是毫秒级的。
时间花在这些地方:截取 2560×1440 全屏、编码成图片、把图片塞进 agent 的上下文、模型读完图决定下一步、再发出动作。中间两步是纯开销,而且每加一步就多花一次。
也就是说,慢的不是鼠标,是每一步都要一个多模态模型重新看一遍屏幕。
翻 JEV 代码的时候看到 README 里这段:
It never sends a screenshot to a big model. Instead it reads the screen deterministically, asks a small classifier which action comes next, and only calls a writing model when a text field genuinely needs free text.
拆开是三条:读屏要确定性地读,不让模型看图;决策是选择题,不是生成,因为大多数步骤不需要计划,只需要从一张短列表里挑一个;只有真的要填字时才请语言模型。
于是每步从「截图 + 多模态推理 + 等几秒」变成「读状态 + 一次 Choice + 执行」。
JEV 原生操作的是浏览器里的一个 tab。我想要的更多一点:操作我那块真实桌面,让指针真的动起来。
链路改成这样:
CDP 读结构化 DOM(46ms,截图不进任何模型)
        │
        ▼
TypeSafe jev-latest 一次 Choice
  ├─ operation    : CLICK / SCROLL_DOWN / SCROLL_UP / DONE / BLOCKED
  └─ click_target : 编号元素表(带 covered 遮挡标记)
        │
        ▼
XTEST 真实输入(指针移动、点击、滚轮)
        │
        ▼
read / decide / act 分段计时 → JSON
动手前我先验证了三个前提,不然写完发现走不通就白干。
读屏这块直接拿 JEV 的 snapshot.js 用。它本来就在做「原子性地读可见控件、保留真实 DOM 节点、算遮挡」,我实测 46 毫秒读完 72 个可点元素。
动作这块,装了 python-xlib 之后测出 XTEST: True,指针可以真的移动和点击。用 CDP 自己的合成事件也能点,但那样指针不动,录屏上看像页面自己在变,说服力不够。
坐标这块,Chrome 用 --start-fullscreen 起来之后我测了一下:视口 2560×1440,屏幕 2560×1440,screenX/screenY 都是 0。视口坐标就是屏幕坐标,窗口偏移和标题栏高度那套换算全省了。
8 步,27.41 秒,平均每步 3.08 秒:
| 步 | 操作 | 置信度 | 本步 | read | decide | act |
|---|---|---|---|---|---|---|
| 1 | SCROLL_DOWN | 0.77 | 7.20s | 4450ms | 1020ms | 1725ms |
| 2 | SCROLL_DOWN | 0.66 | 2.29s | 81ms | 915ms | 1292ms |
| 3 | SCROLL_DOWN | 0.68 | 3.19s | 343ms | 1404ms | 1445ms |
| 4 | CLICK e35 | 0.70 | 1.39s | 75ms | 922ms | 389ms |
| 5 | SCROLL_DOWN | 0.17 | 2.81s | 373ms | 986ms | 1447ms |
| 6 | SCROLL_DOWN | 0.84 | 2.93s | 746ms | 894ms | 1293ms |
| 7 | SCROLL_DOWN | 0.30 | 3.74s | 2536ms | 970ms | 231ms |
| 8 | DONE | 0.33 | 1.07s | 66ms | 1006ms | 0ms |
第 4 步是它自己认出并点中库里那篇 THE ATHLETIC: CURRY'S CHOICE SHAPES WARRIORS FUTURE,最后停在 nba.com/news/steph-curry-decision-warriors-future。
第 1 步 read 花了 4.45 秒,原因是首次读屏撞上页面正在加载,不是链路本身的问题。分段计时就是为了能一眼看出这种事。
省下 9.9 倍的根源是读屏方式。改之前每步都要把一张 2560×1440 的图送进模型,再等它看完;JEV 读的是结构化 DOM,元素的角色、标签、能不能点、有没有被盖住,全是确定字段,46 毫秒读完,而且读屏这件事不再产生模型费用。每步从 19.4 秒降到 3.08 秒,省掉的 16 秒就是图像编码、传输和模型看图那一趟往返。
决策被还原成一道选择题。模型拿到的是一张编号元素表,它只需要回答「操作是哪个、目标是几号」。不用写描述,不用输出坐标或者选择器。JEV 的代码层从元素表里解析出每个可执行目标,模型输出永远不会变成选择器、坐标或可执行 JS。这既省时间,也把注入面收窄了。
概率和置信度是模型原生的。每步都返回一整套概率分布加一个校准过的 confidence,上表八步从 0.17 到 0.84 都有。这意味着链路可以按置信度分流:低置信就不落地、重新读屏,连续几次低置信直接停下,而不是硬点。我自己的 fork 里加了这层门控。
遮挡被当成一条事实交给模型。JEV 的读法会把「被别的控件盖住、点了会被拒」的元素标成 covered。模型看到这个标记,会先去滚动或者先关掉遮住它的东西,而不是反复点一个点不到的按钮。NBA 首页有 cookie 弹窗,改之前那版就卡在这里空转了 28 轮。
再补一条实际感受。改之前那版靠截图理解页面,cookie 弹窗或者横幅广告一盖住正文,它没法判断下面还有没有内容,只好先挪鼠标把这些浮层一个个关掉再往下走,光这一件事就能吃掉几十秒。JEV 读的是 DOM,遮挡关系是直接读出来的事实:哪个元素被盖住了、被谁盖住、盖住之后那个元素还能不能点,全都写在元素表里。模型不用先处理遮挡才知道正文在哪,能点就直接点,不能点就去点那个遮挡物。省下来的不是点那一下的时间,是试探和来回试的时间。
动作是真动作。XTEST 走的是真实指针和真实按键,页面收到的是正常用户输入。配合全屏 Chrome,整条链路里没有一处坐标换算。
每一步都能复盘。read、decide、act 三段分开计时,每步的置信度和落点都存成 JSON。哪一段忽然变慢,看一眼就知道。
decide 那一秒现在是最大的单项开销。JEV 官方 README 报的是 0.13 到 0.38 秒,我这里是 894 到 1404 毫秒,差的部分应该在到 TypeSafe 的网络往返上。
act 也有水分,1.3 到 1.7 秒是因为 14 个滚轮 tick 每个都 sync 了一次显示,间隔还能再压。
还有一条要说清楚:这套只在页面能被 CDP 读到的时候成立。原生桌面应用没有 DOM,那类场景仍然要走 OCR 加无障碍树那条路。这一版没做 OCR 回退,是明确的缺口。
改之前那版也不是没有可取之处。它每步都截图确认,所以不太会点错。慢和稳本来就是一件事的两面。
除了去官网申请 Waitlist,还有三个渠道可以直接体验 Jev:
typesafe-ai/jev。→ vercel.com/ai-gateway/models/jev这三个都是各家自己公布的限免政策,随时可能变,以官方页面为准。
发帖缘起:之前在《Minimax H3 小试牛刀》那个帖里回了一段关于「用 IM 远程给本地 agent 下指令」的经验,版主建议我整理成一篇单独发出来。这篇就是在原有回复基础上扩写的实测记录。
适用对象:DSH 跑在远端服务器(或家里的机器)上,人经常不在电脑前,但又想随时使唤它的人。
DSH 装在一台常年开机的机器上。麻烦在于:人一离开那台机器,这个 agent 就等于不存在了。
我遇到的实际场景就三类:
这条路我自己搭过:bot 收消息 → 转成 prompt → 调本地 CLI → 把输出回传,四步就能跑通。但真要长期用,有三个坑绕不开——长任务没回执(跑 20 分钟你以为它死了)、多人串上下文(得按 chat_id 分开维护)、权限敞开(谁拿到 bot 谁就能在你机器上跑命令)。DSH 生态里已经有现成的了,而且比我那层壳完善得多。
这篇记录三个插件,各自解决链路里的一段:
| 插件 | 解决什么 | 我的使用频率 |
|---|---|---|
| dsh-im | 把 DSH 接进 IM,用聊天窗口下指令、收结果 | 最高 |
| dsh-pocket | 手机扫码,直接看/操作电脑上那个 DSH 界面 | 次高 |
| dsh-computer-use | 让 agent 能真的动鼠标键盘,操作 Linux 桌面 | 偶尔,但关键时刻很顶用 |
三个仓库:
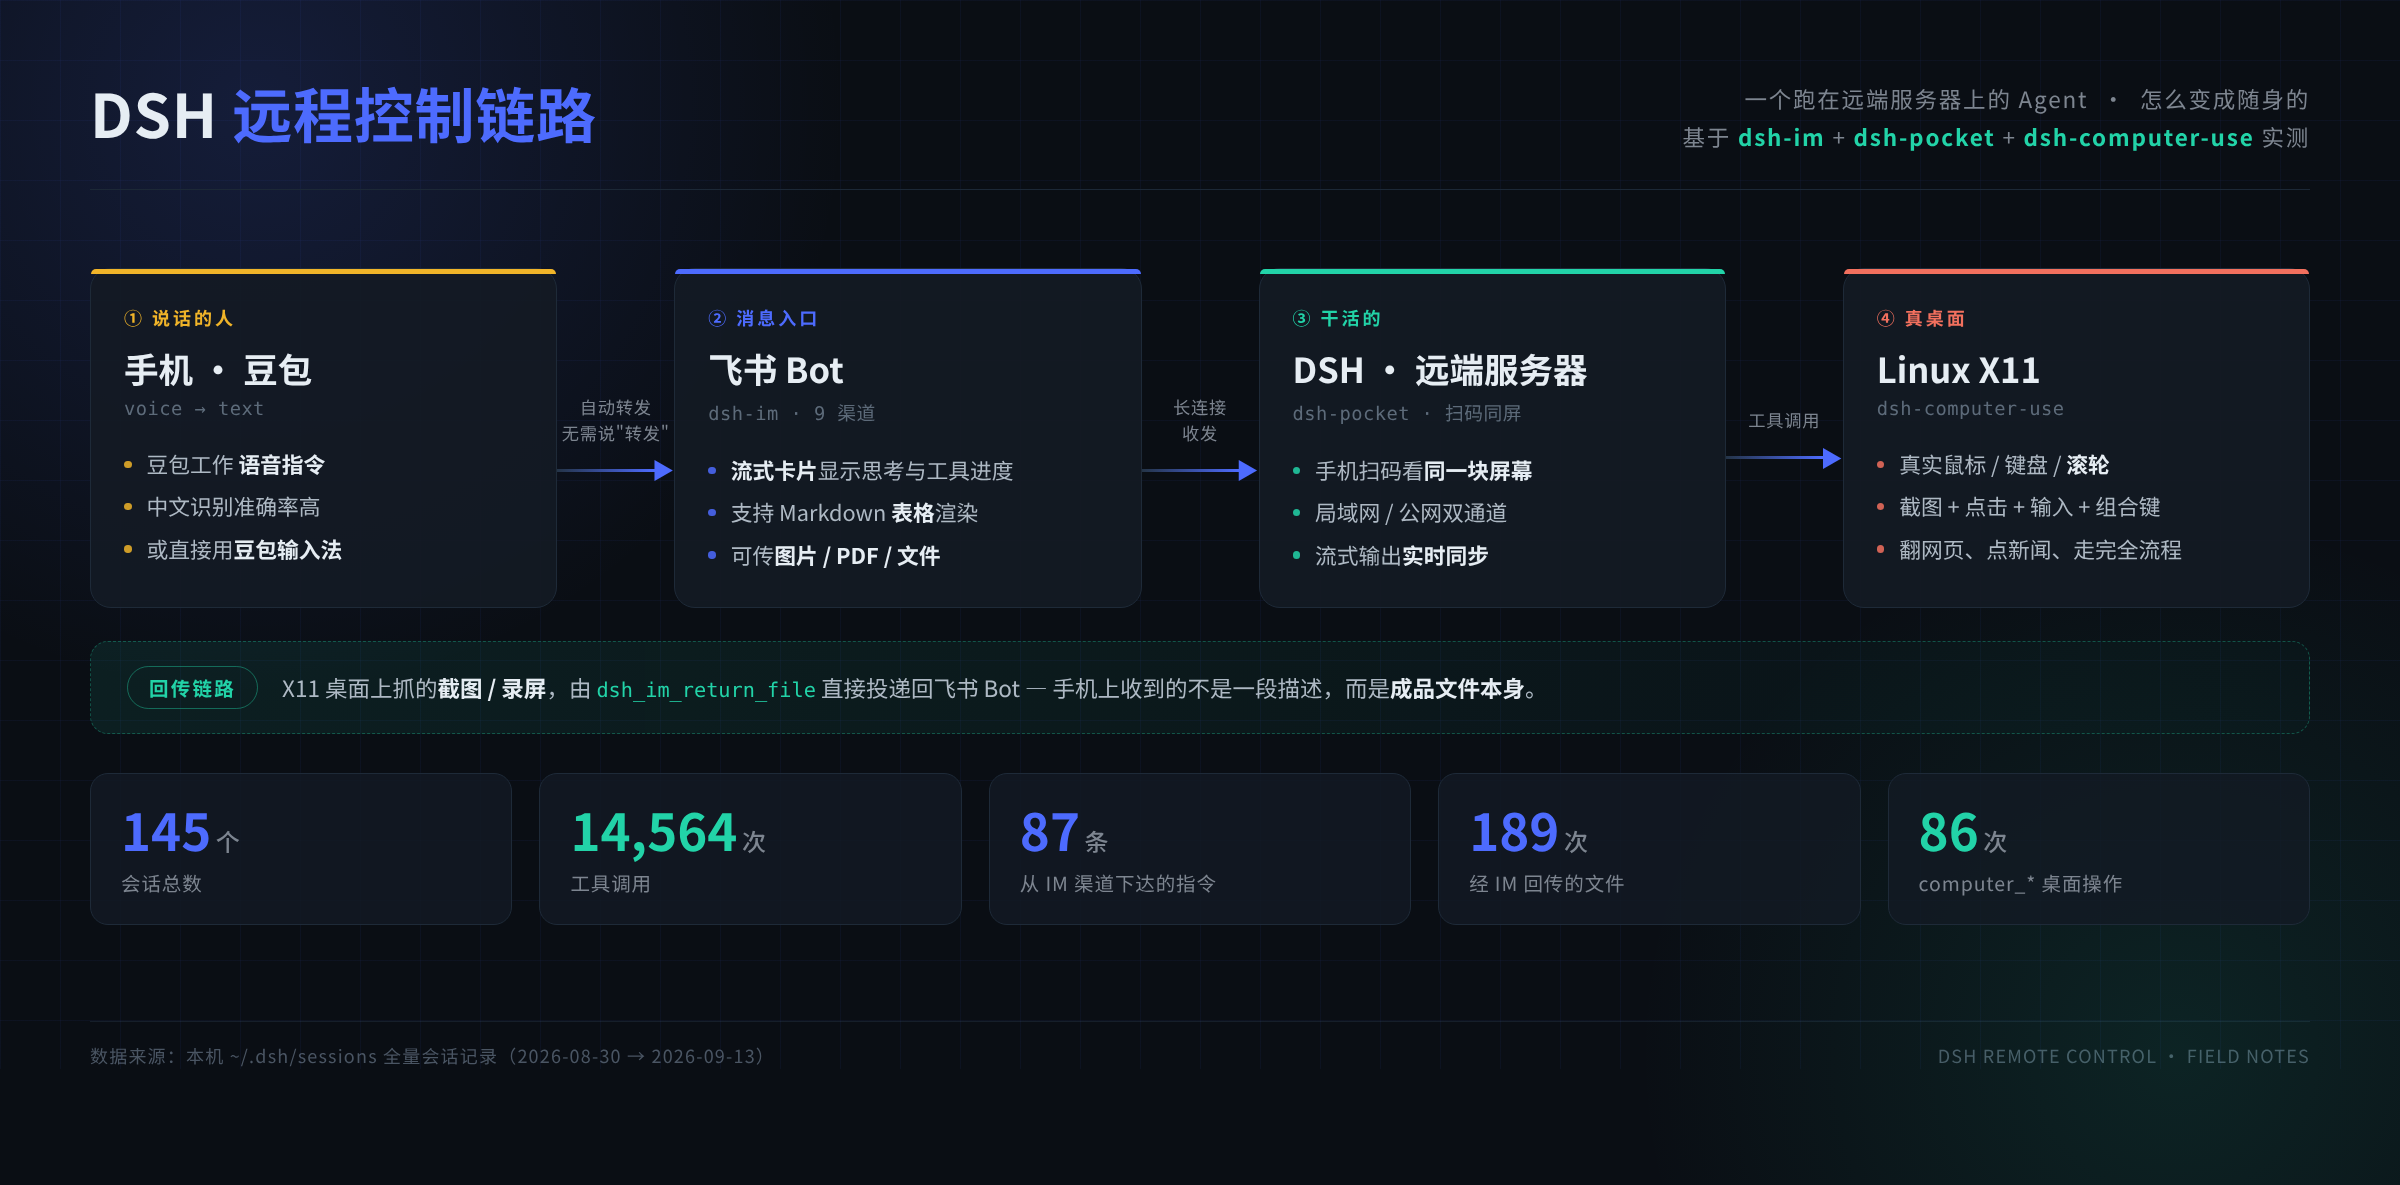
▲ 三个插件串起来之后的完整链路。下面逐个拆开讲。
IM 这条路最适合懒人——不用装客户端、不用记端口、不用配远程桌面,聊天窗口你已经天天在用了。
一个插件、一个设置入口,把本机 DSH 接到 IM 渠道上。目前内置 9 个渠道,外加 iMessage:
飞书、微信、钉钉、企业微信(含自建应用)、QQ、Slack、Telegram、Discord、WhatsApp
每个渠道都能接多个机器人,各机器人的连接状态、工作区、模型、会话绑定互相独立——这点很实用,等于一个人可以按用途分好几个入口。
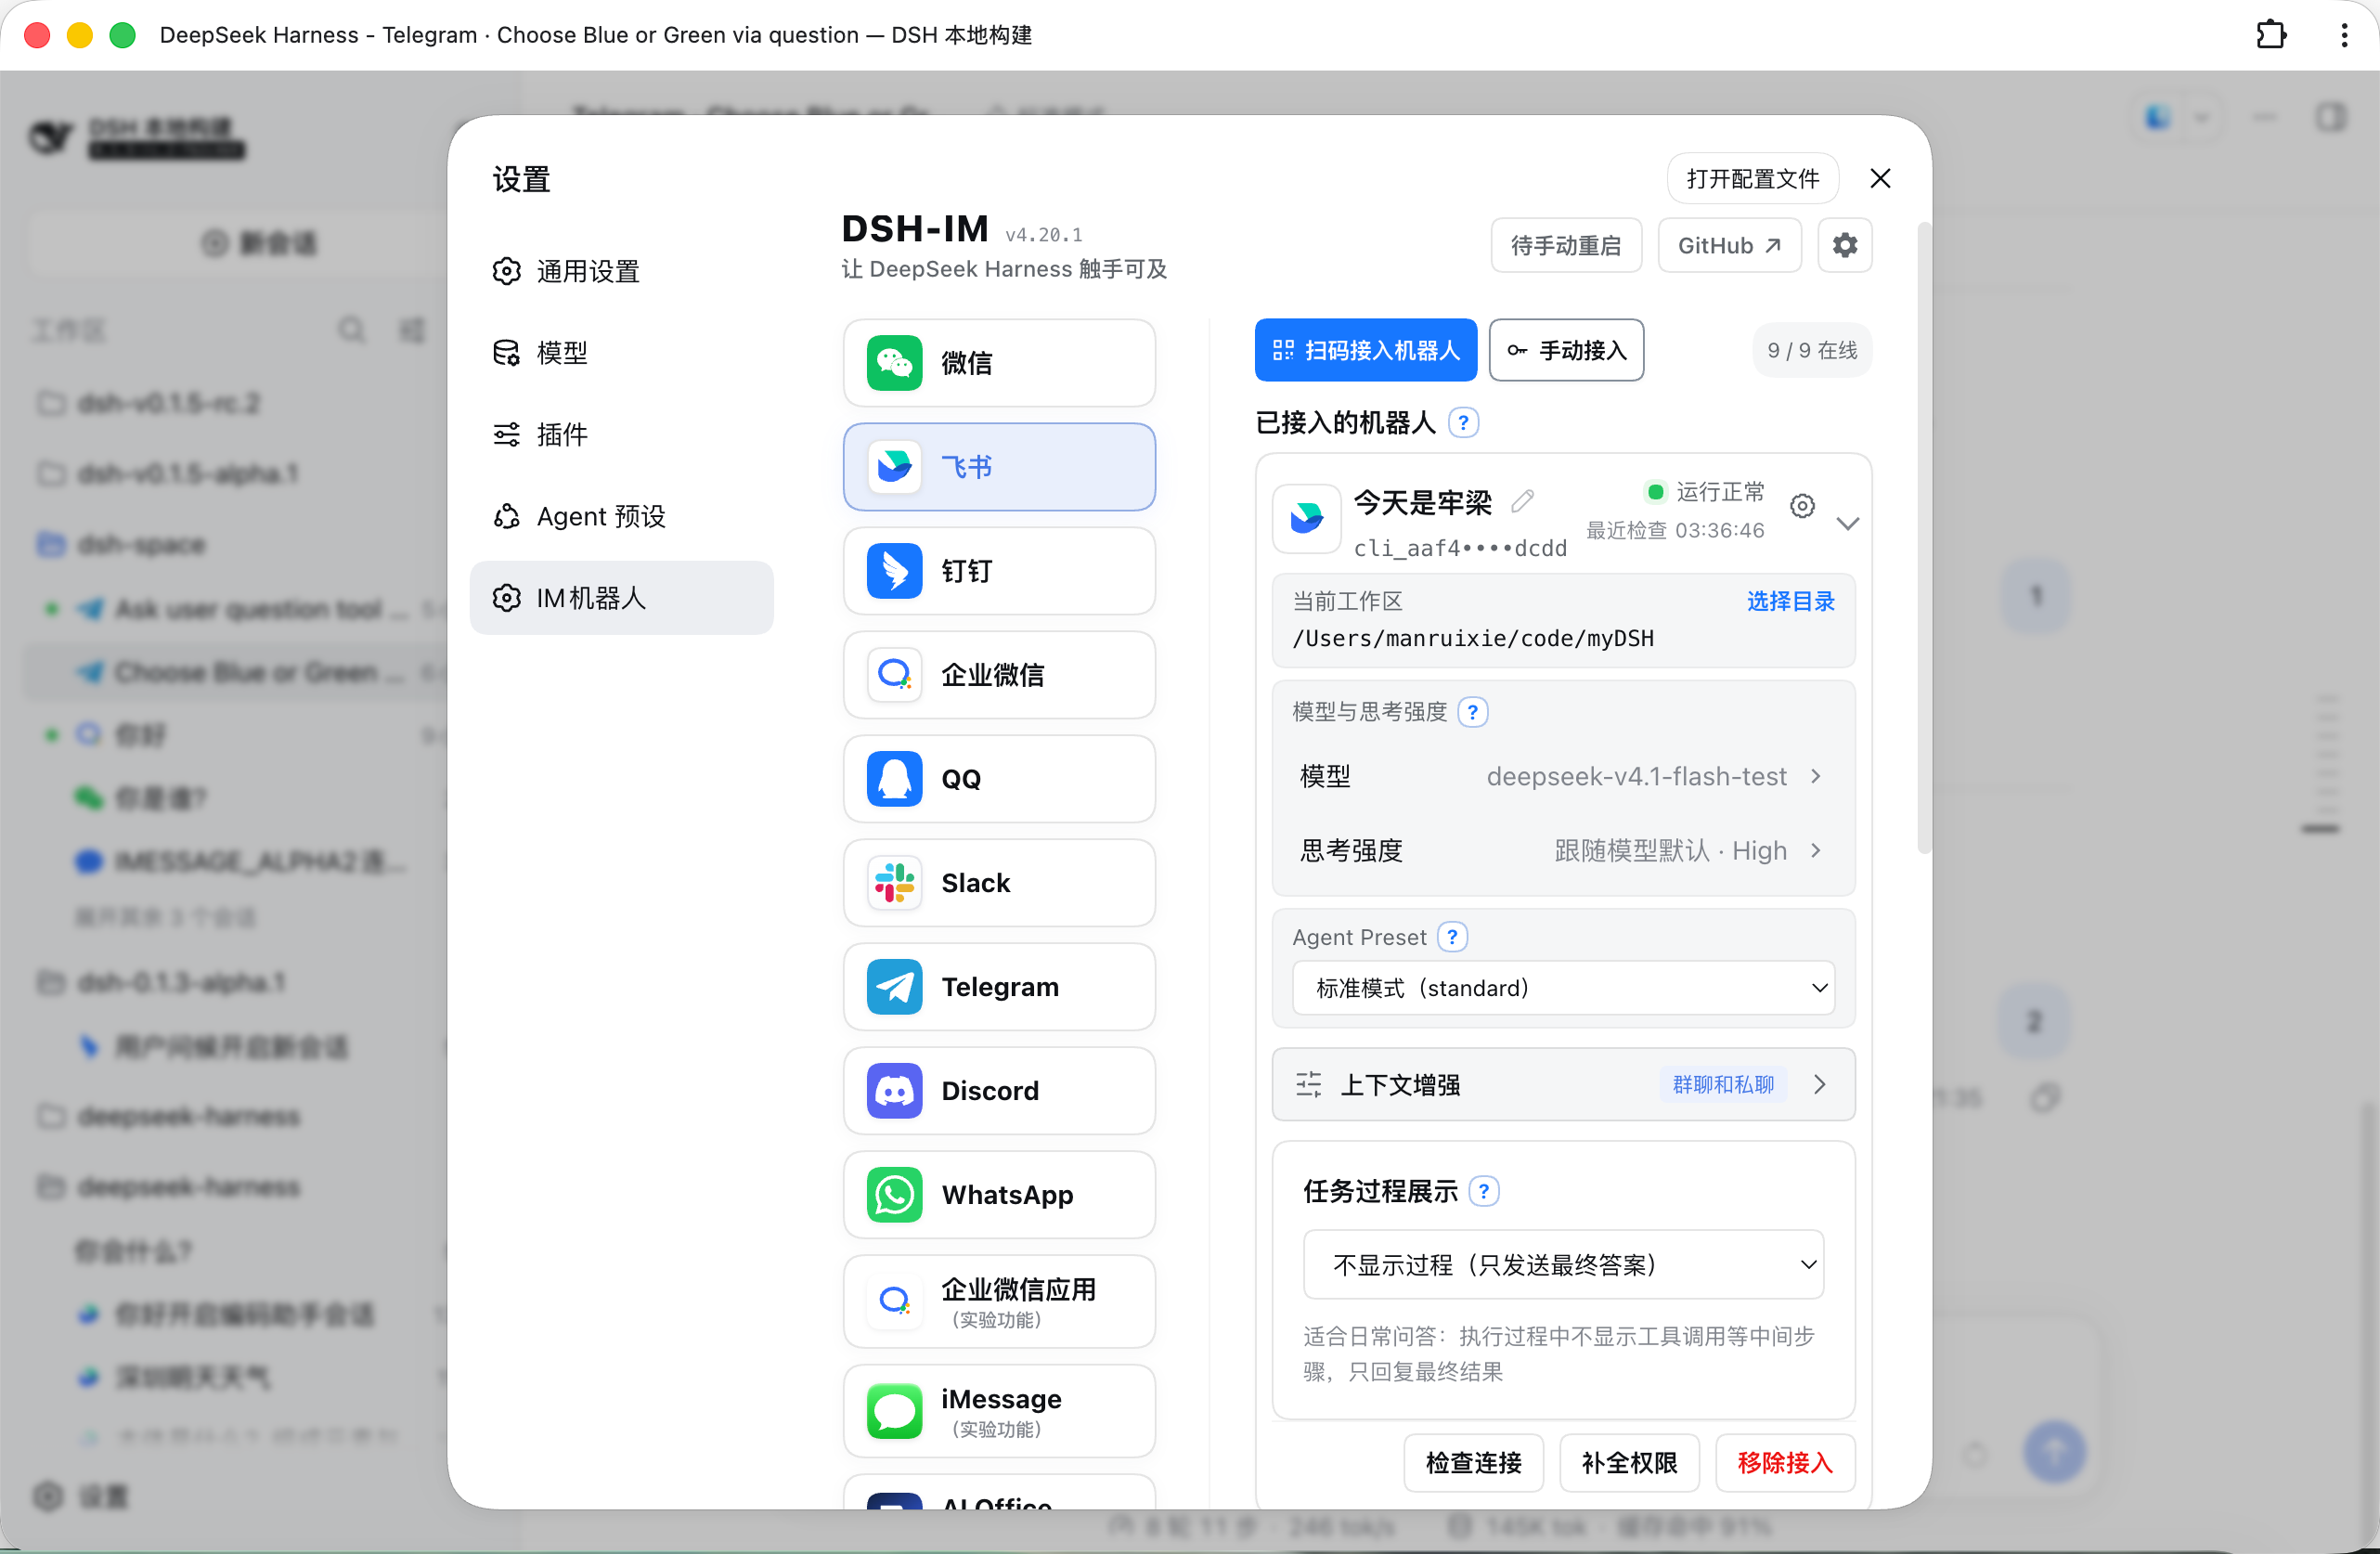
▲ 设置 → IM机器人:一个页面管所有渠道,每张卡片独立配工作区、模型、Agent Preset。
不是随便挑的,飞书这条链路有几个别家没有的好处:
1. 飞书自带豆包工作,语音指令能一路转给 DSH
这是我最看重的一点。我在手机上跟豆包工作说话,豆包把语音转成文字,自动转发给 DSH 飞书 bot,DSH 的回复直接出现在同一个聊天窗口。中文语音识别质量很好——老特在 YT 节目里讲过这个用法,我自己用了确实不错。不想用豆包工作的话,手机上直接装豆包输入法也行,体验同样可以。我的体验是豆包输入法适合你让DSH快速执行短指令,而不是复杂任务的时候用,它识别语音又快又准,当你想给DSH复杂指令,需要多轮对话整理思路的时候,用豆包工作更好(短指令豆包工作也要思考一会儿,没法把他的思考等级调到最低)。
在手机上跟豆包工作多轮对话、远程操控远端服务器上的 DSH,整个流程是顺的:说话 → 转文字 → DSH 干活 → 结果回到聊天窗口。
 DSH 自动转发说明(我自己在用的设置)
【自动转发】
你在豆包里发的消息,会自动转给 DSH,不用额外说"转发"。
DSH 的回复直接出现在当前聊天窗口。

【不转发的情况】
想跟豆包直接说话、不转给 DSH 时,开头说"豆包"或"先别转"。
例:"豆包,帮我总结一下刚才 DSH 的回复"

【自动等回复】
转发后豆包会每 10 秒查一次 DSH 有没有回复,最多等 3 分钟。
一有回复立刻摘给你;超过 3 分钟会提示"DSH 还在处理"。
2. 流式卡片,不把思考过程一股脑倒给你
这点明显比我自己写的壳强。插件对飞书 Bot 做了针对性的优化:思考过程、工具执行进度、回答是分层呈现在流式卡片里的,不是每来一个 token 就刷你一脸。手机上调参数、看进度都舒服。
3. 对表格和 Markdown 的支持很好
DSH 很爱输出表格,飞书这边渲染得住。这点对看结果很重要——一份对比结果过来,直接是张能读的表,而不是一坨竖线。
4. 文件双向
传进去:图片、PDF、文件都能带上,连「引用某条消息」的上下文一起交给 DSH。
传出来:DSH 生成的文件、截图、录屏,能作为渠道原生附件回传。我这边统计下来,这段时间里这个回传能力被用了 189 次。
5. 文件大小够用
飞书 IM bot 支持最大 30MB 的文件,比 Discord 免费版的 10MB 要好,mp4、图片、md、ZIP 这些都能传。
9 月 6 日我在外面,手上只有手机,需要处理一份《智能路面识别 ASIL-B 提升可行性评估报告》。做法是:
全程在手机上完成,没有打开过电脑。后来这个主题还延伸做成了《ISO 26262 功能安全》科普视频。
这就是「IM 接入」真正的价值:不是把聊天框变好看,而是让一份真实的、有上下文的工作,能在你不在电脑前的时候继续推进。
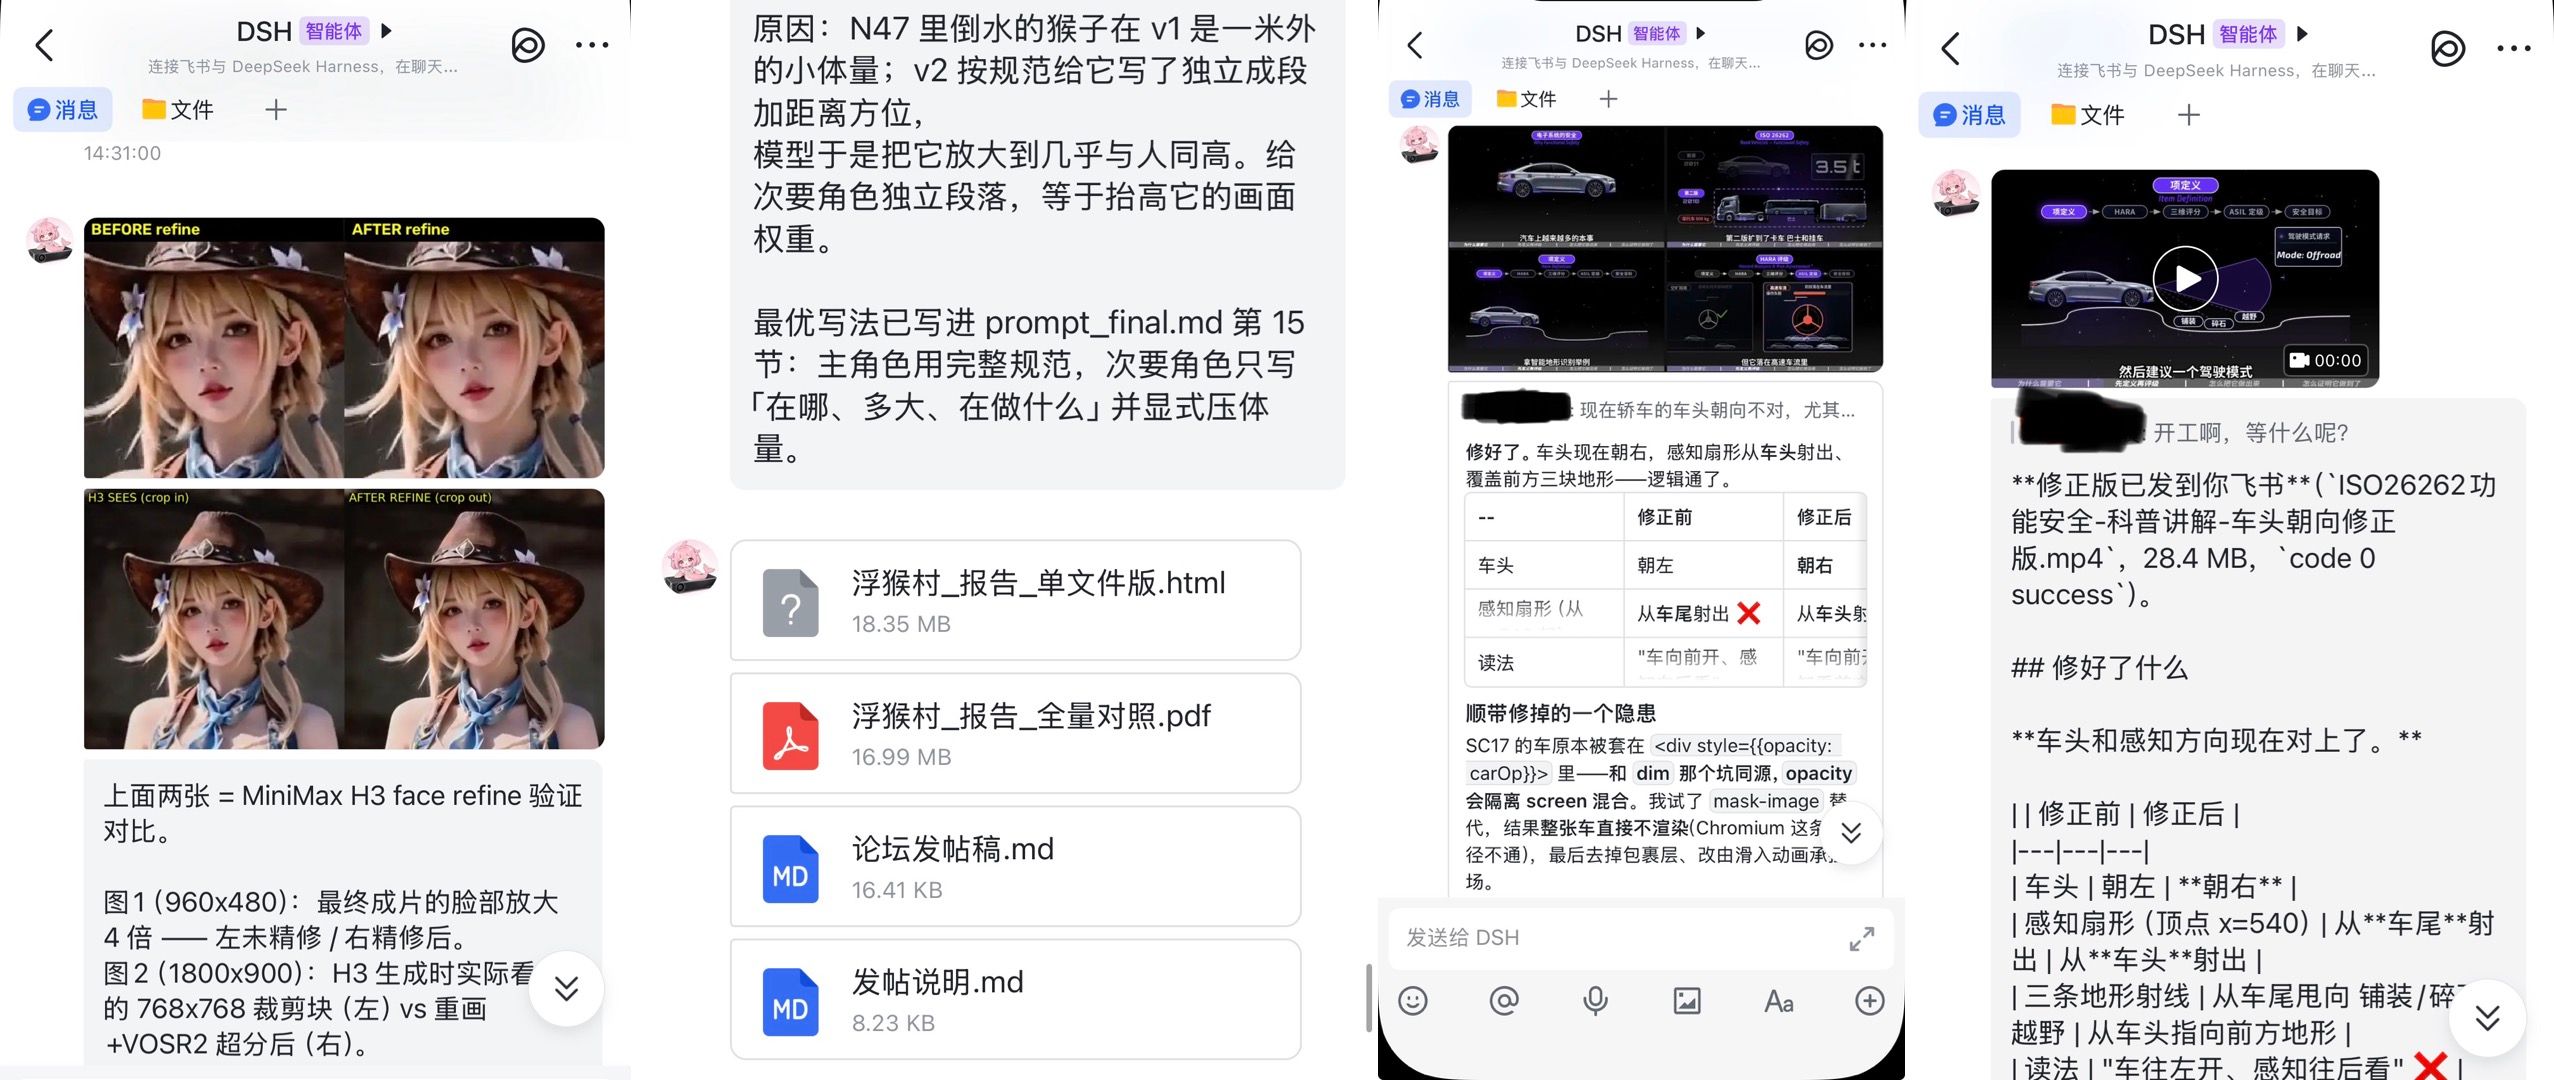
除了处理文档,我在 IM 里干得最多的另一件事是——看到好东西,链接一甩。
最简的一次就是一条链接加两个字:
https://x.com/…/status/2098371224006951151
抄作业
有时候连多余的字都不用说,因为上下文里它知道要干什么。比如在飞书上刷到一条效果不错的视频,直接把链接发过去,后面跟一句要求:
https://x.com/…/status/2098352621535072651
你使用 comfyUI,参考 4 步 lora 声音修复版 V2 的 json,
新写一个 JSON,模型使用 minimax H3 ref2V INT8,做一个同样的视频。
把拼接好的成品推送到 DSH 飞书 bot。
这条指令拆开看,其实是一整条流水线:扒原帖里的提示词 → 照我自己机器上的工作流改写 JSON → 跑出一条视频 → 成品回传到聊天窗口。我要做的只是把链接贴进去。
| 抄什么 | 怎么发 | DSH 干什么 |
|---|---|---|
| 一条推文的提示词 | 链接 +「抄作业」 | 读帖子、提取提示词、按我的工作流重跑一版 |
| 一整套工作流 | 推文链接 + GitHub 工作流链接 +「你抄一下这个作业」 | 下载依赖、跑通流程、出片 |
| 一个作者的整个作品集 | 作品页链接 +「抓取所有图的 prompt metadata」 | 翻页批量抓取、存成 MD、逐张复刻 |
| 一个现成的 skill / 插件 | GitHub 链接 +「你给我安装」 | 装好,然后给我跑示例 |
比如批量那一次:
使用 opencli,抓取并保存 noway163 的所有 Images 的 prompt all metadata,保存为 MD,要和网址关联。……我要你抓取他所有图的 prompt 的 metadata,让我可以抄他作业。
再往后就变成例行公事了——同一个作者的作品集,我会直接说「他的 Prompt 和 Metadata 你都给我存在本地,记得新建一个文件夹」,然后跟一句「定时任务也是一样的」。
因为**「看到好东西」这件事,发生在你刷手机的时候,不在电脑前。**
那条让你眼睛一亮的推文,出现在你通勤的地铁上、排队的间隙里。等三小时后你坐回电脑前,那个链接早就不知道沉到哪个 App 的哪条时间线里去了。
现在我只要顺手一甩,剩下的它自己去跑;跑完了成品还会自己回到这个聊天窗口——视频、PDF、打包好的 zip 都行。
把这 5 个视频发飞书 bot。
IM 适合「下指令、收结果」,但有时候你需要看着那个界面本身——比如它正在跑一个长任务,你想看它滚到哪里了;比如有个审批要点。
dsh-pocket 干的就是这个:装上后,手机扫个码,直接看到并操作电脑上的同一个 DSH 界面,实时同步。
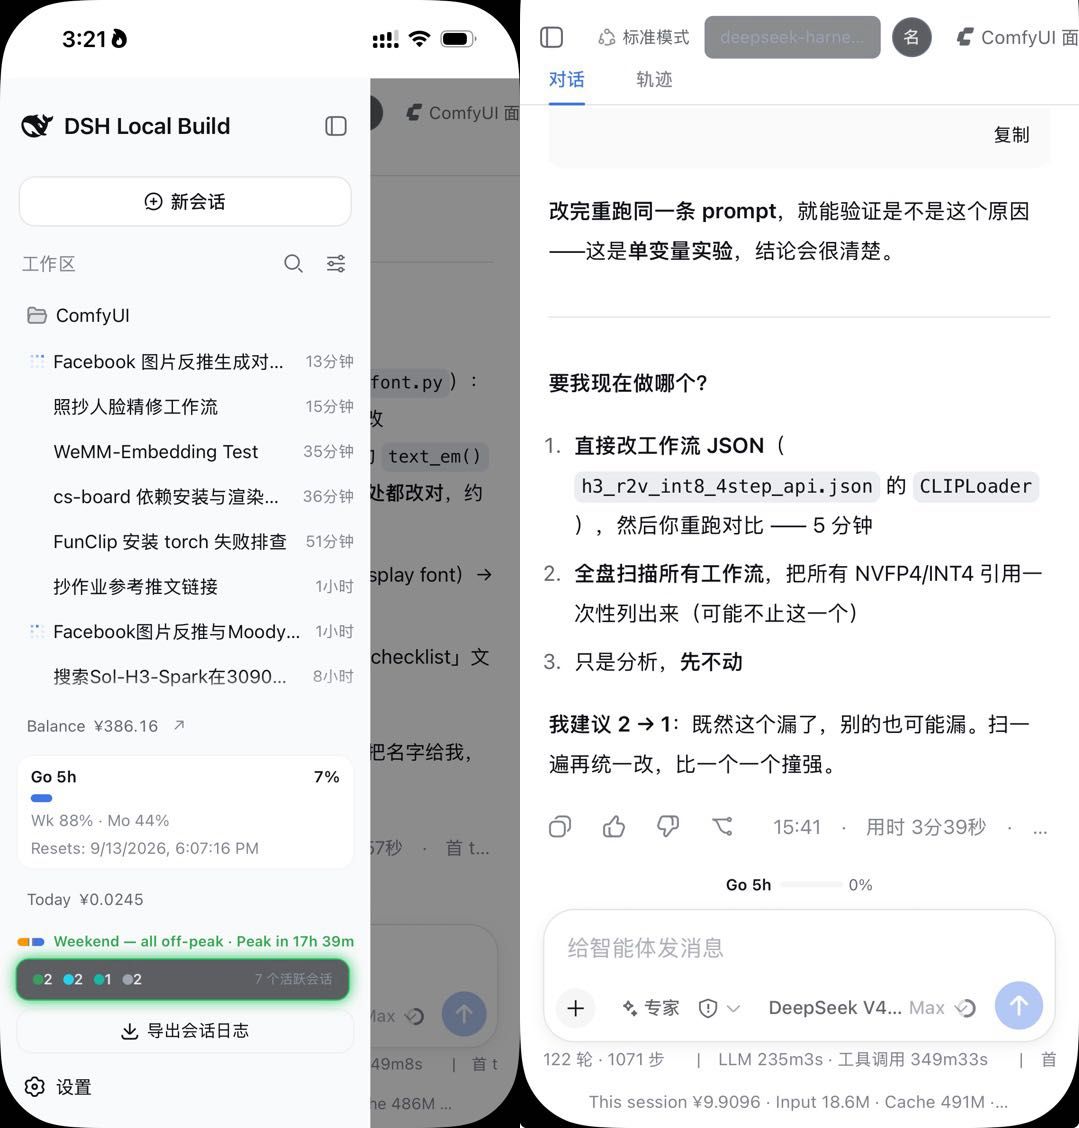
▲ 手机上的界面就是电脑上的界面,流式输出实时同步。
我配的是第三条,买了一个阿里云的域名,让后照着AI教的配好Cloudflare named tunnel。最后按照dsh-pocket一步步设置,就能在手机上公网控制DSH了。
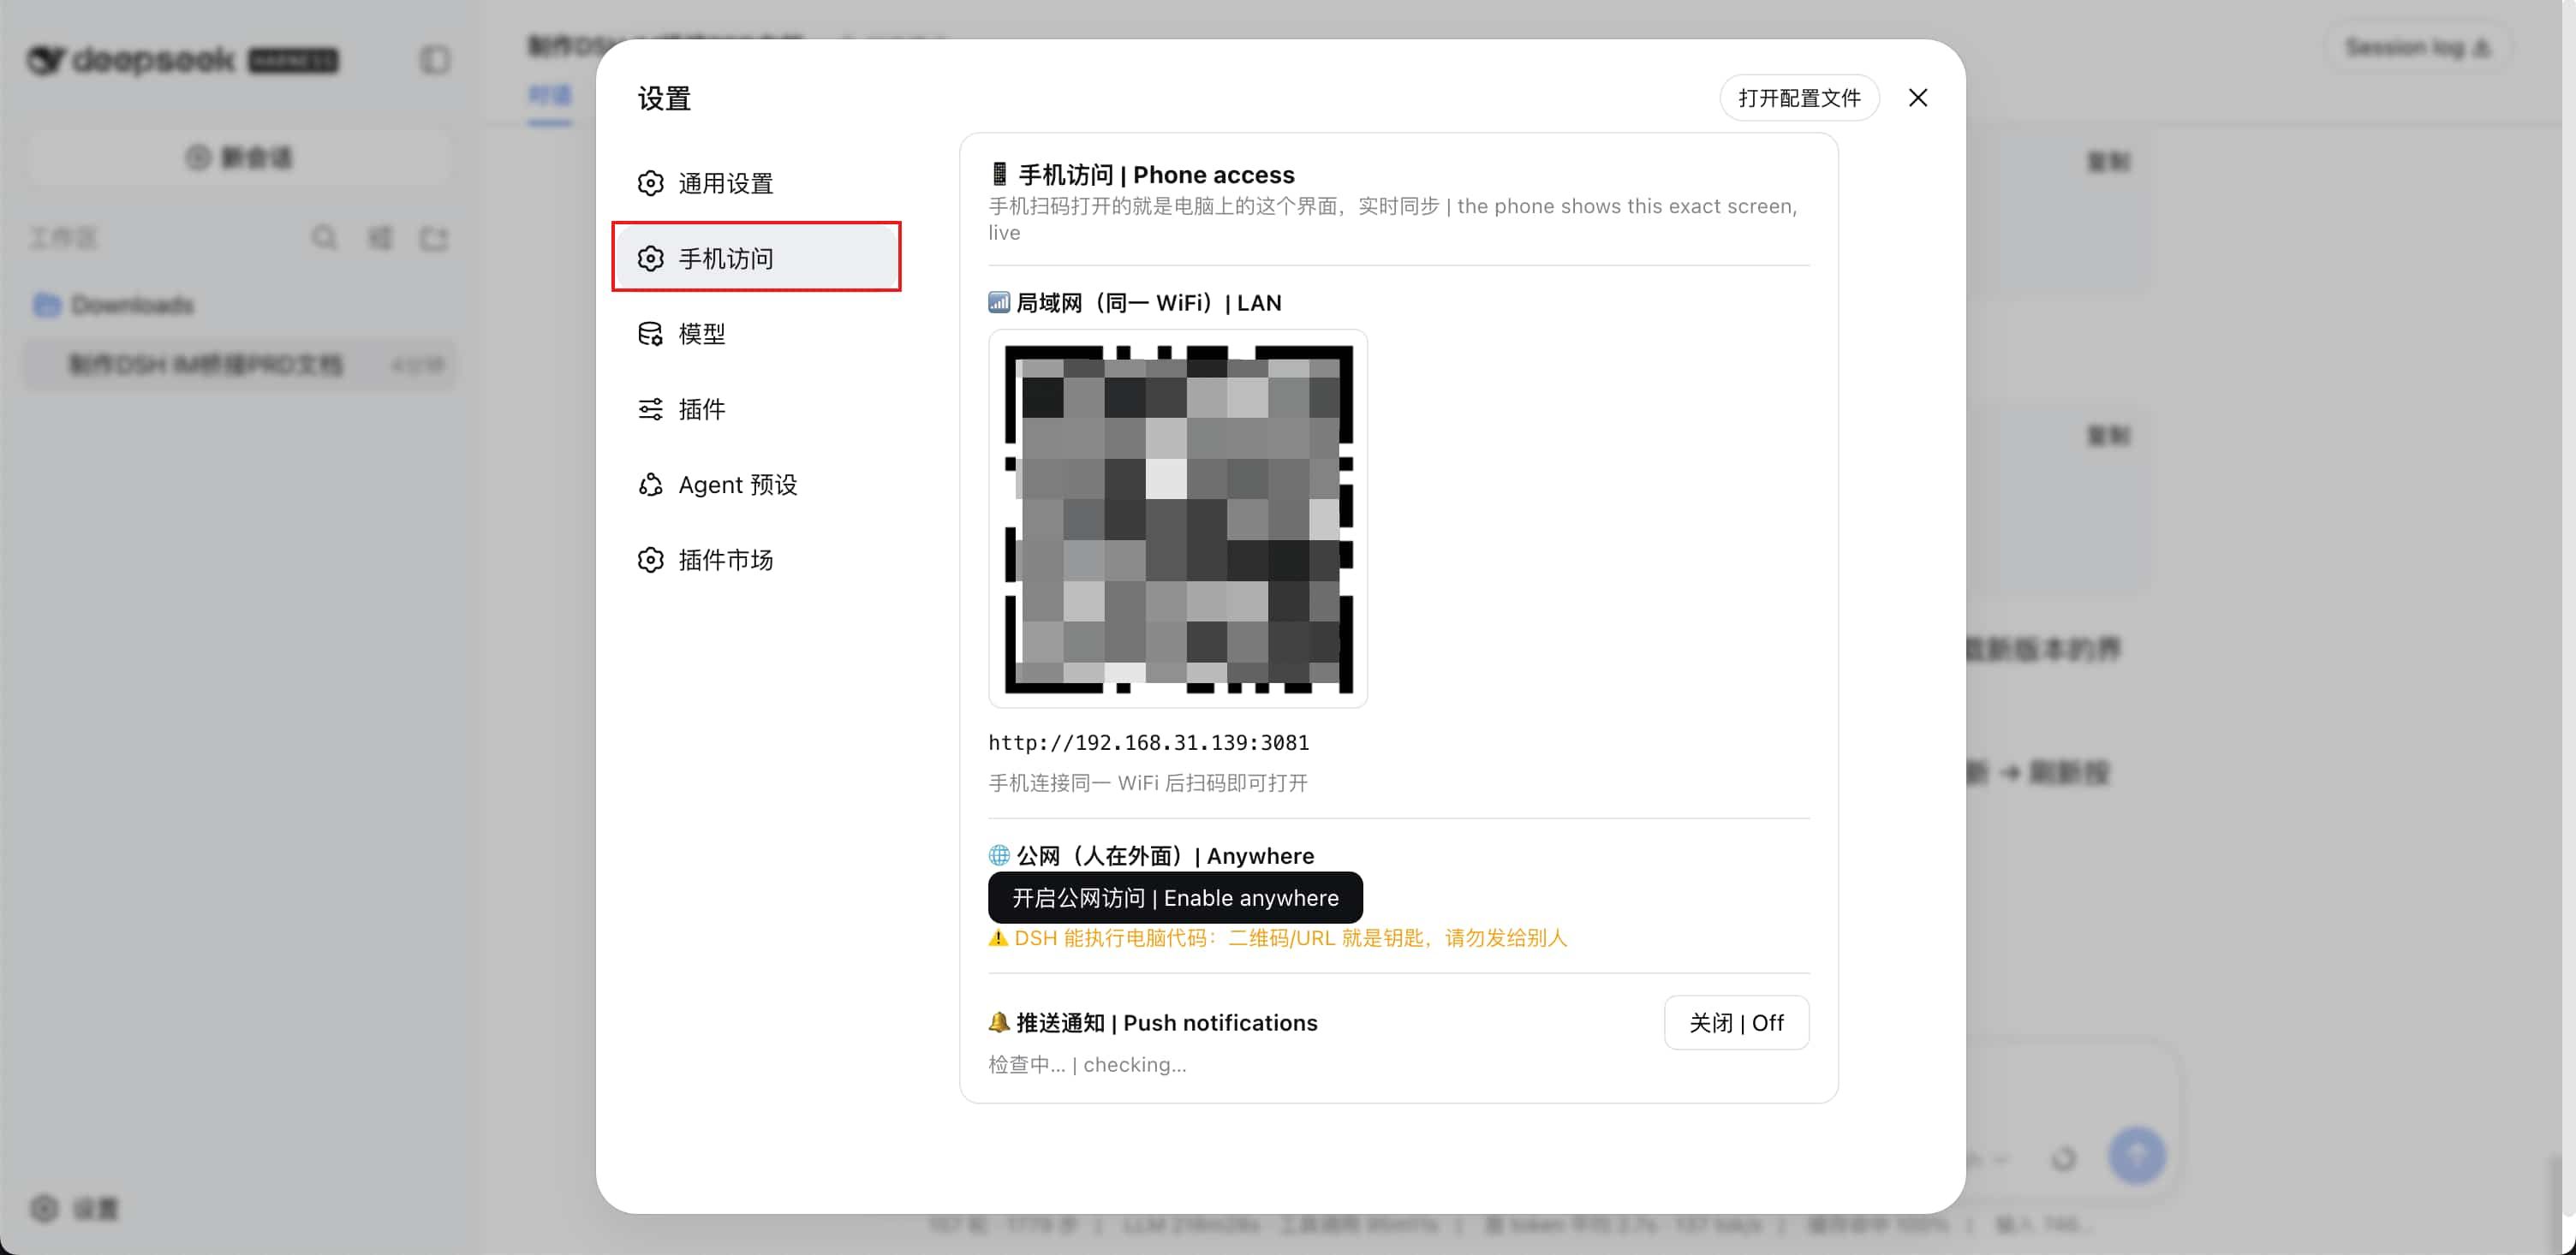
▲ 设置 → 手机访问,和「通用设置」「模型」同级。
IM 和 Pocket 解决的是「怎么把指令送进去、把结果取出来」;computer-use 解决的是「agent 能不能操作那些没有 API 的东西」。
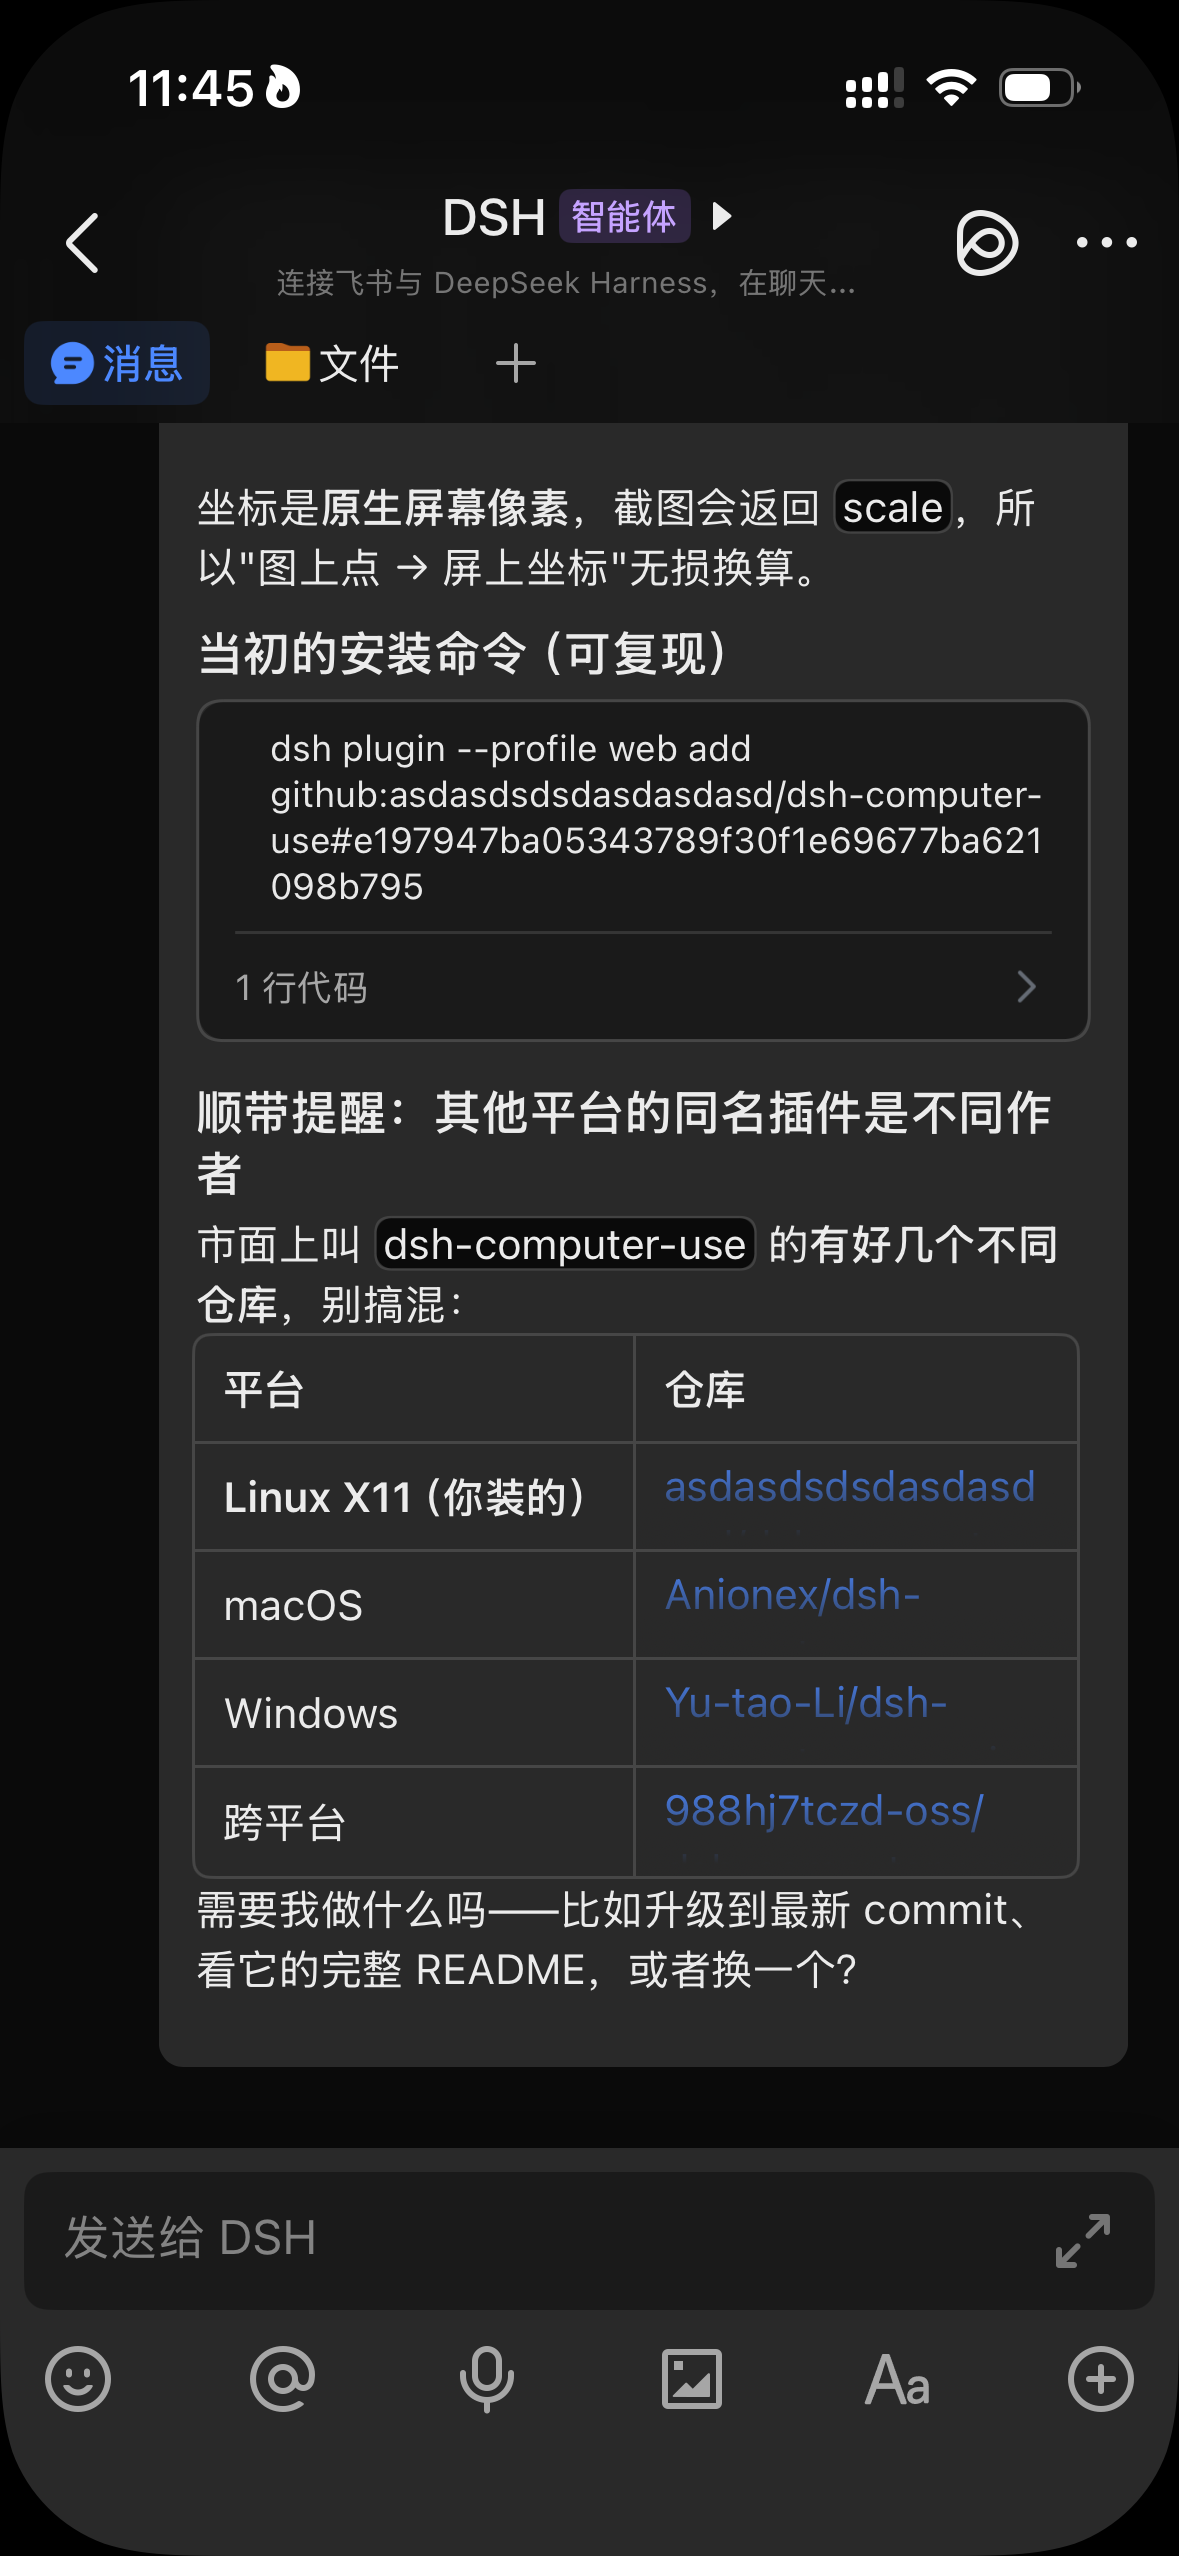
市面上 computer-use 类的插件多数是 macOS 或 Windows 的,我这台是 Linux。这个插件的定位很明确:专门给 Linux X11 用,而且零重依赖——不需要 Node 原生模块、不需要 PowerShell、不需要无障碍框架,就 python3 + libX11 + libXtst + ImageMagick。
它提供 9 个工具:
| 工具 | 作用 |
|---|---|
computer_screenshot |
截图(全屏或指定区域),带缩放元数据 |
computer_move_mouse |
移动指针到原生像素坐标 |
computer_click |
移动并点击(可指定按键、连击) |
computer_drag |
拖拽 |
computer_scroll |
滚轮滚动 |
computer_type |
向当前焦点窗口输入文字 |
computer_key |
发送按键或组合键(enter / ctrl+s / alt+F4) |
computer_cursor |
读当前指针位置 |
computer_screen_info |
屏幕尺寸 + XTest 可用性 |
坐标是 X11 原生像素,截图会同时返回 scale 和区域偏移,所以缩放后的图上点选的坐标不会偏。每步输入动作之后还可以自动附一张新截图(observeAfterAction,默认开),模型能立刻确认上一步有没有生效。
「你用我装好的 computer use 这个 skill。去查找 NBA 官网的首页。一边翻看它,一边跳到哈登的新闻,然后点开,从头翻到尾。」
后面又追加了两条:
「整个过程你用屏幕录制把它录下来,之后发给我的 DSH 飞书机器人。」
「你录制的视频,只保留 1 分钟以后的东西,然后重新发到 DSH 飞书 bot。」
它是真的在动桌面。我把那次会话的工具调用拉出来还原了一遍,一共 47 次调用,桌面操作部分是这么走的:
computer_screenshot                  ← 先看一眼当前屏幕
computer_click ×2 → computer_key ×2  ← 点地址栏进去、清空原内容
computer_type                        ← 输入网址
computer_key ×2 → type → key ×2      ← 回车、进入站点
computer_screenshot                  ← 确认页面真的加载出来了
computer_click                       ← 点进哈登那条新闻
computer_scroll ×4                   ← 往下翻
computer_click ×2 → key → scroll ×4  ← 继续翻,一直翻到底
后面录屏那段更完整。它先自己探测了本机的录屏工具链(ffmpeg / x11grab / import 这些在不在),确认可用之后直接起了个后台录制:
ffmpeg -f x11grab -video_size 2560x1440 -framerate 25 -i :1 \
       -c:v libx264 -preset veryfast ... rec/nba-harden.mkv
翻完之后停录、转成 mp4、裁掉前 60 秒,最后把 NBA官网-哈登新闻-浏览录屏-1分钟后.mp4 发回了飞书 bot。手机上收到的就是这个视频文件。
整个过程我没在电脑上点过任何一下。
先说好的:在 Linux X11 上操作起来还比较流畅,点击、输入、滚动都稳,不飘。它的每一步动作都会回报「系统实际注册到的原生坐标」,加上动作后自动补截图,所以基本不会点偏。
再说实话:翻网页的速度是老年人手速,比不上 Codex 的 computer use(人家在浏览器场景做了专门优化)。它是「截图 → 判断 → 动作 → 再截图」一步步走的,页面元素多、要看清楚再点的时候会明显慢。而且网页下页有cookie弹窗和小广告的遮挡关键位置的时候,computer-use 理解要叉掉小弹窗+操纵鼠标比较慢。
但是——它够用。凡是「只能用界面、没有 API」的活儿,比如登录态维护、看一眼某个站点的页面、点开某个东西翻一遍,它都能干。而且因为它每一步都截图确认,反而不容易点错。
单看每个插件都只是「一个入口」,串起来才有意思:
用嘴说一句话 → 飞书 bot 收到 → DSH 在服务器上干活 → 需要操作界面的时候调 computer-use 动鼠标 → 结果(表格 / 图片 / 录屏文件)直接回到手机聊天窗口。
人到哪儿,agent 跟到哪儿。上面那个 NBA 的例子,从头到尾我没打开过电脑。
从 8 月 30 日到 9 月 13 日,我把本机 ~/.dsh/sessions 里的记录全量统计了一遍,数字比主观感受更有说服力:
| 指标 | 数值 |
|---|---|
| 会话总数 | 145 个(主会话 98 / 子代理 47) |
| 真实用户输入 | 998 条 |
| 工具调用总数 | 14,564 次 |
| 经 IM 渠道下达的指令 | 87 条 |
| 经 IM 回传的文件 | 189 次 |
computer_* 桌面操作 |
86 次 |
| 活跃天数 | 13 个(08-30 → 09-13 这 15 天里) |
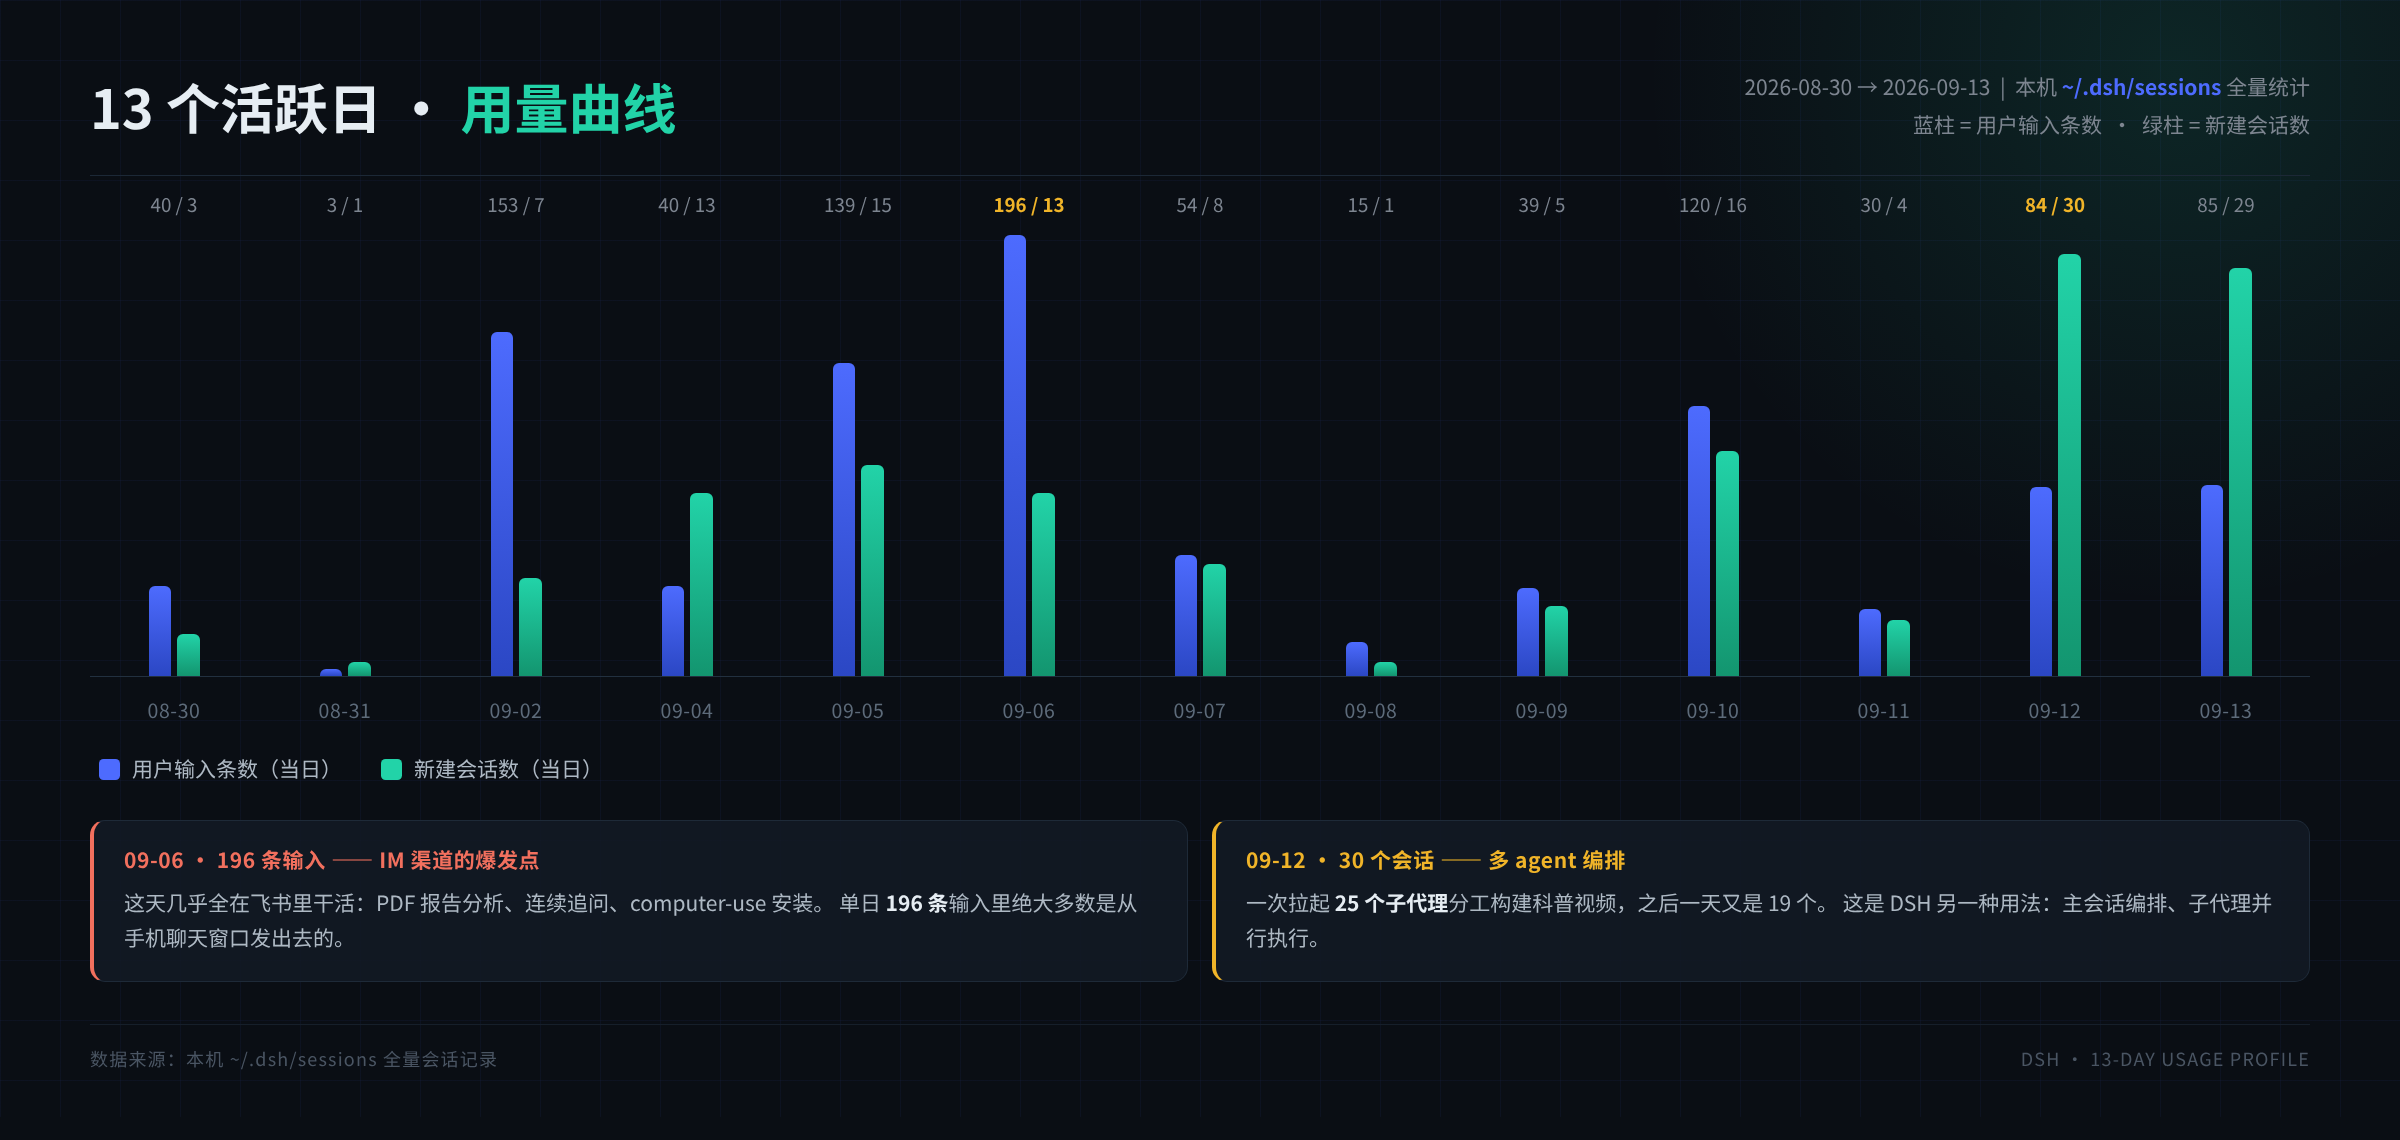
▲ 每天的输入条数与会话数。09-06 是 IM 渠道的爆发点,09-12 是多 agent 编排那天。
其中 computer_ 类的拆分:截屏 14 次、按键 28 次、滚动 18 次、点击 16 次、输入 7 次。量和前面那个「翻网页」的手感是对得上的——确实是一步一步挪出来的。
三个插件里,只用得起一个的话选 dsh-im——它把「随时随地能给 agent 下指令、还能收到成品文件」这件事做得最完整,配合飞书 + 豆包语音那条链路,基本就是给服务器上的 agent 配了一部专线电话。
要盯着看就加 dsh-pocket,它解决的是「我要看那块屏幕本身」的场景,配置一次、命名隧道固定域名之后就不用再管了。
要操作没有 API 的东西就加 dsh-computer-use,在 Linux X11 上它是目前最省事的选择,慢是真慢,但那些只能靠界面点的活儿,它真能替你干完。
最后,三个插件都是社区作者的作品,用得上就去给个 Star。
@terry 好的,老特,我单独发个帖子总结一下我最近用DSH的经验吧。
有了DSH的这几个插件,可以很方便的远程控制服务器上的DSH。
https://github.com/xmanrui/dsh-im#readme
https://github.com/shaobeichen/dsh-pocket#readme
https://github.com/asdasdsdsdasdasdasd/dsh-computer-use#readme
这几个DSH插件挺好的。
附上豆包工作转发给DSH 飞书bot的指令。不想用豆包工作,手机上直接装豆包输入法,体验也不错。
Note:
豆包 DSH 自动转发使用说明
你在豆包里发的消息,会自动转给 DSH,不用额外说"转发"。DSH 的回复直接出现在当前聊天窗口。
想跟豆包直接说话、不转给 DSH 时,开头说"豆包"或"先别转"。
例:"豆包,帮我总结一下刚才 DSH 的回复"
3. 自动等回复
转发后豆包会每 10 秒查一次 DSH 有没有回复,最多等 3 分钟。一有回复立刻摘给你;超过 3 分钟会提示"DSH 还在处理"。
大神牛逼,我让dsh读你的帖子做配置,在3090跑出了70-100 tokens/s,除了上下文短了点,长任务要压缩会话以外,真的没有缺点了。识图也从之前用llama.cpp的原版10s/张加速到2.5s/张。
